DASE 7113 · 课程精讲

约束优化算法

共 44 页。按原课件顺序,左侧看原页,右侧读讲解。

逐页目录 · 共 44 页
  1. 有约束以后,算法要同时管下降和可行性
  2. 先分类,再选择求解方法
  3. Programming 在这里为什么译为“规划”
  4. 线性规划的可行域为什么是多面体
  5. 线性规划的三种结果
  6. 图解法:平移目标等值线,找到最优顶点
  7. 一整条边都最优,也仍有顶点最优解
  8. 单纯形法的直观想法与本课重点
  9. linprog 的输入:目标、矩阵、右端和上下界
  10. 求解器方法:HiGHS 与单纯形并不矛盾
  11. 完整例题:把大于号翻成小于号
  12. 项目最早完工:先把表读成约束
  13. 项目时间模型怎样放进 linprog
  14. 要求 40 天完成:增加工期压缩变量
  15. 高层建模工具:照着公式写,而非手抄大矩阵
  16. 逐句读 CVXPY 的赶工模型
  17. 同一个模型用 gurobipy 怎样表达
  18. 二次规划:目标多了平方项
  19. 二次规划可以利用 KKT 结构求解
  20. QP 的工具选择怎样理解
  21. 把 QP 的数学表达逐项翻译成 CVXPY
  22. 更一般的目标,但限制仍是线性的
  23. 用一个集合 Ω 统一表示全部线性限制
  24. Frank–Wolfe:先把目标换成切平面
  25. 线性子问题的解为什么给出下降方向
  26. 沿两个可行点的连线走,新点仍可行
  27. Frank–Wolfe 还剩两个选择
  28. 约束凸问题的最优性:所有可行方向都不再下降
  29. Frank–Wolfe gap:能计算的停止指标
  30. 把 Frank–Wolfe 拼成完整算法
  31. Frank–Wolfe 的两种步长
  32. 交通均衡:每条路的耗时随流量增加
  33. 交通势函数:积分后为什么能求均衡
  34. 读 Frank–Wolfe 的 gap 收敛图
  35. 投影梯度:先走一步,再拉回可行域
  36. 投影本身也是一个优化问题
  37. 用 PGD 求同一交通均衡
  38. PGD 的步长过大,会在边界之间来回跳
  39. 一般非线性规划:约束也开始弯曲
  40. SQP:二次近似目标,一次近似约束
  41. 先把课件公式与代码的目标统一
  42. 逐项计算 SQP 子问题所需的导数
  43. 为什么直接走完一个 SQP 位移还不够稳
  44. SLSQP:把实用约束求解器接到模型上
原第 1 页

有约束以后,算法要同时管下降和可行性

原课件第1页
点击原页可打开 PDF。

这一讲研究约束优化算法。无约束时,沿负梯度走即可尝试下降;有约束时,还必须保证新点满足限制。比如分配 10 辆车到三条路,三个流量必须非负,而且总和必须始终为 10。

先学习怎样调用求解器处理线性规划和二次规划,再学习 Frank–Wolfe、投影梯度下降,以及处理非线性约束的 SQP。贯穿全讲的问题是:既让目标变小,又让变量安排符合规则。

原第 2 页

先分类,再选择求解方法

原课件第2页
点击原页可打开 PDF。

无约束问题只有 minf(x)。约束问题还带 gi(x)≤0 和 hi(x)=0:前者可以有余量,后者必须精确满足。

  1. 如果目标和全部约束都是线性或仿射表达,得到线性规划 LP,例如 min3x1+2x2,约束 x1+x2≥10、x≥0。
  2. 如果目标含平方而约束仍线性,可能属于二次规划 QP。
  3. 如果出现指数、四次项或非线性约束,就需要考虑更一般的方法。

这里“线性约束”通常也包含常数项,例如 2x1−x2+3≤0。识别结构是为了选好工具:不能只因为都叫优化问题,就把同一算法套上去。

对应课堂录音Week09 Part01 01:35:56–01:40:50
原第 3 页

Programming 在这里为什么译为“规划”

原课件第3页
点击原页可打开 PDF。

这里的 program 原本指安排计划,例如安排物资运输、人员部署和活动时间;不是专指编写计算机程序。老师在录音里用军事后勤调配解释这个词的来历。

例如有若干批物资、不同目的地和有限运输能力,问题是:每条路线运多少,才能满足需求并使总费用最低?这是一份资源分配计划,也就是 mathematical programming 中的 programming。

因此“线性规划”说的是:用线性目标和线性限制寻找最好的安排。它可以用纸笔分析,也可以交给计算机求解;是否写代码不是分类依据。

对应课堂录音Week09 Part01 01:35:56–01:40:50
原第 4 页

线性规划的可行域为什么是多面体

原课件第4页
点击原页可打开 PDF。

把所有满足限制的点收集起来,得到可行域 Ω。本页把每条不等式和等式分别看成一个集合:

Gi={x:gi(x)≤0},Hj={x:hj(x)=0},Ω=⋂iGi∩⋂jHj.
  1. 二维线性不等式,例如 x1+x2≤1,表示一条直线的一侧,叫半平面。
  2. 线性等式,例如 x1+x2=1,表示直线本身;在高维中叫超平面。
  3. 所有约束同时成立,就是把这些区域取交集。有限个线性限制交出来的集合叫多面体。

图里的多边形是二维示意。多面体可以有界,也可以无界,还可能为空。线性目标再在这个集合上寻找最低值。

对应课堂录音Week09 Part01 01:35:56–01:40:50
原第 5 页

线性规划的三种结果

原课件第5页
点击原页可打开 PDF。

本页问题为 min−x1−2x2,满足 x1+x2≤c、x1,x2≥0。最小化负数,等价于尽量增大 x1+2x2。

  1. c<0:不可行。两个非负数相加至少为零,不可能小于负数,所以没有一个点满足限制。
  2. c≥0 且有限:存在最优解。可行域是三角形。把额度全部分给收益系数更大的 x2,取 (x1,x2)=(0,c),目标值为 −2c。当 c=0 时只有原点。
  3. 去掉总量上界:向下无界。令 x1=0,x2=t,t 越大目标 −2t 越小,可以一直下降。

课件用 c=∞ 表示取消那条有限上界。不可行是“一个允许的点都没有”;无界是“允许的点有很多,而且目标没有有限下限”,两者完全不同。

对应课堂录音Week09 Part01 01:40:54–01:45:30
原第 6 页

图解法:平移目标等值线,找到最优顶点

原课件第6页
点击原页可打开 PDF。

现在 c=1,可行三角形的顶点为 (0,0),(1,0),(0,1)。令目标值为 z=−x1−2x2,整理得 x2=−12x1−12z.

  1. 固定 z,得到斜率为 −1/2 的直线,线上所有点目标值相同。
  2. 让 z 变小,截距 −z/2 变大,直线平行向上移动。
  3. 在仍与三角形相交的前提下,最优位置经过 (0,1)。此时目标值 z=−2。
  4. 也可以直接检查三个顶点:目标分别为 0、−1、−2,最小值确实为 −2。

本例说明:在具有顶点的可行多面体上,线性目标若取得有限最优值,可以在顶点找到一个最优解。不能把它推广为任意多面体都必有顶点;有些无界集合本身不含顶点。

对应课堂录音Week09 Part01 01:54:08–01:59:06Week09 Part01 01:59:07–02:05:18
原第 7 页

一整条边都最优,也仍有顶点最优解

原课件第7页
点击原页可打开 PDF。

可行域保持不变,目标改为 z=−x1−x2。等值线变成 x2=−x1−z,斜率为 −1,与三角形的斜边平行。

  1. 因为 x1+x2≤1,所以目标 −x1−x2≥−1。
  2. 凡是满足 x1+x2=1、两个变量非负的点,都达到目标值 −1。
  3. 例如 (1,0),(0.5,0.5),(0,1) 全部最优,所以最优解不唯一。
  4. 这条最优边的两个端点 (1,0),(0,1) 同样最优,顶点最优解仍然存在。

老师在录音中特别区分:“存在一个顶点最优解”不等于“所有最优解都是顶点”,也不等于“最优解唯一”。

对应课堂录音Week09 Part01 01:59:07–02:05:18
原第 8 页

单纯形法的直观想法与本课重点

原课件第8页
点击原页可打开 PDF。

课件介绍 Dantzig 的单纯形法。直观上,它利用线性规划的几何结构,在相邻顶点之间移动,逐步改善目标值。高维里还要处理基、退化和数值容差等问题,细节比二维画图多得多。

本课这一部分的重点是把现实问题写成正确的线性模型,再调用成熟求解器。你需要知道输入的每个系数代表什么、约束是否写对,以及输出表示最优、不可行还是无界。

所以接下来的练习不会要求先自己实现完整单纯形算法,而是把前面建立的模型转换为求解器能接收的形式。

对应课堂录音Week10 Part01 00:09:56–00:14:00Week09 Part01 02:05:19–02:09:35
原第 9 页

linprog 的输入:目标、矩阵、右端和上下界

原课件第9页
点击原页可打开 PDF。

本页左边是 MATLAB,右边是 SciPy 的线性规划接口。它们接受的核心数学形式相同:

mincTx,Aubx≤bub,Aeqx=beq,l≤x≤u.
  1. c 是目标系数。例如目标 −x1+4x2 对应 c=(−1,4)T。
  2. Aub 每一行放一条不等式左侧的系数,bub 的对应元素放右侧常数。
  3. 等式单独放在 Aeq,beq,不要为了凑接口随意改成单边不等式。
  4. 每个变量的最小值、最大值放在 bounds。没有上界或下界可用 None 表示。

开始编码前先固定变量顺序。矩阵的第几列,必须始终对应同一个变量,这是避免错位最重要的一步。

对应课堂录音Week09 Part01 02:05:19–02:09:35Week09 Part01 02:09:36–02:14:56
原第 10 页

求解器方法:HiGHS 与单纯形并不矛盾

原课件第10页
点击原页可打开 PDF。

图中圈出的 method='highs' 是 SciPy 线性规划接口展示的方法选择。HiGHS 是求解器体系,接口还可选择对偶单纯形或内点方法。

原页关于单纯形法“难以处理大型问题”的概括过宽。现代对偶单纯形仍是实用算法;旧的独立 simplex 实现停用,也不等于整个算法家族被淘汰。

本课写应用代码时,可直接用 linprog(..., method='highs'),把注意力放在模型和结果。求解后查看 res.success、res.message、res.x 和 res.fun,分别确认求解状态、说明、参数和目标值。只有成功求解后,才把输出当成对应模型的最优解。

对应课堂录音Week09 Part01 02:05:19–02:09:35
原第 11 页

完整例题:把大于号翻成小于号

原课件第11页
点击原页可打开 PDF。

原问题是最小化 −x1+4x2,约束为 −3x1+x2≤6、−x1−2x2≥−4、x2≥−3。其中 x1 没有限定符号。

  1. 第二条两边乘 −1,不等号反向,成为 x1+2x2≤4。
  2. 因此矩阵两行为 (−3,1) 和 (1,2),右端为 6、4。
  3. 显式写出 x1 自由、x2≥−3,避免误用非负变量默认值。
from scipy.optimize import linprog
res = linprog([-1, 4], A_ub=[[-3, 1], [1, 2]],
              b_ub=[6, 4], bounds=[(None, None), (-3, None)],
              method='highs')
print(res.x, res.fun)

结果为 (10,−3),最优值 −22。手算核对:由 x1≤4−2x2 得 −x1+4x2≥−4+6x2≥−22,而 (10,−3) 满足全部约束并达到这个下界,所以确为最优。

对应课堂录音Week09 Part01 02:09:36–02:14:56
原第 12 页

项目最早完工:先把表读成约束

原课件第12页
点击原页可打开 PDF。

TA,…,TI 表示各活动的完成时刻,不是开始时刻。活动开始时刻等于“完成时刻减工期”。

  1. A 工期 8、无前置:TA−8≥0。
  2. B 在 A 后开始、工期 10:TB−10≥TA。C 同理为 TC−9≥TB。
  3. D 的前置为 B 和 C,所以分别写 TD−8≥TB 与 TD−8≥TC,两条都要满足。
  4. G 的前置为 C、D、F,需三条约束:TG−2≥TC,TD,TF。
  5. 令 z≥TA,…,TI,最小化 z 就把全部任务的最晚完成时刻压到最早。

递推检查:A=8,B=18,C=27,D=35,E=23,F=33,G=37,H=36,I=47。所以最早完工为47 天,关键路径 A→B→C→D→G→I 的工期和为 47。

E 等 B,F 等 E,H 等 F,I 等 G 和 H。完整的后半段分别是 TE≥TB+5、TF≥TE+10、TH≥TF+3、TI≥TG+10、TI≥TH+10。例如 G 必须等 C、D、F 中最晚的 D 在第 35 天结束,所以 TG=35+2=37。I 等较晚的 G,得到 37+10=47。

对应课堂录音Week09 Part01 02:09:36–02:14:56
原第 13 页

项目时间模型怎样放进 linprog

原课件第13页
点击原页可打开 PDF。

课件把变量固定为 v=(TA,TB,TC,TD,TE,TF,TG,TH,TI,z)T,共十个。目标只取最后一个变量,因此 c=(0,0,…,0,1)T。

  1. 第一条 TA≥8 的系数行为 (1,0,…,0),右端为 8。
  2. TB−TA≥10 的系数行为 (−1,1,0,…,0),右端为 10。
  3. z−TA≥0 的行在 TA 列放 −1、z 列放 1,其余为零;其他八条 z≥Ti 同样写。
  4. 图中先把所有限制统一整理成 Av≥b,最后调用时整体乘 −1:A_ub=-A、b_ub=-b。

完成时刻设为非负;z 可设为自由变量,因为 z≥Ti≥0 已间接给出下界。调用求解器得到最优 z=47。不同最优输出的非关键活动时刻可能含等待,但都应满足工期和先后关系。

矩阵难读时,任取一行翻回原来的活动关系检查。例如 D 的约束必须同时含 B、C 两位前置,不能漏掉其中之一。

运行完整的项目工期模型
from scipy.optimize import linprog

tasks = "ABCDEFGHI"
duration = dict(zip(tasks, [8, 10, 9, 8, 5, 10, 2, 3, 10]))
before = dict(zip(tasks, ["", "A", "B", "BC", "B", "E", "CDF", "F", "GH"]))
column = {task: i for i, task in enumerate(tasks)}
A_ub, b_ub = [], []
for task in tasks:
    for parent in before[task] or [None]:
        row = [0] * 10
        row[column[task]] = -1
        if parent is not None:
            row[column[parent]] = 1
        A_ub.append(row)
        b_ub.append(-duration[task])
    row = [0] * 10
    row[column[task]], row[9] = 1, -1
    A_ub.append(row)
    b_ub.append(0)

res = linprog([0] * 9 + [1], A_ub=A_ub, b_ub=b_ub,
              bounds=[(0, None)] * 9 + [(None, None)], method="highs")
print(res.success, res.fun)

column 给每项任务的完成时刻分配一列,第 10 列留给 z。每个前置关系生成一行,例如 C 在 B 后完成,写成 TB−TC≤−9,B 列填 1,C 列填 −1。A 没有前置任务,所以只填 A 列。第二种行是 Ti−z≤0。程序直接生成“小于等于”的矩阵,输出 True 47.0。

对应课堂录音Week09 Part01 02:09:36–02:14:56
原第 14 页

要求 40 天完成:增加工期压缩变量

原课件第14页
点击原页可打开 PDF。

设 xi 是活动 i 缩短的天数,实际工期为 di−xi。例如 A 原来 8 天,压缩 2 天后变为 6 天。

  1. 按表设置上界:0≤xA≤2、0≤xB≤2、0≤xC≤4 等。G 不能压缩,所以 xG=0。
  2. 时间约束中把工期换成压缩后的工期,例如 TB≥TA+10−xB。
  3. 全部完成时刻要求 Ti≤40。
  4. 最小化额外成本:5000xA+9000xB+7000xC+4500xD+1500xE+3500xF+4500xH+9500xI.

一组最优压缩方案为 (xA,xB,xC,xD,xE,xF,xG,xH,xI)=(2,2,0,3,1,1,0,0,0)。成本为 10000+18000+13500+1500+3500=46500。对应最早完成时刻为 6、14、23、28、18、27、30、30、40。

压缩原关键路径后,其他分支可能成为瓶颈。G 行中 TG−(2−xG) 表示 G 的开工时刻,它至少等于 C、D、F 三个完成时刻的最大值。

证明为什么 46,500 已经是最低费用

只取两条路径也能给任何方案算费用下界。A→B→C→D→G→I 原长 47,压缩量之和 r1=xA+xB+xC+xD+xI 至少是 7。A→B→E→F→H→I 原长 46,r2=xA+xB+xE+xF+xH+xI 至少是 6。

分别乘 5,500 和 3,500 后相加,得到 5500r1+3500r2≥59,500。对照表格里的真实费用,这个加权和对 A 每天多算 4,000,对 D 多算 1,000,对 E 多算 2,000。其余各项都等于或低于真实费用。

最多多算 4000(2)+1000(3)+2000(1)=13,000,因为 A、D、E 分别最多压缩 2、3、1 天。因此任意可行方案至少花 59,500−13,000=46,500。本页的方案满足所有前置关系并达到下界,所以最优。

对应课堂录音Week09 Part01 02:26:36–02:30:43Week09 Part01 02:30:46–02:36:32
原第 15 页

高层建模工具:照着公式写,而非手抄大矩阵

原课件第15页
点击原页可打开 PDF。

前一题有两组变量:压缩天数和完成时刻。把它们全部排成系数矩阵虽然可行,却很容易发生列错位。CVXPY 和 gurobipy 允许更接近数学模型的表达。

  1. 先建立命名变量,例如 xA、TA。
  2. 直接写限制,例如 xA <= 2、TB >= TA+10-xB。
  3. 直接把成本加权求和,声明最小化。
  4. 由建模工具整理并调用数值求解器。

CVXPY 是建模层,具体数值计算由它调用的求解器完成;gurobipy 是 Gurobi 的 Python 接口。老师在录音中强调的好处是模型更便于阅读和核对:修改某项工期时,能直接找到对应约束。

对应课堂录音Week09 Part01 02:26:36–02:30:43Week09 Part01 02:30:46–02:36:32
原第 16 页

逐句读 CVXPY 的赶工模型

原课件第16页
点击原页可打开 PDF。

图中代码分为变量、约束、目标和求解四部分。

  1. xA = cp.Variable(name="xA", nonneg=True) 建立非负压缩变量;其余 xi 和完成时刻 Ti 同样建立。
  2. constraints = [xA <= 2, ...] 收集最大压缩量限制。xG≥0 与 xG <= 0 合起来固定 xG=0。
  3. TB == TA+10-xB 让单一前置的活动紧接前项开始。在此没有资源冲突、等待也不降低成本的模型中,可选择这种最早安排。
  4. D、G、I 有多个前置,用多条 >= 表示必须等最晚的前置完成,不能把它们全部改成等式。
  5. 添加全部 Ti <= 40,再写 objective = cp.Minimize(总成本)。
  6. problem = cp.Problem(objective, constraints) 组成问题;problem.solve() 求解。用 problem.value 读最优成本,xA.value 等读变量值。

最优额外成本为 46500。输出可能出现约 10−8 的微小零值或很小的越界残差,结合求解状态与容差读数,不必把它解释为另一个压缩方案。

完整课堂程序和具体输出可以逐行对照。打开 70 行代码讲解。

对应课堂录音Week09 Part01 02:30:46–02:36:32Week09 Part01 02:38:15–02:41:54
原第 17 页

同一个模型用 gurobipy 怎样表达

原课件第17页
点击原页可打开 PDF。

这页与上一页数学模型相同,只换了建模接口。把对应关系看清,就不需要重新学一套优化原理。

  1. model = Model() 创建模型。
  2. addVar(lb=0, ub=2, name="xA") 建立 0≤xA≤2 的变量;lb 是下界,ub 是上界。
  3. 完成时刻也用 addVar(lb=0, ...) 建立。
  4. setObjective(成本表达式, GRB.MINIMIZE) 声明最小化成本。
  5. addConstr(TD >= TC+8-xD) 添加一条数学约束,每个前置关系各写一条。
  6. model.optimize() 求解,之后从变量的 .X 属性取数值、从 model.ObjVal 取目标值。

原页注释里的 setParam('Method',2) 是指定求解方法的可选设置,去掉注释才会执行。无论使用哪个接口,最终应检查的是同一组工期、预算和 40 天完工条件。

对应课堂录音Week09 Part01 02:30:46–02:36:32
原第 18 页

二次规划:目标多了平方项

原课件第18页
点击原页可打开 PDF。

二次规划 QP 的标准形式是 minx 12xTPx+qTx,Gx≤h,Ax=b. 目标最高为二次,约束仍然线性。

  1. qTx 是线性部分,和 LP 相同。
  2. xTPx 可以产生 x12、x1x2 等二次项。通常取 P 为对称矩阵。
  3. 若 P⪰0,目标凸;若 P≻0,目标严格凸,非空可行域上的最优点至多一个。

例如 minx12+x22,约束 x1+x2=1,x≥0,取 P=2I,q=0。因为固定总和为 1,两个量越均匀平方和越小,最优点为 (0.5,0.5),最优值 0.5。QP 不再只需要到多面体顶点找最优点。

原第 19 页

二次规划可以利用 KKT 结构求解

原课件第19页
点击原页可打开 PDF。

QP 的梯度为 Px+q。对于凸 QP,最优性可通过可行性、乘子条件和驻点方程联系起来:

Px+q+GTλ+ATν=0,Gx≤h,Ax=b,λ≥0,λi(Gx−h)i=0.

λ 对应不等式限制,ν 对应等式限制且可正可负。许多专门算法利用这个结构,反复处理线性系统或活跃约束。

本课这里的实用重点仍是调用求解器:识别并提交 P,q,G,h,A,b,而不是自己实现完整 QP 求解器。与线性规划相比,除了约束矩阵,还要核对二次项的矩阵和系数 1/2。

把第18页的 QP 代入 KKT

令 P=2I, q=0, G=−I, h=0, A=(1,1), b=1。先试两个分量都大于零。此时两个不等式都有余量,互补条件给 λ1=λ2=0。驻点式变成 2x1+ν=0, 2x2+ν=0。两式相减得 x1=x2,代入 x1+x2=1,得到 x1=x2=1/2, ν=−1。两个分量确实大于零,其他条件也都成立,因此这个点是凸 QP 的全局最优点。

对应课堂录音Week10 Part01 00:09:56–00:14:00
原第 20 页

QP 的工具选择怎样理解

原课件第20页
点击原页可打开 PDF。

左图是 MATLAB 的 quadprog,右侧引出 CVXPY 与 gurobipy。它们让我们以二次目标、线性限制的形式建立模型。

本页“没有专门 QP 算法”的文字在对照 SciPy 的接口,不表示 SciPy 完全不能求解二次问题:通用 minimize 也能处理不少这样的模型。对于可识别的凸 QP,使用明确支持该结构的建模方式通常更便于表达。

学习时先把目标整理成 12xTPx+qTx,检查 P 的对称性和半正定性,再把线性约束逐项写出。工具名称改变,不影响这些数学检查。

对应课堂录音Week10 Part01 00:14:00–00:17:18
原第 21 页

把 QP 的数学表达逐项翻译成 CVXPY

原课件第21页
点击原页可打开 PDF。

这一页把 12xTPx+qTx、Gx≤h、Ax=b 翻译成代码。先用第18页的例子把所有数据补齐:最小化 x12+x22,要求两项非负、总和为1。

import numpy as np
import cvxpy as cp
n = 2
P = 2*np.eye(n)
q = np.zeros(n)
G = -np.eye(n)
h = np.zeros(n)
A = np.array([[1., 1.]])
b = np.array([1.])
x = cp.Variable(n)
objective = cp.Minimize(0.5*cp.quad_form(x, P) + q.T @ x)
constraints = [G @ x <= h, A @ x == b]
prob = cp.Problem(objective, constraints)
prob.solve()
print(x.value)
print(prob.value)
  1. P=2I,所以二次项为 12xT(2I)x=x12+x22。q=0 表示没有额外一次项。
  2. G=-I,h=0 表示 −xi≤0,也就是 xi≥0。G是 2×2,h长度为2。
  3. A=[[1,1]],b=[1] 表示 x1+x2=1。A是 1×2,b长度为1。
  4. cp.Variable(n) 建立长度为2的待求变量;quad_form(x,P) 表达 xTPx,@ 是矩阵乘法。
  5. Problem 把目标和约束放在一起,solve() 求解。x.value 是解向量,prob.value 是一个目标值,二者不同。

输出应接近 x=(0.5,0.5)、目标值0.5。先核对两项非负、和为1,再核对 0.52+0.52=0.5。

课件的 objective 行末多了一个逗号,实际输入时删掉。否则 Python 会把目标变成元组。这里的P半正定,目标是凸的。

对应课堂录音Week10 Part01 00:14:00–00:17:18
原第 22 页

更一般的目标,但限制仍是线性的

原课件第22页
点击原页可打开 PDF。

现在把目标扩展为一般可微非线性函数,约束仍然线性。例如 minex1+x24,x1+x2=1,x1,x2≥0.

它不是 QP,因为有指数和四次项;但可行域仍是一个线段,结构很简单。我们希望保留这个可行域,并在它里面逐步降低目标。

接下来的两种想法分别是:Frank–Wolfe 每轮用线性目标寻找可行端点;投影梯度先朝下坡方向走,再把越界点拉回可行域。它们处理可行性的方式不同。

对应课堂录音Week10 Part01 00:21:41–00:26:15
原第 23 页

用一个集合 Ω 统一表示全部线性限制

原课件第23页
点击原页可打开 PDF。

把所有线性等式、不等式取交集,记为多面体 Ω。原问题就简写成 minx∈Ωf(x).

这种写法把两部分分开:f 告诉我们目标怎样变化,Ω 告诉我们哪些点允许使用。图里的蓝色多边形就是 Ω。

例如交通流量限制为 x1+x2+x3=10、xi≥0,所以 Ω={x∈R3:1Tx=10,x≥0}。它在三维空间里是一个三角形。每个顶点表示把全部流量放到同一条路,边和内部表示多条路分担流量。

线性限制使 Ω 为凸集:两个可行点之间的整条线段都可行。Frank–Wolfe 正好利用这一点来更新。

原第 24 页

Frank–Wolfe:先把目标换成切平面

原课件第24页
点击原页可打开 PDF。

从可行点 xk∈Ω 出发,在它附近用一阶近似表示目标:

f(y)≈f(xk)+∇f(xk)T(y−xk).
  1. 这一轮 xk 已固定,所以 f(xk)−∇f(xk)Txk 是常数。
  2. 因此最小化近似式,等价于求 yk∈argminy∈Ω∇f(xk)Ty.
  3. 目标对 y 线性,而 Ω 是线性约束集合,所以这是一个 LP 子问题。

例如 Ω={y≥0:y1+y2=1},当前梯度为 (0.5,−0.5)。要最小化 0.5y1−0.5y2,就把总量全放在第二个变量,得到 yk=(0,1)。

原页子问题的约束应写为 y∈Ω,而不是 x∈Ω,因为现在真正正在选择的变量是 y。

解出近似问题,不等于可以直接跳过去。用 f(x)=x2、−1≤x≤1 算一次:在 x0=−1,导数为−2,线性近似是 1−2(y+1),它在区间内的最小点为 y0=1。若直接跳到1,下一轮导数变成2,线性近似的最小点又是−1。两端来回跳,原目标一直是1,而真正最优点0的目标是0。

所以 LP 解主要告诉我们往哪边走;还要决定走多远。这就是下一页采用 dk=yk−xk 的原因。

对应课堂录音Week10 Part01 00:21:41–00:26:15
原第 25 页

线性子问题的解为什么给出下降方向

原课件第25页
点击原页可打开 PDF。

把从当前点指向 LP 解的向量记为 dk=yk−xk。证明它有用,关键只用一个事实:yk 是这一轮线性子问题的最优解。

  1. 近似目标中只有 ∇f(xk)Ty 随y变化,其余是常数。因此对任何可行点 z∈Ω,都有 ∇f(xk)Tyk≤∇f(xk)Tz.
  2. 当前点 xk 本身也可行,可以取 z=xk。于是 ∇f(xk)Tyk≤∇f(xk)Txk.
  3. 两边移项,得到 ∇f(xk)T(yk−xk)=∇f(xk)Tdk≤0.
  4. 若内积严格小于0,由一阶展开 f(xk+αdk)=f(xk)+α∇f(xk)Tdk+o(α),足够小的正步长会让目标下降。

例如 xk=(0.5,0.5)、梯度为 (0.5,−0.5),LP解 yk=(0,1),则 dk=(−0.5,0.5),内积为−0.5,确实可以下降。

内积等于0时,没有得到严格下降方向;后面用它建立停止条件。原页“保证下降”应按这个严格负的条件理解。

对应课堂录音Week10 Part01 00:36:06–00:41:40Week10 Part01 00:41:40–00:42:38Week10 Part01 00:44:22–00:51:11
原第 26 页

沿两个可行点的连线走,新点仍可行

原课件第26页
点击原页可打开 PDF。

更新式为 xk+1=xk+αk(yk−xk)=(1−αk)xk+αkyk.

当 0≤αk≤1 时,两个系数非负且和为 1,这叫凸组合。因为 Ω 是凸集,而两个端点都在其中,所以整条线段也在其中。

  1. α=0:留在当前点。
  2. α=1:直接到 LP 子问题的解 yk。
  3. α=0.5:走到两点正中间。

沿上页例子,(0.5,0.5)+0.5(−0.5,0.5)=(0.25,0.75),仍然两个分量非负且总和为 1。若步长大于 1,就可能越过端点而违反限制,因此这里线搜索的范围要限制在 [0,1]。

这里的 [0,1] 是统一保证可行的步长范围。以区间 [−1,1]、当前点−1、LP解1为例,α=1.2 会得到 −1+1.2(1−(−1))=1.4,已经越界。它解释了为什么不能把无约束线搜索的任意正步长直接搬过来。

对应课堂录音Week10 Part01 00:51:13–01:00:26Week10 Part01 01:00:28–01:02:42Week10 Part01 01:04:54–01:08:43Week10 Part01 01:36:50–01:40:51
原第 27 页

Frank–Wolfe 还剩两个选择

原课件第27页
点击原页可打开 PDF。

现在已经有了算法骨架:可行起点 → 求梯度 → 解一个线性子问题 → 沿可行线段移动。但还要明确两件事:

  1. 步长怎么选?可以随迭代逐渐减小,也可以在当前线段上做一维搜索。步长越大并不自动越好,线性子问题的最优点未必也是原非线性目标的最优点。
  2. 什么时候停?不能照搬无约束的“梯度等于零”,因为最优点可能位于边界,梯度仍非零。需要检查是否还有可行下降方向。

例如最小化 f(x)=x,约束 x≥0,最优点为 0,但导数一直是 1。向左虽能下降,却不允许走。因此约束最优性的关键是:在允许走的方向里,是否还能下降。

对应课堂录音Week10 Part01 01:04:54–01:08:43
原第 28 页

约束凸问题的最优性:所有可行方向都不再下降

原课件第28页
点击原页可打开 PDF。

这个内积条件也叫变分不等式形式。当 f 可微且凸、Ω 为凸集时,它恰好刻画全局最优点:

∇f(x*)T(x−x*)≥0,∀x∈Ω.
  1. x−x* 表示从最优点指向任意可行点的方向。
  2. 如果其中某个内积为负,就能沿那条可行线段走一小步并下降,与最优矛盾。
  3. 反过来,凸函数下界为 f(x)≥f(x*)+∇f(x*)T(x−x*)。若内积全部非负,就有 f(x)≥f(x*),因此全局最优。

图里 x* 位于多边形顶点。能让一阶目标下降的方向朝着可行域外,留在可行域内的方向都无法改善目标。原页标题虽写“Projected Gradient Descent”,这一页的条件同时用于下面的 Frank–Wolfe 停止准则。内积等于零属于边界情况,不能单凭它称为严格下降。

对应课堂录音Week10 Part01 01:08:46–01:10:20Week10 Part01 01:12:41–01:17:19
原第 29 页

Frank–Wolfe gap:能计算的停止指标

原课件第29页
点击原页可打开 PDF。

定义 gapk=−∇f(xk)T(yk−xk)=∇f(xk)T(xk−yk). 因为 yk 是线性子问题的最优解,所以 gapk≥0。

  1. 若 gap 为零,就有 ∇f(xk)Tyk=∇f(xk)Txk。
  2. 而任意可行 x 都满足 ∇f(xk)Tx≥∇f(xk)Tyk。
  3. 合起来得到 ∇f(xk)T(x−xk)≥0,正是上一页的最优性条件。

凸目标下,gap 还能给出目标误差上界:设 x* 最优,凸性给出 f(xk)−f(x*)≤∇f(xk)T(xk−x*);线性子问题给 ∇f(xk)Tyk≤∇f(xk)Tx*。 移项时把两边乘 −1,再都加上 ∇f(xk)Txk。连起来得到 0≤f(xk)−f(x*)≤∇f(xk)T(xk−x*)≤∇f(xk)T(xk−yk)=gapk.

因此可以在 gapk<ε 时停止。它既考虑目标坡度,也考虑可行方向,比直接看梯度范数更适合这里的约束问题。

例如取 ε=0.001,对于这里的凸目标,gapk<0.001 表示当前目标值比最优值高不到0.001。这个容差由需要的精度决定;gap不是“本轮流量变化有多小”,也不是原始梯度的长度。

对应课堂录音Week10 Part01 01:18:53–01:24:56
原第 30 页

把 Frank–Wolfe 拼成完整算法

原课件第30页
点击原页可打开 PDF。
  1. 选择可行起点 x0∈Ω。
  2. 第 k 轮计算梯度 vk=∇f(xk)。
  3. 求 LP:yk∈argminy∈ΩvkTy。
  4. 令 dk=yk−xk,算 gapk=−vkTdk。
  5. 若 gap 小于容差,退出;否则选 0<αk≤1,更新 xk+1=xk+αkdk。

完整算一轮:令 f(x)=(x1−0.25)2+(x2−0.75)2,约束 x≥0,x1+x2=1,起点 (0.5,0.5)。梯度为 (0.5,−0.5),LP 解为 (0,1),方向为 (−0.5,0.5),gap 为 0.5。

选步长 0.5,更新到 (0.25,0.75),目标从 0.125 降到零。下一轮梯度和 gap 都为零,停止。这个例子把“求方向、算 gap、选步长、更新”四步连起来了。

对应课堂录音Week10 Part01 01:40:51–01:41:43Week10 Part01 01:48:02–01:51:24
原第 31 页

Frank–Wolfe 的两种步长

原课件第31页
点击原页可打开 PDF。

课件给出两种策略:

  1. 递减步长:αk=1/(k+2)。从 k=0 开始,步长依次为 1/2、1/3、1/4、…,逐渐减小。计算便宜,不需要额外搜索。
  2. 精确线搜索:求 αk∈argmin0≤α≤1f(xk+αdk)。只在线段内寻找,保证新点仍可行。
from scipy.optimize import minimize_scalar
result = minimize_scalar(lambda alpha: f(x + alpha*d),
                         bounds=(0, 1), method='bounded')
alpha = result.x
x = x + alpha*d

递减步长不一定让每一轮目标或 gap 都单调下降;精确线搜索会在当前线段上选较好的位置,但每轮要多算几次目标。比较时应使用相同起点和同一个停止指标,并把总耗时也记下来。

为什么固定0.01还可能振荡?Frank–Wolfe乘步长的是“当前点到所选顶点”的向量d。接近均衡时,顶点仍可能很远;若每次还按固定比例走,实际位移未必缩到零。课堂把0.01改成0.001后,gap仍会先下降,再进入平台或波动。

递减也不是越快越好。1/(k+2) 从1/2、1/3逐渐缩小;若改成 1/(k+2)2,后面的步子很快接近零,剩下的总移动量可能不够。在同一交通例子中,从均分起点跑10000轮,平方分母的版本仍约为 (5.42661,2.90656,1.66683),gap约32.22,离均衡还很远。

这与普通梯度下降的固定学习率要区分:梯度下降的实际位移是“学习率×梯度”;梯度变小时,固定学习率也能产生越来越小的位移。

对应课堂录音Week10 Part01 01:18:53–01:24:56Week10 Part01 01:24:56–01:27:50Week10 Part01 01:52:59–02:06:17Week10 Part01 02:06:18–02:09:03Week10 Part01 02:11:02–02:16:03
原第 32 页

交通均衡:每条路的耗时随流量增加

原课件第32页
点击原页可打开 PDF。

共有 q=10 单位出行流量从 Home 到 Work,三条路并联。xi 为路线 i 的流量,所以 x1+x2+x3=10、xi≥0。这里把流量当连续量处理。

c1(x1)=4+x12,c2(x2)=25+x22,c3(x3)=50+x32.
  1. 常数 4、25、50 是各路没有拥堵时的基础耗时。
  2. 平方项表示拥堵:流量越大,走这条路越慢。
  3. 均衡时,实际有人使用的路线,耗时都等于最小可用耗时;更慢的路线没有人使用。

例如先把全部流量放到路线 1,耗时为 (104,25,50),路线 2 明显更快,分配还不是均衡。均衡不是让每条路流量相等,而是让已使用的路线没有更便宜的替代选择。

对应课堂录音Week10 Part01 01:24:56–01:27:50Week10 Part01 01:36:50–01:40:51Week10 Part01 01:40:51–01:41:43Week10 Part01 01:48:02–01:51:24
原第 33 页

交通势函数:积分后为什么能求均衡

原课件第33页
点击原页可打开 PDF。

先把成本积分,得到交通势函数:

f(x)=∑i=13∫0xici(v)dv=4x1+25x2+50x3+x13+x23+x333.

以第 2 路为例,∫0x2(25+v2)dv=[25v+v3/3]0x2=25x2+x23/3。第 1、3 路只换掉常数。对第i项求导,得到 ∂f/∂xi=ci(xi)。因此梯度的三个分量,恰好是当前三条路线的耗时。原页展开式的三次项系数应全部为1/3,老师代码使用的也是这个积分结果。

为什么这个 LP 不需要通用求解器

当前流量 xk 一旦固定,ci(xik) 就是三个固定数字。子问题为:

miny∑ici(xik)yi,yi≥0,y1+y2+y3=10.

用课堂的示意系数20、25、15算:目标 20y1+25y2+15y3=15×10+5y1+10y2≥150。取 y1=y2=0,y3=10 就达到150,所以全部放在第三条路最好。20、25、15只是演示线性子问题的数字;实际每轮使用当前成本计算出的系数。

代码于是只需先建零向量,再执行 y[np.argmin(c)] = 10。若最低成本并列,任选一条最低成本路线,也能得到一个最优顶点解。

“全有全无”与真实更新的区别

把子问题中的全部需求分给当前最快路线,叫全有全无分配。真正更新为 xk+1=(1−α)xk+αyk:保留一部分旧流量,只让一部分向最快路线调整。可行域中的连续分流,由这些顶点分配的组合逐渐形成。

把最终均衡手算出来

  1. 先假设第三条路没人用。前两条都有流量,均衡要求 x1+x2=10、4+x12=25+x22。
  2. 后一式为 (x1−x2)(x1+x2)=21。代入总量10,得 x1−x2=2.1。
  3. 两式相加、相减,得到 x=(6.05,3.95,0)。
  4. 前两条耗时均为40.6025,第三条空着时仍需50,确实更慢,所以假设成立。势函数约217.30833。

势函数用来刻画均衡,通常不等于总出行时间 ∑ixici(xi)。

对应课堂录音Week10 Part01 01:24:56–01:27:50Week10 Part01 01:36:50–01:40:51
原第 34 页

读 Frank–Wolfe 的 gap 收敛图

原课件第34页
点击原页可打开 PDF。

图里比较递减步长与精确线搜索。横轴为迭代次数,纵轴为Frank–Wolfe gap,使用对数刻度。

  1. 开始都降得快:明显不合理的分流先被修正。
  2. 递减步长曲线随后有密集波动:当前最快路线不断切换,LP选择的顶点也跟着切换。
  3. 线搜索曲线较平滑,但后期也很慢。课堂演示约10000轮后,gap仍在 10−2 量级。

比较时还要算每轮花多少工作。递减步长只算一次 1/(k+2);精确线搜索还要多次计算目标,解一个一维问题。因此外层迭代数差不多时,线搜索可能花更多CPU时间。

这也解释本方法的取舍:每轮LP有时很便宜,特别是本例只需找最小成本的路线;但便宜的一轮可能要重复很多次。应同时看gap、迭代次数和总运行时间。

另附的 三种步长练习程序 会从同一个起点分别重跑递减、线搜索、回溯三种策略,便于公平比较。

对应课堂录音Week10 Part01 02:11:02–02:16:03
原第 35 页

投影梯度:先走一步,再拉回可行域

原课件第35页
点击原页可打开 PDF。

普通梯度下降先算 yk=xk−αk∇f(xk)。但 yk 可能落在蓝色可行域 Ω 外面。投影梯度下降 PGD 再找 Ω 中离它最近的点,把它拉回去。

  1. 先按负梯度方向走,使用目标函数的下降信息。
  2. 再做投影,修复违反的约束。
  3. 投影后的点作为下一轮位置。

一维例子:min(x+1)2,约束 x≥0,当前 x=0.5。导数为 2(x+1)=3,步长 0.5 时,未经投影的新点为 0.5−0.5×3=−1。离 −1 最近的非负点是 0,所以投影后取 xk+1=0。它正是约束最优点,尽管该点导数为 2 而不为零。

动手试 · 同一起点走一步,比较两种方法

在可行三角形内最小化到目标点 (0.8, 0.8) 的平方距离的一半。从 (0.2, 0.3) 出发,把步长调到 1。

对应课堂录音Week10 Part01 02:11:02–02:16:03Week10 Part01 02:16:03–02:21:00
原第 36 页

投影本身也是一个优化问题

原课件第36页
点击原页可打开 PDF。

投影写成 xk+1=ΠΩ(yk)=argminx∈Ω‖x−yk‖22,yk=xk−αk∇f(xk).

平方距离等于 (x−yk)T(x−yk),对 x 是凸二次函数,所以当 Ω 由线性限制构成时,投影就是凸 QP。

  1. 若约束只是 li≤xi≤ui,逐分量截断即可:xi=min(ui,max(li,yi))。
  2. 若还要求非负且总和为 q,投影具有形式 xi=max(yi−τ,0),其中 τ 调到使 ∑ixi=q。
  3. 例如 y=(4.8,−1.25,−2.5)、总和要求 10,三项都可保持为正,故 τ=(4.8−1.25−2.5−10)/3=−2.983333,得到 x≈(7.783333,1.733333,0.483333),三项非负且和为 10。

PGD 每轮解的是“最近点”子问题;Frank–Wolfe 每轮解的是“线性目标最低点”子问题。二者都利用可行域结构,但目标和结果不同。

课堂实现把梯度步得到的点叫y,再建立一个新的决策变量z来做投影。z与y长度相同;cp.sum_squares(z-y) 就是距离平方。最小化距离和最小化距离平方,选出的最近点相同,因为平方在非负距离上保持大小顺序。

这一步的目标很简单,即使原来的f含指数或其他复杂非线性,投影仍只处理“离y最近”这个二次目标。代价是每轮需要一个QP,而Frank–Wolfe每轮需要一个LP。

从 KKT 推出投影为什么要减同一个数

把目标写成 12‖x−y‖2。对总量约束 ∑ixi=q 用乘子 τ,对各个 −xi≤0 用乘子 μi≥0。第 i 个驻点式为 xi−yi+τ−μi=0。

若 xi>0,互补条件给 μi=0,于是 xi=yi−τ>0。若 xi=0,驻点式给 μi=τ−yi≥0,所以 yi−τ≤0。合并两种情况就是 xi=max(yi−τ,0),最后用总量确定 τ。

对应课堂录音Week10 Part01 02:16:03–02:21:00Week10 Part01 02:21:00–02:23:34Week10 Part01 02:30:31–02:34:11
原第 37 页

用 PGD 求同一交通均衡

原课件第37页
点击原页可打开 PDF。

仍用 f(x)=4x1+25x2+50x3+∑ixi3/3,所以梯度为 c(x)=(4,25,50)+x2。下面完整算一次梯度步和CVXPY投影:

import numpy as np
import cvxpy as cp
x = np.array([10., 0., 0.])
alpha = 0.05
c = np.array([4., 25., 50.]) + x**2
y = x - alpha*c
z = cp.Variable(3)
projection = cp.Problem(
    cp.Minimize(cp.sum_squares(z-y)),
    [z >= 0, cp.sum(z) == 10]
)
projection.solve()
x = z.value
print(x)
  1. x 是当前可行流量;先取 (10,0,0),三项非负且和为10。
  2. c 为当前梯度,算得 (104,25,50)。
  3. y=x-alpha*c 得到 (4.8,−1.25,−2.5),它还不是合法流量。
  4. z=cp.Variable(3) 是待求的投影流量。非负限制和总量限制必须同时写。
  5. sum_squares 把三个坐标差分别平方后相加;求解器寻找满足约束、且这个和最小的z。
  6. z.value 读取解向量,结果约 (7.783333,1.733333,0.483333)。重新赋给x,下一轮再算新的c。

不能只把y的负数裁成零,那会得到 (4.8,0,0),总流量只剩4.8。投影要同时保住非负与总量10。

重复这个更新,流量会接近 (6.05,3.95,0)。原页展开势函数沿用了第33页的系数笔误,计算时使用正确积分式。

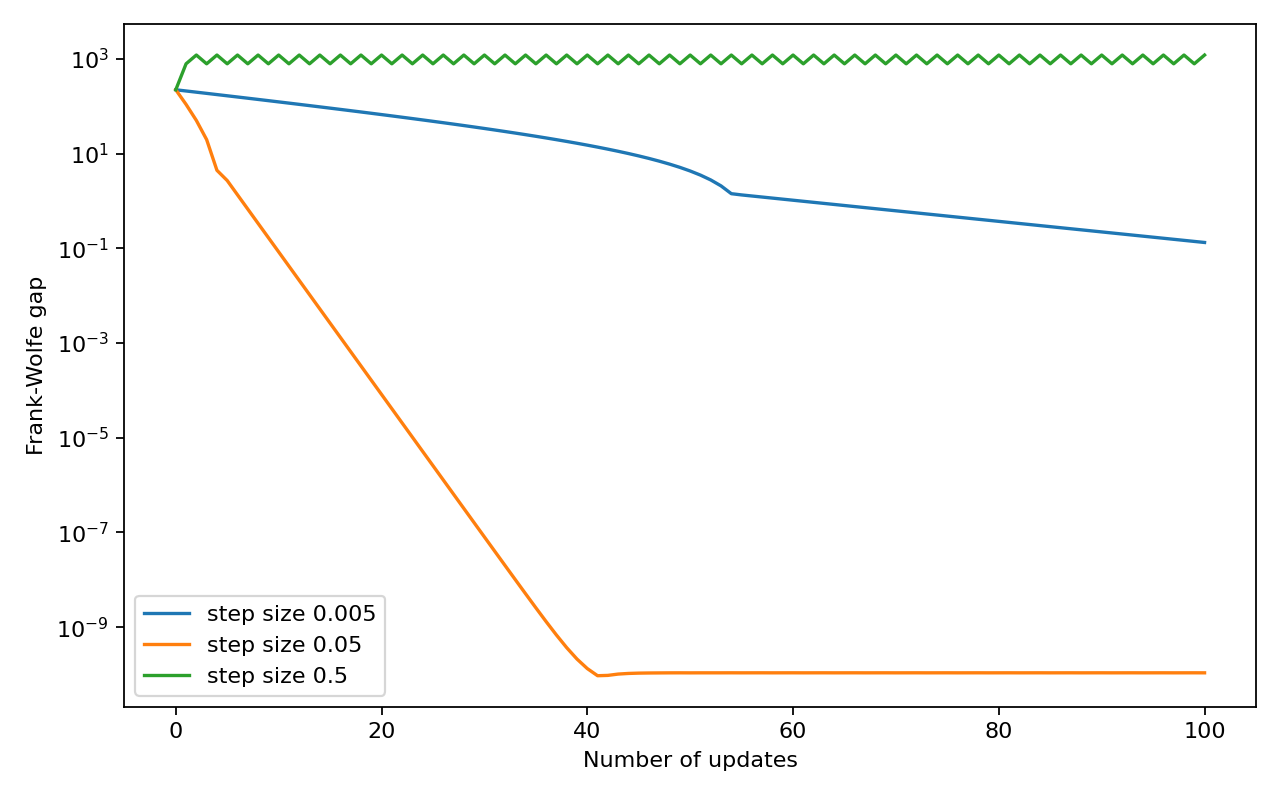
打开可运行的三种步长程序:它从均分起点分别跑0.005、0.05、0.5,每轮都解上述投影QP,并把比较图保存到“运行结果”。

对应课堂录音Week10 Part01 02:21:00–02:23:34Week10 Part01 02:30:31–02:34:11
原第 38 页

PGD 的步长过大,会在边界之间来回跳

原课件第38页
点击原页可打开 PDF。

图中比较步长 0.005、0.05、0.5。横轴为迭代次数,纵向为对数刻度;原图未标纵轴指标名,这里主要比较下降速度与振荡。蓝线对应 0.005,缓慢改善;橙线对应 0.05,约 50 次降到很小;绿线对应 0.5,持续振荡。

过大步长为何会振荡,可以从交通例子直接算出:

  1. 在 (10,0,0),梯度为 (104,25,50)。步长 0.5 先走到 (−42,−12.5,−25),投影后变成 (0,10,0)。
  2. 在 (0,10,0),梯度变成 (4,125,50),先走到 (−2,−52.5,−25),投影后又回到 (10,0,0)。
  3. 于是两个极端分配交替出现,无法接近中间的均衡流量。

投影保证每轮满足约束,但不自动保证每轮接近最优。选好步长依旧重要。由于最优点在边界,正确停止信号可用 ‖x−ΠΩ(x−α∇f(x))‖,而不能要求原目标梯度本身趋于零。

复现结果:另附程序从相同均分流量出发,各更新100次,并统一用Frank–Wolfe gap衡量约束最优性:

固定步长100次后的流量gap
0.005约(6.048316,3.951684,0)约0.13309
0.05约(6.05,3.95,0)约 1.1×10⁻¹⁰
0.5在(10,0,0)与(0,10,0)之间振荡约790与1210交替

这张 复现图 的纵轴明确标成gap,便于与Frank–Wolfe比较。步长0.05接近解后,投影后的实际位移会趋近零;固定步长本身并不意味着每次移动同样远。

对应课堂录音Week10 Part01 02:30:31–02:34:11
原第 39 页

一般非线性规划:约束也开始弯曲

原课件第39页
点击原页可打开 PDF。

前面目标可以非线性,但 Ω 始终由线性限制构成。现在进一步允许 gi(x) 和 hj(x) 非线性,例如 x12+x22≤1 或 x1x2=1。

这时可行边界可能弯曲,甚至由不连通的区域组成。原来的线性子问题不再直接保留所有真实约束,投影本身也可能变得更难求。

SQP 的思路是把困难问题拆成一串较简单的局部问题:目标用二次近似,约束用一次近似,每轮求一个 QP,再更新近似位置。它把前面学过的泰勒展开、线性化和二次规划结合起来。

对应课堂录音Week10 Part01 02:34:13–02:39:04
原第 40 页

SQP:二次近似目标,一次近似约束

原课件第40页
点击原页可打开 PDF。

在当前点 xk 附近,用位移 d=x−xk 表示候选新点。课件的演示子问题应写为:

mind f(xk)+∇f(xk)Td+12dT∇2f(xk)d, gi(xk)+∇gi(xk)Td≤0,hj(xk)+∇hj(xk)Td=0.
  1. 目标保留到二阶,得到关于 d 的二次函数。常数 f(xk) 不影响解,可以去掉。
  2. 约束保留到一阶,所以子问题中的限制对 d 线性。
  3. 求解这个 QP,得到位移 dk,先形成候选点 xk+dk,再在新点重建近似。

原页二阶项缺少 1/2,按泰勒展开应补上。这里演示使用目标 Hessian;标准 SQP 通常使用拉格朗日函数 Hessian 或其近似,把约束曲率也计入,并配合步长控制。

把本讲三种近似连起来:Frank–Wolfe用一次目标近似、保留原线性约束;SQP用二次目标近似、一次约束近似。每轮移动到新点后,近似都要重新计算,不能把第一轮的近似一直用到底。

对应课堂录音Week10 Part01 02:34:13–02:39:04
原第 41 页

先把课件公式与代码的目标统一

原课件第41页
点击原页可打开 PDF。

课堂口述与本页数学框写 x14+x22,但 SciPy 与 CVXPY 两段代码都写 x14+x24,下一页梯度也按四次方计算。为与代码一致,下面讲 f(x)=x14+x24。

三条约束统一写为 gi(x)≤0:

g1=x12−x1+1−x2,g2=x12−4x1+6−x2,g3=x12−3x1+x2−2.
  1. SciPy 的字典形式 type='ineq' 要求返回值非负,因此传入的是 -g1(x)、-g2(x)、-g3(x)。
  2. CVXPY 直接写 x2≥x12−x1+1、x2≥x12−4x1+6、x2≤−x12+3x1+2,与上式一致。
  3. 使用四次目标求解,结果约为 (1.66666667,2.11111111)=(5/3,19/9),目标约 27.57902759。
  4. 代回三约束,得到约 (0,0,−2.11111111),前两条活跃,第三条有余量。

如果按标题改用 x14+x22,最优点会变为约 (1.24626617,2.56811469),最优值约 9.00757919。两组结果属于两个不同目标,比较求解器时必须先统一目标。

对应课堂录音Week10 Part01 02:34:13–02:39:04
原第 42 页

逐项计算 SQP 子问题所需的导数

原课件第42页
点击原页可打开 PDF。

对代码采用的四次目标,有

∇f=[4x134x23],∇2f=[12x120012x22].

三条约束梯度分别为 ∇g1=(2x1−1,−1)T、∇g2=(2x1−4,−1)T、∇g3=(2x1−3,1)T。每轮代码依次做以下工作:

  1. 在当前 x 计算目标梯度、Hessian、各约束值和各约束梯度,并保存它们。
  2. 建立关于位移的目标 0.5*d.T @ H @ d + grad @ d。这里变量是 d,不是原参数 x。
  3. 每条线性化约束 gi+∇giTd≤0,在 SciPy 中写成 -g_i-grad_gi @ d >= 0。
  4. 求出位移,再执行 x = x + d。位移很小时停止,是本页的简化判断。

例如从 x=(0,0) 开始,目标梯度和 Hessian 都为零,三条线性化限制为 1−d1−d2≤0、6−4d1−d2≤0、−2−3d1+d2≤0。此时首个二次模型退化为常数目标,所以实用算法还需更完整的曲率与步长处理。

取一个容易手算的起点,算出第一轮

取 x0=(1.5,2.5),目标梯度为 (13.5,62.5),Hessian为 diag(27,75),三个约束值为 (−0.75,−0.25,−1.75)。于是这一轮QP为:

mind 12(27d12+75d22)+13.5d1+62.5d2, −0.75+2d1−d2≤0,−0.25−d1−d2≤0,−1.75+d2≤0.

该QP最优点的前两条约束取等号。解 2d1−d2=0.75、d1+d2=−0.25,得 d=(1/6,−5/12)。第三条有余量,所以 λ3=0。把 d 代入 QP 的目标梯度,得 (27d1+13.5,75d2+62.5)=(18,125/4)。 加上约束梯度 λ1(2,−1)+λ2(−1,−1) 并令和为零, 得 18+2λ1−λ2=0, 125/4−λ1−λ2=0。 用 λ2=18+2λ1 消去,得到 λ1=53/12, λ2=161/6。两个乘子非负,驻点和互补都成立,因此该可行位移就是凸 QP 的最优解。

更新得到 x1=(5/3,25/12)≈(1.666667,2.083333)。把它代回原始约束,前两项均为 1/36>0。它满足的是线性化约束,暂时没有满足原弯曲约束。

对应课堂录音Week10 Part01 02:34:13–02:39:04Week10 Part01 02:39:35–02:43:03
原第 43 页

为什么直接走完一个 SQP 位移还不够稳

原课件第43页
点击原页可打开 PDF。

上一页已经给出一个具体原因:满足近似约束,不等于满足原约束。从 (1.5,2.5) 出发,第一轮得到 (5/3,25/12),前两条原始约束违反量都是 1/36。

  1. 第一轮的目标约26.554,甚至低于真正约束最优值27.579。原因是那个点不可行,所以不能直接把更小数字当成更好答案。
  2. 在新点重新计算,两条约束值都是 1/36,对 x1 的斜率是 7/3、−2/3,对 x2 都是 −1。下一轮两条仍取等号,即 1/36+(7/3)d1−d2=0 与 1/36−(2/3)d1−d2=0。 相减得 3d1=0,代回得 d2=1/36。得到 x2=(5/3,19/9),前两条原约束恢复为0,第三条约为−2.111。
  3. 现在目标约27.579,与第41页求解器结果一致。目标比上轮升高,是在修复不可行性。

这两轮说明“每轮重建局部模型”的作用。其他非线性问题中,还可能遇到奇异或不定Hessian、不可行子问题、全步过大等情况,实用SQP会加入曲率处理和步长接受准则,兼顾目标与约束违反程度。

二阶目标的系数仍应为 12dTHd。本页打印式漏了1/2,代码中的0.5是正确的。

对应课堂录音Week10 Part01 02:39:35–02:43:03
原第 44 页

SLSQP:把实用约束求解器接到模型上

原课件第44页
点击原页可打开 PDF。

最后介绍 SLSQP,即 Sequential Least Squares Programming。使用 SciPy 时可以显式选择这个方法:

from scipy.optimize import minimize

def f(x):
    return x[0]**4 + x[1]**4

def g1(x):
    return x[0]**2 - x[0] + 1 - x[1]

def g2(x):
    return x[0]**2 - 4*x[0] + 6 - x[1]

def g3(x):
    return x[0]**2 - 3*x[0] + x[1] - 2


cons = [{'type': 'ineq', 'fun': lambda x: -g1(x)},
        {'type': 'ineq', 'fun': lambda x: -g2(x)},
        {'type': 'ineq', 'fun': lambda x: -g3(x)}]
res = minimize(f, x0=[1.5, 2.5], method='SLSQP',
               constraints=cons,
               options={'ftol': 1e-10, 'maxiter': 1000})
print(res.success, res.message)
print(res.x, res.fun)
print([g1(res.x), g2(res.x), g3(res.x)])
  1. f,g1,g2,g3 在开头分别定义四次目标和三条原始约束。x0 是初始猜测,不是变量下界。
  2. 不等式函数取负号,是因为接口要求返回值非负。
  3. ftol 控制求解精度,maxiter 限制最大迭代轮数。
  4. 求解后先确认成功状态,再将数值代回原始约束。对于本页例子,应得到约 (5/3,19/9),并检查原始三个 gi≤0。

本讲的方法选择现在可以连起来:LP/QP 先利用专门结构;线性可行域上可用 Frank–Wolfe 或 PGD;一般光滑非线性约束可考虑 SQP/SLSQP。选择以后,仍要把目标、变量顺序和约束方向写正确。

课堂演示约五轮得到 (1.6667,2.1111),对应的是代码采用的 x14+x24 目标。这里的重点是复杂模型 → 局部简单子问题 → 更新 → 重新近似这条设计思路;SciPy的SLSQP负责更完整的数值实现。
对应课堂录音Week10 Part01 02:39:35–02:43:03