没有找到对应内容,换一个词试试。
原课件第1页 / 26页视觉系统:从图像到机器人能用的信息
这一讲把三种工具连起来:OpenCV处理图像,YOLO检测物体,ROS把视觉结果交给机器人的其他模块。
一张相机照片首先只是像素数字。机器人需要从中提取“这里有杯子”“杯子在画面左侧”等信息,再结合深度和坐标关系决定动作。本讲先解释图像处理工具,再解释检测框,最后介绍模型部署与机器人集成。
原课件第2页 / 26页学习路线:处理、检测、部署、集成
前面几页认识计算机视觉和OpenCV;中间认识YOLO怎样输出物体框、怎样用NMS去重、怎样用IoU比较框;后面解释ONNX如何帮助部署模型,以及视觉信息如何进入ROS。
这些层次不要混淆:OpenCV是工具库,YOLO是目标检测方法的一类,ONNX是模型表示格式,ROS是机器人软件通信与组织框架。它们各做一部分工作,组合后才能形成从相机到动作的系统。
原课件第3页 / 26页计算机视觉究竟在做什么
计算机视觉把数字图像或视频转换成有意义的描述。分类问“图里是什么”;检测问“有哪些物体、在哪里”;分割问“每个像素属于哪一类”;识别或匹配则进一步判断对象身份或对应关系。
例如同一张桌面图:分类可回答“桌面场景”,检测可框出两个杯子,分割可给每个杯子的像素区域。机器人抓取通常不只需要类别,还要位置、深度或姿态。视觉既可用传统图像算法,也可使用机器学习与深度学习。
课堂串讲(11-16 Part01 00:35:36–00:47:20)
课堂从SLAM转到视觉:传感器先取得图像,视觉算法再把像素变成有意义的信息。医学成像、监控、人脸识别是这里提到的应用。
原课件第4页 / 26页OpenCV是一套可调用的视觉工具
OpenCV的全称是Open Source Computer Vision Library。库的意思是已经写好的函数与数据结构,程序可以直接调用,不必从头实现读图、缩放、边缘检测等基础功能。
例如相机获得一帧图像后,可用OpenCV把彩色图转成灰度,再做滤波,最后寻找边缘。底层主要用C++实现,也提供其他语言接口。学习它时重点是每个函数接收什么图像、返回什么结果,以及操作顺序怎样改变后续算法的输入。
课堂串讲(11-16 Part01 00:35:36–00:47:20)
这里介绍的是可供程序调用的视觉与机器学习软件库。读这一页时,把“库提供函数”和“应用程序安排处理流程”分开理解。
原课件第5页 / 26页模块化:按任务组合所需功能
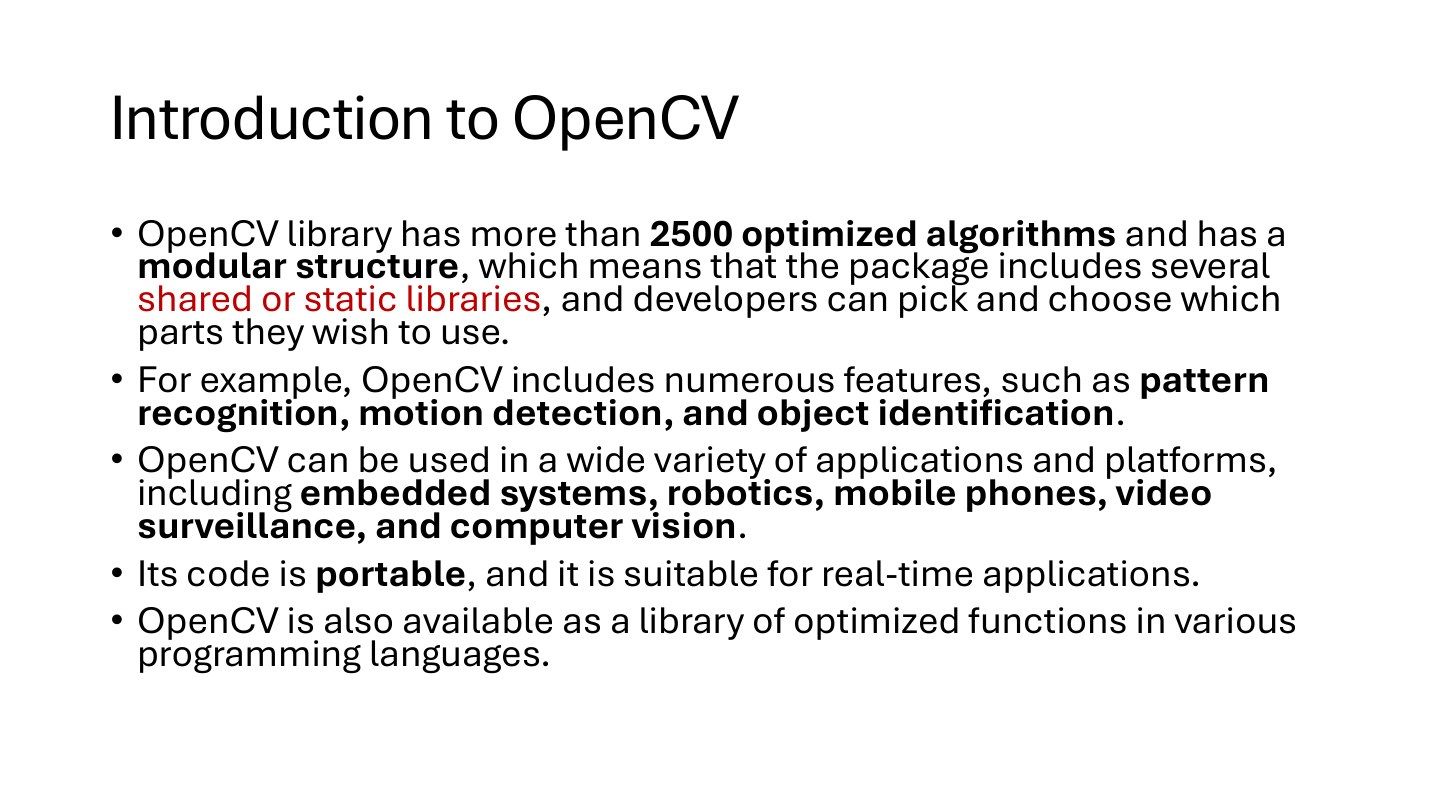
OpenCV包含很多算法,并按功能分成模块。你可以只使用读取图像、图像处理、视频或神经网络推理等需要的部分,不必把所有功能都放进一个程序。
例如识别红色标记的流程是:读相机→转换颜色空间→筛选红色像素→清理小噪点→找轮廓→算中心。每一步都只解决一个小问题。课件提到的算法数量表达库的规模,真正需要掌握的是如何把这些小步骤连成完成任务的处理链。
课堂串讲(11-16 Part01 00:47:22–00:53:32)
课堂用“超过2500个优化算法”和模块化结构说明OpenCV的功能范围。使用时按任务选择组件,重点仍是把所需操作依次连接起来。
原课件第6页 / 26页从基础图像操作到三维信息
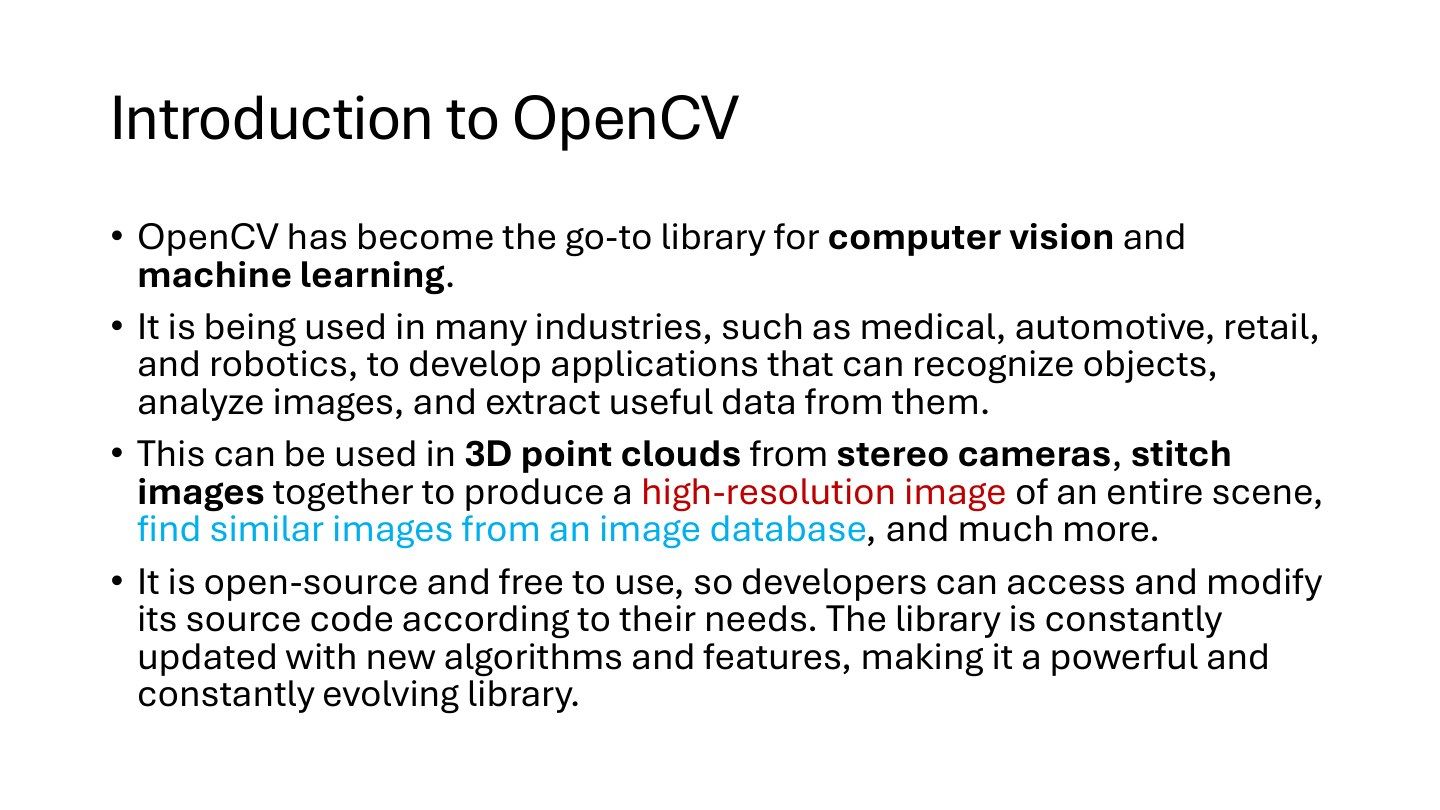
本页列举双目点云、图像拼接和图像检索。双目利用左右相机视差估计深度;拼接通过重叠区域的匹配,把多张图排进同一空间;检索则用图像特征找相似图片。
这里的共同思路是先提取图像中的对应信息,再利用几何或相似度关系。相机看到的二维位置不会自动变成真实三维坐标;双目还需要标定、左右图对应和尺度信息。OpenCV提供实现这些步骤的工具,开发者负责按任务设置输入与参数。
课堂串讲(11-16 Part01 00:47:22–00:53:32)
图像拼接是课堂中的一个例子:把有重叠区域的图像对齐,再合成覆盖更大场景的高分辨率图像。
原课件第7页 / 26页几类常见视觉应用怎样理解
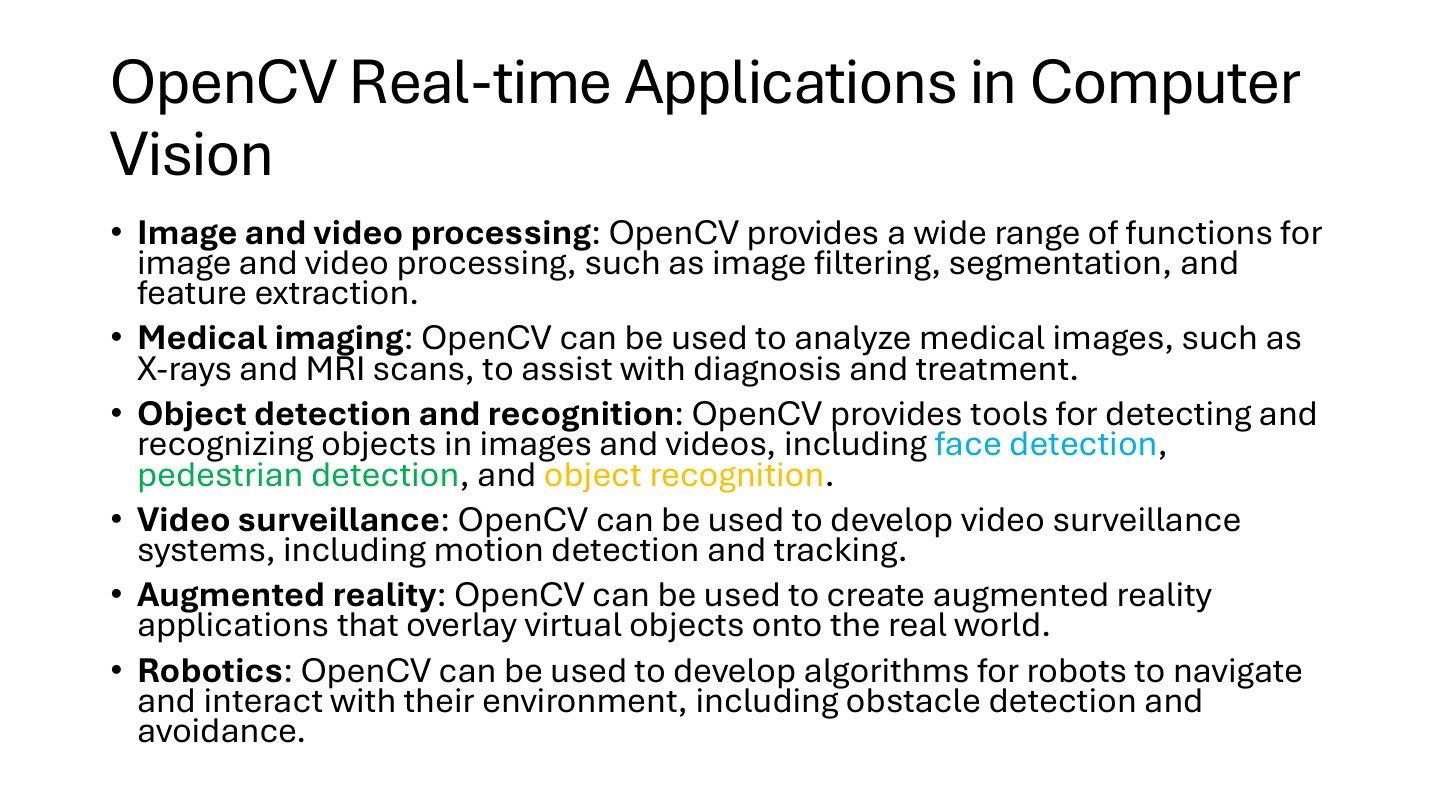
图像与视频处理包括去噪、滤波、分割和特征提取。目标检测寻找人脸、行人或物体;监控还需要把不同帧里的目标关联起来,形成跟踪;增强现实把虚拟图形放到真实画面中的正确位置。
机器人应用可按同样的链条理解:相机拍到环境,算法找障碍或标记,几何模块估计位置,控制模块据此移动。医疗图像等领域也使用图像分析工具,但实际任务还需要相应的数据、算法和评价,基础函数本身不等于完整应用。
课堂串讲(11-16 Part01 00:47:22–00:53:32)
课堂把滤波、分割、特征提取与检测、跟踪、增强现实这些应用联系起来。复习时先说清每一步得到什么,再说明它怎样支持最终任务。
原课件第8页 / 26页自动驾驶、交互与地形感知
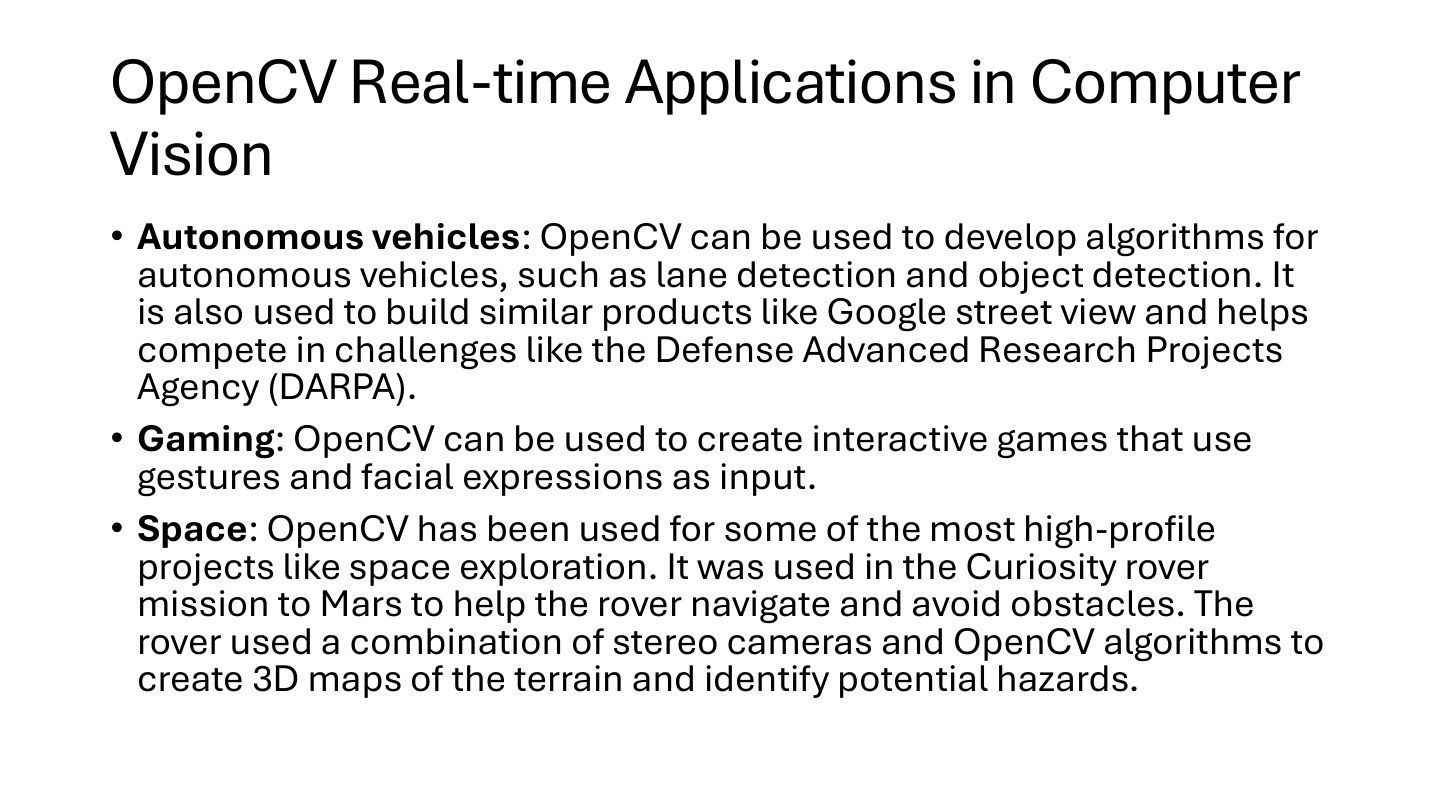
自动驾驶可用视觉找车道、车辆和行人;交互游戏可把手势或面部动作转换成输入;地形探测可用双目图像估计前方地面形状。这些例子说明,同一套图像处理基础能服务不同任务。
以车道检测为例:先选择道路区域,再增强线条特征,检测候选车道边界,最后估计车辆相对车道的位置。对机器人来说,输出应是控制需要的信息,例如横向偏差,而不仅是在窗口里画出一条漂亮的线。
原课件第9页 / 26页基础数据与显示窗口的分工
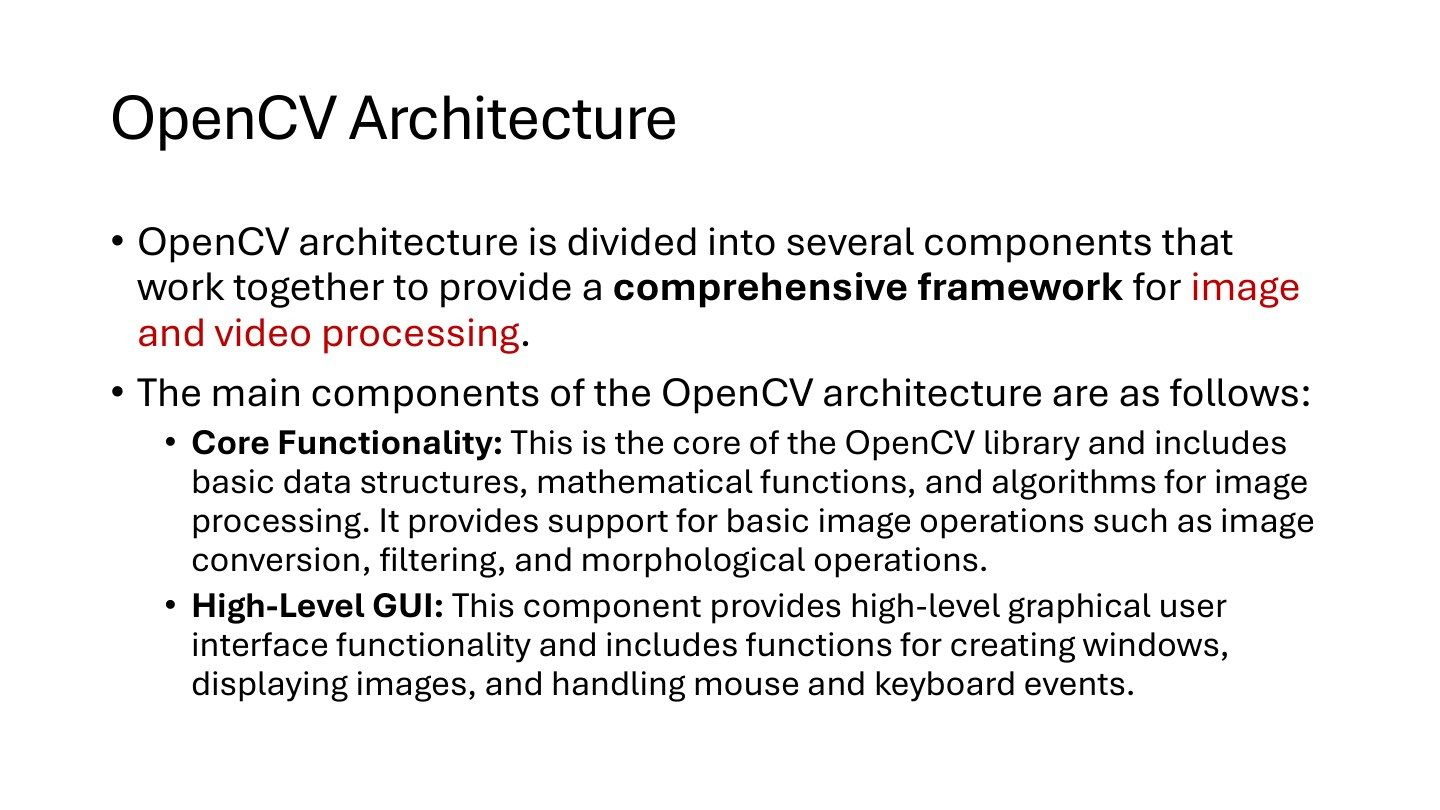
图像通常以矩阵存储:行、列表示像素位置,通道保存颜色信息。核心功能提供矩阵、运算等基础;图像转换、滤波和形态学等具体处理主要由相应图像处理模块提供。
HighGUI负责窗口显示及键盘、鼠标交互。例如处理程序输出一幅边缘图,再由窗口把它显示出来。显示窗口不是算法本身;没有窗口的机器人后台程序仍可以正常处理图像,并通过消息把结果发给其他节点。
回听:11-16 Part01 00:53:32–00:57:58。
原课件第10页 / 26页读视频、处理图像、匹配特征
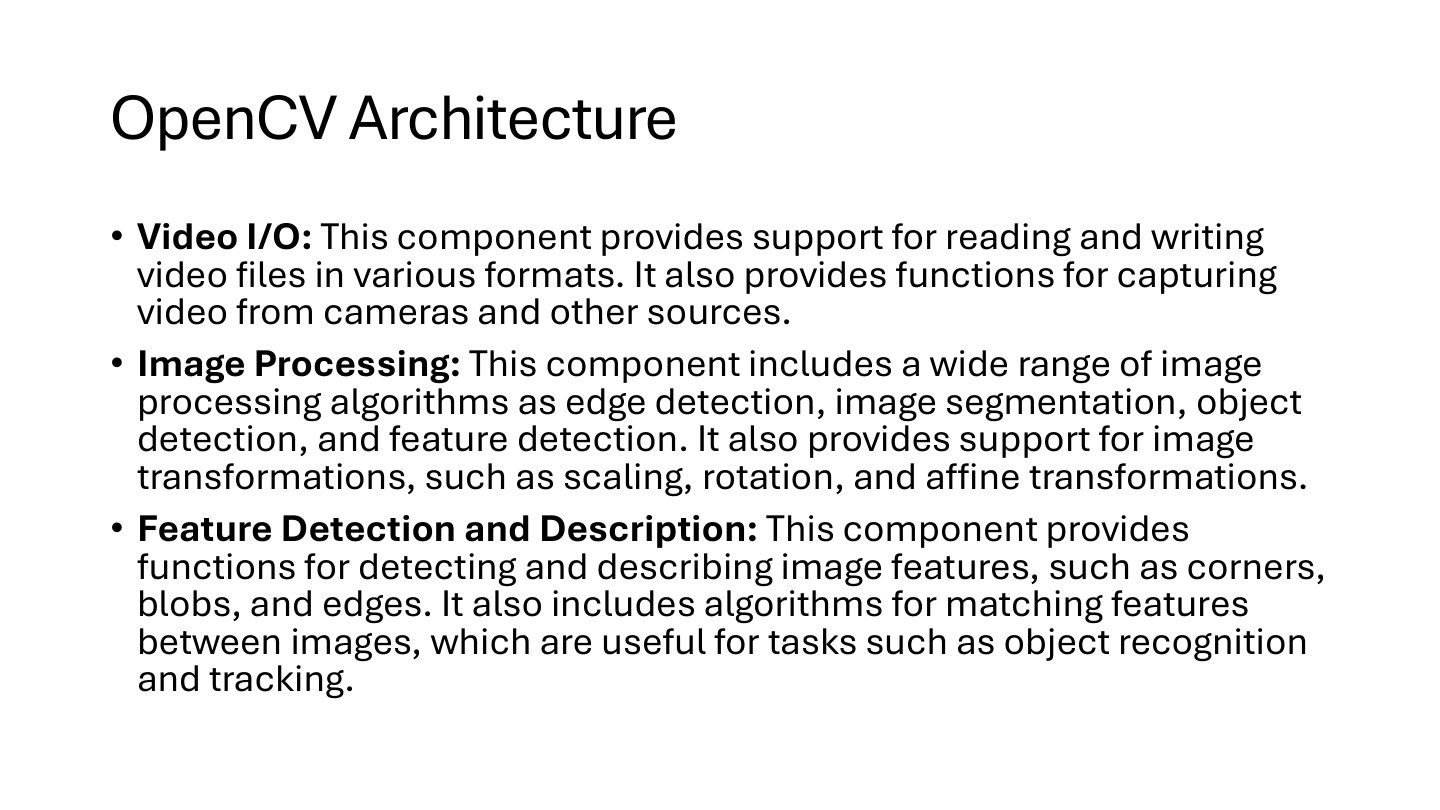
Video I/O负责从相机或文件读帧,以及写视频;图像处理负责滤波、缩放、旋转、边缘与区域提取;特征检测与描述负责寻找容易辨认的局部结构,并用数值向量表示它们。
例:要追踪墙上的标记,先连续读帧,在图中找角点,给角点计算描述子,再与上一帧匹配。匹配回答“当前这个点,是不是上一帧那个点”;结合几何关系,才能估计运动。读不到帧、处理出错、匹配失败是三个不同阶段的问题。
课堂串讲(11-16 Part01 00:53:32–00:57:58)
这一段依次涉及视频读写与采集、边缘检测和缩放、特征检测与描述、图像间的特征匹配。按“取帧→处理→找特征→匹配”的顺序回听。
原课件第11页 / 26页检测、机器学习与几何工具
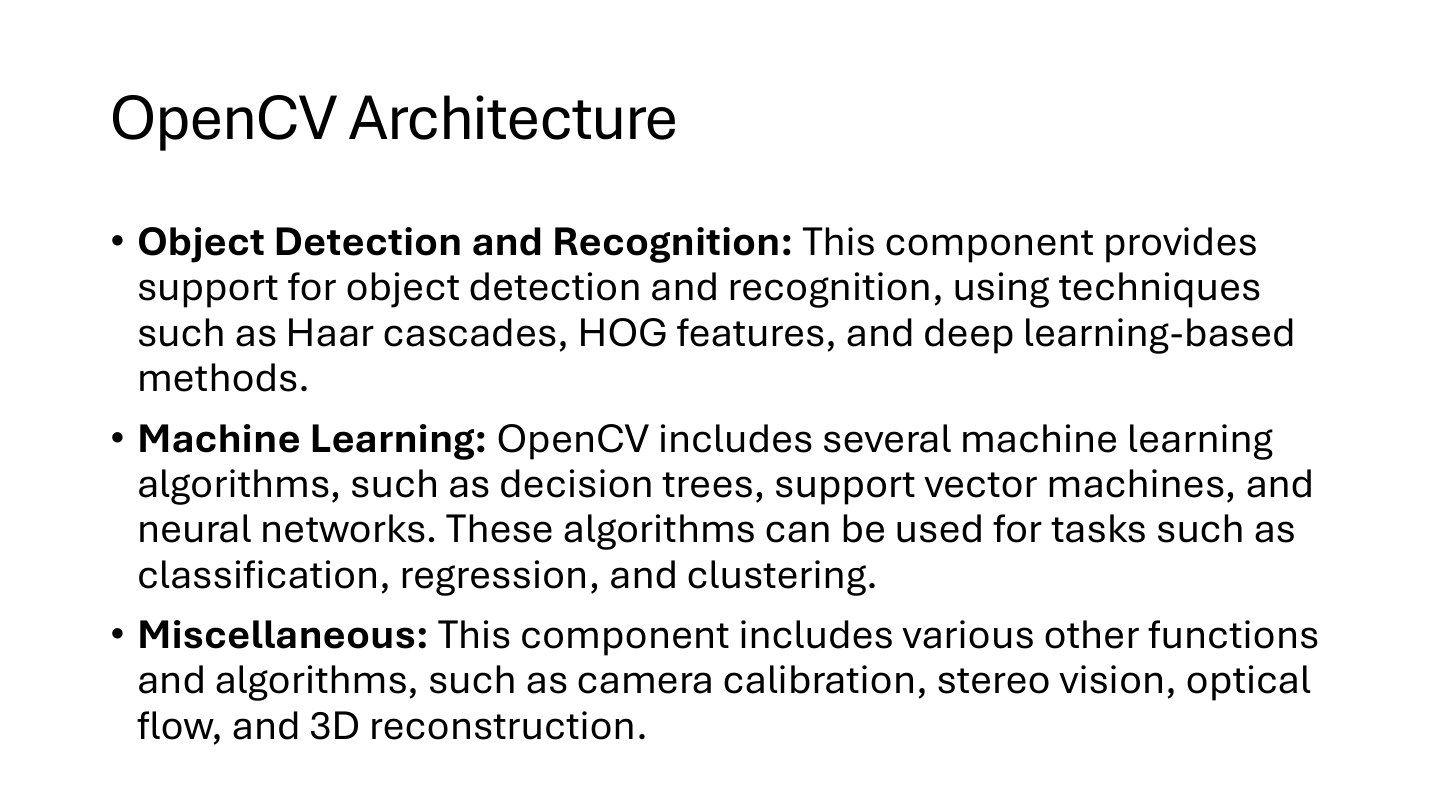
Haar级联和HOG是传统检测例子,深度学习是另一类方法。机器学习模块提供分类、回归或聚类工具;相机标定、双目、光流和三维重建则涉及图像与真实几何之间的关系。
“检测到杯子”与“知道杯子离我多远”属于不同任务。前者可由检测模型输出框和类别,后者还要深度或几何推断。把模块按最终需要的信息组合,比只记算法名称更有用:先写清输入、输出,再决定调用哪些工具。
原课件第12页 / 26页YOLO为什么叫只看一次
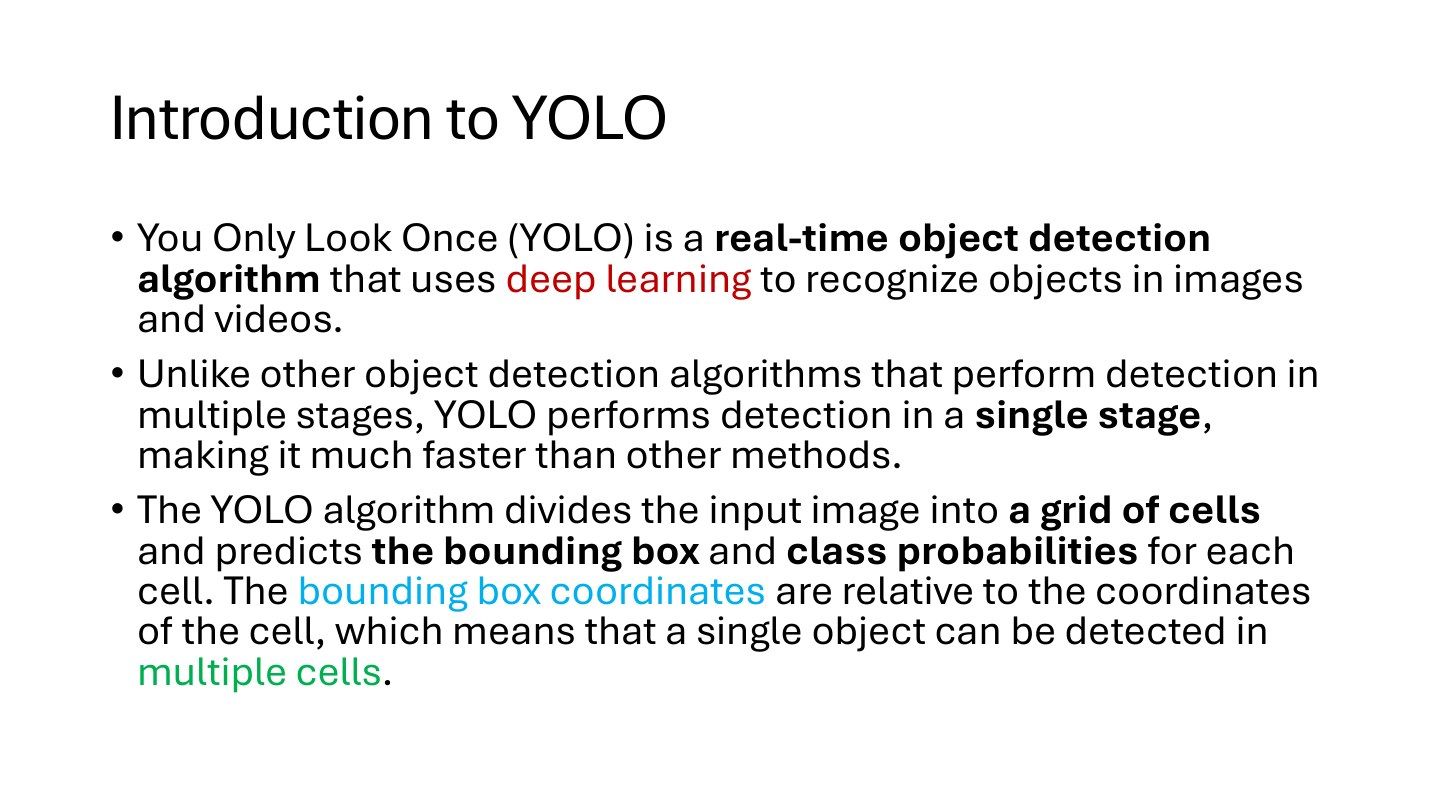
YOLO是You Only Look Once,即一次网络前向计算同时产生图中多个位置的检测预测。早期YOLO用网格组织输出,每个网格位置预测边界框和类别信息,这叫单阶段检测思路。
输入的一张图先经过多层特征计算,再得到许多候选框;后处理按分数和重叠程度筛出结果。因此“一次”说的是一套联合预测过程,而不是只找一个物体。先把数据流记成“图像→网络提取特征→候选框与类别分数→筛选结果”。本讲后面给出早期结构图,Tutorial 7再使用YOLOv8模型演示实际输出。
原课件第13页 / 26页检测框的五个数字怎样读
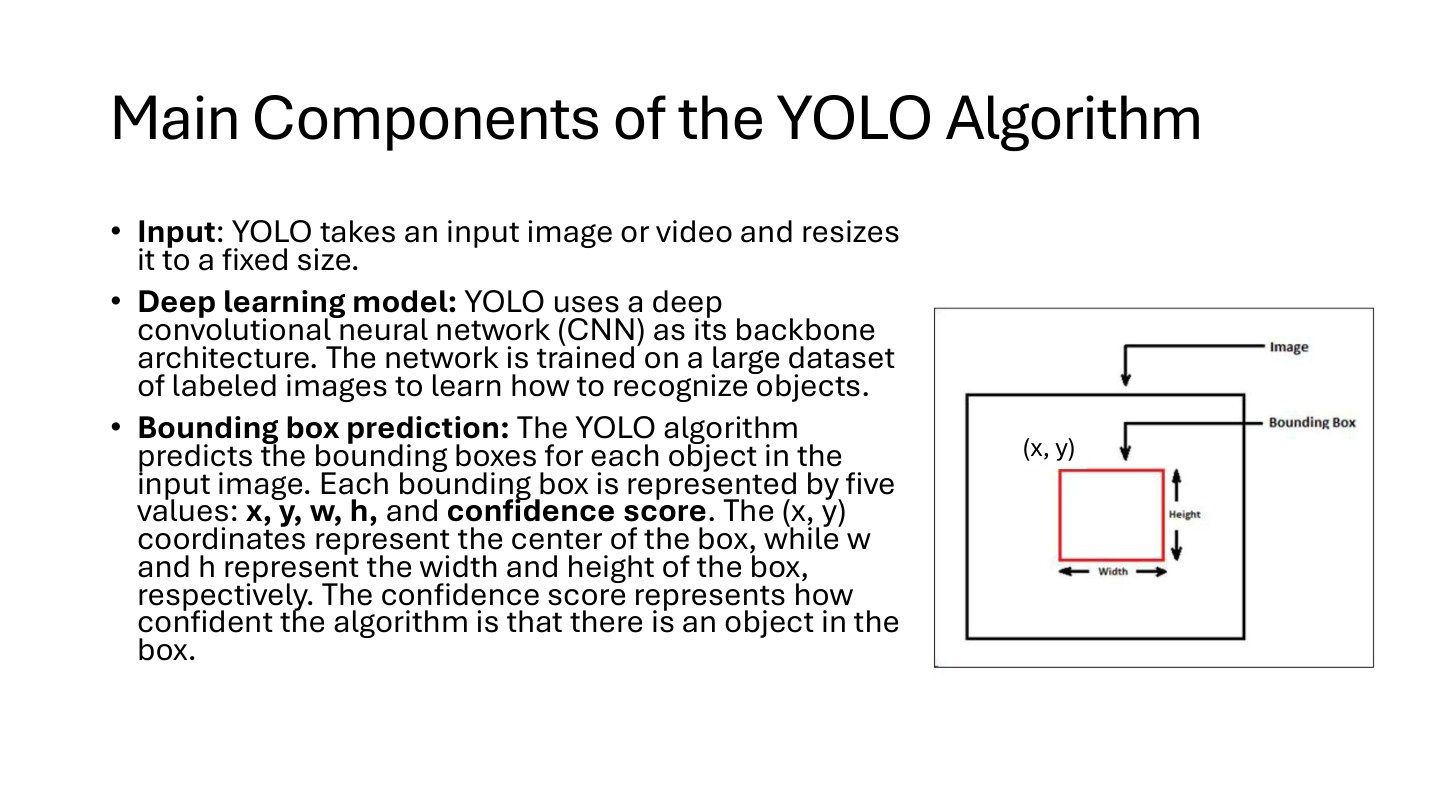
图像通常以左上角为(0,0),x向右增加,y向下增加。课件用(x,y,w,h,confidence)表示候选框:x、y是框中心,w、h是宽高,confidence是检测分数。图中把(x,y)标在角上,但正文定义采用中心坐标。
例:中心(100,80),宽40、高20,单位都为像素。半宽=40/2=20,半高=20/2=10。因此左边=100−20=80,右边=100+20=120;上边=80−10=70,下边=80+10=90。两角为(80,70)、(120,90)。
分数用于筛选候选;统计检测是否正确还要对照类别和标注。图像若先缩放或补边,检测框也必须按相同几何关系变回原图坐标,才能画到物体上。
课堂串讲(11-16 Part01 00:57:58–01:05:23)
课堂把YOLO作为单阶段检测方法,联系速度优势、带标签图像训练和边界框预测来讲。训练阶段用标注学习规律,推理阶段则为新图像输出候选框。
原课件第14页 / 26页NMS去重的完整顺序
同一物体附近可能出现多个高分框。非极大值抑制NMS按以下顺序去重:先按分数从高到低排;取最高分框,放进保留列表;计算它与其他候选框的IoU;删除重叠超过阈值的低分框;再从剩余候选取最高分,重复直到候选为空。
例:A分数0.9、B为0.8、C为0.7,NMS重叠阈值为0.5。先保留A。若A与B的IoU=0.7,则删除B;A与C的IoU=0.1,则C留下。剩余只有C,再保留C,最后输出A、C。
分数用于决定先保留谁,IoU用于判断是否高度重叠,两者作用不同。常见做法按类别分别处理,避免把重叠的不同类目标当作重复。
回听:11-16 Part01 00:57:58–01:05:23。
原课件第15页 / 26页用狗的图片读懂NMS前后
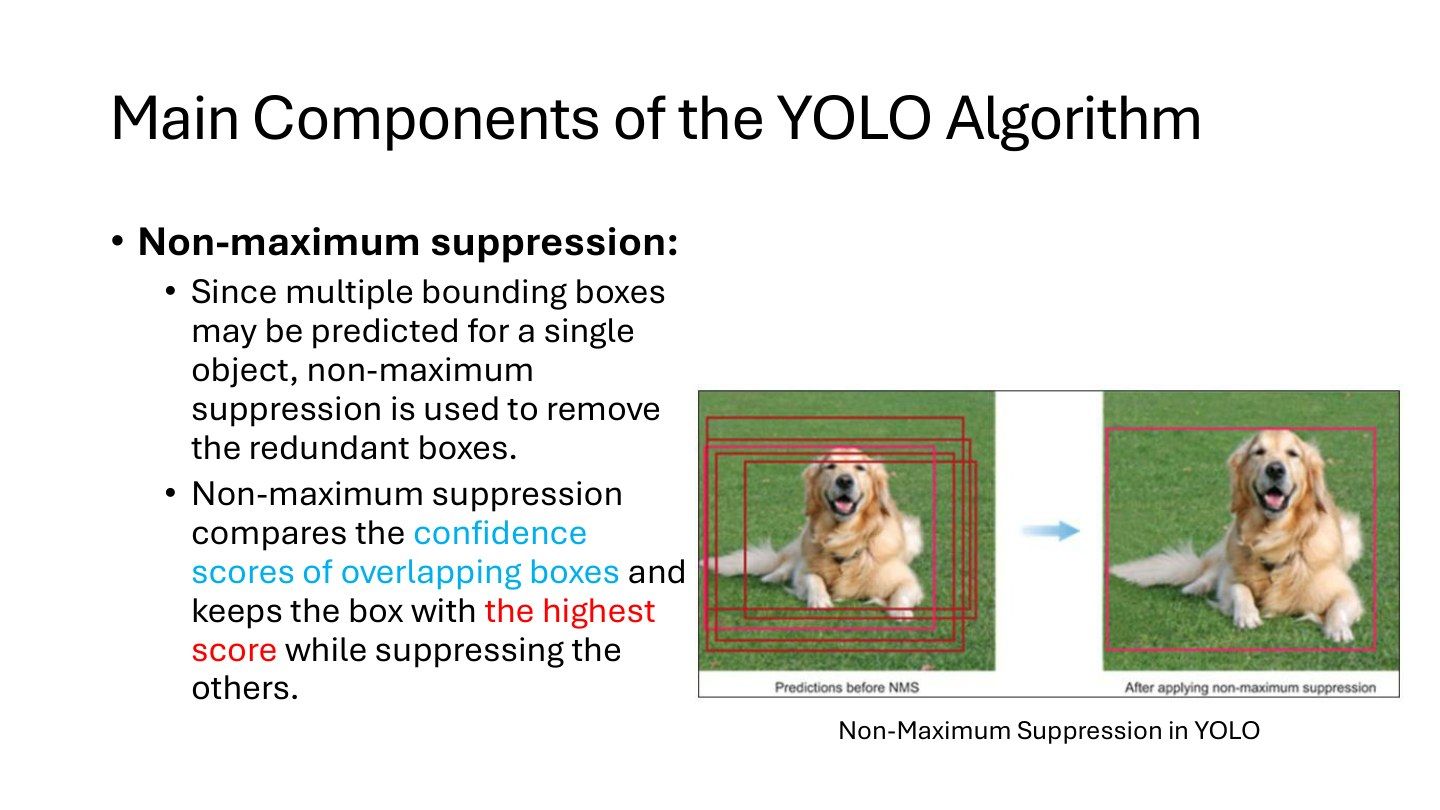
左图一只狗周围叠着很多框,它们是同一目标的多个候选,并不表示画面里有很多只狗。箭头右侧只保留一个框,说明算法把冗余候选去掉了。
操作时不是简单把框平均,也不是选面积最大的框,而是先保留高分框,再按重叠程度抑制其他候选。NMS阈值较低会更积极地删除重叠框;阈值较高会保留更多框。两个物体非常靠近时,这个选择会影响漏检与重复框的平衡。
原课件第16页 / 26页IoU怎样一步一步计算
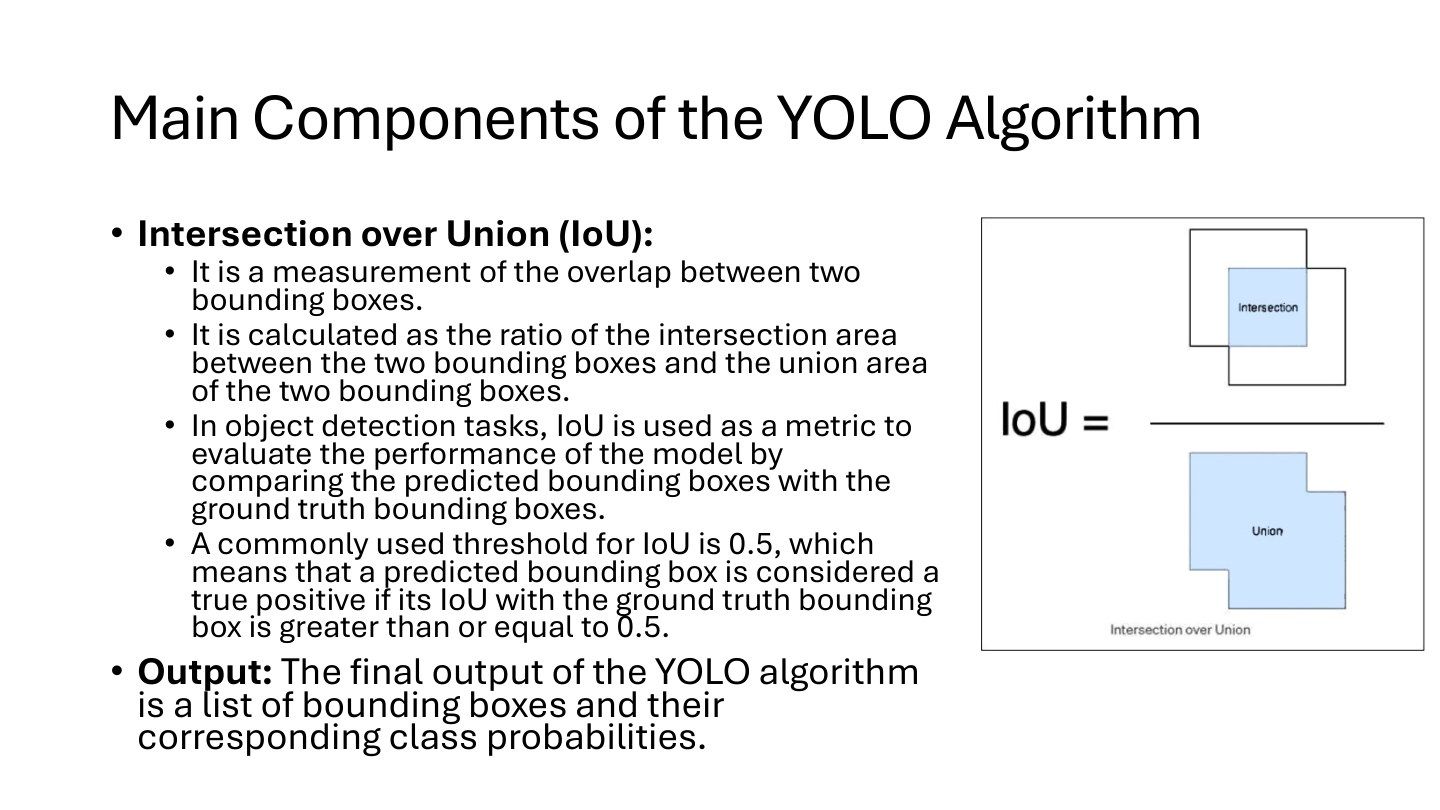
IoU=交集面积÷并集面积。交集是共同覆盖的区域;并集=A面积+B面积−交集,因为重叠部分在前两项中被算了两次。
用两个框完整算一次。A两角为(0,0)、(10,10),B为(4,0)、(14,10),单位为像素。两框各自宽10、高10,所以面积各100。
共同横向范围是x=4到10,宽10−4=6;共同纵向范围是y=0到10,高10。因此交集=6×10=60;并集=100+100−60=140;IoU=60/140≈0.429。完全重合为1,完全不相交为0。
检测评估比较预测框与标注框。若此例要求 IoU≥0.5,0.429<0.5,即使类别正确,这个预测也不能与该标注匹配为真阳性。过了阈值还要检查类别和一对一匹配。后处理中的 NMS 用同一公式比较两个预测框。
课堂串讲(11-16 Part01 00:57:58–01:05:23)
课堂比较预测框与真值框,并提到0.5。课件把0.5用作这一评估例子的IoU阈值;NMS阈值另行设置。
小演示 · 移动两个框,观察 IoU 和 NMS
原课件第17页 / 26页怎样理解YOLO的优点
单阶段预测便于构造快速检测流程,适合需要及时响应的场景。它可以同时给出多个物体的类别与框,结构也便于部署。
但速度要看模型大小、输入分辨率和运行硬件;精度要看训练数据、目标尺寸和遮挡情况。理解本页的“快、准、灵活”时,要落实为具体指标:一秒处理多少帧、每帧延迟多久、漏掉多少目标。小目标只占几个像素时,任何检测方法都更难辨认,提高分辨率又会增加计算量。
课堂串讲(11-16 Part01 00:57:58–01:05:23)
这一段用速度、准确性、灵活性和简单性概括YOLO的优点。复习时将这些词分别对应到帧率、检测结果、任务适配和处理流程。
原课件第18页 / 26页沿YOLO结构图从左读到右
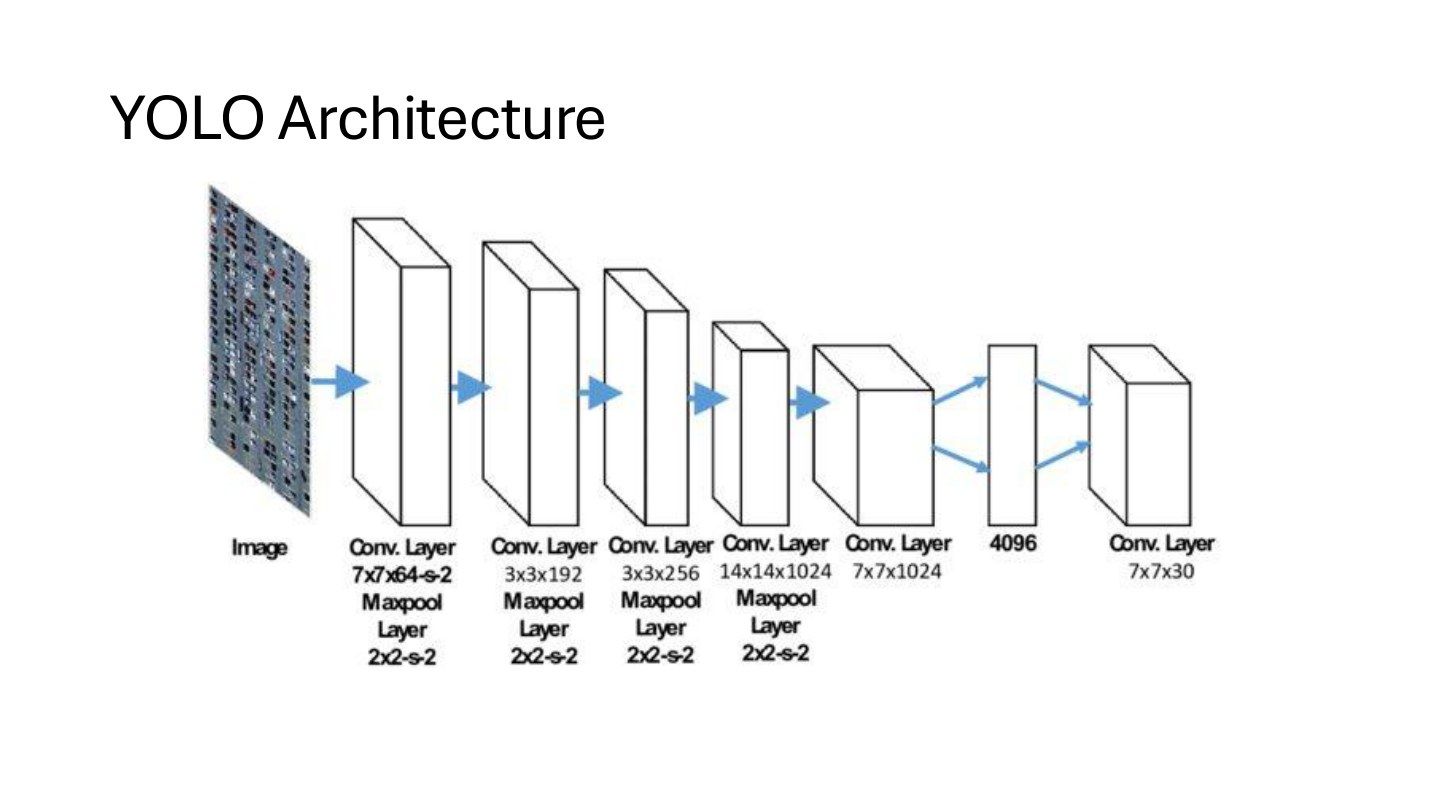
从左向右跟蓝箭头读:输入图像→多层卷积与池化→中间特征→最终预测。卷积从局部像素提取边缘、纹理,再组合成复杂特征;池化或较大步长让空间尺寸变小,后层可综合更大范围的信息。
第一块标7×7×64-s2,可分开读成7×7卷积核、64个输出通道、步长2。Maxpool 2×2-s2是2×2最大池化、步长2。后续3×3、192、256等数字继续描述卷积与通道规模;4096表示中间特征维数。
这张早期YOLO图最终输出7×7×30:49个网格,每格预测20个类别值与2个框,每框5个数,所以20+2×5=30。总共49×30=1470个输出数。
Tutorial 7的YOLOv8n示例采用另一种布局(1,84,8400):1张图、每候选4个框值+80个类别分数、8400个候选。两种布局来自不同模型,读实际代码时按它加载的模型解释形状。
原课件第19页 / 26页ONNX:保存模型的通用表示
ONNX全称Open Neural Network Exchange,是表示机器学习模型的一种开放格式。它保存计算图、运算和模型参数,使训练框架与部署工具之间有一种共同语言。
例如你用PyTorch训练检测模型,部署设备却使用另一个推理引擎;可以先把模型导出成ONNX文件,再让兼容的引擎加载。ONNX描述模型怎样算,图像从相机读取、缩放、颜色转换及结果发布等外围工作,仍由应用程序完成。
原课件第20页 / 26页怎样读跨框架转换图
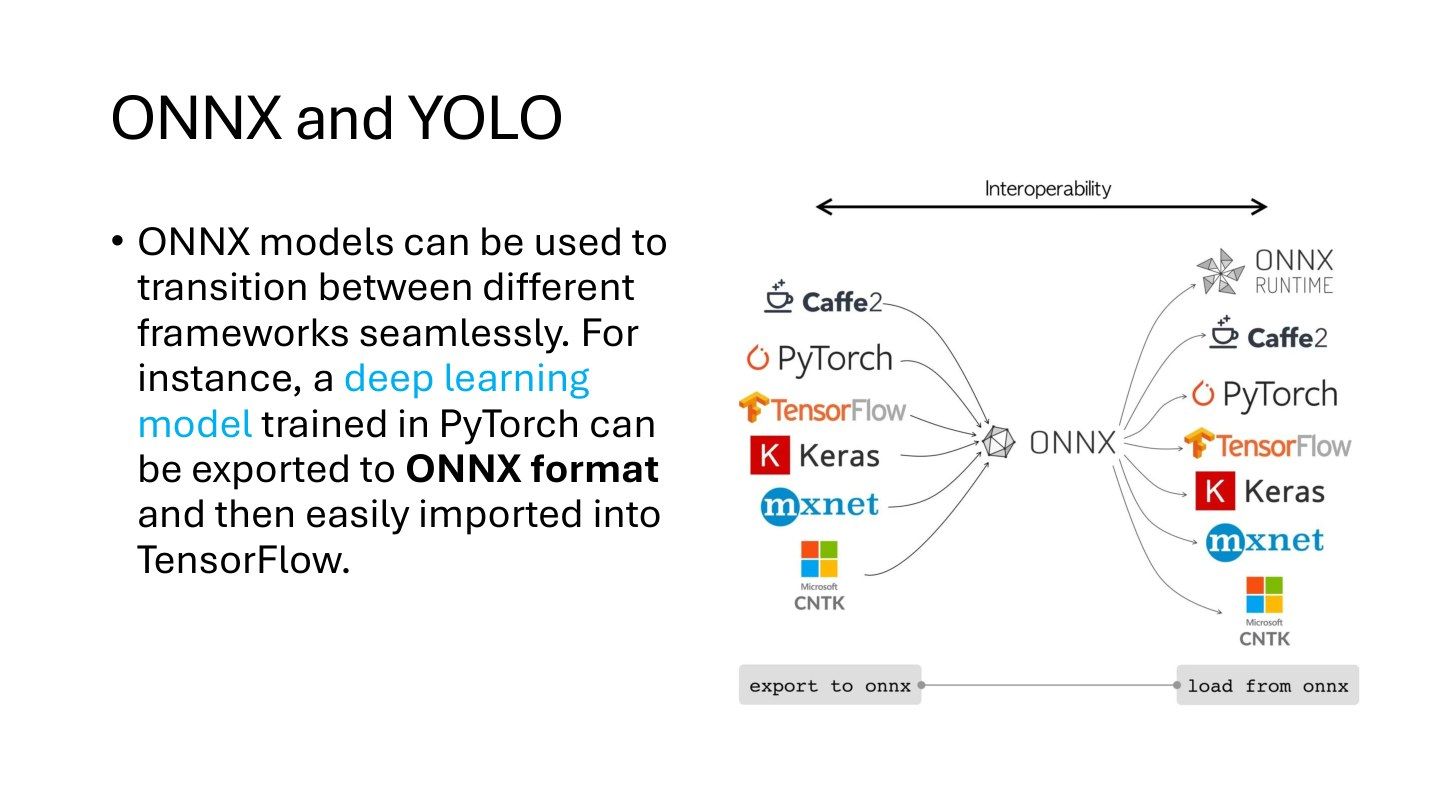
图左侧是模型来源,如PyTorch、TensorFlow等;中间ONNX是交换格式;右侧是可加载或转换这些模型的目标工具。箭头代表模型表示的转换或加载,不是把同一图像在每个框架里重新训练一次。
跨工具部署时,需对齐输入张量尺寸、通道顺序、归一化和支持的运算。例如训练时输入RGB、0到1浮点值,部署时却输入BGR、0到255整数,即使成功加载模型,预测也会变化。转换后应拿同一张图比较两端输出。
原课件第21页 / 26页ONNX Runtime负责执行模型
ONNX是文件表示,ONNX Runtime是读取该表示并运行推理的执行工具。它组织计算图、优化运算,并通过相应执行后端利用CPU、GPU或其他加速硬件。
一轮推理的流程是:创建会话→准备输入张量→执行模型→读取输出张量→解码成框和类别。加速效果取决于运算是否被目标后端支持、数据传输开销和输入规模。模型文件与运行引擎要分清:前者像一份计算说明,后者真正按说明完成运算。
课堂串讲(11-16 Part01 01:05:24–01:13:28)
课堂把开放模型表示与跨环境部署联系起来,并提到CPU、GPU和专用加速器。模型表示负责保存计算内容,运行工具负责在目标硬件上执行。
原课件第22页 / 26页YOLO导出ONNX后怎样部署
整体顺序为:在训练框架中完成训练→选择权重→导出ONNX→用目标推理引擎加载→接入预处理与后处理→测速度和检测结果。
导出通常不需要重新训练,但部署程序必须理解输出张量含义。有的导出包含部分后处理,有的只输出原始候选;应用端需要据此解码、筛分数和执行NMS。优化可以降低计算或内存开销,前提是转换后的输出仍符合任务需求。不能只以“文件导出成功”作为完成部署的判断。
课堂串讲(11-16 Part01 01:05:24–01:13:28)
跨环境部署的重点是复用已经训练好的模型。读转换流程时,分别跟踪模型文件怎样转换、输入图像怎样处理、输出结果怎样解码。
原课件第23页 / 26页把示例工作流落实成输入输出
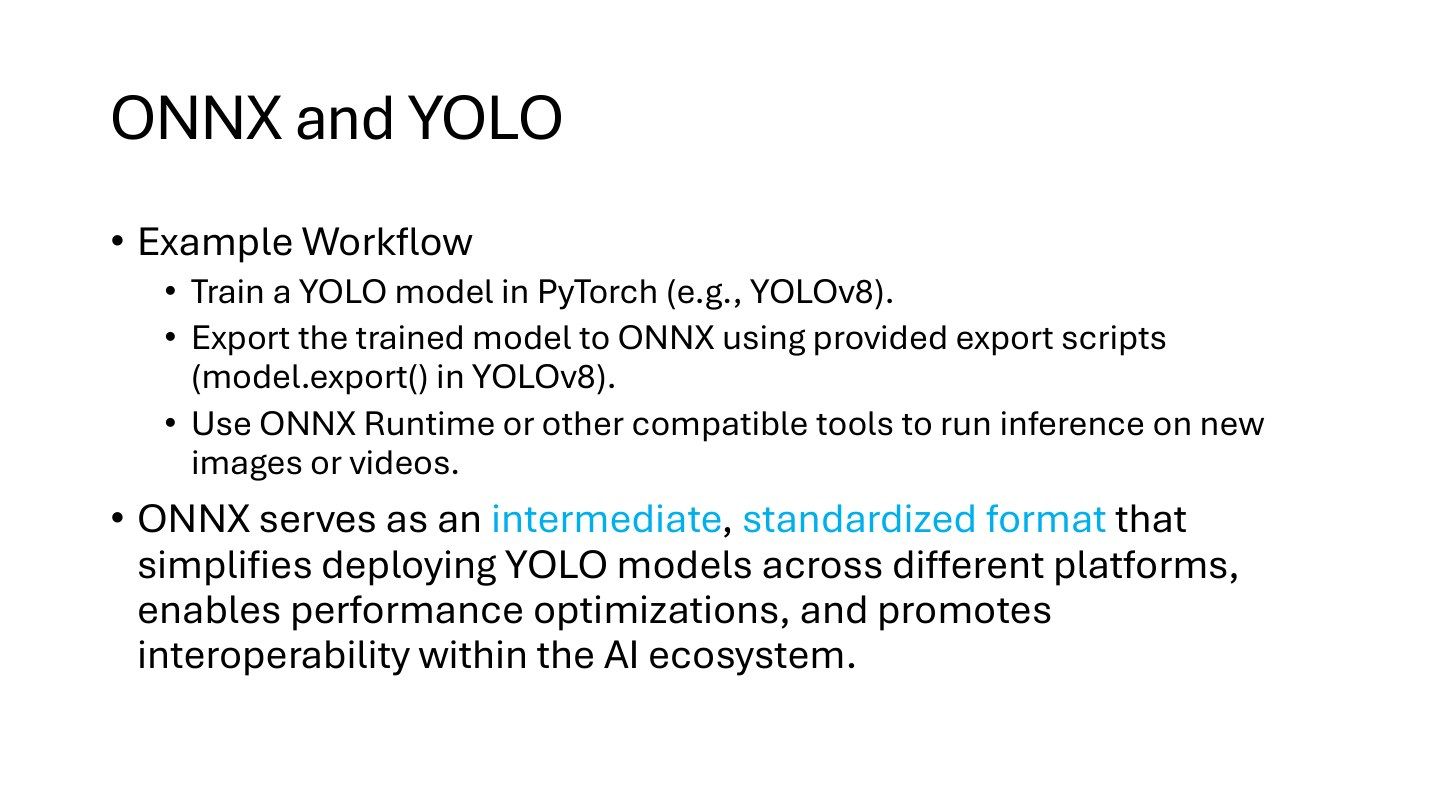
第一步训练YOLO,输入带标注图像,输出模型权重。第二步导出,例如课件所述model.export调用,输入权重与导出配置,输出ONNX模型。第三步用推理工具处理新图像,得到检测结果。
部署检查可用固定图片:先记录原框架的类别、分数、框,再用ONNX引擎处理同一图,确认坐标和类别一致。随后接视频流,观察持续运行速度与延迟。这样依次确认模型转换、单图推理、实时系统,定位问题更直接。
原课件第24页 / 26页OpenCV、YOLO、ROS如何接起来
一种常见处理链是:相机节点发布图像→视觉节点读图→OpenCV做格式转换和预处理→YOLO输出检测框→视觉节点发布类别与框→任务节点作决定。
传统特征匹配、Haar级联和深度检测是不同的识别途径,按任务选用。ROS负责将结果传给控制系统,但检测框仍只是像素坐标。如果机器人要抓取杯子,还需深度、相机标定和坐标变换,才能把图像里的位置转成机械臂坐标中的目标。
课堂串讲(11-16 Part01 01:05:24–01:13:28)
这一段把物体识别与机器人控制连接起来:视觉模块给出目标信息,任务和控制模块再利用它决定动作。识别结果是后续决策的输入。
原课件第25页 / 26页视觉导航和避障分别需要什么
导航可用光流判断图像特征怎样运动,用双目估计深度,或通过视觉SLAM同时估计运动与地图。避障则要判断前方哪些区域被占据、障碍离机器人多近,以及是否会进入行驶路径。
边缘和轮廓帮助找形状,背景减除帮助发现相对固定背景变化的区域,但移动相机会让大量背景也变化,因此需要相机运动补偿或其他线索。检测到物体类别不等于已得到安全距离;深度与机器人自身尺寸还要进入碰撞判断。
原课件第26页 / 26页视觉反馈怎样真正影响机器人动作
机器人识别目标并接近后,可以持续跟踪目标在画面中的偏差,调整末端或底盘,使偏差缩小。例如目标应位于画面中心,实际在左侧,控制器便根据标定关系产生修正动作,这是一种视觉反馈思路。
ROS集成时,相机消息要带时间和坐标系,检测结果也要对应同一帧。任务模块接收结果、决定动作,再由控制模块执行;下一帧继续测量,形成闭环。处理速度再快,若使用的是过时图像,修正方向也可能滞后,所以整条链路的延迟都要考虑。
回听:11-16 Part01 01:13:28–01:37:03。