左右键翻页;“连续阅读”展开整份;搜索可定位概念。
本讲的目标与后续联系
这讲先介绍课程要求,再学习矩阵、机器学习的三种训练信号,以及损失、梯度下降和验证。把机器学习想成“用数据调整一个预测规则”:例如输入电机温度和电流,输出故障类别,后面的数学就是在说明规则怎样表示、怎样改进。
教师背景与课程应用方向
授课教师Yang Xu的研究方向包括智能增材制造、制造AI及先进结构与功能材料,课程因此常用传感器、机器人和生产线举例。比如预测成品强度是数值回归,判断合格与否是分类;先认清输入和输出,就能理解工程例子的学习任务。联系邮箱为yxu195@hku.hk,办公室HW823-B。
目录怎样组织学习顺序
学习顺序是课程总览→数学基础→机器学习类别→训练与验证。矩阵用来组织数据,学习类别决定可用的反馈,损失与梯度说明怎样调整模型,验证则检查它对新数据的表现。
课程时间与周次
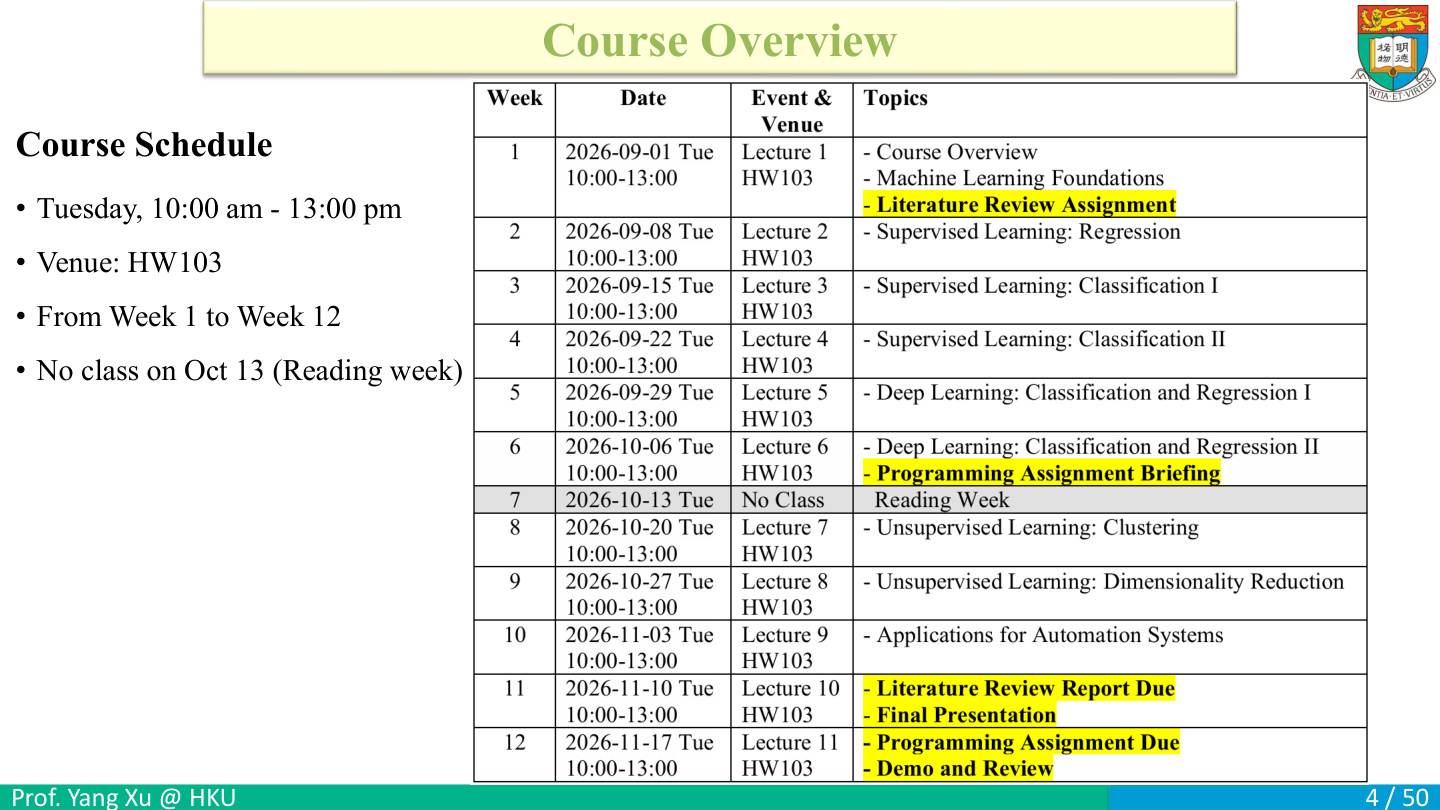
课程时间表列周二10:00–13:00、HW103,授课跨Week1至Week12,10月13日为Reading Week。Week表示授课周,Lecture表示讲义章节:一份讲义可能跨两次课,一次课也可能继续上一讲,因此复习时按主题和页码衔接。
主题之间怎样衔接
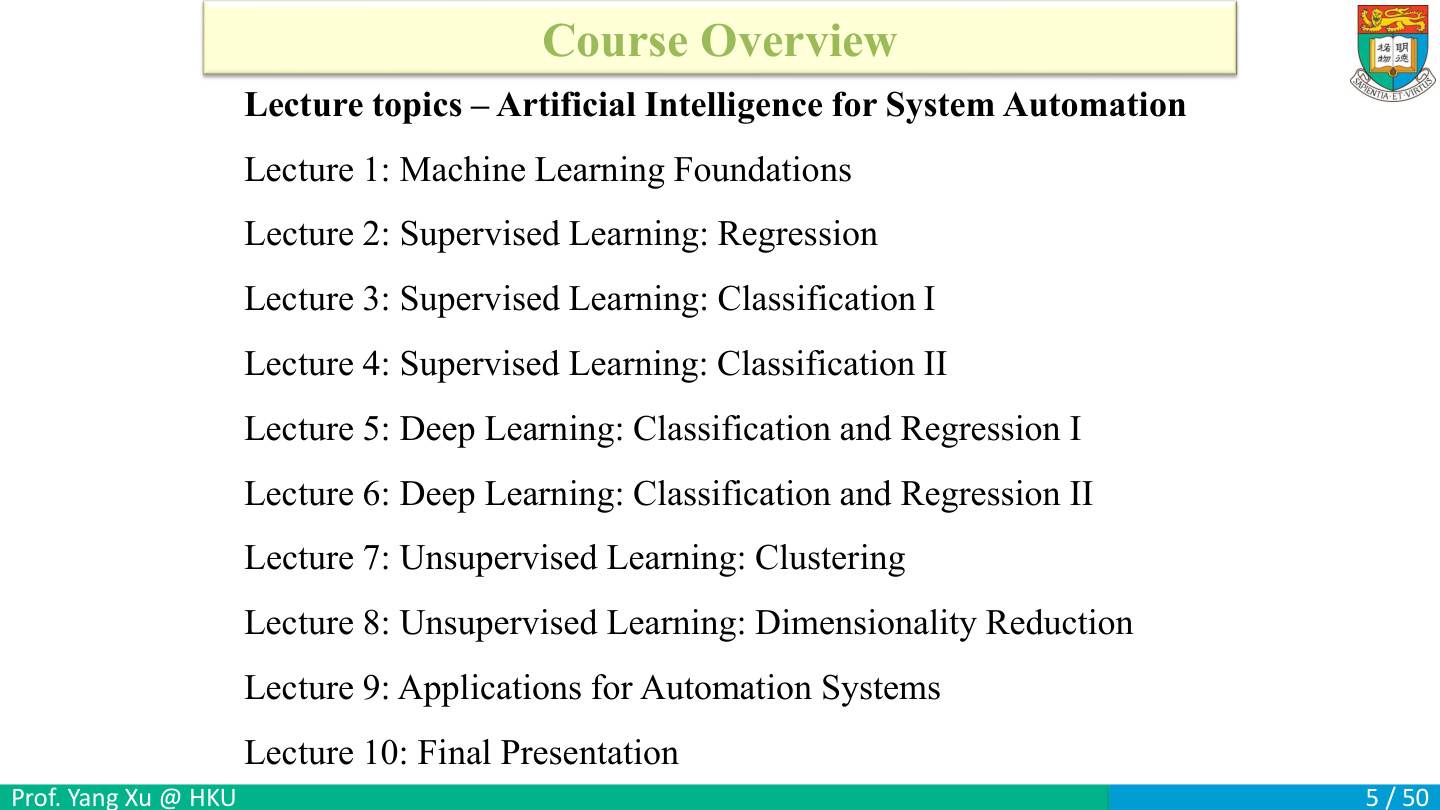
课程从机器学习基础出发,学习回归和分类,再进入集成学习、神经网络、聚类、降维与自动化应用。用生产线串起来:回归预测耗电,分类识别缺陷,聚类整理未标注运行模式,降维把很多传感器量压缩为更少的特征。
为什么需要自己实现与观察
动手的价值在于把“公式会怎样变化”变成能观察的结果。比如ŷ=wx、x=3时,把w从1改成2,预测应从3变6;再加入目标y=5,就能比较误差从2降到1。每次只改一个设置,并解释输出为什么变化,比只记最终准确率更能建立理解。
成绩权重与时间节点
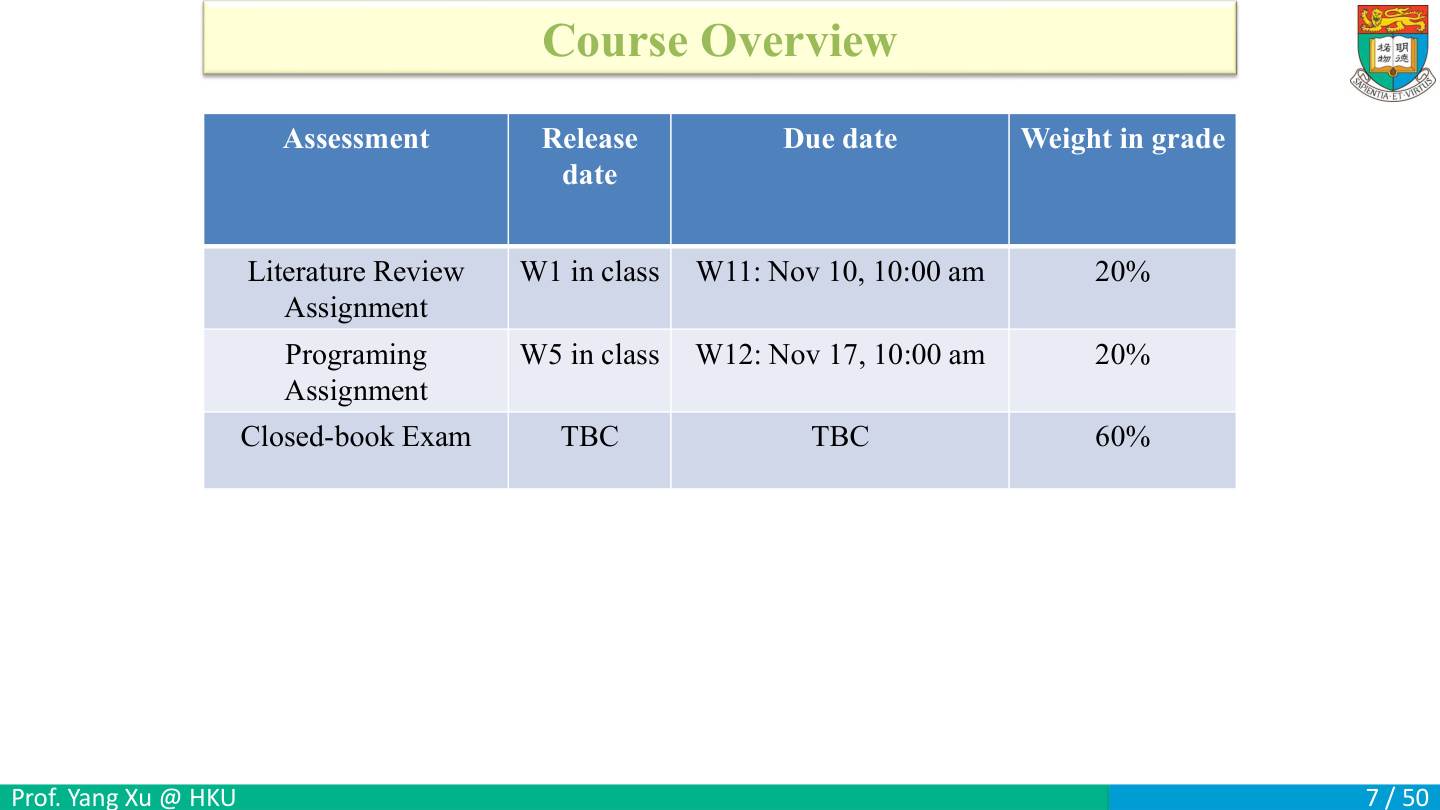
考核分为文献综述20%、编程作业20%、闭卷考试60%;表中综述截止为11月10日10:00,编程作业截止为11月17日10:00,考试时间TBC意为待定。权重20%就是0.2,所以三项成绩80、90、70时,总评=0.2×80+0.2×90+0.6×70=16+18+42=76分。某一项提高10分,20%项使总评提高2分,60%项使总评提高6分。
文献综述要比较什么
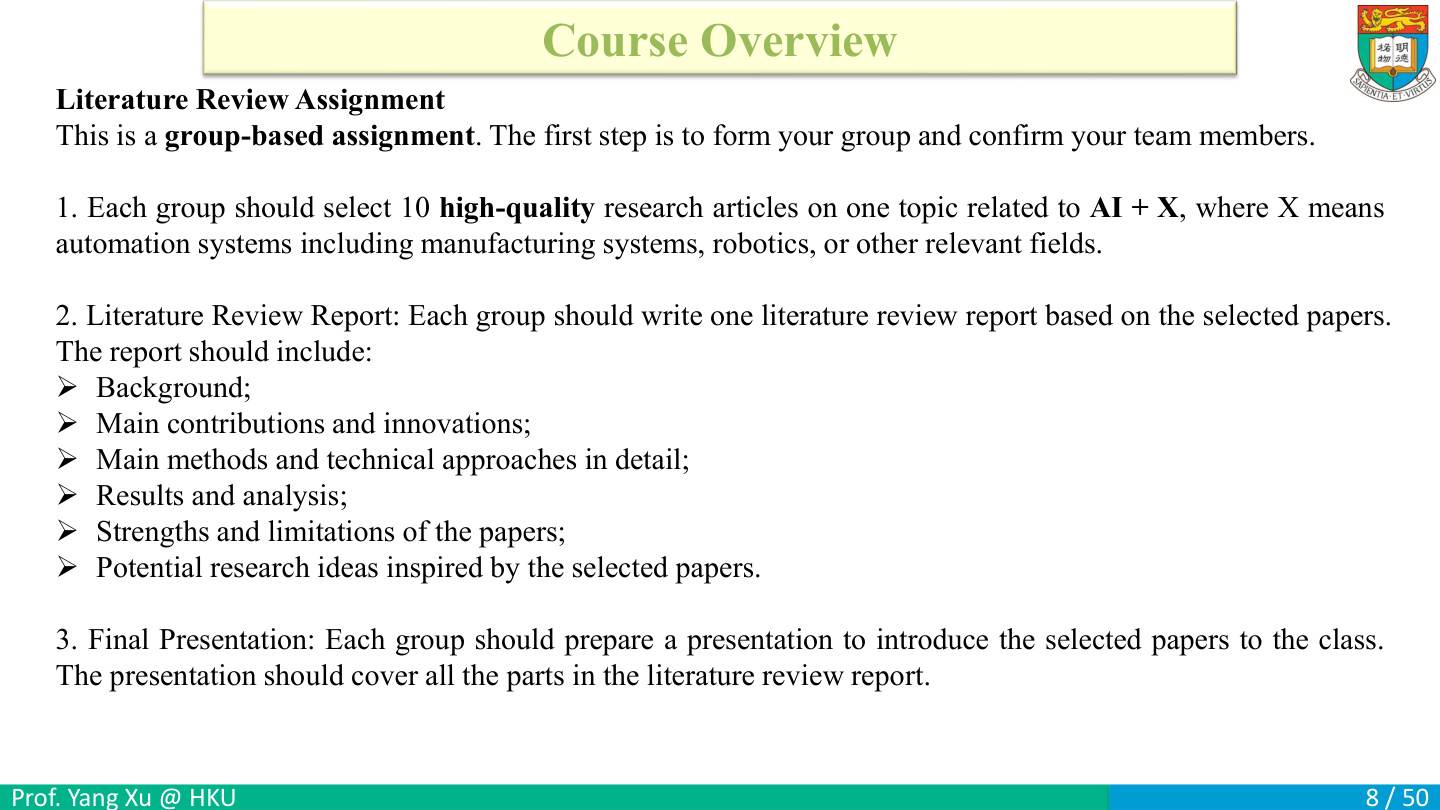
小组围绕一个 AI+自动化主题选 10 篇高质量研究论文。报告和课堂展示都覆盖研究背景、贡献与创新、技术方法、结果、优点与局限、由局限引出的研究想法。
读两篇缺陷检测论文时,先对照输入、训练数据、测试条件和指标。两篇分别报 95% 和 98%,但一篇测单一产线,另一篇测新产线,就要先解释测试难度,才能判断性能差异。方法部分可按「输入 → 处理步骤 → 输出」并排写,帮助读者看清差别来自哪里。
小组完成与个人提交的区别
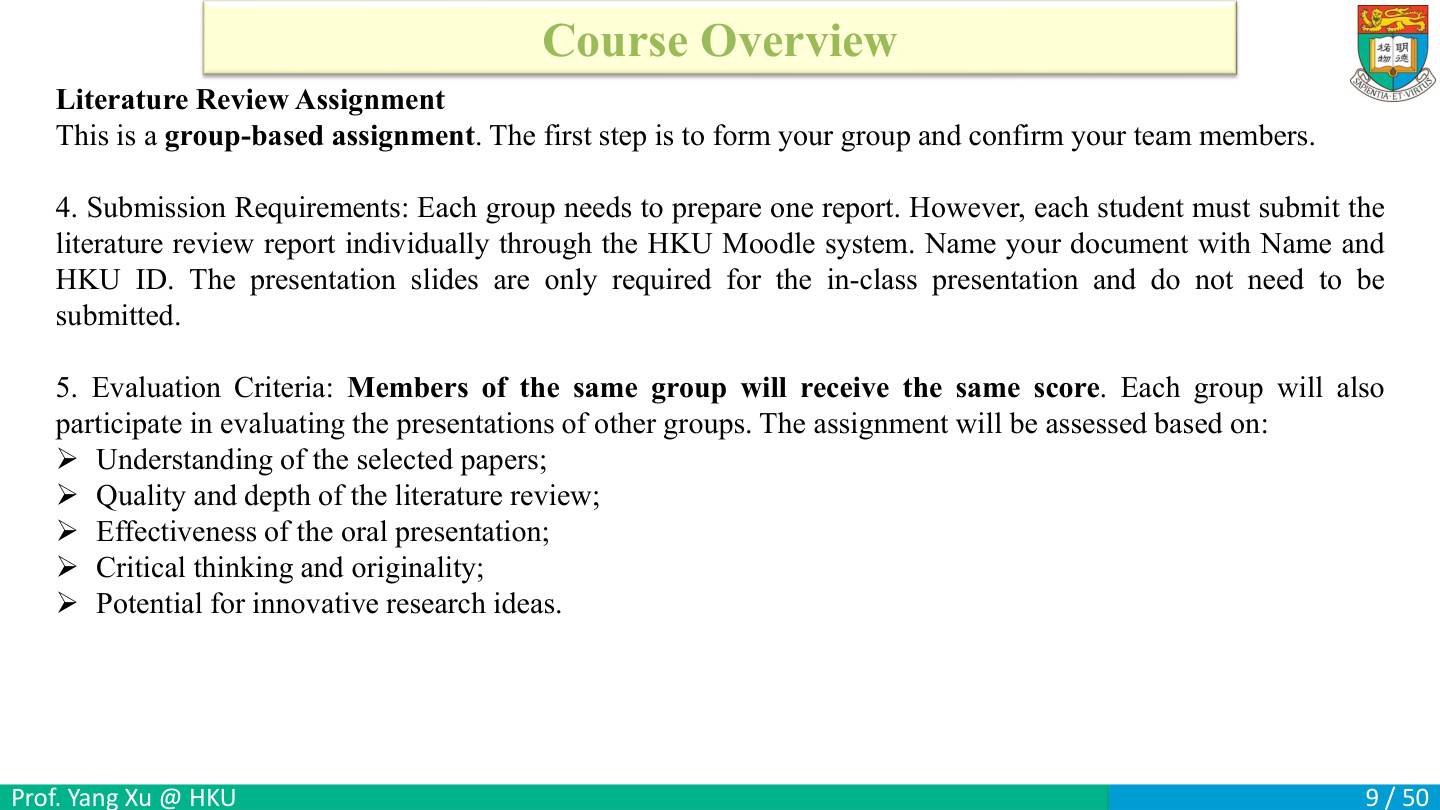
全组完成同一份报告,每位组员都要以本人姓名和 HKU ID 命名文件并单独上传 Moodle。展示幻灯片供课堂使用,无需提交。课件同时说明同组成员得分相同,各组参与评价其他组的展示。
评分看论文理解、综述深度、口头表达、批判思考和研究想法。举例来说,写「模型在新机器上的性能可能下降」时,接着指出论文只用单台机器采数,并提出跨机器测试,就把局限、依据和研究设想连起来了。
编程作业交付物与工具角色
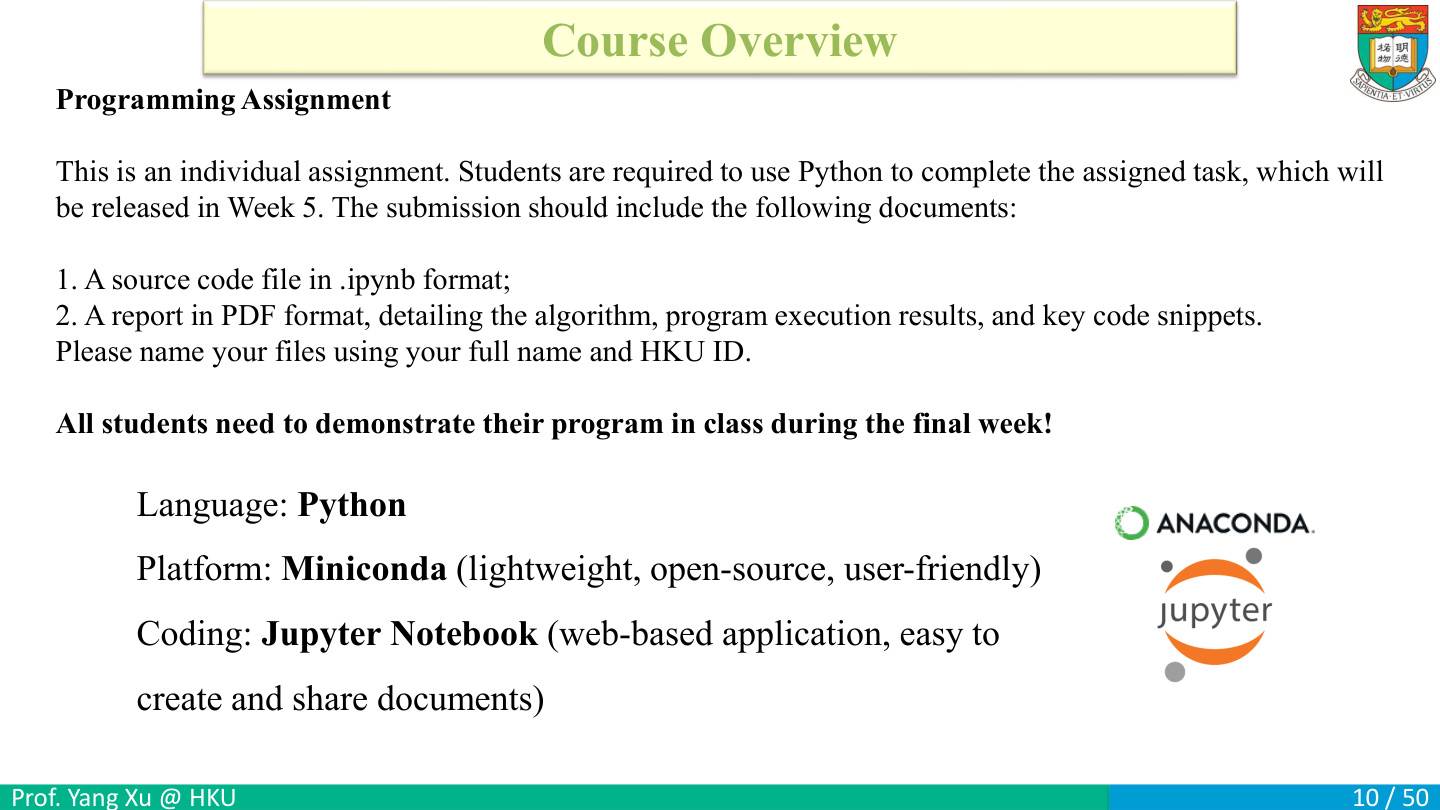
个人编程作业用Python完成,交付代码、解释算法和结果的PDF报告,并在课堂演示。Miniconda负责环境和依赖,Jupyter Notebook把代码、说明与输出放在一起;代码单元按实际执行顺序生效,例如先运行x=2,后面的单元才能使用x。演示前重启内核并从头按顺序运行,可检查代码是否依赖遗留变量。
作业规则如何落实到产物
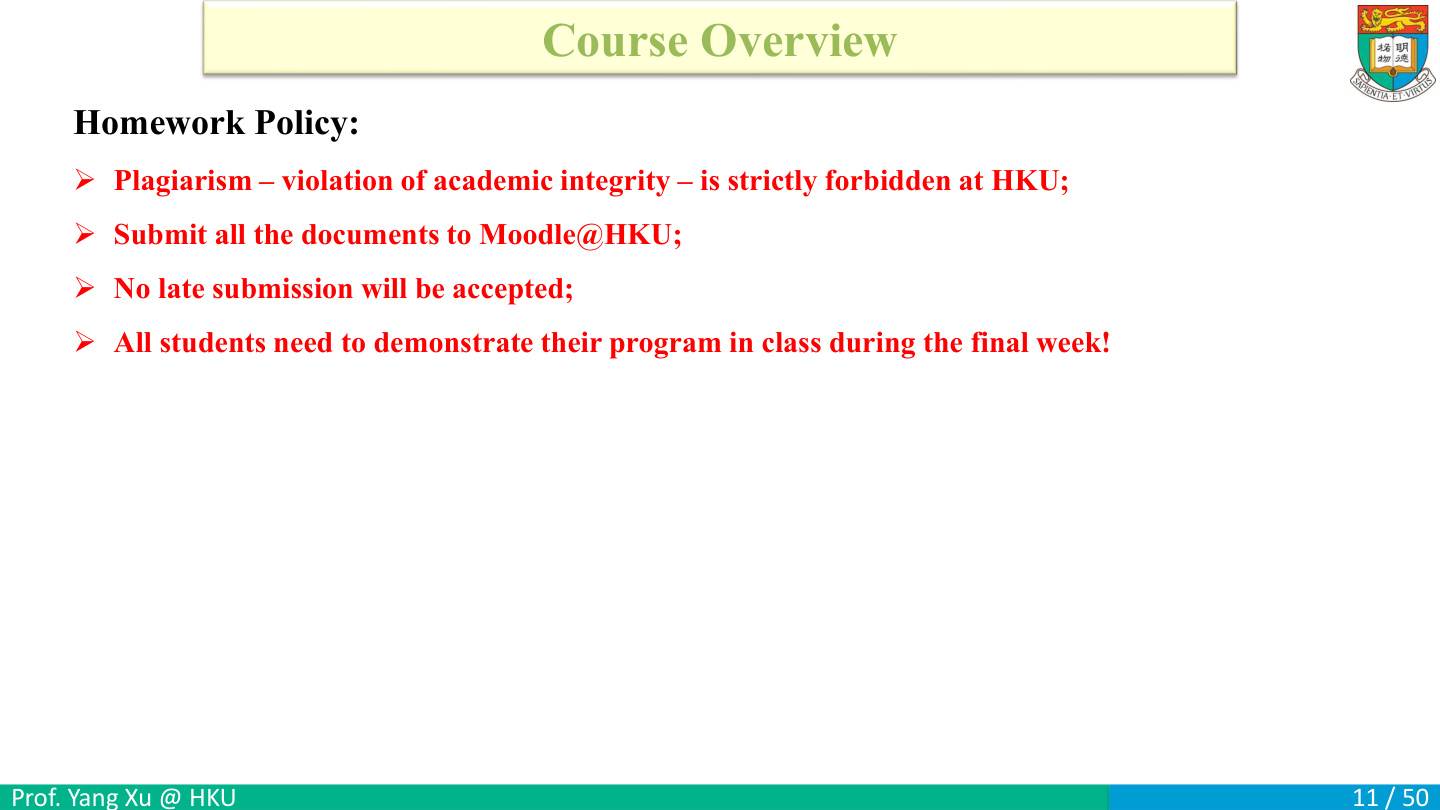
作业通过Moodle提交,按时完成,并遵守学术诚信要求。准备演示时要能说明输入文件在哪里、图片怎样变成数组、模型怎样读取,以及预测结果怎样保存,这些步骤连起来才是一套可复现程序。
答疑联系方式与提问准备
教师Yang Xu可预约面谈或Zoom;两位TA为Likun Ye和Chengkun Zhang,房间HW105M。问理论时指出卡住的页码与推导行,问代码时给出最小输入、报错和已尝试的步骤,例如“读入28×28图片后,reshape这一行报形状错误”,就比“程序不行”容易定位。
进入机器学习基础
从这里开始,把x理解为一条输入、X理解为许多样本排成的矩阵、y理解为目标、w理解为待学习权重。若一条记录含温度和电流,x有2项;100条记录每行一条,X就是100×2,接下来的矩阵运算会不断用到这个读法。
齐次方程的零解与可逆性
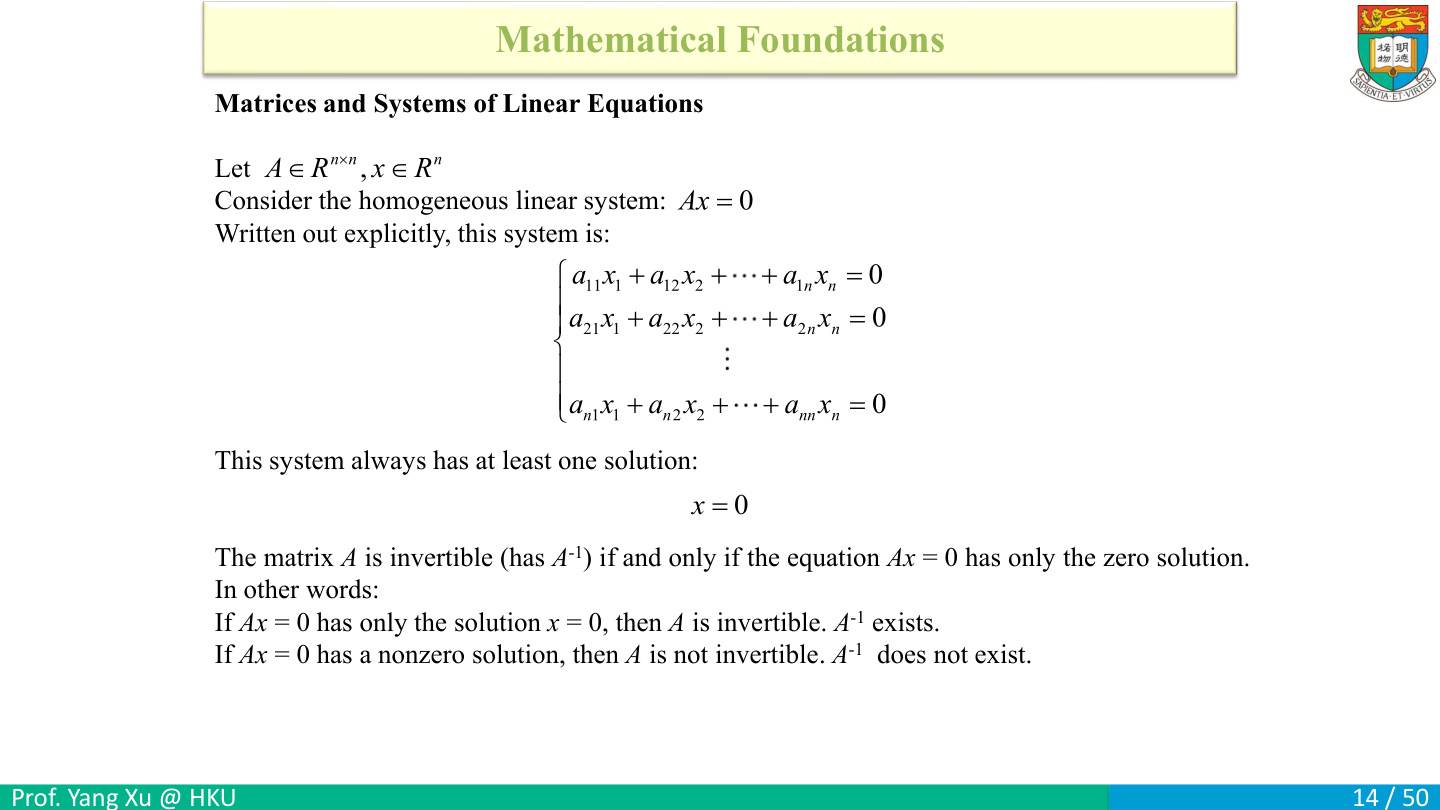
设A为n×n实方阵,x是n维列向量。Ax=0称齐次线性系统:等号右边是n项全为0的向量,表示每一行方程都要成立。x=0总是一个解,我们要检查的是还有没有非零解。
先把二维乘法展开。A=[[2,1],[0,3]],x=(a,b)ᵀ:
| 矩阵的哪一行 | 与x作内积 | Ax=0要求 |
|---|---|---|
| 第1行(2,1) | 2a+1b | 2a+b=0 |
| 第2行(0,3) | 0a+3b | 3b=0 |
由第二行得b=0,代回第一行得2a=0,所以a=0。A=diag(2,3)时同样是2a=0、3b=0,也只有零解。
换成A=[[1,2],[2,4]]:第二行恰是第一行的2倍,只需满足a+2b=0。令b=1就得a=−2,于是非零x=(−2,1)ᵀ也满足Ax=0:第一项−2+2=0,第二项−4+4=0。
这解释了“丢掉一个方向”:零输入和非零输入(−2,1)得到同一个输出0,无法从输出唯一找回输入。因此这个A不可逆。对n×n方阵,只有零解等价于列向量无冗余、秩为n,也等价于可逆。
正向推理可逐步写成:若A⁻¹存在,Ax=0两边左乘A⁻¹,得到A⁻¹Ax=A⁻¹0;左边Ix=x,右边0,故x只能为0。
非零零空间向量为何否定可逆
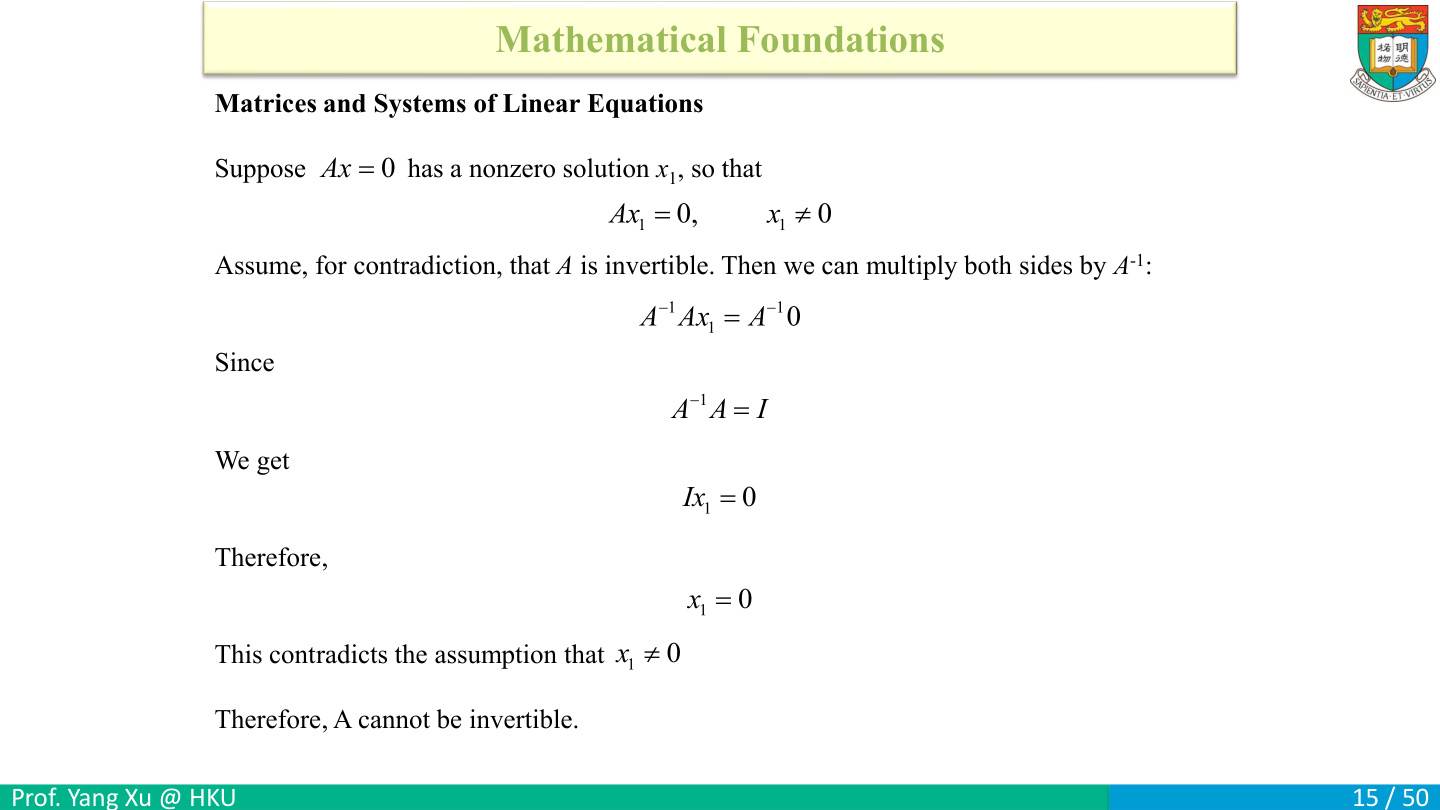
已知有一个完整向量 x₁≠0 满足 Ax₁=0。为了检验 A 能否有逆,先假设 A⁻¹ 存在,并在等式两边左乘它。
A⁻¹(Ax₁)=A⁻¹0。
左边按结合律把括号移到前两个因子,得到 (A⁻¹A)x₁=Ix₁=x₁。右边是 A⁻¹ 的各行与全零向量做内积,结果仍为 0。这样推出 x₁=0,与已知 x₁≠0 矛盾,故 A 不可逆。
方阵逆可以想成还原输入的操作。第14页中 x=(−2,1)ᵀ 和零向量都被映成零。如果逆存在,同一个输出就要同时还原出两个不同输入。矩阵乘法允许改变括号位置,A⁻¹ 左乘后无需交换 A 与 A⁻¹。
矩阵乘法是列向量线性组合
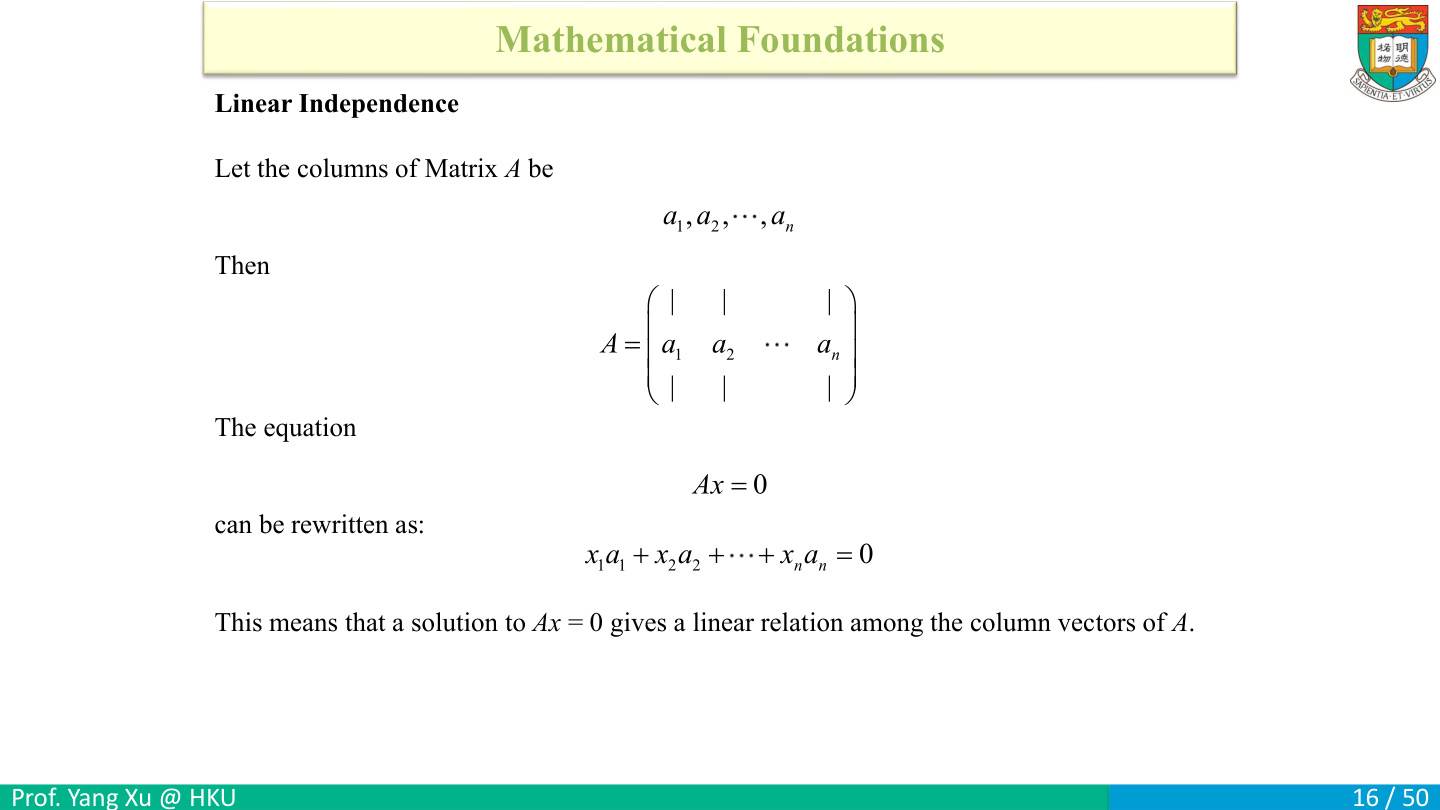
设 A=[a₁ a₂ … aₙ],x=(x₁,…,xₙ)ᵀ。Ax=x₁a₁+x₂a₂+…+xₙaₙ。x 的第 j 个分量就是第 j 列的系数。
用 A=[[1,3],[2,4]]、x=(2,−1)ᵀ 同时算两种写法。
| 读法 | 计算 | 结果 |
|---|---|---|
| 逐行内积 | (1×2+3×(−1), 2×2+4×(−1))ᵀ | (−1,0)ᵀ |
| 各列缩放再相加 | 2(1,2)ᵀ−(3,4)ᵀ=(2,4)ᵀ−(3,4)ᵀ | (−1,0)ᵀ |
列组合也能看出 A 有无冗余。换成 a₁=(1,2)ᵀ、a₂=(2,4)ᵀ,取 x=(2,−1)ᵀ,Ax=2a₁−a₂=(0,0)ᵀ。非零系数也能拼出 0,因为 a₂ 本来就是 a₁ 的两倍。
m×n 矩阵有 n 列,所以 x 要提供 n 个系数。每一列有 m 项,组合出的结果也有 m 项。
线性相关与线性无关
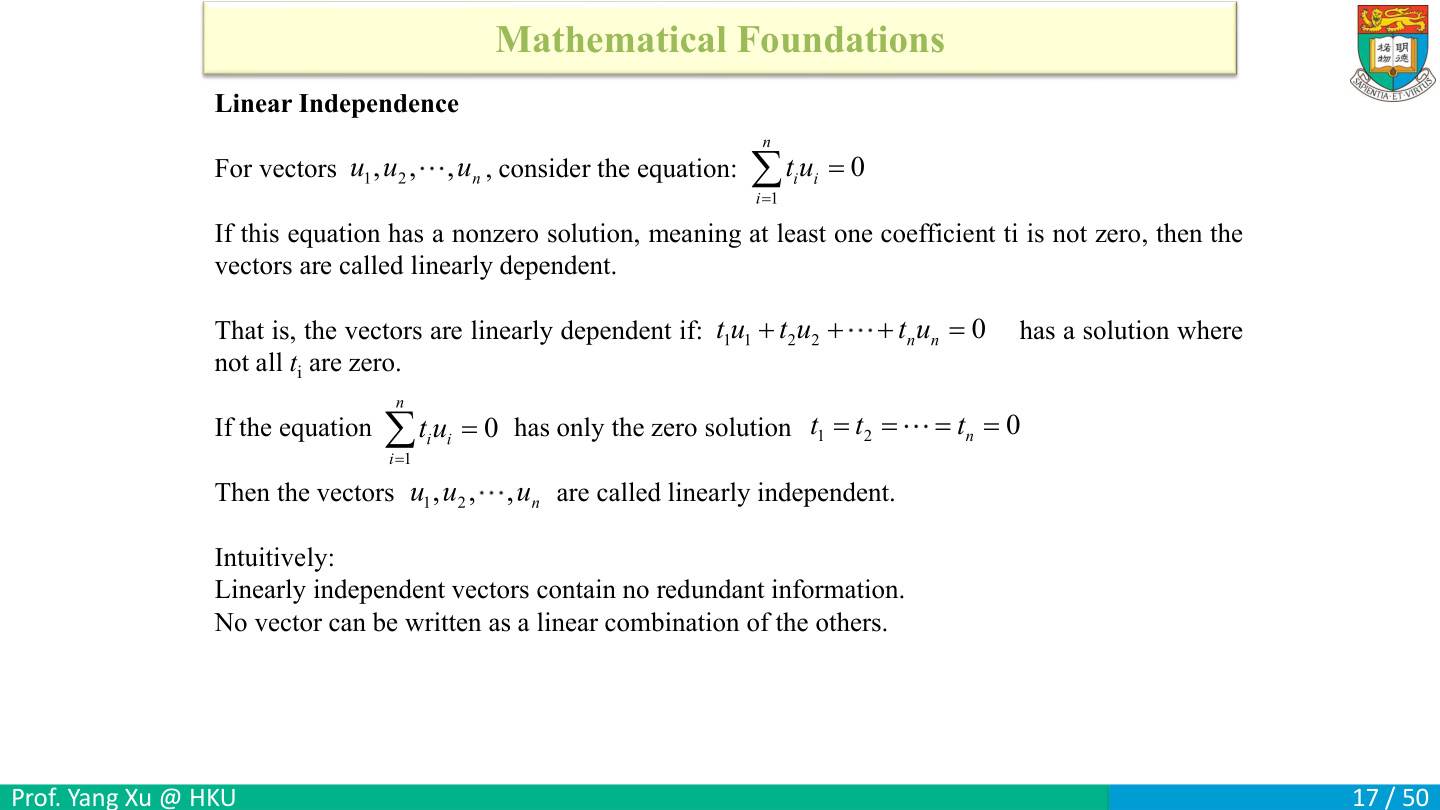
考虑Σ_i t_iu_i=0。若存在不全为0的系数t_i使等式成立,向量组线性相关;若只能所有t_i=0,则线性无关。这里“非零解”意为系数向量非零,不要求每个系数都非零。
例子u1=(1,0)、u2=(0,1),式子(t1,t2)=(0,0)迫使两系数都0,故无关。u1=(1,0)、u2=(2,0)虽然不相等,却有2u1−u2=0,故相关。任何向量组若包含零向量,也相关,因为该向量系数取1即可。
“无关”不是生活里的互不影响,而是严格说无法用其他列的倍数相加替代某一列。若u₃=u₁+u₂,则u₁+u₂−u₃=0,系数(1,1,−1)不全0,便已证明相关;不需要再枚举所有系数组合。若要证明无关,则必须说明使组合为0的所有可能情况最终都只能是零系数。
练一练。二维向量u₁=(1,0)、u₂=(0,1)、u₃=(1,1)各不相同,是否线性无关?答案:相关,因为u₁+u₂−u₃=(0,0)。由此也看到二维空间中最多只有两个独立方向;放入再多二维向量也不会创造第三个独立方向。
秩衡量独立列的数量
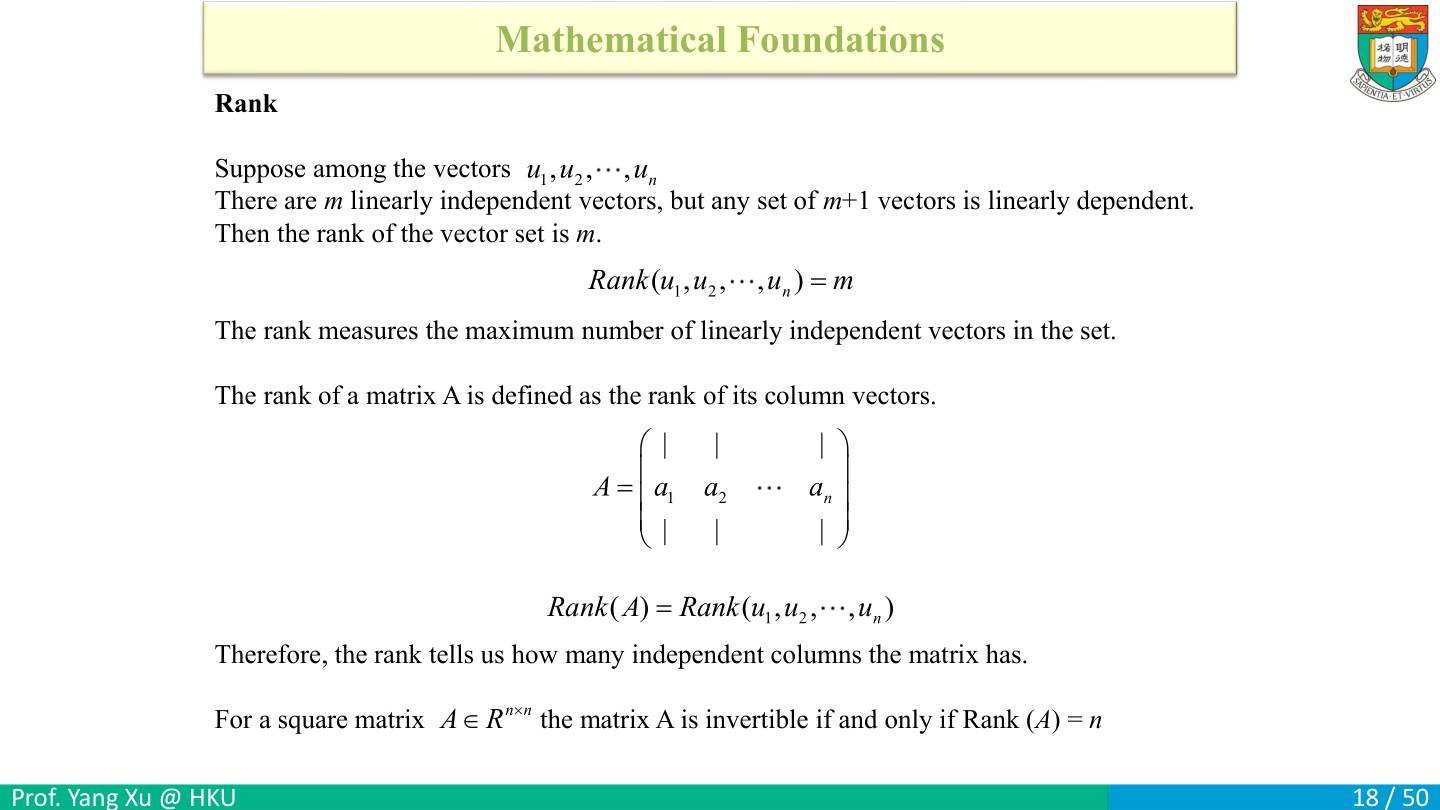
rank(A)是列向量中最多可选出的线性无关向量数量。n×n方阵可逆当且仅当rank(A)=n。矩形m×n矩阵的秩最多min(m,n),不能仅凭秩等于列数就说存在普通方阵逆。
例子A=[[1,2,0],[0,0,1]]三列为(1,0)、(2,0)、(0,1),第二列冗余,第一与第三列无关,所以秩2。对回归而言,完全重复或线性组合的特征可导致参数不唯一。这里的a与u都指矩阵的列向量。
可以用“保留哪些列仍能生成原来所有列”来计算小矩阵的秩。先留第一列,再问下一列是否能由已留列拼出;能拼出就不新增独立方向,不能才加入。对[[1,2,0],[0,0,1]],第二列=2倍第一列,所以不加入;第三列沿另一方向,需要加入,最终留下两列,秩为2。
练一练。3×2矩阵的秩能等于3吗?答案:不能,只有两列,独立列最多2;2×3矩阵也最多秩2,因为列都在二维空间。回归中,样本数量与特征独立性要分别检查:两项传感器记录若永远一项等于另一项两倍,增加记录后仍然冗余。
特征向量与特征值的含义
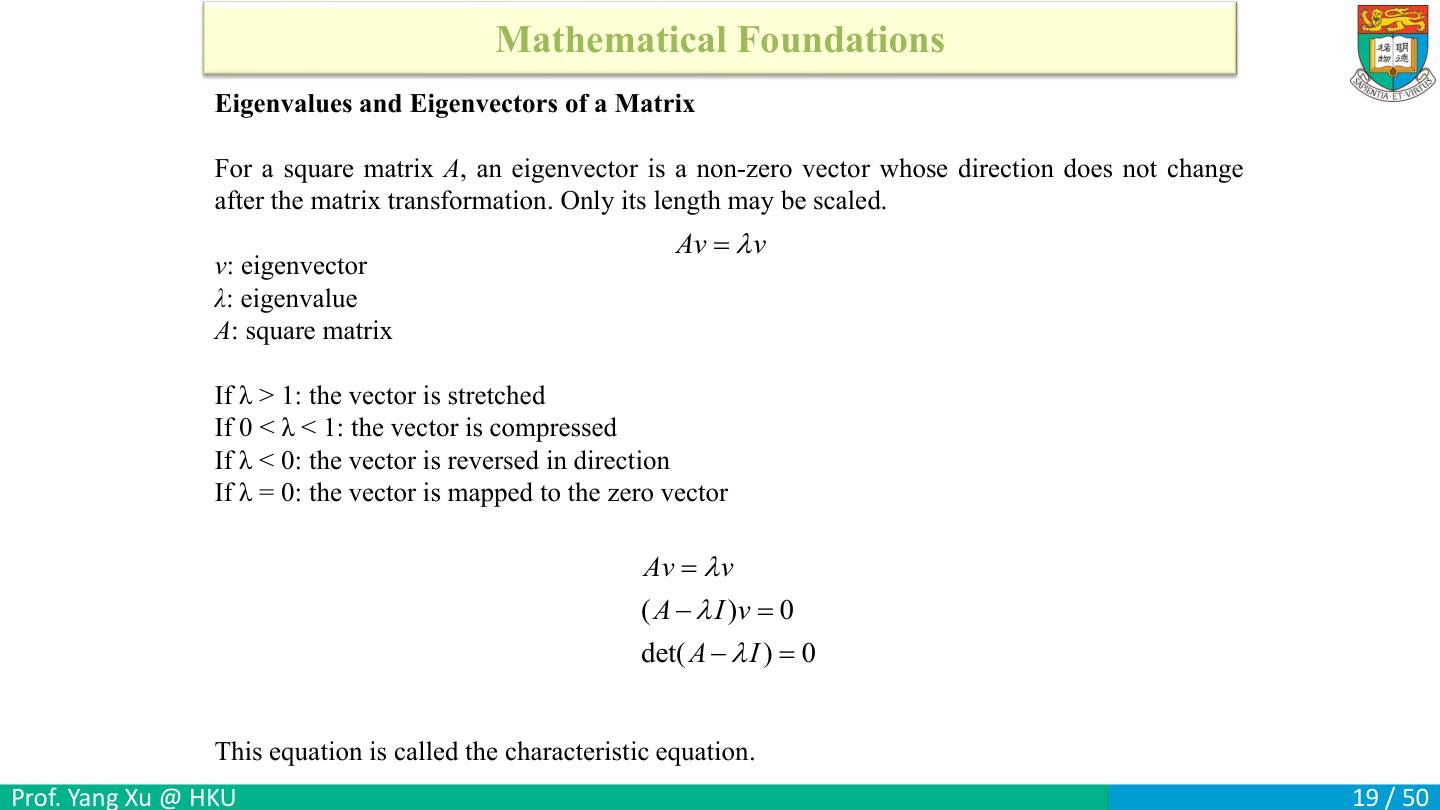
定义Av=λv,v必须非零;A作用后仍沿同一直线,λ给缩放和可能的反向。λ>1伸长,0<λ<1缩短,λ<0反向,λ=0映到零。反向时向量朝向改变,但仍在同一直线上;“方向不变”应按这个含义理解。
移项得(A−λI)v=0。要有v≠0,上一页说明矩阵A−λI必须不可逆,因此det(A−λI)=0,称特征方程。非零v不能省略,否则任意λ都可配v=0而失去定义。
从Av=λv到特征方程时不能把v像一个数那样“约掉”。v是向量,没有一般意义上的向量除法。正确步骤是移项Av−λv=0,把λv写成λIv,提取成(A−λI)v=0;需要非零v,因此A−λI有非零零空间,才推出行列式为0。
练一练。A=diag(2,−1),v=(0,3)ᵀ时Av=(0,−3)ᵀ,是几倍v?答案:−1倍,λ=−1。长度并未变,但朝向反了。v=(1,1)ᵀ一般不是此A的特征向量,因为(2,−1)无法用同一个倍数同时得到。这是判断特征向量的直接代入法。
λ=0的情况也不违反非零v要求:v仍非零,只是Av等于零。它正好把特征值与零空间连接起来;若一个方阵有零特征值,则存在非零输入被压成零,因此没有普通逆矩阵。
二阶矩阵特征值每一步计算
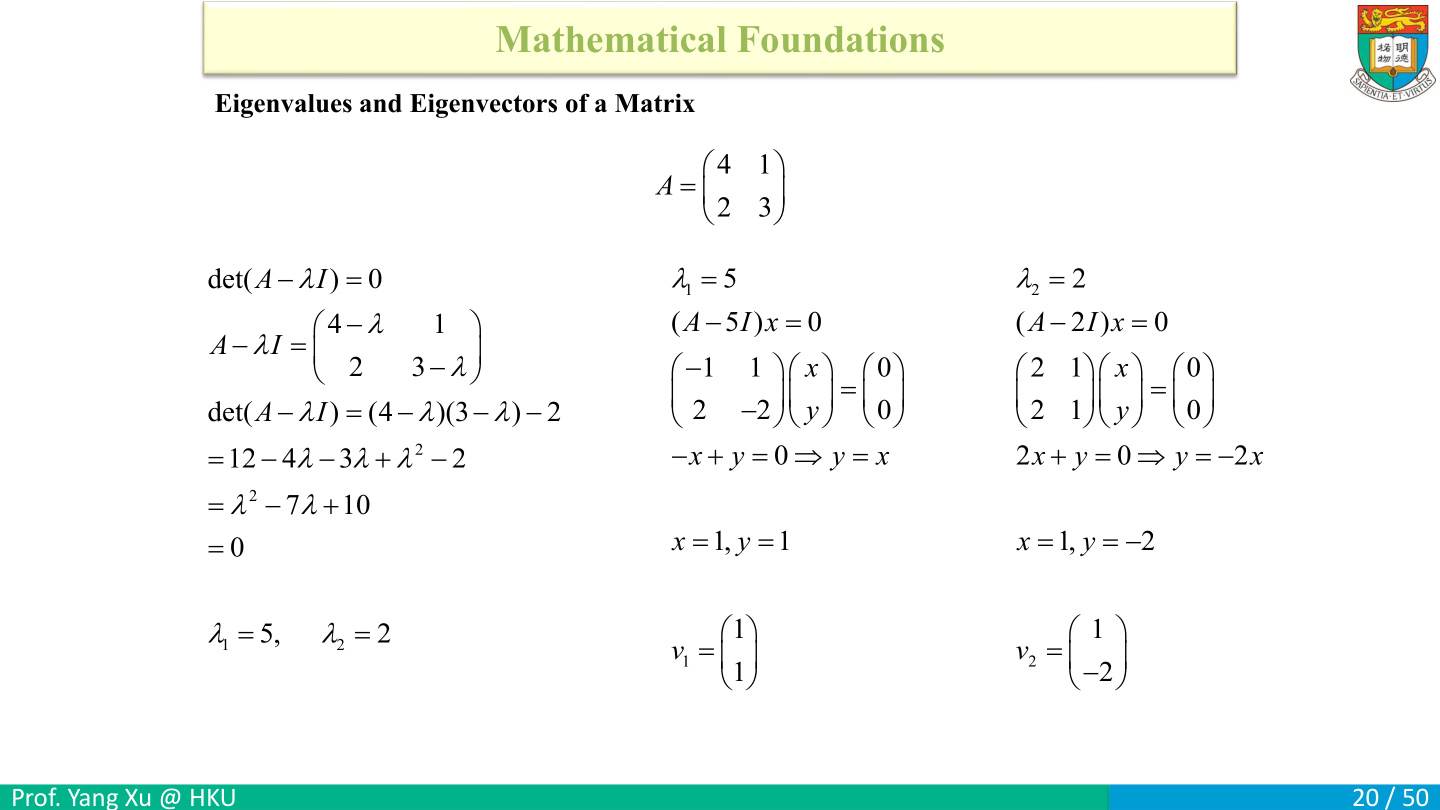
原矩阵 A=[[4,1],[2,3]]。A−λI=[[4−λ,1],[2,3−λ]],只在主对角线上减 λ。
二阶行列式的计算规则是 [[a,b],[c,d]] → ad−bc,所以本例为 (4−λ)(3−λ)−1×2。乘开得到 12−4λ−3λ+λ²−2=λ²−7λ+10。两个数 5 和 2 的和为 7,积为 10,因此可因式分解成 (λ−5)(λ−2)。乘积为 0,故 λ=5 或 λ=2。
| 代入的特征值 | (A−λI)v=0 的两行,v=(x,y)ᵀ | 解的关系 | 选一个非零向量 |
|---|---|---|---|
| 5 | −x+y=0,2x−2y=0 | y=x | x=1 得 v₁=(1,1)ᵀ |
| 2 | 2x+y=0,2x+y=0 | y=−2x | x=1 得 v₂=(1,−2)ᵀ |
每个 λ 下的两行都只给一个独立条件,所以可以自由选一个非零 x。代回原定义检验 A(1,1)ᵀ=(5,5)ᵀ=5v₁,A(1,−2)ᵀ=(2,−4)ᵀ=2v₂。同一向量乘任意非零倍数依然表示同一特征方向。
特征分解需要足够独立方向
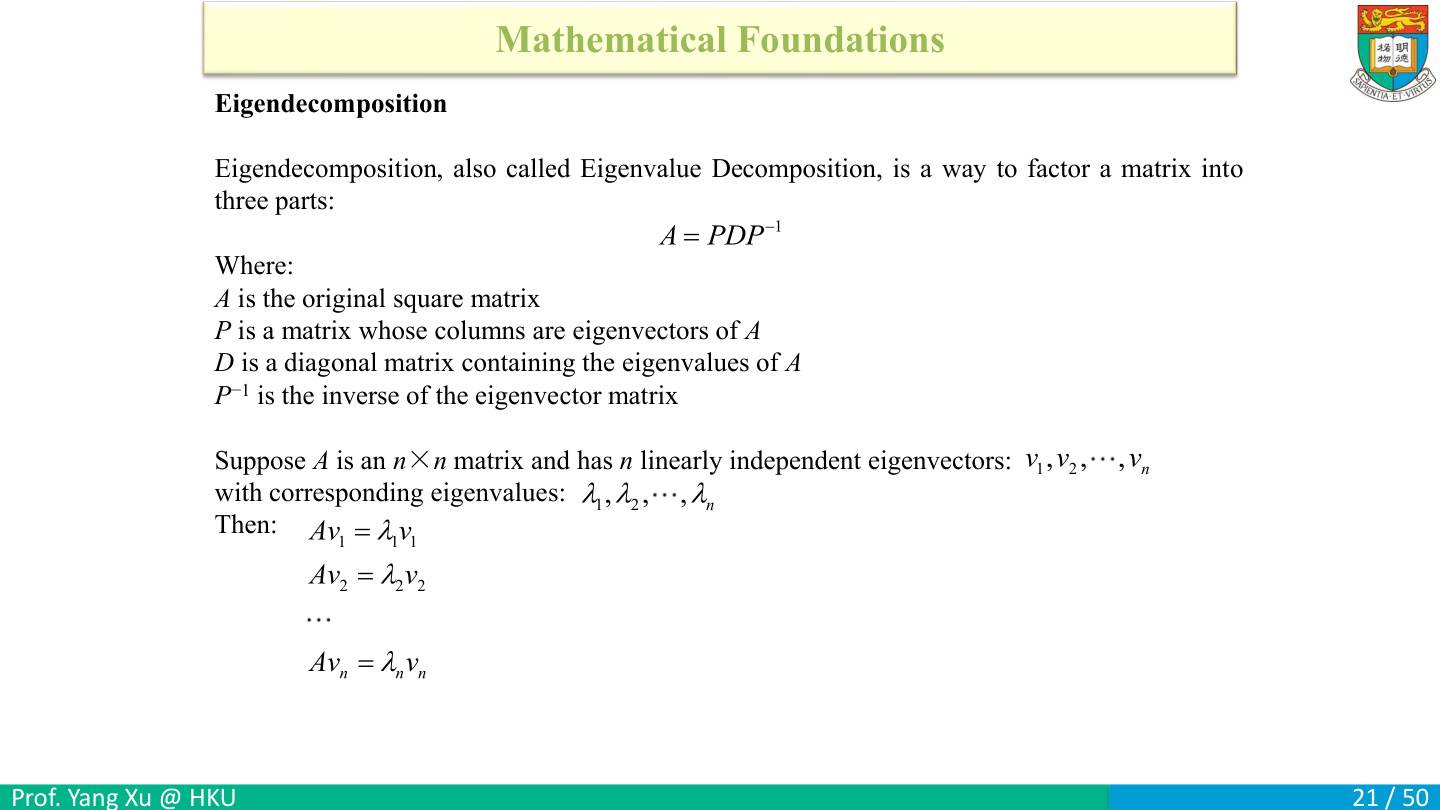
特征分解A=PDP⁻¹把一次变换拆成三步:P⁻¹换到特征向量坐标,D沿各特征方向缩放,P再换回原坐标。P的列必须是足够多的线性无关特征向量;n×n矩阵需要n个这样的方向。
前页A=[[4,1],[2,3]],取v₁=(1,1)ᵀ、v₂=(1,−2)ᵀ,特征值分别5、2。因此P=[[1,1],[1,−2]],D=diag(5,2);P的行列式1×(−2)−1×1=−3,逆为[[2/3,1/3],[1/3,−1/3]]。
用x=(1,0)ᵀ看三步到底做了什么。先设x=c₁v₁+c₂v₂,按坐标得到c₁+c₂=1、c₁−2c₂=0。第二式给c₁=2c₂,代入第一式3c₂=1,所以c₂=1/3、c₁=2/3。
| 阶段 | 运算 | 结果 |
|---|---|---|
| 换成特征坐标 | c=P⁻¹x | (2/3,1/3)ᵀ |
| 各方向缩放 | Dc=(5c₁,2c₂)ᵀ | (10/3,2/3)ᵀ |
| 换回原坐标 | P(Dc)=(10/3)v₁+(2/3)v₂ | ((10+2)/3,(10−4)/3)ᵀ=(4,2)ᵀ |
直接算Ax=(4,2)ᵀ,两种路线相同。D的顺序若交换,P的两列也要一起交换,才能让每个方向乘到自己的特征值。
有重复特征值也可能分解,例如单位矩阵可任选一组独立方向;关键是独立特征向量的数量。反例[[1,1],[0,1]]只提供一个独立特征方向,因此不能用这种方式对角化。
由列关系得到矩阵分解
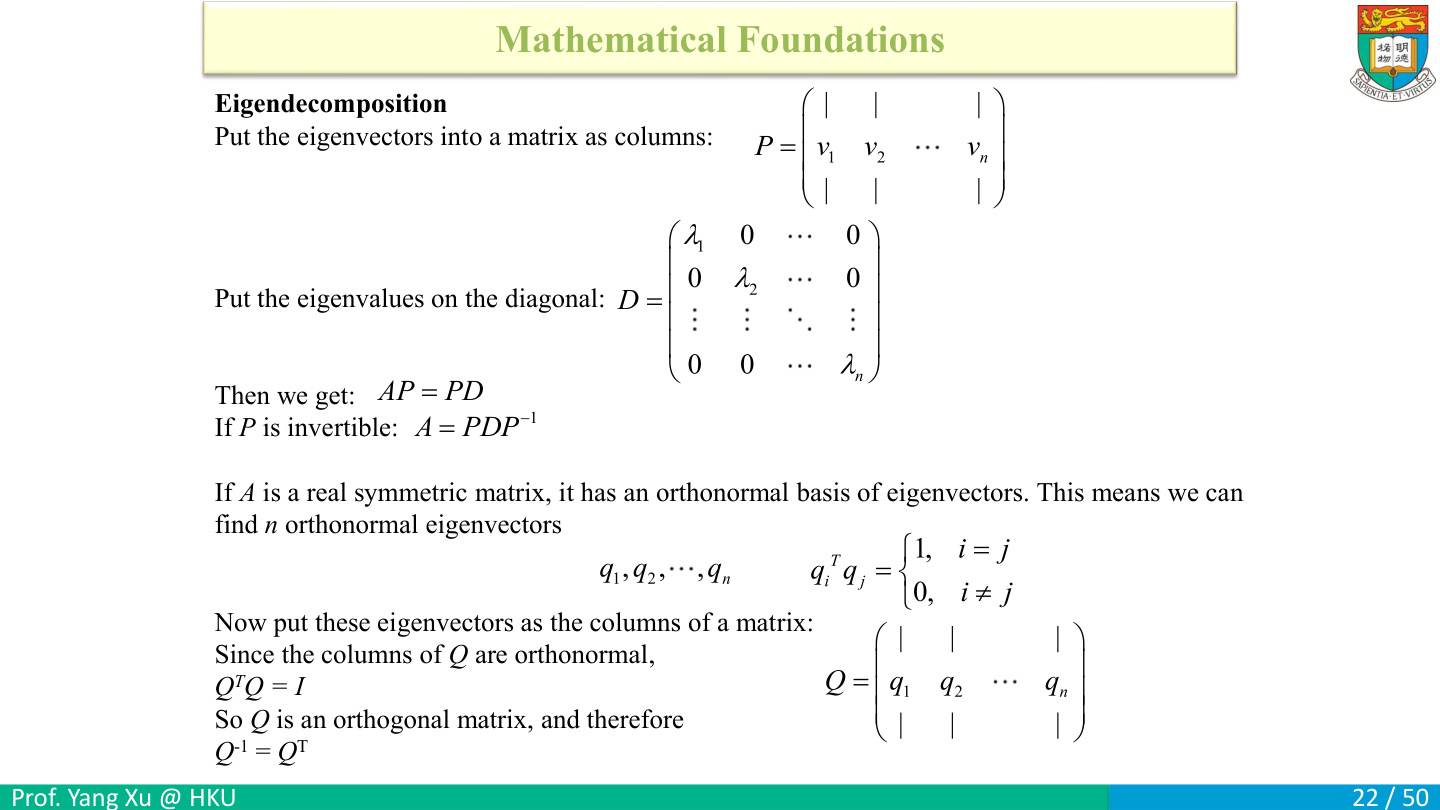
每列Av_i=λ_iv_i,按列排在一起得到AP=[Av1 … Avn]=[λ1v1 … λnvn]=PD。若P可逆,右乘P^−1便得A=PDP^−1。不能左乘P^−1后直接把乘积顺序交换,因为矩阵一般不交换。
若A为实对称矩阵,可选一组正交单位特征向量q_i,组成Q,满足q_iᵀq_j在i=j时为1、否则0,故QᵀQ=I。单位长度与相互垂直两件事都要满足。上一页非对称A的v1与v2内积−1,不能直接当作这种Q。
正交与归一分开做:例如(1,1)和(1,−1)内积1−1=0,已经垂直,但两者长度都是√2,尚未归一。每个向量除√2后,自己与自己内积1,和另一个内积0;把这些内积排成QᵀQ,恰好得到单位矩阵。因此Qᵀ可承担把坐标转回去的逆变换。
自测。P的列都是单位长度,能否立即说P⁻¹=Pᵀ?答案:不能,还需要列之间正交,且此处P为方阵。两个相同的单位列向量甚至会令P不可逆。回到公式时,AP=PD必须在右边乘P⁻¹,得到APP⁻¹=PDP⁻¹;乘法顺序不能任意改动。
正交特征分解的坐标解释
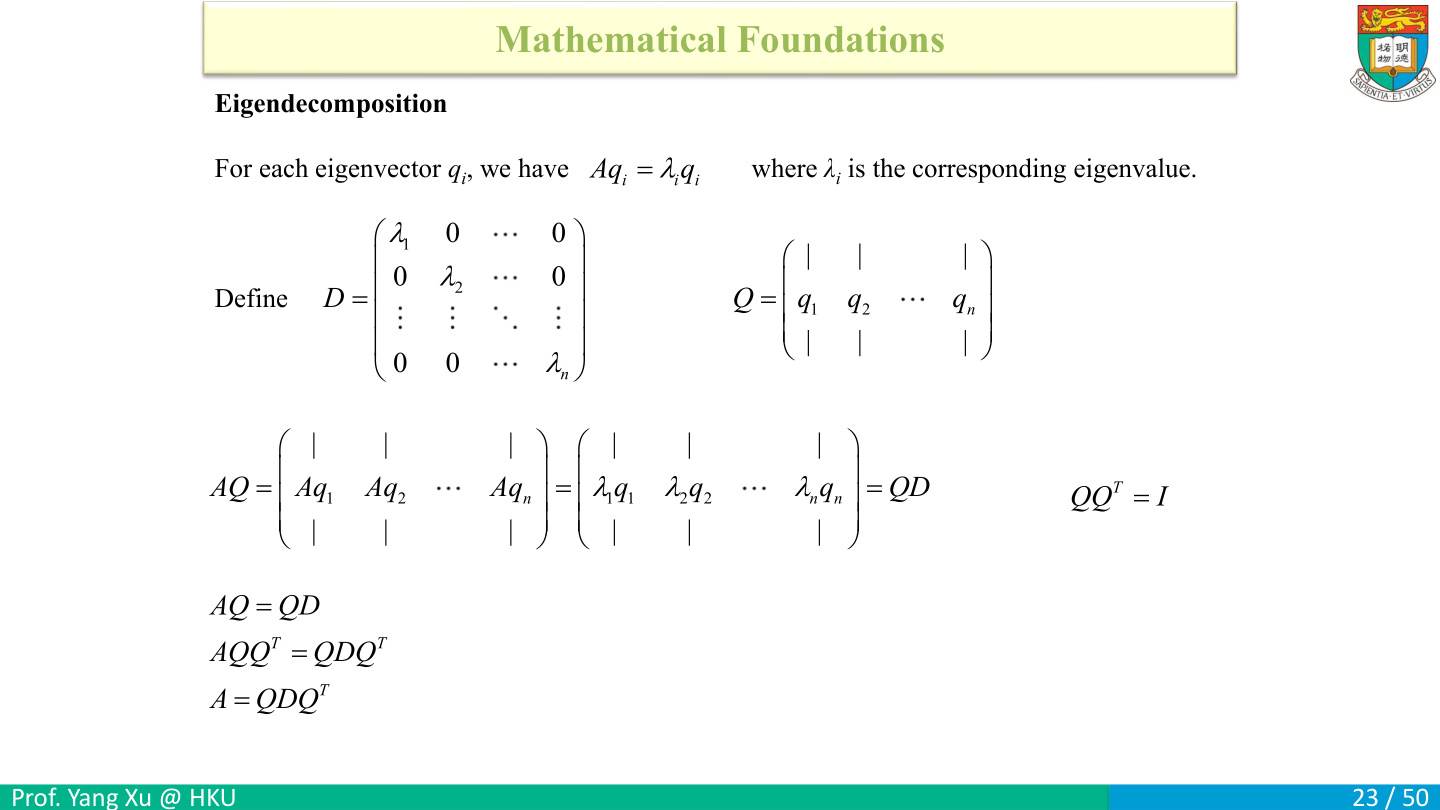
从AQ=QD右乘Qᵀ:AQQᵀ=QDQᵀ。方阵Q正交意味着QQᵀ=I和Q^−1=Qᵀ,所以A=QDQᵀ。Qᵀ先把原向量换到特征方向坐标,D沿各方向缩放,再由Q变回原坐标。
例子A=[[2,1],[1,2]],单位特征向量q1=(1,1)/√2,q2=(1,−1)/√2,特征值3和1。两列正交,故可写Q diag(3,1)Qᵀ。协方差矩阵是实对称矩阵,PCA就会使用这种分解;Q⁻¹=Qᵀ的依据是特征向量彼此正交且已归一化。
代入一个简单输入x=(1,0)。Qᵀx=(1/√2,1/√2);D再乘得到(3/√2,1/√2);最后Q组合成((3+1)/2,(3−1)/2)=(2,1),与A第一列一致。每一步都只做已认识的内积或缩放,所以QDQᵀ没有额外神秘操作。
自测。为什么实对称矩阵在本课反复出现?答案:XᵀX和协方差矩阵都实对称,因而可用这种正交特征分解研究哪些方向缩放大、哪些方向缩放为零。若A不是实对称,先检查是否满足相应条件,再选择一般PDP⁻¹或其他方法。
L1和L2范数怎样计算
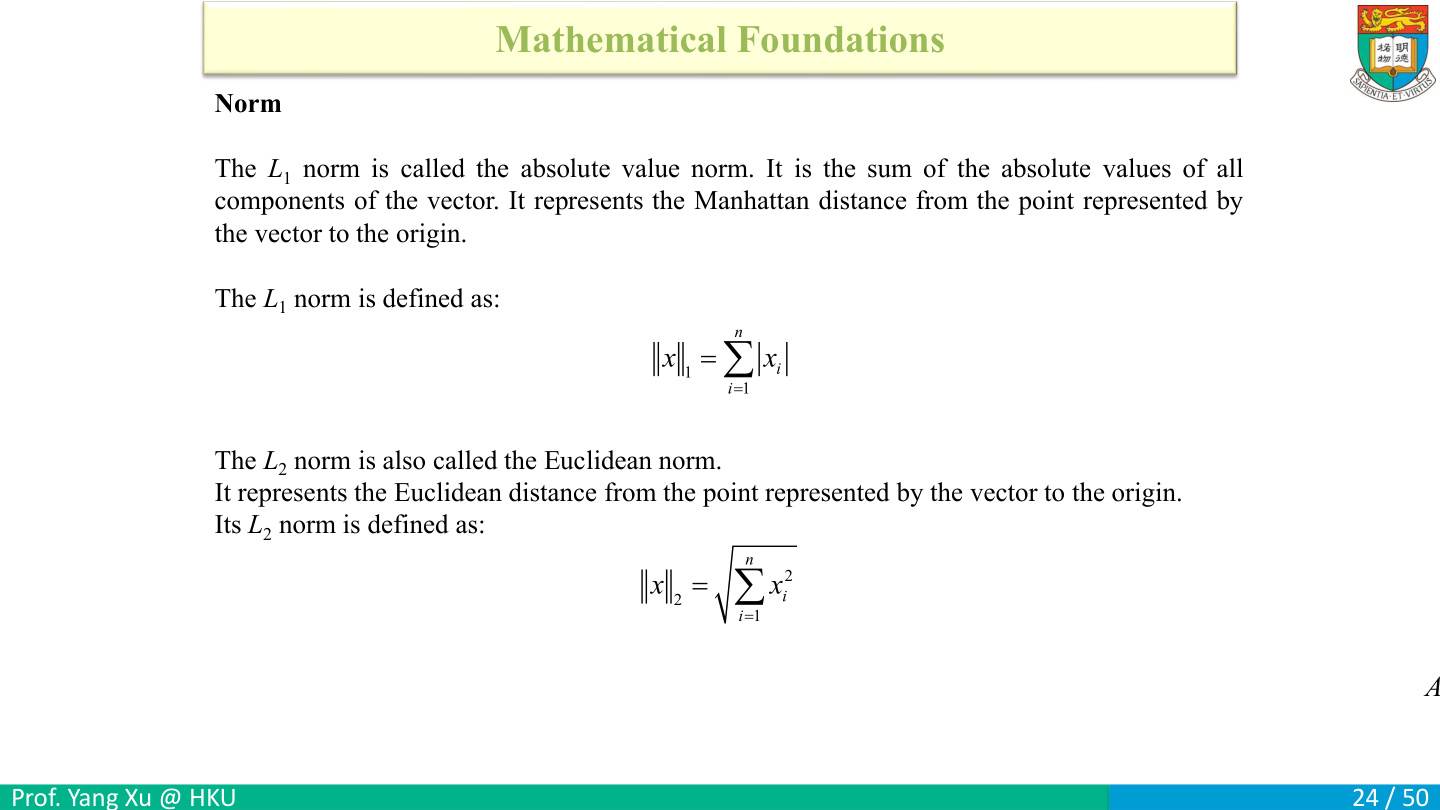
L1范数||x||1=Σ|x_i|,对应坐标格上的曼哈顿距离;L2范数||x||2=√Σx_i²,对应直线欧氏距离。距离两点a、b时应对差向量a−b取范数,而不是分别取大小再相减。
例子x=(−3,4),L1为3+4=7,L2为√(9+16)=5。平方L2范数为25,不是5;后续正则化中有无平方会改变导数。范数结果非负,不能因某一分量负而抵消。
计算两点距离时先做差。例子a=(1,2)、b=(4,6),a−b=(−3,−4),L₁距离=|−3|+|−4|=7,L₂距离=√((−3)²+(−4)²)=5。二维直角三角形的两边长3和4,直线斜边长5,而沿水平再竖直走总路程7;这是欧氏与曼哈顿的直觉。
自测。先算||a||₂再减||b||₂会不会也等于两点距离?答案:通常不会。例如a=(1,0)、b=(0,1),两长度都1,差为0,但两点距离√2。另一个易错点是“平方范数”:||a−b||₂²=25,开平方前后都可能在公式中出现,要看损失到底定义哪一种。
休息与复习
用前面的三个结果做一次短复习。
- Ax=0 有非零解时,零向量与这个解被 A 映到同一个输出,A 无法唯一还原输入。
- A=[[4,1],[2,3]] 的特征方程 (λ−5)(λ−2)=0,对应缩放倍数 5 和 2。
- 对 (−3,4),沿坐标走的 L₁ 长度是 3+4=7,直线 L₂ 长度是 √(9+16)=5。
按训练信号区分三类学习
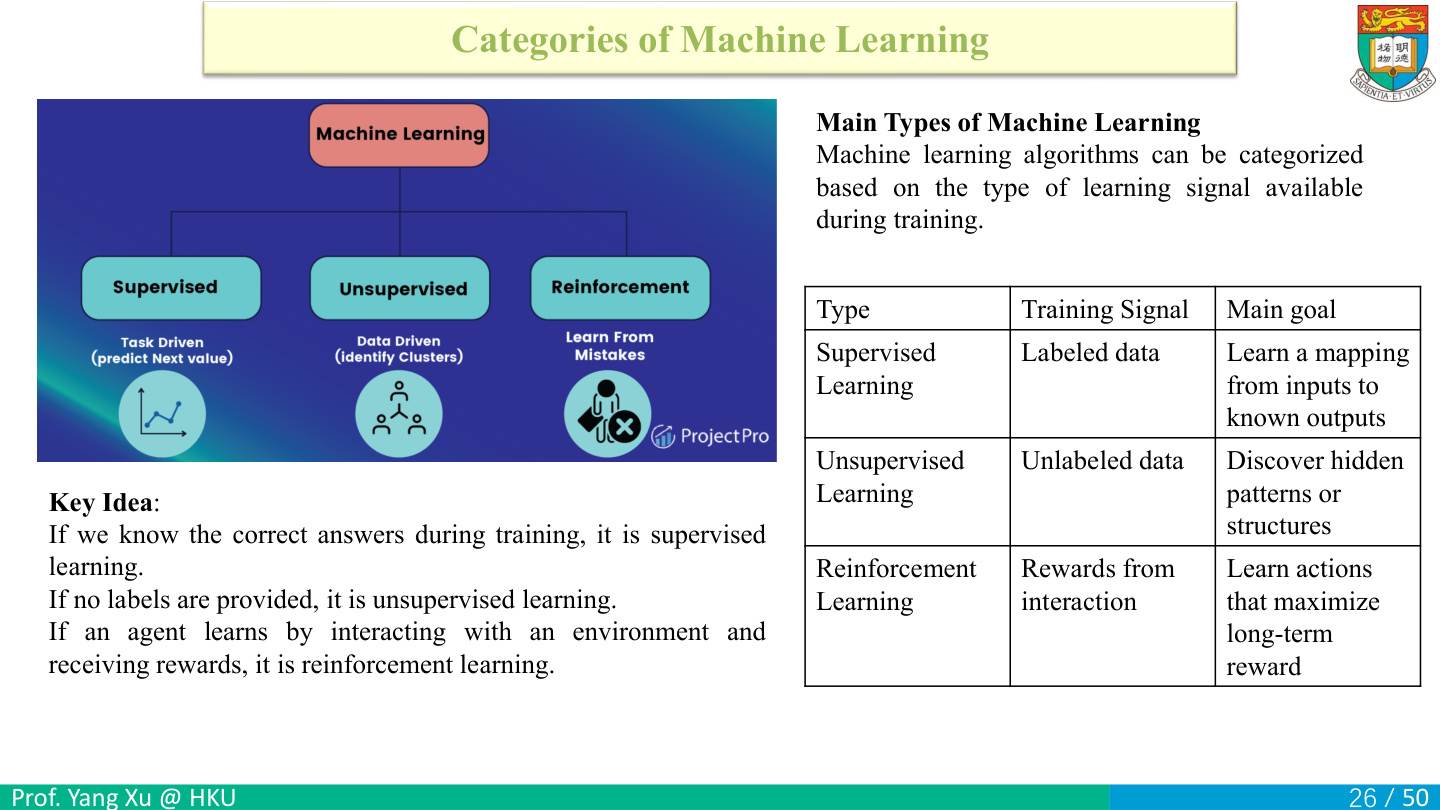
三类学习分别是监督、无监督、强化学习:分别从带标签样本、无标签数据、与环境互动所得奖励学习。分类依据是训练时获得的信号,不是算法是否使用神经网络。
例子:给传感器记录配“故障或正常”标签是监督学习;只按运行状态相似性分组是无监督;控制机器人动作并依据任务成功奖励改善策略是强化学习。同一系统可以同时用多种方法。
把同一个机器人例子分成三个训练设定。设每条输入x=(温度,振动):若每条都有人工判断y=正常/故障,就是监督学习;若只有这些x,程序自己按相似程度分组,就是无监督;若机器人根据状态选择动作a,随后收到任务得分r,再改善策略,就是强化学习。学习设定取决于训练信号,同一种输入可用于不同设定。
自测。强化学习的奖励1分等于“正确动作标签=1”吗?答案:不等于。标签通常直接告诉这一条样本的目标,奖励评价动作后果,还可能延迟出现。无监督也不等于“没有学习目标”:聚类仍需定义相似性,降维仍需指定保留信息的准则。先看训练信号,再看模型名字,是本页最可靠的分类方法。
漫画里的三种学习信号
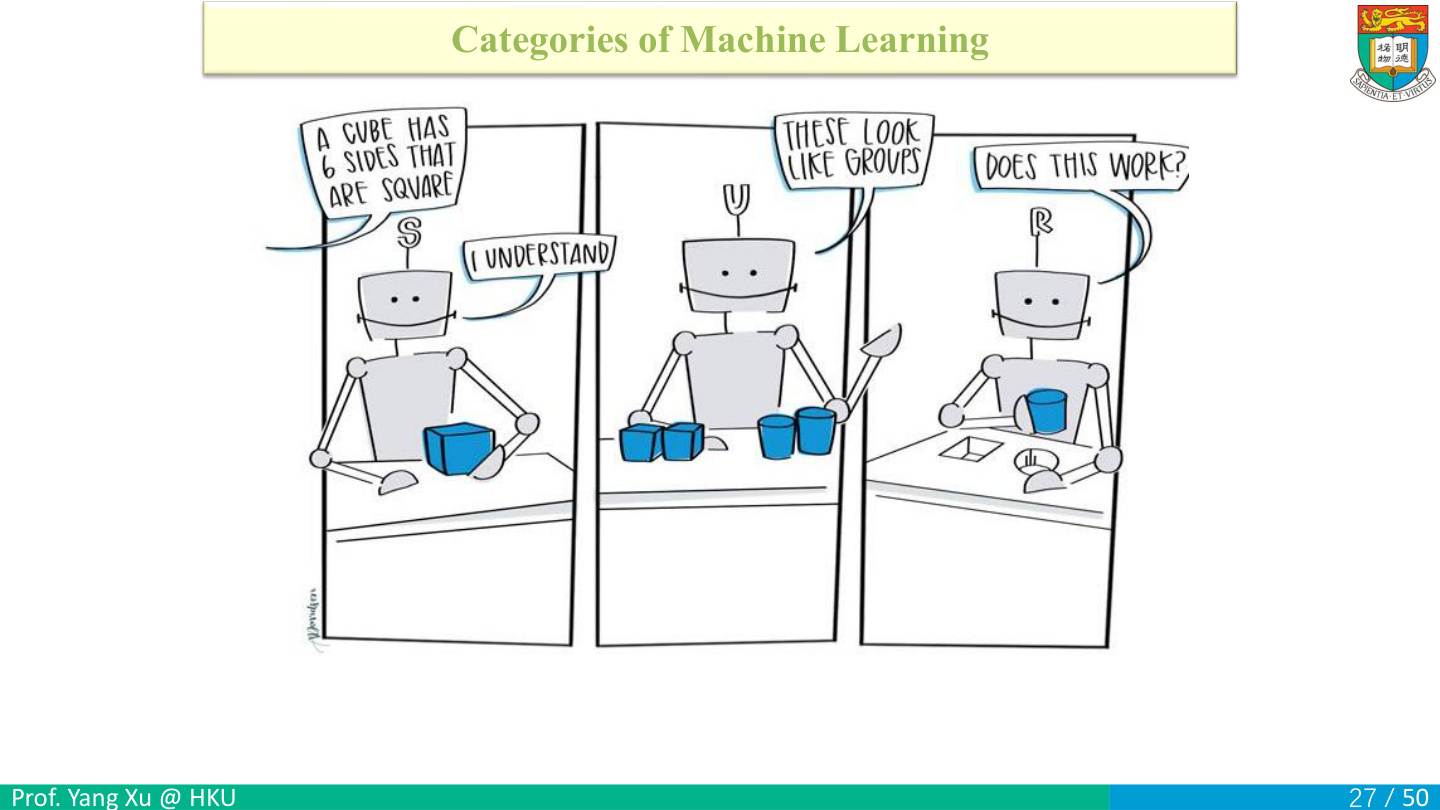
左图有人告诉机器人“立方体有六个正方形面”,对应监督标签;中图机器人把物体分组,对应从相似性中找结构;右图机器人尝试动作后问“这样有效吗”,对应强化学习的奖励反馈。区别在训练时得到什么信息:答案、数据结构,还是行动后果。
分类与回归看输出语义
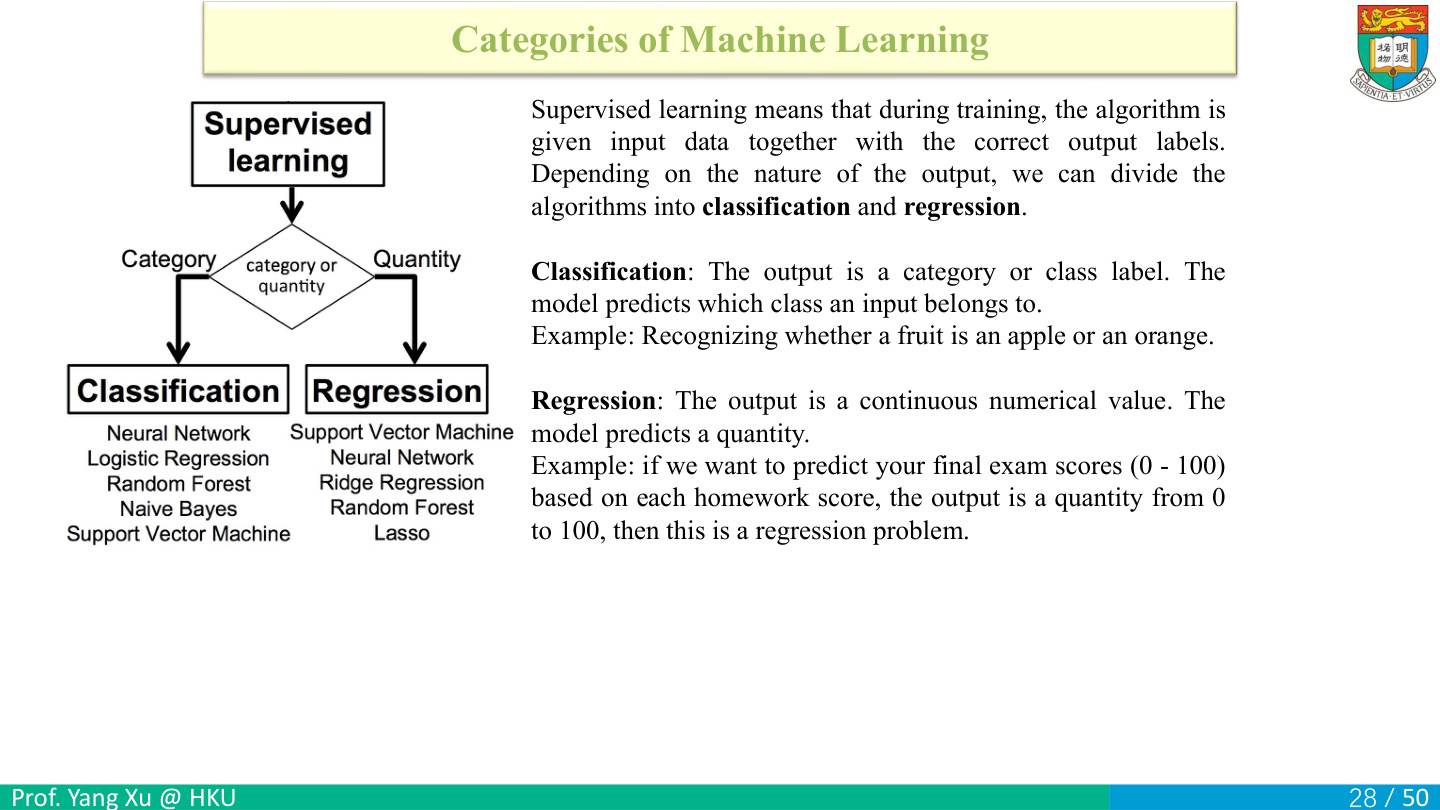
分类输出类别,例如苹果或橙子;回归输出连续数量,例如根据平时作业预测期末分数。输入可以同为向量或图片,不决定任务属于哪一种。
把猫狗编码成0、1仍是分类,因为数字是类别代号;预测概率0.8也不让任务自动变回归。反之,分数被限制0至100仍可以是回归。
判断回归还是分类,看答案在任务中代表什么,而不只看它是否写成数字。数字1、2、3若代表三种故障类型,就不能认为故障3是故障1的三倍;这是分类编码。温度23.7°C是具有大小、差值和单位的测量量,预测它属于回归。把温度再按阈值分成“正常/高温”时,则是对同一输入重新定义一个分类任务。
算一遍。真实类别编号是1,模型报3,不能用“只差2”来表达一般分类严重程度;先统计是否相等。真实温度20、预测23,则残差3°C可用于平方损失。自测预测“设备故障概率0.8”属于哪类任务?答案:分类模型的概率输出,最后仍要解决故障类别判断,不因概率连续就自动变成普通回归。
聚类与降维保留的结构不同
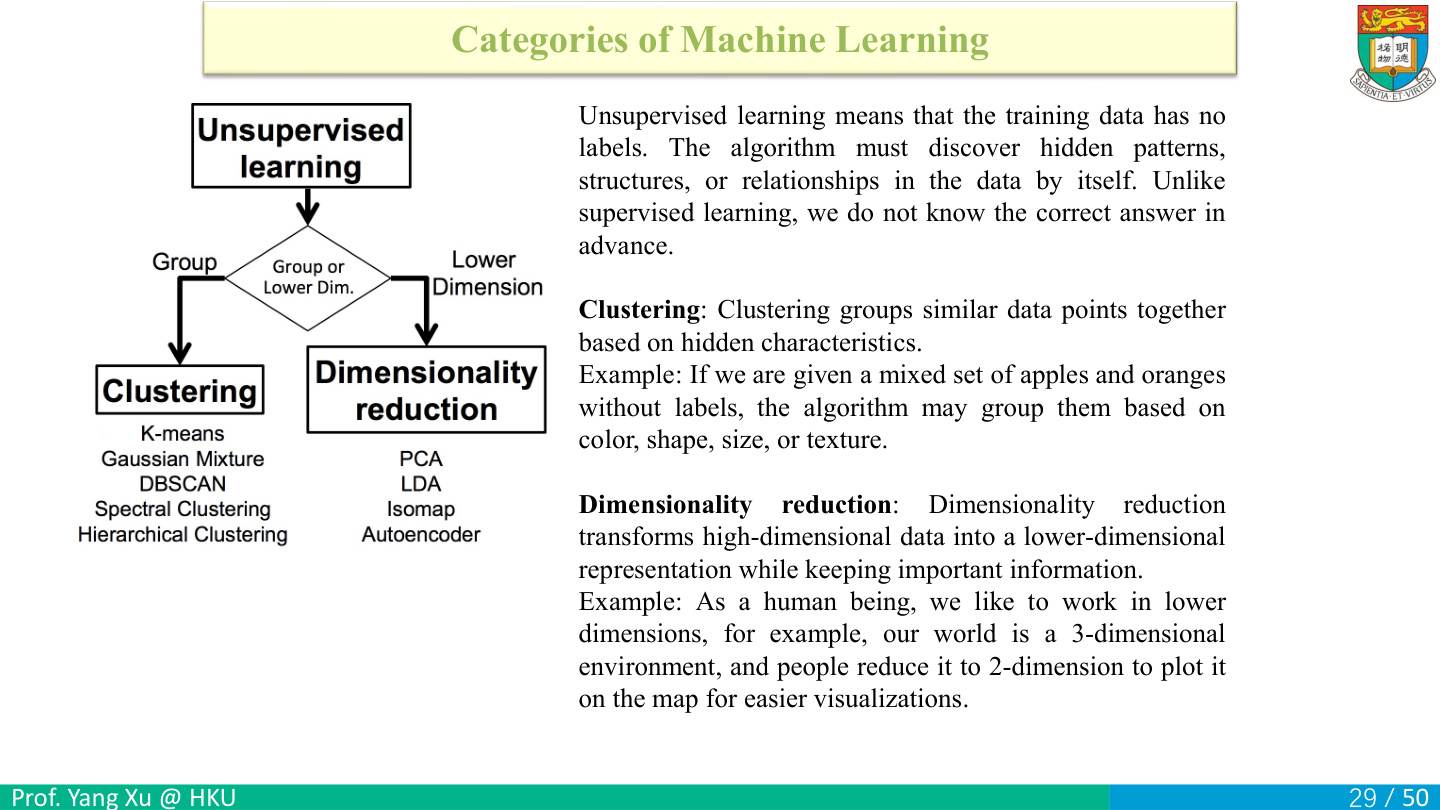
无监督学习的输入没有已知类别标签。聚类给每条样本分配一个组号,降维则为每条样本计算一组更短的坐标。
例如一条记录有三维:(电流、温度、振动)。聚类输出组号 A 或 B;组内记录按某种定义相似,可再结合设备工况理解各组。降维可以把同一条三维记录映射到两个坐标 (z₁,z₂),这两个数也可以是原来三个传感器量的组合。
用简单投影看信息如何丢失:取前两维时,(3,20,0.1) 和 (3,20,1.2) 都变成 (3,20)。投影后两点重合,但振动差异消失。若任务要发现高振动故障,应该检查降维方法有没有保留这项差异。
强化学习关注长期回报
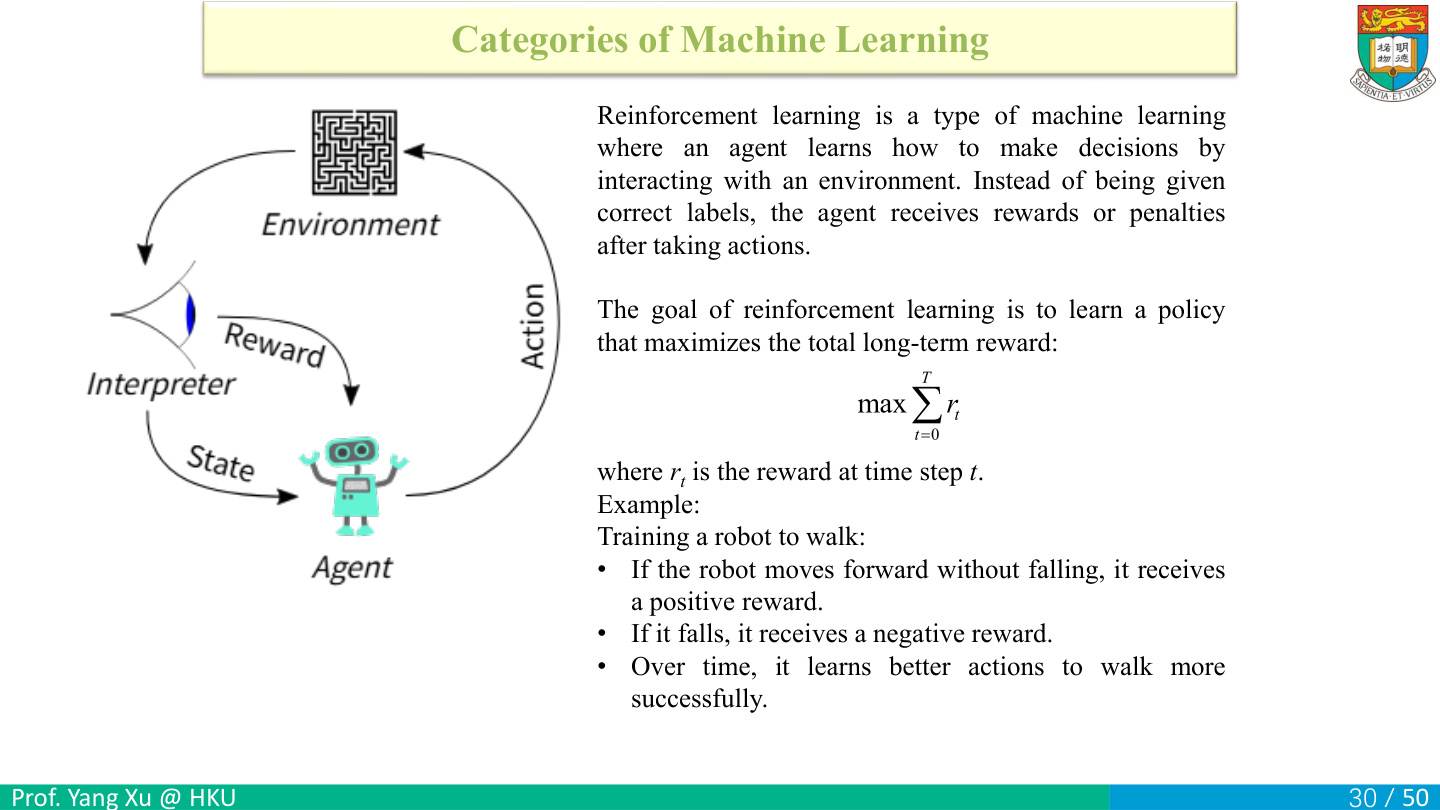
强化学习按「观察状态 → 选择动作 → 环境给出新状态与奖励 → 再选动作」循环进行。策略 π 是在不同状态下怎样选动作的规则;rₜ 表示第 t 步收到的奖励。
用课件的有限时段目标,先算每条路线的累计奖励 Σ_(t=0至T) rₜ,再寻找使累计奖励更高的策略。
| 第一步 | 即时奖励 | 第二步 | 后续奖励 | 总回报 |
|---|---|---|---|---|
| 直接靠近目标 | +1 | 跌倒 | −10 | −9 |
| 先绕路 | 0 | 安全到达 | +5 | 5 |
只看第一步会喜欢直接走,合计两步后会选绕路。奖励可以延迟,因此学习时需要把早先的动作与后来的结果联系起来。环境有随机性时,同一策略可能跑出不同总回报,通常用期望累计回报比较策略。
参数模型的固定维度
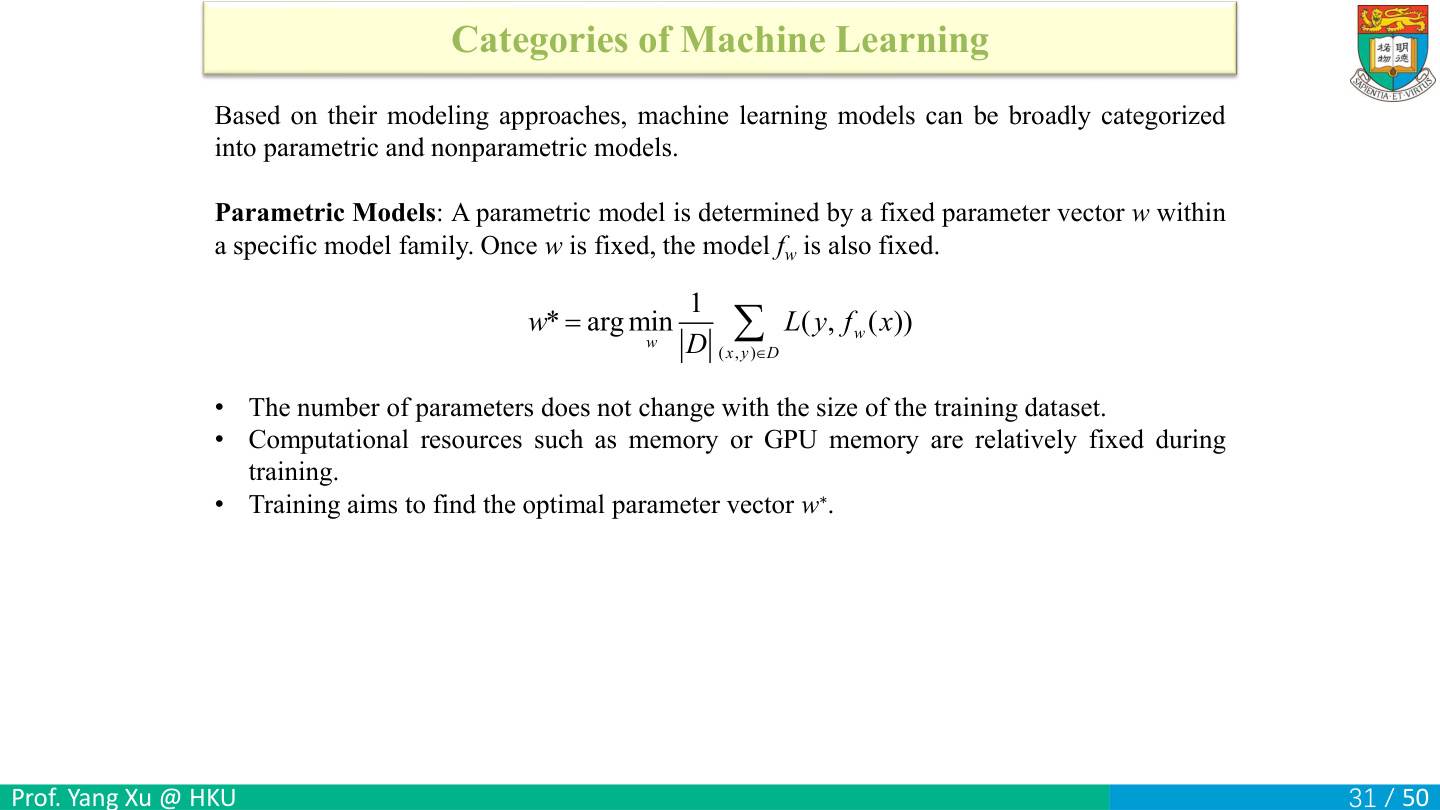
参数模型由固定维度向量w和给定模型族f_w确定。训练寻找w*=argmin_w (1/|D|)Σ_(x,y)∈D L(y,f_w(x))。argmin返回使目标最小的参数,不是最小损失那个数。
例如线性模型f_w(x)=w0+w1x,无论样本100条还是100万条,参数仍2个。这里固定的是模型参数规模;数据更多时,训练计算与数据存储仍会增加。
把argmin读成“让后面的损失最小的那个w”。例子只有两个候选参数w=1与w=2:若两者平均损失分别5与1,argmin返回w=2;min返回的才是损失数值1。星号w*表示使所定义目标最小的参数;这是优化问题里的最优解记号。
算一遍。模型ŷ=w₀+w₁x有两个参数。两样本(1,3)、(2,5),若取(w₀,w₁)=(1,2),预测分别3、5,损失0。再加第三条样本,不会自动增加第三个权重,这就是固定参数规模的含义。自测神经网络参数很多就一定是非参数模型吗?答案:不是,只要架构确定后参数数量固定,仍可按此定义视为参数模型。
非参数模型的规模与超参数
非参数模型复杂度可随数据量或分布增长,个别训练样本可能直接成为模型的一部分。非参数模型仍可以有超参数,也需要根据数据建立预测规则。
新增K近邻例:预测时保留训练样本,寻找最近的k个并投票;样本越多,保存和搜索的对象也增多。k本身仍是超参数。决策树也可随数据长出不同数量节点。按参数与非参数分类,和按监督与无监督分类是两条不同轴。
非参数模型可以理解为“模型能用多少细节,不预先锁死成固定长度权重”。KNN把样本本身当参考,新增一条样本可能新增一次可检索的参考;决策树是否增加分支取决于数据和限制。这里的“非参数”是统计建模术语,绝不等于没有数字或没有需要选择的设置。
练一练。KNN中的k=3,是训练自动求出的权重吗?答案:通常是先给定或用验证选出的超参数;它决定取几个邻居。若保存1000条784维图像,参考数据的数值量约784000;保存2000条就加倍。这与线性模型始终只有固定个权重不同,但预测计算和存储仍要依具体实现讨论,不能由名称直接判断快慢。
梯度和局部线性近似
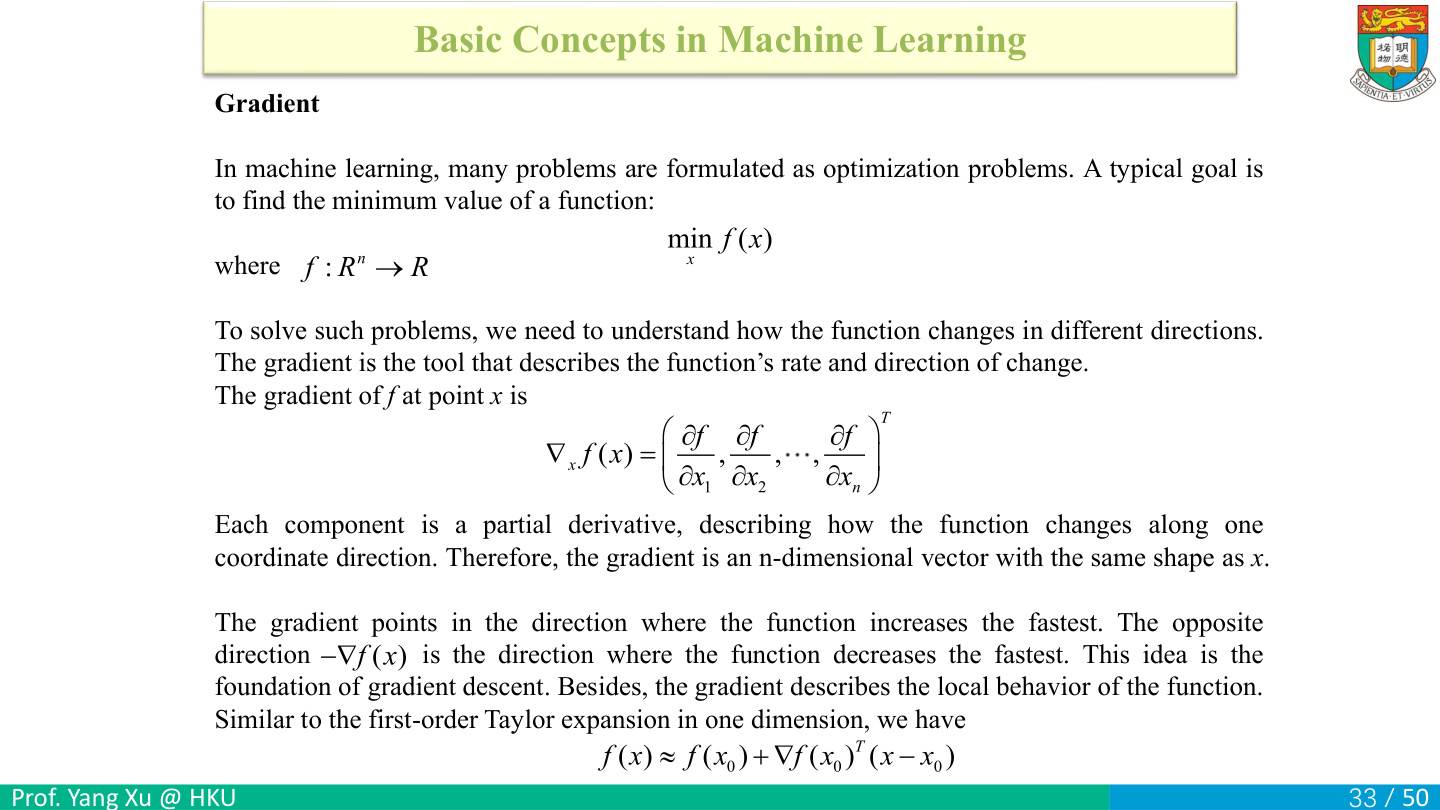
偏导数是在其余分量暂时不动时,只看一个坐标的变化率。梯度把所有偏导数排成列向量:∇f(x)=(∂f/∂x₁,…,∂f/∂xₙ)ᵀ,维度与x相同。
用f(x₁,x₂)=x₁²+3x₂²算一遍:
- 对x₁求导时把3x₂²当常数,得到2x₁。
- 对x₂求导时把x₁²当常数,3x₂²的导数为3×2x₂=6x₂。
- 在x₀=(1,2)代入,得到梯度g=(2×1,6×2)ᵀ=(2,12)ᵀ,原函数值f(x₀)=1+3×4=13。
位移Δ=(Δ₁,Δ₂)ᵀ时,一阶预计变化为gᵀΔ=2Δ₁+12Δ₂,故f(x₀+Δ)≈13+2Δ₁+12Δ₂。
| 移动方法 | 位移Δ | 一阶预计增加 | 实际增加 |
|---|---|---|---|
| 只将x₁加0.1 | (0.1,0) | 2×0.1=0.2 | 1.1²−1²=0.21 |
| 只将x₂加0.1 | (0,0.1) | 12×0.1=1.2 | 3(2.1²−2²)=1.23 |
两次移动步长相同,x₂方向变化更大,与第二个偏导12大于2一致。近似与实际之间的0.01、0.03来自省略的二阶项。
固定一个很小的欧氏步长时,梯度方向的一阶增加最大,负梯度方向的一阶下降最大。公式用≈,表示用局部直线近似曲面;步子较大时要重新看高阶变化。
单样本损失如何加成总目标
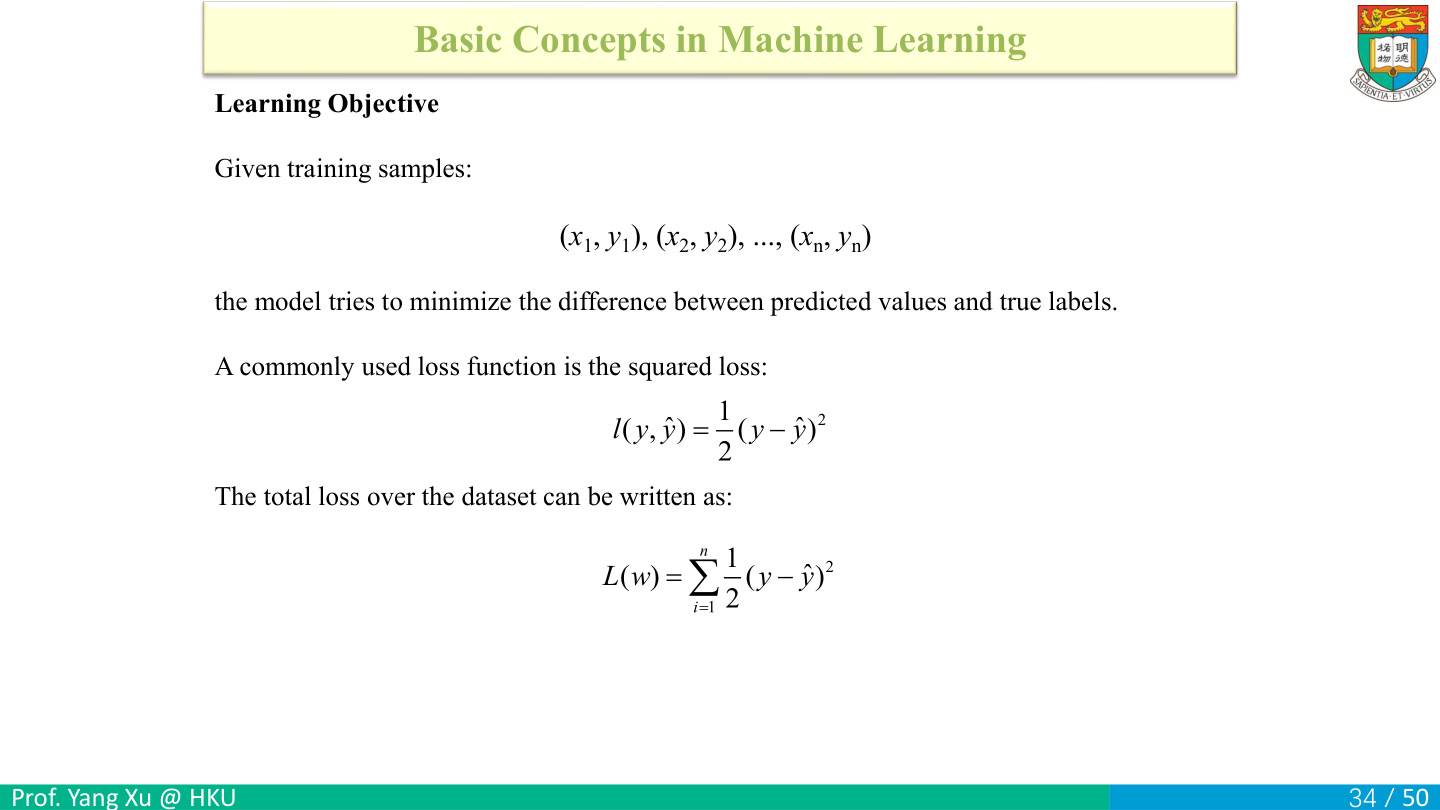
单条样本的半平方损失是 ℓ(y,ŷ)=(ŷ−y)²/2。第 i 条输入 xᵢ 经模型给出 ŷᵢ=f_w(xᵢ),再与固定的真实值 yᵢ 比较。
| i | 真实值 yᵢ | 预测 ŷᵢ | 残差 ŷᵢ−yᵢ | 单条损失 ℓᵢ |
|---|---|---|---|---|
| 1 | 2 | 1 | −1 | (−1)²/2=0.5 |
| 2 | 5 | 7 | 2 | 2²/2=2 |
总损失 L=Σᵢℓᵢ=0.5+2=2.5。平方过后,高估和低估都贡献正的损失,下页再把总损失除以样本数。
求导时令 u=ŷ−y。由 ℓ=u²/2 得 dℓ/du=u,又因 y 固定有 du/dŷ=1,于是 dℓ/dŷ=u×1=ŷ−y。若在求参数 w 的梯度,还要再乘 ∇w ŷ。例如 ŷ=wx 时,乘上的就是输入 x。
MSE的系数约定与量纲
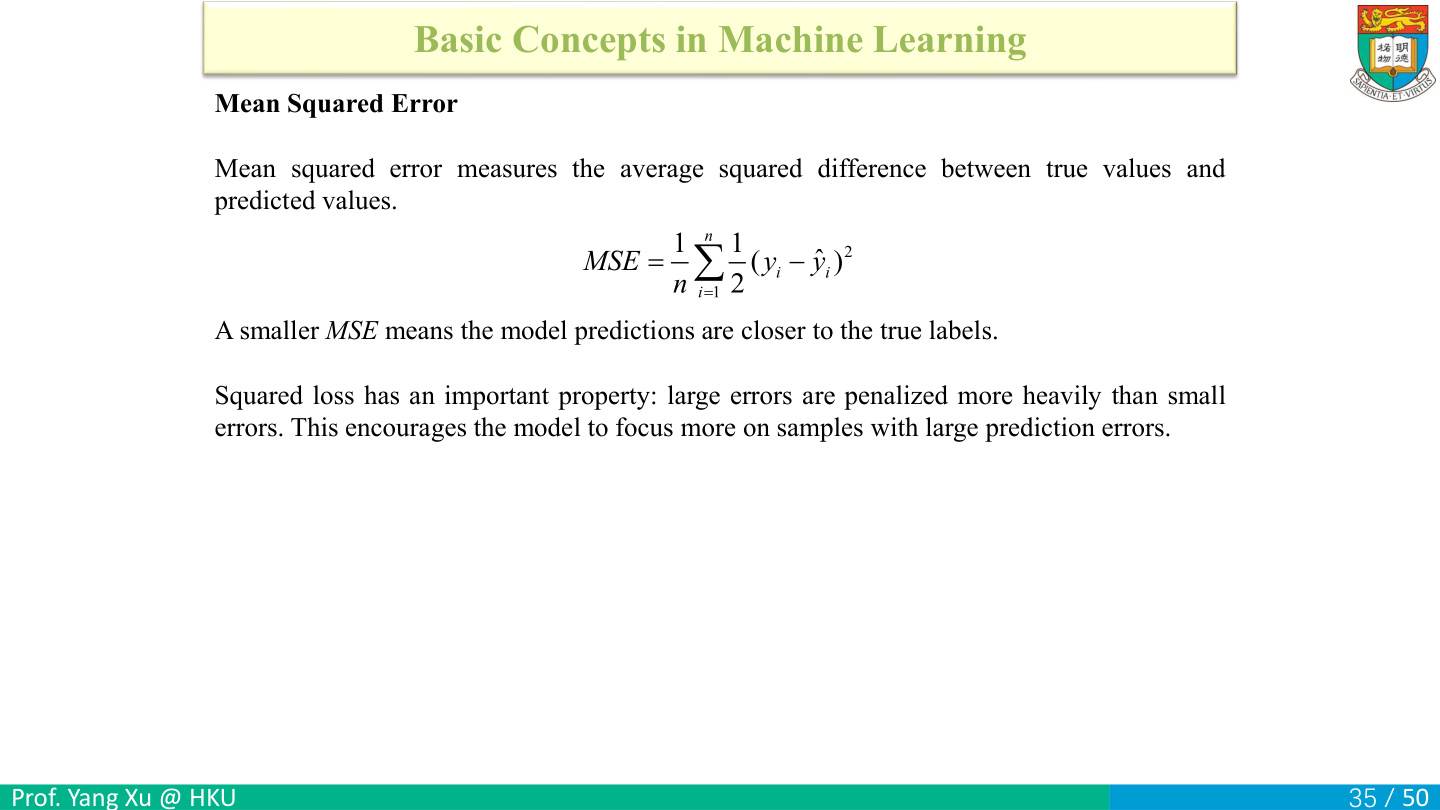
这里的MSE=(1/n)Σ_i [1/2(y_i−ŷ_i)²],即半均方误差;常见MSE定义不含1/2。两者最优参数相同但数值与梯度相差2倍,所以比较报告和学习率时必须说明约定。
续前例n=2,半MSE约定得到2.5/2=1.25,通常MSE为5/2=2.5。误差单位若是安培,平方误差单位是安培平方。误差从1变2,惩罚从1变4,解释了大误差为何受更重惩罚。模型对新数据的表现用验证误差检查。
平均化用来消除样本数对数值规模的直接影响。若同一批样本复制一遍,总损失翻倍,平均损失保持不变;它并不因为重复数据而自动获得更多新信息。课件的1/(2n)与常见1/n只差常数,但训练步长受梯度整体尺度影响,读代码时要确认到底在哪一步做了除法。
练一练。两条残差1和3,常见MSE=(1²+3²)/2=5;本页半MSE=2.5;均方根误差RMSE=√5,三者不能混报。若误差单位是°C,MSE单位°C²,RMSE回到°C。平方对较大误差更敏感:把残差3降到2,平方项减少5;把1降到0只减少1。它鼓励纠正大误差,也容易受异常大值影响。
梯度下降的一次更新
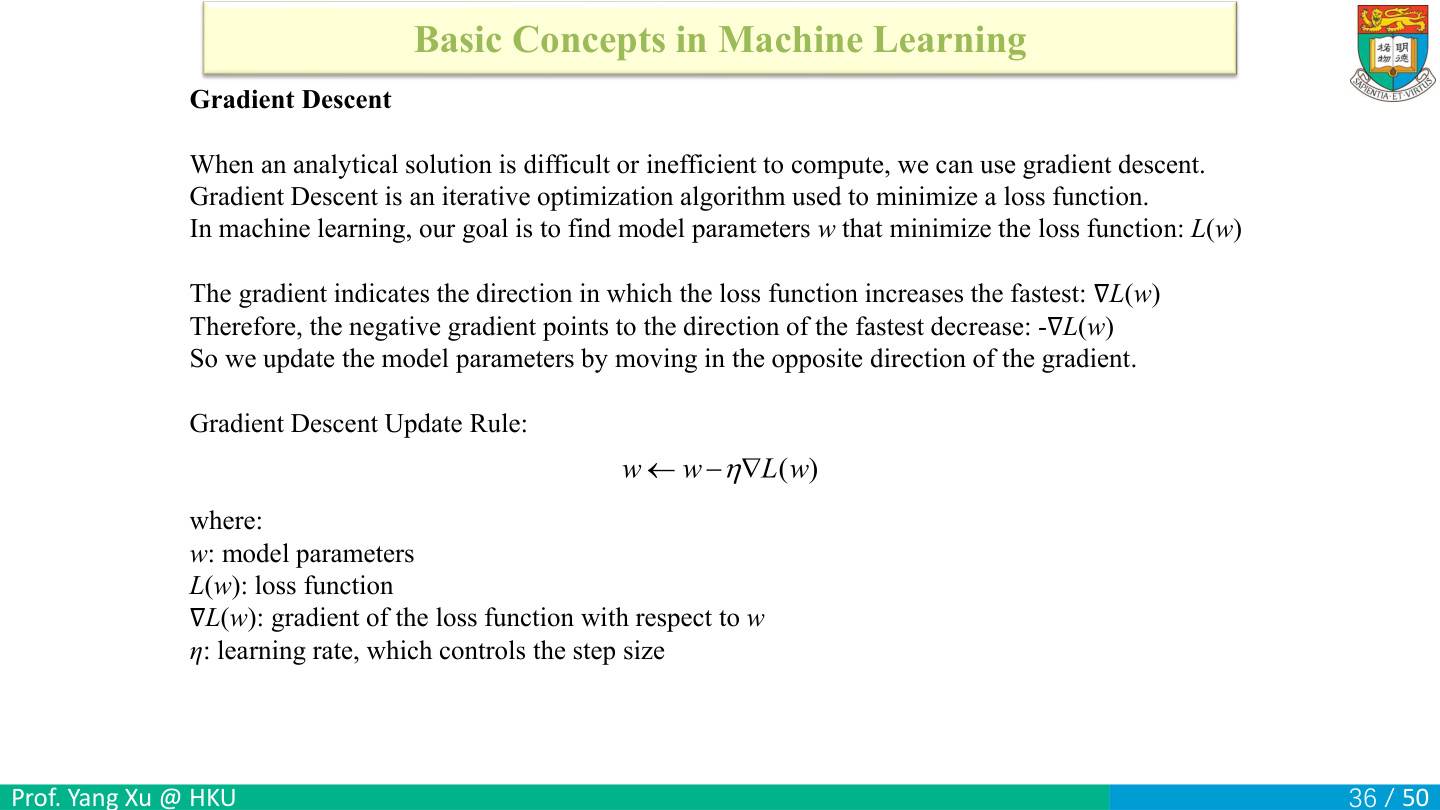
w←w−η∇L(w),η>0是学习率,w是待学习参数。箭头表示用右侧旧值计算后替换左侧,而不是代数恒等式。每次一般先预测、计算损失、求梯度,再更新;需要重新计算梯度,不能把第一次梯度一直复用。
一维例子L(w)=1/2(w−3)²,梯度w−3。若初始w=0、η=0.5,则新w=0−0.5(−3)=1.5,损失从4.5降到1.125。下一次梯度变−1.5。
将箭头当作一次计算操作:先存旧w,计算g=∇L(旧w),再算新w=旧w−ηg。多维时所有分量的梯度都来自同一个旧位置,而不是改完第一个参数后又用半新半旧位置改第二个。学习率η控制沿该方向走多远,梯度提供方向及局部变化率,两者角色不同。
算一遍。L(w₁,w₂)=1/2[(w₁−2)²+(w₂+1)²],初始(0,0),梯度(−2,1)。η=0.1时新参数为(0.2,−0.1):第一个增加、第二个减少,不是所有参数都向负数移动。自测“减梯度”是否必然使每个w变小?答案:否,梯度若为负,减负数会增加参数,关键是降低损失。
由泰勒式得到下降方向
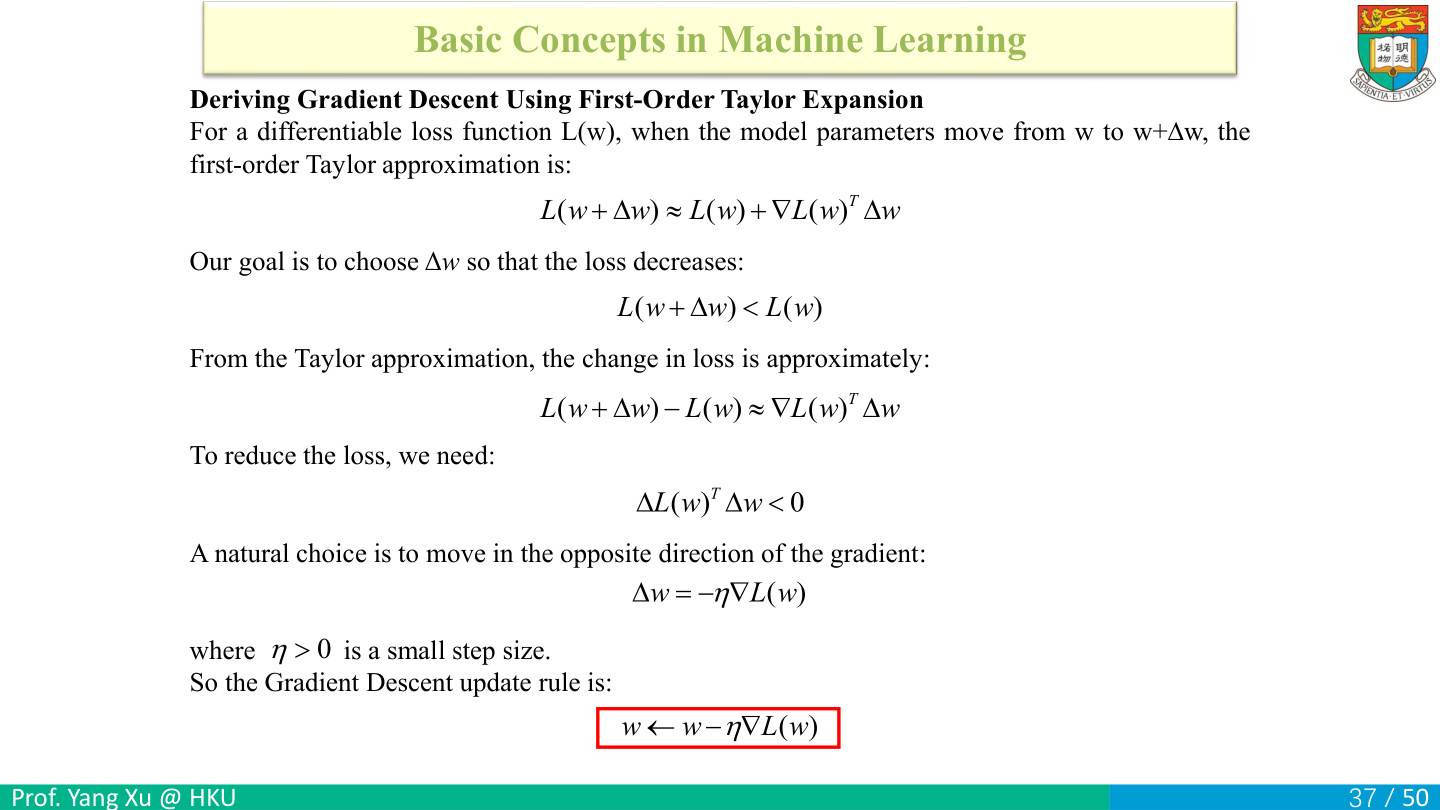
L(w+Δw)−L(w)≈∇L(w)ᵀΔw。取Δw=−η∇L(w),内积等于−η||∇L(w)||²,在η>0、梯度非零时严格负。因此小步下有下降趋势,更新得到w_new=w−η∇L(w)。
一阶变化量是∇L(w)ᵀΔw:梯度提供每个参数方向的变化率,与位移作内积后才得到标量损失变化。由于泰勒只是一阶近似,还存在高阶项;步太大时这些项可能抵消下降,所以这不是任意η都保证降低的证明。
把下降证明中的每个量对齐:g=∇L(w)是d×1列向量;Δw也是d×1;gᵀΔw是1×1的标量。取Δw=−ηg后,gᵀΔw=−ηgᵀg,gᵀg=Σgⱼ²≥0。只要g不全零且η>0,这个一阶项就小于0,因此负梯度是局部下降方向。
练一练。若g=(3,4)、η=0.01,一阶预计损失变化多少?答案:−0.01(9+16)=−0.25。若g=0则该项为0;不能从这一点立即判断已到全局最小,可能是局部最小、局部最大或鞍点,还需要函数结构信息。平方损失的凸性在后续回归中帮助判断全局性质,这里仅讲一般可微函数的局部原理。
学习率过大时为何越走越远
动手试试 · 改变学习率,走一步梯度下降
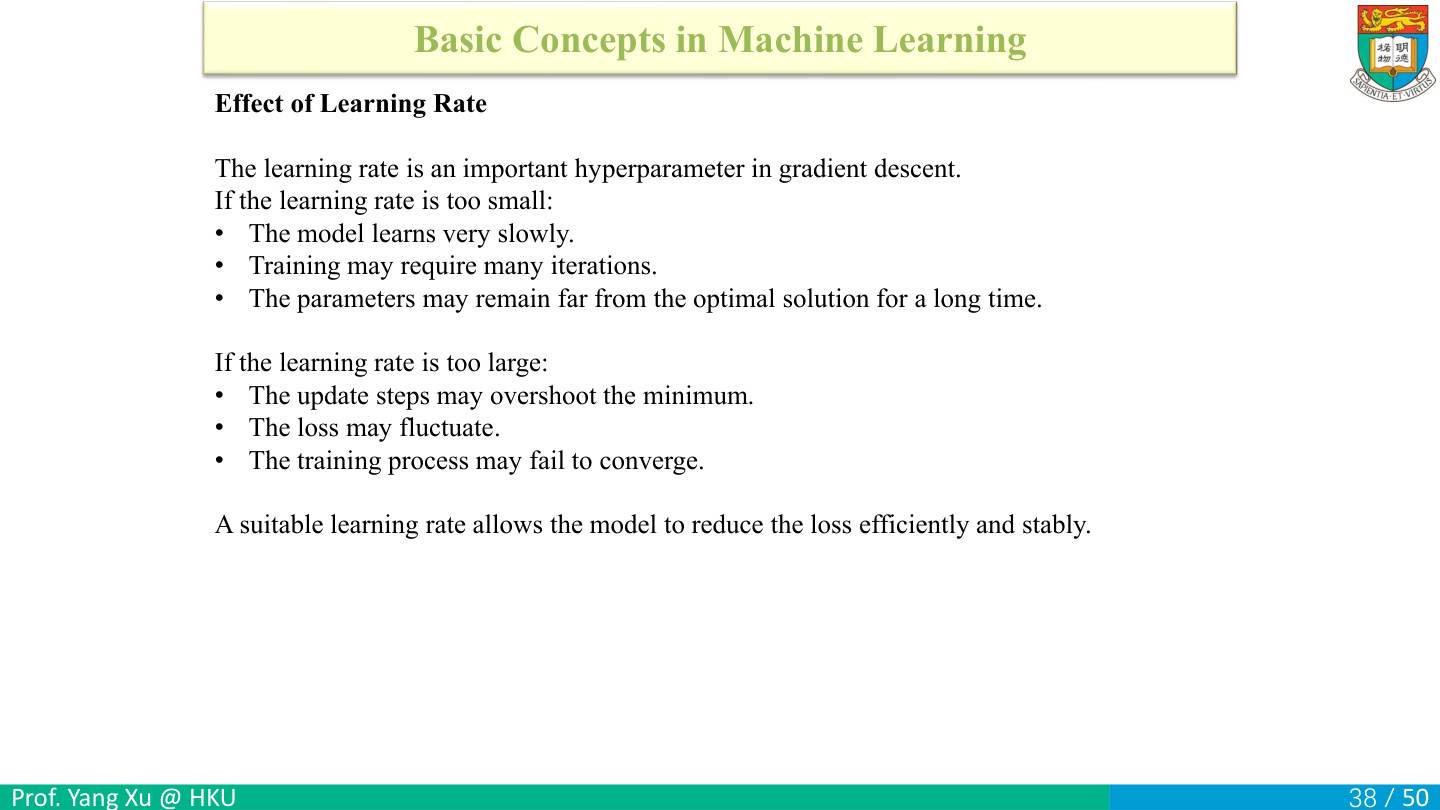
以 L(w)=(w−3)²/2 为例,最低点在 w=3,梯度是 w−3。令 e=w−3 表示离最低点的带符号误差。从梯度下降式直接移项:
w_new−3 = w−η(w−3)−3 = (1−η)(w−3)。
所以 e_new=(1−η)e。若旧误差非零,误差要缩小就需 |1−η|<1。写成 −1<1−η<1,解得 0<η<2。
| 从 w₀=0 出发 | w₁=w₀−η(w₀−3) | w₂=w₁−η(w₁−3) | 现象 |
|---|---|---|---|
| η=0.1 | 0.3 | 0.57 | 每步接近一点 |
| η=1 | 3 | 3 | 一步到最低点 |
| η=2 | 6 | 0 | 在最低点两侧等幅振荡 |
| η=3 | 9 | −9 | 每步将误差的绝对值放大 2 倍 |
若损失整体乘 c>0,梯度也乘 c,误差乘子随之变成 1−ηc。例如 c=100 时,同样的稳定条件给出 0<η<0.02。学习率要配合梯度的尺度,这个具体区间来自本例的曲率。
区分规律与噪声
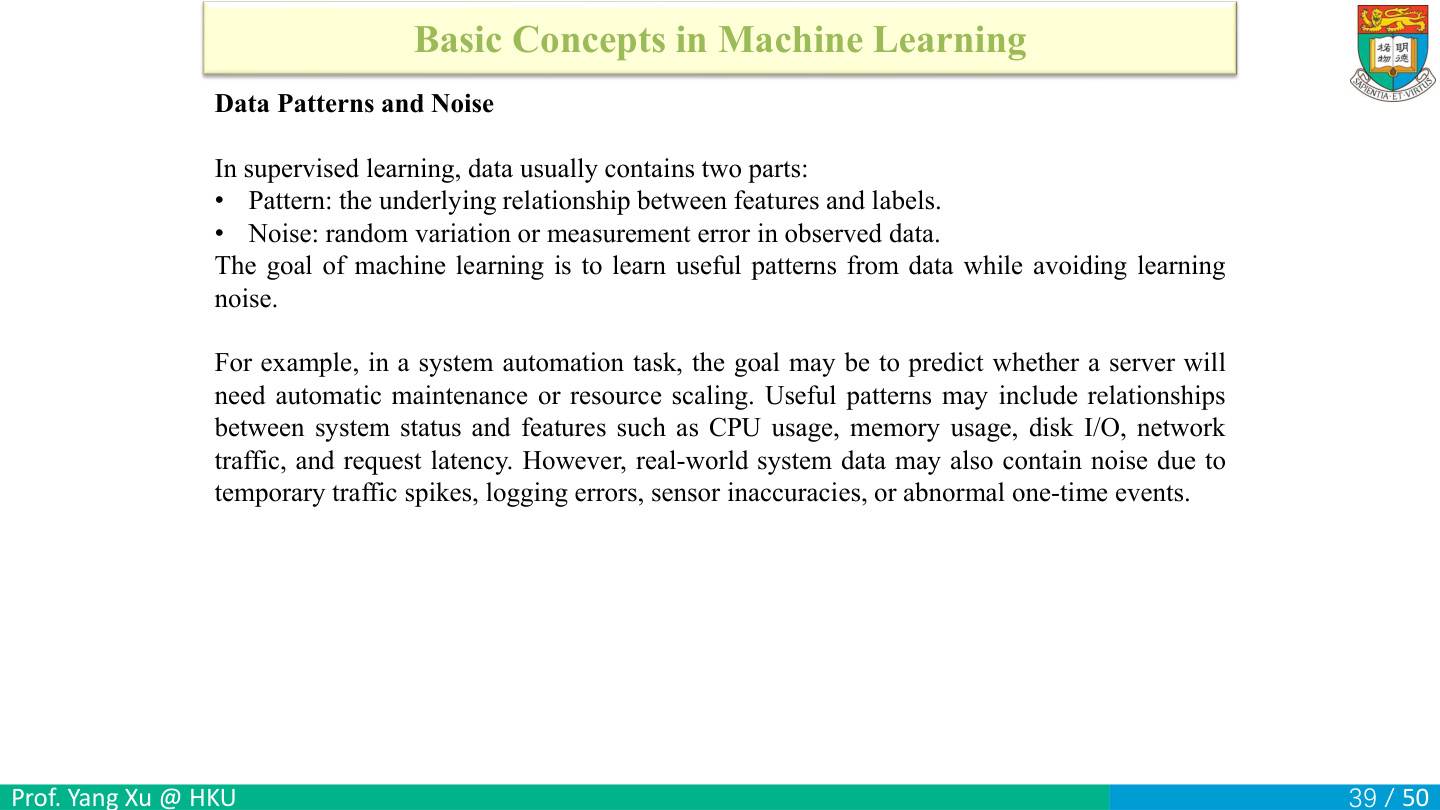
监督数据包含可重复规律和随机变化或测量误差。自动维护例可用CPU、内存、磁盘I/O、网络流量和延迟等特征;短暂流量峰值、日志错误、传感器误差或一次性事件可能形成噪声。
不能仅凭异常就认定噪声:真正故障也可能罕见,需结合任务和证据。例子:温度读数偶然跳到不可能范围可检查传感器;高温连续出现并伴振动则可能是有效信号。训练目标是学可泛化关系,而非逐条背住所有波动。
把一个测量写成“可重复规律+误差”是为了区分模型能学什么。例如真实温度趋势为20+2t,传感器有±0.2波动:多次记录可能学到斜率约2,却不应试图预测每次独立随机波动的具体正负。噪声可能随工况改变,也可能在时间上相关,可以结合传感器与测量过程判断其结构。
练一练。某条高振动记录很少见,是否删掉就能减少过拟合?答案:不能仅凭少见就删。它可能是重要故障,删除后反而失去需要学习的模式。先查看设备工况、传感器和标注依据,再决定清洗。模式与噪声的区别会影响后面欠拟合、过拟合判断,也解释了为什么训练误差不一定应追到0。
欠拟合的表现与排查顺序
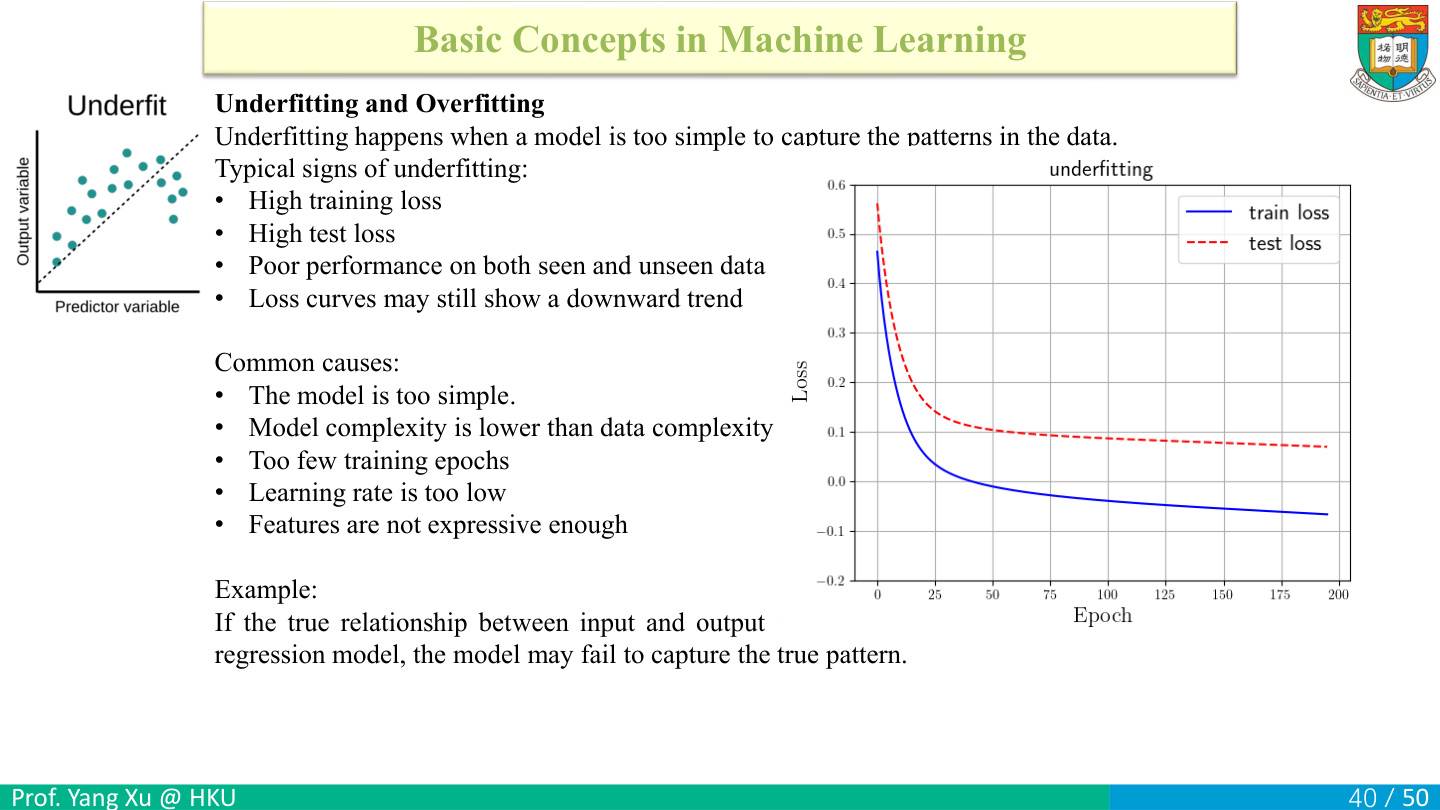
左图的虚线是一条直线,蓝点整体带有弯曲趋势。直线很难同时贴合曲线的两侧。右图横轴是训练轮数 Epoch,纵轴是损失 Loss;蓝色训练曲线和红色测试曲线起初都会下降,后期仍分别停在有误差的位置。这是训练样本也没有拟合好的示意。
用三个无噪声点看表达能力。真实关系 y=x²,在 x=−1、0、1 时,目标是 1、0、1。若直线 ŷ=a+bx 要命中左右两端,就要满足 a−b=1、a+b=1,相减得 2b=0,再代回得 a=1。这样中心 x=0 的预测是 1,真实值却是 0。模型没有 x² 项时,继续调参数也无法同时命中三点。
如果模型中已有 cx²,例如 a=b=0、c=1 就能命中三点。若训练和验证误差仍高,就再检查参数有没有训到位,例如轮数是否足够、学习率是否使损失下降过慢。用验证集看训练过程中的未见数据表现。
过拟合看训练与未见数据的差距
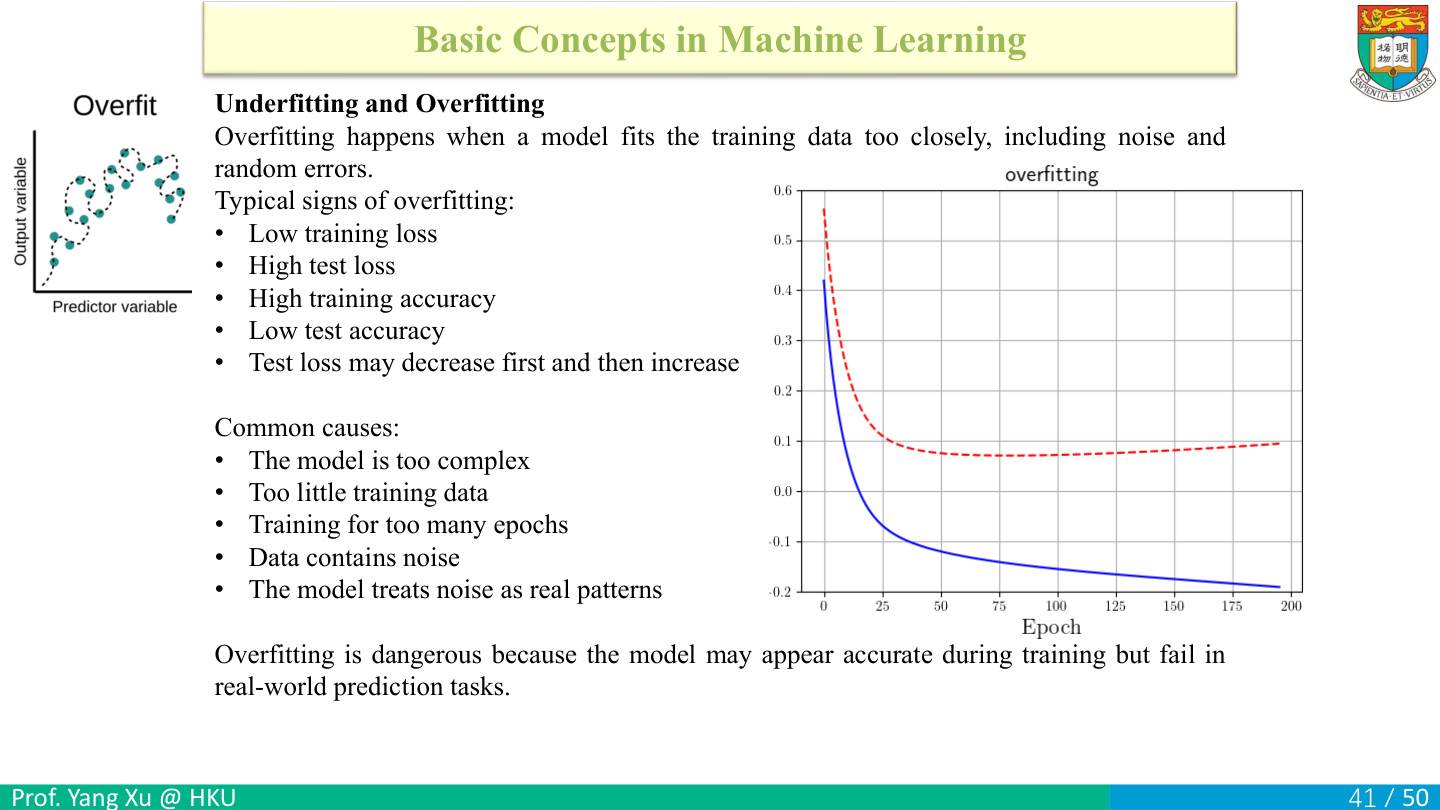
左图的曲线追着各个训练点频繁弯折,尝试把个别点的波动也解释成规律。右图蓝线是训练损失,持续下降;红线是未见数据损失,先降后升。沿横轴从左到右读,可以看到它们开始分开的位置。
例如某次训练第 20 轮的训练和验证损失分别为 0.2 和 0.3,第 50 轮分别为 0.1 和 0.6。后 30 轮让训练损失降低 0.1,却让验证损失增加 0.3。若按验证损失选这两次中的模型,会选第 20 轮,再在独立测试集上评价。
数据少或含噪声、模型太灵活、训练太久,都可能让模型学到只适用于这批训练样本的细节。判断时同时看训练曲线和验证曲线,尤其留意验证损失从哪一轮开始持续上升。
好拟合是为泛化服务
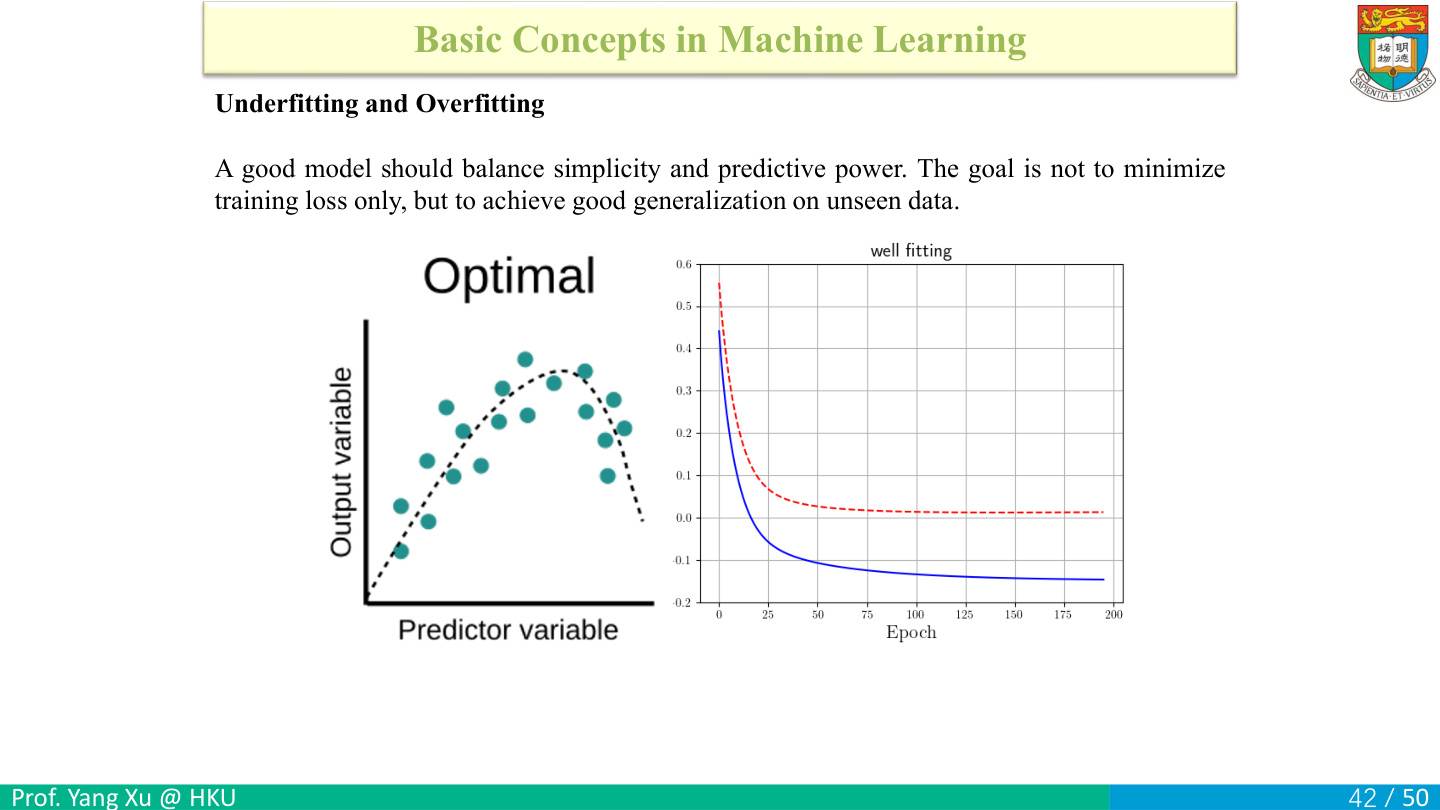
左图平滑曲线顺着点群的大体弯曲趋势走,个别点可以在曲线上下。右图蓝色训练损失和红色未见数据损失都先下降,再趋于平稳;图中仍留有训练与未见数据的差距。
| 模型 | 训练损失 | 同一批验证数据的损失 |
|---|---|---|
| A | 0 | 4 |
| B | 0.5 | 1 |
两者用同一个损失定义。A 把训练样本全部拟合,B 在验证样本上平均误差更小。若验证集能代表未来使用场景,B 的结果更支持泛化。两条曲线距离小也要看纵轴数值:若它们一起停在较高损失处,仍可能是欠拟合。
正则化改变了优化目标
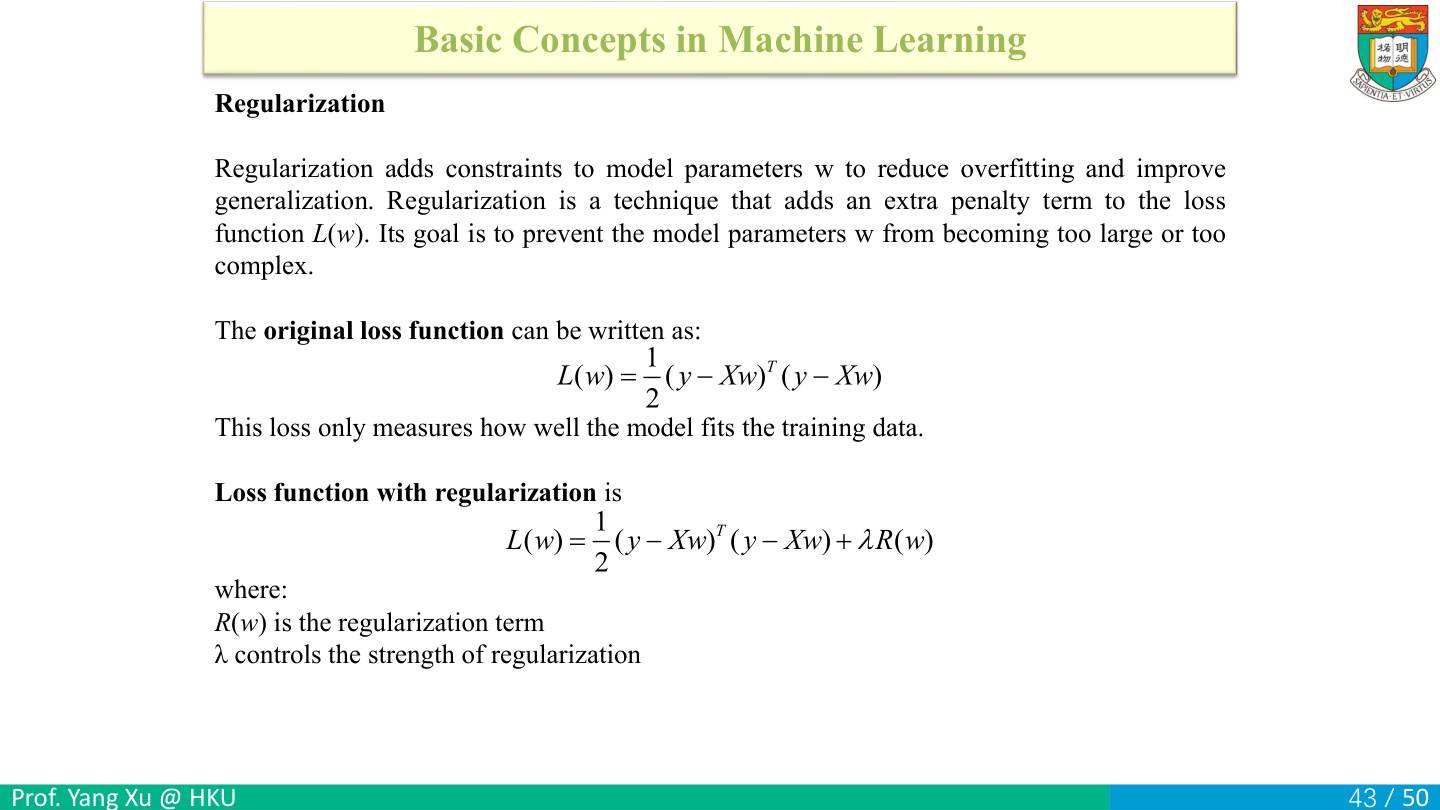
将正则化目标写成两个部分:Lλ(w)=L₀(w)+λR(w)。其中 L₀(w)=(y−Xw)ᵀ(y−Xw)/2 是训练拟合误差,R(w) 是参数惩罚,λ≥0 控制参数惩罚占多重。对实际训练而言,w 从整个可选范围里寻找;下表用两套候选参数展示权衡。
| λ | A 的目标(原损失 1,惩罚 10) | B 的目标(原损失 2,惩罚 1) | 较低者 |
|---|---|---|---|
| 0 | 1+0×10=1 | 2+0×1=2 | A |
| 0.05 | 1+0.05×10=1.5 | 2+0.05×1=2.05 | A |
| 1 | 1+1×10=11 | 2+1×1=3 | B |
λ 增大时,惩罚小的 B 即使训练拟合略差,也可能胜出。选 λ 时在同一验证集上比较预测误差。R(w) 可以取 Σ|wⱼ| 或 Σwⱼ²。同一特征若从米改为厘米,为保持预测不变,其权重会缩小至原来的 1/100,惩罚也会变,所以不同特征的尺度会影响正则化。
LASSO与Ridge的推导差别
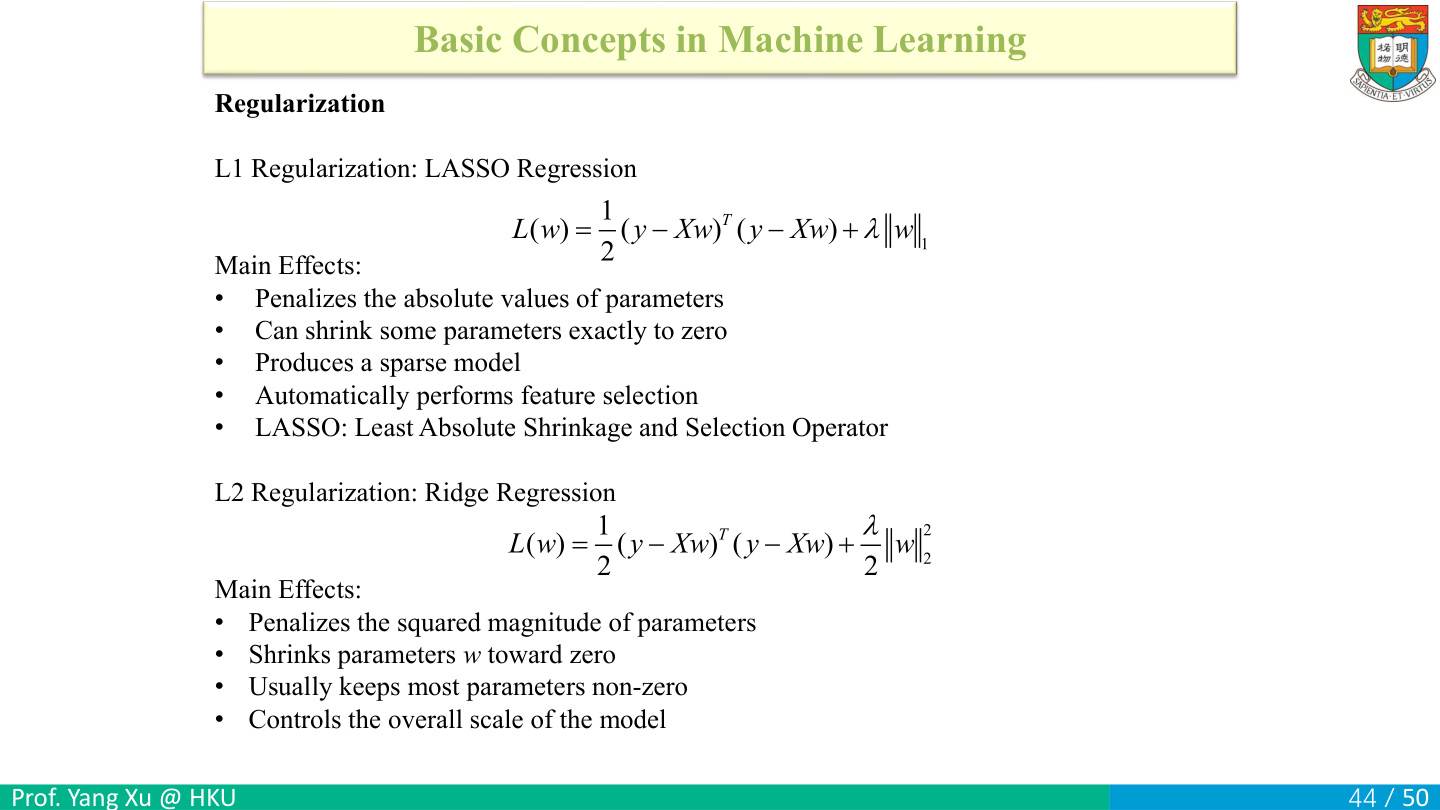
LASSO加λ||w||1,Ridge加(λ/2)||w||2²。L1可把一些系数压到精确0形成稀疏;L2通常平滑缩小。使用不同尺度特征前要注意惩罚可受单位影响,截距是否惩罚也应明确。
Ridge对L0求导Xᵀ(Xw−y),惩罚导数λw,令和为0得(XᵀX+λI)w=Xᵀy。在λ>0且全部系数均受惩罚时矩阵正定,解唯一。
一维L1例子min 1/2(w−a)²+λ|w|:若w>0,导数w−a+λ=0,得w=a−λ且需a>λ;若w<0,得w=a+λ且需a<−λ;若|a|≤λ则最优w=0。因此soft-threshold为sign(a)max(|a|−λ,0)。
补上L1在零点的处理:|w|在w>0时导数1,在w<0时导数−1,在0处没有普通导数。对于一维目标(w−a)²/2+λ|w|,0点最优的条件可用左右斜率判断:左斜率−a−λ≤0,右斜率−a+λ≥0,合起来−λ≤a≤λ。因此一整段a都对应精确零,而不是恰巧算到零。
算一遍。a=0.5、λ=1:L1给w=0;L2目标(w−a)²/2+λw²/2的导数(1+λ)w−a=0,解w=0.25。a=3、λ=1时L1给2,L2给1.5。两种惩罚都有收缩,但收缩方式不同。自测“L2一定保留每一个非零系数”准确吗?答案:通常没有L1那种普遍的精确归零机制,特定数据的对称性也可能令某系数恰为0。
正则化等高线怎样读
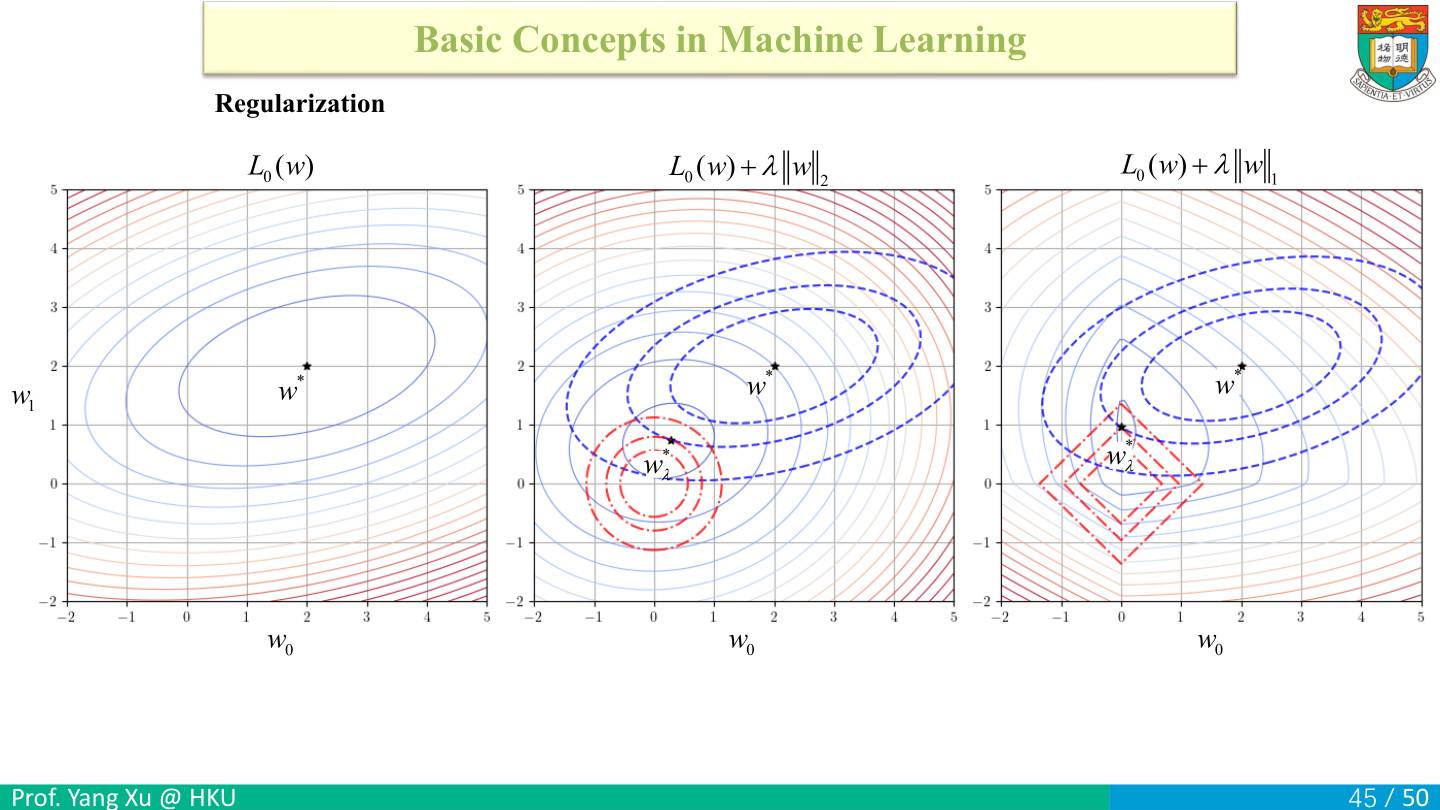
图中每个点(w₀,w₁)是一套候选参数;换一个点,就是换一个模型。等高线连接损失相同的参数点,椭圆中心w*是原训练损失的最低点。
加入正则后,同时考虑拟合损失与参数大小。L2惩罚以原点为中心的等值线是圆,L1惩罚的等值线是菱形;右图菱形的尖角位于坐标轴上,容易与损失等高线在轴上接触,例如w₀=0、w₁非零,出现稀疏系数。
因此从左到右读:原损失独自决定最优点;加L2后最优点向较小范数区域移动;加L1后,尖角几何使部分系数容易精确归零。横纵轴是参数,并非训练样本的坐标或分类边界。
中间图标||w||₂,前页公式用||w||₂²/2:二者等值集合都为圆,但作为相加惩罚时导数不同,λ的数值尺度也不同。图帮助理解移动方向与归零机制,具体参数仍由所写目标求解。是否惩罚截距,也应在目标中写清。
训练参数与调超参数分两层
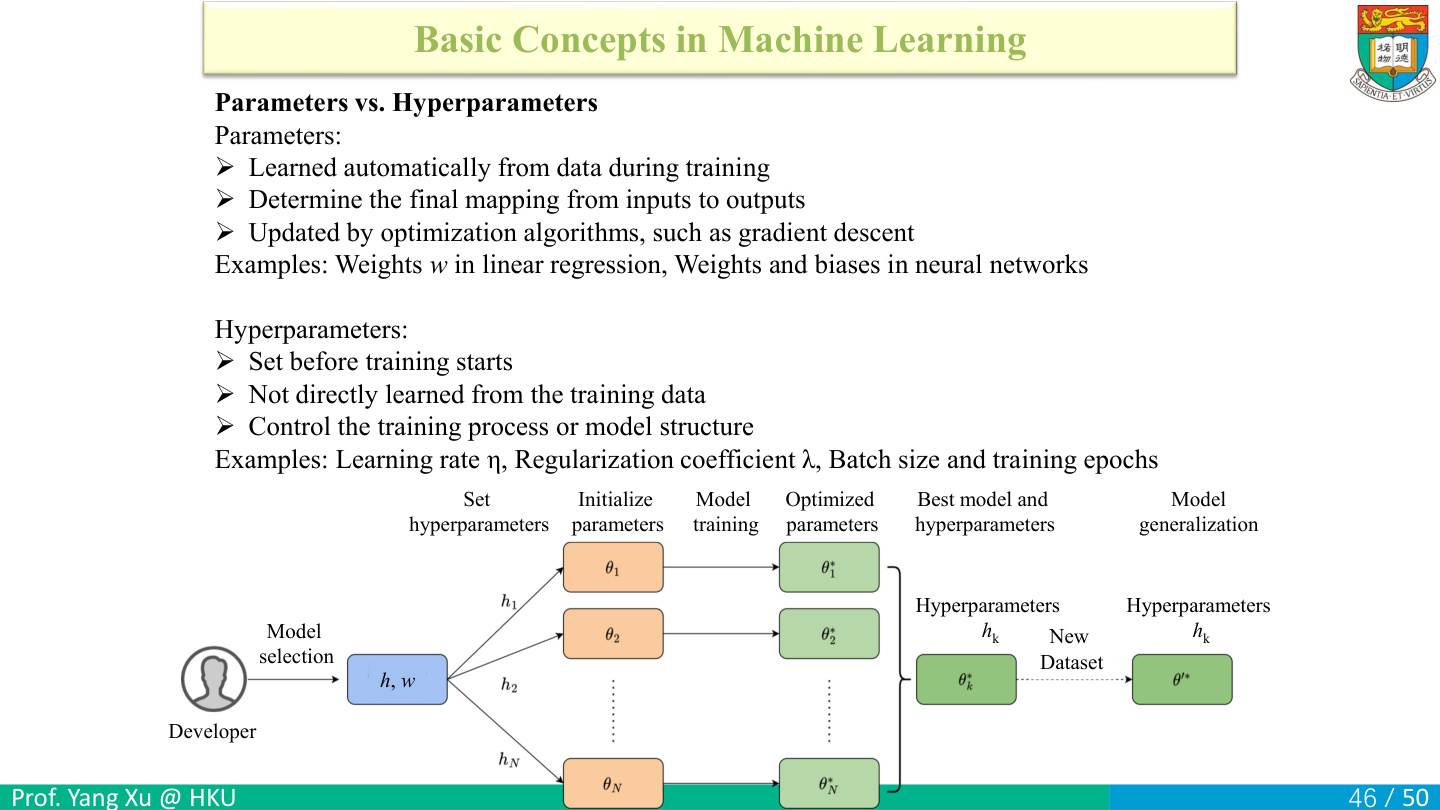
参数如回归权重、神经网络权重与偏置由训练数据优化;超参数如学习率η、正则化λ、batch size与epochs控制结构或训练过程。流程图先设超参数、初始化参数,再训练,比较配置后得到模型。
超参数也可以用程序自动搜索;它属于外层选择,与内层用梯度训练w分工不同。例子对λ=0、0.1、1分别从头训练三个w,再用验证结果选λ;不能直接看训练损失最低就选λ=0。
想象两层旋钮:内层旋钮w由训练过程自动调,外层旋钮η、λ、网络宽度等由实验设置或搜索过程调。即使外层由程序自动试多个值,它们仍相对当前训练过程属于超参数。batch size是一次更新用多少样本,epoch是完整扫过训练集多少轮,不是同一个数。
练一练。100条训练样本、batch size=20,一轮在不丢余样本的情况下有几次更新?答案:100÷20=5次;训练10轮通常50次更新。若对λ=0.1与1各训练一次,再按验证误差挑选,w的学习使用训练集,λ的选择使用验证集;最后不能把验证误差当完全没参与选择的独立测试成绩。
训练集与验证集的分工
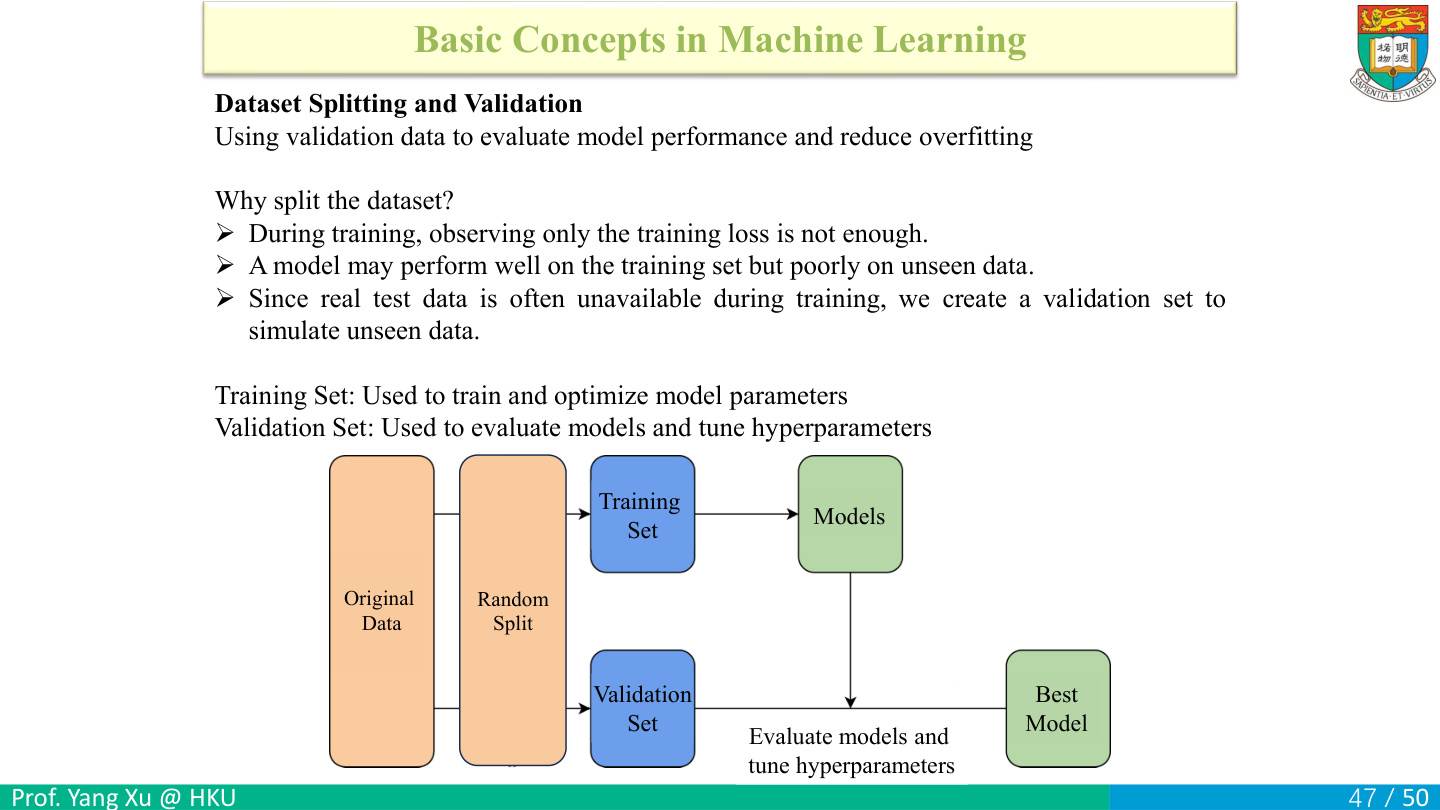
将数据切分为训练与验证:训练集更新参数,验证集评估和选择模型或超参数。图中验证箭头指向模型选择,而非反向给每个训练梯度提供标签。
例子1000条样本分800训练、200验证,只在800上拟合标准化均值与参数,再把同一变换用于验证。若先用全部1000拟合预处理,可能发生信息泄漏。时间序列或同设备重复样本不宜不加考虑地随机切分,应按时间或组保持评估独立性;最终测试集还需留作选择结束后的评价。
先切分再拟合任何会“从数据学数字”的预处理。例子训练值[0,2]均值1,验证值100:若用训练均值,验证中心化后是99;若先看全体均值34,连训练输入也被验证值改变。标准化不使用标签仍然可能传递未见数据的分布信息,所以也应在每轮训练范围内拟合。
自测。来自同一台机器同一次运行的相邻帧随机分到训练与验证,独立吗?答案:往往很相关,模型可能借同一背景或同一运行状态获得过于乐观成绩。若未来目标是新设备或新时间段,应考虑按设备或时间切分。验证集参与阈值和模型选择,最终测试集则在选择完成后评价整套流程。
K折交叉验证的每一步
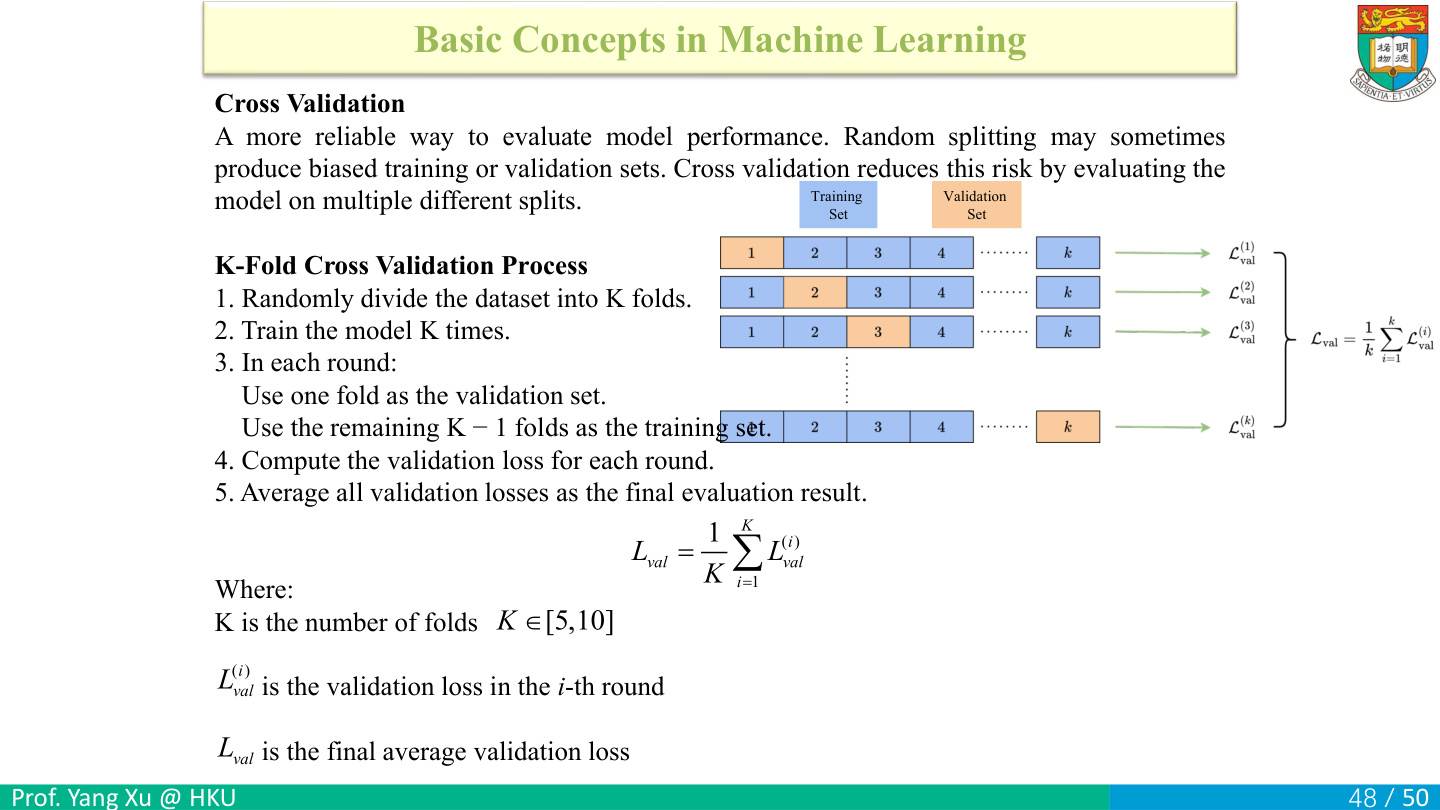
K 折交叉验证把开发数据分成 K 份,轮流把一份留作验证。K 需要是至少为 2 的整数,各折非空;课件推荐 5 至 10 折。这里先取三份 A、B、C 算一遍。
| 第几轮 | 用于拟合 | 用于验证 | 验证错误率 |
|---|---|---|---|
| 1 | B+C | A | 0.10 |
| 2 | A+C | B | 0.15 |
| 3 | A+B | C | 0.20 |
每轮重新拟合;标准化的均值、标准差和特征选择也从本轮训练折计算,再用到验证折。三折等大时,验证错误率为 (0.10+0.15+0.20)/3=0.15。一般写作 L_val=(1/K)Σᵢ L_val⁽ⁱ⁾,平均的是损失或指标。各折样本数不等时,可以另外按样本数加权,并说明采用哪种汇总。
若同一设备的一次运行含多条相关记录,让整组记录留在同一折。用历史预测未来可做按时间向前滚动的验证,每轮只用验证时段之前的数据。选定超参数以后,用全部开发数据重新训练,并在保留的测试集上评价。
把数学与训练流程连成一条线
把本讲用到的数学串成一次训练。输入 x=2、真实目标 y=5,选线性模型 ŷ=wx,初始 w=1。
- 预测
ŷ=1×2=2。 - 算半平方损失
L=(2−5)²/2=4.5。 - 对 w 求导。
dL/dŷ=ŷ−y、dŷ/dw=x,相乘得(2−5)×2=−6。 - 取学习率 0.1,更新
w=1−0.1×(−6)=1.6。 - 用新参数预测
ŷ=1.6×2=3.2,得到L=(3.2−5)²/2=1.62。
w 是由这条训练样本更新的参数,学习率 0.1 是预先设定或用验证选择的超参数。若拿独立样本 (3,7) 做评价,新预测是 4.8,半平方损失为 (4.8−7)²/2=2.42。同一条更新公式能降低已见样本的误差,未见样本的效果要另外算。
本讲结束
这讲建立了后面反复使用的工具:用矩阵表示数据,用损失评价预测,用梯度更新权重,再用验证数据选择模型。下一讲把它们连起来,完整推导线性回归与Logistic分类。