左右键翻页;“连续阅读”展开整份;搜索可定位概念。
分类第一讲
这讲先用KNN按近邻投票或平均,再研究特征、内积与核,最后用SVM寻找间隔更大的分类边界。贯穿全讲的问题是:怎样表示输入、怎样比较样本,以及怎样利用已知标签预测新样本。
学习路线
KNN负责“找最近的几个”,特征与核负责“用什么信息比较”,SVM负责“在候选分界中选哪一个”。先算具体邻居和距离,再看矩阵与几何推导,公式就有了对应的动作。
社团预测的提问
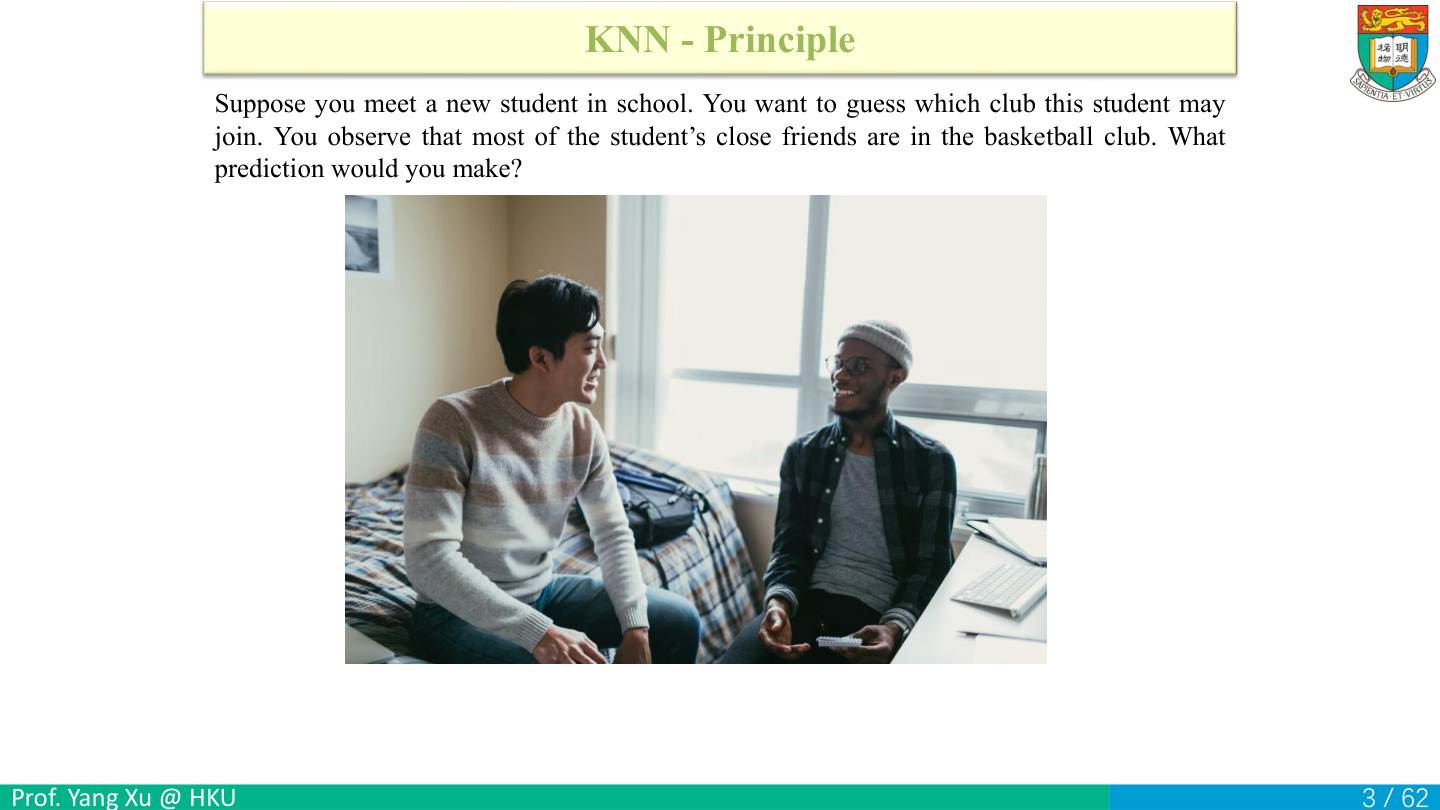
新同学的亲近朋友大多在篮球社,你可能猜他也会参加篮球社。这个类比将朋友当作已有样本、朋友的社团当作标签、新同学当作待预测输入。
要把直觉变成KNN,需要把“亲近”写成可计算的特征与距离。例如用运动兴趣和活动频率描述人,再按这些特征找最相似的几位同学。若改用与社团关系很弱的鞋码,找到的近邻可能就缺少参考价值。
练一练。开始计票前先回答两件事:用哪些特征找朋友,取最近几位?前者决定相似的含义,后者就是后面的超参数k。选好以后,才用这些邻居已经知道的社团标签作预测。
从邻居推出类别
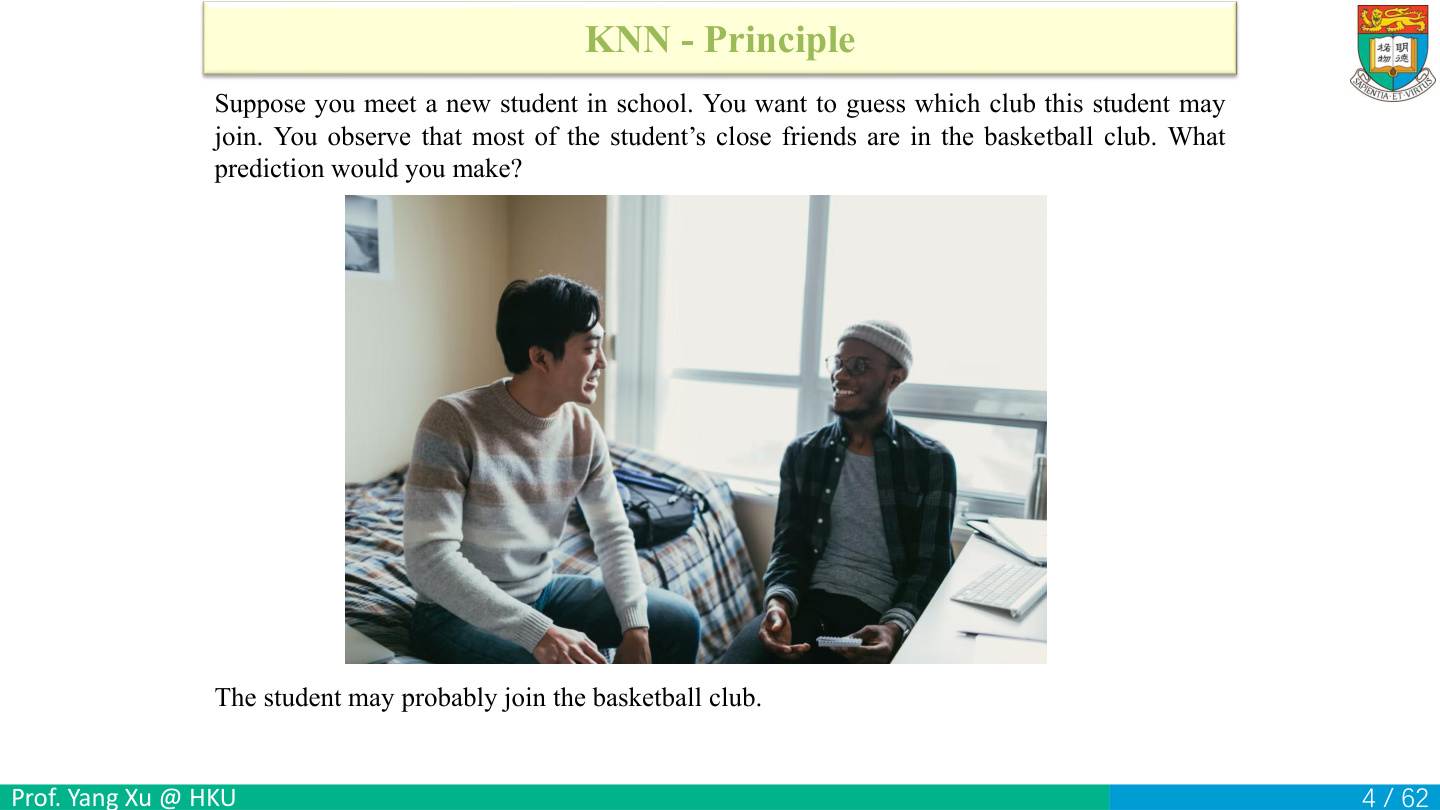
最近三位朋友分别参加篮球、篮球、足球社,篮球得到2票、足球1票,于是多数投票预测篮球。得到新同学实际选择后,再将预测与真实社团比较,就能评价这次判断是否正确。
若改取四位朋友,结果是两篮球、两足球,就出现平票,需要事先规定处理规则,例如使用距离权重或固定类别顺序。最近距离本身也可能并列,这同样属于算法需要补齐的细节。
这个例子把预测步骤具体化:先按特征找邻居,再读取邻居标签,再按规则计票。查询者的真实选择用于最后评价,近邻搜索只使用已有输入与训练标签。
KNN分类核心
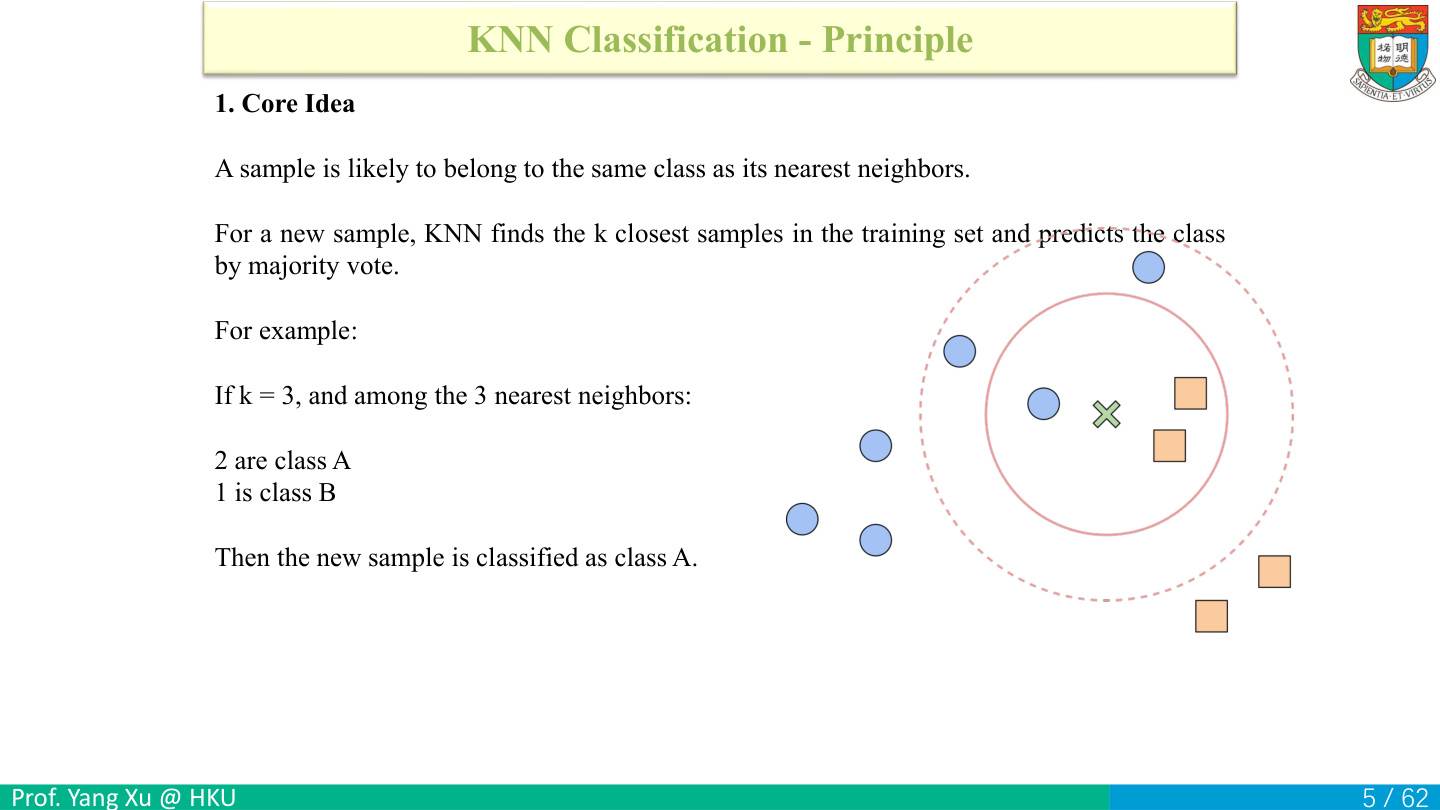
KNN 分类对一条新输入先算距离,再按距离从小到大取前 k 条训练样本,最后用这些标签投票。k 决定取多少个邻居。
设查询 x=2.5,训练数据为 (0,A)、(2,A)、(3,B)、(8,B)。
| 按距离排列的邻居 | 标签 | 距离计算 | k=3 时计票 |
|---|---|---|---|
| 2 | A | 2.5−2=0.5 | A 加 1 |
| 3 | B | 3−2.5=0.5 | B 加 1 |
| 0 | A | 2.5−0=2.5 | A 加 1 |
| 8 | B | 8−2.5=5.5 | 圈外,跳过 |
A 得 2 票,B 得 1 票,因此预测 A。若 k=1,距离 0.5 有两条并列,需要预先规定取哪一条。若一张照片重复存了多次,每个副本通常各占一票,近邻结果就可能改变。
训练阶段主要保存参考数据,查距离与投票在预测时发生,因此称为惰性学习。可以用验证数据比较不同 k 的表现。
指示函数与argmax
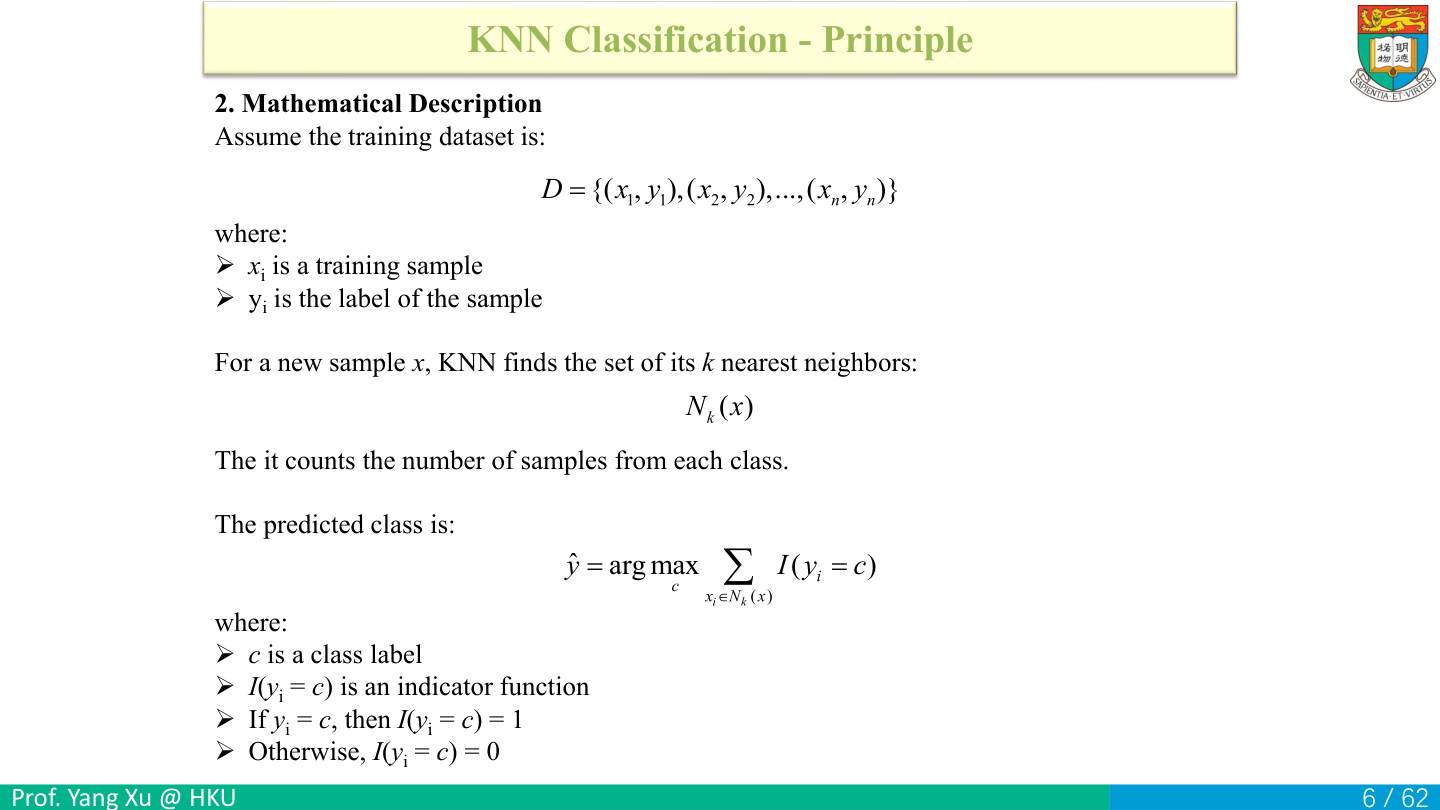
原数据D={(x_i,y_i)},邻居集合N_k(x),预测y_hat=argmax_c sum_(x_i属于N_k(x)) I(y_i=c)。I条件成立取1,否则0;sum是某类票数,argmax返回票数最大的类别,不返回最大票数本身。邻居标签[2,2,7],c=2得2票,c=7得1票,输出2。计算顺序为全体距离→选邻居→对每类计数→取类。若距离并列或票数并列需固定规则,不能临时看真实标签打破平局。
把公式从里往外读:I(yᵢ=c)先回答“这个邻居属于候选类c吗”,是就1、不是0;Σ把邻居们的1加起来,得到c类票数;argmax再比较每个候选c,返回票数最大的类别。N_k(x)是随查询x改变的邻居集合,不是固定一群样本对所有输入通用。
算一遍。近邻标签[7,2,7,2,7],候选c=2的指示项为[0,1,0,1,0],和2;c=7为[1,0,1,0,1],和3,预测7。自测最大票数3与输出类别7哪一个是argmax结果?答案:7;max才返回3。这里x是新输入,xᵢ是训练输入,yᵢ是训练标签;查询标签留到评价时再与预测比较。
图中的k为3和5
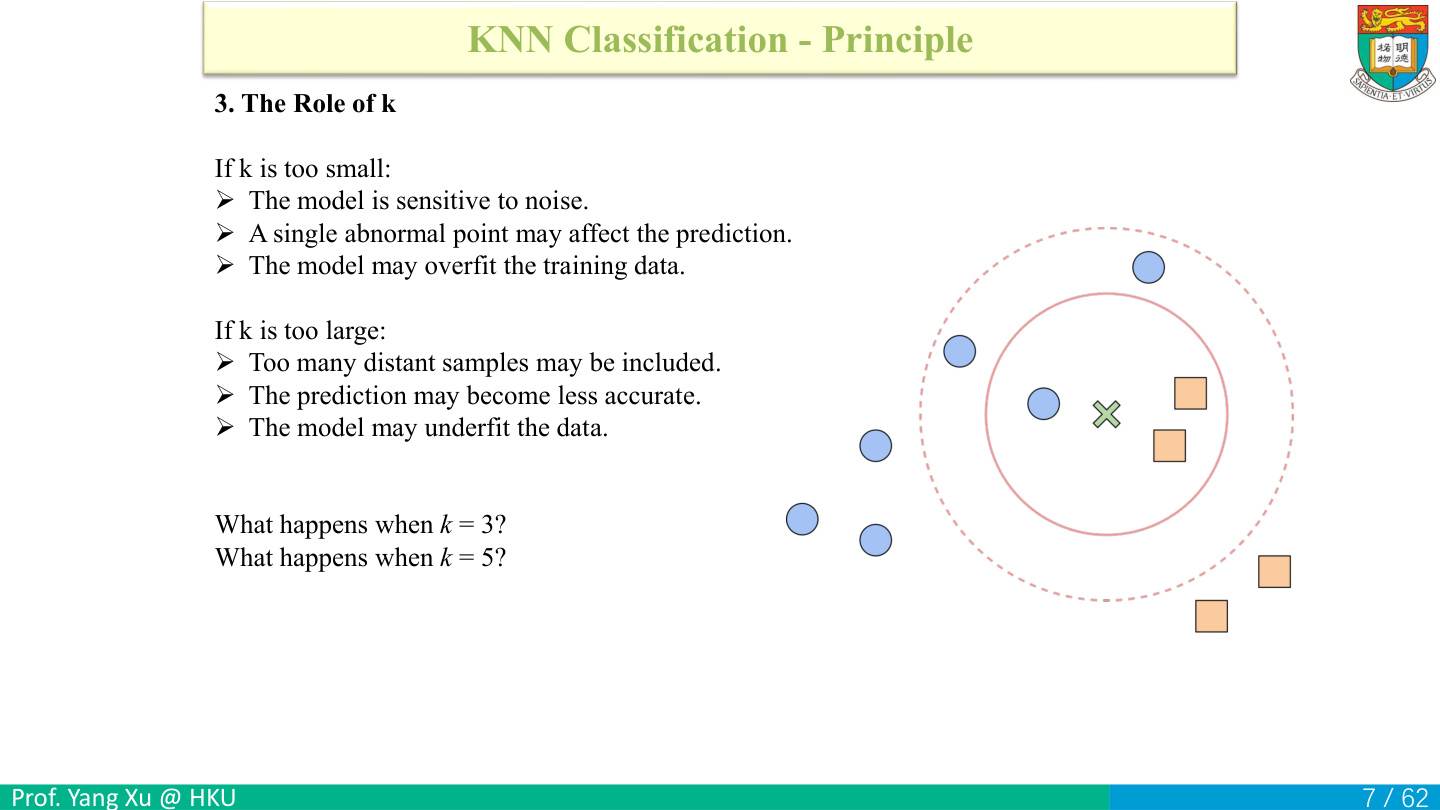
绿色叉是查询点,蓝圆与橙方是两类训练样本。小实线圈内有3个最近点:橙方2、蓝圆1,因此k=3预测橙方;扩大到虚线圈后增加2个蓝圆,变成蓝圆3、橙方2,因此k=5预测蓝圆。
圈表示从查询点向外扩展的邻域,位置随查询点改变,大小随k改变。圈外样本对当前这次投票贡献0票;计数的对象是最近k个样本。
k很小时,单个错标签或噪点就可能决定结果;k很大时,会混入更远的样本,局部差异被平均掉。k通常用验证集选择。
练一练。若k等于全部训练样本数,简单多数票的预测怎样变化?答案:所有查询都使用同一批标签,通常总报全局多数类。二分类取奇数k可减少票数平局;多分类中仍可出现三类各1票,所以还要定义平票规则。
MNIST输入是什么
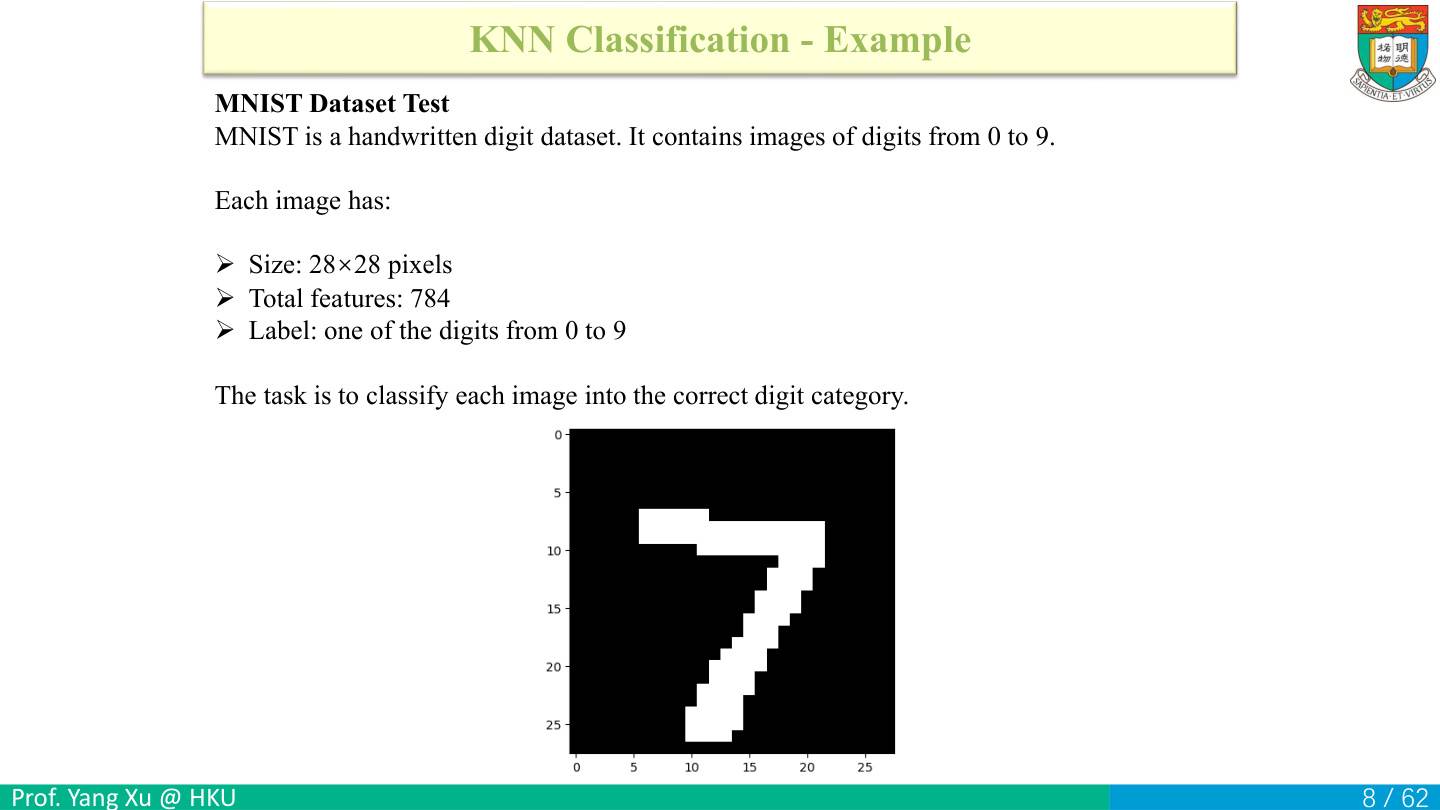
MNIST每张28×28像素、共784特征、标签0至9。784来自像素位置,不是784个类别。模型看到的是亮度数组,而人看到的“7”只是这些数值的视觉解释。KNN会比较两张图对应位置,而不是自动理解笔画含义,所以平移和书写差异会影响距离。
28×28表示28行、28列,每个位置一个亮度数;28×28=784只是输入长度。标签则从0到9中选一个,属于10类。模型不会因为文件名写“7”就自动懂图片内容,必须保证读取的像素数组与正确标签对应。若训练图与标签错位,模型学到的映射会混乱。
练一练。一批100张图若展平成矩阵,每行一张,形状是什么?答案:100×784;标签向量长度100,不能是784。像素从0到255缩放至0到1会统一改变距离尺度,但若所有图都同样线性缩放,欧氏距离排序不变;若只缩放查询图却不缩放参考图,距离意义就被破坏。平移一格会改变许多对应像素,解释了原像素KNN的局限。
输入维度784很高,而图像本来具有相邻像素关系;展平并未删除数值,却使普通欧氏比较不会自动利用二维局部结构。后续CNN正是用局部卷积与共享权重利用这类空间关系。
展平 划分 准确率
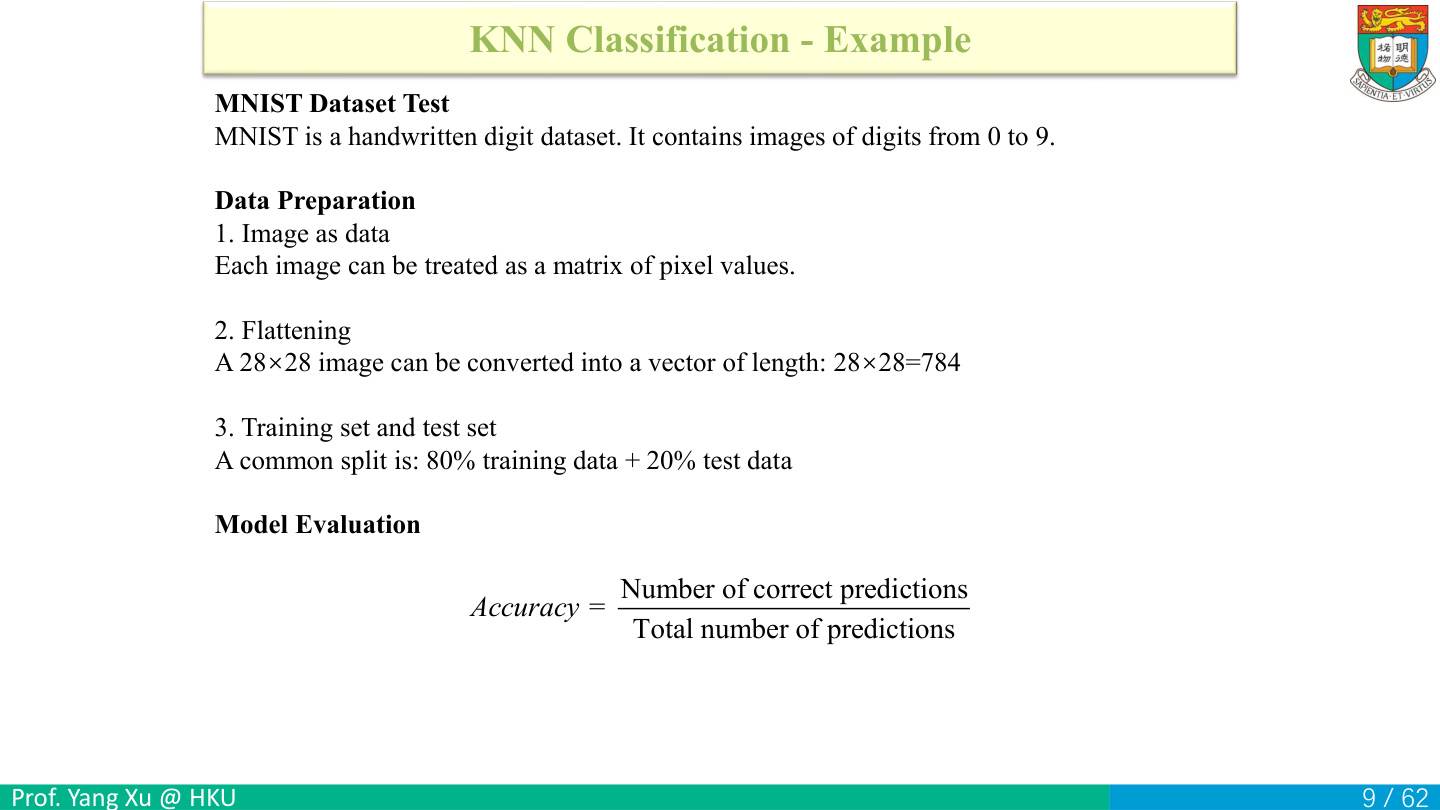
将 28×28 个像素按确定的顺序排成 784 项。先用两张 2×2 小图看形状变化:
import numpy as np

images = np.array([[[1, 2], [3, 4]], [[5, 6], [7, 8]]])
features = images.reshape(len(images), -1)
## 形状从 (2, 2, 2) 变为 (2, 4)
## features 为 [[1, 2, 3, 4], [5, 6, 7, 8]]
len(images)=2 保留每张图的位置,-1 让 NumPy 用总元素数 8 除以 2,推得每行 4 项。图像按从上到下逐行读取,每行从左到右。如果查询图按列顺序排成 (1,3,2,4),同一图像的对应像素也会错位。MNIST 用同一行规则得到 (图像数量, 784)。
课件以 80% 训练、20% 测试为例。训练图作为近邻参考,验证集负责选 k;选定设置后,再在测试上计算准确率。编程作业使用作业材料给定的 60000 张训练图与 10000 张公开测试图。比如预测 [2,7,1,9],真值 [2,2,1,9],逐项比较为 [对,错,对,对],准确率 3/4=75%。错把 2 写成 7 只计一次错误。
KNN回归与归一权重
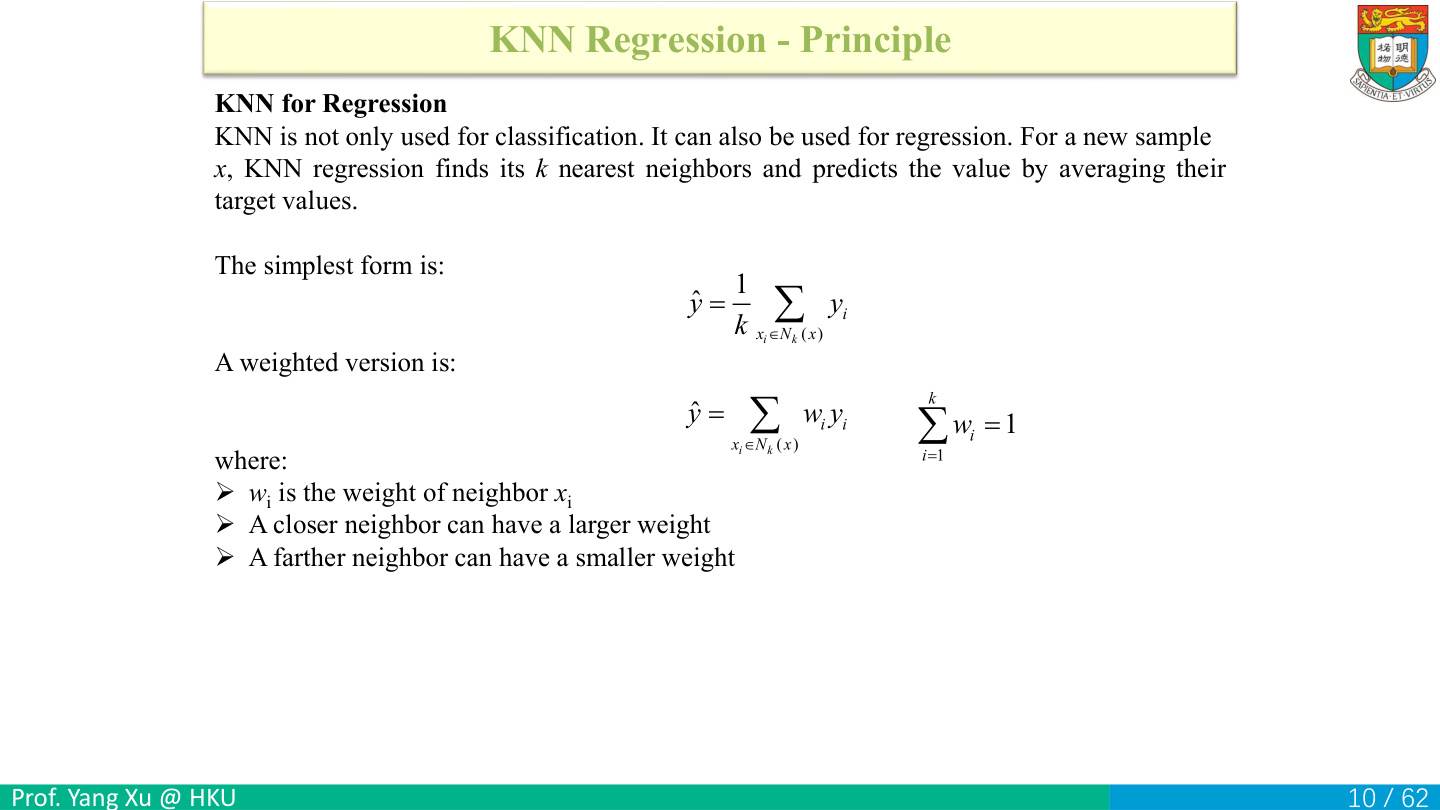
KNN回归先找k个近邻,再平均它们有数量意义的目标值。简单均值为ŷ=(1/k)Σyᵢ;加权均值为ŷ=Σwᵢyᵢ,其中权重总和Σwᵢ=1。分类则对类别投票,例如数字标签代表类别时不用其编号求数值平均。
三个近邻目标为2、4、9,简单均值(2+4+9)/3=5。若距离分别1、2、4,想让近的影响更大,可先取距离倒数aᵢ=1/dᵢ,再除总和得到wᵢ。
| 邻居 | 目标yᵢ | 距离dᵢ | 原始权aᵢ=1/dᵢ | 归一权wᵢ=aᵢ/(7/4) | 预测贡献wᵢyᵢ |
|---|---|---|---|---|---|
| 1 | 2 | 1 | 1 | 4/7 | 8/7 |
| 2 | 4 | 2 | 1/2 | 2/7 | 8/7 |
| 3 | 9 | 4 | 1/4 | 1/7 | 9/7 |
原始权重和为1+1/2+1/4=7/4;归一权重和(4+2+1)/7=1。逐项加贡献得到ŷ=(8+8+9)/7=25/7≈3.571,比普通平均5更靠近最近目标2。
若漏掉归一化,直接算1×2+0.5×4+0.25×9=6.25,还要除总权重1.75,才得到同样的25/7。另一个两邻居例子,目标10、20、权重0.75、0.25,预测7.5+5=12.5。
完全零距离时,先按统一规则处理完全匹配样本,或使用aᵢ=1/(dᵢ+ε)避免除零;ε是一个正的小数。
灰度图矩阵
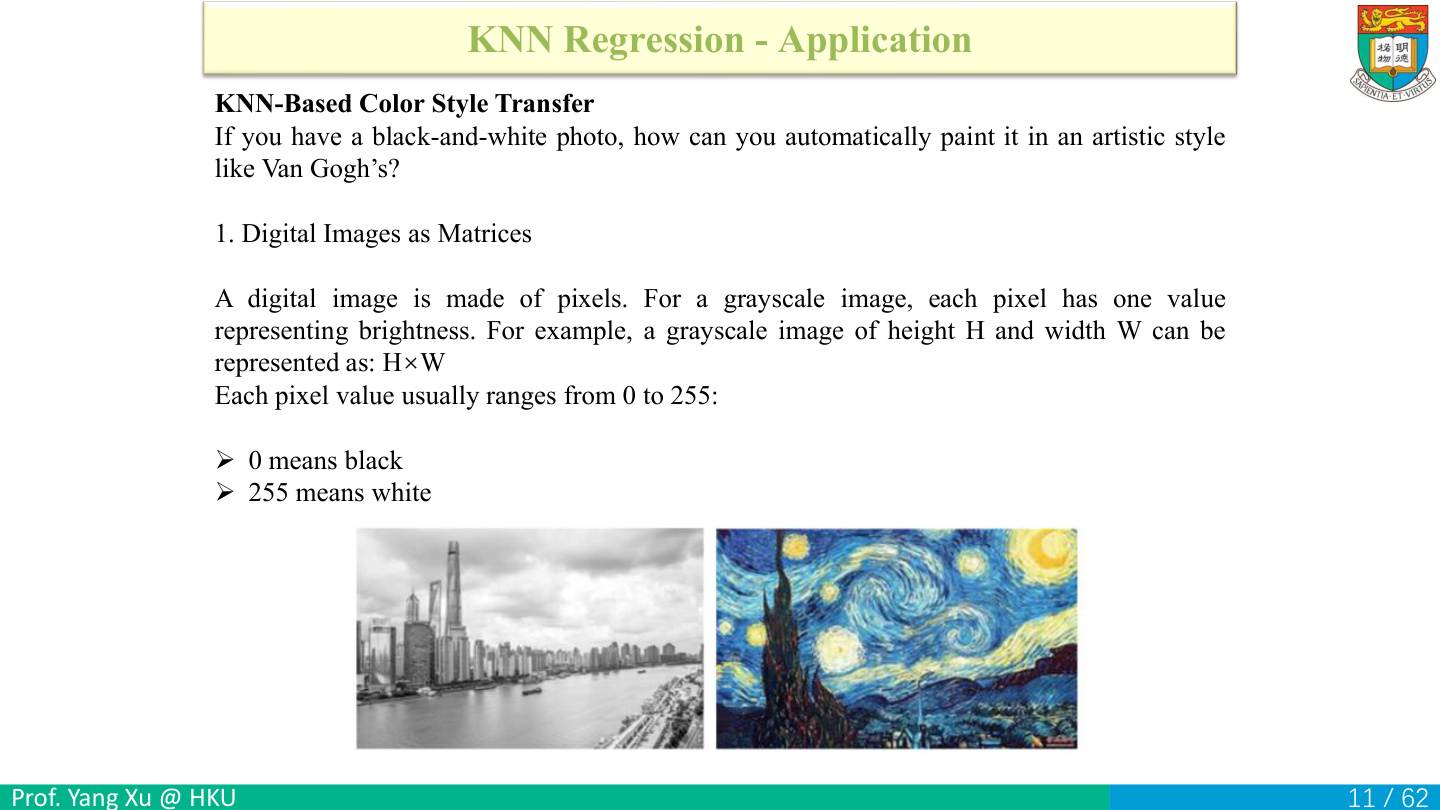
给灰度照片借用另一张图的色彩前,先把图像看成H×W像素矩阵,每个位置通常为0至255的亮度数,0黑、255白。H是高、W是宽,像素值是输入特征而不是位置编号。颜色化任务不等于识别图中物体;简单KNN仅根据亮度纹理寻找相似区域,不会保证天空或皮肤一定语义正确。
把灰度图当成数表看:H表示行数,W表示列数;像素x[r,c]是第r行第c列亮度。2×3图[[0,128,255],[255,128,0]]共6个数,第一行从黑到白,第二行反过来。数字0不是“没有像素”,而是一个黑像素;255也不是第255类,只是亮度编码。
自测。把整图各值乘0.5,形状变了吗?答案:形状仍2×3,亮度范围改变。把图转成灰度通常丢掉色彩信息,不可能仅由单个亮度唯一恢复原RGB;所以这里的上色要借风格图的颜色参考,而不是证明黑白图藏有唯一的彩色答案。后续patch加入邻域纹理,是为了增加匹配线索,不是消除所有歧义。
数据类型也影响运算:若亮度保存为无符号整数,直接相减可能发生下溢;进行距离计算前常转成合适的浮点数。数学中的0−255=−255,程序也必须按能表示负数的类型计算这一差值。
RGB三通道
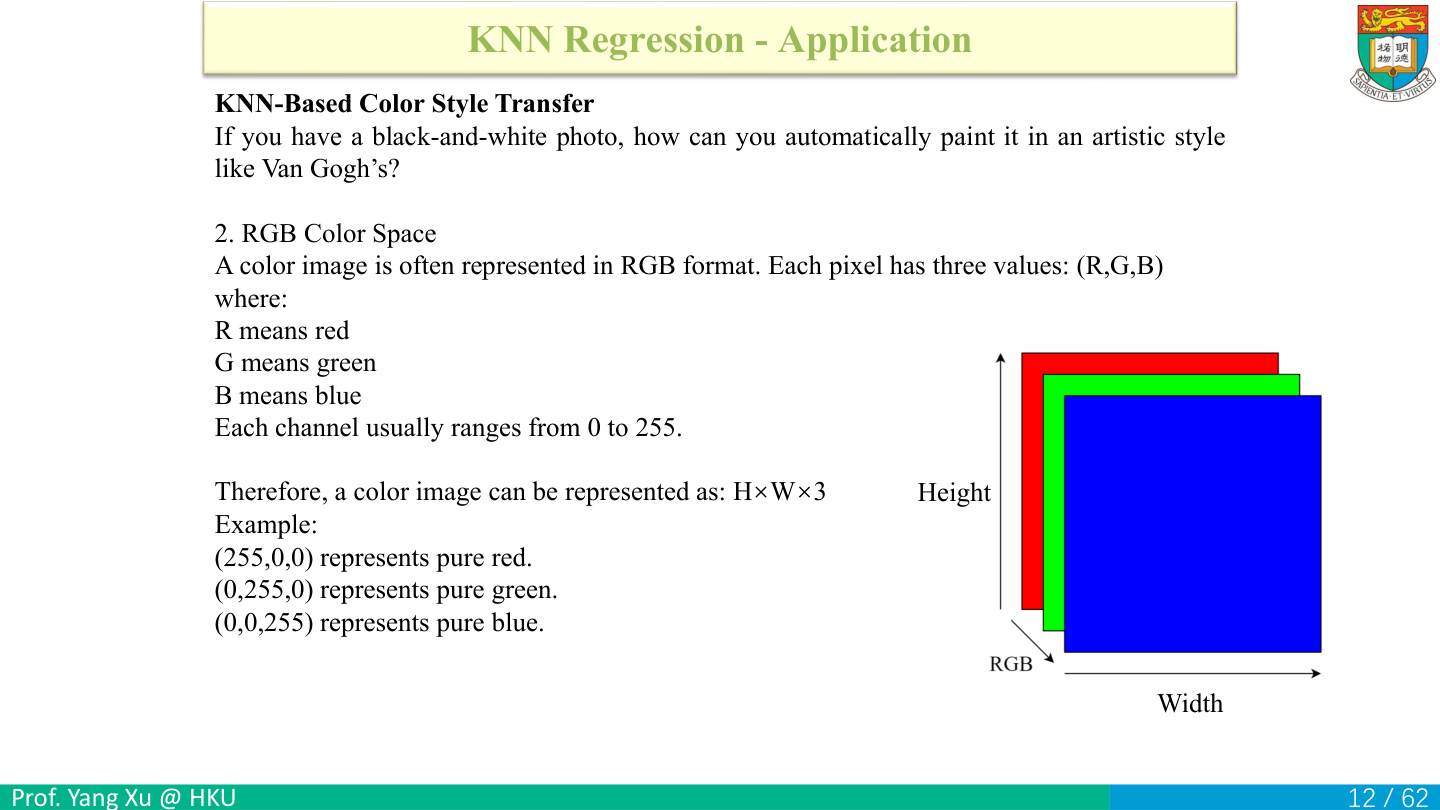
每像素(R,G,B),红、绿、蓝各0至255,整图H×W×3;(255,0,0)红、(0,255,0)绿、(0,0,255)蓝。图中Width沿水平、Height沿垂直,最后通道轴不表示三张独立样本。把RGB压到一个平均值会失去颜色信息。两个像素构成一行时数组形状1×2×3,元素数6。
最后那个3是通道数:同一像素依次存红、绿、蓝贡献,不是把宽度乘3后变成另一种空间尺寸。一行两像素,红(255,0,0)、蓝(0,0,255),数组形状1×2×3,共6个数。若程序采用3×H×W通道在前也能表示同样图片,但必须知道当前约定,不能直接按错轴处理。
练一练。(0,0,0)是什么?答案:黑;(255,255,255)是白;(128,128,128)是中间灰。若只看R通道,纯绿与纯蓝都为0,说明单通道不能表达完整颜色。进入LAB转换时是把每像素三维RGB坐标转换成另一组三维坐标,不是把彩色图样本数量变成三倍。
RGB通道顺序与BGR不同,两个格式都用三个数但第一与第三项含义互换。若图像看起来红蓝颠倒,先核对读取、转换、显示各步骤的通道约定,而不是立刻怀疑KNN的平均公式。
RGB中的明暗与颜色
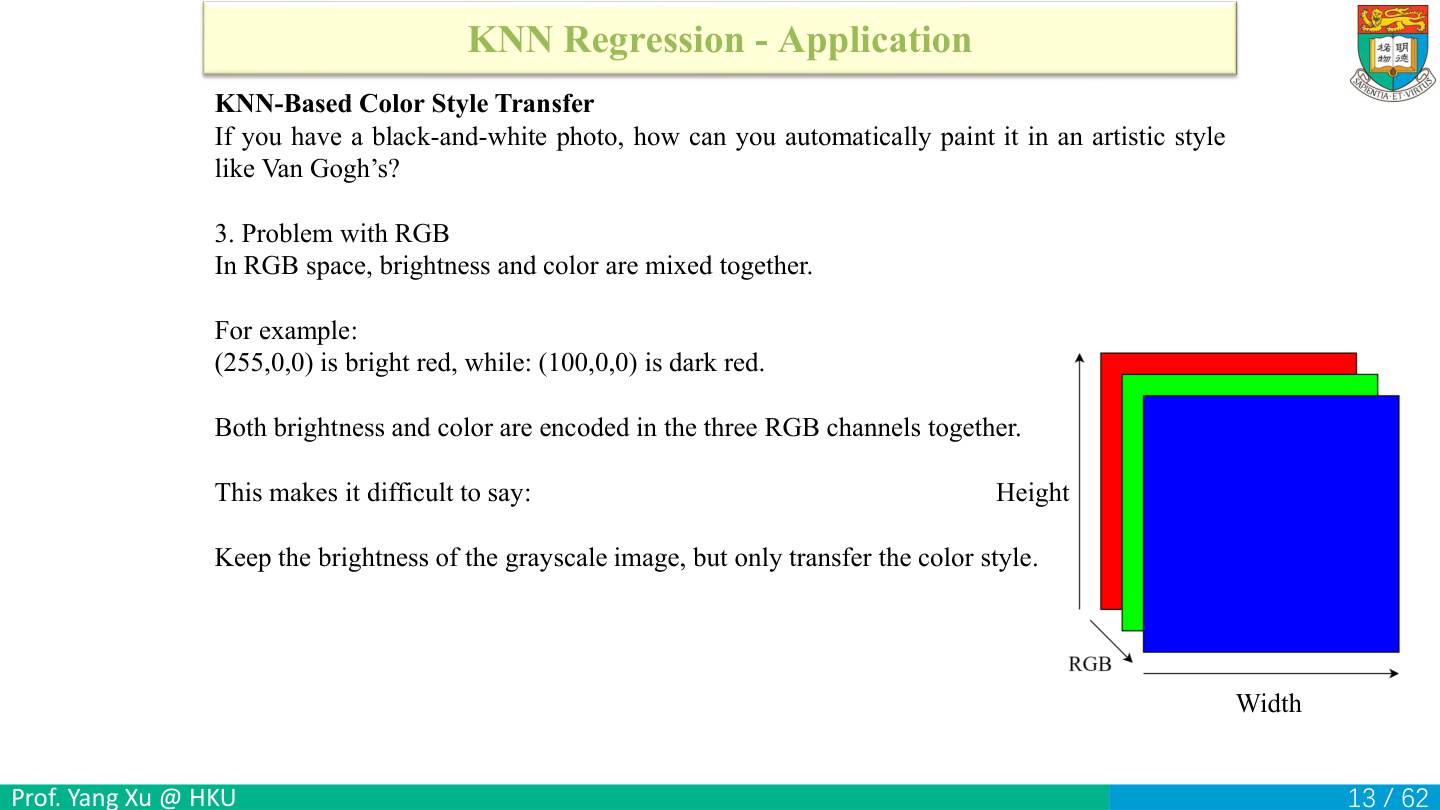
原例(255,0,0)与(100,0,0)都是红色系但亮度不同。三个RGB坐标一起决定外观,不能简单固定一个通道就说“保持原亮度”。若目标只转颜色、保留内容图结构,更适合换到有单独明度分量的表示。
在RGB里同时把三通道放大,往往既影响明暗,也影响显示效果与截断;“保留一个RGB值”不等于保留感知明度。即使两个不同RGB组合具有相近明度,也可能明显不同色,这正是单一灰度无法唯一推出颜色的原因。亮红与暗红说明明暗变化会反映在RGB通道数值中。
练一练。想保留灰度照片的建筑轮廓而借用风格色彩,应先把颜色与明度分成适合的坐标,再只预测色度;能否简单把所有像素R通道换成同一个数?答案:不能,这不表达期望的分工,还可能毁掉细节。LAB把明度与色度分开,实际转换时沿用同一图像库的函数与数值范围。
同样亮度的不同颜色在灰度转换后可能相同,所以从灰度还原RGB是信息不足的问题。借用风格参考等于加入先验偏好:希望相似纹理采用相似颜色;它补的是统计参考,不是找回被灰度转换必然保存的隐藏值。
LAB的三个分量
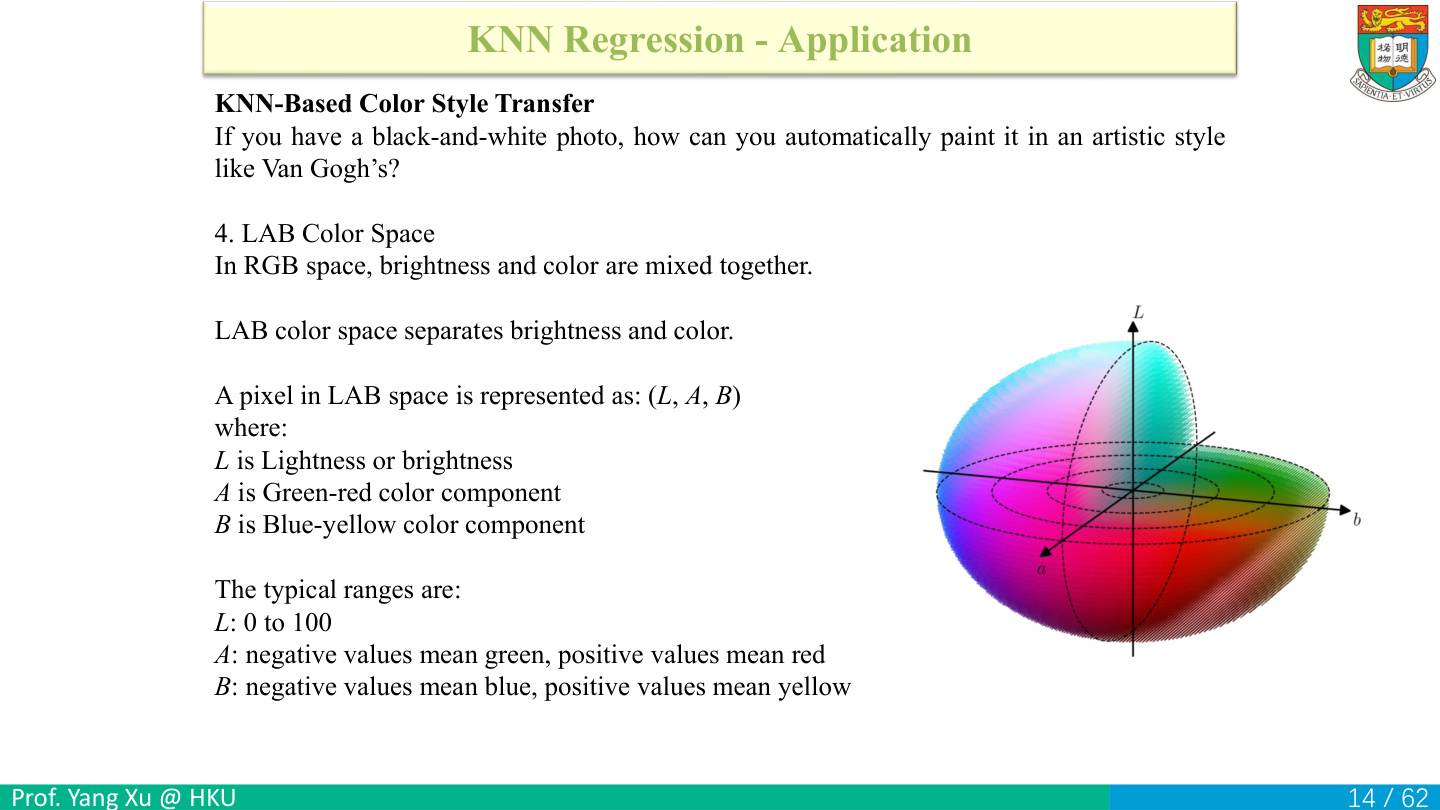
L表示明度,典型0至100;A沿绿负红正方向,B沿蓝负黄正方向。LAB不是RGB的改名,它是经颜色转换得到的不同坐标。读取A、B需保留正负,若粗暴转无符号整数会扭曲颜色。不同图像库可能采用不同编码范围,转换时统一按所用库的LAB约定处理L和色度。
把LAB看作三个不同问题:L回答“有多明”,A回答“偏绿还是偏红”,B回答“偏蓝还是偏黄”。A或B可以负,负不是非法颜色,也不表示图片出错。L≈0趋近黑、L≈100趋近白是典型定义范围;转换库若把通道编码为其他整数区间,必须先查明约定再进行距离或平均。
练一练。某像素LAB=(50,20,−10),可说它是中等明度、在A轴偏红、B轴偏蓝;不能直接把它当RGB=(50,20,−10)显示,因为坐标定义不同。若想保持L,只把A、B换为预测值,三个分量仍组成一个像素。LAB的作用是把感知明度与两个色度方向分开,方便分别处理。
A/B平均前也须统一编码。例如真实A=−10若在某库用偏移整数保存,直接把编码值当真实LAB坐标会改变解释。始终在同一颜色库、同一数据类型约定下完成正向与反向转换。
输入L 输出A B
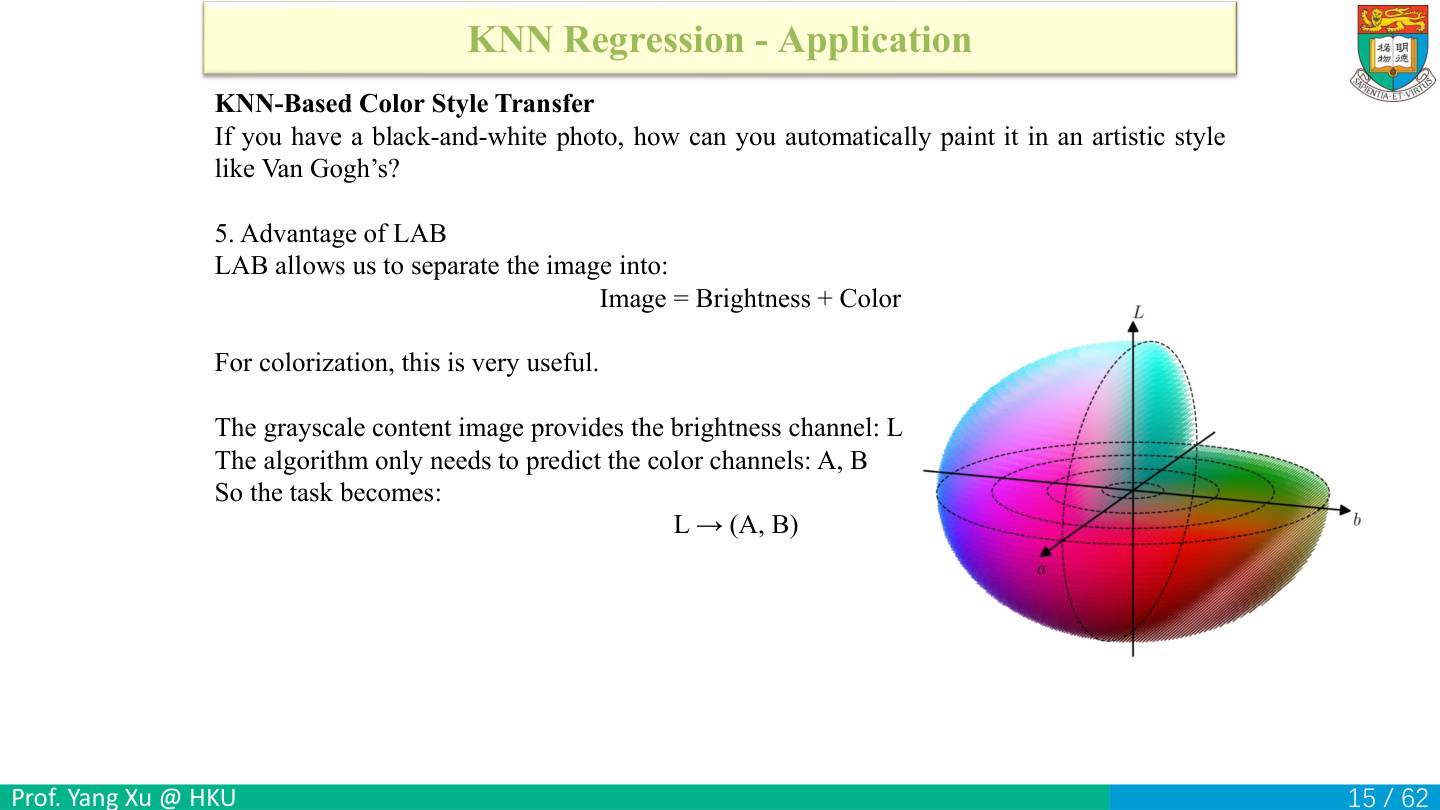
内容灰度图提供明度L,模型估计两个连续色度A、B,再组合成彩色图,因此任务写作L→(A,B)。这是双输出回归:同一批近邻的A值分别平均、B值分别平均,得到两个输出。
单个明度有歧义:L=50可配很多A/B组合,红或蓝的物体可能具有相近明度。使用3×3明度patch,加入周围纹理与边缘,有助于寻找更合适的颜色参考。
颜色标签是二维向量,所以A、B使用同一批近邻索引。例如两个邻居的中心色度分别(20,10)和(−20,30),简单平均得(0,20)。A方向正负抵消,结果可能更接近中性,这解释了简单平均有时让颜色变灰。
最终明度仍取内容图的L,保留原来的明暗结构;色彩来自局部参考的估计。蓝天空与蓝机器表面在局部纹理上可能相似,语义更准确的上色通常还需要更丰富的上下文。
用明度匹配,再借取颜色
内容图只有灰度,风格图转换为 LAB 后有明度 L 和两个色度 A、B。两张图先按明度比较,再读取风格近邻的色度。
| 阶段 | 内容图提供什么 | 风格图提供什么 |
|---|---|---|
| 找近邻 | 查询明度块,9 项 | 各个参考明度块,均为 9 项 |
| 借颜色 | 该中心的原明度 | 最近邻中心的 A、B,用来分别求均值 |
两边的明度要采用同一坐标、量级和展平顺序。若一方是 0–255 的文件灰度,另一方是 0–100 的 LAB 明度,同样的中间亮度会写成不同比例的数,距离就会混入编码差异。可把内容图当作三个通道相同的中性 RGB 像素,按风格图用的同一种转换取 L。
准备内容图和风格图
原Step1:内容图A是待上色灰度图,风格图B是提供颜色的彩色图。这里A、B既用于图像名字、又在LAB中用于通道名字,阅读时用“内容A图”“A色度通道”明确区分。两图不必同一尺寸,因为匹配在局部特征空间进行;但必须有足够相似的明度纹理才有可用参考。
先在纸上给两张图贴角色标签:内容图A提供几何结构与每个像素原明度,风格图B提供明度样本以及对应颜色。输出应具有内容图的H_A×W_A尺寸,因为逐个给内容像素上色;风格图可以是不同尺寸,它负责提供参考patch,提供参考颜色。
练一练。内容图100×200、风格图50×80,最后输出应是多大?答案:100×200×3,颜色空间转换后有三通道。A/B既是图片名字又是LAB通道名字,最好写成L_content、a_style等避免混淆。两图不要求严格同位置对应;KNN是在整个参考集合中按特征相似性检索,所以这是颜色转移而非像素一对一配准。
实现前可先做输入检查:内容是否确为单通道或已明确转灰度,风格是否有有效三通道,数组是否为空,像素值范围是否一致。输入读错仍可能产生一个数组,因此“没报错”不等于输入角色正确。
风格转换与内容明度
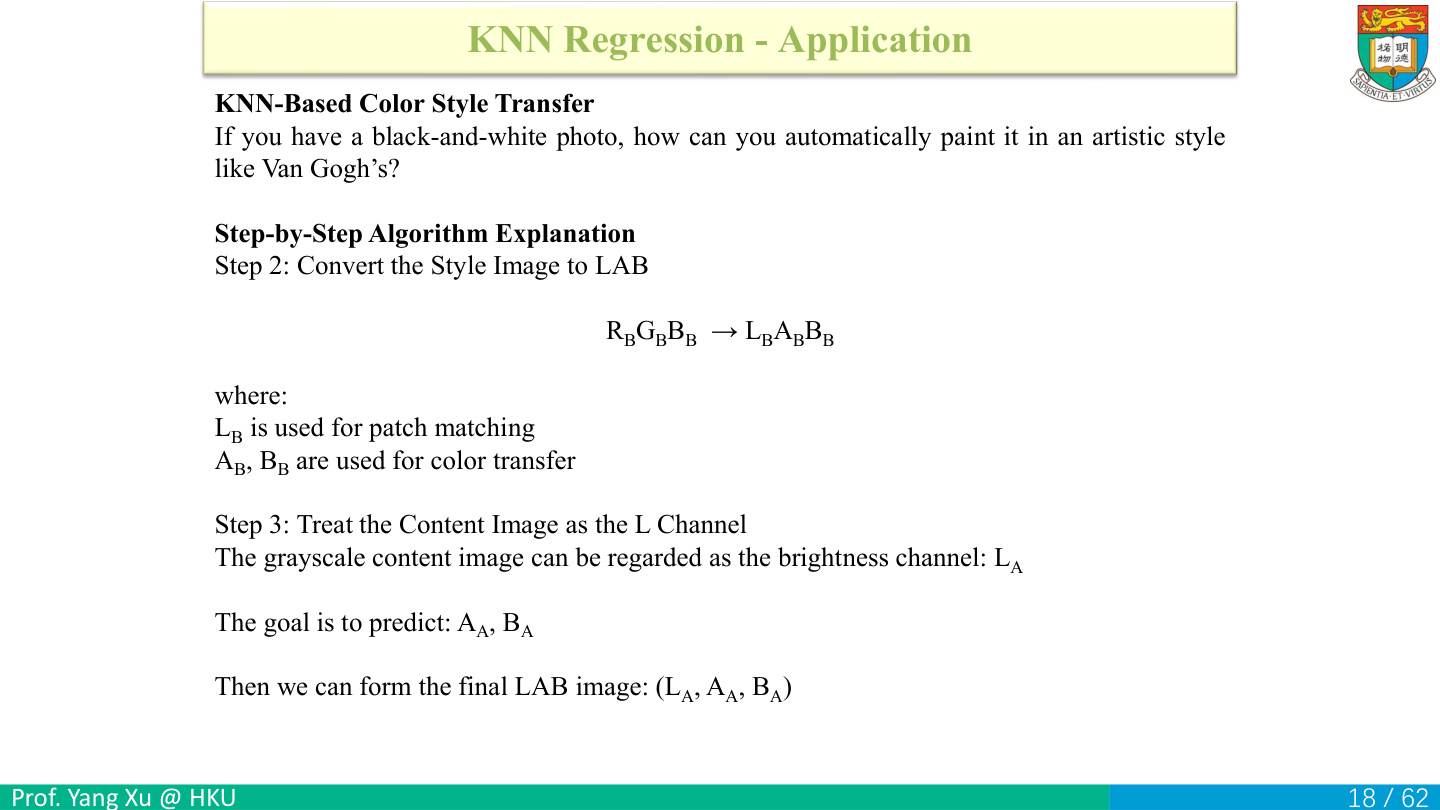
原Step2把风格RGB转换为(L_B,A_B,B_B);L_B用于patch匹配,A_B/B_B作为要借用的颜色标签。Step3将内容亮度记L_A,目标估计A_A/B_A,最终组合(L_A,A_A,B_A)。实现时先按所用库的转换约定,把内容灰度与风格明度统一到可比较的范围。
把中间变量列成表即可减少错线:风格RGB转换得L_style、a_style、b_style;输入特征从L_style提patch;对应目标从a_style、b_style中心点读。内容灰度统一到L_content的约定范围,再提同样patch,输出预测a_content、b_content,最后合并[L_content,a_content,b_content]。
练一练。风格的L_style在最终内容像素中是否应替换L_content?答案:按本页算法不应,它只用于寻找参考;最终保留内容明度。例如内容灰度用0–255、风格L用0–100时,先统一编码与缩放,再计算patch距离;这样距离才反映结构差异。
局部3乘3块
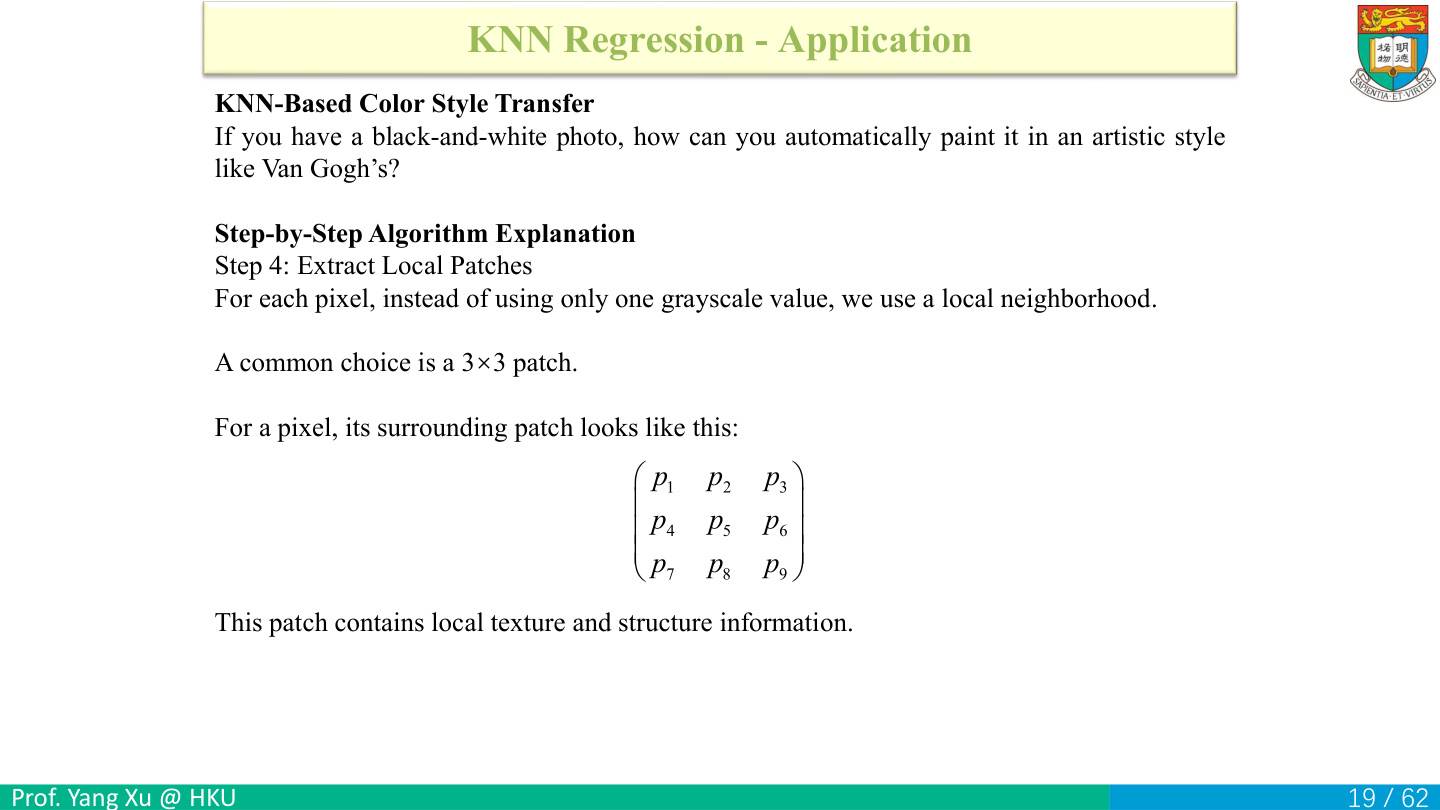
3×3 局部块的中心是 p₅,要为它预测颜色。周围八个值让匹配看到纹理。比如中心同为 80,全 80 的块是平坦区;三行亮度依次全为 0、80、160 的块则有从上到下的明暗变化。只查中心数值会把两种区域认成一样。
采用 Python 从 0 开始的下标,若中心在 (r,c)=(2,2),可用 L[r-1:r+2, c-1:c+2]。切片的结束下标不包含在内,实际取第 1、2、3 行和第 1、2、3 列,正中间仍是 (2,2)。
在 5×5 图里,取完整邻域的中心可落在行号 1、2、3 和列号 1、2、3,共 9 个。边缘没有完整邻域;若 25 个像素都要上色,可以先按同一规则给内容图和风格图补一圈像素,再以原图的每个位置为中心提取邻域。
patch到中心颜色的数据集
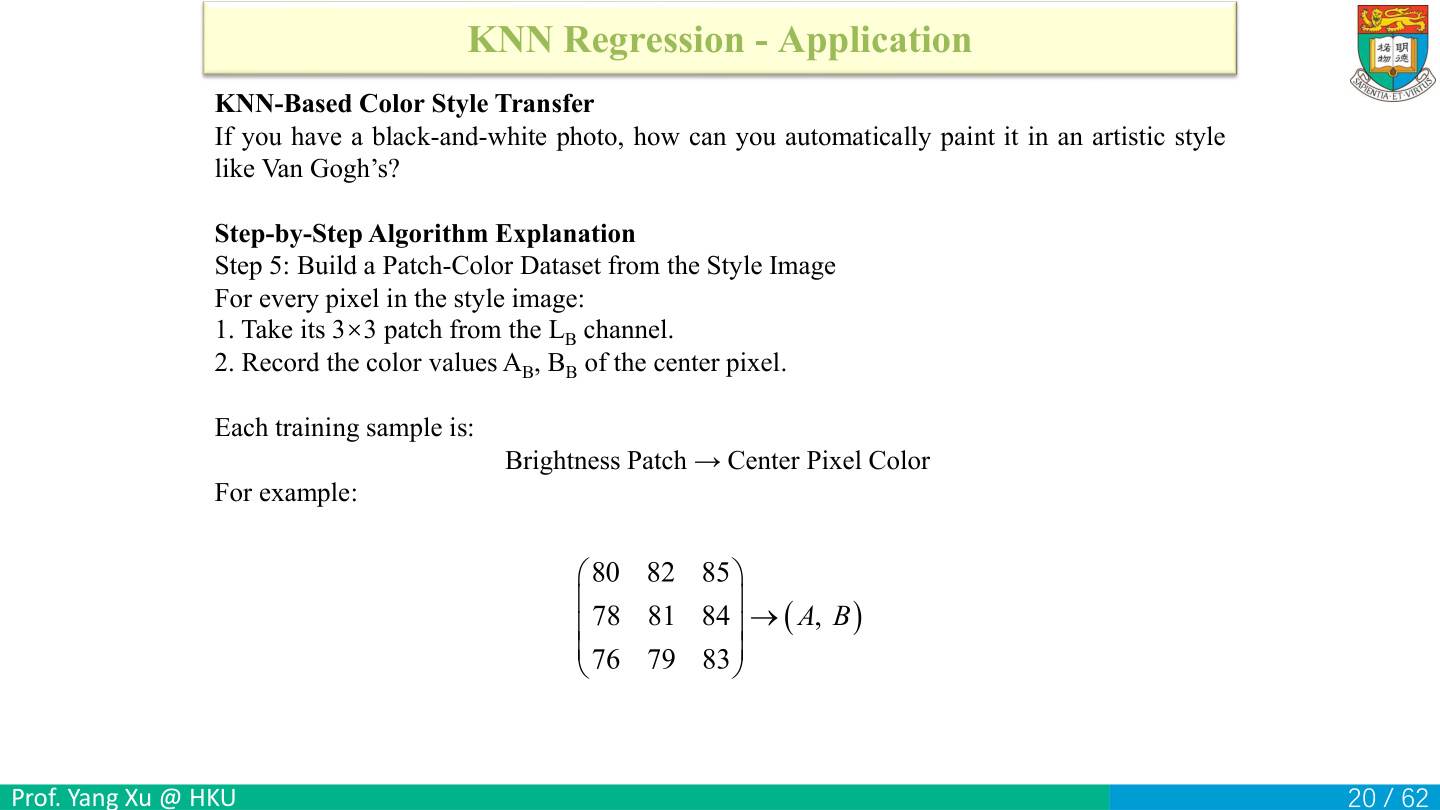
风格图里的每个有效中心 (r,c) 贡献一条记录。先从 L 通道取以它为中心的 3×3 块,再从同一坐标取 A[r,c] 和 B[r,c]。这两个数是要借用的中心颜色。
原页的块是 [[80,82,85],[78,81,84],[76,79,83]],中心亮度 81。按行展平得 (80,82,85,78,81,84,76,79,83)。假如这一点的色度是 (10,−5),就写成下面这一条训练记录:
| 记录索引 | 9 维输入:邻域亮度 | 2 维目标:中心色度 |
|---|---|---|
| 0 | (80,82,85,78,81,84,76,79,83) | (10,−5) |
代码把输入和目标按相同顺序追加。若有 M 个中心,得到 style_features.shape=(M,9) 和 style_colors.shape=(M,2)。下一页查到第 0 条邻居时,就取 style_colors[0]。如果单独打乱颜色数组,形状仍然对,但同一索引已指向别处的颜色。
展平与欧氏距离
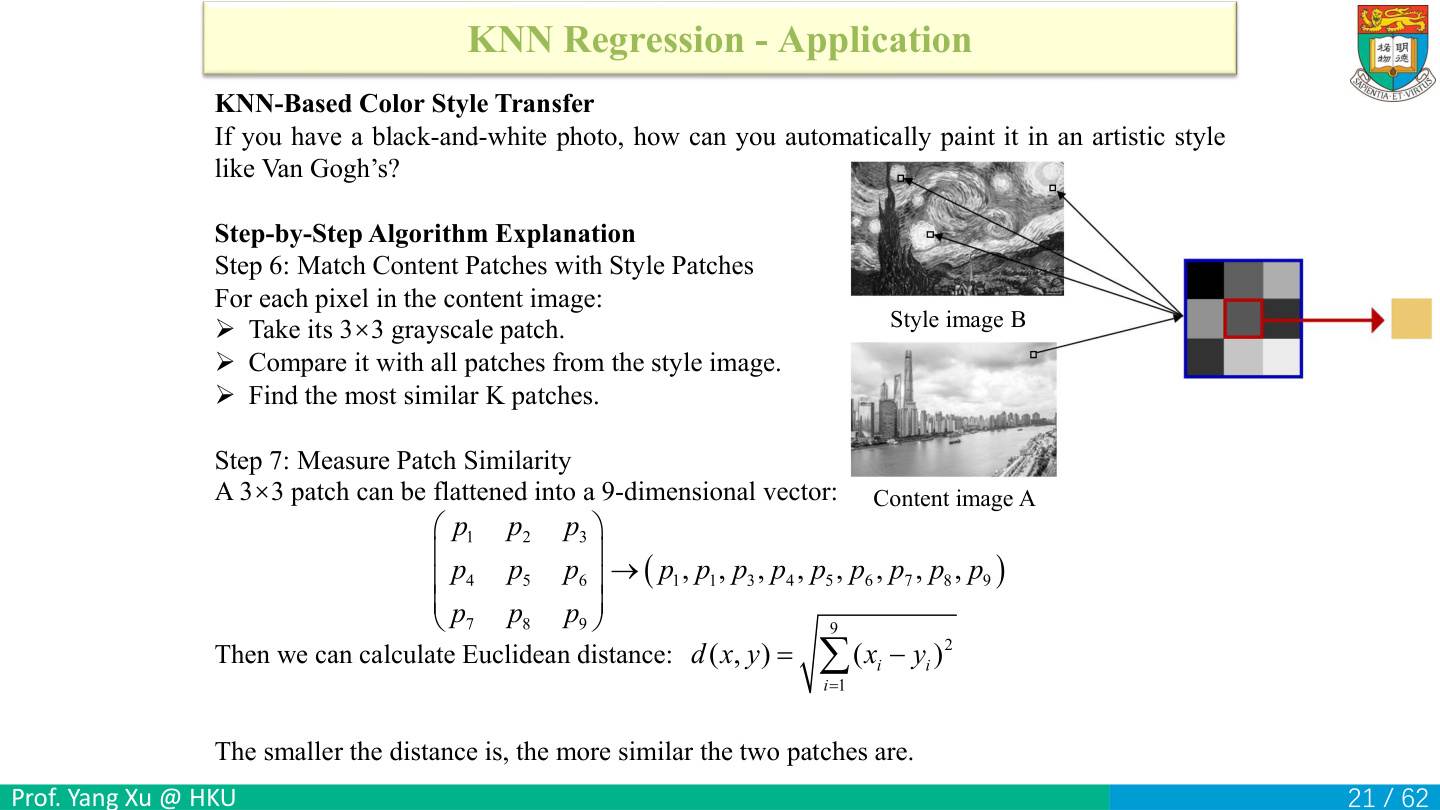
比较时,内容块与风格块都按行展平成 (p₁,p₂,p₃,p₄,p₅,p₆,p₇,p₈,p₉)。课件的第二项重复写了 p₁,按原 3×3 方格实际应为 p₂。
用第20页风格块继续算。假设内容查询 Q 的九项与参考甲相同,只有中心从 81 变为 83;参考乙与 Q 相同,只有第一项从 80 变为 77。
| 参考 | Q 与参考的非零差值 | 平方距离求和 | 欧氏距离 |
|---|---|---|---|
| 甲,索引 0 | 第5项 83−81=2 | 2²=4 | √4=2 |
| 乙,索引 1 | 第1项 80−77=3 | 3²=9 | √9=3 |
距离 d=√Σᵢ(Qᵢ−参考ᵢ)²,其余八个位置每项差 0。平方根会保持大小顺序,挑邻居时可以直接比较平方距离。
数组的逐位置比较可分成三步。style_features 有 M 行,query 是 9 项内容块;亮度数组先转浮点,避免无符号像素相减时出现回绕。
diffs = style_features.astype(float) - query  # (M, 9),每行对应一张参考块
dist2 = (diffs ** 2).sum(axis=1)               # (M,),每个参考块一个分数
nearest = np.argsort(dist2, kind="stable")[:k] # 距离相同保留原记录顺序
若本例只取 k=1,得到索引 0;若这两块是仅有的参考并取 k=2,就得到索引 [0,1],再到颜色表里按这两个索引取中心色度。
对两个色度分别平均
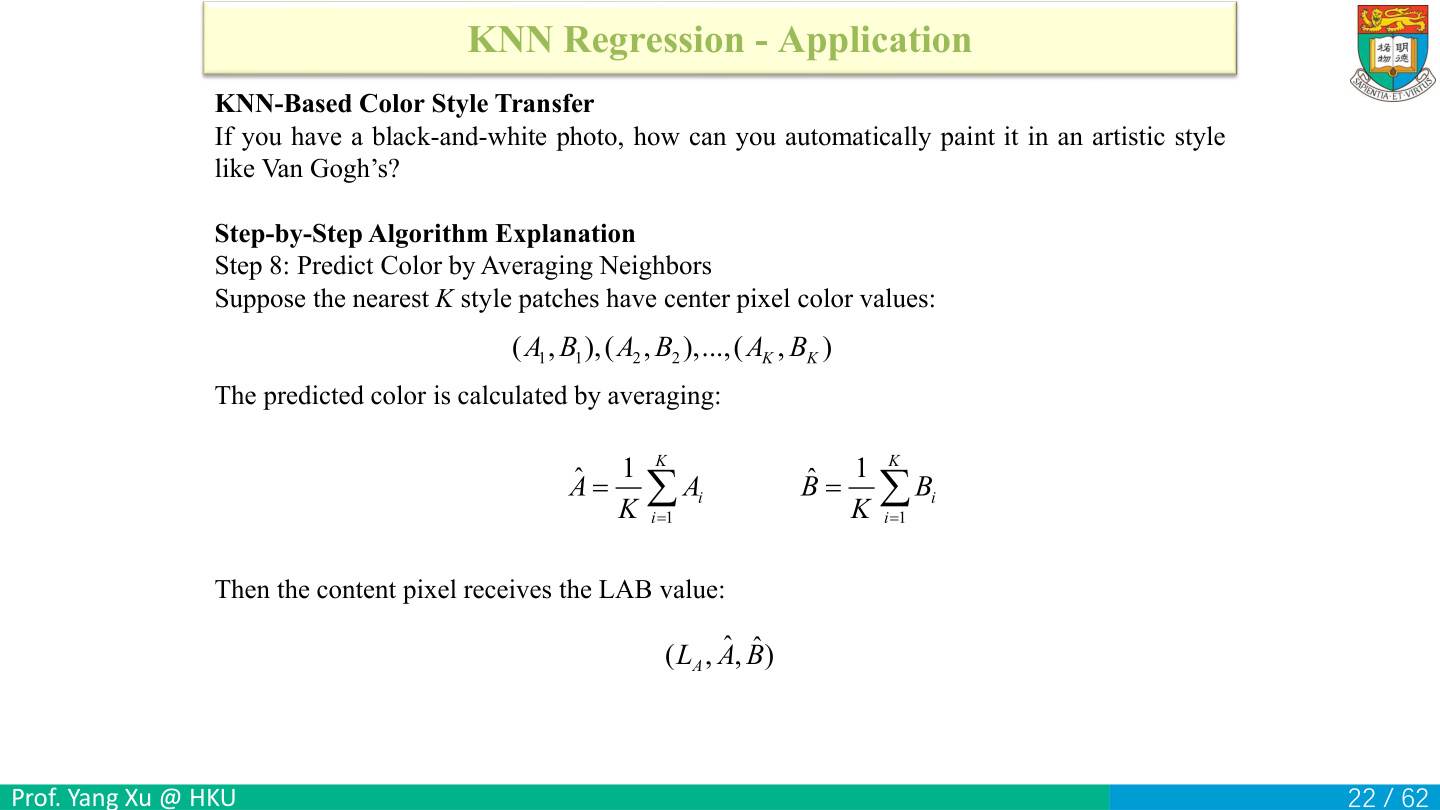
沿用前页的两个邻居。设参考甲、乙的中心色度分别是 (10,−5)、(30,25),那么 style_colors[[0,1]] 会取出两行。两列分别是 A 与 B,沿行的方向平均,得到一个二维结果。
| 色度 | 两位邻居的值 | 平均 |
|---|---|---|
| A | 10、30 | (10+30)/2=20 |
| B | −5、25 | (−5+25)/2=10 |
代码中的 style_colors[nearest].mean(axis=0) 就是分别对两列求平均。前页内容块的中心亮度是 83,于是给中心填 (L,A,B)=(83,20,10)。内容图自己的明度放在第一项,参考图的 L 只用来找近邻。
若采用第10页的距离权重,距离 2、3 的原始权重分别是 1/2、1/3,和为 5/6,归一后为 3/5、2/5。于是 Â=(3×10+2×30)/5=18,B̂=[3×(−5)+2×25]/5=7。普通平均对应每个邻居都有 1/k 的权重。
LAB转回RGB
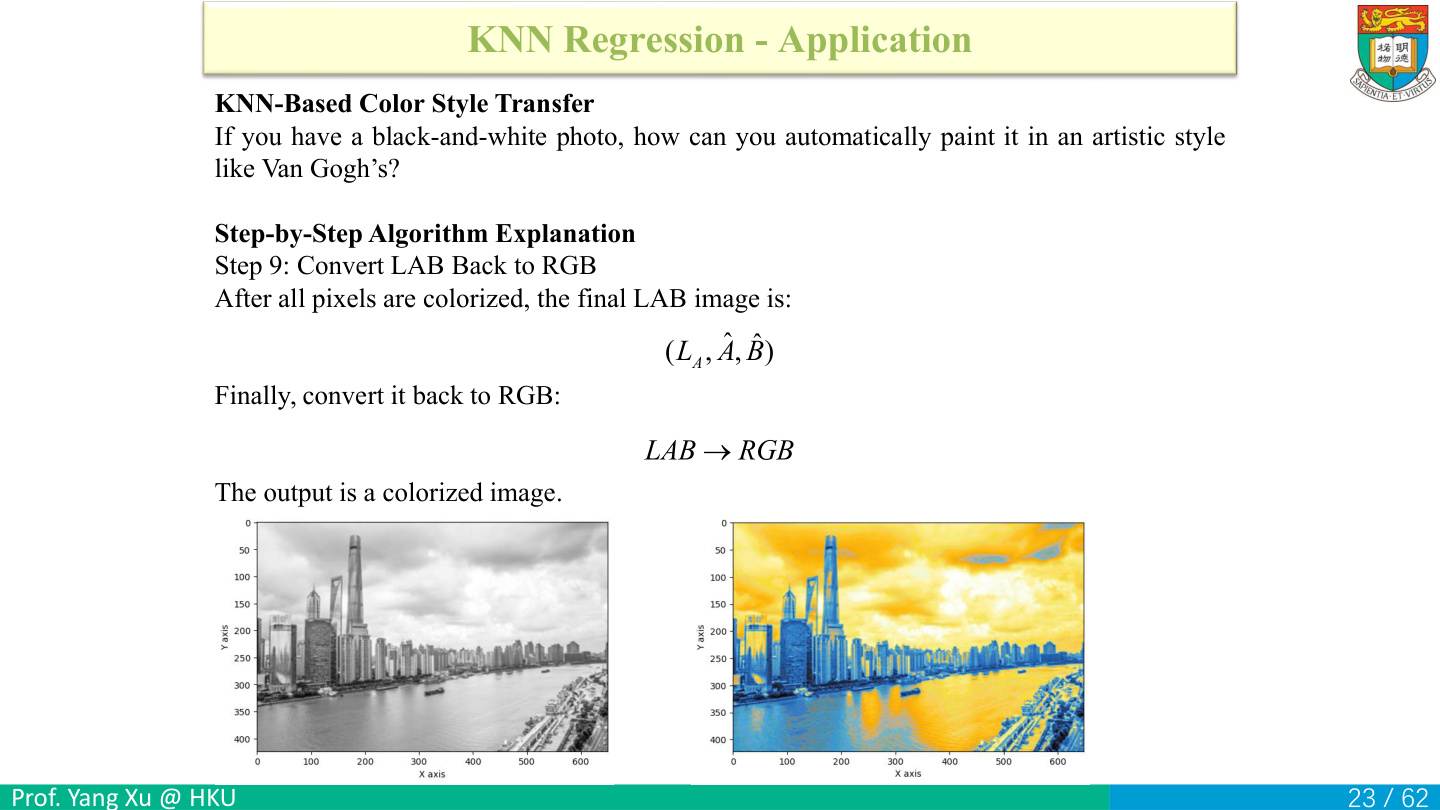
对每个内容中心完成近邻匹配后,手上有三张大小同为 H×W 的数表:原明度 L、估计色度 Â、估计色度 B̂。前页中心在同一位置保存了 83、20、10,合并以后该位置就是 LAB 像素 (83,20,10)。
lab_result = np.stack((L, A_hat, B_hat), axis=-1) 将三个分量放到最后一个轴,得到 H×W×3。再使用与前面相同颜色编码的转换函数,从每个 LAB 像素算出对应 RGB 像素。转换后仍是同样的行列位置与尺寸。若先给明度图补边,输出只取原图中心对应的 H×W 区域。
部分估计出的 LAB 值可能超出显示设备的 RGB 色域。转换库可能裁剪这些颜色;显示前按该库的 RGB 范围保存。若看到红蓝颠倒,可以先核对输出是 RGB 还是 BGR。
休息和流程复盘
复盘颜色转移:取内容明度patch→寻找风格近邻→读取近邻中心A/B→分别平均→与原内容L合并→转回RGB。记住三个尺寸:patch为9维,颜色目标为2维,输出每像素为3通道。
从KNN转向特征与相似度
接下来从岭回归推导样本相似性矩阵K=XXᵀ,再通过特征映射和核表示更丰富的关系。先分清方向:距离通常越小越近,内积则同时受到向量长度和夹角影响。
岭回归回顾
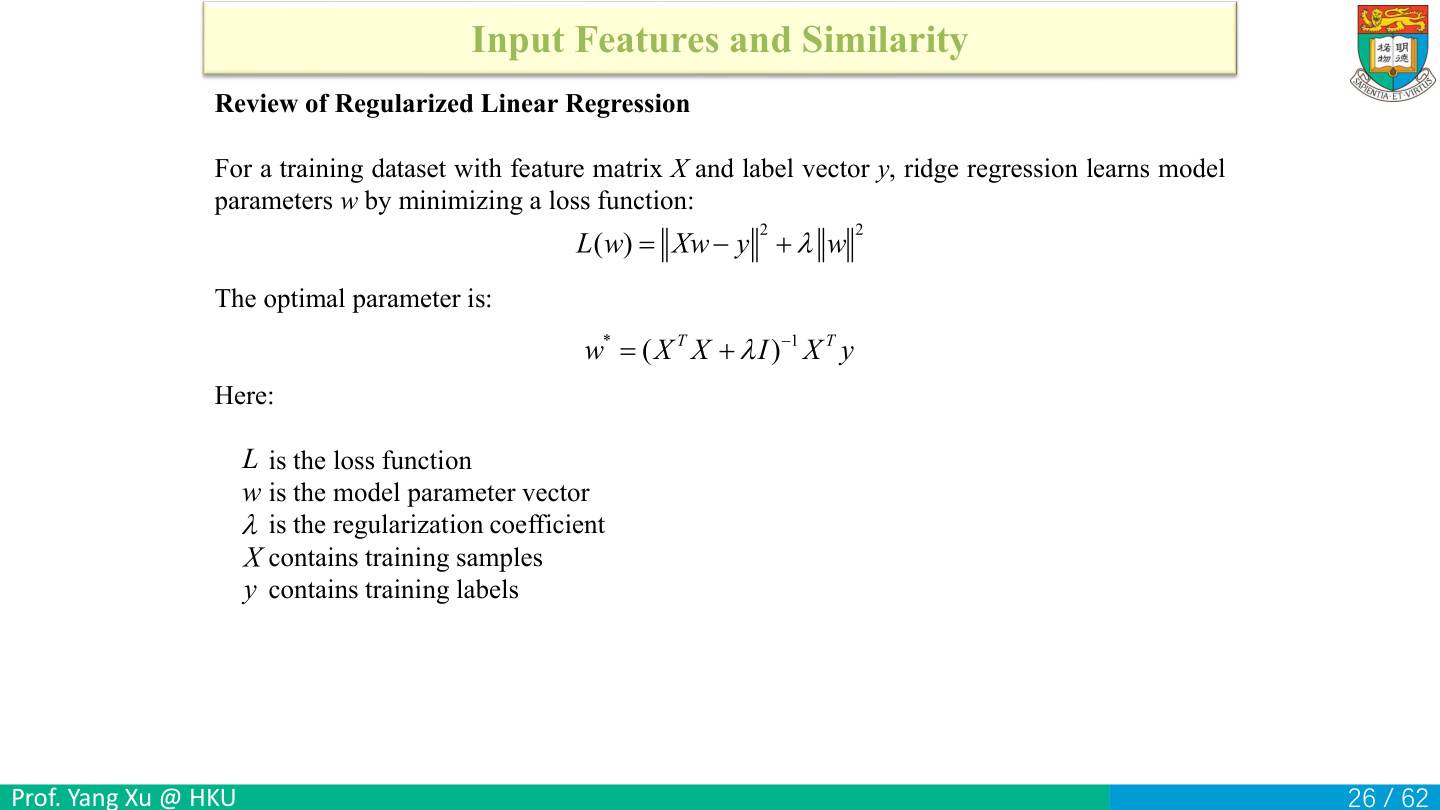
原目标L=||Xw−y||²+lambda||w||²,最优w*=(X^TX+lambda I)^(-1)X^Ty。对第一项求导2X^T(Xw−y),第二项2lambda w,令和为0并消去2,得到正规方程。X为m×d,w为d×1,y为m×1,lambda>0确保可逆。与Lecture2某些页的1/2和平均化约定要核对,不能把lambda数值跨约定直接混用。
先把旧岭回归式逐个形状写出:m条样本、每条d维,X是m×d,w是d×1,y是m×1,XᵀX是d×d,I也必须为d×d。目标没有1/2,但数据项与惩罚项同时都没有,求导都带2,令梯度为0时可整体约掉,所以仍得到课件给的解。
算一遍。一维X=(1,2)ᵀ、y=(2,4)ᵀ、λ=1,XᵀX=1²+2²=5,Xᵀy=1×2+2×4=10,最优w=10/(5+1)=5/3。无惩罚时是2,加入惩罚后收缩。自测此处λ和前讲平均损失版能否直接用同一数值比较?答案:先统一总和/平均及系数约定,再谈同等正则强度。下一步将用这个例子核对样本空间表达。
推穿恒等式的推导
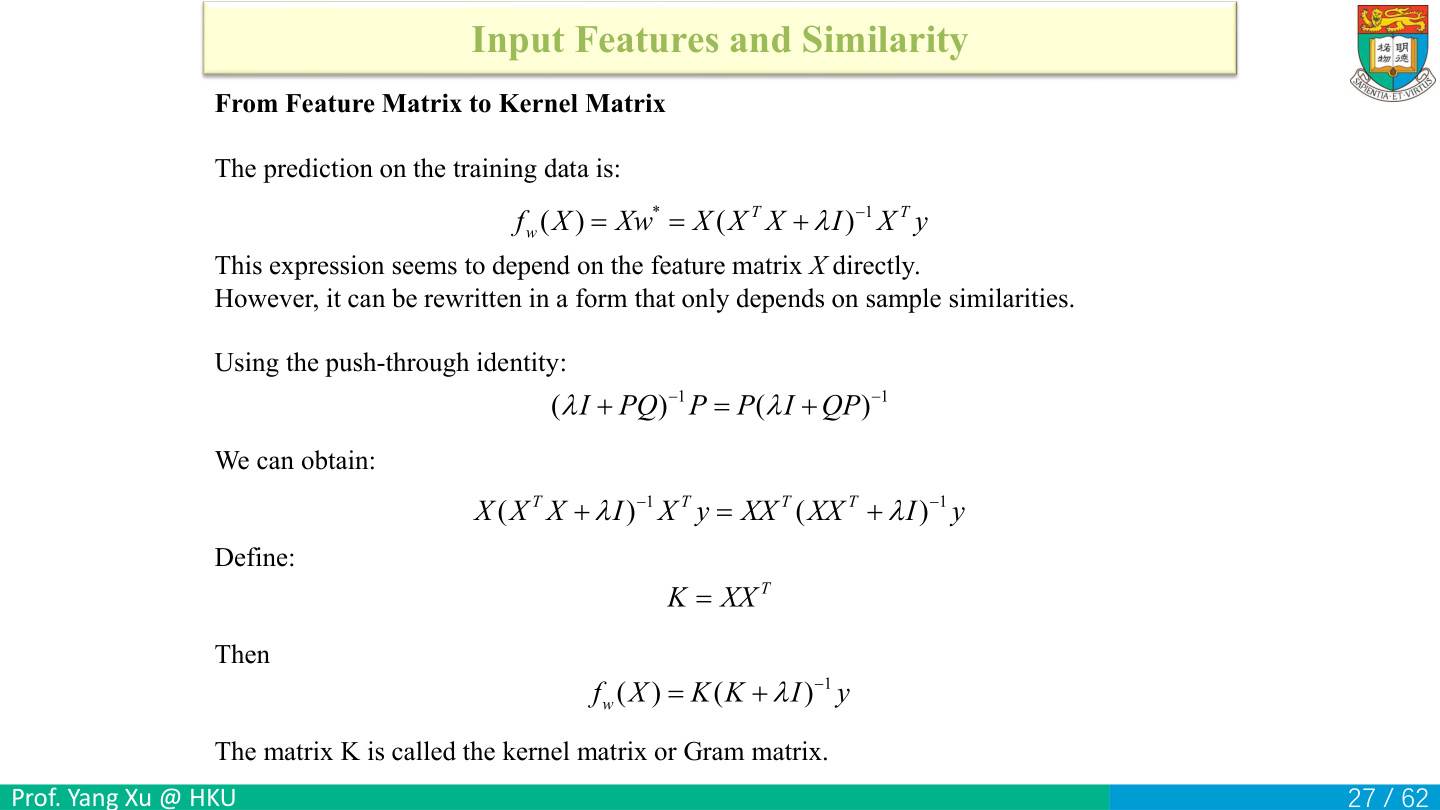
这一页把特征空间的岭回归解,改写成样本相似度矩阵的形式。设m条样本、每条d维,定义:
| 记号 | 定义 | 形状 |
|---|---|---|
| X | 每行一个样本 | m×d |
| A | XᵀX+λI_d | d×d |
| K | XXᵀ | m×m |
| B | K+λI_m | m×m |
I_d与I_m分别是对应大小的单位矩阵;λ>0使A、B可逆。关键不是交换乘法顺序,而是先证明BX=XA:
BX=(XXᵀ+λI_m)X=XXᵀX+λX=X(XᵀX+λI_d)=XA。
然后逐步消去A和B:
- 左乘B⁻¹:
X=B⁻¹XA。 - 再右乘A⁻¹:
XA⁻¹=B⁻¹X。 - 再右乘Xᵀ:
XA⁻¹Xᵀ=B⁻¹XXᵀ=B⁻¹K。 - B=K+λI,所以BK=KB;在等式两侧分别乘B⁻¹,可得B⁻¹K=KB⁻¹。
- 因而训练预测
Xw*=XA⁻¹Xᵀy=K(K+λI_m)⁻¹y。
用前页数据核对:X=(1,2)ᵀ、y=(2,4)ᵀ、λ=1。K=[[1,2],[2,4]],B=[[2,2],[2,5]],行列式2×5−2×2=6,所以B⁻¹=[[5,−2],[−2,2]]/6。于是α=B⁻¹y=((10−8)/6,(−4+8)/6)ᵀ=(1/3,2/3)ᵀ,Kα=(5/3,10/3)ᵀ。
参数路线则w=(1²+2²+1)⁻¹(1×2+2×4)=10/6=5/3,Xw也为(5/3,10/3)ᵀ。两种路线预测相同,求解系统从d×d换为m×m,选择哪种要看样本数与特征数。
内积与余弦
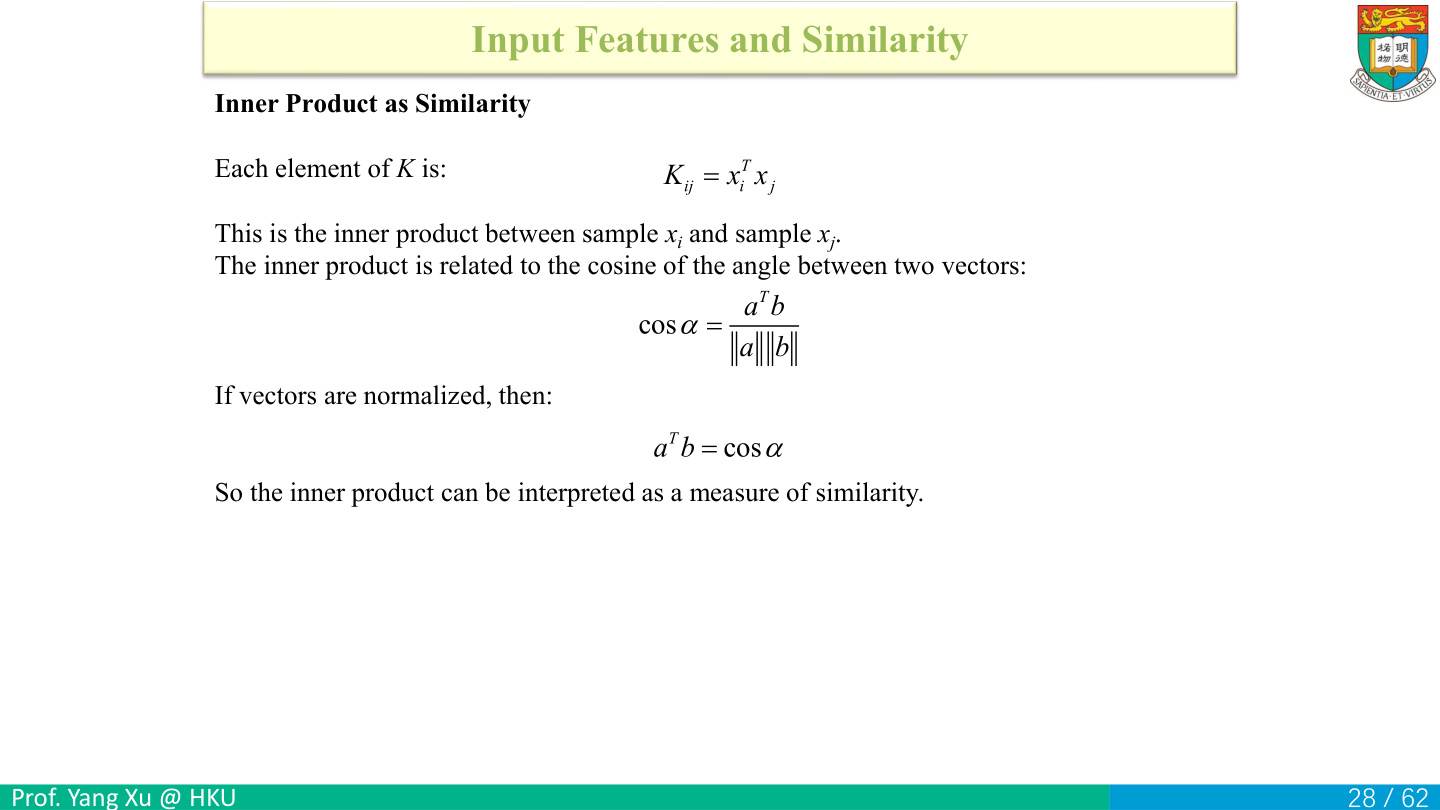
原K_ij=x_i^Tx_j,等于||x_i||||x_j||cos角度。若两个向量都单位长度,才有内积=cos角度;不归一时大长度可使内积很大,即使方向没有更接近。(1,0)与(2,0)内积2,和(100,0)内积100,但两者夹角都0;归一后均为1。零向量无法除以长度,需单独约定。K为Gram矩阵,对称且半正定,不是任意“看起来相似”的数字表。
Gram矩阵第i行第j列放训练样本xᵢ与xⱼ的内积。它的对角Kᵢᵢ=||xᵢ||²,非对角反映二者长度与夹角。对称性来自xᵢᵀxⱼ=xⱼᵀxᵢ。半正定可直接验证:任意系数c,cᵀKc=cᵀXXᵀc=||Xᵀc||²≥0,因此它确实能作为特征内积结构,而非任意填的一张关系表。
练一练。样本x₁=(1,0)、x₂=(0,1),K是什么?答案:[[1,0],[0,1]];两者互相垂直、长度1。若换x₂=(2,0),K=[[1,2],[2,4]],两行相关且秩1。想只比较方向时可归一化非零向量,内积才等于余弦;零向量无法除以自身长度,需明确处理。
新样本的核形式
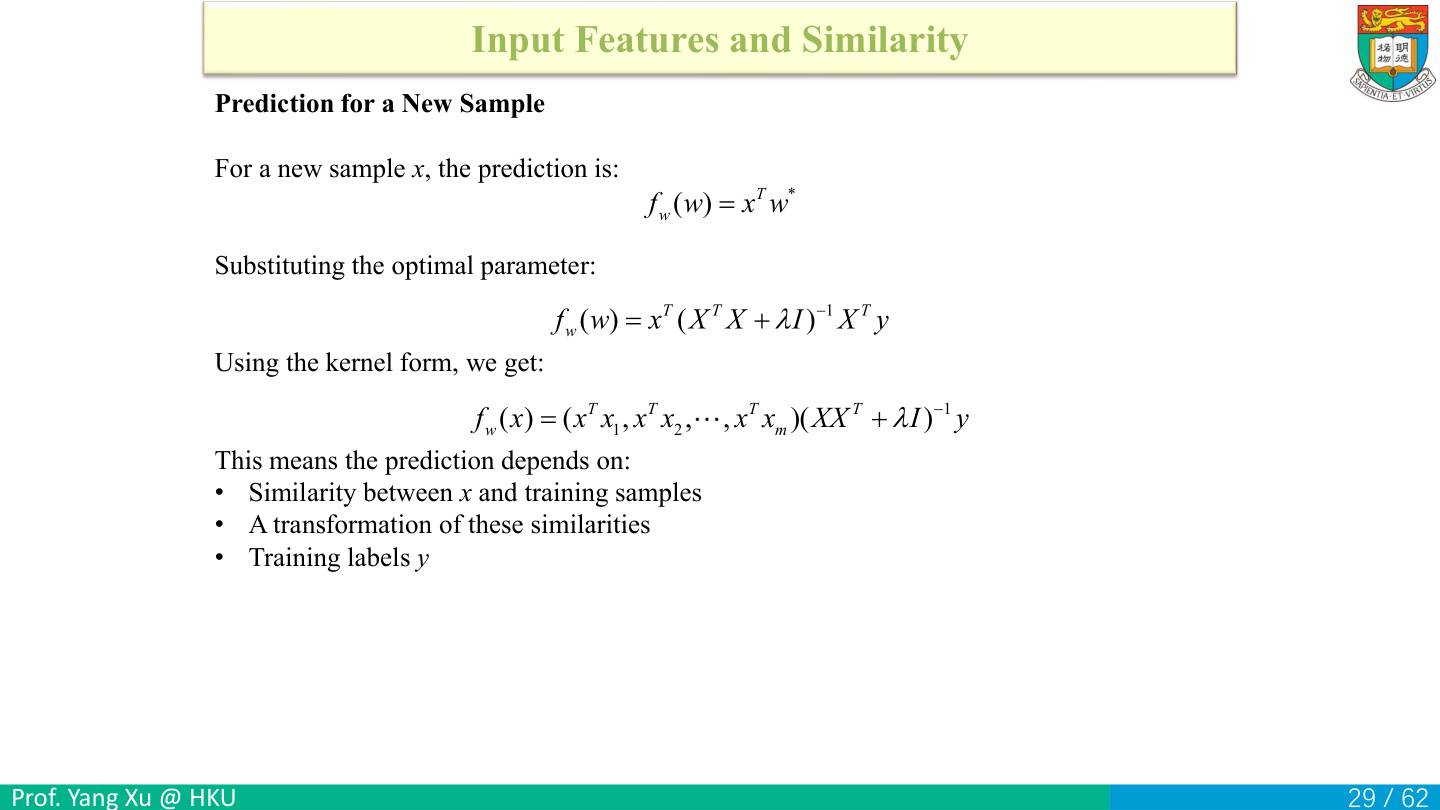
先把第27页的等式接回来。那里定义 A=XᵀX+λI_d、B=XXᵀ+λI_m,并导出了 XA⁻¹=B⁻¹X。两边同时转置会倒转乘法顺序。A 和 B 都对称,其逆也对称,于是 (XA⁻¹)ᵀ=A⁻¹Xᵀ,(B⁻¹X)ᵀ=XᵀB⁻¹,所以:
w*=A⁻¹Xᵀy=XᵀB⁻¹y。
新样本 x 用 f(x)=xᵀw* 预测。代入上式得到 f(x)=(xᵀXᵀ)B⁻¹y;xᵀXᵀ 的第 i 项是 x 与第 i 条训练样本的内积。课件公式前两处写 f(w),按这一含义应读 f(x)。
训练时解 Bα=y 得 m 维系数 α。预测时计算 k(x)=(xᵀx₁,…,xᵀx_m)ᵀ,再把对应项相乘求和,即 f(x)=k(x)ᵀα。
沿用训练点 1、2,α=(1/3,2/3)ᵀ。查询 x=3 时,两个核值为 3×1=3、3×2=6,得到 3×1/3+6×2/3=5。原模型用 w*=5/3,代入 x=3 也是 5。系数 α 由整组样本的方程决定,可以为负,也没有和为 1 的要求。
长宽到面积的特征映射
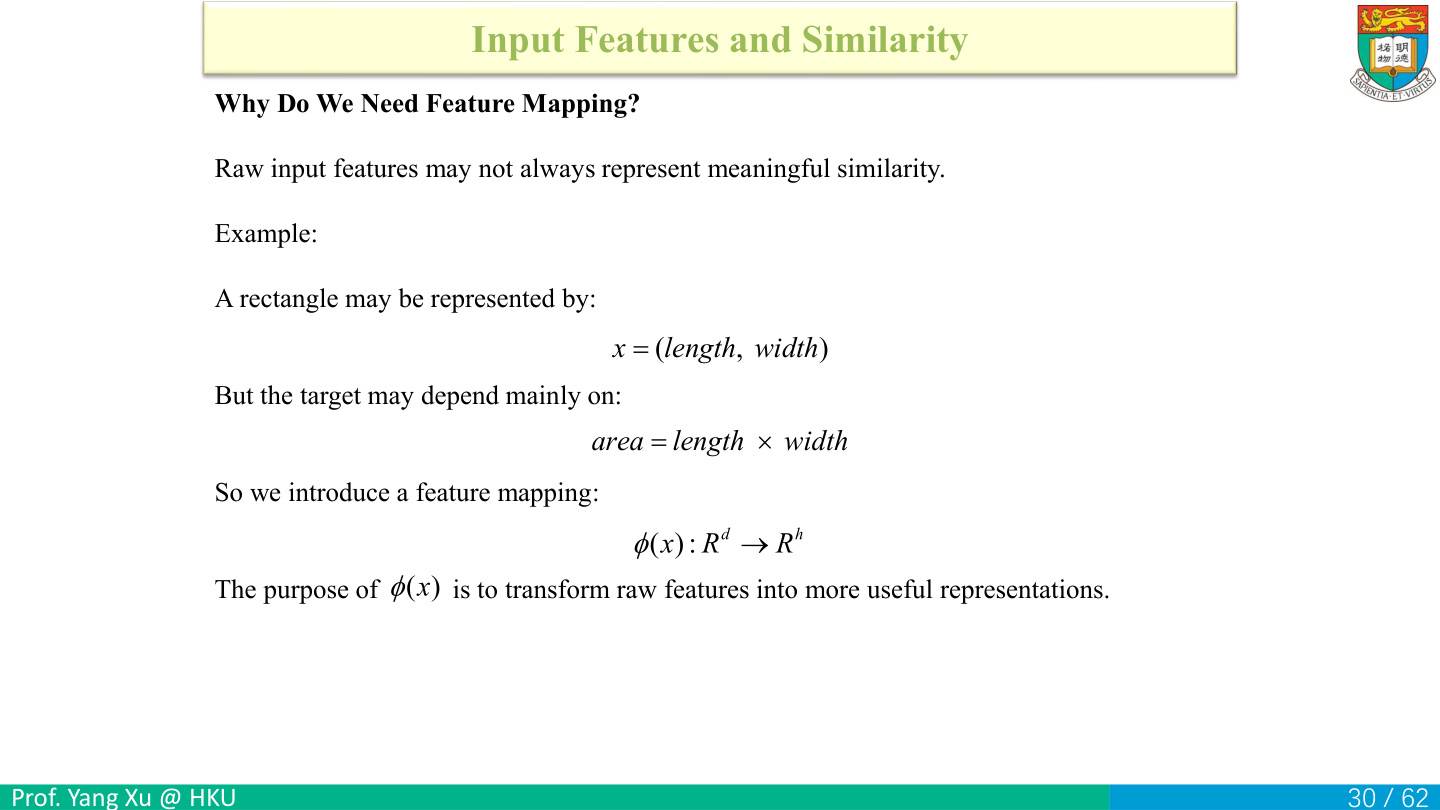
课件用矩形的长度 l、宽度 w 举例,面积为 l×w。原始线性模型 ŷ=a l+b w+c,每当长度增加 1,模型的预测总增加 a。面积的增量却是 (l+1)w−lw=w。例如宽为 1 时长度每加 1,面积加 1;宽为 2 时,面积加 2。一个固定的 a 无法同时表达两种增量。
把输入改写为 φ(l,w)=(l,w,lw),模型仍对新特征的系数线性。取长度和宽度的系数为 0、面积特征的系数为 1,马上得到 ŷ=lw。这就是特征映射 φ,从原来的 d 维向量计算一个 h 维向量,本例 d=2、h=3。
(2,6) 与 (3,4) 在原坐标里相隔 √5,但面积同为 12;(2,6) 与 (2,7) 的原坐标距离为 1,面积却差 2。对主要由面积决定的任务,加入乘积项可以给模型直接使用的信号。
核等于映射后的内积
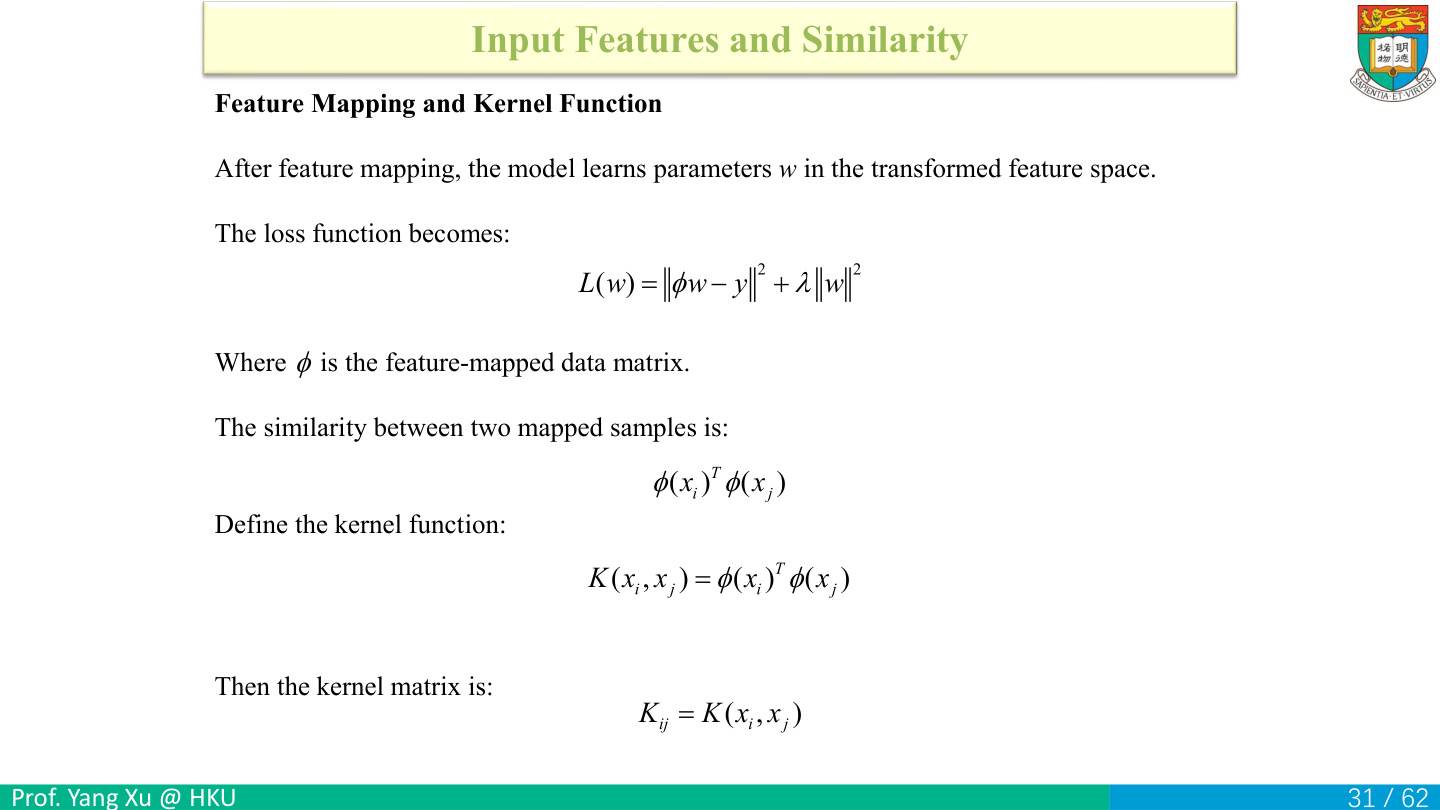
原映射矩阵Phi每行phi(x_i)^T,目标||Phi w−y||²+lambda||w||²。定义k(x_i,x_j)=phi(x_i)^T phi(x_j),于是K_ij为两映射样本内积。phi(x)=(x,x²),x=2、z=3,则phi(2)=(2,4)、phi(3)=(3,9),核值6+36=42。核不是单独对一个样本的预测,也不等于标签是否相同。
把φ矩阵与φ函数区分:φ(x)是单条样本的h维列向量,Φ将m条变换后的样本按行排成m×h矩阵;K=ΦΦᵀ始终m×m,不随h直接扩成h×h。第i,j项是φ(xᵢ)ᵀφ(xⱼ),因此核值表示“在新特征中的内积”,并不是最终预测值。
算一遍。φ(t)=(t,t²),两样本t=1与2,变换为(1,1)、(2,4),K=[[2,6],[6,20]]。K₁₂=1×2+1×4=6;K₂₂=2²+4²=20。自测若只知道核函数k(t,s)=ts+t²s²,是否还需要真的保存每个φ分量?答案:为计算这些核值不需要,直接代入t、s即可。这就是直接计算核值的思路。
核技巧与计算边界
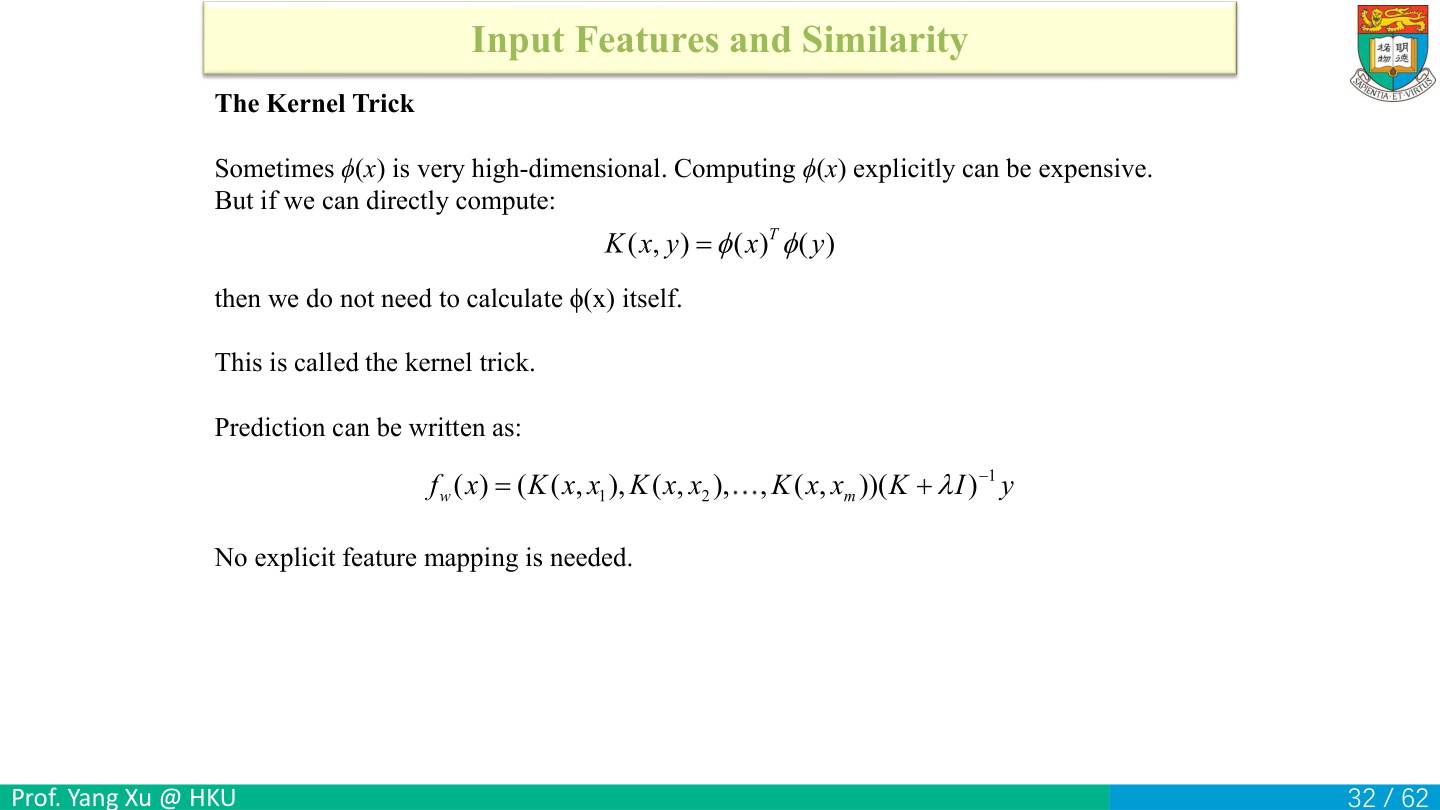
核技巧直接计算 k(x,z)=φ(x)ᵀφ(z)。训练用 Kᵢⱼ=k(xᵢ,xⱼ) 解 (K+λI)α=y,预测用 f(x)=k(x)ᵀα。这等价于用映射后的特征拟合,但计算时不必构建每个 φ 向量。
看二维二次核,k(x,z)=(xᵀz)²=(x₁z₁+x₂z₂)²。平方展开为 x₁²z₁²+2x₁x₂z₁z₂+x₂²z₂²。所以可理解为映射 φ(x)=(x₁²,√2 x₁x₂,x₂²):两个向量的中间项相乘,两个 √2 正好给出系数 2。
取 x=(1,2)、z=(3,4)。直接算内积再平方:(1×3+2×4)²=11²=121。显式映射得到 (1,2√2,4) 和 (9,12√2,16),再算内积 9+48+64=121。
有效的内积核会产生半正定的 K,因为任意系数向量 c 都满足 cᵀKc=||Φᵀc||²≥0。直接算核值能省去显式高维特征,但 m 条训练样本的稠密 K 仍要存 m² 项。
转入SVM
前面研究输入怎样表示,接下来研究边界怎样选:SVM用最大间隔和松弛约束来训练分类器。二分类标签从Logistic的0/1改为−1/+1,以便用“标签×分数”统一表达分类正误。
SVM的标签约定
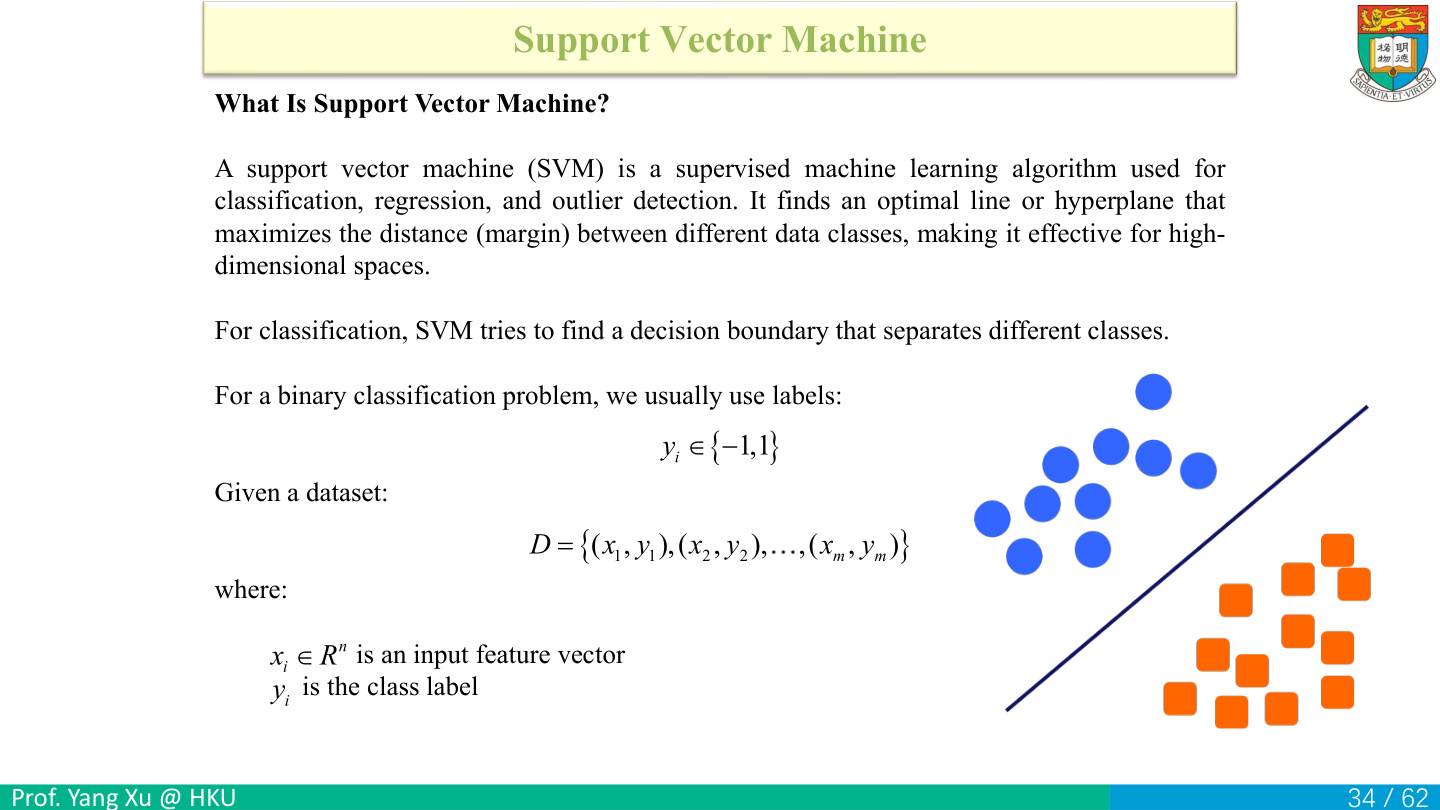
SVM有分类、回归和异常检测等用途,这里讨论二分类,y_i∈{−1,+1},x_i为n维特征。使用±1使y_i乘判别分数后统一表示分类是否正确。若把Logistic的0/1标签直接代入SVM约束,负类y=0会让左边恒0,约束失效。
为什么换成±1?正类分数希望>0,负类分数希望<0,乘上其真实标签后,两种正确情况都变成正数:(+1)×正=正,(−1)×负=正。错分则乘积为负,因此一个量yᵢ(wᵀxᵢ+b)便可统一描述两类,后面的间隔约束才写得简洁。
算一遍。正类样本分数2,带标签分数2;负类样本分数−3,乘标签−1得到3,都是正确。若负类分数+0.5,乘标签得−0.5,是错误。自测若负类仍用0,yᵢ分数能否检查正误?答案:恒等于0,失去作用,所以不能直接搬Logistic标签。xᵢ的n维只是输入长度,m才是样本数量;别把不同页面用的d/n记号强行混成一个固定字母。
标签乘分数的正负可用一张符号表核查:同号乘积正,异号乘积负。若计算出的某个负类分数很负却被你标为错误,先检查是否忘了乘标签−1,而不是急着修改边界参数。
边界 法向量 符号
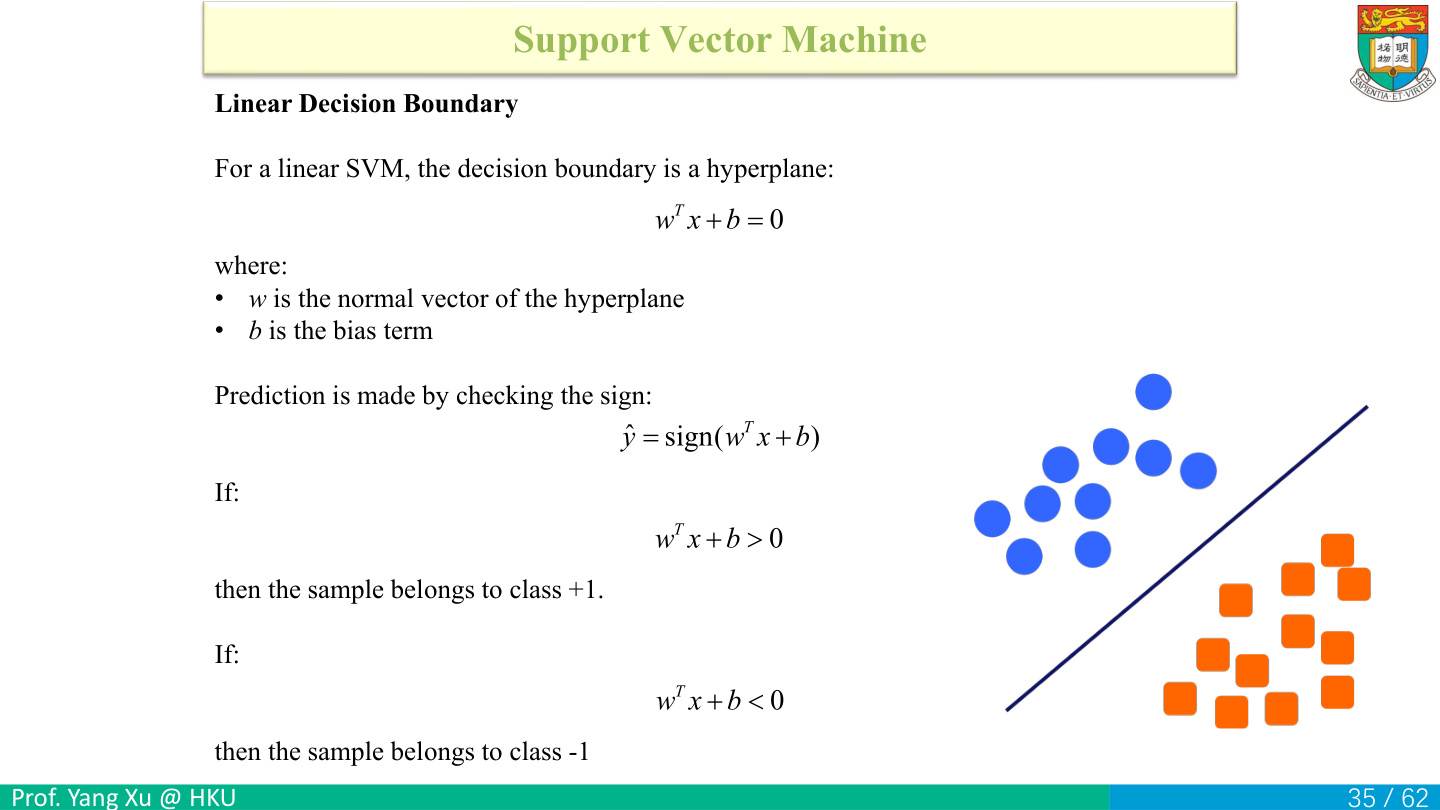
原边界w^Tx+b=0,w是垂直边界的法向量,b控制平移;预测sign(w^Tx+b)。分数正判+1,负判−1,等于0的平局需预先约定。w=(1,0),b=−2,边界x1=2,点(3,5)分数1判正,(1,5)分数−1判负。第二坐标在此不影响预测。
超平面是高维中的线性边界:二维是一条线,三维是一个平面,更高维称超平面。w指向垂直边界的方向,沿边界移动时wᵀx保持不变。b使整条边界平移,通常不应把它误当某一个坐标的独立缩放。w=0时没有正常的法向量,后面距离式也无法用。
算一遍。w=(2,−1)、b=−1,边界2x₁−x₂−1=0,即x₂=2x₁−1。点(2,1)分数4−1−1=2判+1;点(0,1)分数−2判−1。自测把w、b都乘2,类别会变吗?答案:只要乘的是正数,符号不变、边界不变;若乘负数则符号翻转,类别解释也翻转,不能不加条件地说任意缩放都同一分类器。
边界与法向量垂直可由差向量验证:若x、z都在边界,则wᵀx+b=0、wᵀz+b=0,两式相减得wᵀ(x−z)=0,所以沿边界的位移与w内积为0,即相互垂直。
为什么最大间隔
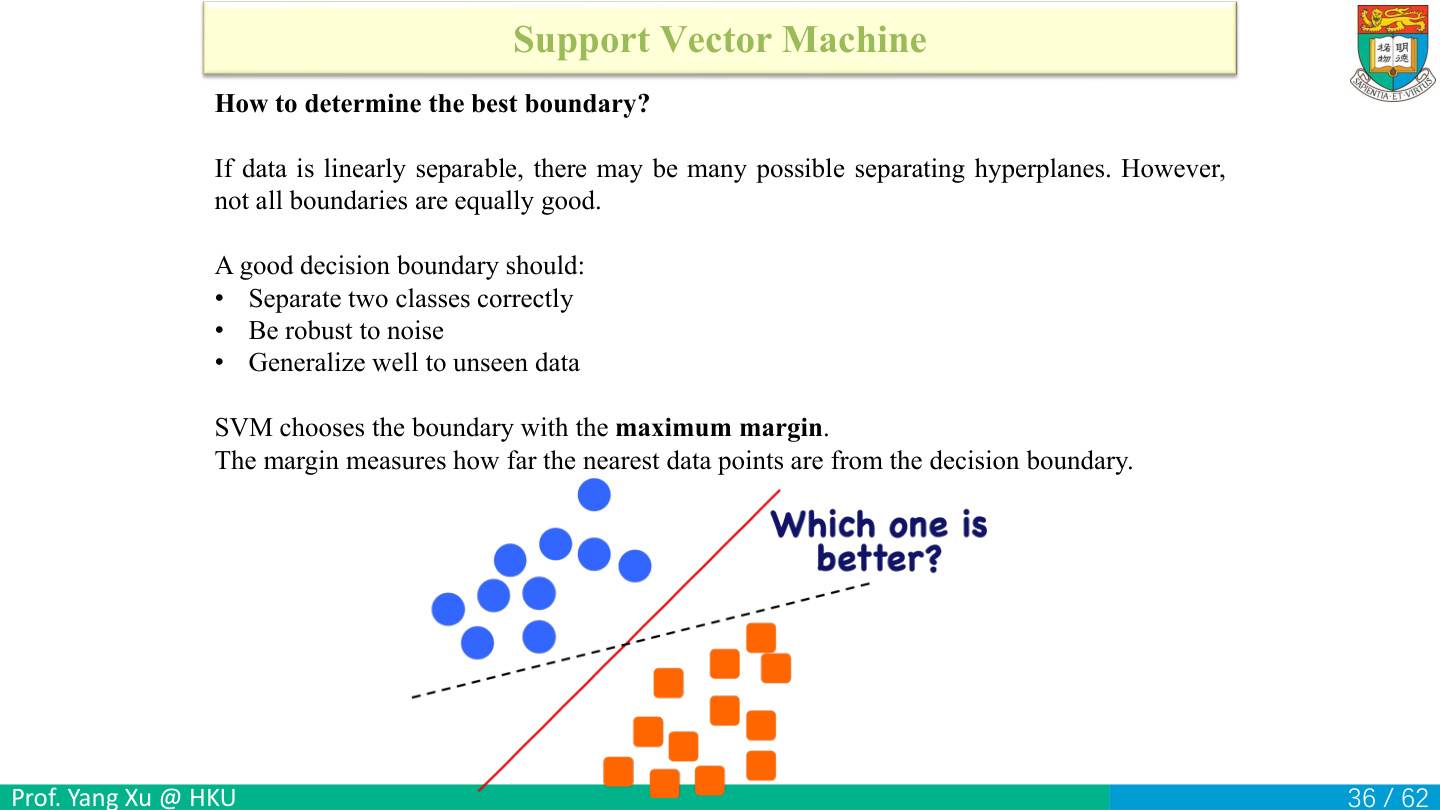
下方图里的红实线和黑虚线都能分开蓝点与橙方。比较它们时,对每条线找离它最近的训练点,再看点到线的垂直距离。SVM 选择让这个最近距离尽可能大的边界。
一维负样本为 −2,正样本为 4。边界要落在两点之间。
| 边界位置 c | 到 −2 的距离 c+2 | 到 4 的距离 4−c | 取较小值 |
|---|---|---|---|
| 0 | 2 | 4 | 2 |
| 1 | 3 | 3 | 3 |
| 3 | 5 | 1 | 1 |
两边距离总和固定为 6,所以较小的一边最多只能是 3。令 c+2=4−c,解得 c=1,恰让两边都是 3。这个例子中,两侧最靠近的点夹出了边界,正是支持向量起作用的方式。
几何间隔与图的宽窄缓冲
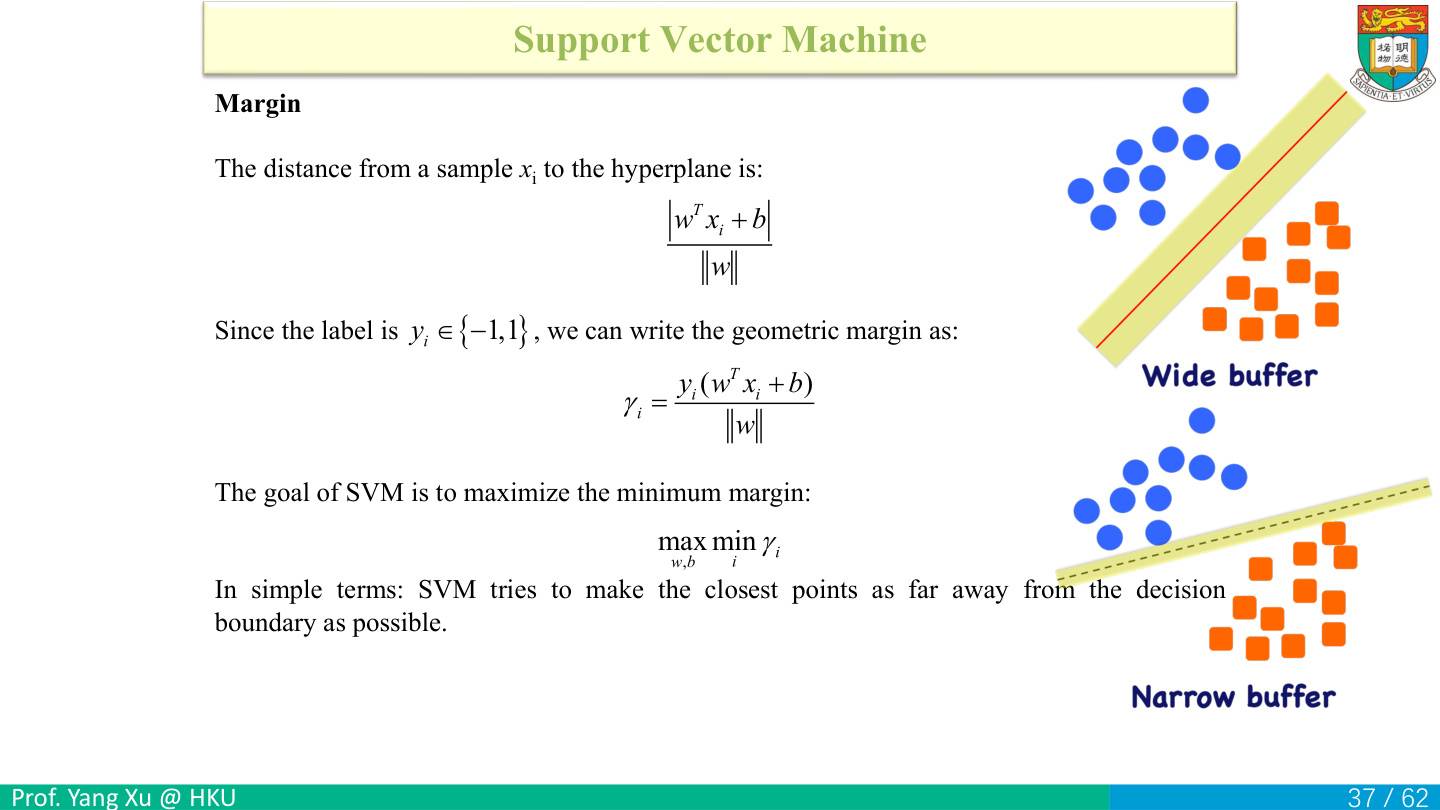
图中上方的黄色带较宽,下方较窄。两条中心线都能分开蓝点和橙方;若看离线最近的训练点,上图留下的缓冲更宽。
设分数 sᵢ=wᵀxᵢ+b。点离线的无符号距离是 dᵢ=|sᵢ|/||w||,只关心离线多远。带标签的几何间隔 γᵢ=yᵢsᵢ/||w|| 同时保留正误:正确侧取正,错误侧取负,边界上取 0。对一条候选边界,用 minᵢ γᵢ 找最差点,再在候选边界中让这个最小值尽可能大。
例如 w=(3,4)、b=0,长度 ||w||=√(3²+4²)=5。点 (1,0) 的分数为 3,无符号距离为 3/5。若它的真实标签为 +1,带标签间隔为 +3/5;若标签为 −1,则为 −3/5,表示这个点落在错误一侧。用长度 5 作除数,消除了分数随参数整体缩放的变化。
点到超平面的距离逐步推导
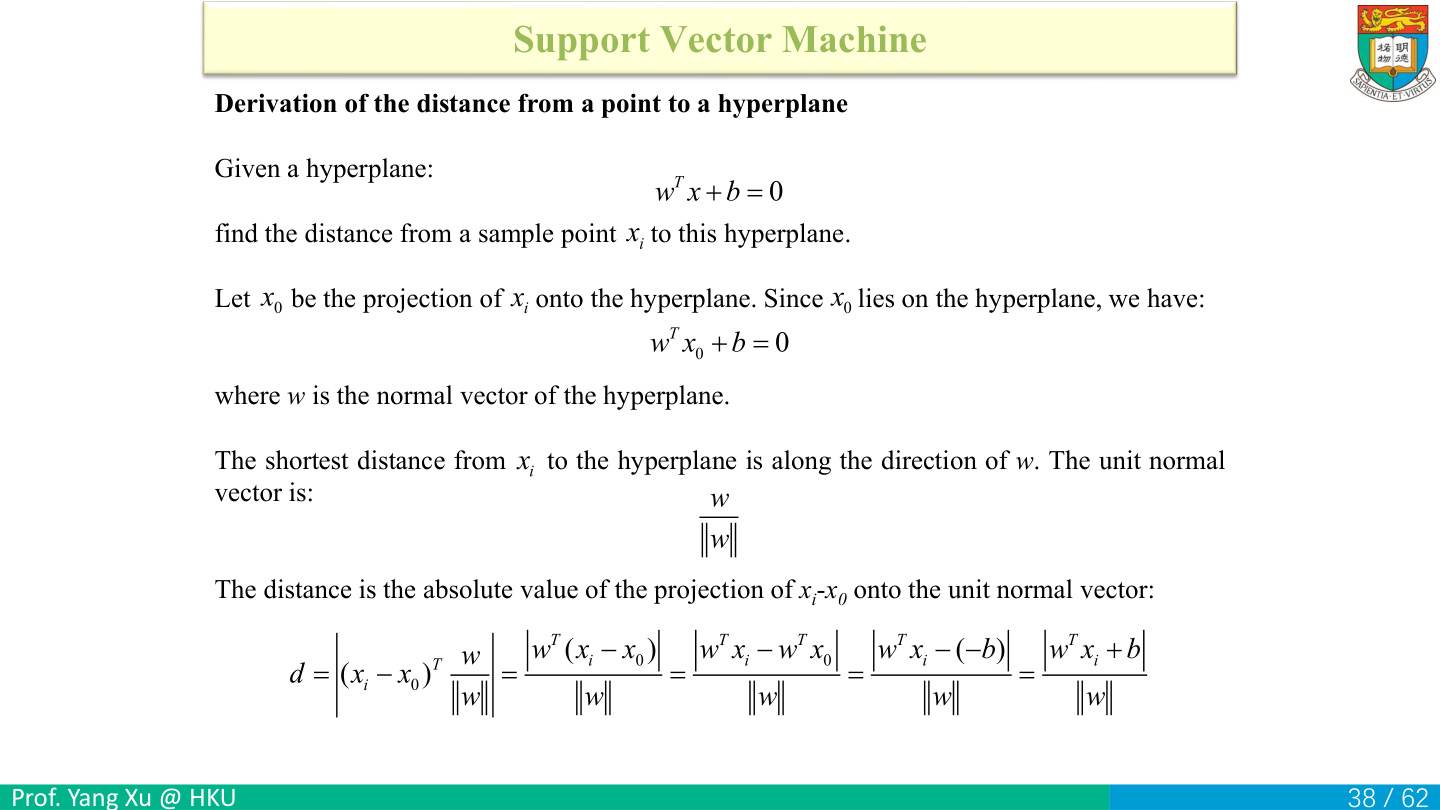
要算点xᵢ到边界wᵀx+b=0的最短距离,先找垂足x₀:它在边界上,并且从xᵢ到x₀的位移垂直边界,沿法向量w。这里要求w≠0。
先看一眼具体位置。边界x₁=2,点P=(5,7);最短路线只改变第一坐标,落到P₀=(2,7):
x1 = 2
   |
   | P0(2,7) ----- 3 ----- P(5,7)
   |
回到一般公式,分四步:
- 将法向量缩成长度1:u=w/||w||。
- 位移在这个单位方向上的长度是投影绝对值,故
d=|uᵀ(xᵢ−x₀)|。 - 代入u并展开分子:
d=|wᵀxᵢ−wᵀx₀|/||w||。 - 因x₀在边界上,wᵀx₀+b=0,移项得wᵀx₀=−b;代回即
d=|wᵀxᵢ+b|/||w||。
具体例子中w=(1,0)、b=−2,||w||=1,d=|5−2|/1=3,与图中水平距离一致。如果等式同乘2,写成2x₁−4=0,分子变|10−4|=6,分母变2,距离仍3。
绝对值使几何距离非负;上一页的带标签间隔则用yᵢ保留分类正误。边界上任意其他点可能需要沿边界多走一段,垂足才给最短路线。
函数间隔与几何间隔
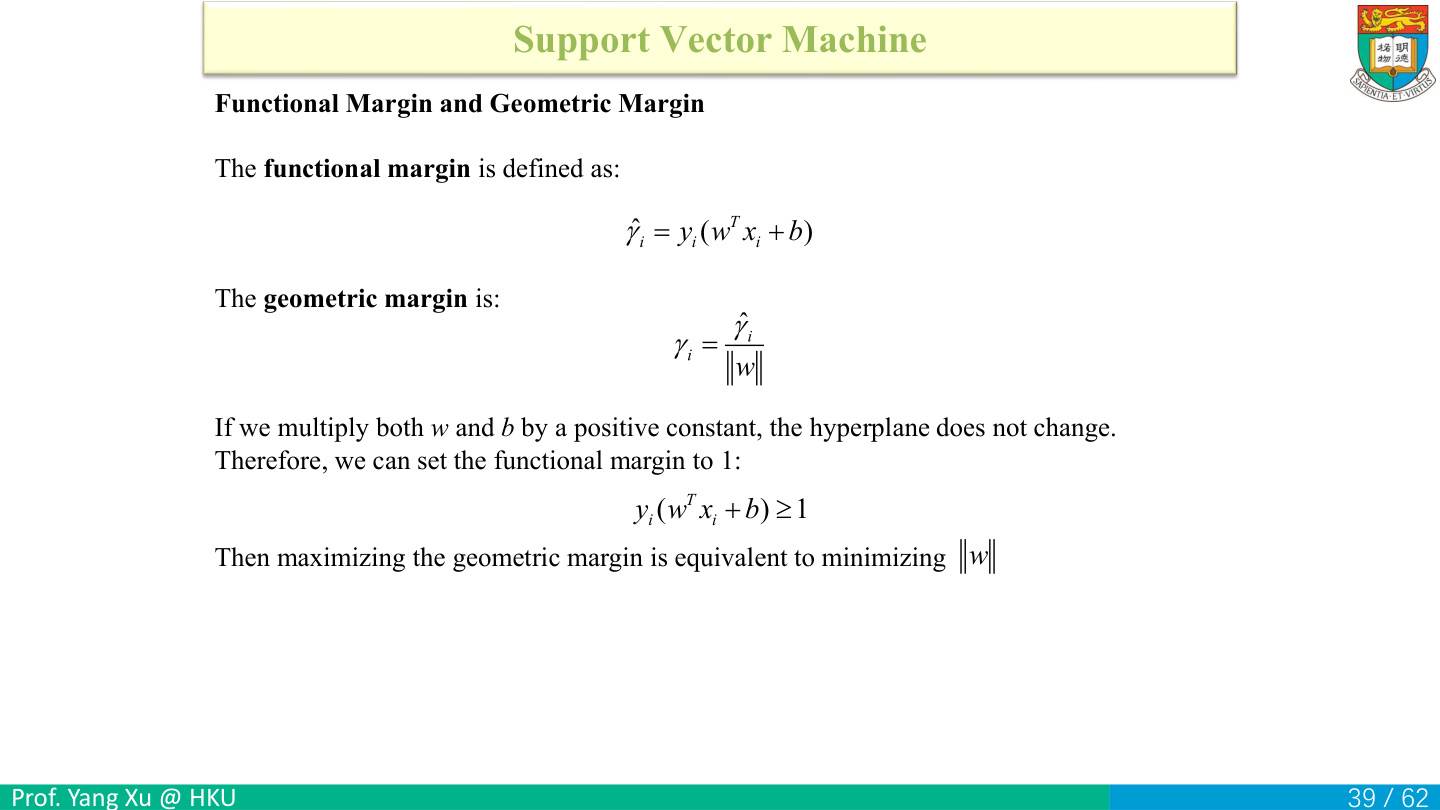
原函数间隔hat_gamma_i=y_i(w^Tx_i+b),几何间隔=hat_gamma_i/||w||。把w、b同乘正数c,分数和函数间隔乘c,边界与几何间隔不变。因此先固定最小函数间隔为1,约束所有点y_i(w^Tx_i+b)≥1,再最大化1/||w||。不是让每个点都等于1,只有最贴边支持点通常取等号。
函数间隔ŷγ=yᵢsᵢ会随(w,b)的整体数值尺度改变,几何间隔却会抵消该尺度。在线性可分且正确侧最小函数间隔a>0时,把w、b都除a,便使最小函数间隔变1,不改几何边界。于是可在这个标准尺度下,要求所有样本≥1,再优化||w||。
练一练。三个带标签分数原为2、3、5,把w、b除2后得到1、1.5、2.5;是所有点都等于1了吗?答案:不是,只有最小的变1,其他仍≥1。这是把最近支持点贴在间隔线,而不是强迫所有样本都挤在两条线上。单侧几何间隔为1/||w||,因此在已固定尺度后,才可以通过减小||w||扩大间隔;未固定尺度时直接比较范数没有同样意义。
正确侧与正的安全距离
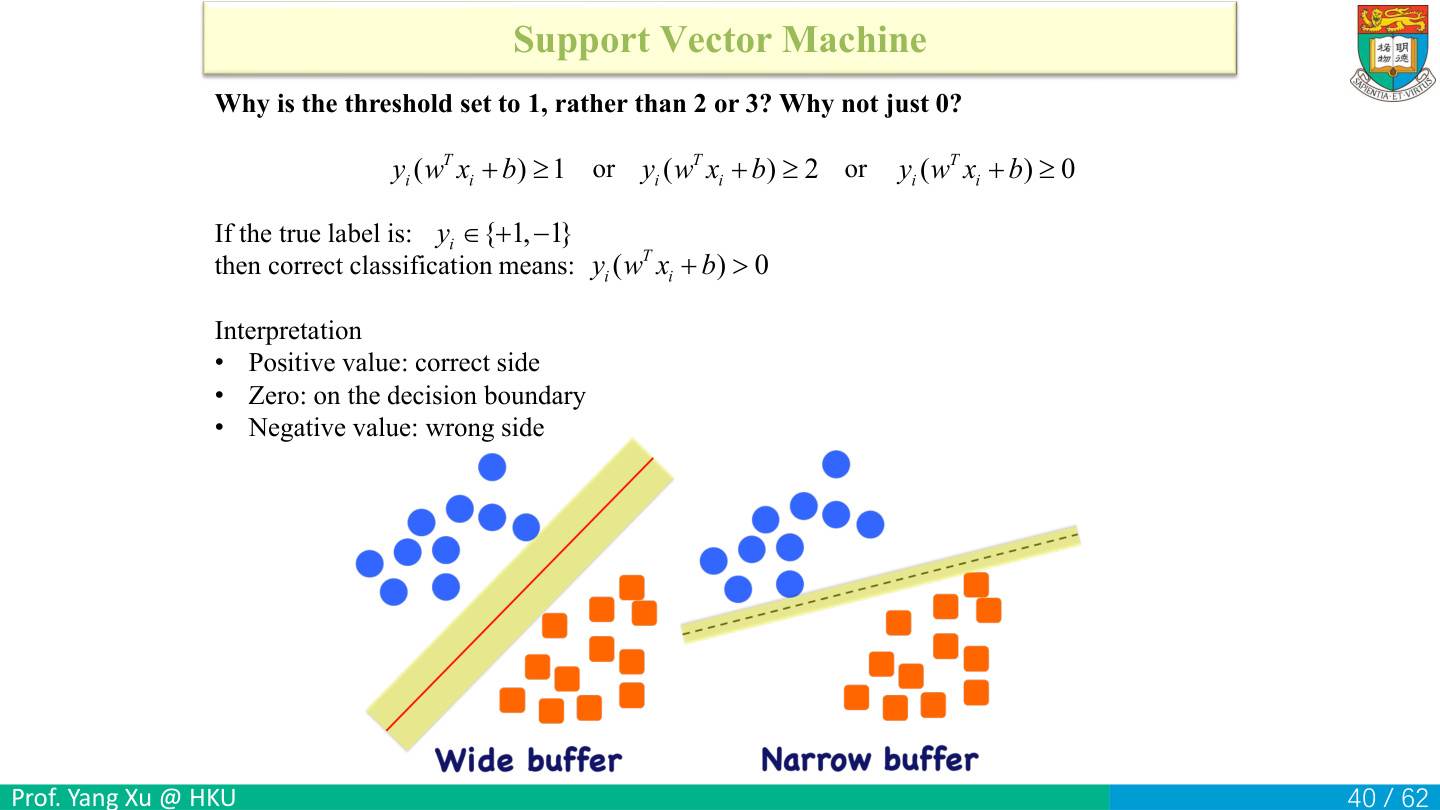
比较三个候选约束:≥1、≥2和≥0。y_i分数>0表示在正确侧,=0在边界,<0错侧。仅≥0允许w=0,b=0使所有点都满足,却没有有用分类器或间隔尺度,无法达到最大间隔目标。某正样本分数0.1虽正确,却可能轻微扰动就改判;函数间隔约束要求在选定尺度下达到正安全带。
只要求yᵢsᵢ≥0太弱:w=0、b=0让每条分数都0,所有约束形式上成立,但根本没有可区分两类的方向,距离分母还为0。用正阈值1排除这类退化,并配合最小范数目标建立可比较的尺度。阈值2或3也能用,只是要一致地重标参数。
算一遍。负样本x=−1、正样本x=1,b=0。若约束≥1,两条都要求w≥1;若≥2,则w≥2;它们最小范数解分别1与2,但分界都x=0。自测“设1是因为正类标签等于1”完全准确吗?答案:不是,标签±1与统一约束有关,而右侧正阈值选1是方便的尺度标准化。零与任意正阈值的逻辑作用不同。
若右侧用任何正数a,可把参数整体重标到右侧1;但a=0无法通过除a进行这种标准化。正数与零在这里不是数字大小的小差别,而是是否能定义正间隔尺度的根本区别。
两条间隔边界
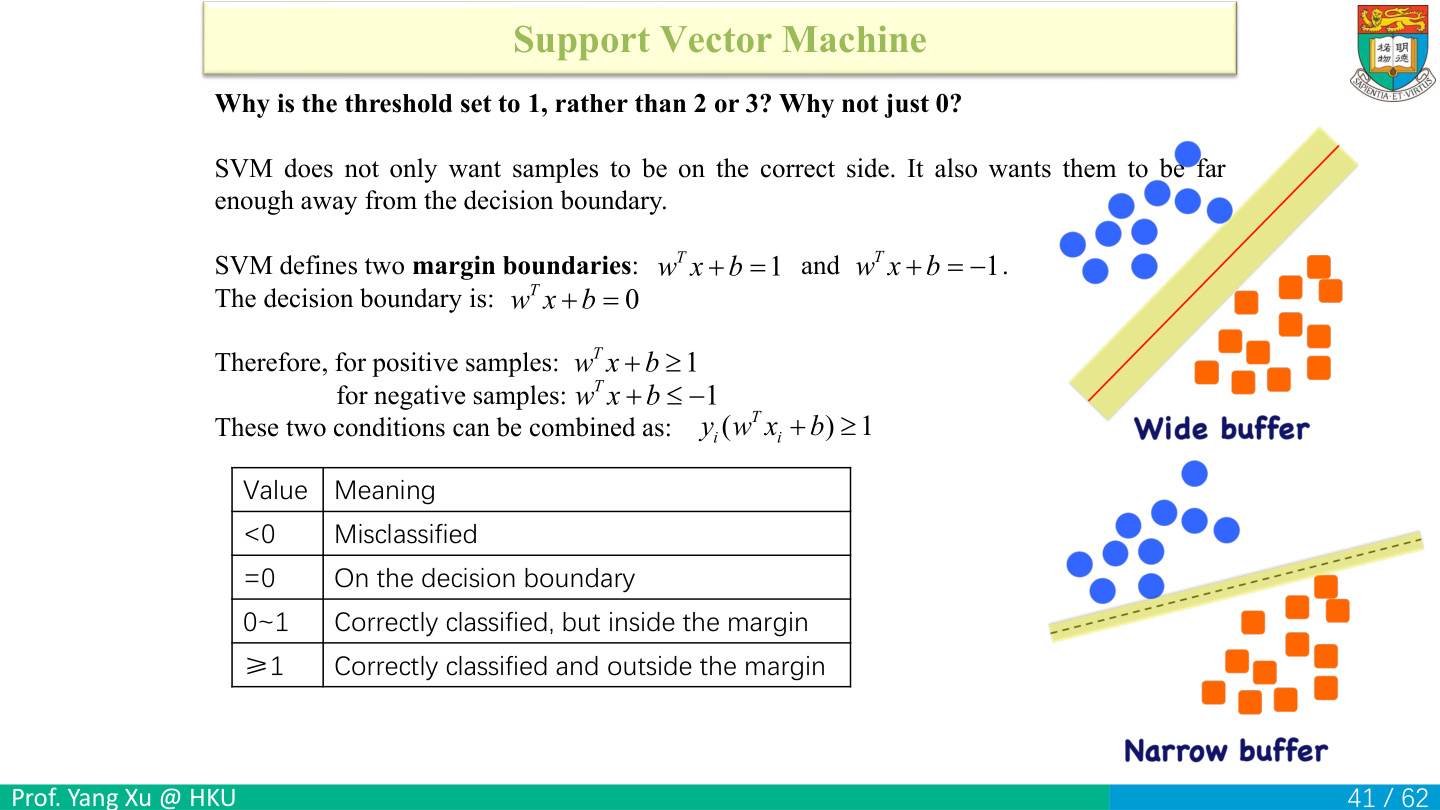
原三平面分别分数−1、0、+1。对正类要求分数≥1,负类分数≤−1,统一为y_i分数≥1。若带标签分数0.5,分类正确但在间隔带内;1.2正确且在带外;−0.2错误。注意“0至1”指带标签函数间隔,不能不乘标签就把负类分数−2说成错。
两类分别展开:正类y=+1时y(wᵀx+b)≥1直接是分数≥1;负类y=−1时−(wᵀx+b)≥1,两边乘−1需反转不等号,变分数≤−1。这一步的不等号方向是初学者常错的地方。两条间隔边界分数±1,中间分数0才是类别决策边界。
练一练。负类样本分数−0.5,乘标签后0.5:分类正确但在间隔带内。负类分数−2,乘标签后2:正确且达到带外。正类分数−0.1,带标签分数−0.1:错误。表格中的0到1说的是带标签分数,不是原始分数,更不是概率。几何带宽需要再除||w||,不要把函数分数1当“距离一定1个长度单位”。
当带标签分数恰为1时,样本在间隔边界上;大于1才严格在带外。教材常把两者合称满足间隔,阅读“outside”时要留意是否包含等号,不把边界点错误丢出可行集合。
1换成2不改变几何分类器
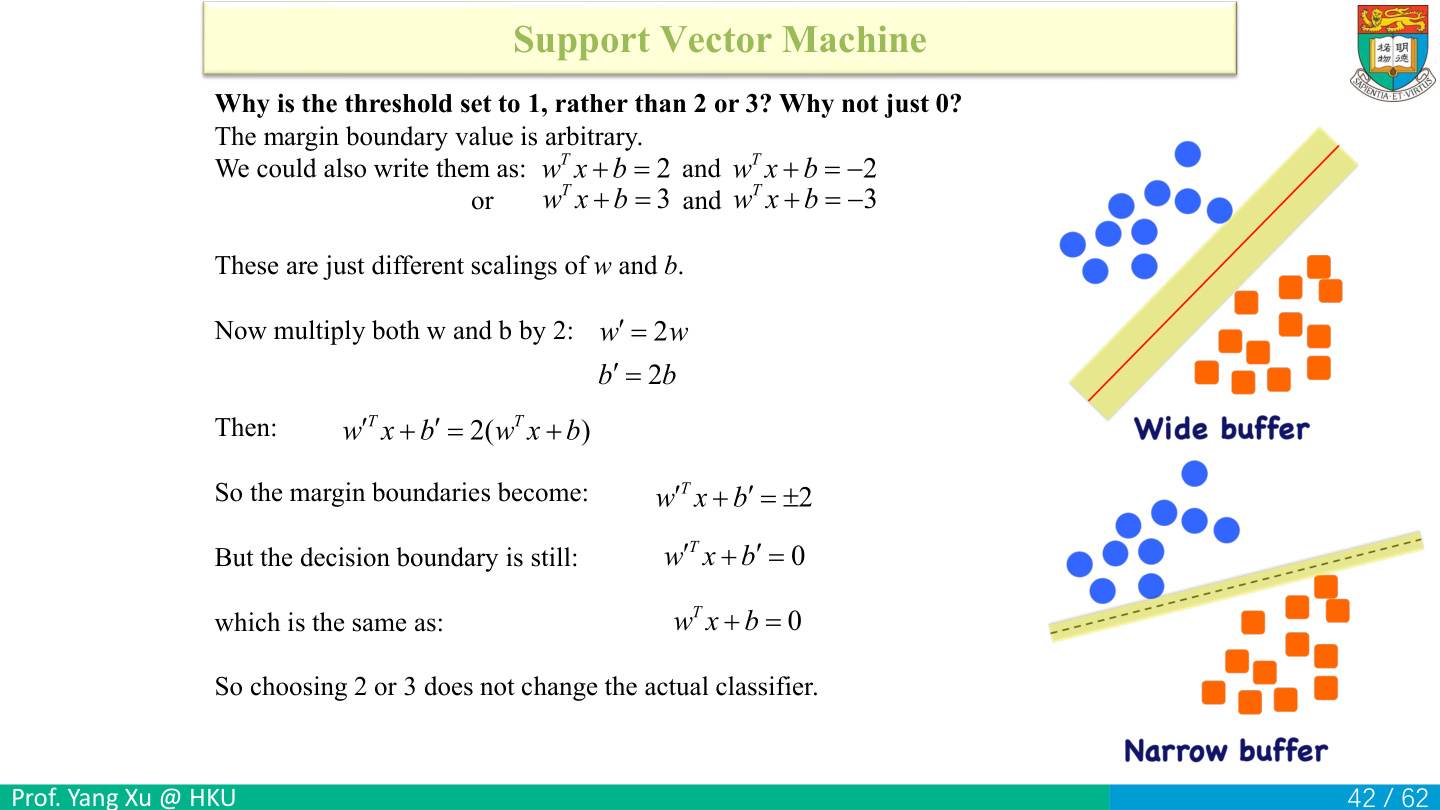
原令w'=2w,b'=2b,则w'^Tx+b'=2(w^Tx+b)。原边界分数0仍为0,原间隔线±1变为新分数±2。距离|2分数|/||2w||抵消因子2,所以几何距离不变。若采用右侧阈值2,参数与间隔线也按同一尺度重标;几何边界相同,最优参数数值则随之改变。选1是方便的标准化,不是概率阈值1。
做一次完整抵消:新分数s'=2s,新范数||w'||=||2w||=2||w||,所以距离|s'|/||w'||=|2s|/(2||w||)=|s|/||w||。原来的±1线在新参数表示中成为±2线;若错误地仍把新±1线当原间隔线,位置就变了,因此“缩放不变”要连同阈值一起解释。
练一练。原w=(1,0)、b=−2,决策x₁=2,原+1间隔x₁=3。新w=(2,0)、b=−4,+2间隔仍x₁=3;新+1间隔却是x₁=2.5。哪个对应原线?答案:新+2。右侧阈值由1改为2后,参数数值也成倍变化,而几何分类边界保持相同。
硬间隔SVM目标
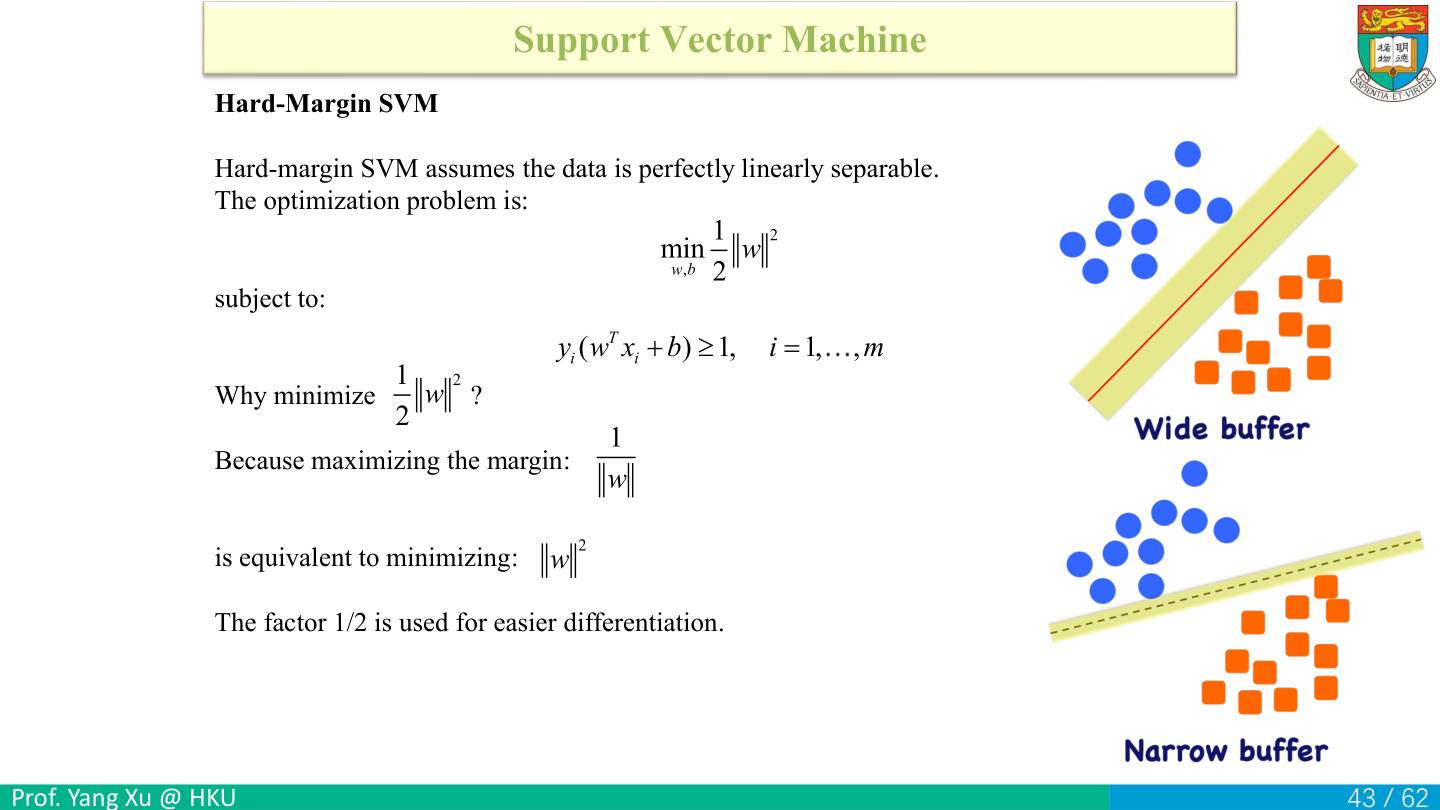
硬间隔 SVM 在线性可分时求解:
min_(w,b) ||w||²/2,每条样本满足 yᵢ(wᵀxᵢ+b)≥1。
第39页把最小函数间隔缩放为 1,因此中心线到每条间隔线的距离是 1/||w||,整条带宽是 2/||w||。想扩大带宽,就要减小 ||w||;范数非负,最小化范数与最小化其平方选出的参数相同,乘 1/2 让目标对 w 的梯度为 w。
完整算一次:负样本 x=−1、正样本 x=1。正类约束给 w+b≥1;负类约束给 −(−w+b)≥1,整理为 w−b≥1。两式相加得到 2w≥2,所以任何可行解都需 w≥1。目标 w²/2 在这个范围随 w 增大,因此先试 w=1。代回两条约束,分别得到 b≥0、b≤0,故 b=0。决策边界是 x=0,两条间隔线为 x=−1 与 x=1,带宽 2。
若同一个 x=0 同时标为 +1 和 −1,则约束分别要求 b≥1、b≤−1,无解。下一页允许付出代价后违反个别约束。
松弛变量与边界情形
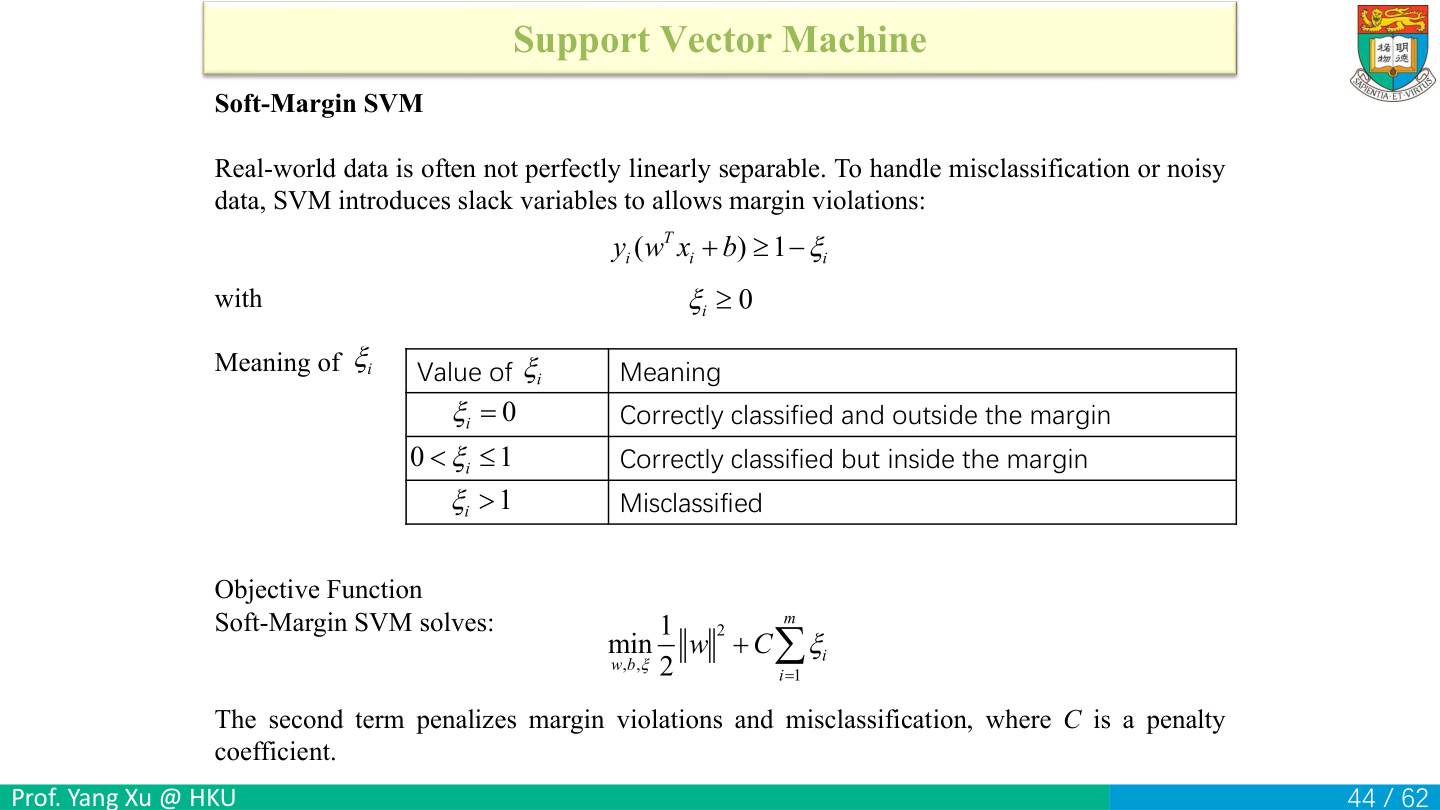
软间隔引入每条样本的松弛量ξᵢ≥0,将约束改为yᵢ(wᵀxᵢ+b)≥1−ξᵢ,目标为||w||²/2+CΣᵢξᵢ。第一项偏好更宽间隔,第二项对违反间隔付出代价;C控制两者的相对权重。
记带标签分数γ̂ᵢ=yᵢ(wᵀxᵢ+b)。从约束移项得到ξᵢ≥1−γ̂ᵢ,同时ξᵢ≥0;固定w、b且C>0时,最小代价选择是ξᵢ=max(0,1−γ̂ᵢ),这就是hinge损失。
逐个代入:
- γ̂=1.5,ξ=0,正确且满足间隔。
- γ̂=0.4,ξ=0.6,正确但在间隔带内。
- γ̂=0,ξ=1,恰在决策边界,类别由平局规则决定。
- γ̂=−0.2,ξ=1.2,位于错误侧。
图中表格把0<ξ≤1都列作正确分类,其中ξ=1要单独按边界理解。以上位置对应的是最小松弛;任意可行ξ还可以取更大,因此由一个未优化的ξ只能读出约束允许范围。
C大时,违反间隔的代价更高;C小时,更偏向较小范数。通过验证选择C,可以平衡贴合训练数据与对噪声的敏感程度。
本讲回顾
用一次预测分清三部分。KNN 为查询点找到训练邻居,再用它们的类别投票或数值求均值。核函数给出两个输入在映射后的内积,可用这些值构造样本相似度矩阵。SVM 先根据训练点选出带间隔的边界,预测时只根据新输入落在边界的哪一侧判类。
本讲结束
下一讲继续从 SVM 的间隔约束展开,再学习决策树如何逐步切分样本。