左右键翻页;“连续阅读”展开整份;搜索可定位概念。
贝叶斯网络与自编码器
本讲前半用概率图和贝叶斯公式推理不确定的事件,后半用自编码器学习数据的压缩与重构。
本讲学习顺序
学习顺序:联合概率表→贝叶斯网络→条件概率与贝叶斯公式→MLE/MAP→朴素贝叶斯→自编码器。
随机变量与联合分布:先列出所有组合
机器人行为受地面、供电、传感器和任务等因素影响。若每次把所有组合写成巨大表格,很快就难以管理,因此要利用结构。建图前先弄清表格中的变量和事件。
地面状态记为0=干、1=湿;导航模式记为0=普通、1=谨慎。这里的0和1是类别代号,每种状态的出现频率由概率表描述。
两个二值变量共有 2×2=4 种组合:干/普通、干/谨慎、湿/普通、湿/谨慎。联合概率 P(F=f,M=m) 回答两个条件同时出现的可能性。四项都应非负,总和为1。
若有n个二值变量,完整联合表要列 2^n 项;n=3有8项,n=10有1024项。由于总和1,独立可调概率数一般是 2^n−1。这正是为什么希望用局部依赖分解联合分布。
自测:P(F=1,M=0) 是“湿地面条件下普通模式的概率”吗?不是,它是两事件同时发生的联合概率;条件概率还要除以 P(F=1)。
联合、边缘、条件概率:把四个百分数算通
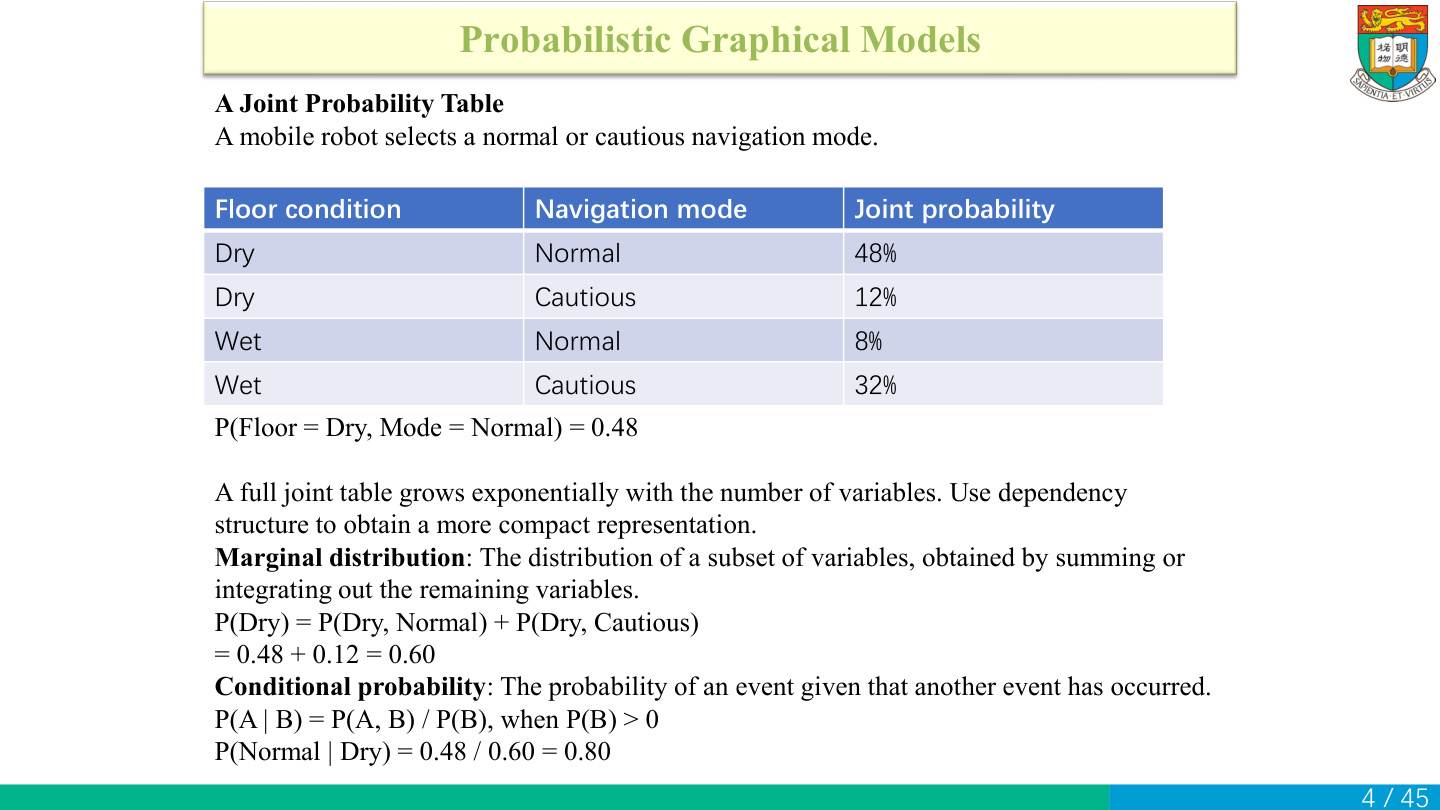
把四项联合概率想成100次观测,对应48、12、8、32次。行表示地面,列表示导航模式,每一格同时满足行条件与列条件。
| 地面 | 普通 | 谨慎 | 该行总数 |
|---|---|---|---|
| 干 | 48 | 12 | 60 |
| 湿 | 8 | 32 | 40 |
| 该列总数 | 56 | 44 | 100 |
边缘概率把不关心的变量加掉。地面干的概率 P(干)=0.48+0.12=0.60;湿为0.40。普通模式概率 0.48+0.08=0.56;谨慎模式为0.44。求干地面概率时必须加同属干地面的两行,不是把表格随便两项相加。
条件概率缩小观察范围。已知地面干,只在总概率0.60这部分中比较,普通模式占 0.48/0.60=0.80。已知地面湿,普通模式占 0.08/0.40=0.20。条件改变后,分母也跟着变。
反向条件不同:P(干|普通)=0.48/0.56=6/7≈0.8571,不等于0.80。两个式子分子相同,但一个只看干地面,一个只看普通模式,观察范围不同。
还可检验独立性。若地面与模式独立,应有 P(干,普通)=P(干)P(普通)=0.60×0.56=0.336,实际0.48,不相等,所以这个联合表中两变量不独立。
自测:P(谨慎|湿)是多少?0.32/0.40=0.80。若回答0.32,就把联合概率误当条件概率了。
读概率图:节点是变量,箭头规定局部分布
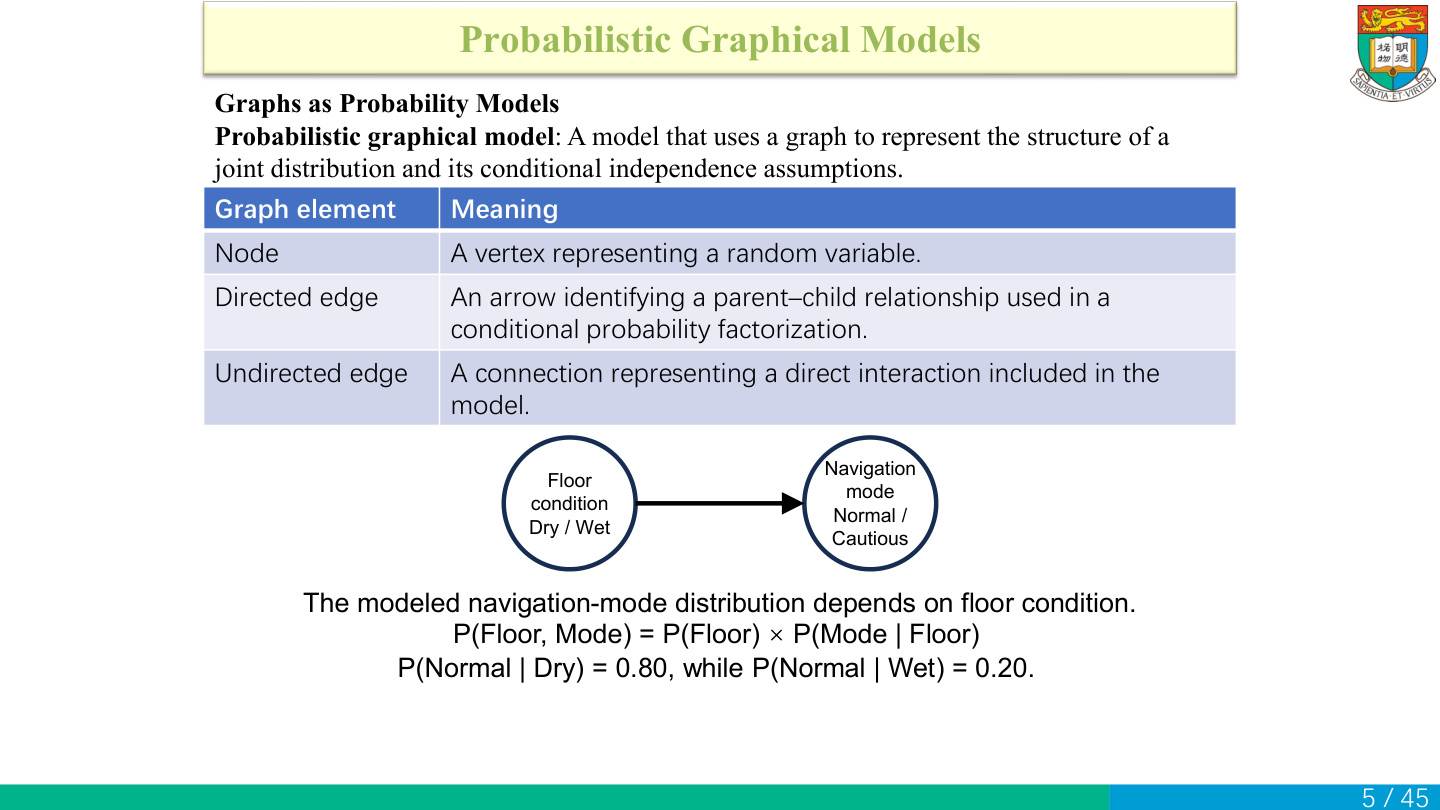
节点代表一个随机变量;有向边指出父节点与子节点。分解概率时,子节点使用“给定父节点后的条件概率”。图中的地面状态指向导航模式。
这张图对应 P(F,M)=P(F)P(M|F)。先给地面状态一个概率,再给不同地面下的模式概率。用上一页表恢复参数:P(干)=0.6、P(湿)=0.4;P(普通|干)=0.8、P(谨慎|干)=0.2;P(普通|湿)=0.2、P(谨慎|湿)=0.8。
把这些局部数相乘便可恢复联合表:0.6×0.8=0.48;0.6×0.2=0.12;0.4×0.2=0.08;0.4×0.8=0.32。这说明图没有丢掉本例的概率信息,而是改了表示方式。
也可反过来写 P(M)P(F|M),同样恢复这个联合表。这里的箭头规定用哪组条件概率来组织模型。
下一页比较两种结构:贝叶斯网络用有向边与条件概率,马尔可夫网络用无向边与势函数。
自测:知道父节点干地面的概率0.6、其下普通模式概率0.8,联合概率是多少?0.48,而不是把0.6与0.8相加。
贝叶斯网络与马尔可夫网络:边的方向有计算后果
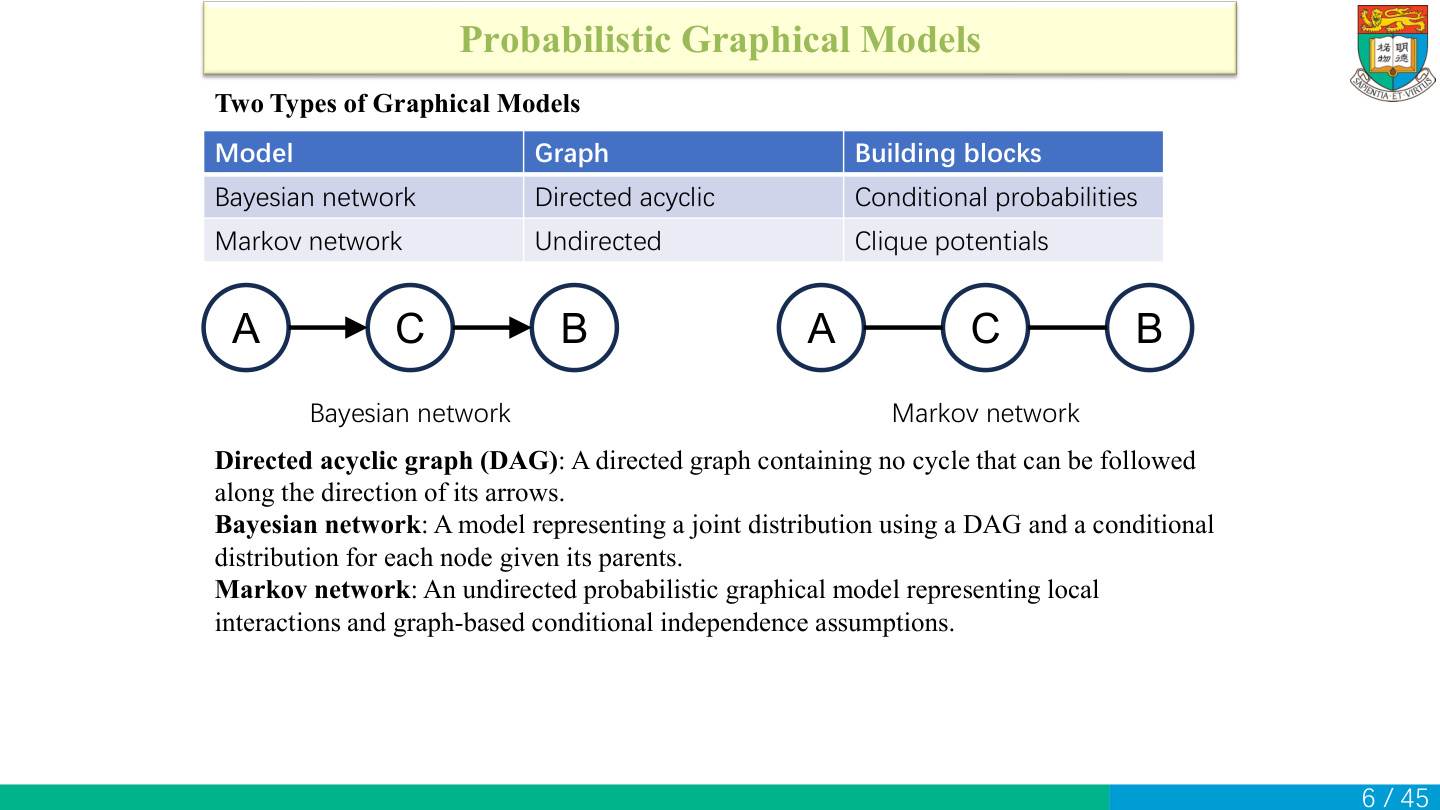
贝叶斯网络使用有向无环图DAG。有向表示箭头有方向;无环表示不能沿箭头绕一圈回到起点。A→C→B合法;若再加B→A,便形成有向环,不能按普通贝叶斯网络DAG来解释。
贝叶斯网络给每个节点一个“已知父节点后的条件分布”,根节点没有父节点,直接给边缘分布。联合分布为所有这些局部分布相乘。离散变量常用CPT(条件概率表)存参数,同一父节点组合下,子节点全部可能取值的概率和为1。
马尔可夫网络使用无向图,局部构件是clique potentials(团势函数)。势函数可理解成某种状态组合的非负相容性分数,不一定单独归一化成概率;通常把势函数相乘后再除全局归一化常数。不能把无向连接想成“两个反向条件概率同时相乘”。
例子:二值链A→C→B有根节点P(A)、两张条件表P(C|A)、P(B|C)。若每变量只有两状态,分别需要1、2、2个自由概率,共5个;完整三变量联合表则需7个。这里节省来自图假设A与B在给定C后独立。
自测:图纸上有圆形闭合轮廓是否就一定违反无环?看箭头能否顺着绕回起点,不能只看无向外形。本页图A→C→B没有有向回路。
按父节点分解;区分链式法则与图上的分解
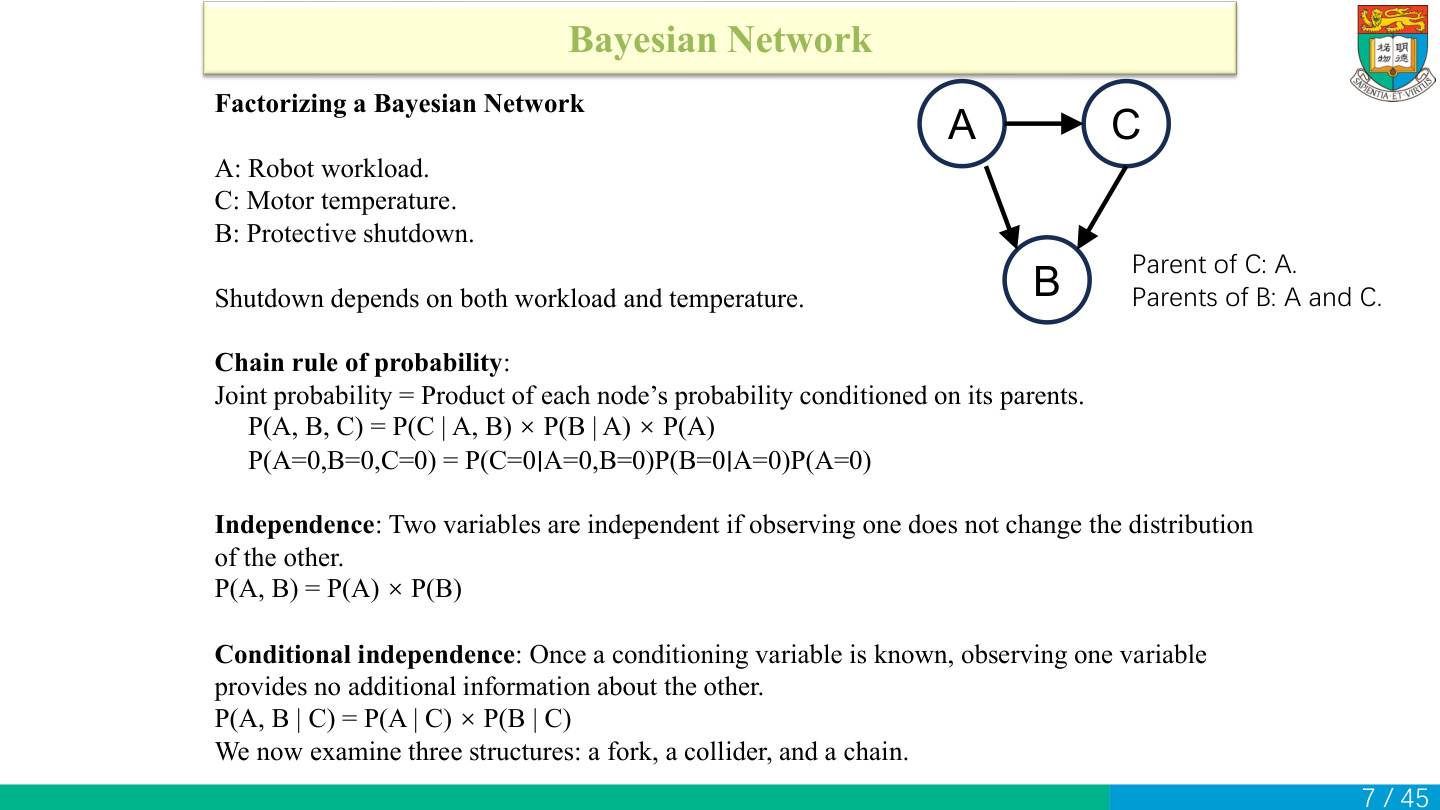
看箭头指向谁,给谁的概率加上右侧条件。
| 节点 | 箭头从哪来 | 使用的局部概率 |
|---|---|---|
| A(负载) | 无 | P(A) |
| C(温度) | A | P(C 给定 A) |
| B(停机) | A、C | P(B 给定 A、C) |
按A、C、B的顺序选状态。先选负载,再看这个负载下的温度,最后看这组负载和温度下的停机概率。三项相乘,得到 P(A,B,C)=P(A)P(C|A)P(B|A,C)。
原图下面的 P(C|A,B)P(B|A)P(A) 是按A、B、C排序的链式法则。按图上的父节点来写,则应使用 P(A)P(C|A)P(B|A,C):C给定A,B给定A与C。
教学代入:若某一组局部概率为 P(A=0)=0.6、P(C=0|A=0)=0.8、P(B=0|A=0,C=0)=0.9,则这组全零状态联合概率为 0.6×0.8×0.9=0.432。三个条件要保持相同变量取值。
独立指 P(A,B)=P(A)P(B),观察一个不会改变另一个分布。条件独立指已知C后,P(A,B|C)=P(A|C)P(B|C)。两者条件范围不同,可以一个成立、另一个不成立。
本图三节点之间都有直接连接,并没有仅凭图结构就能删除的A、B、C独立关系。下一页开始看缺边的简单结构。
自测:如果B有两个二值父节点,需要几组父节点条件?四组00、01、10、11;每组再给B的概率分布。
Fork共同原因:知道环境后,关联为何可以消失
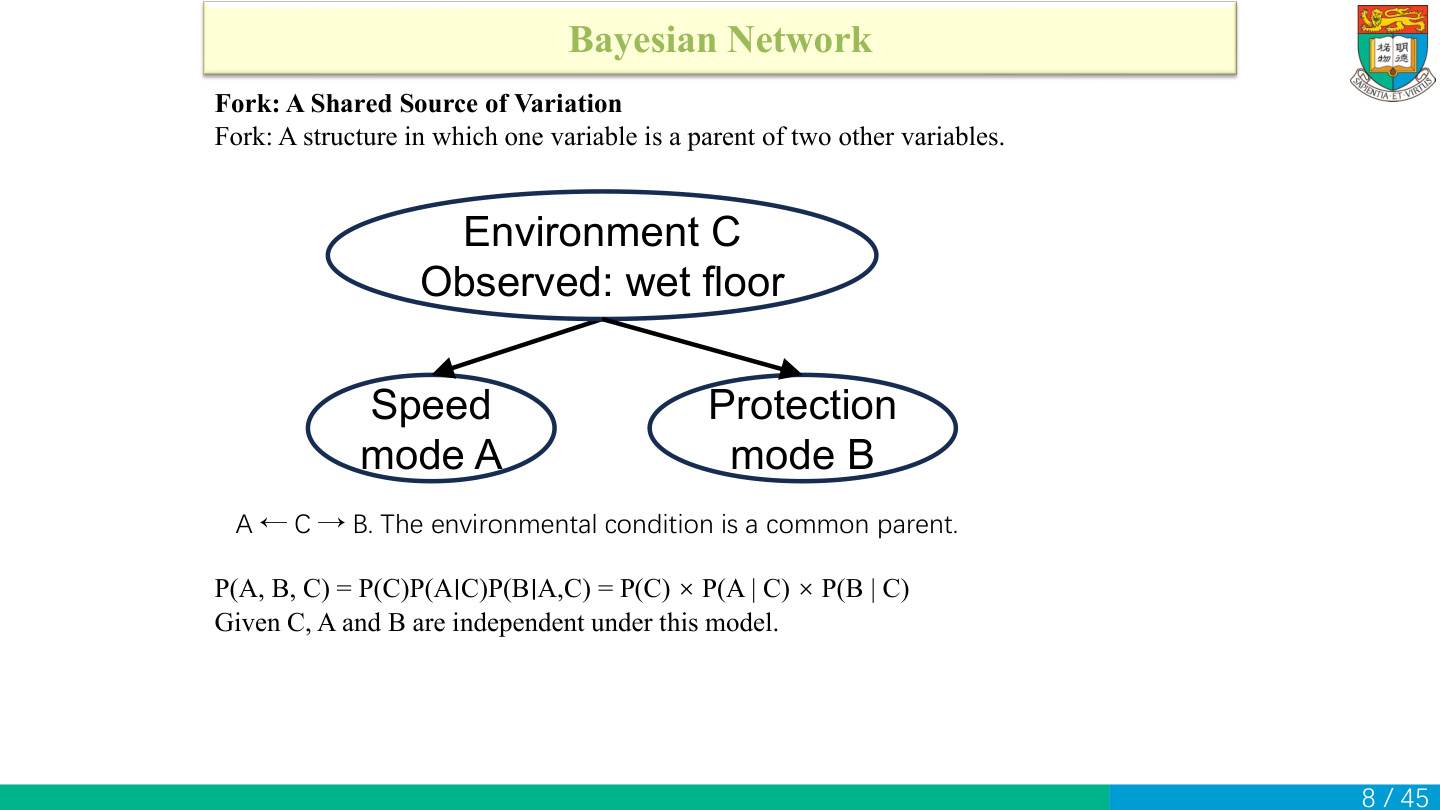
Fork(叉形)是 A←C→B,C是共同父节点。本页C是环境,A是速度模式,B是保护模式。天气湿可能同时使速度更保守、保护更严格,因此未看C时A与B可能表现出关联。
图假设联合分布 P(A,B,C)=P(C)P(A|C)P(B|C)。固定C后,P(A,B|C)=P(A|C)P(B|C),这就是条件独立。它表示在模型已知道环境状态后,额外看到速度模式,不再提供保护模式的新信息。
数字例子:湿/干各0.5。湿时A=1与B=1概率各0.8且给定天气独立;干时各0.2。则 P(A=1)=0.5、P(B=1)=0.5,但联合 0.5×0.8×0.8+0.5×0.2×0.2=0.34,不等于0.25,边缘上有关联。在湿地面条件下,联合为0.64,恰等于0.8×0.8,条件下独立。
“给定C”就是已知C的取值,只在相同环境条件下比较A与B。例如先固定湿地面,再看速度模式与保护模式。
自测:给定C后还需要把 P(B|A,C) 保留对A的依赖吗?本图假设可以化成 P(B|C),这正是fork结构表达的信息。
Collider共同结果:为什么看了结果反而引入关联
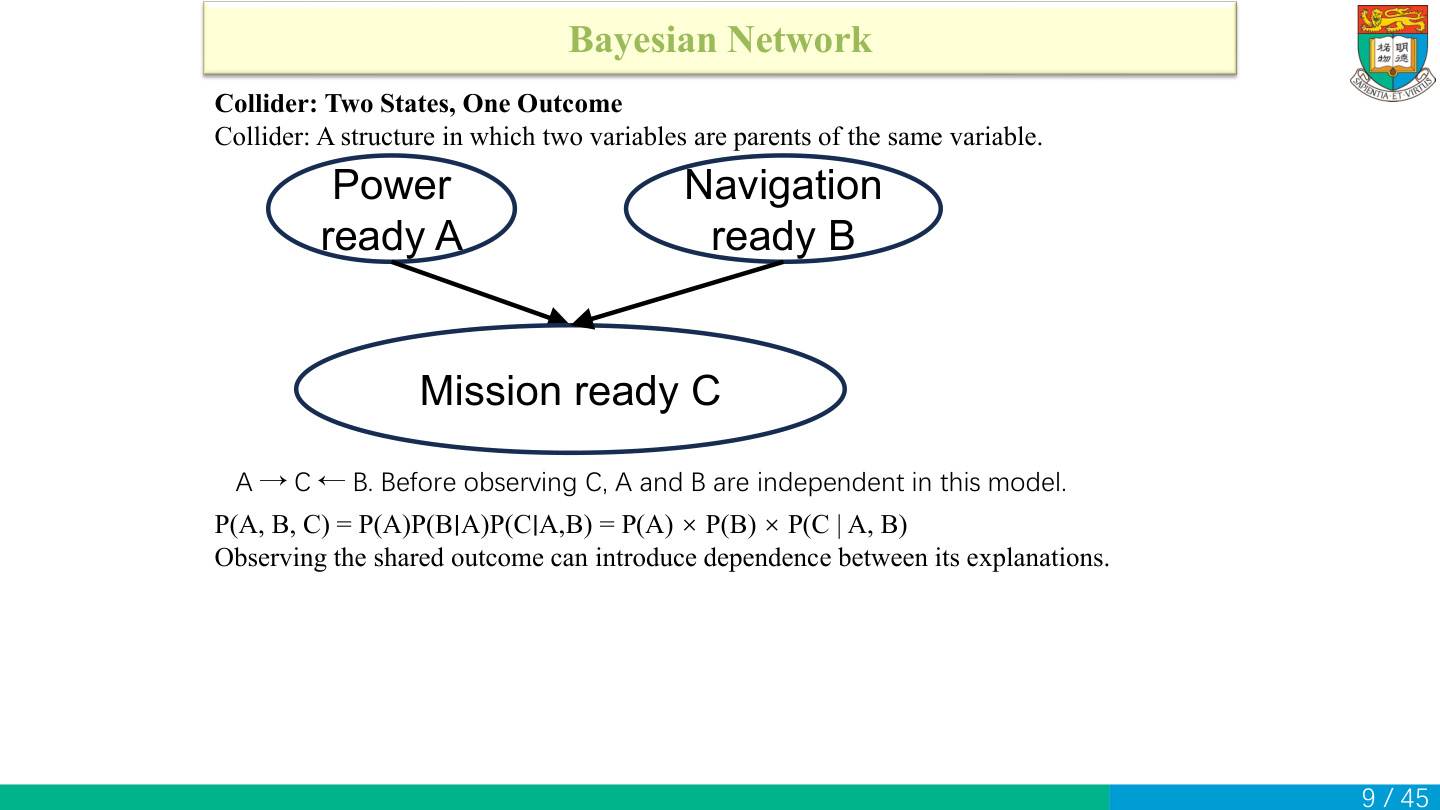
Collider(碰撞结构)为 A→C←B。本页A=电源准备好,B=导航准备好,C=任务准备好。A、B原先独立,联合分布写 P(A)P(B)P(C|A,B)。C的概率同时取决于两个父节点。
未观察C时,把C所有取值加掉:P(A,B)=P(A)P(B)Σ_C P(C|A,B),括号内和为1,因此等于 P(A)P(B)。A、B独立不是凭直觉猜出来的,而是能从分解直接算出。
观察C后,P(A,B|C) 要乘上与A、B两者有关的C似然,再归一化,通常无法拆成两个独立因子。例如已经知道任务失败,再发现电源故障,这个故障已解释一部分失败,怀疑导航故障的程度可以下降,这叫explaining away。
对比:fork给定共同原因C后,A与B条件独立;collider给定共同结果C后,A与B可以产生关联。
自测:仅看这张三节点碰撞图、不观察C,A与B应按什么联合概率计算?P(A)P(B)。观察C后再用这个乘积,一般会错。
贝叶斯公式:相同联合概率写两遍再相除
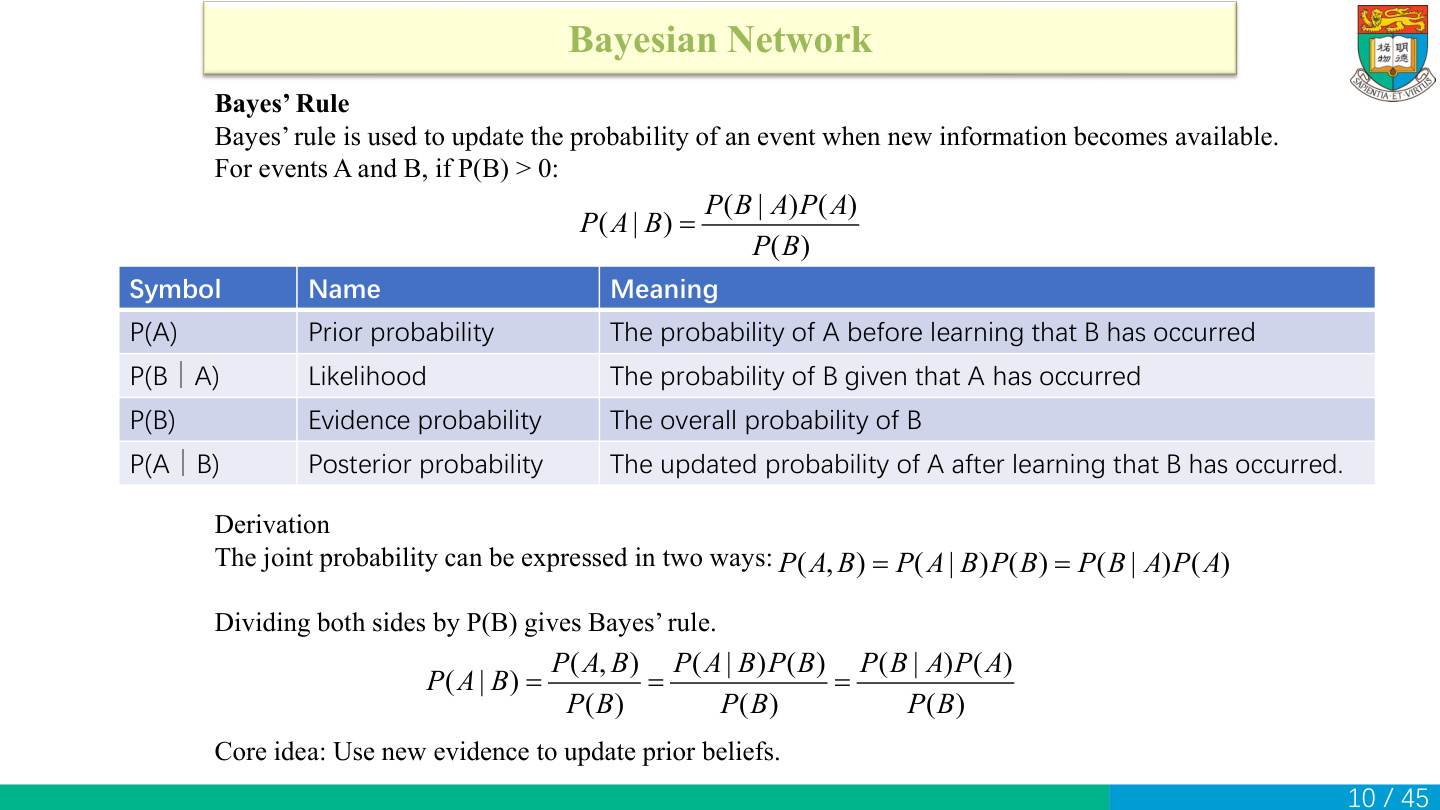
P(A|B)=P(B|A)P(A)/P(B)。先别背四个名称,先理解同一事件“A和B都发生”的两种计数法:先选B再看A,得到 P(A|B)P(B);先选A再看B,得到 P(B|A)P(A)。两者相等,除以正的P(B),便得到公式。
P(A)是先验,表示看到这次B证据前的概率;P(B|A)是似然,表示假设A成立时多容易产生B;P(B)是证据总概率,负责归一化;P(A|B)是后验,表示看到B后更新的概率。竖线两边交换会改变问题,似然不是后验。
教学设备例:故障率0.01,故障时报警率0.9,正常时误报率0.05。证据“报警”的总概率要包含两条路径:0.9×0.01+0.05×0.99=0.009+0.0495=0.0585。看到报警后故障概率 0.009/0.0585≈0.1538。虽然故障时90%会报警,报警后故障概率却只有15.38%,因为正常设备数量很多,误报贡献也大。
这说明不能忽略先验基率。分子只含目标解释的贡献,分母含所有可产生证据的互斥解释。若P(B)=0,普通条件概率在该事件上不能这样相除。
用10,000台设备理解分母:100台故障,其中90台报警。其余9,900台正常,其中495台误报。收到报警后,观察范围缩到585台,其中90台故障,所以概率为90/585≈15.38%。
条件全概率:每一种情况乘它在当前条件下的权重
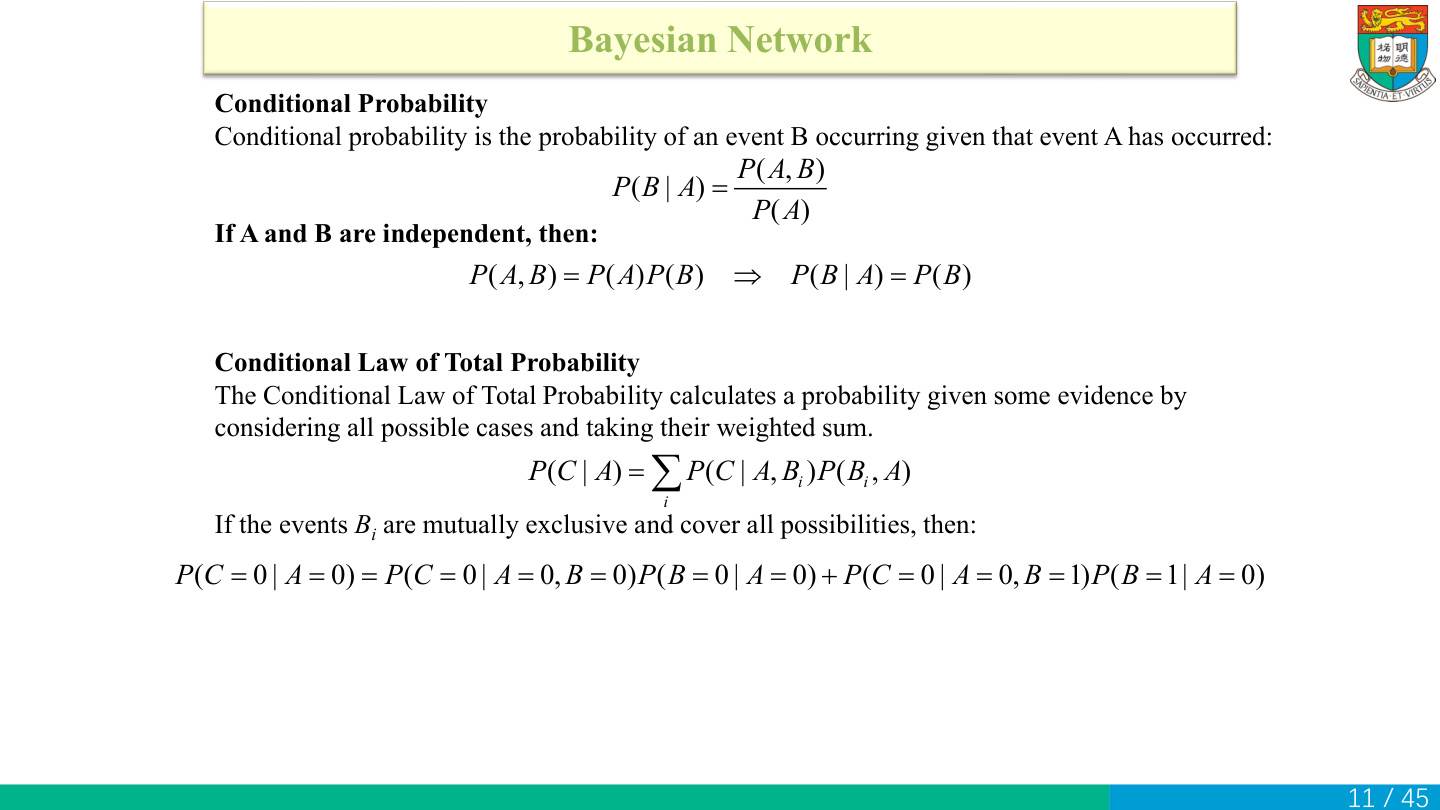
条件概率定义 P(B|A)=P(A,B)/P(A),前提P(A)>0。如果A、B独立,分子为 P(A)P(B),约掉P(A)后得到P(B),表示知道A不会改变B的概率。
把另一个变量B的所有状态分情况,可得 P(C|A)=Σ_i P(C|A,B_i)P(B_i|A)。先在已知A的范围内考虑每个B_i情况,再按该情况出现的权重加权。B_i应互斥并覆盖全部可能。
展开一步。把事件C且A按Bᵢ拆成互不重叠的小格,得到 P(C,A)=Σ_i P(C,A,B_i)。每格又等于 P(C|A,B_i)P(A,B_i)。整式除P(A),左边变 P(C|A),右边每个权重变 P(A,B_i)/P(A)=P(B_i|A)。原图右侧使用联合权重时,需要补上这一步除法。
例子核验:令 P(A)=0.5;给定A时B=0/1各0.5;两种B下P(C|A,B)都0.8。正确结果 0.8×0.5+0.8×0.5=0.8。若误用联合权重,两个P(A,B)各0.25,只得0.4;除P(A)=0.5才回到0.8。
当A、B独立时,P(B|A)=P(B),加权时就能直接使用B的边缘概率。
自测:B只有0、1两种值,已知A后 P(B=0|A)=0.3,另一权重是多少?0.7。权重和应为1,这是检查条件全概率的好方法。
概率AND门:四种父节点状态逐行求和
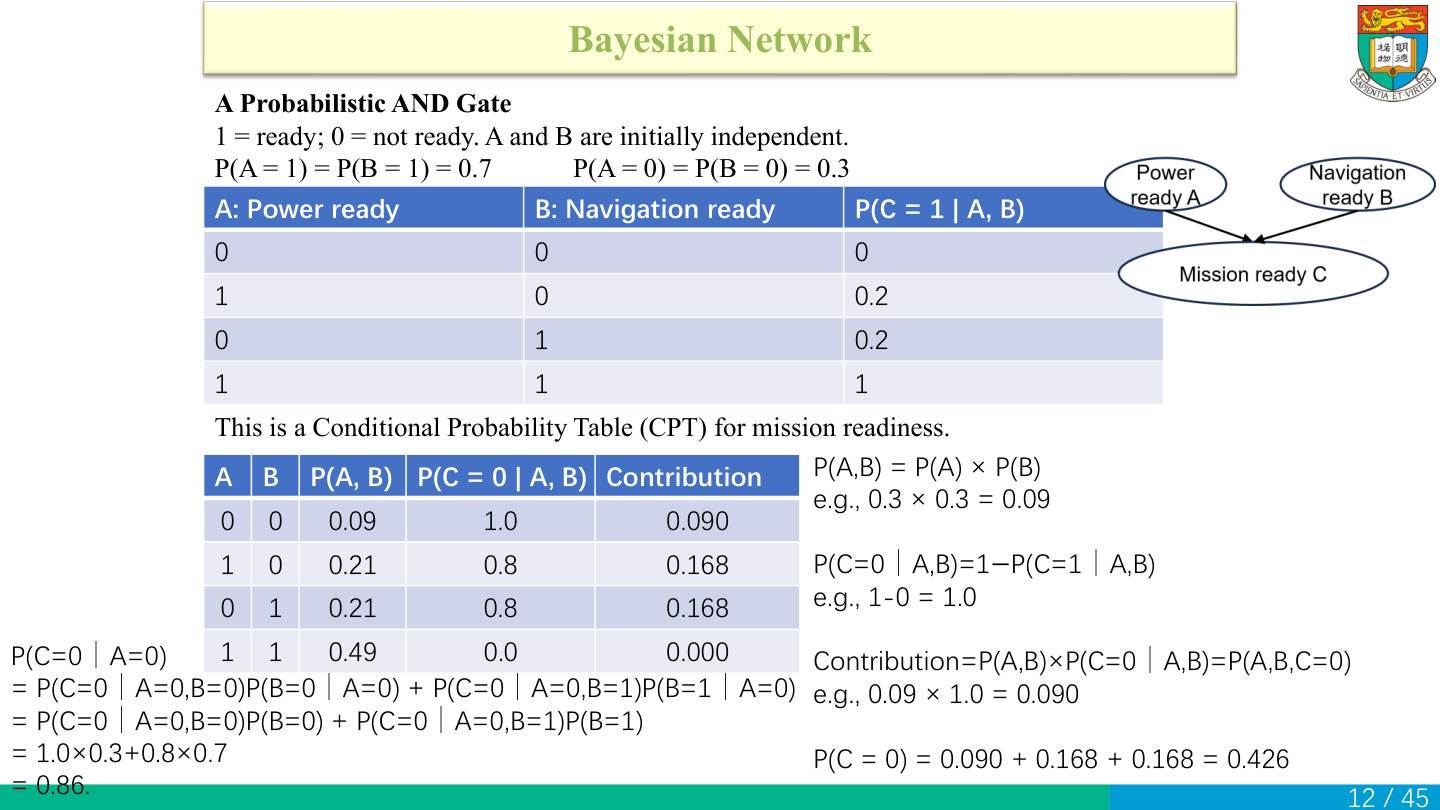
A与B独立,准备好概率都0.7,未准备好概率都0.3。C=任务准备好。CPT给 P(C=1|00)=0、P(C=1|10)=0.2、P(C=1|01)=0.2、P(C=1|11)=1。这不是严格布尔AND:只有一个子系统准备好时仍有0.2成功概率。
求失败概率C=0,先把每个CPT概率变补事件 1−P(C=1|A,B),再乘该父节点组合概率:
| A,B | P(A,B) | 失败条件概率 | 联合失败贡献 |
|---|---|---|---|
| 0,0 | 0.3×0.3=0.09 | 1−0=1 | 0.09 |
| 1,0 | 0.7×0.3=0.21 | 1−0.2=0.8 | 0.168 |
| 0,1 | 0.3×0.7=0.21 | 0.8 | 0.168 |
| 1,1 | 0.7×0.7=0.49 | 1−1=0 | 0 |
相加得 P(C=0)=0.09+0.168+0.168+0=0.426。成功概率 1−0.426=0.574。0.09是父状态联合概率,不是已经乘上C之后的一般结果;本例它恰乘1没变。
已知A=0时,B仍以0.3/0.7出现,因为A、B原先独立。失败概率 1×0.3+0.8×0.7=0.86。这里权重不是0.09和0.21,因为条件已缩到A=0的范围。
自测:A=B=1时失败贡献是多少?0。即使父状态出现概率0.49,条件失败率为0,乘积仍0。
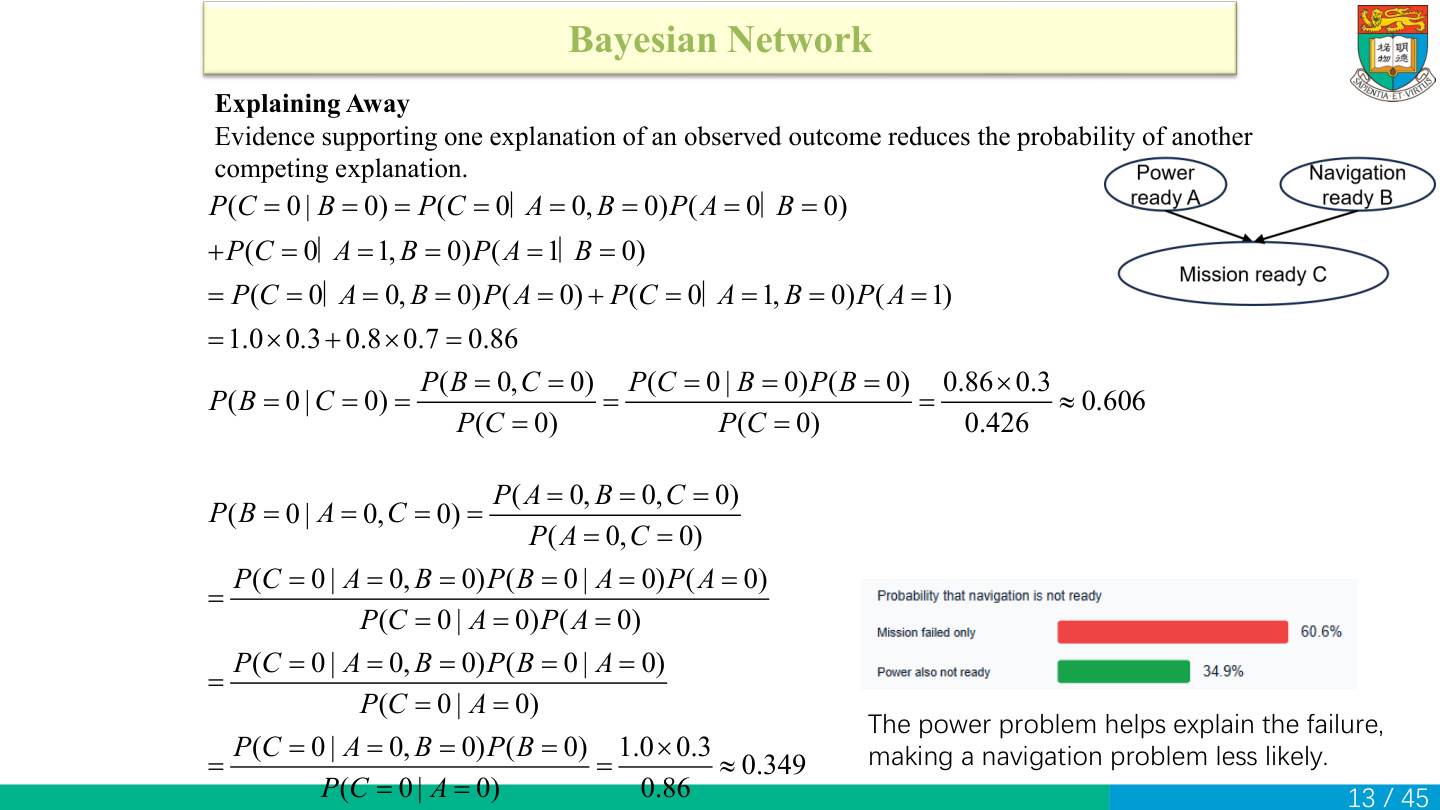
解释消除:把0.606与0.349逐步算出来
动手试试 · 加入证据,观察故障概率
沿用上一页A/B准备率0.7、失败率0.3以及CPT。先计算只知道任务失败时导航未准备好的概率:
- 已知B=0时,按A分情况,
P(C=0|B=0)=1×0.3+0.8×0.7=0.86。 - 导航失败且任务失败的联合概率
P(B=0,C=0)=0.86×0.3=0.258。 - 全部任务失败概率为0.426,所以
P(B=0|C=0)=0.258/0.426≈0.6056。
现在还知道电源没准备好A=0:
P(C=0|A=0)=0.86(同样分情况可算出)。P(B=0|A=0,C=0)=P(C=0|A=0,B=0)P(B=0|A=0)/P(C=0|A=0)。- A、B原先独立,所以分子
1×0.3=0.3;除0.86得到约0.3488。
也可用全联合验证:三者 A=0,B=0,C=0 的概率0.09;P(A=0,C=0)=0.3×0.86=0.258;相除 0.09/0.258=0.3488。两条路线应一致。
知道任务失败时,导航故障概率从原先0.3升到0.6056;再知道电源故障后,降到0.3488。电源问题解释了部分任务失败,所以导航问题的怀疑程度下降。
自测:为何不能仍说给定C后A、B独立?若独立,知道A不会让B概率从0.6056变0.3488,数值已证明此条件下存在依赖。
Chain中间状态:给定中间变量后路径被阻断
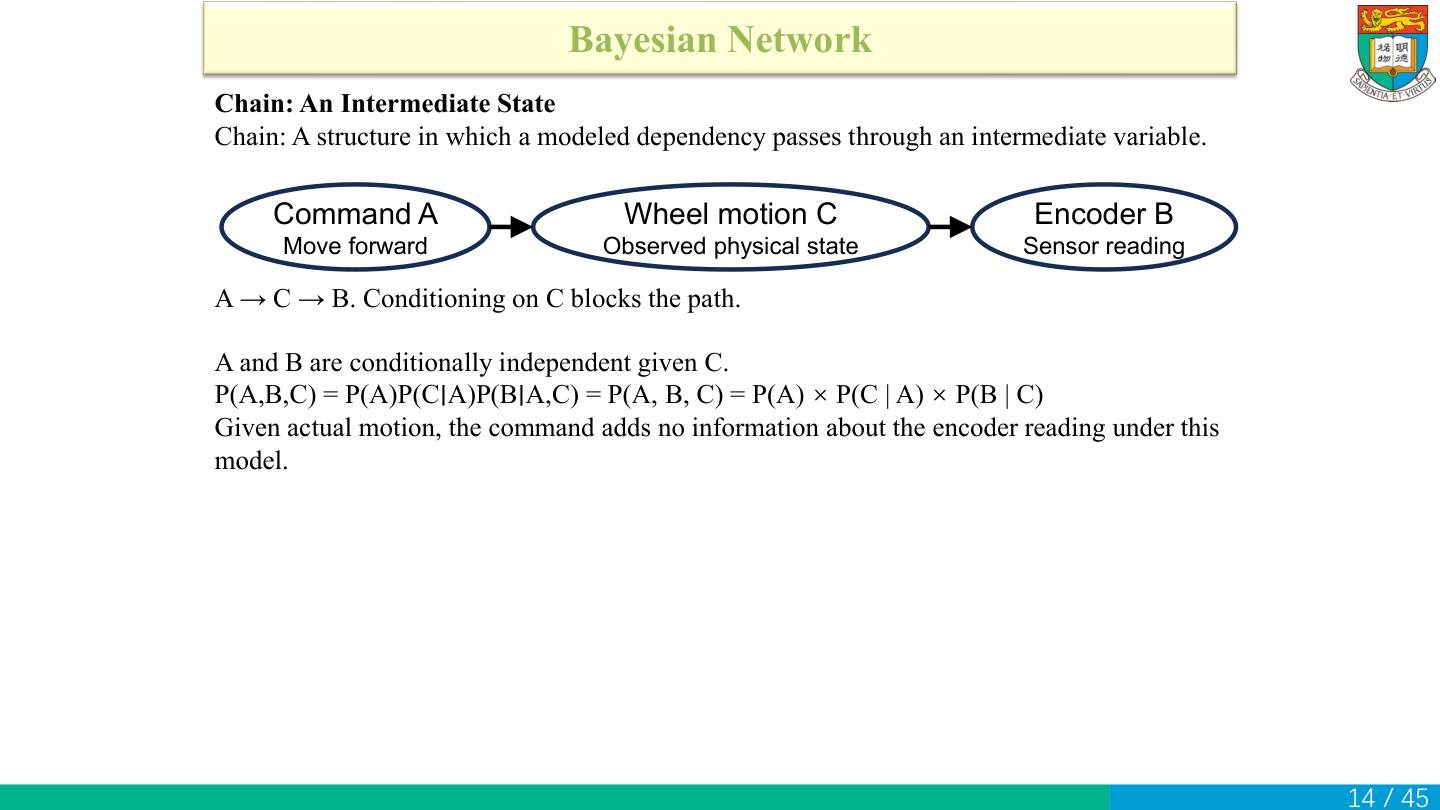
本页链为 A→C→B:命令A影响实际车轮运动C,C影响编码器读数B。联合分解 P(A,C,B)=P(A)P(C|A)P(B|C)。在这个简化模型里,编码器看的是车轮实际状态;一旦实际运动已知,命令本身不再提供读数的额外信息。
从一般链式法则可写 P(A)P(C|A)P(B|A,C)。图假设给定C后B与A独立,因此最后项化成 P(B|C)。这是从一般概率公式走到特定图结构的关键一步,不能省掉理由。
例子:不管命令是前进还是停止,只要实际车轮确实静止,模型对编码器读数的分布相同。这不是说命令不影响读数,而是它的影响经由中间运动C传递,C已知后这条路径的信息已包含在C里。
若C没观察到,必须对所有可能运动状态加权:P(B|A)=Σ_C P(B|C)P(C|A)。不同命令使运动状态分布不同,因此最终B分布也可能不同。
自测:链中知道A后,能否总把B与C当成独立?不能,图上的直接C→B仍在。被给定C阻断的是A到B的间接路径。
三种结构对照:先找中间节点箭头朝哪边
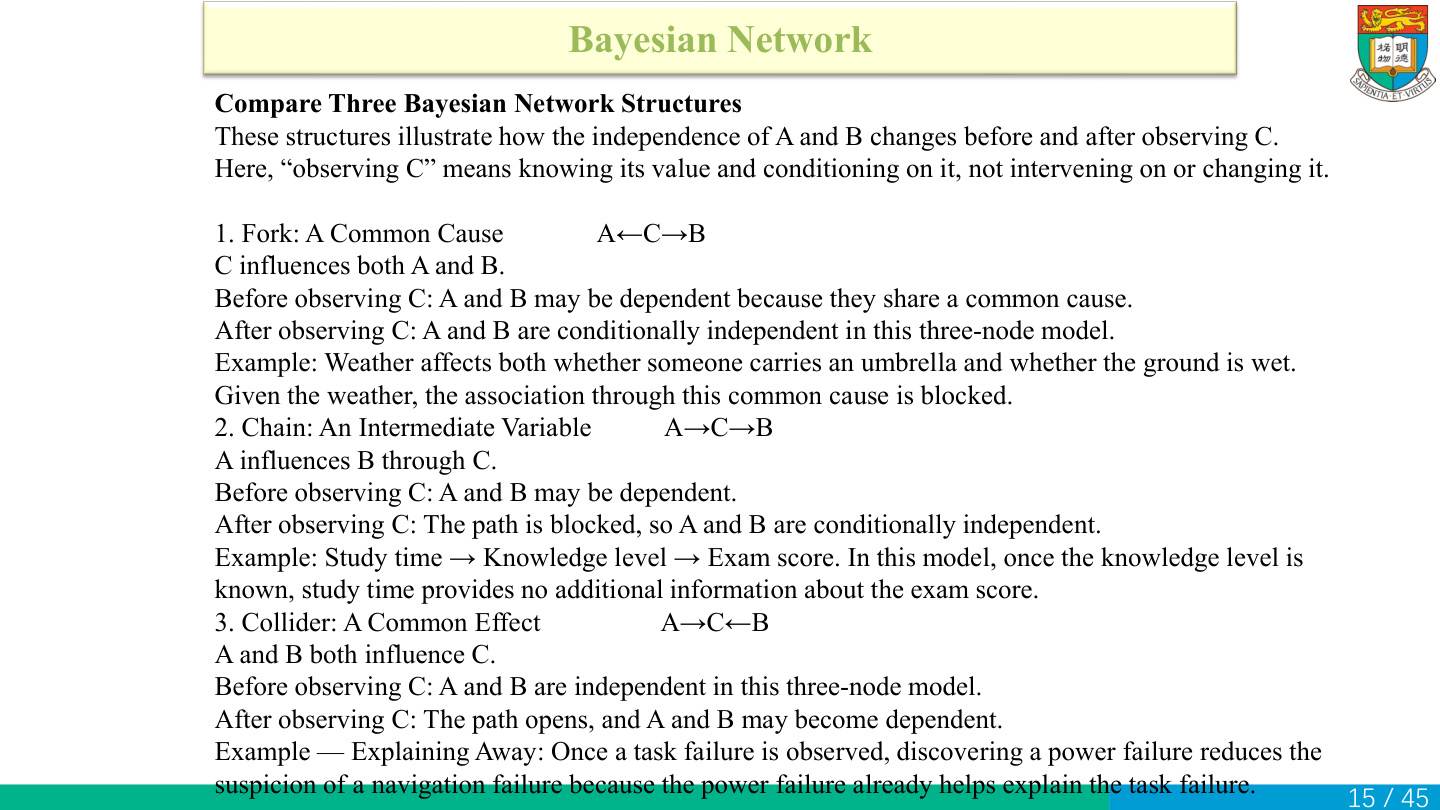
这页把三种结构放一起。读图先只看A与B之间路径上的中间C,观察两条箭头是否都指向C:若是,就是collider;否则是chain或fork。
| 结构 | 未给定C | 给定C(在本三节点模型下) |
|---|---|---|
| A←C→B,fork | A、B可能相关 | A、B条件独立 |
| A→C→B,chain | A、B可能相关 | A、B条件独立 |
| A→C←B,collider | A、B独立 | A、B可能相关 |
fork例:天气使人带伞也使地湿;给定天气后,共同原因路径被阻断。chain例:学习时长→知识水平→分数;模型中给定知识水平后,时长对分数不再提供额外信息。collider例:任务失败←电源故障/导航故障;知道共同结果后,两个解释会互相影响。
对第13页尤其要分清两次观测:先观察任务失败使路径打开;再观察一个父节点帮助解释失败,降低另一解释的相对怀疑程度。
自测:口号“多知道一个变量总会让其他变量更独立”对吗?不对,collider是明确反例。给定变量指按其取值筛选条件,不是改变该变量。
执行器标定:观测数据与未知参数分开写
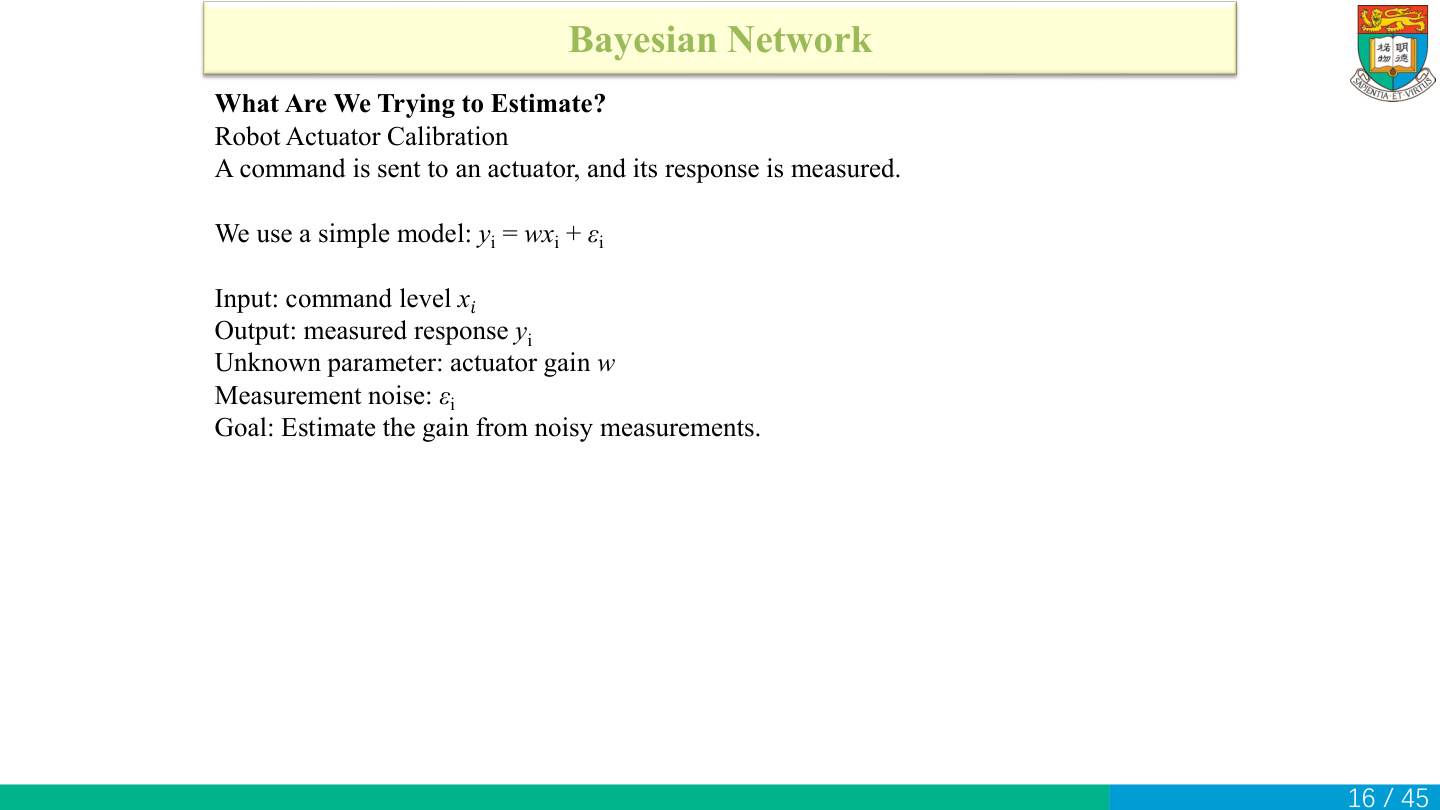
模型 y_i=w x_i+ε_i 中,x_i是第i次发送的命令值,y_i是测到的响应,w是希望估计的增益,ε_i是测量噪声。下标i表示不同实验;w没有i下标,表示这些测量共享一个增益,而不是每次各学一个w_i。
例子:命令3,若w=2,理想响应6;实际测到6.2,可以把偏差0.2看作这次噪声。看到一个不精确的样本,不宜马上认定真实增益就是6.2/3。多次测量可以在噪声假设下共同估计w。
估计时,把测量到的x、y固定,比较不同w的拟合效果;预测时,把估计得到的w固定,用新x计算响应。
若命令单位为伏特、响应为rpm,w的单位就是rpm/V,噪声ε与响应y同为rpm。本题使用无截距模型 y=wx+ε。
自测:x=0的测量能否在这个无截距模型中直接提供w的斜率信息?理想预测始终0,对w不敏感,因此单靠这些零输入无法识别增益。
似然、先验、后验:三者分别把什么当未知
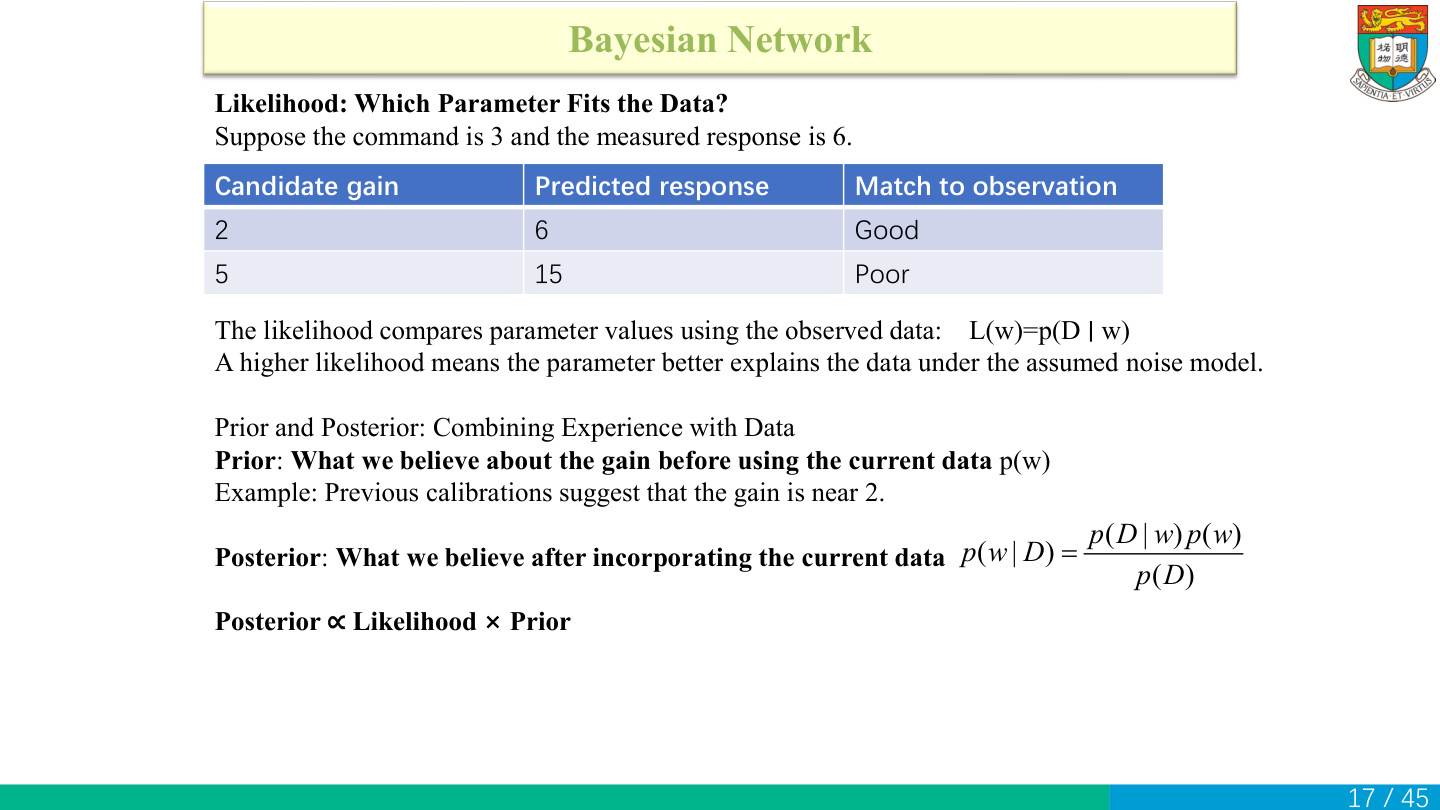
观测命令3、响应6。候选w=2预测6,w=5预测15。若噪声通常不大,前者更符合观测。形式上似然 L(w)=p(D|w) 把数据D固定,拿它比较参数w。连续数据时这里是概率密度,不能把“恰好响应6”的单点概率与密度混淆。
算一遍:假设噪声标准差1,观测密度正比 exp(−(6−3w)^2/2)。w=2时,预测6、残差0,指数为0;w=5时,预测15、残差−9,指数为−40.5。前者的密度更高,所以这次数据更支持w=2。
先验p(w)表达使用当前数据前对增益的知识,比如历史标定认为靠近2更合理。后验 p(w|D)=p(D|w)p(w)/p(D) 把似然与先验相乘,再通过p(D)归一化。
正比号省去的是对w不变的归一化常数。求最优w时,所有随w变化的项都保留下来。
自测:p(D|w)与p(w|D)是否是同一个量?不是,条件方向不同;前者在给定参数下描述数据,后者在给定数据后描述参数。
MLE与MAP:argmax返回参数,不是概率值
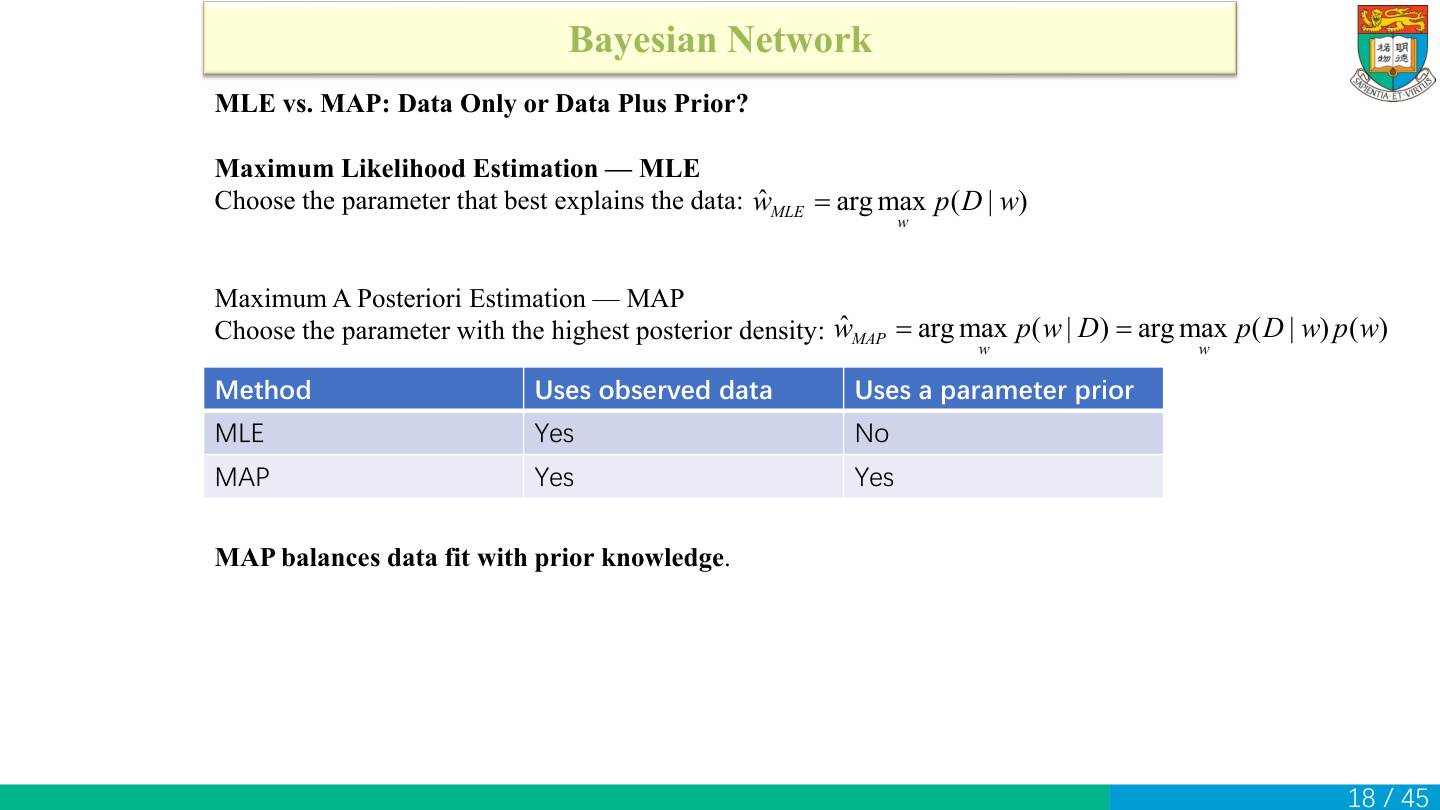
MLE是最大似然估计:w_MLE=argmax_w p(D|w)。MAP是最大后验估计:w_MAP=argmax_w p(w|D)=argmax_w p(D|w)p(w),因为分母p(D)不随w改变。
argmax读“使这个函数最大的参数位置”。若比较w=1、2、3时分数为0.2、0.8、0.5,max是0.8,而argmax是2。估计最终需要输出w,不是返回其密度0.8。
对数是严格递增函数,因此最大化正的乘积等价于最大化对数和;再加负号便可写最小化负对数。MAP变为 argmin[−log p(D|w)−log p(w)]。这一步把“数据拟合+先验约束”放在同一个加法目标里。
均匀先验下,p(w)为常数,MAP与MLE给出相同的最大点。非均匀先验会把估计拉向先验偏好的区域;先验越集中,这种拉力越强。
例子:当前观测支持w=3,先验偏向w=2。MAP将两者结合;下一页用方差计算各自的权重,再得到具体折中值。
自测:为何MAP的argmax能省略p(D)?因为固定数据时它对所有w相同,除以同一正常数不改变排名。
多次测量的似然:条件独立让乘积成立
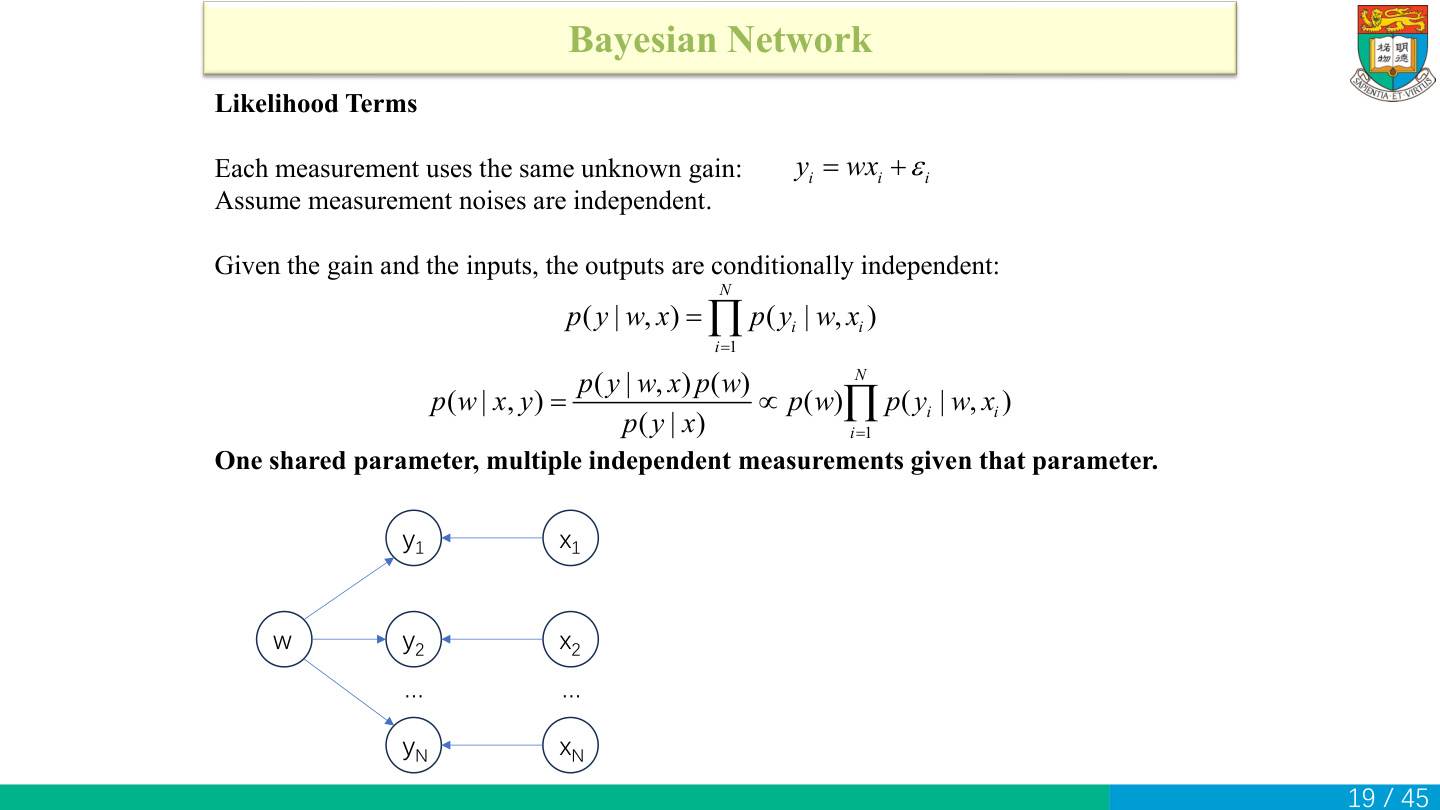
对N次测量,所有输出共享未知w:y_i=w x_i+ε_i。若各次噪声独立,给定w与输入后,输出条件独立,因此 p(y|w,x)=Π_i p(y_i|w,x_i)。大写Π表示连乘,和Σ连加不同。
两次测量:D包含 (x1,y1)=(1,2) 与 (x2,y2)=(2,4.2)。给一个候选w,分别算两次观测密度,再乘起来。假设方差1,联合密度正比 exp(−[(2−w)^2+(4.2−2w)^2]/2)。取负对数,指数中的平方残差变成加法目标。误差独立是能相乘的前提,不是只因有两个样本就自然成立。
图中w指向各y_i,x_i也指向相应y_i。给定w后,各次噪声可独立;但若把w当不确定随机变量且不条件化,各y_i仍共享w带来的关联。这与前面共同父节点的fork有关。
后验 p(w|x,y)∝p(w)Π_i p(y_i|w,x_i)。先验只乘一次,不是每个测量各乘一次同一p(w),否则样本越多会凭空重复强化先验。
自测:给定同一w,两次独立测量的似然分别为0.5与0.2,联合似然是多少?0.5×0.2=0.1;取对数后为 log0.5+log0.2。
从高斯MAP推到岭惩罚,含每一个系数
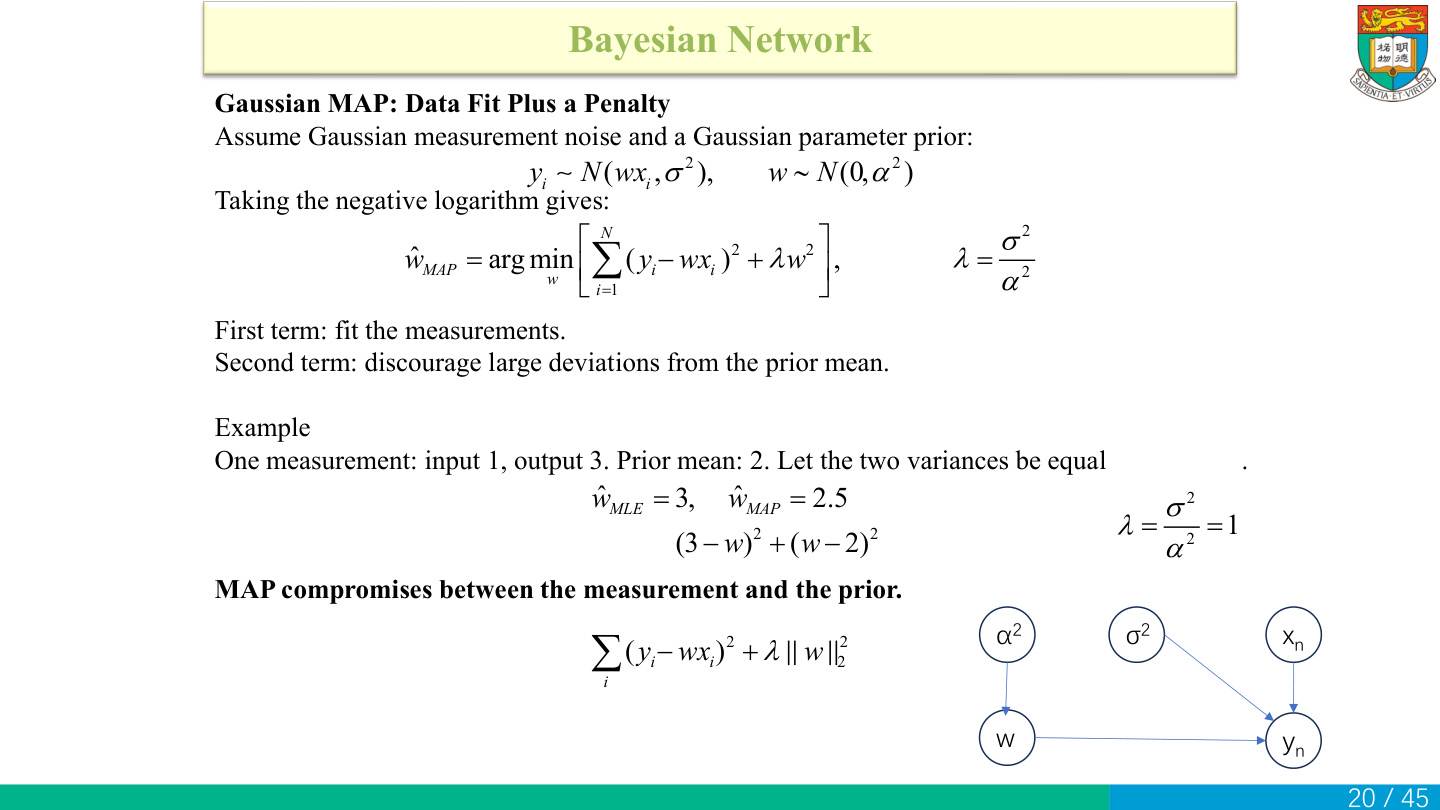
设 y_i|w,x_i ~ N(wx_i,σ²),先验 w~N(0,α²)。σ²表示测量噪声方差;α²表示先验对w的分散程度。高斯密度中的指数分别是 −(y_i−wx_i)^2/(2σ²) 与 −w²/(2α²)。
- 似然是每条观测的高斯密度相乘,再乘一次先验。把各指数加起来,乘积可写成
常数 × exp[−Σ_i(y_i−wx_i)²/(2σ²)−w²/(2α²)]。 - 取负对数,exp被消去,负号翻转,得到
Σ_i(y_i−wx_i)²/(2σ²)+w²/(2α²)+常数。 - 丢掉与w无关的常数,整个目标乘正数2σ²。第一项的2σ²约掉,第二项的系数变成
2σ²/(2α²)=σ²/α²。 - 于是目标是
Σ_i(y_i−wx_i)²+λw²,其中λ=σ²/α²。噪声越大越依赖先验;先验越分散,惩罚越弱。若先验均值μ0不为0,惩罚变λ(w−μ0)²。
原页下方例子改用先验均值2、单次x=1,y=3、两个方差相等,目标是 (3−w)²+(w−2)²。求导:2(w−3)+2(w−2)=4w−10;令0得w=2.5。MLE只最小化 (3−w)²,得到3。这里不是把上方零均值公式直接代入,先验均值已改变。
先验均值为μ₀时,对目标求导得到 −2Σᵢxᵢ(yᵢ−wxᵢ)+2λ(w−μ₀)=0。两边除2、打开括号,含w的项合为 w(Σᵢxᵢ²+λ),移到另一边得 Σᵢxᵢyᵢ+λμ₀。因此 w_MAP=(Σᵢxᵢyᵢ+λμ₀)/(Σᵢxᵢ²+λ)。例题代入得 (1×3+1×2)/(1²+1)=5/2。
自测:α²变得很大,λ怎样变?趋近0,先验更宽,MAP向MLE靠近。σ²、α²都是方差,不能把标准差直接代进同一比例。
词袋:把句子变成固定长度的数字向量
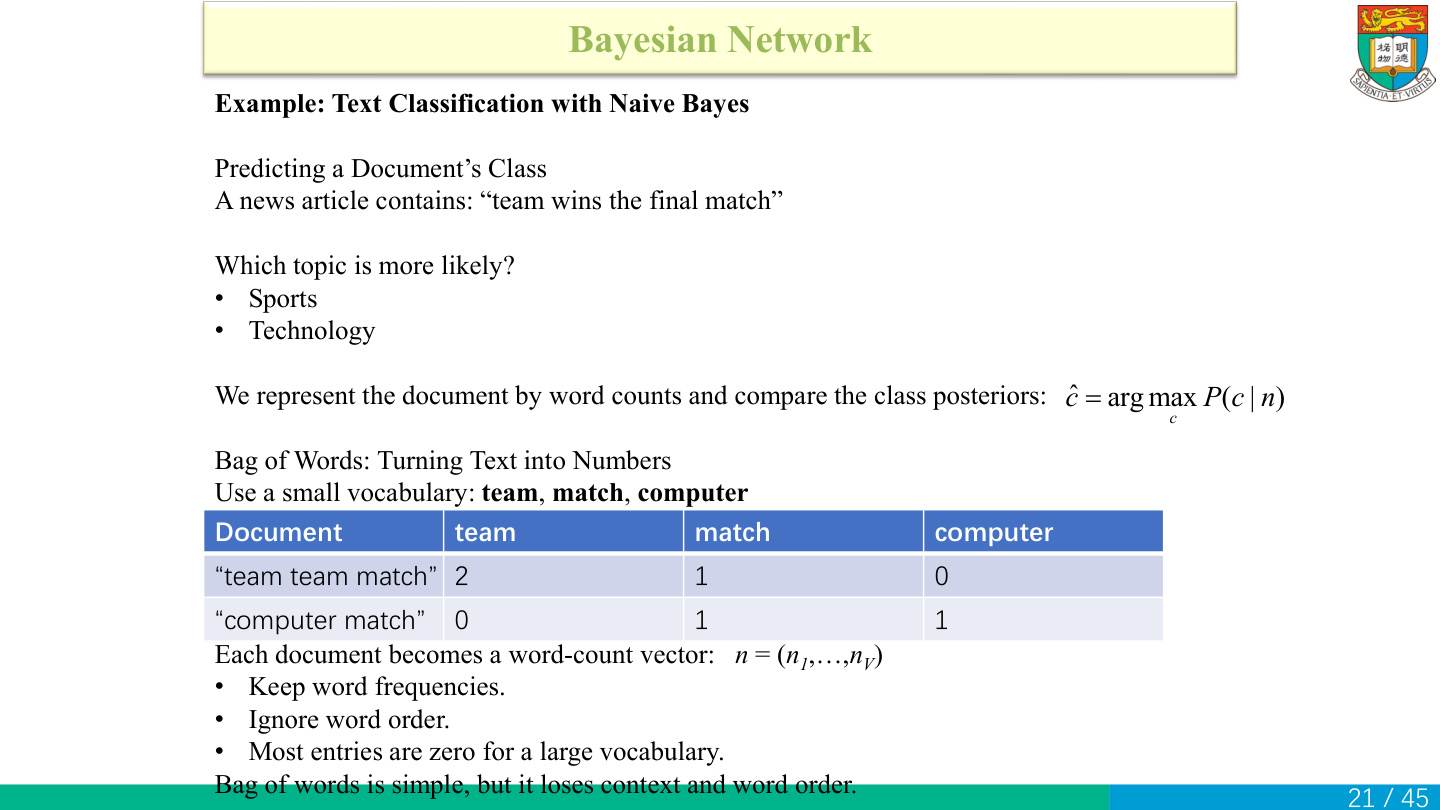
朴素贝叶斯文本分类希望根据文章内容预测类别,例如Sports或Technology。计算机先要把不同长度的文字转成固定规则的数字。课件词表固定顺序为 [team,match,computer],每个位置记录该词出现次数。
“team team match”变 [2,1,0];“computer match”变 [0,1,1]。第一个向量的2表示team出现两次,不表示“类别2”,也不是team在词典中的编号。向量维度V等于词表大小,本例V=3;文章长度L是出现的词数,本例第一篇L=3。
词袋bag of words保留词频而忽略顺序,所以“team match team”与“team team match”向量相同。这有利于简化计算,却丢失语序、否定关系和上下文。真实词表很大时,多数词没在某篇文章出现,向量常很稀疏。
流程:先用训练数据确定词表和预处理规则;每篇文档按同一顺序计数;从训练类别估计类先验与词概率;对新文档比较后验得分。测试时不能重新随意排序词表,否则第一维含义会变。
按本例词表,句子“team wins the final match”中的team和match各出现一次,向量为 [1,1,0];词表之外的词在这三个位置上不计数。
自测:[0,2,1]对应什么计数?team0次、match2次、computer1次;总已收录词次数3。
“朴素”的假设:给定类别,把每次词出现当独立抽样
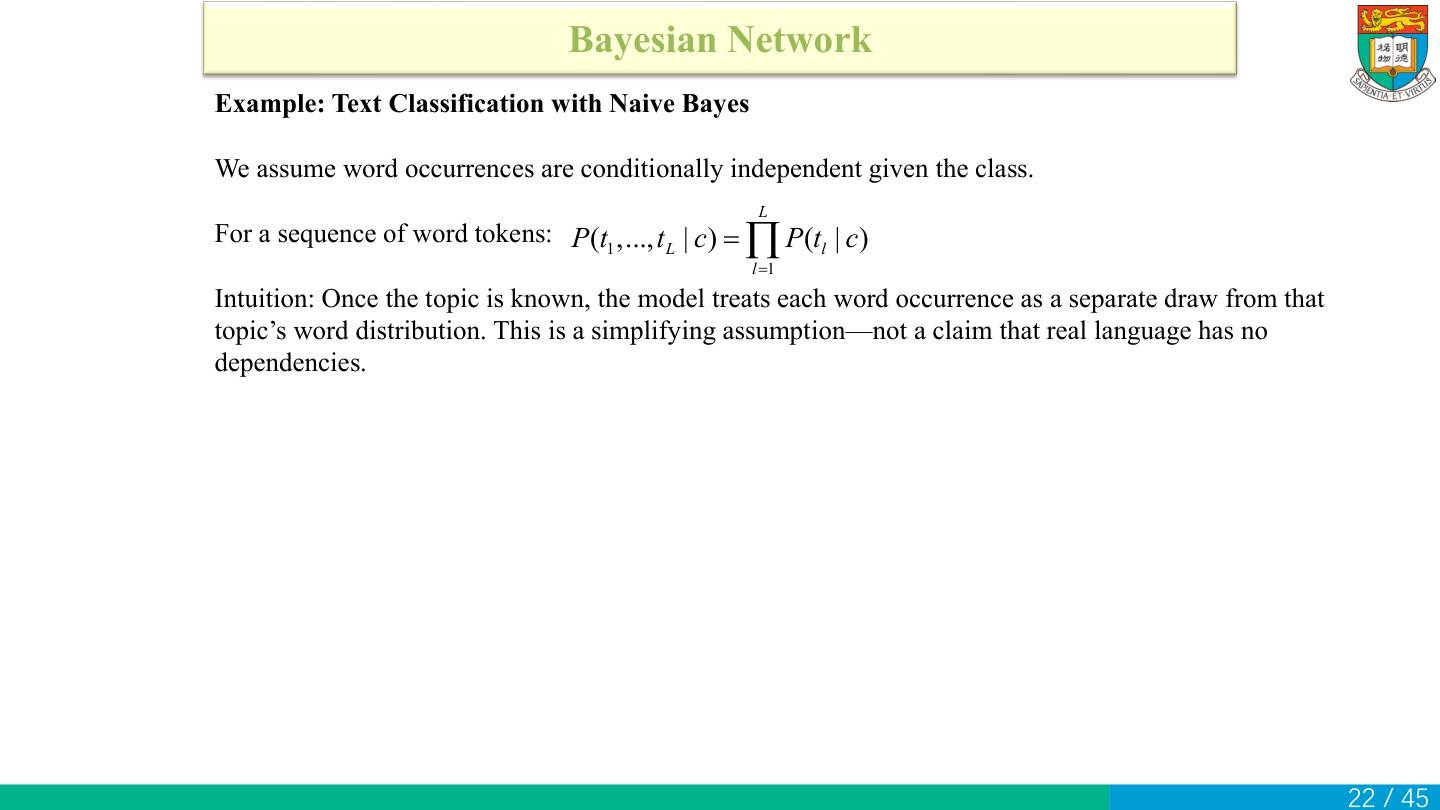
给定类别c,朴素贝叶斯假设每个token(一次词出现)独立地从该类的词分布抽取:P(t1,…,tL|c)=Π_l P(t_l|c)。这里同一个team出现两次,就有两个team因子,而不是只乘一次。
例子:Sports类词概率team0.6、match0.3、computer0.1。序列“team team match”的条件概率为 0.6×0.6×0.3=0.108;若再乘类先验0.5,类别未归一化得分为0.054。0.108是给定类别后的词序列概率,0.054额外包含类别先验,角色不同。
“朴素”来自条件独立这个简化:模型分别统计每类中各词的出现概率,所以训练只需要词频计数,预测只需要连乘或对数相加。
若只看词频[2,1,0],两个team和一个match有三种排列:TTM、TMT、MTT。各排列概率都为θ_team²θ_match,所以词频概率是3倍的单序列概率。3来自 3!/(2!1!0!)。一般情形的倍数是 L!/Π_j n_j!,由观察到的词频决定。比较Sports和Technology时这倍数相同,就只需要比较 Π_j θ_cj^(n_j)。
自测:team出现3次,它的概率项怎样写?θ_team³。未出现词的次数为0,概率项是 θ^0=1,不会因该词未出现而直接乘0。
训练计数与平滑:修复本页重复错放的公式
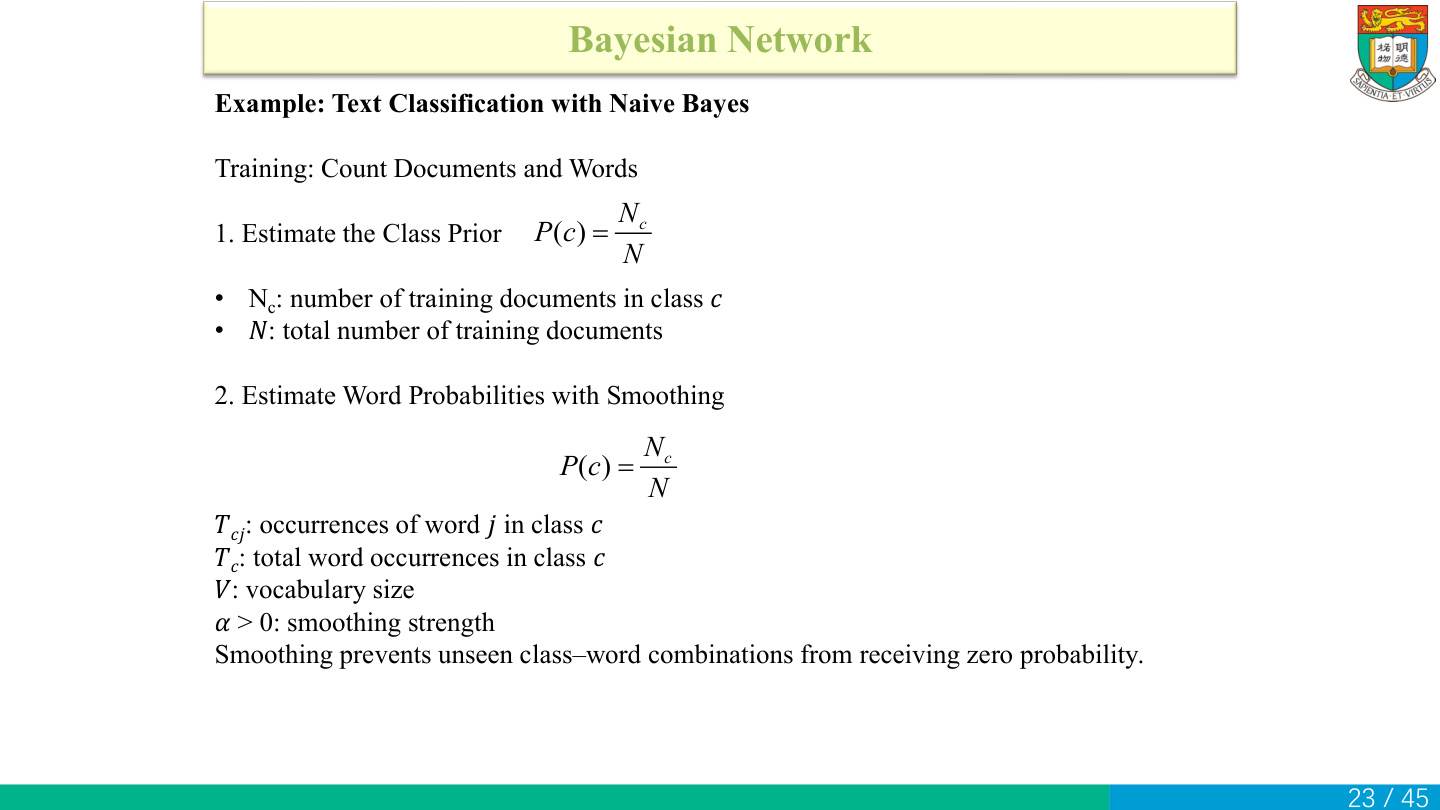
第一步估计类先验 P(c)=N_c/N:N_c是该类训练文档数,N是全部训练文档数。例如10篇里6篇Sports,先验为0.6。这里数的是文档,不是词。
第二步估计类内词概率。T_cj是第c类中词j的总出现次数;T_c是该类所有词出现次数之和;V是固定词表大小;α>0是平滑强度。正确的加性平滑公式为 θ_cj=(T_cj+α)/(T_c+αV)。
原图在词概率的位置重复了类先验公式;词概率应使用上面的 θ_cj=(T_cj+α)/(T_c+αV)。分子数该词,分母数该类全部词。
以某一类为例,把α=1当成给词表里的每个词先放一张计数卡。
| 词 | 实际次数 | 加一后的次数 | 概率 |
|---|---|---|---|
| team | 4 | 5 | 5/9 |
| match | 2 | 3 | 3/9 |
| computer | 0 | 1 | 1/9 |
| 合计 | 6 | 9 | 1 |
computer虽然在训练中未出现,乘入新文档的类别得分时仍有1/9的概率。
分母加αV是给每个词都加α,增加的总次数为V份α。若只在分子加1、分母不变,概率总和会超过1。α=1常叫Laplace平滑;其他正值是更一般的加性平滑。
自测:词表变成4词,仍取α=1,分母应是T_c+3还是T_c+4?后者。即使第四词在某类没出现,也占一份平滑伪计数。
预测比较:重复词的指数、归一化与对数分数
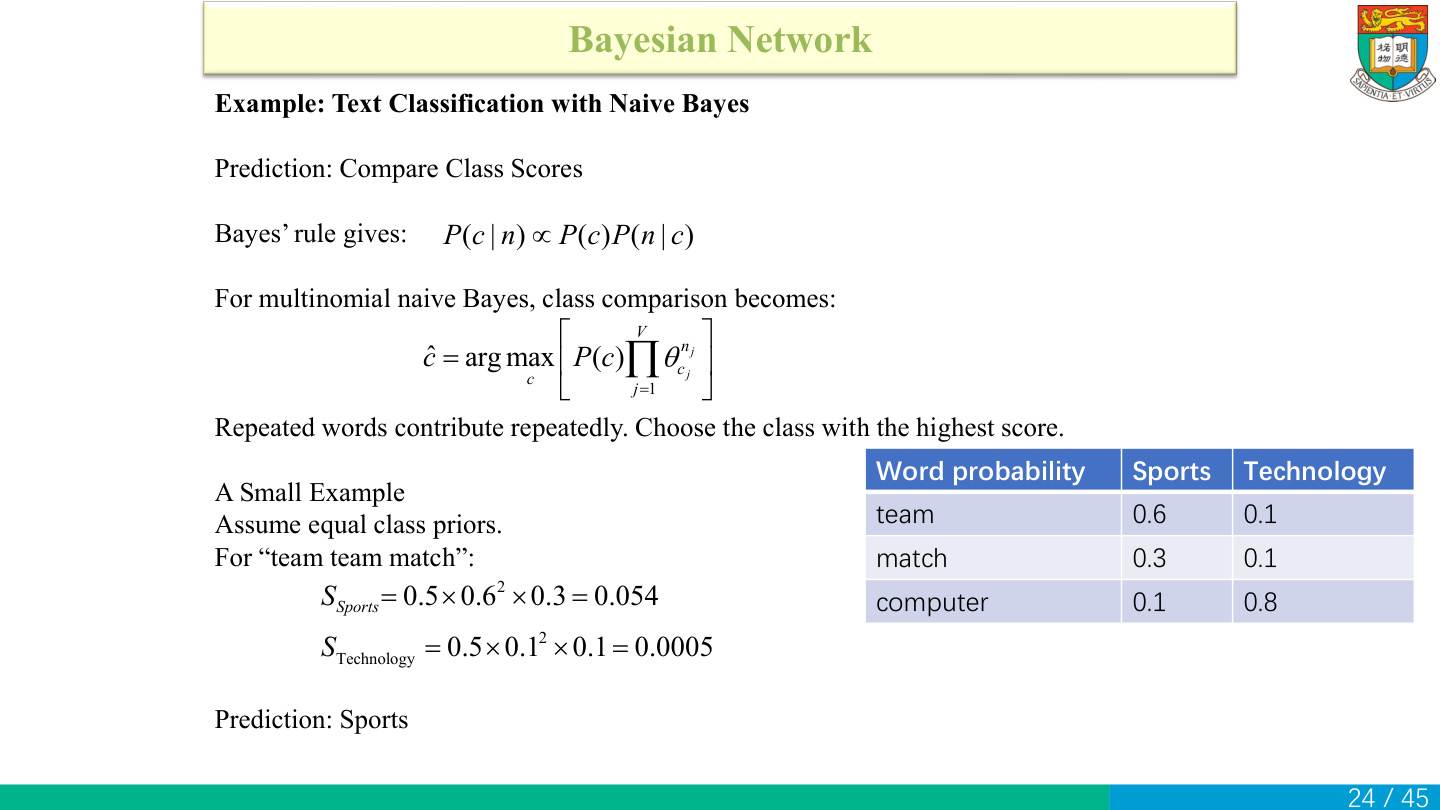
预测规则 c_hat=argmax_c P(c|n)。由贝叶斯公式,对同一篇文档,各类别共用分母P(n),所以只需比较 S_c=P(c)Π_j θ_cj^(n_j)。S_c不是自动归一化后的后验概率,但其大小顺序与后验相同。
原表Sports词概率为team0.6、match0.3、computer0.1;Technology为0.1、0.1、0.8;两类先验均0.5。“team team match”向量 [2,1,0]:
- Sports得分
0.5×0.6²×0.3×0.1⁰=0.5×0.36×0.3×1=0.054。 - Technology得分
0.5×0.1²×0.1×0.8⁰=0.5×0.01×0.1×1=0.0005。 - 0.054更大,预测Sports。
- 若要两类归一化后验,分母是
0.054+0.0005=0.0545,Sports约0.9908,Technology约0.00917。不能直接说Sports后验只有5.4%。
词很多时连乘会非常小,可比较 log S_c=log P(c)+Σ_j n_j log θ_cj。对数单调,不改变argmax,却把乘法变加法,数值更稳定。team出现两次,对数项也应乘2。
自测:文档只有“computer”,两类得分分别0.05与0.4,应预测Technology。不是永远选训练文档更多的类别,词似然也会改变排名。
休息
休息15分钟。接下来从概率推理转到神经网络的数据压缩与重构。
进入自编码器
自编码器的路径是 x→编码器φ→潜在表示z→解码器ψ→重构x_hat。训练目标是让重构结果接近输入。
自编码器总图:压缩通道再尝试还原
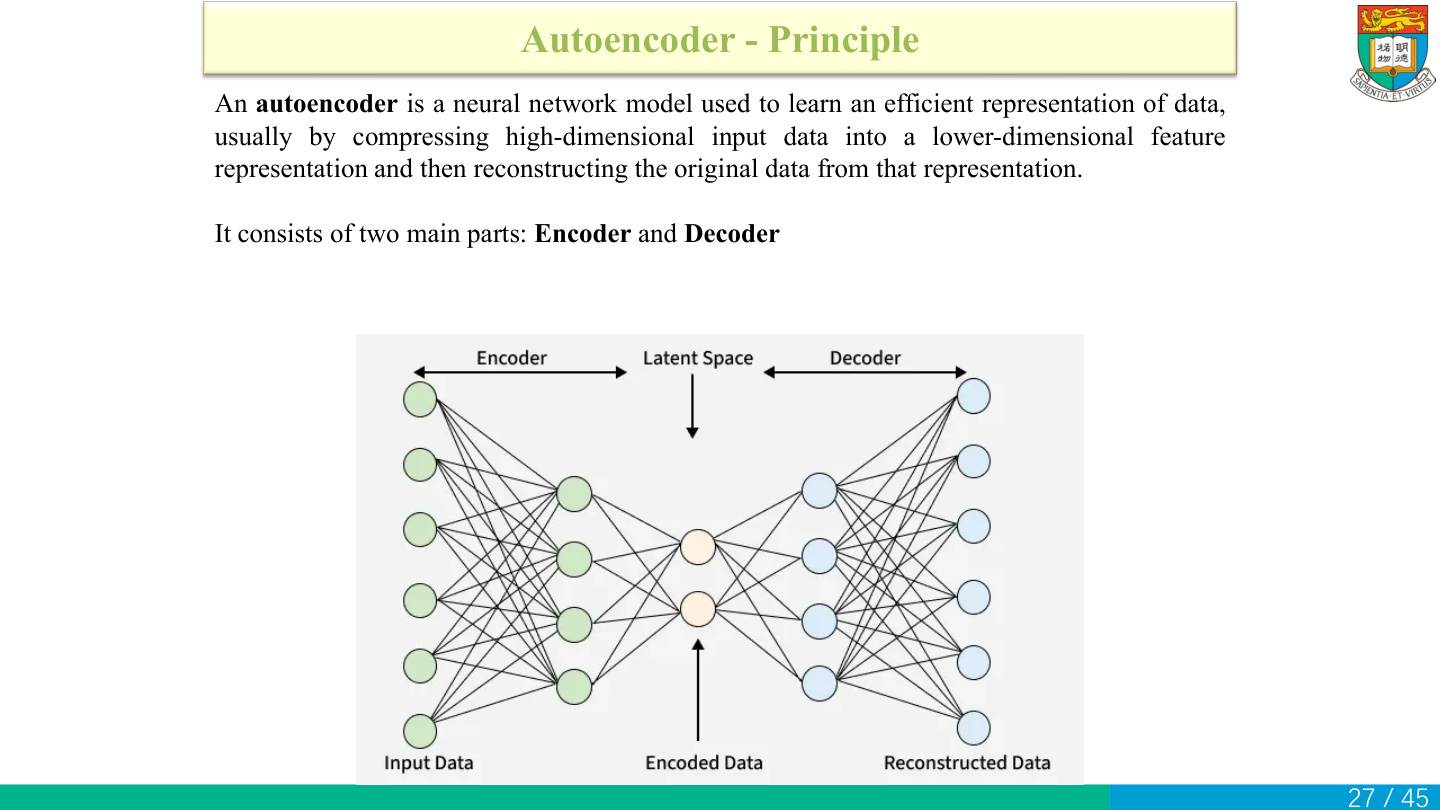
图左端是输入,左半部分encoder(编码器)把输入映射到中间较窄的latent space(潜在空间),右半decoder(解码器)把潜在表示恢复到原输入形状。网络输出是重构值,通常不与输入完全相同。
直觉:像把一张复杂图片写成一张很短的“内部说明书”,再用另一个模型根据说明书还原。内部说明书是学出来的数字向量,不一定每个位置都对应人能命名的属性。
训练样本可以只有图像x,不需“这是什么类别”的外部标签,因为目标就是x自己。前向算 x_hat=ψ(φ(x));比较x_hat与x得损失;反向传播同时调整编码器与解码器参数。它常被归入无监督表示学习,也具有用输入构造监督目标的自监督思路。
用两维压一维试算。若正常数据常是(2,3)、(5,6)这种“第二维≈第一维+1”的关系,编码器可以只存第一维z,解码器输出(z,z+1)。输入(5,6)得到z=5,重构(5,6)。输入(5,9)也得到z=5,但重构仍是(5,6),第二维差3。瓶颈保留了常见关系需要的信息。
自测:自编码器训练时的目标图从哪里来?就是当前输入x本身;网络输出x_hat后,与x逐元素比较。
图中每一层:6个输入节点→4个隐藏节点→2个编码节点→4个解码节点→6个重构节点。连线表示权重,每个节点把收到的加权输入相加、加偏置,再经过激活函数。
Encoder公式:从x到z,φ里包含什么
点击图片放大。
课堂补充
Week09课堂讲解 · Part01 00:22:10–00:27:18
自编码器基本结构
Week09课堂讲解 · Part01 00:35:22–00:47:31
潜在维度、Decoder、重构损失
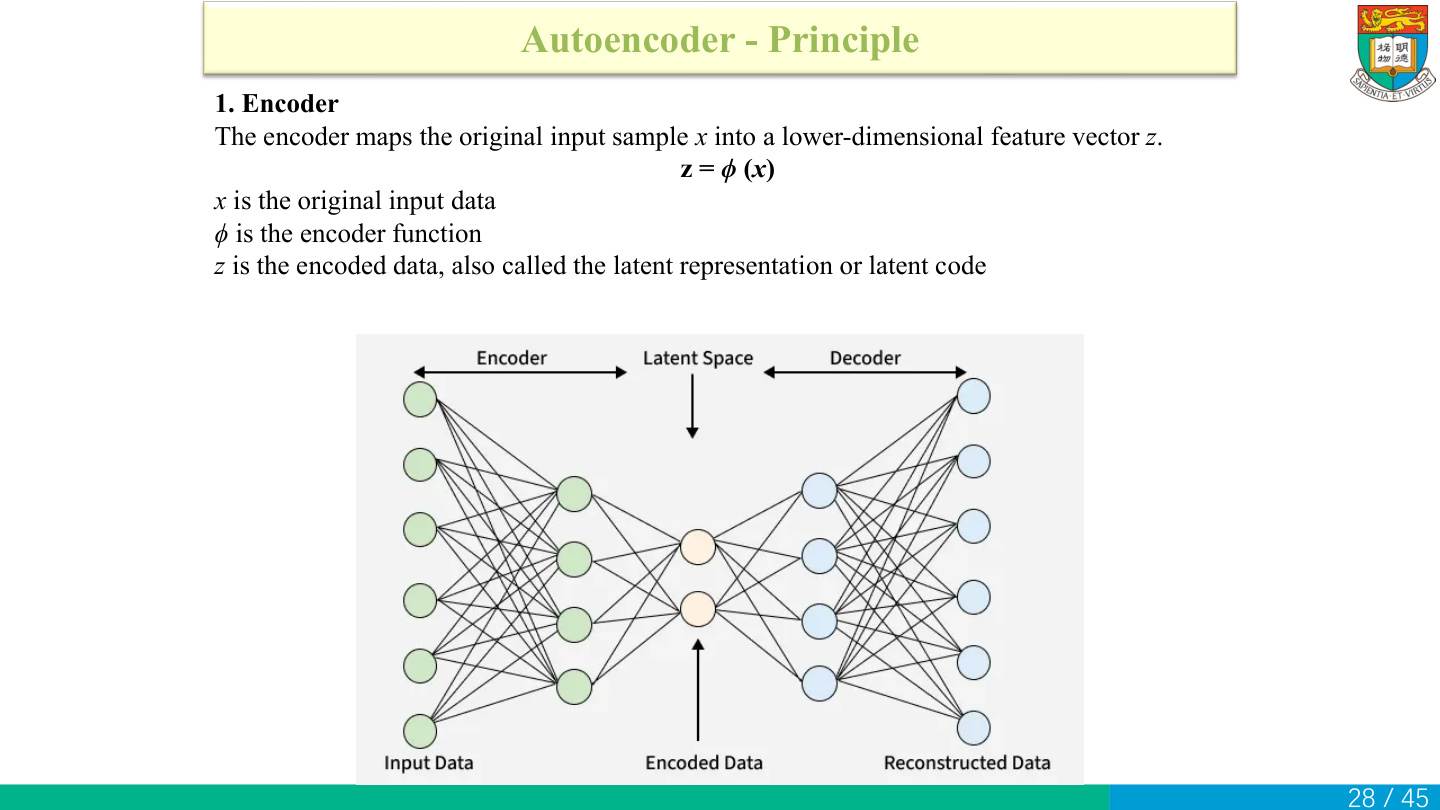
记号为 z=φ(x)。x是原输入,φ是编码器函数,z是潜在表示。φ表示由权重、偏置和激活函数组成的编码器;这个函数名把多层运算合写在一起。
教学小网络:x有3维,编码成2维。令 u=Wx+b,W形状2×3,b形状2×1;然后 z=sigmoid(u),z形状2×1。若x=[1,0,2]^T,W两行为 [1,0,−1] 与 [0,1,1],b为0,则u第一维 1−2=−1、第二维 0+2=2,z约 [0.2689,0.8808]。
编码器参数是W的6个权重与b的2个偏置,合计8。z中的两个数是这次输入产生的激活,不是两个需要永久保存的模型参数。换输入后z会改变;同一个训练好编码器的权重仍相同。
压缩只意味着输出特征数减少,如何减少由训练目标决定。不是随便删除输入后两维,也不是必须取输入均值。多层网络能学习非线性组合。
自测:一批B个3维样本编码成2维,输出共有多少个激活?2B个;模型参数依然8个,不乘B。Week09 Part01 00:22:10–00:27:18及00:35:22–00:47:31提供相关口头说明。
784维变32维:维度、样本数与参数数分开数
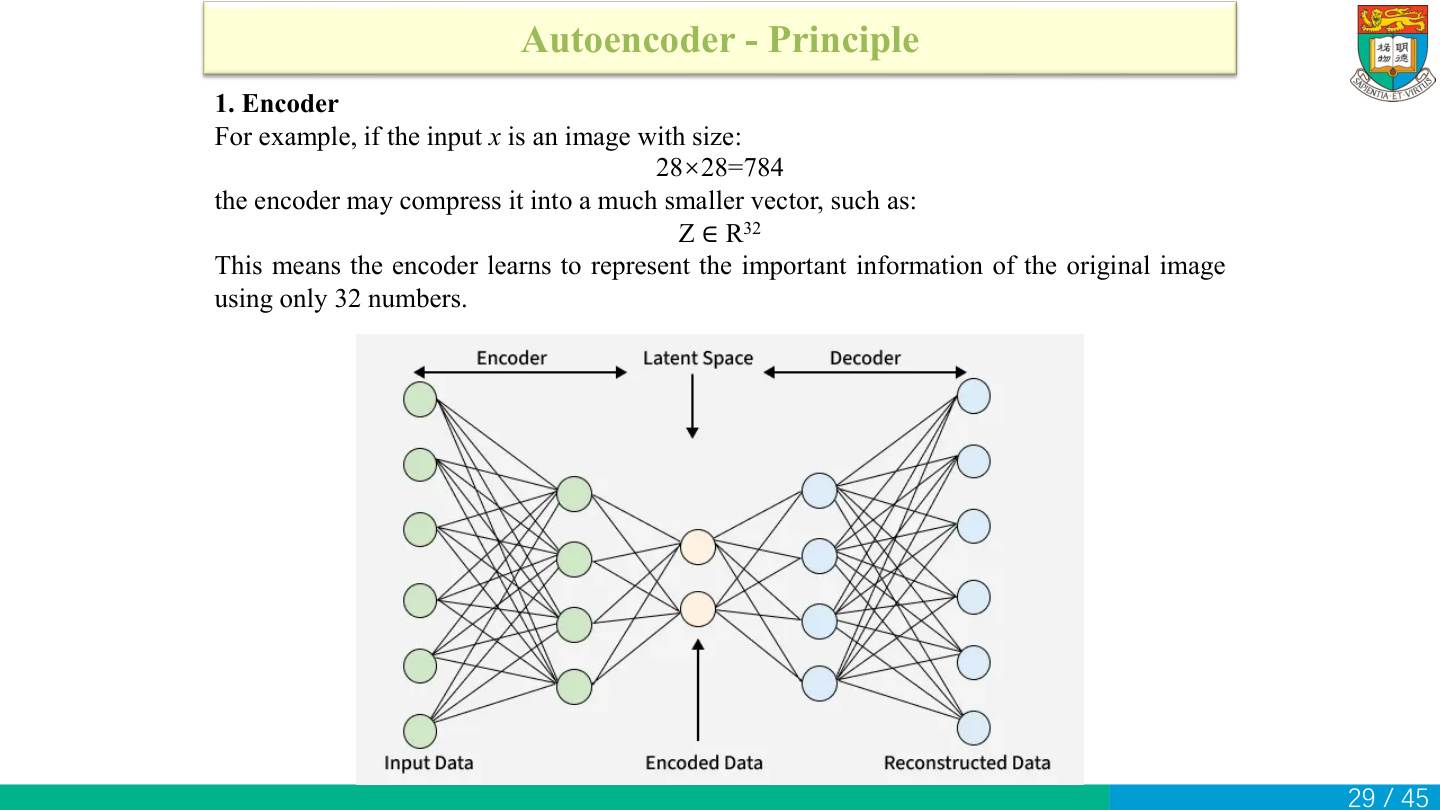
28×28灰度图有 28×28=784 个像素,展开后每张图为784维。编码成 z∈R^32,表示用32个实数描述这张图。
编码后的数值个数缩小到原来的 32/784≈4.08%,维数压缩约24.5倍。解码器再用这32个数生成784维重构。
单层参数例:若直接全连接784→32且有偏置,权重 784×32=25088,偏置32,合计25120。输出每张图仍只有32个数。参数数可以远大于潜在维度,因为它们要支持许多不同输入共用同一套映射。
本页选择32维潜在空间;后面的网络示例选100维,参数计算题选64维。潜在维度是设计网络时设定的宽度。
自测:20张图输入,若每张编码32维,z整体常写形状 (20,32)。这会把训练参数数变成20倍吗?不会,批次只增加激活与计算量,模型权重共享。
潜在表示:保留什么,由训练目标决定
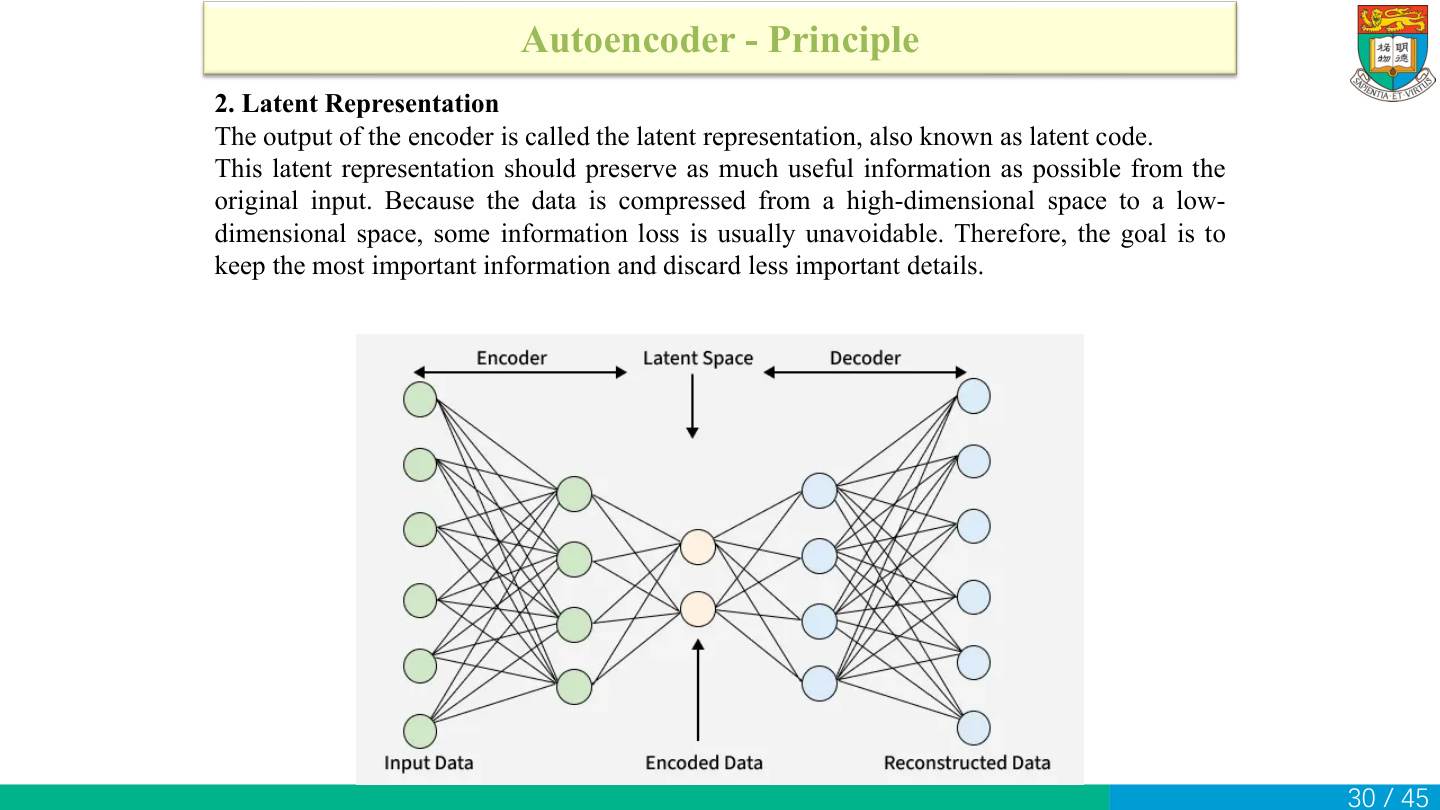
latent representation、latent code、潜在表示、潜在编码在这里指同一中间向量z。“潜在”表示它不是原传感器直接测出来的量,而是模型内部学出来的表征。
训练会让z保留最有助于降低重构误差的信息。用像素平方误差训练时,笔画轮廓、亮暗分布等影响许多像素的结构,会对损失产生较大影响。
例子:把5个传感器值压成3维,可以把它们之间共同变化的模式编码进z。一个潜在维度通常混合多个输入的影响,就像“负载增大时,电流、温度和振动一起变化”的组合。
自测:潜在维度从32增到100,对重构能力有什么影响?网络能传递更多信息,通常更容易把细节重构出来;代价是压缩程度降低。
Decoder公式:x_hat是近似重构,不是标签
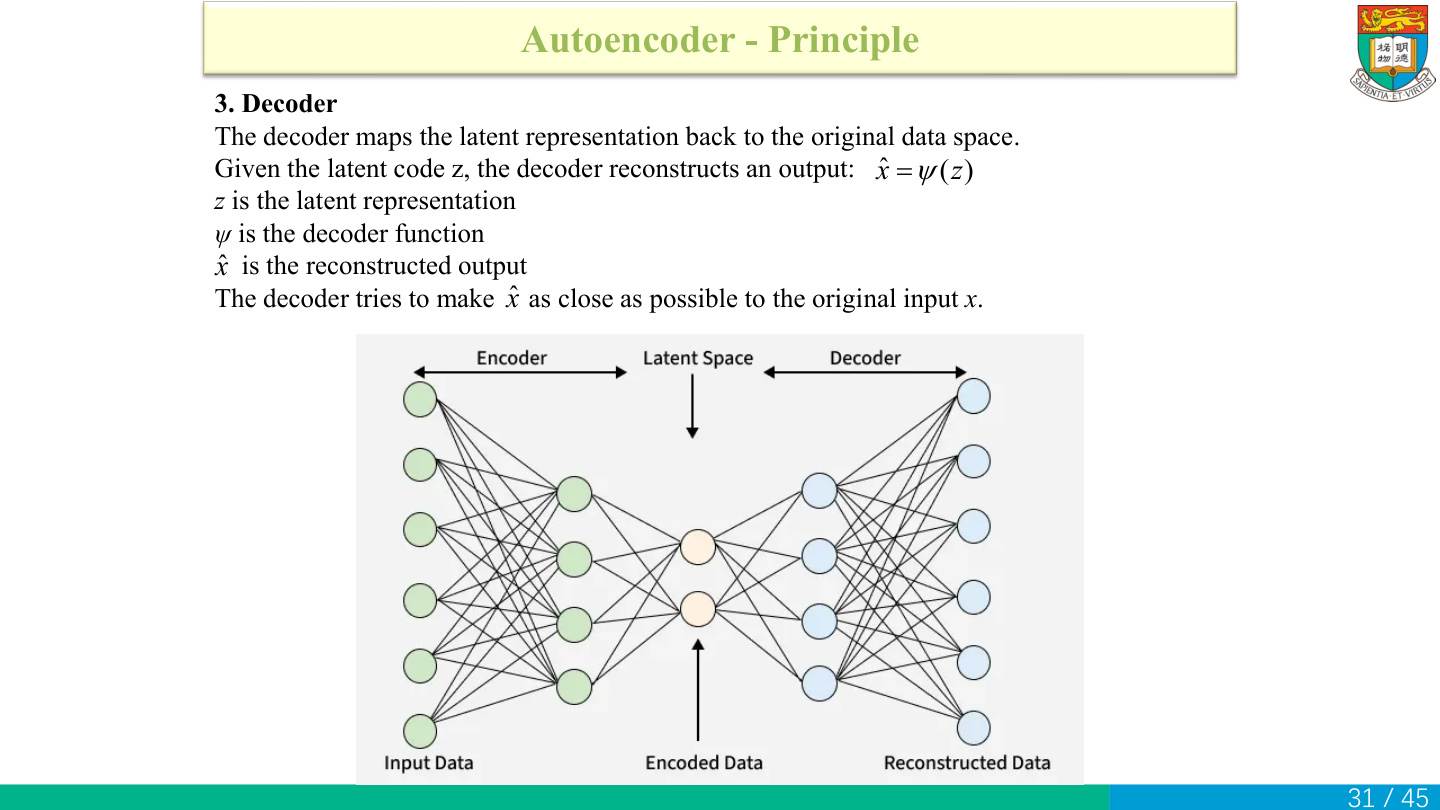
解码器写 x_hat=ψ(z)。帽子表示重构或估计;z来自编码器;ψ是另一套可训练映射。输出维度要回到输入所在空间,例如输入784维,重构也应是784维,才能逐像素比较。
例子:z有2维,解码到3维。W形状3×2,b形状3×1。若z=[0.2,0.8]^T,W三行为 [1,0]、[0,1]、[1,−1],b为0,则线性输出 [0.2,0.8,−0.6]^T。若末层还接sigmoid,需分别再算 1/(1+e^(−u)),不能把线性结果直接当最终输出。
有损压缩后,ψ通常不是φ的严格数学逆。不同输入可能被编码为接近甚至相同的z,解码器无法凭空知道被丢弃的细节。它只能根据训练学到的模式生成近似还原。
本讲编码器与解码器使用各自独立的权重。即使层的宽度左右对称,参数也逐层计算。
自测:输入为5个传感器值,若decoder输出3个值,还能直接与5维输入做逐元素MSE吗?不能,形状不匹配。3维可以是潜在空间,但重构端应回到5维。
重构损失:平方、求和、平均到底除哪个数
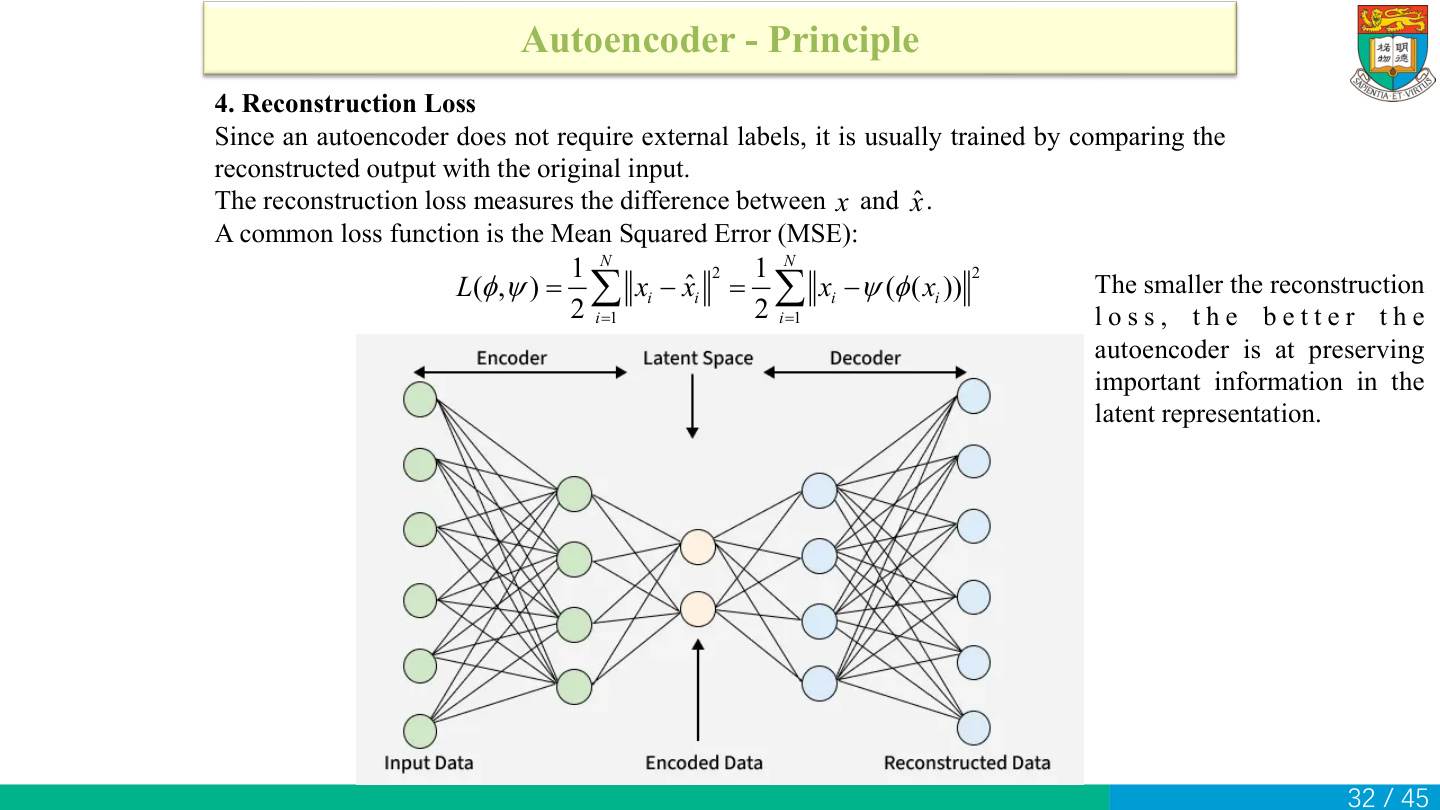
令一个样本误差向量 e=x−x_hat,平方范数 ||e||²=Σ_j e_j²:先逐维相减,再逐维平方,最后相加。训练目标 L(φ,ψ) 通过 x_hat=ψ(φ(x)) 同时依赖两套参数。
算一遍:x=[1,2],x_hat=[0.8,2.3],误差为 [0.2,−0.3],逐项平方得 [0.04,0.09],平方和0.13,按两个特征取平均得到MSE=0.13/2=0.065。
用两条三维误差向量比较三种写法。第一条为(0.2,−0.3,0),平方和0.13。第二条为(0,0.1,0.1),平方和0.02。令S为所有平方项的总和,则S=0.15,样本数N=2,每条特征数d=3。
| 写法 | 公式 | 代入结果 |
|---|---|---|
| 原图公式,半平方误差和 | S/2 | 0.15/2=0.075 |
| 每样本平均的半平方误差 | S/(2N) | 0.15/4=0.0375 |
| 每元素的MSE | S/(Nd) | 0.15/6=0.025 |
原图把第一行称为MSE,实际计算时要先认清题目要求的平均范围。
为什么常有1/2?对单维 (x_hat−x)²/2 求x_hat导数,平方带来的2与1/2抵消,得到 x_hat−x。再用链式法则把梯度传回decoder和encoder。
自测:误差为2和−2,MSE是多少?先平方为4和4,再平均得4。先平均误差会得到0,丢掉两次预测偏离的大小。
编码器实例:784→256→128→100逐层走
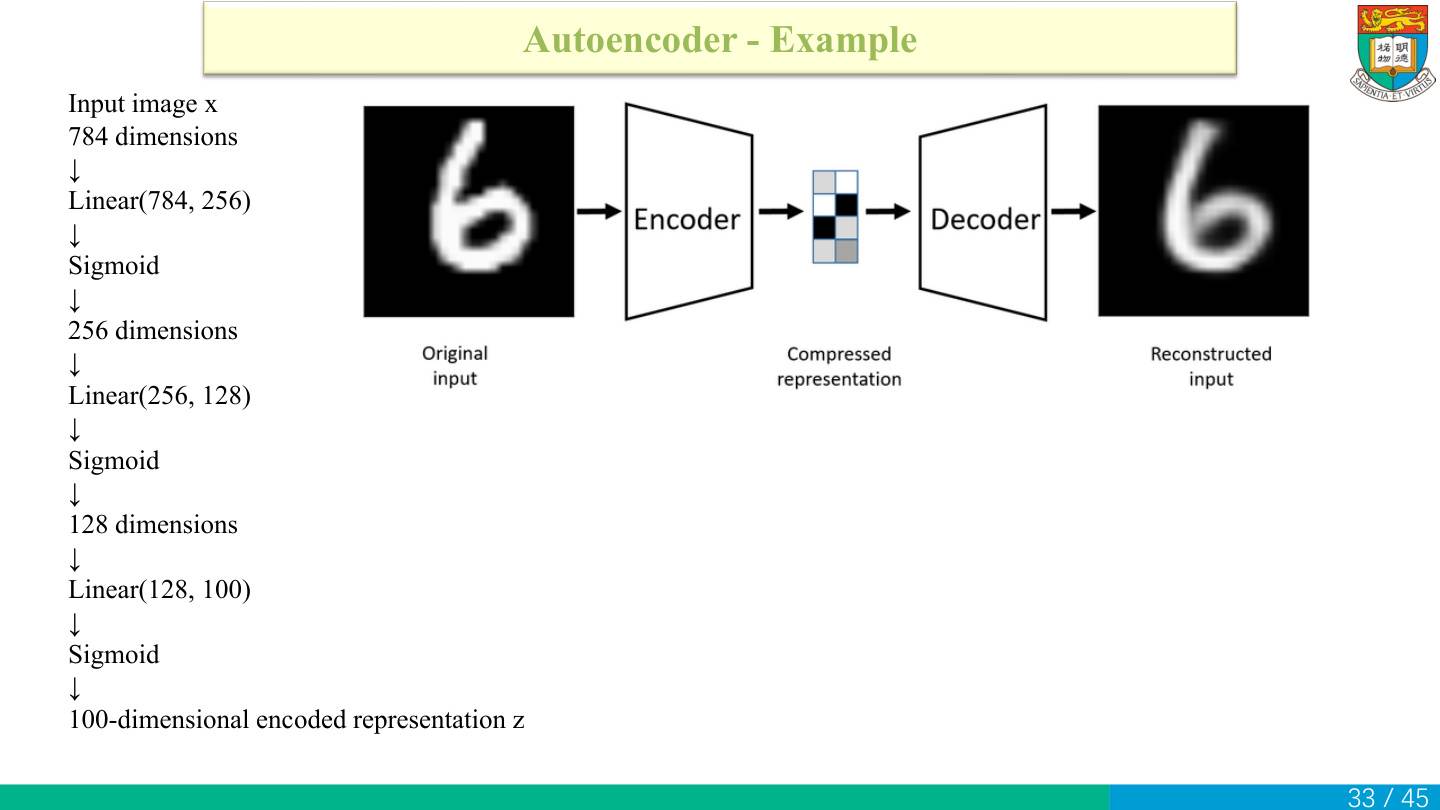
本页结构依次为:784维输入→Linear(784,256)→Sigmoid→Linear(256,128)→Sigmoid→Linear(128,100)→Sigmoid→100维z。每个Linear都做 u=Wh+b,Sigmoid再逐元素做 1/(1+exp(−u))。
按单样本列向量跟踪:第一W为256×784,输出256×1;第二W为128×256,输出128×1;第三W为100×128,输出100×1。每次Sigmoid保持维度,只把数值压到0与1之间。它不会把256维自动压成128维,降维发生在下一Linear的输出节点数。
每层参数依次为 784×256+256=200960、256×128+128=32896、128×100+100=12900。编码器总参数为 200960+32896+12900=246756。
一批B张图常写 (B,784)→(B,256)→(B,128)→(B,100),数学列向量写法与程序批量行写法只是布局不同,要统一转置规则。
自测:本页一共有几个有参数的层?3个Linear;3个Sigmoid没有额外权重或偏置。图中的数字6是输入图片,模型要重构它的784个像素。
图中过程:左侧清晰数字6→编码器→100维压缩表示→解码器→右侧重构图。右边的6较模糊,表示压缩和重构时丢失了一部分像素细节。
解码器实例:100→128→256→784不是求矩阵逆
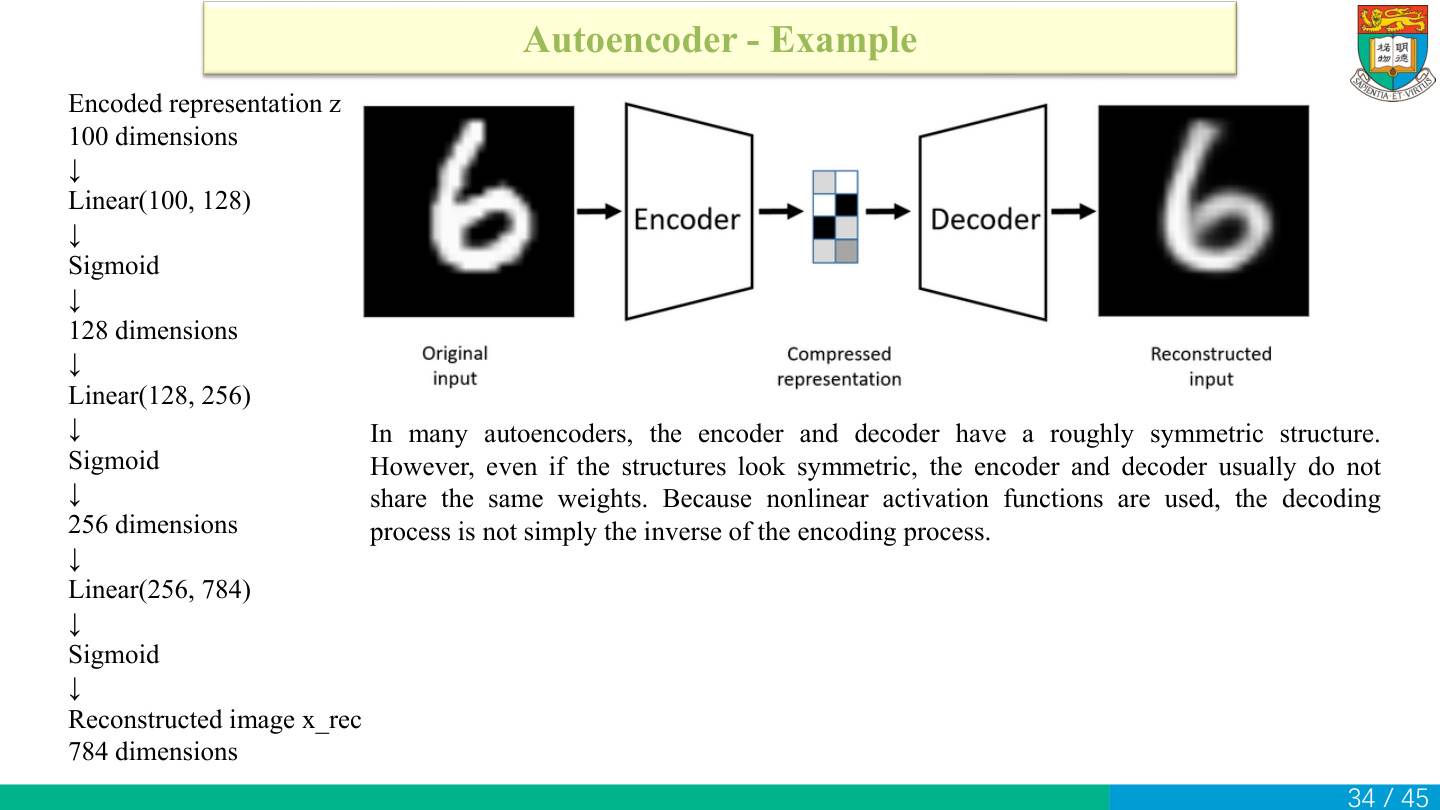
decoder把100维z依次送入Linear(100,128)、Sigmoid、Linear(128,256)、Sigmoid、Linear(256,784)、Sigmoid,得到784维重构,再按原像素顺序reshape回28×28图像。
单样本权重形状依次128×100、256×128、784×256;偏置长度分别128、256、784。独立参数为 100×128+128=12928、128×256+256=33024、256×784+784=201488;合计247440。与上一页encoder246756相加,完整100维例共有494196参数,假设权重不共享。
虽然维度链看起来左右对称,偏置总数不对称:编码器输出层数值数为256+128+100,解码器为128+256+784。权重乘积对称不意味着总参数数一样。
末层Sigmoid使每个重构像素处于0到1,输入像素因此通常也需按一致规则缩放到0到1。例如原像素255除255变1。若原始输入仍在0–255而输出至多1,损失会因尺度不匹配很大。
自测:编码器把784维压成100维,为什么decoder不直接取编码矩阵的逆?784→100通常不是可逆的一一映射,且网络含非线性、参数一般也不共享。它学习的是近似重构函数。
故障检测设定:先学正常关系,再看偏离程度
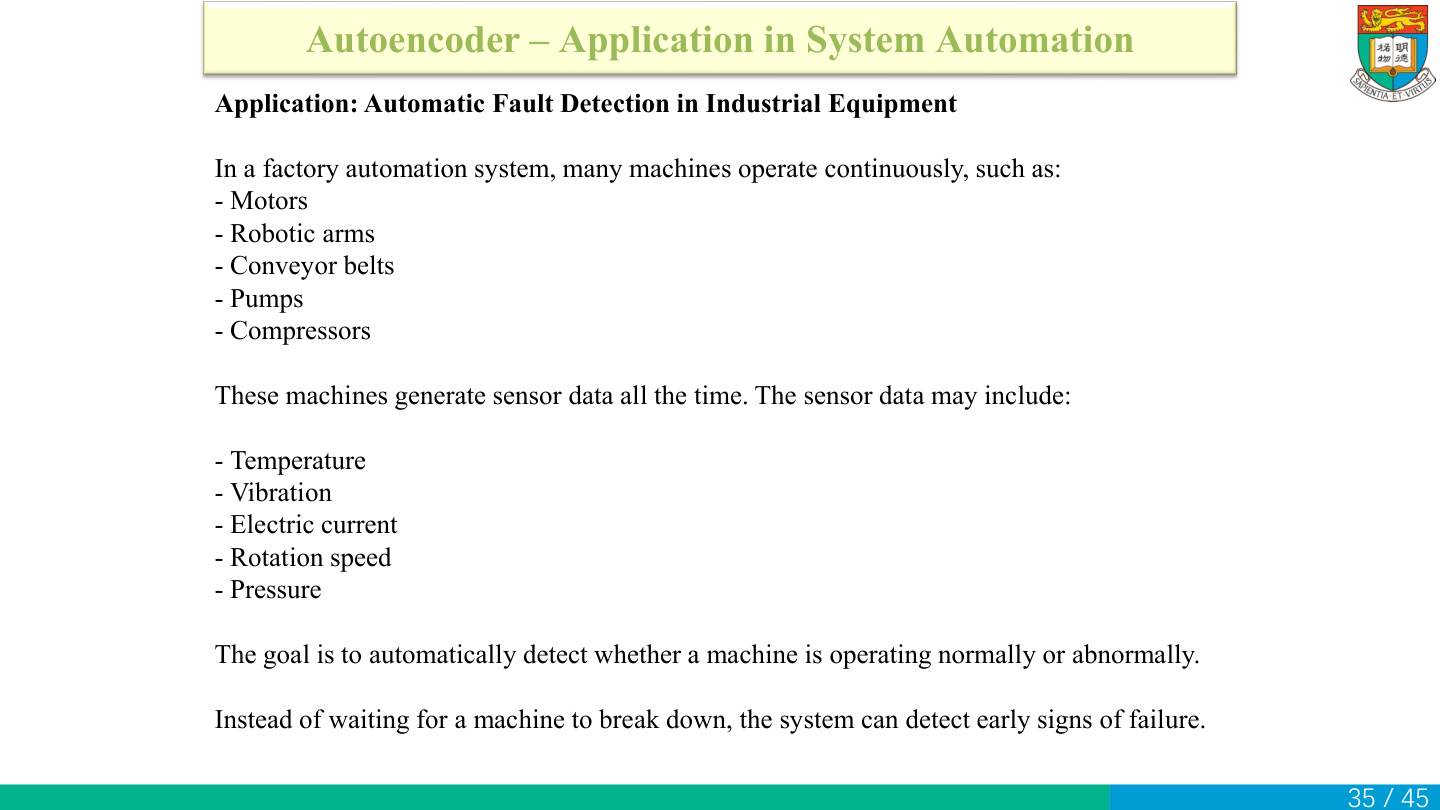
工业设备不断产生温度、振动、电流、转速、压力等数据。自编码器可用这些数据建立正常运行状态的模型。
这里先用正常运行数据训练。模型学会正常传感器组合的重构;运行时,将新输入与重构结果比较,用误差衡量它偏离正常模式的程度。
例子:正常高负载时电流和温度一起上升。若出现很高振动但电流与转速几乎不变,组合可能偏离训练见过的正常关系。模型看的是多个数一起是否协调,而不必只靠某一个传感器超过固定原始值。
本例每条样本是同一时刻的5维传感器向量。若要描述一段时间内的变化,可以将时间窗中的统计量或序列作为样本。
判断时使用重构误差:正常组合通常误差小,偏离已学模式的组合往往误差大。阈值将这种连续分数转成正常/异常判断。
五维传感器输入:单位不同,不能直接比较平方差
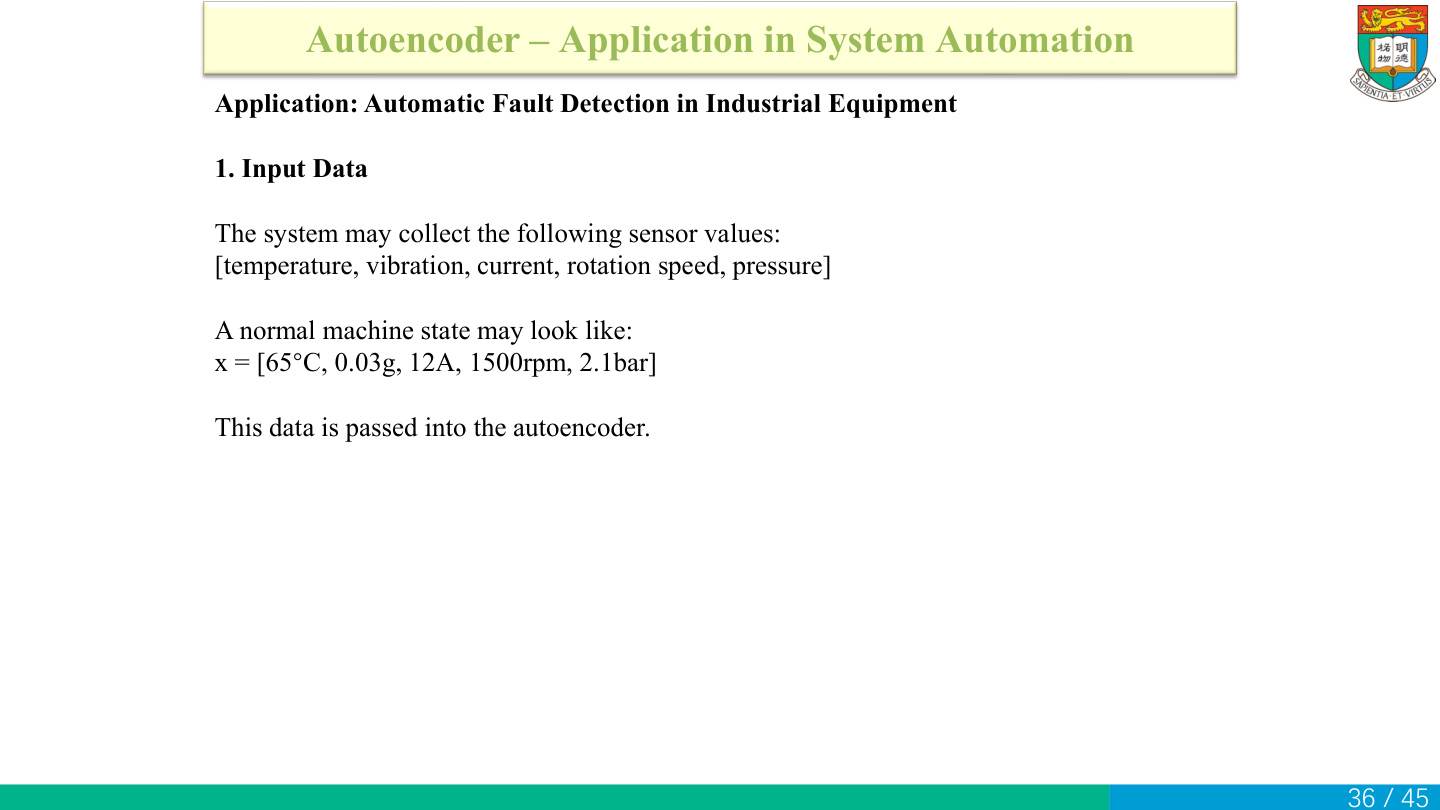
原向量为 [65°C,0.03g,12A,1500rpm,2.1bar],顺序固定为温度、振动、电流、转速、压力。一个样本有5维,不是五个彼此无关的训练样本;编码器利用同一时刻各维的组合关系。
原始单位差异很大。转速变化10rpm平方是100,振动变化0.02g平方仅0.0004,直接把原始差平方相加会被大数值尺度主导。并且不同物理单位的平方直接相加需要约定尺度,才能有一致解释。
标准化:只用训练正常数据估计每维均值μ_j与标准差s_j,变换 x'_j=(x_j−μ_j)/s_j。假设温度均值60、标准差5,则65变1;转速均值1400、标准差100,则1500也变1,表示它们各偏离一个标准差。其他维同理,不能整条向量只减同一个均值。
训练、验证、新输入都用训练时同一套μ和s。不要为每个测试样本重新算自己的均值和标准差,也不要用测试集重新拟合预处理。若某维训练标准差0,需要专门处理,不能直接除0。
自测:把输入第3维电流与第4维转速交换,数值仍能送进5维网络,结果会可靠吗?不会,因为权重按固定特征含义训练。维度相同不意味着语义顺序可互换。
正常数据训练:前向、比较、反向、冻结
本页流程为正常传感器x→编码成z→解码成x_rec→比较x与x_rec。训练时,每个正常样本既是输入,也是重构目标;没有外部“正常=0、故障=1”的分类标签也可以优化重构。
一次训练步骤:读取一批正常数据→按保存的均值和标准差缩放→计算z→计算x_rec→求重构损失→反向传播→更新编码器与解码器。下一批使用更新后的参数重复。
训练后固定网络,在正常验证数据上计算误差分布,用它选择异常阈值。
算一遍:标准化输入 [0,1],重构 [0.1,0.8],残差 [−0.1,0.2],平方和 0.01+0.04=0.05,两维平均误差为0.025。
自测:为什么中间设置较窄的瓶颈?让网络用有限的维度概括正常数据中的共同关系,再用这些关系重构输入。
阈值判定:误差先有明确单位与定义
设误差分数为E、异常阈值为τ。比较规则是:E>τ判异常,E≤τ未触发异常。训练、验证和运行时始终使用同一个误差公式。
例子:采用5维标准化输入的每维平均平方误差,某样本平方残差为 [0.01,0.09,0.04,0,0.01],和0.15,除5得E=0.03。若τ=0.02则超过阈值;若误把平方和0.15与按MSE标定的0.02相比,尺度不一致,判断会失真。
阈值可根据正常验证误差选择。例如100条正常样本中,希望最多约1条触发,可在误差排序后取接近第99百分位的位置。降低阈值更容易报警,提高阈值会让更多样本通过。
超过阈值后,系统可以报警、生成维护工单或执行预设停机规则。这里E是重构误差,它的数值表示偏差大小。
部署流程:从原始传感器到可追溯的判断
完整流程:读取传感器→按训练时的特征顺序排列→使用相同尺度变换→计算重构→计算误差E→比较阈值τ→输出状态或触发动作。
算一遍:一条5维样本的五项平方误差和为0.10,按维度平均得到 E=0.10/5=0.02。阈值为0.03,0.02≤0.03,因此本次未触发异常。
同时保存每一维的平方误差,可以看出本次分数主要来自哪项。例如振动贡献最大,就能定位“哪一个观测最偏离模型重构”。
自测:模型、阈值、标准化参数三者哪个需要保存?三个都需要。只保存权重却忘了特征尺度,无法稳定复现原判断。
参数题先画四层:784→256→64→256→784
点击图片放大。
这是新的计算题,潜在维度64,与前面的32或100不同。Encoder为784→256→64,Decoder为64→256→784。题目明确每层全连接都有权重与偏置,且没有说明权重共享,所以按四套独立Linear来数。
先把层写成清单,而不是只数图里的节点:第1层784输入、256输出;第2层256输入、64输出;第3层64输入、256输出;第4层256输入、784输出。激活函数若有Sigmoid,通常无额外可学习参数;输入本身784个像素也不是模型权重。
每个输出神经元都连接全部输入,故每输出需要m个权重,再加1个偏置;共有n个输出,参数为 n(m+1)=mn+n。例如小层3→2,每个输出有3个权重+1个偏置,两输出共8,而不是3+2=5。
可先独立算四项:784×256+256、256×64+64、64×256+256、256×784+784。下一页解释通式,再后两页展开数字。这里先写完整表达式,已能防止漏偏置或只数编码器。
自测:批大小32会把参数总数乘32吗?不会,样本共用同一模型。
全连接参数公式:为什么偏置数等于输出数
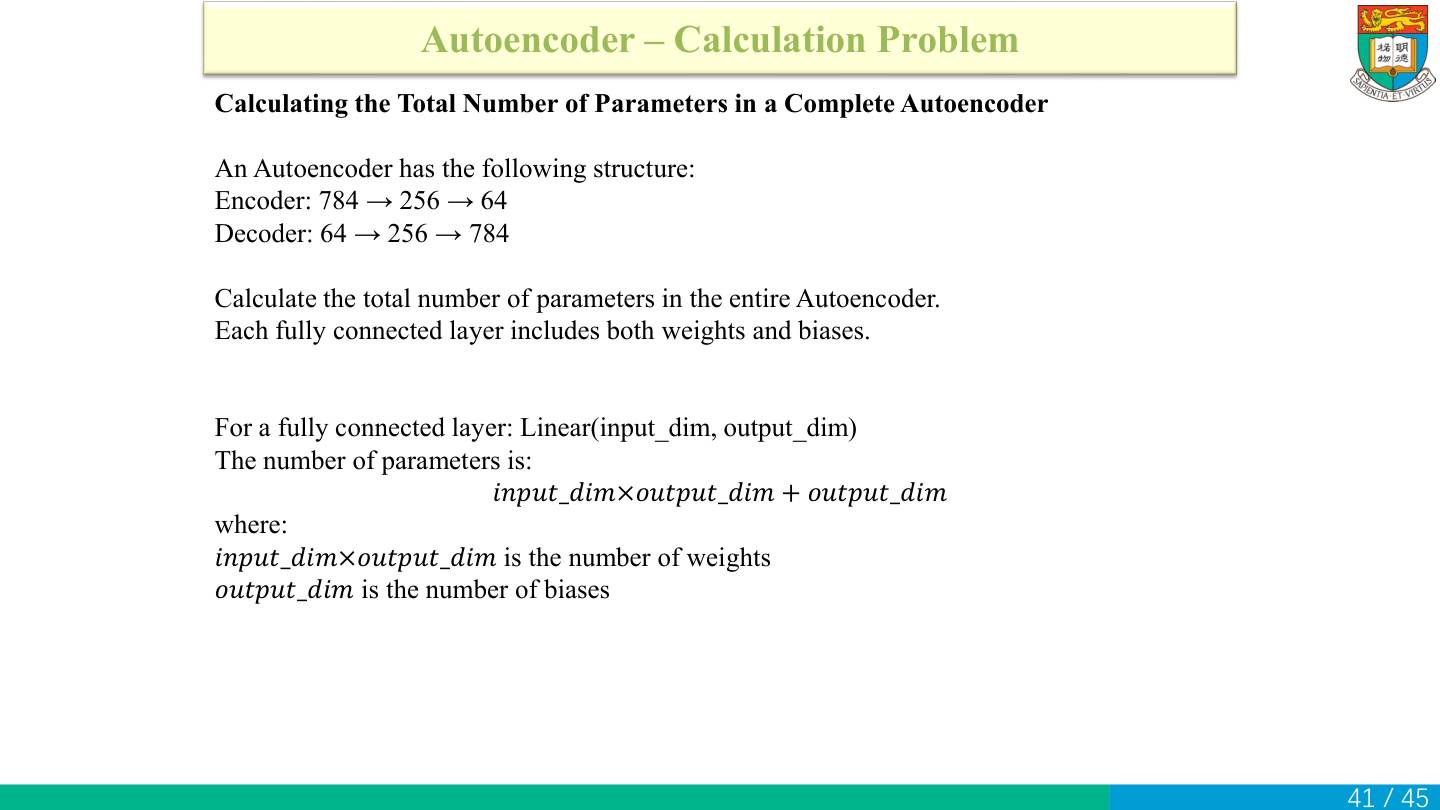
Linear(m,n)做 y_j=Σ_(i=1..m) W_ji x_i+b_j,j从1到n。对固定一个j,求和里有m个独立权重;n个j一共有mn个权重。每个输出j再有一个b_j,所以偏置n个,合计mn+n。
用3→2小层完全展开:y1=w11x1+w12x2+w13x3+b1;y2=w21x1+w22x2+w23x3+b2。六个w加两个b,共8。这里没有“每个输入再配一个偏置”的规则,偏置加在输出上。
矩阵W按列向量计算时是n×m。框架显示的权重排布可能采用相应转置,但元素总数mn不变。若题目特别写bias=False,才去掉+n;本题明确有偏置,不能省。
自测:64→256层为何偏置256而非64?因为它有256个输出,每个输出各加一个偏置。权重虽然与256→64层同为16384,偏置却不同。
编码器参数:乘法、偏置、合计逐步展开
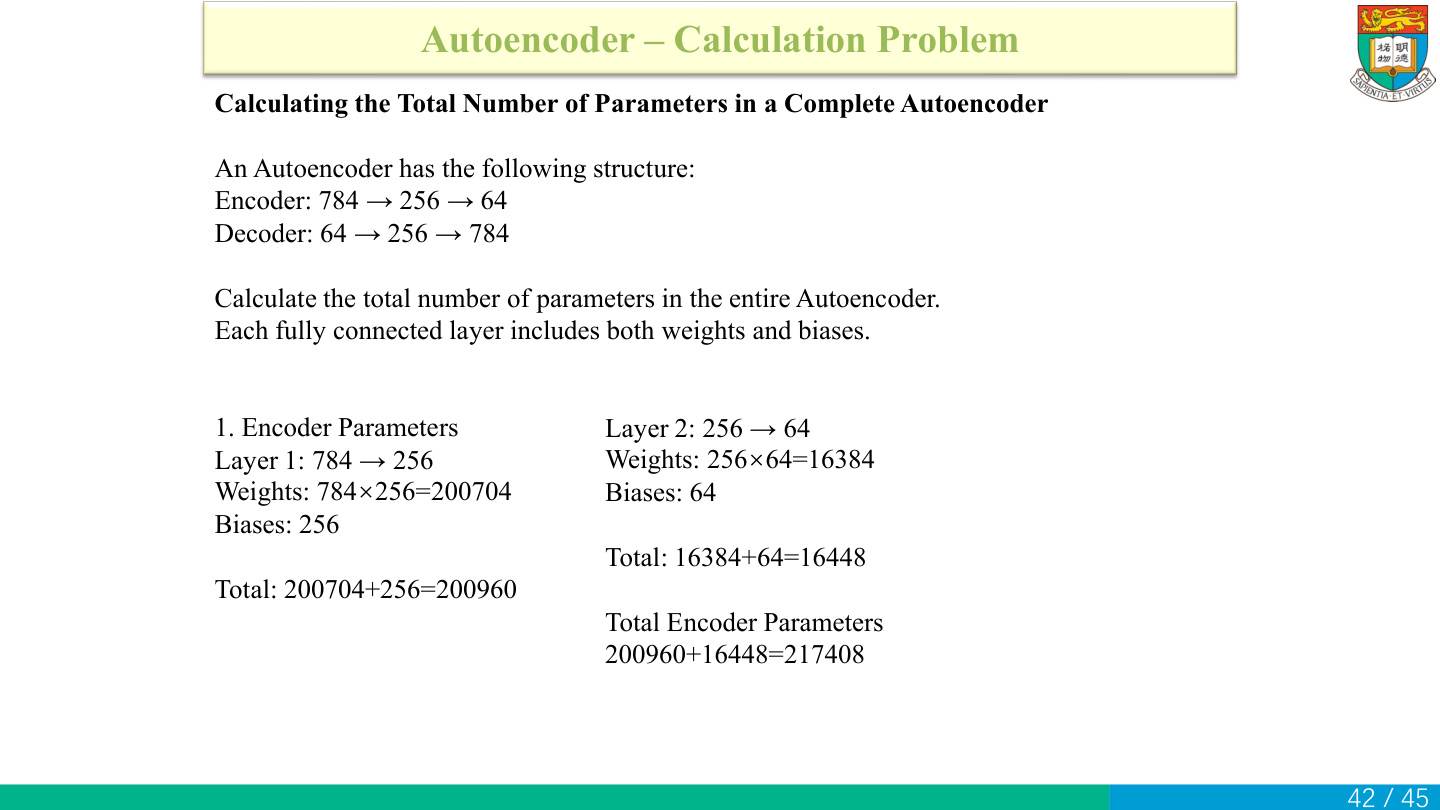
Encoder有两层:784→256与256→64。逐层算,不要因为看到对称网络就直接乘2。
第一层权重:784×256=784×(200+50+6)=156800+39200+4704=200704。每个256输出各一个偏置,再加256,得 200704+256=200960。
第二层权重:256×64=256×(60+4)=15360+1024=16384。输出64,所以偏置64,得 16384+64=16448。
编码器总数 200960+16448=217408。这里权重共 200704+16384=217088,偏置共 256+64=320,再相加也得到217408。用两种加法交叉检查,容易发现漏掉或多算偏置。
如果前向数据是一张784维图,经过第一层变256维,再经过第二层变64维。输出64只是潜在激活数量,不能说“编码器只有64参数”;217408个参数定义了把所有可能输入变成64维的映射。
自测:若只把第一层bias关闭,编码器参数减少多少?256,得到217152;不是减少784,也不是把整个网络的偏置都删掉。原页217408与这里逐项计算一致。
解码器与总参数:对称权重不等于总数相等
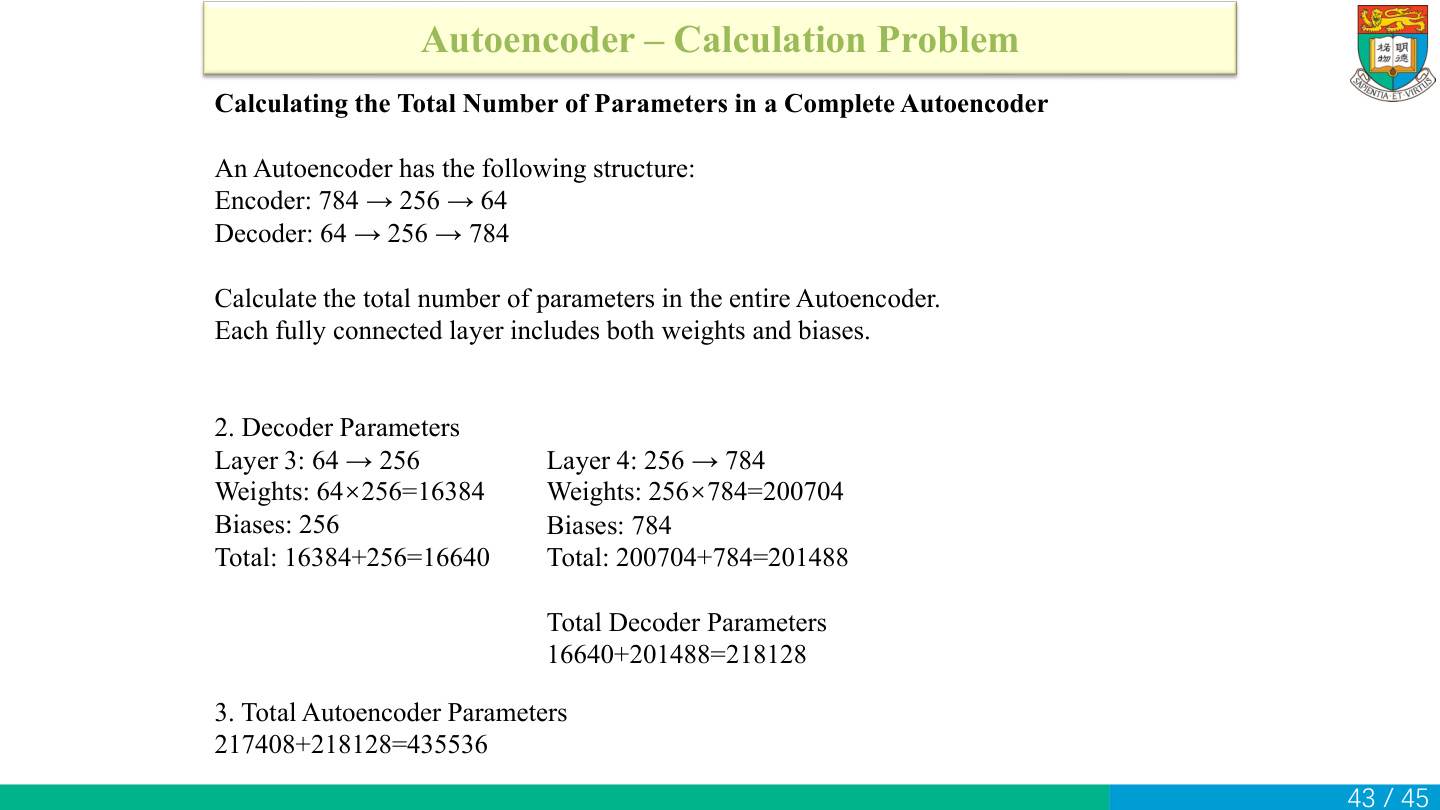
Decoder第一层64→256:权重 64×256=16384,输出256个偏置,合计16640。第二层256→784:权重 256×784=200704,偏置784,合计201488。
解码器合计 16640+201488=218128。与编码器217408相加:217408+218128=435536,这才是整个网络答案。
再用全网拆分复核:四层权重和 200704+16384+16384+200704=434176;偏置和 256+64+256+784=1360;总计 434176+1360=435536。两种算法一致。
为何decoder比encoder多720?两侧权重总数相同;encoder偏置320,decoder偏置1040,差 1040−320=720。如果把编码器总数直接乘2,只得434816,恰少720。图看起来对称并不能略过这一步。
本题四层权重独立,每个输出节点都有偏置;Sigmoid没有额外可学习参数,因此总数由这四个Linear层决定。
自测:只问decoder时答多少?218128;问整个AE时答435536;只问权重、不含偏置则434176。答题先圈出问法。
本讲回顾
贝叶斯网络把联合概率拆成局部条件概率,贝叶斯公式用证据更新概率。自编码器走 x→z→x_hat,用重构误差训练;全连接层参数数为“输入维×输出维+输出维”。
结束
本讲结束。接着做Tutorial,练习AE参数、CNN乘加、k-means更新、感知机和KNN。