左右键翻页;“连续阅读”展开整份;搜索可定位概念。
Q1全题面:从八个传感器到异常告警,完整走一遍
动手试试 · 调节阈值,比较重构误差
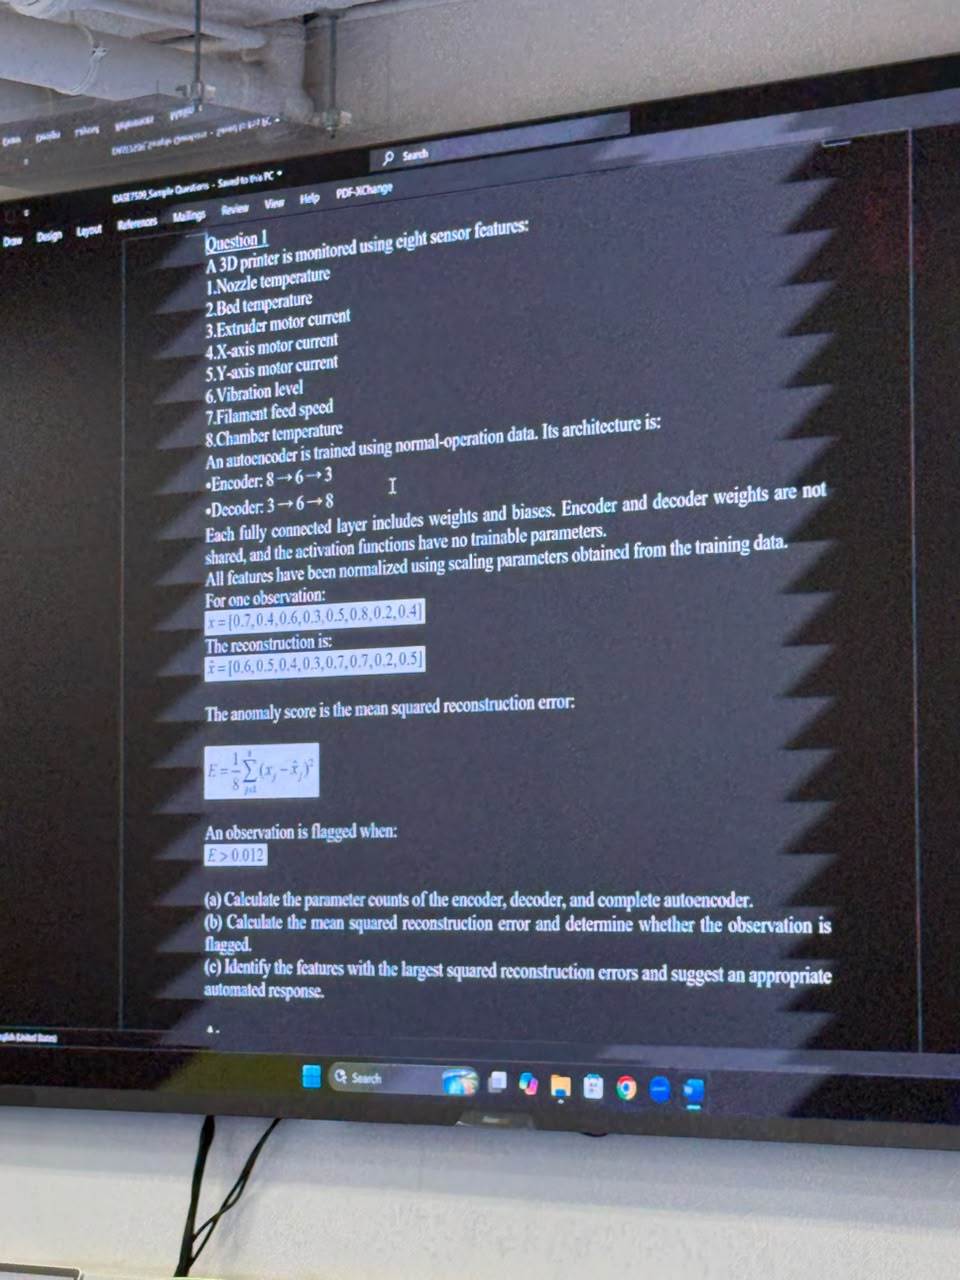
3D打印机八项归一化特征依次为喷嘴温度、热床温度、挤出机电机电流、X轴电流、Y轴电流、振动、耗材进给速度、腔体温度。正常数据训练的全连接自编码器为8→6→3→6→8,权重不共享,每层含bias,激活没有可训练参数。
先算(a)参数。输入m、输出n的全连接层,每个输出都看m个输入,因此权重mn个,每个输出另有1个偏置,合计mn+n。8→6:48+6=54;6→3:18+3=21,编码器54+21=75。3→6:18+6=24;6→8:48+8=56,解码器24+56=80。总数75+80=155。不是8+6+3+6+8,也不能因两半对称就把独立权重少算一半。
再算(b)重构误差。输入x=(0.7,0.4,0.6,0.3,0.5,0.8,0.2,0.4),重构x̂=(0.6,0.5,0.4,0.3,0.7,0.7,0.2,0.5)。按相同顺序相减,得(0.1,−0.1,0.2,0,−0.2,0.1,0,−0.1);各项平方为(0.01,0.01,0.04,0,0.04,0.01,0,0.01)。先加0.01+0.01=0.02,再加0.04=0.06,再加0.04=0.10,再加两项0.01=0.12;均值E=0.12/8=0.015。题面规定E>0.012才标记,0.015大于0.012,因此标记为可能异常。
最后(c)定位贡献。第3、5项各0.04,并列最大,分别对应挤出机电流与Y轴电流。合计贡献(0.04+0.04)/0.12=2/3≈66.67%。根据这两项的贡献,产生告警并优先检查挤出机与Y轴驱动系统。重构误差指出偏离正常关系的信号,故障原因还需结合设备检查判断。
本题特征已用训练数据得到的缩放参数归一化,不要再按当前一条观测重新缩放。
Q1题面近照:读清模型条件、向量与严格阈值
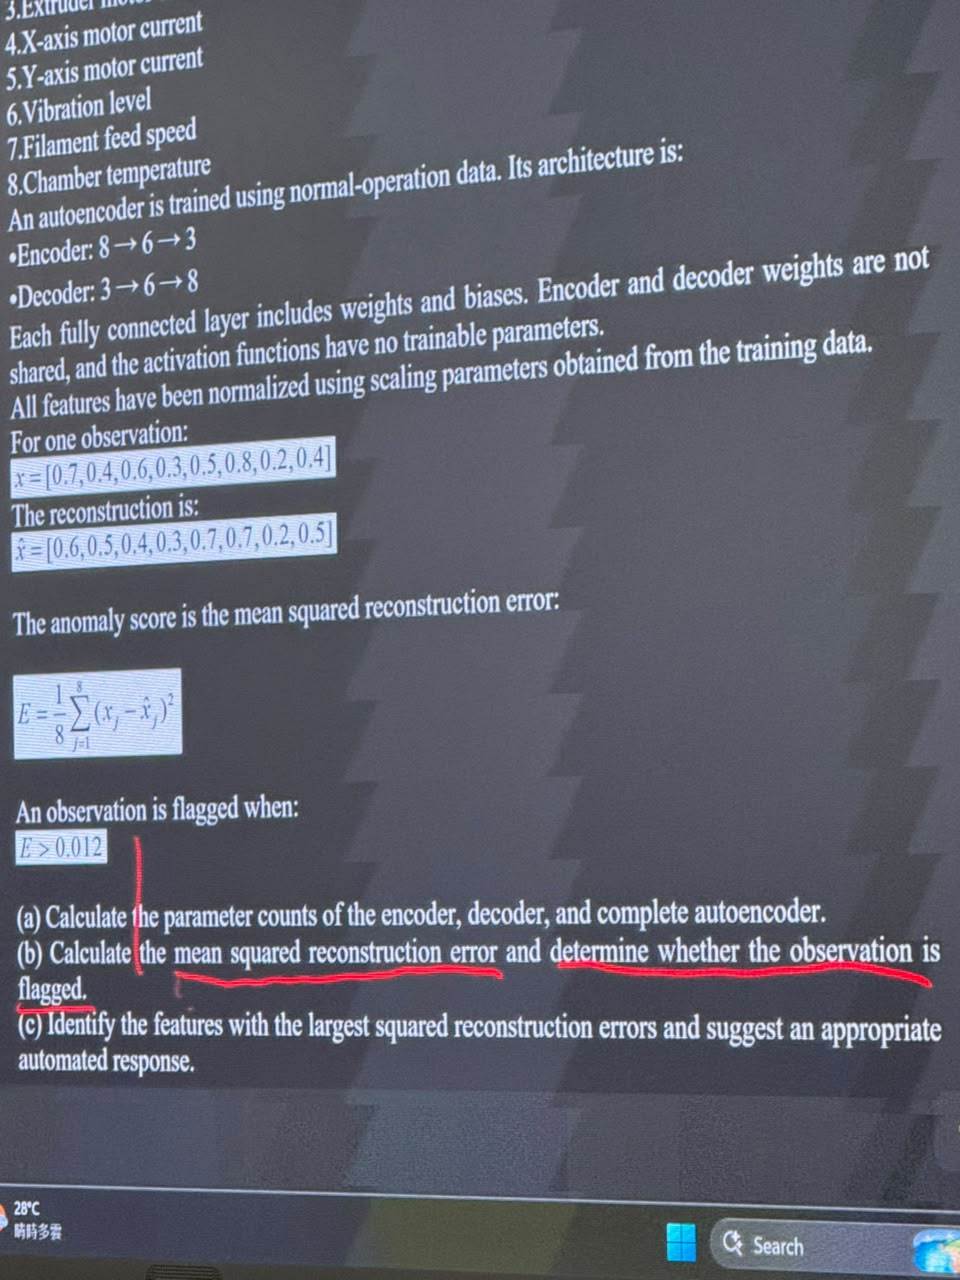
先逐条读条件:全连接层有权重和偏置;编码器与解码器不共享权重;激活函数没有可训练参数;特征的归一化参数来自训练数据。
模型8→6→3表示一条8维观测先变6维,再变3维。3 维表示中的每一项都可以由全部 8 个输入共同决定。解码器再从 3 维恢复到 8 维。比如输出的第 3 项,要与输入的第 3 项挤出机电流对齐后相减。
公式 E=(1/8)Σ_j(x_j−x̂_j)² 应从括号开始算:先逐维相减,再平方,再求和,最后除8。把 Σ差值 先合并再平方,会让正负误差抵消,已经变成另一种量。本题差值含0.1与−0.1,平方后都贡献0.01。
题面阈值是 E>0.012,不是大于等于。如果恰好0.012,按此规则不标记;实际0.015所以标记。参数总数155、E=0.015是两项不同答案,不能把模型参数当作除数。
Q1(a)投影解答:每一层为什么都要另加偏置
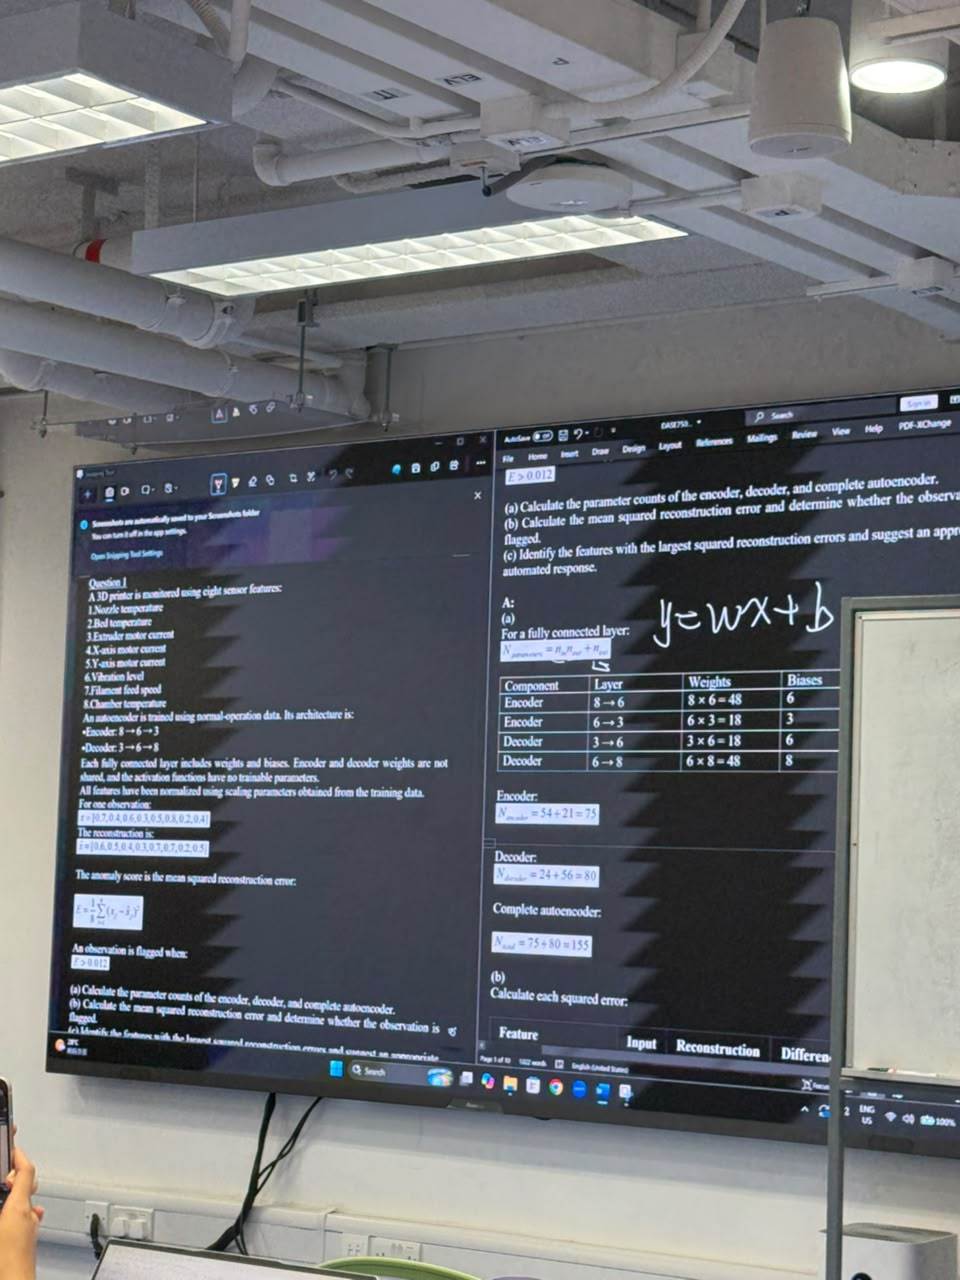
全连接层计算 y=Wx+b。以8→6为例,W 有6行,每行对应一个输出。第1个输出为 y₁ = W₁₁x₁ + W₁₂x₂ + … + W₁₈x₈ + b₁,这一行用8个权重和1个偏置。x 有8项,Wx 有6项,与6项偏置 b 一一对齐再相加。
| 位置 | 输入→输出 | W 的形状 | 权重数 | 偏置数 | 参数数 |
|---|---|---|---|---|---|
| 编码器第1层 | 8→6 | 6×8 | 48 | 6 | 54 |
| 编码器第2层 | 6→3 | 3×6 | 18 | 3 | 21 |
| 解码器第1层 | 3→6 | 6×3 | 18 | 6 | 24 |
| 解码器第2层 | 6→8 | 8×6 | 48 | 8 | 56 |
编码器 54+21=75,解码器 24+56=80,合计 75+80=155。两处48来自不同的权重矩阵,各算一遍。激活只变换当前输出值,可训练参数数为0。
Q1(b)误差表:八行每一行都算清
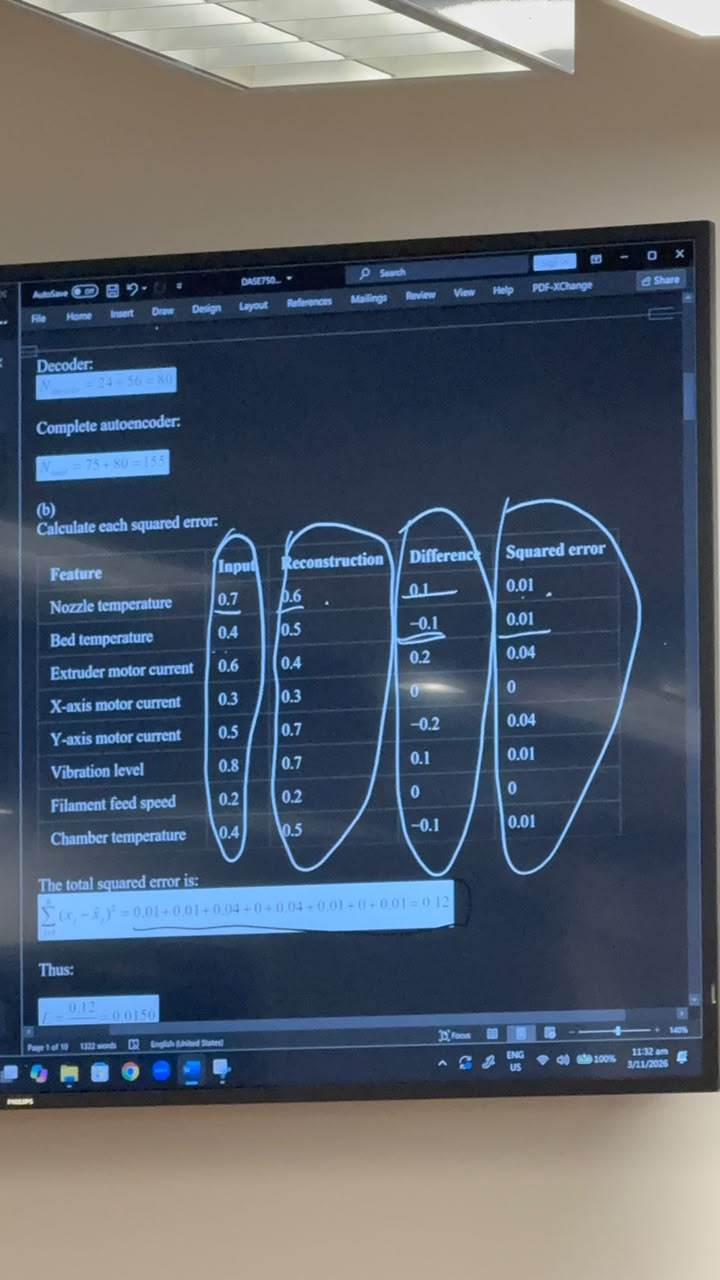
按“输入→重构→差值→平方误差”逐行计算:
| 特征 | 输入−重构 | 平方误差 |
|---|---|---|
| 喷嘴温度 | 0.7−0.6=0.1 | 0.01 |
| 热床温度 | 0.4−0.5=−0.1 | 0.01 |
| 挤出机电流 | 0.6−0.4=0.2 | 0.04 |
| X轴电流 | 0.3−0.3=0 | 0 |
| Y轴电流 | 0.5−0.7=−0.2 | 0.04 |
| 振动 | 0.8−0.7=0.1 | 0.01 |
| 耗材速度 | 0.2−0.2=0 | 0 |
| 腔体温度 | 0.4−0.5=−0.1 | 0.01 |
负数平方变正,因为(−0.2)×(−0.2)=0.04;平方误差不会相互抵消。把最后一列相加:四个0.01共0.04,两个0.04共0.08,再加两个0,合计0.12。之后还要除以8,得到均方误差0.015。
表中数值已经归一化,各通道才有较可比的尺度。不要把第3项和第5项的0.04解释成原单位的0.04安培,它们是归一化差值的平方。
Q1(b,c)判异常:0.12是总和,0.015才是分数
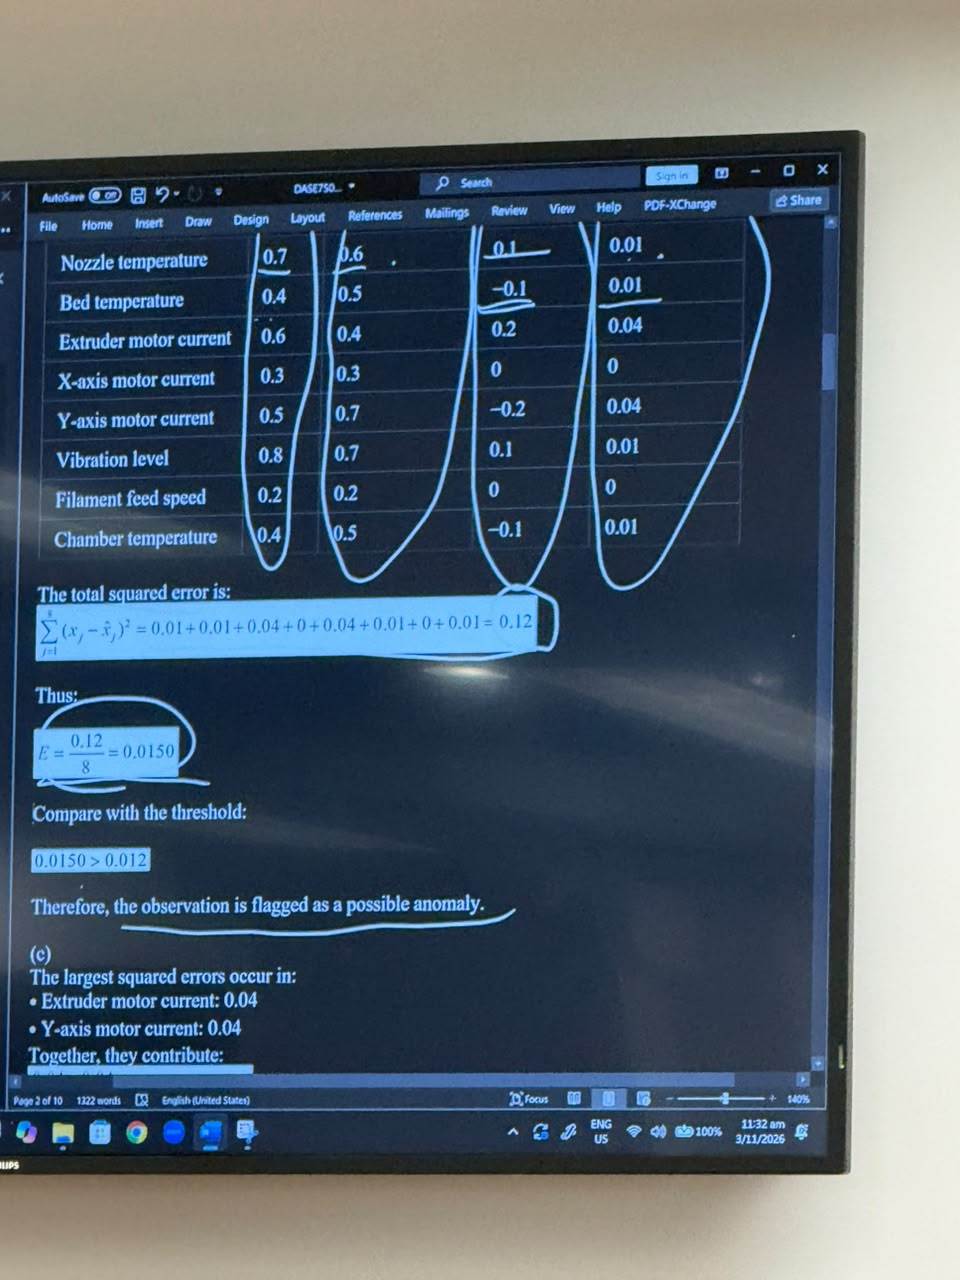
先把八项平方误差相加:0.01+0.01+0.04+0+0.04+0.01+0+0.01=0.12。
题目用的是均方重构误差,八项求和后除8:E=0.12/8=0.0150。0.12是八项的总和;0.015是每项的平均。阈值0.012针对E,所以必须拿0.015去比较,不能随意换成0.12。
0.0150 > 0.012 成立,因此标记为可能异常。把比较式两边同时乘8,也可在平方误差总和的尺度上检查:0.12 > 8×0.012 = 0.096。两种写法的判断相同。
逐维最大的两项都是0.04:挤出机电机电流、Y轴电机电流。并列第一时,两项都应写出,不可只选先看到的那项。标记表示当前传感器组合偏离了模型学到的正常关系,需要进一步检查。
Q1(c)误差贡献与响应:为什么是66.67%
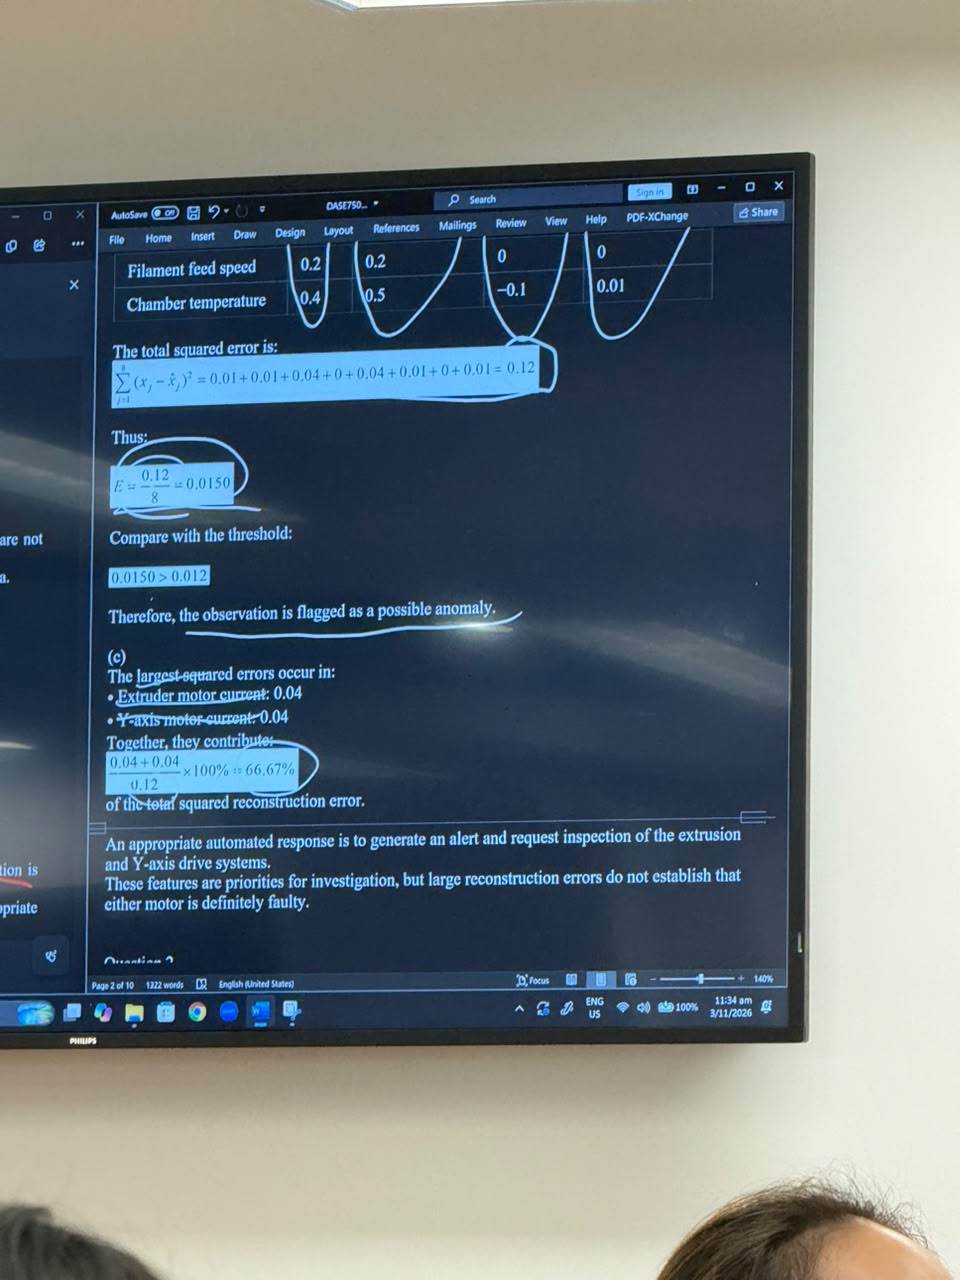
异常检测的计算链是:误差总和0.12→平均0.015→大于0.012→请求进一步检查。
最大项为挤出机电流0.04、Y轴电流0.04,合计0.08。贡献比例必须用“这两项误差之和/全部误差之和”:0.08/0.12=8/12=2/3≈0.66667,转百分比约66.67%。不能用0.08/0.015,因为分子是总和、分母却已除8,尺度不一致。
若用平均量也可算,但两项先分别除8:各0.005,总0.01;再除总体均值0.015,仍是2/3。这个检查能帮助发现分母用错。
告警可附上这条观测的 E=0.015、阈值 0.012、第3和第5项各 0.04,让维护人员优先检查挤出机与Y轴驱动系统。异常分数提供排查线索,实际原因由设备检查确认。
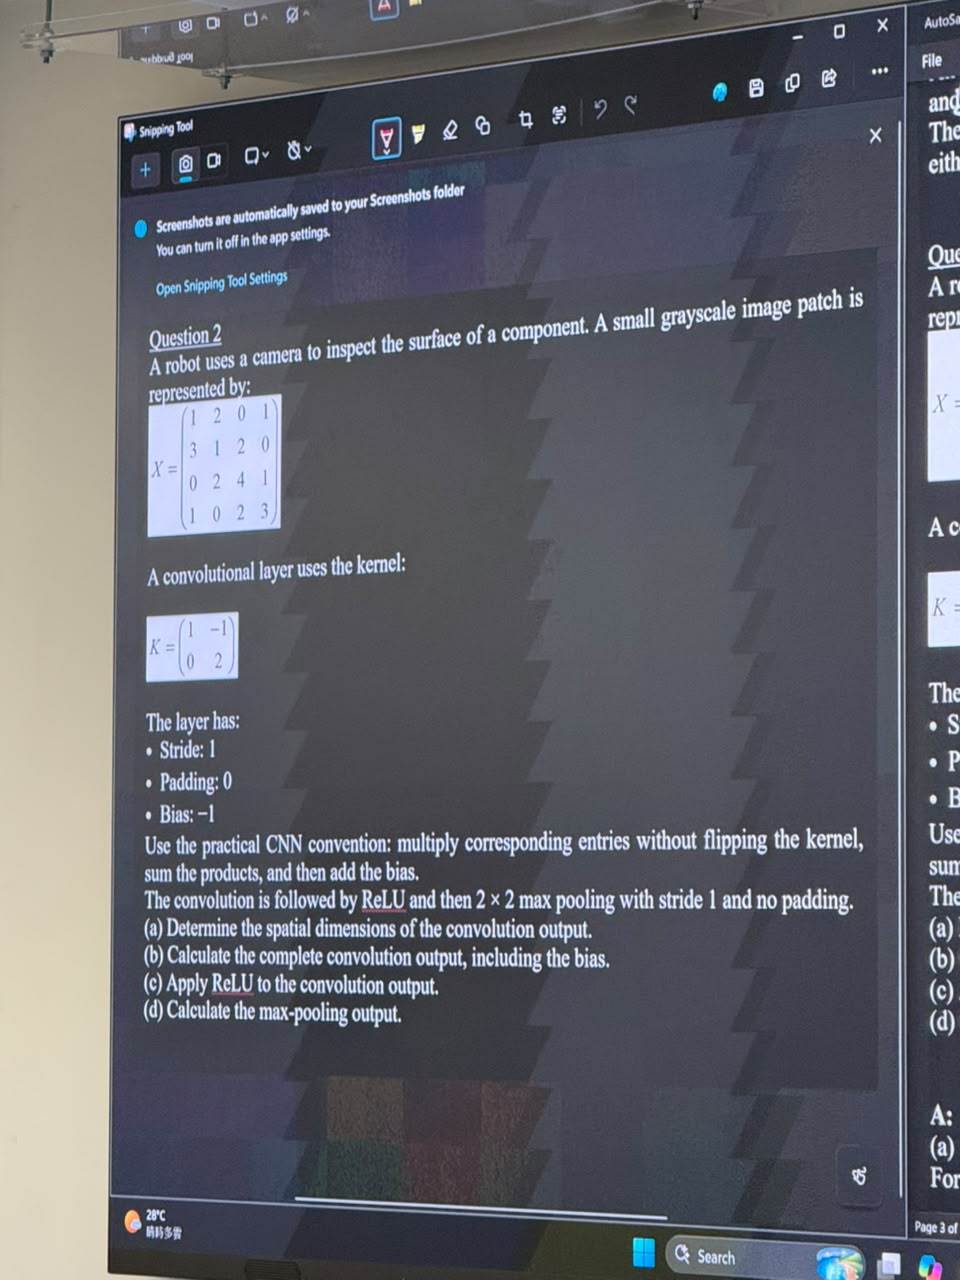
Q2全题面:卷积九格、ReLU和四格池化完整手算
动手试试 · 逐格做卷积、ReLU和池化
本题输入X和核K为:
X = 1 2 0 1      K =  1 -1
    3 1 2 0           0  2
    0 2 4 1
    1 0 2 3
卷积stride=1、padding=0、bias=−1。题面明确按CNN惯例不翻核。之后做ReLU,再做2×2、stride=1、无padding的最大池化。
(a)每边输出 floor((4+2×0−2)/1)+1=3,所以是3×3。窗口左上角能放在第1、2、3行与第1、2、3列,共9个位置。
(b)以下下标从1开始,每格都对应“图块四项乘核,再加−1”:
Y11=1×1+2×(-1)+3×0+1×2-1=0
Y12=2×1+0×(-1)+1×0+2×2-1=5
Y13=0×1+1×(-1)+2×0+0×2-1=-2
Y21=3×1+1×(-1)+0×0+2×2-1=5
Y22=1×1+2×(-1)+2×0+4×2-1=6
Y23=2×1+0×(-1)+4×0+1×2-1=3
Y31=0×1+2×(-1)+1×0+0×2-1=-3
Y32=2×1+4×(-1)+0×0+2×2-1=1
Y33=4×1+1×(-1)+2×0+3×2-1=8
因此Y=[[0,5,−2],[5,6,3],[−3,1,8]]。每一格都要加一次bias,不是最后整张图只减1。
(c) ReLU 在每个位置计算 max(0,Y),只把−2、−3改为0。位置和尺寸保留,R=[[0,5,0],[5,6,3],[0,1,8]]。
(d)池化每边 (3−2)/1+1=2,四窗口分别取max(0,5,5,6)=6、max(5,0,6,3)=6、max(5,6,0,1)=6、max(6,3,1,8)=8,输出P=[[6,6],[6,8]]。stride=1使窗口重叠,不能照搬Lab里stride=2的例子。
Q2滑窗板书:为什么只有3×3个合法位置
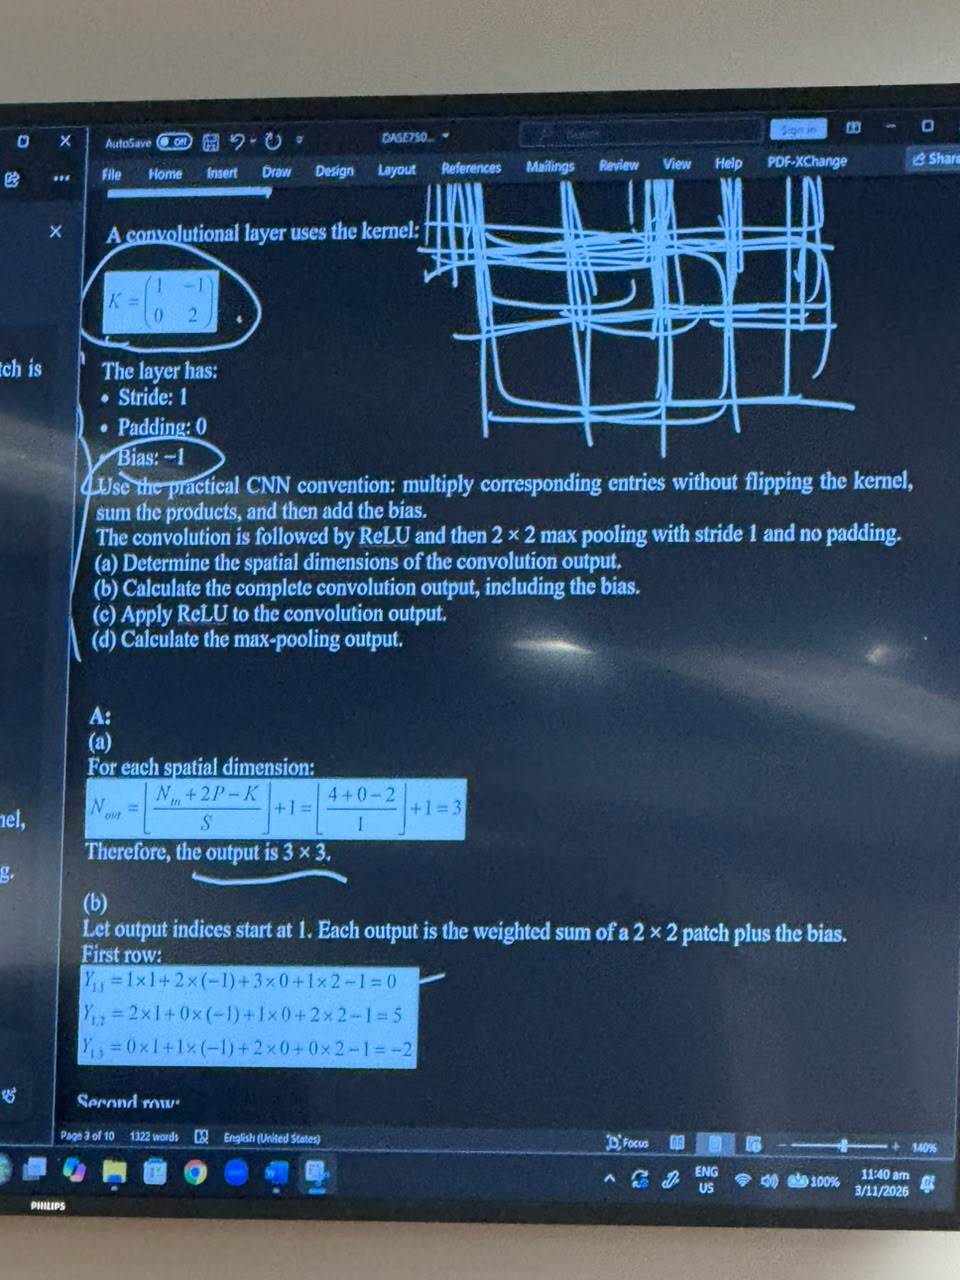
把核看成一个在网格上移动的2×2小窗口。输入边长N=4,核边长K=2,无填充P=0,每步S=1。
先想横向:核左边可以放在输入第1列,覆盖1–2列;放第2列,覆盖2–3列;放第3列,覆盖3–4列;若放第4列,会需要不存在的第5列,不能再放。因此恰有3个横向位置。纵向同理3个,合计9个输出。
一般情况下,补边后的长度是 N+2P。用从0开始的下标,窗口的最后一个合法起点是 N+2P−K。令 t 为已移动次数,窗口起点是 tS,须满足 tS ≤ N+2P−K。最多能移动 floor((N+2P−K)/S) 次,加1计入起点0。这题是 floor((4+2×0−2)/1)+1=3。
左上图块为[[1,2],[3,1]],按K=[[1,−1],[0,2]]逐项相乘,1−2+0+2−1=0。向右一格换成[[2,0],[1,2]],2+0+0+4−1=5。再向右是[[0,1],[2,0]],0−1+0+0−1=−2。
核保持原方向,每个输出加bias=−1;padding=0,输入周围不补格子。
Q2(a,b)九个输出:逐行检查核、输入与偏置
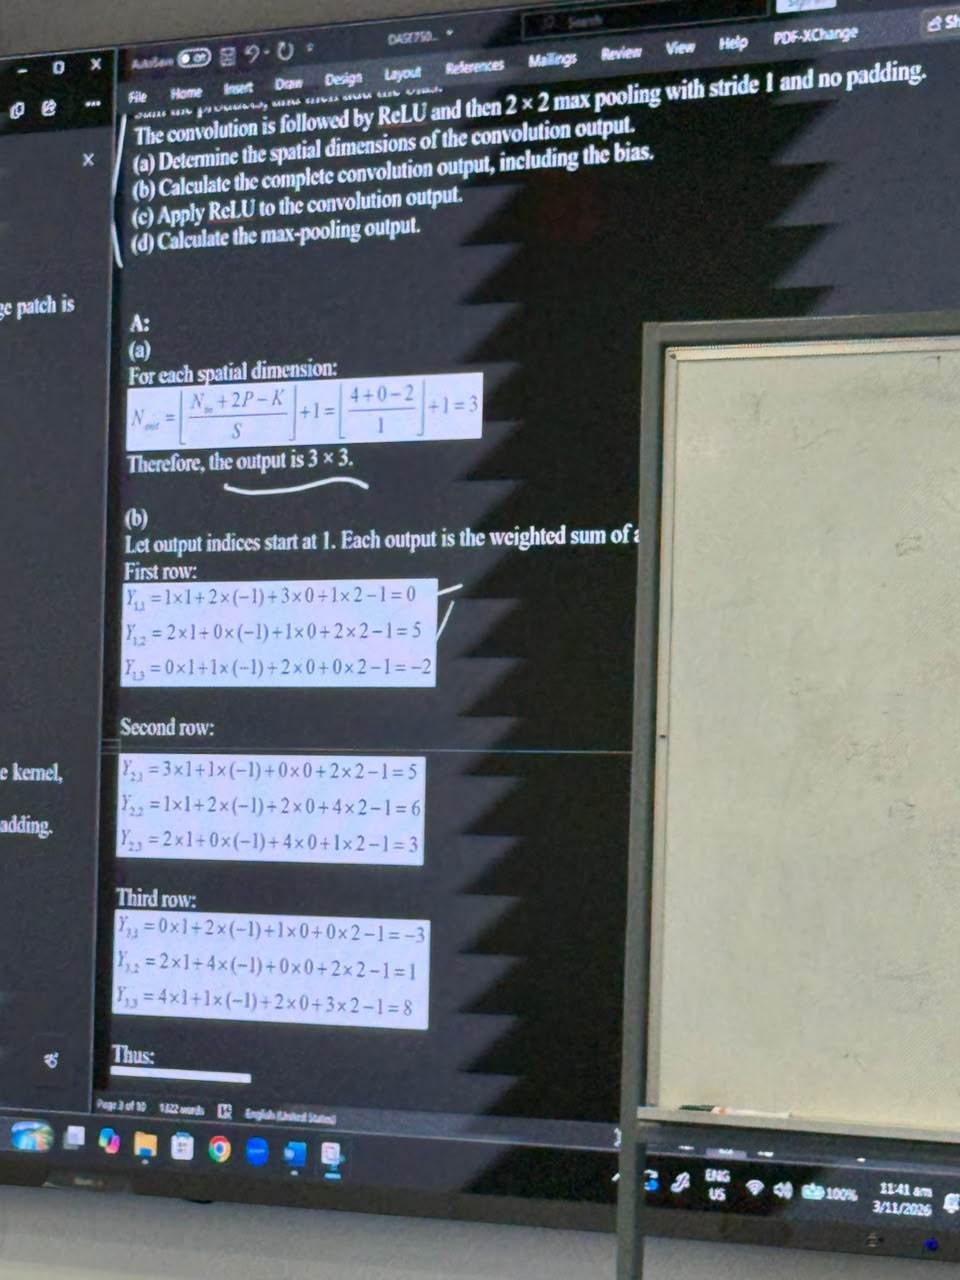
逐行计算3×3的卷积输出。核固定K=[[1,−1],[0,2]],所以每个2×2图块[[a,b],[c,d]]输出可简写 a−b+2d−1;c乘0,仍应知道它的位置。
第一行窗口依次为[[1,2],[3,1]]、[[2,0],[1,2]]、[[0,1],[2,0]],算得1−2+2−1=0;2−0+4−1=5;0−1+0−1=−2。
第二行从输入第2行开始:[[3,1],[0,2]]给3−1+4−1=5;[[1,2],[2,4]]给1−2+8−1=6;[[2,0],[4,1]]给2−0+2−1=3。
第三行从输入第3行开始:[[0,2],[1,0]]给0−2+0−1=−3;[[2,4],[0,2]]给2−4+4−1=1;[[4,1],[2,3]]给4−1+6−1=8。
按空间位置排列得到 [[0,5,−2],[5,6,3],[−3,1,8]]。下标从1起时 Y₂₃ 的2、3也是输入窗口左上角的行号、列号,覆盖输入2–3行、3–4列。
Q2(b,c)卷积到ReLU:负值置零,正值原样保留
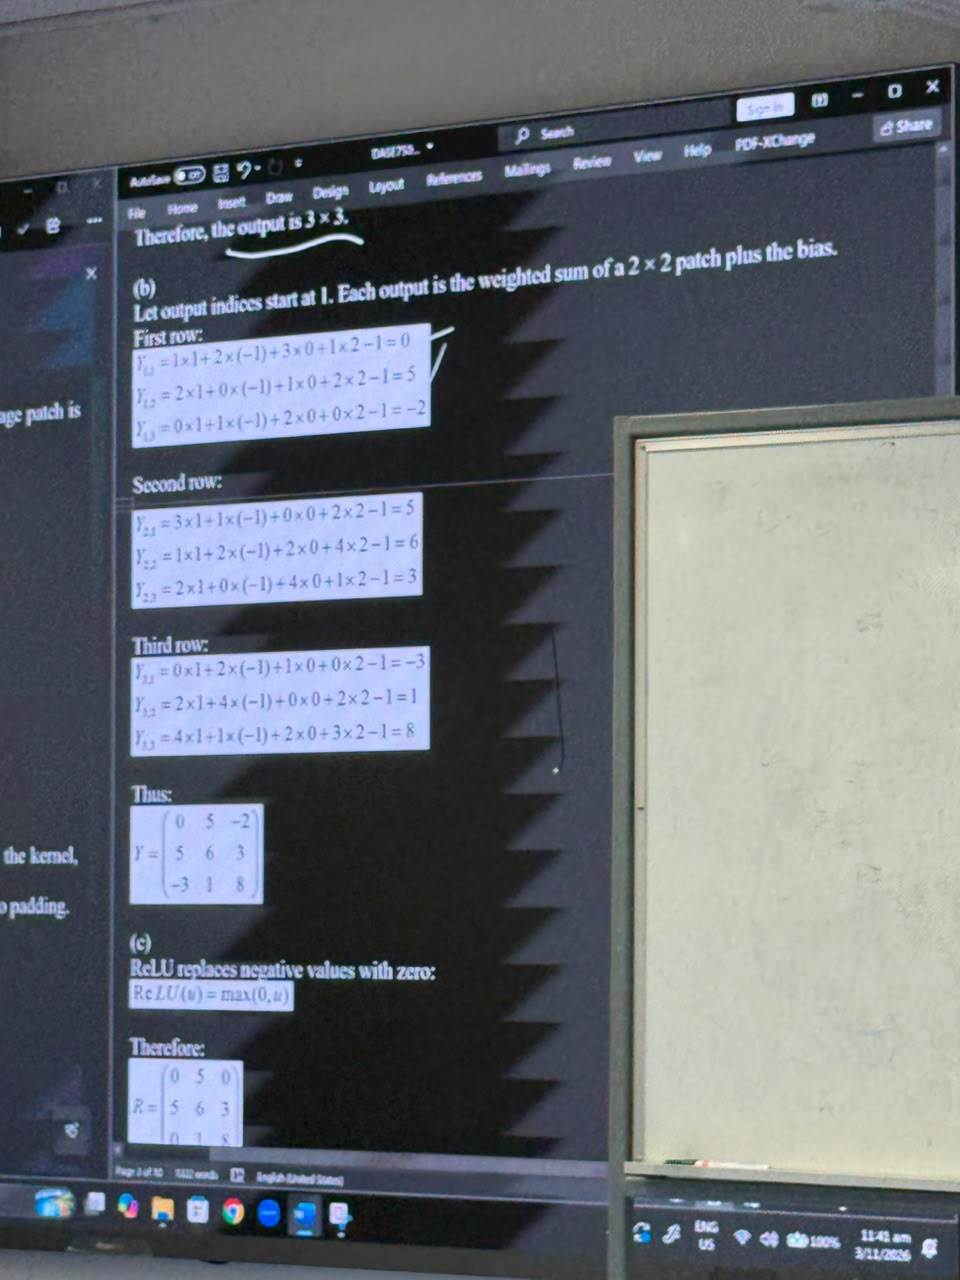
卷积输出按行排列为:第一行0、5、−2;第二行5、6、3;第三行−3、1、8。
ReLU规则是 Rij=max(0,Yij),针对每个元素单独计算。第一行max(0,0)=0、max(0,5)=5、max(0,−2)=0;第二行5、6、3都大于0,保持;第三行−3变0,1与8保持。因此R=[[0,5,0],[5,6,3],[0,1,8]]。
把 −2 与 0 比较会得到 0,而 abs(−2) 会得到 2。ReLU 对9个位置分别比较一次,所以尺寸保持3×3。
卷积bias已经在Y里加过,ReLU不需要再减1。后续池化应以R为输入,而非重新回到原图X。两次操作的职责不同:卷积作加权局部计算,ReLU作非线性截断,池化才汇总邻域。
Q2(c,d)池化:stride=1的窗口为什么互相重叠
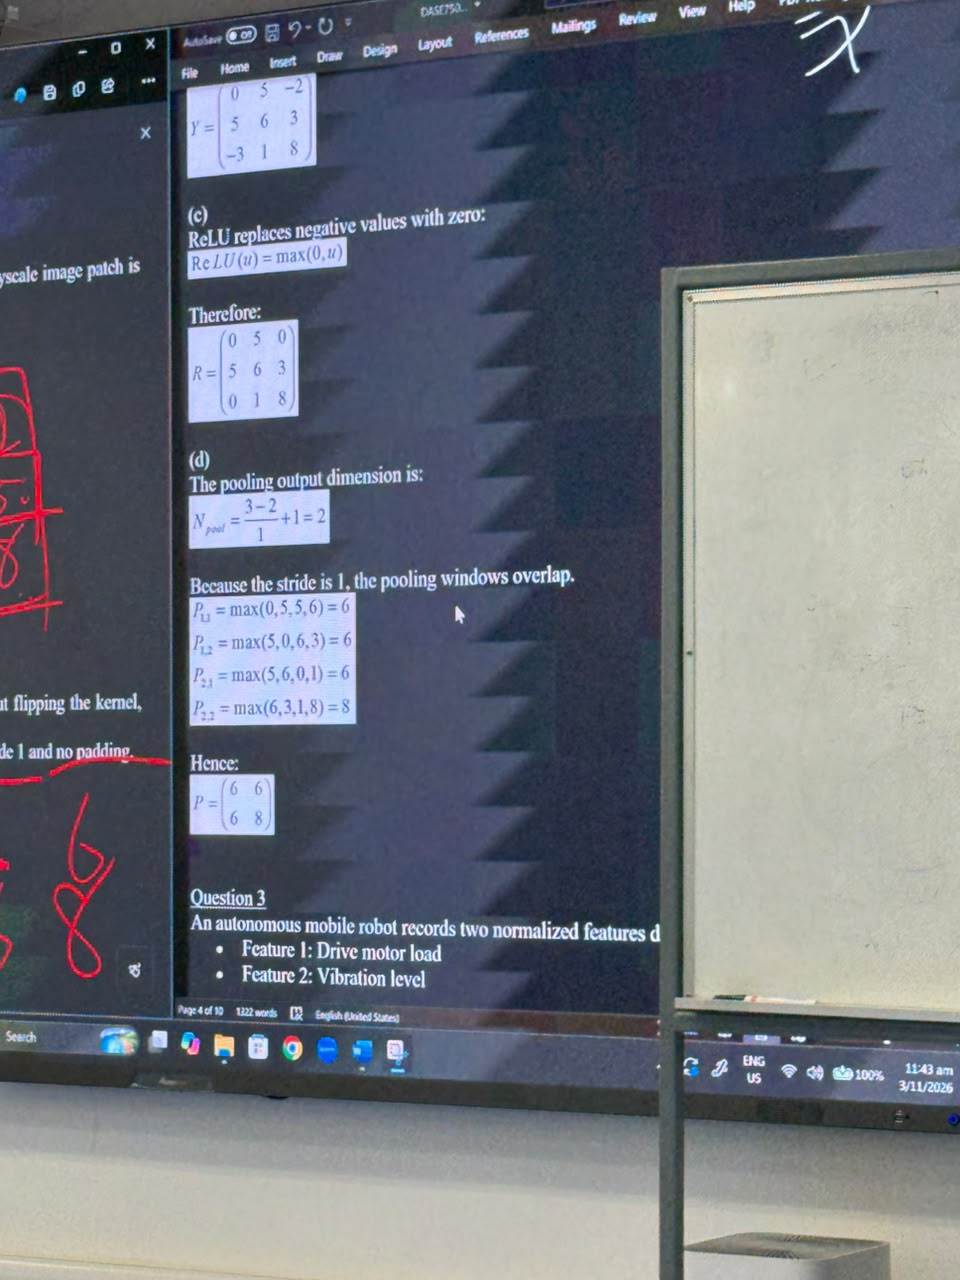
池化的输入是ReLU结果R=[[0,5,0],[5,6,3],[0,1,8]]。2×2窗口放在3×3输入上,stride=1,因此横向有(3−2)/1+1=2个位置,纵向也2个,输出为2×2。
每个窗口的最大值填到输出中与窗口左上角对应的位置,行列从1数起。
| 窗口位置 | 覆盖的行与列 | 按行读出的四个值 | 输出 |
|---|---|---|---|
| 左上 | 1–2行、1–2列 | 0、5、5、6 | 6 |
| 右上 | 1–2行、2–3列 | 5、0、6、3 | 6 |
| 左下 | 2–3行、1–2列 | 5、6、0、1 | 6 |
| 右下 | 2–3行、2–3列 | 6、3、1、8 | 8 |
按位置写P=[[6,6],[6,8]]。输入中心位置 (2,2) 的6出现在四个窗口中,在前三个窗口里取得最大值。
如果误用stride=2,本输入边长只够放1个不越界窗口,就会得到1×1结果,与题面不同。也不能把四个窗口的最大值再平均,因为题目要求的是最大池化图。
Q3全题面:两轮k-means、稳定性与最终目标完整计算
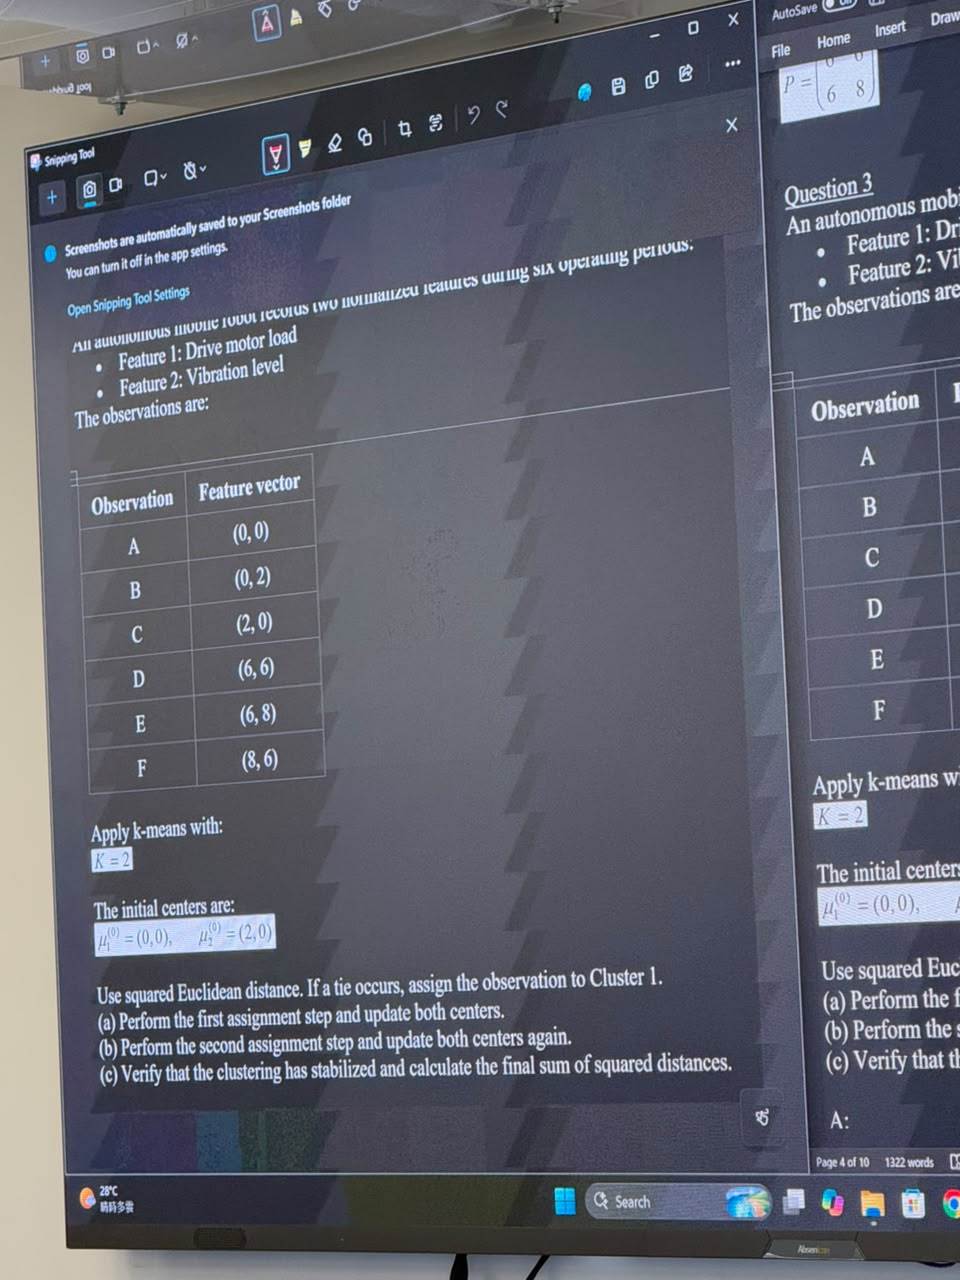
题目用六段机器人运行数据,每点有驱动电机负载、振动两个特征:A=(0,0)、B=(0,2)、C=(2,0)、D=(6,6)、E=(6,8)、F=(8,6)。K=2,初始中心μ1=(0,0)、μ2=(2,0)。对点 x=(x₁,x₂) 与第 k 个中心 μₖ=(aₖ,bₖ),平方欧氏距离为 d²(x,μₖ)=(x₁−aₖ)²+(x₂−bₖ)²。k 取1或2,在对应列填距离。两中心等距时归簇1。
第一轮先全部分配,再更新。到初始两中心的距离对依次是A(0,4)、B(4,8)、C(4,0)、D(72,52)、E(100,80)、F(100,72)。每对挑小的,所以簇1={A,B},簇2={C,D,E,F}。μ1=((0+0)/2,(0+2)/2)=(0,1);μ2=((2+6+6+8)/4,(0+6+8+6)/4)=(5.5,5)。
第二轮用新中心重新比较。A到两中心(1,55.25),B(1,39.25),C(5,37.25),D(61,1.25),E(85,9.25),F(89,7.25)。因此C由簇2移到簇1,得{A,B,C}及{D,E,F}。中心更新为((0+0+2)/3,(0+2+0)/3)=(2/3,2/3),以及((6+6+8)/3,(6+8+6)/3)=(20/3,20/3)。
第三次分配检查稳定性。到最终μ1、μ2的平方距离分别为A(8/9,800/9)、B(20/9,596/9)、C(20/9,596/9)、D(512/9,8/9)、E(740/9,20/9)、F(740/9,20/9)。归属不变,重新取均值也不变,算法稳定。
最终目标只累加每点到自己所属中心的距离,不把两列都加:J=(8+20+20+8+20+20)/9=96/9=32/3≈10.6667。没有除样本数6,因为题目问平方距离总和。K=2是簇数,和kNN里的邻居数不是同一概念。
Q3同题另一视角:先分组,再求均值,顺序不能换
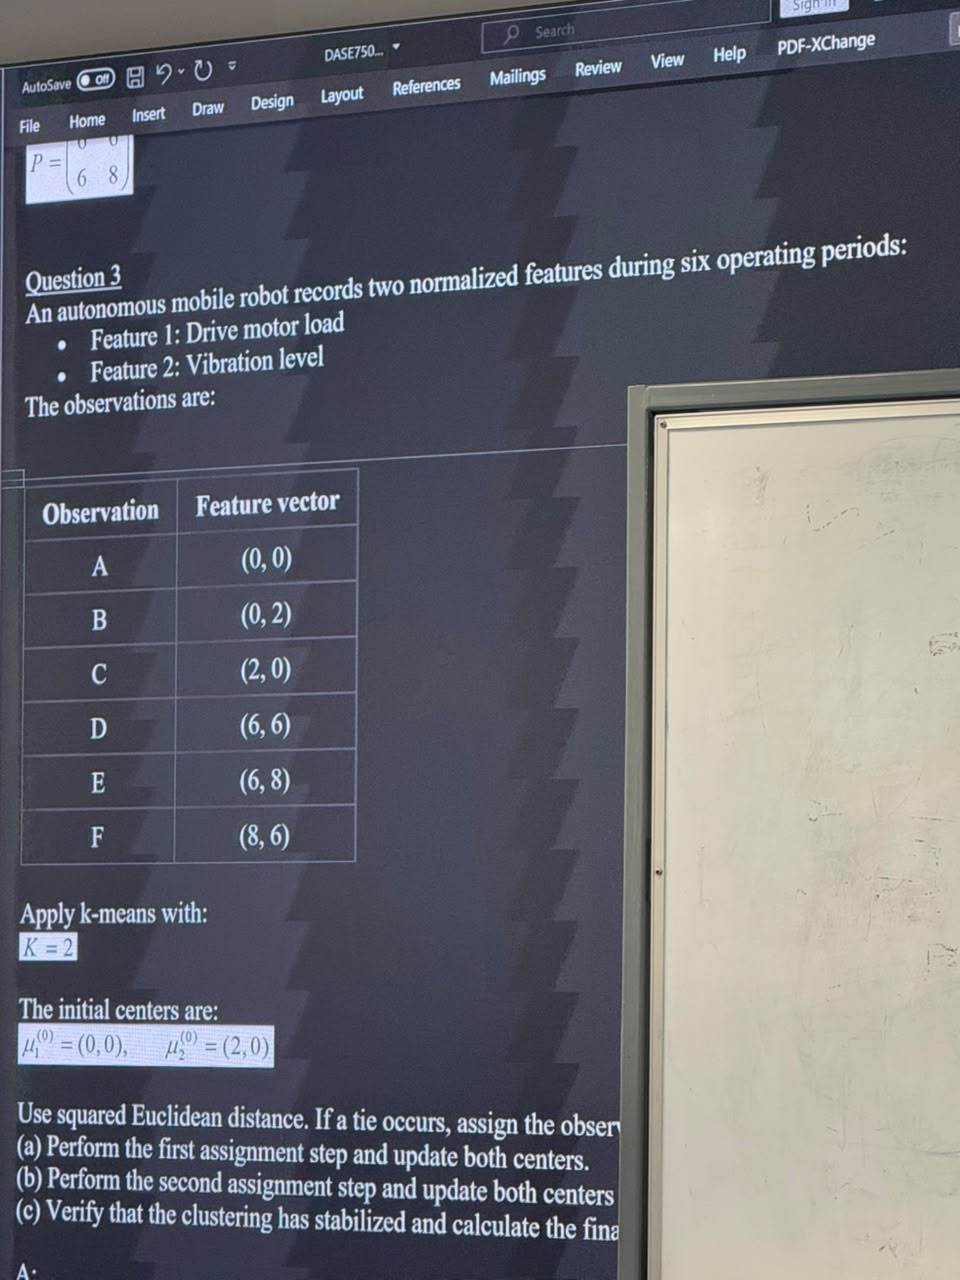
这道题依次要求:第一轮分配与中心更新;第二轮分配与更新;验证稳定性并计算最终平方和。
k-means每轮有两个阶段。先固定两个中心,把所有点分到最近中心;再固定分组,对每组的两个坐标分别求平均。不能刚分完A就立刻移动中心,再拿新中心处理B,那会变成另一种更新流程,和本题标准批量k-means不同。
固定一个簇后,中心的两个坐标可独立求。以其中一个坐标为例,令 t 为待选中心坐标,x_i 为这个簇第 i 个点在该轴上的坐标。目标是 J(t)=Σ_i(x_i−t)²。每项求导得 2(x_i−t)×(−1)=2(t−x_i),全加起来得 J'(t)=2(nt−Σ_i x_i)。令导数为0,解得 t=Σ_i x_i/n。二阶导数是 2n>0,所以这是非空簇的最小值。两个轴各算一次,即为负载均值与振动均值。
本题初始两个中心都在左下附近,不代表它们已经是最终两簇的真实代表。第一轮簇1只有A、B,中心(0,1);簇2含C、D、E、F,中心(5.5,5)。第二轮C重新检查后转组,最终中心(2/3,2/3)与(20/3,20/3)。
Q3(a)第一轮十二个距离与两个中心
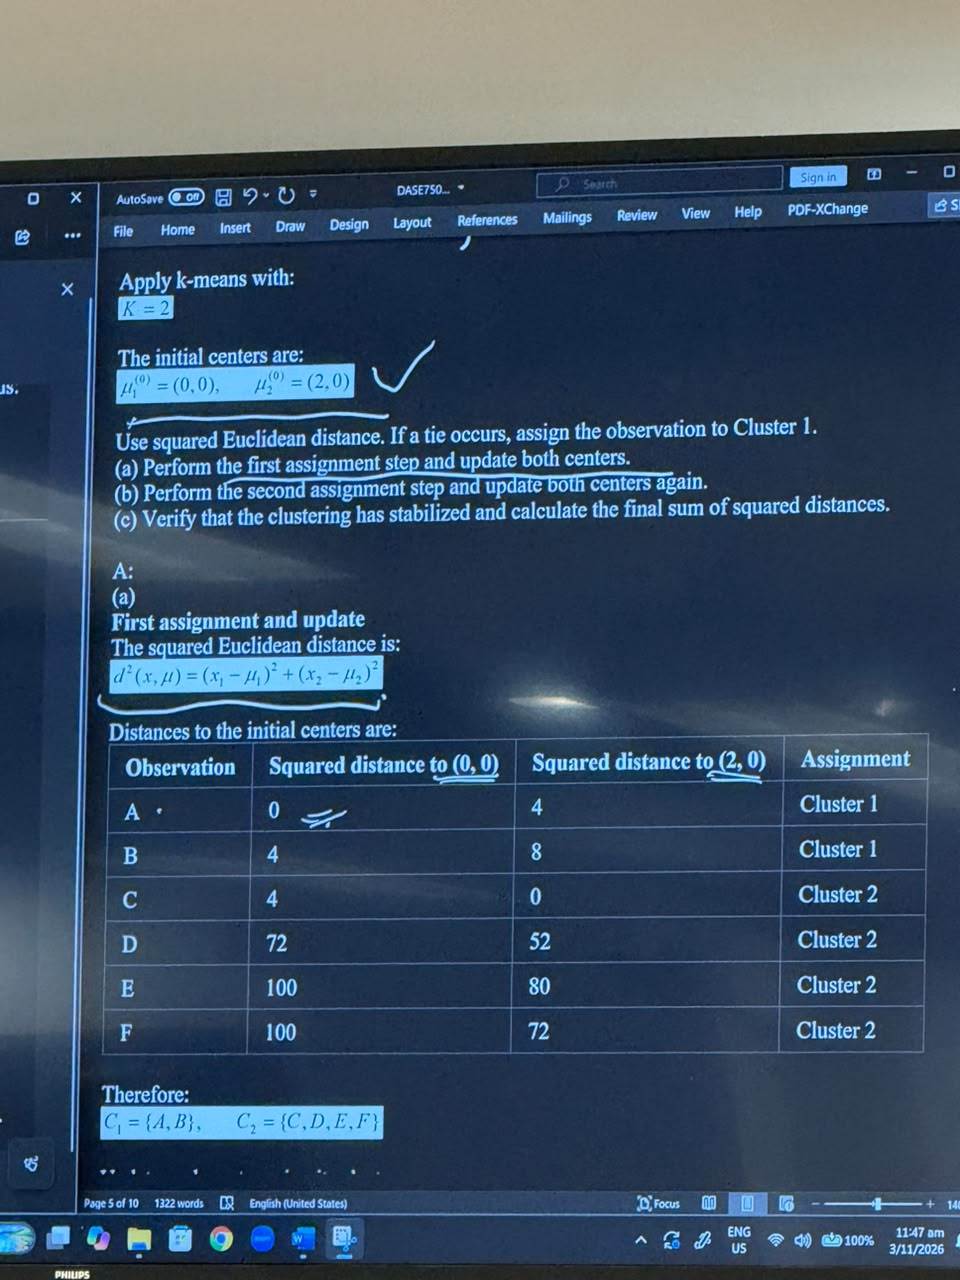
用两个初始中心(0,0)、(2,0)计算第一轮距离。两个坐标差各自平方后相加,不开平方:
A到(0,0):0²+0²=0;到(2,0):(−2)²+0²=4,选簇1。 B到(0,0):0²+2²=4;到(2,0):(−2)²+2²=8,选簇1。 C到(0,0):2²+0²=4;到(2,0):0²+0²=0,选簇2。 D到(0,0):6²+6²=72;到(2,0):4²+6²=52,选簇2。 E到(0,0):6²+8²=100;到(2,0):4²+8²=80,选簇2。 F到(0,0):8²+6²=100;到(2,0):6²+6²=72,选簇2。
于是簇1={A,B},簇2={C,D,E,F}。当前没有平局;题面规定的平局归簇1仍应保留为算法规则。
分完后才更新:簇1的横坐标均值(0+0)/2=0,纵坐标(0+2)/2=1,故μ1=(0,1)。簇2横坐标(2+6+6+8)/4=22/4=5.5,纵坐标(0+6+8+6)/4=20/4=5,故μ2=(5.5,5)。
Q3(b)第二轮:C为什么从簇2移到簇1
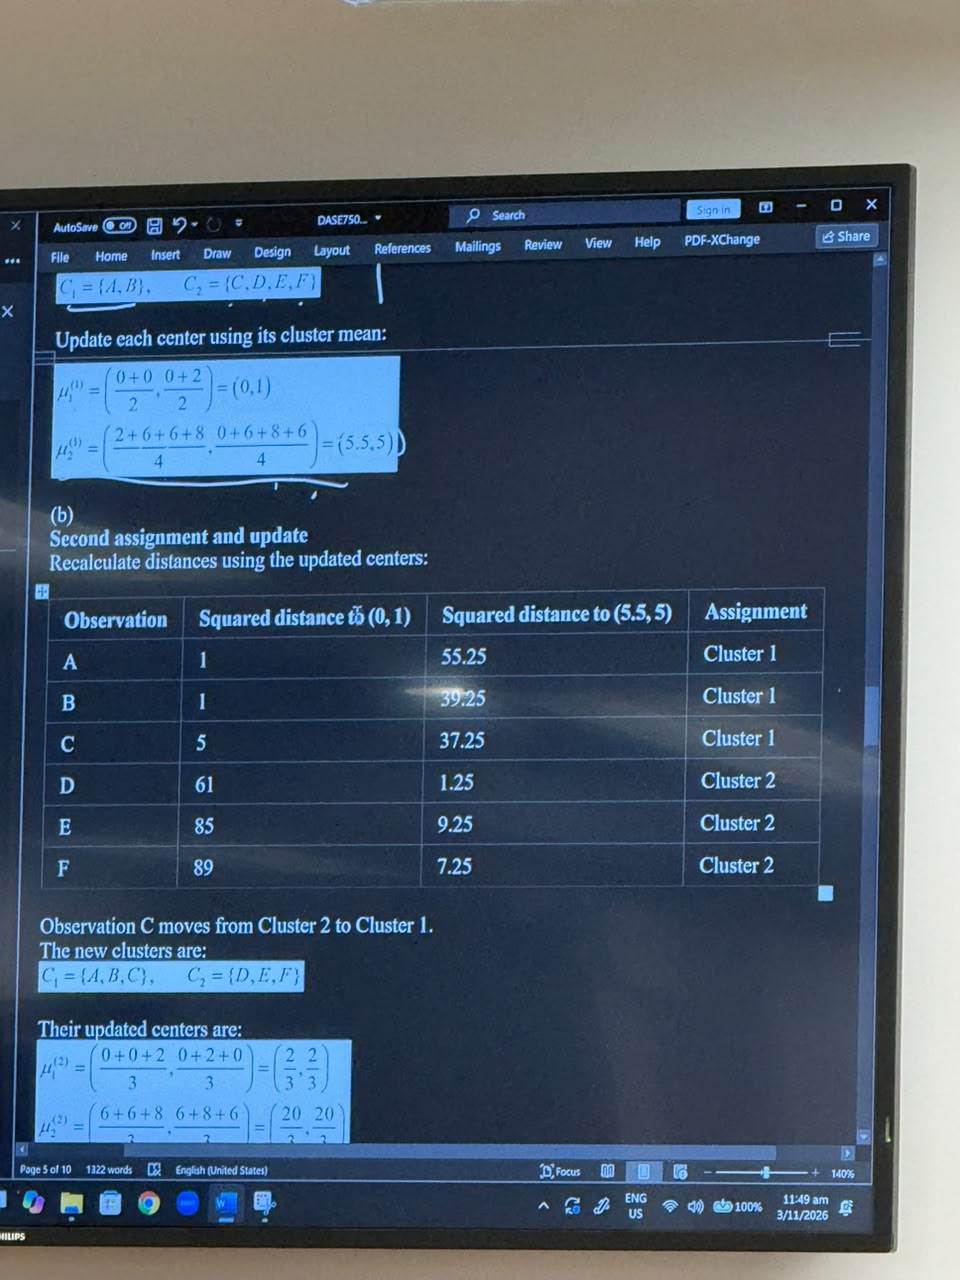
第一轮更新后,μ1=(0,1)、μ2=(5.5,5)。每点重新比较,不因上一轮分组就永久锁定。
A:到μ1为0²+(−1)²=1;到μ2为(−5.5)²+(−5)²=30.25+25=55.25。 B:0²+1²=1;另一边30.25+9=39.25。 C:2²+(−1)²=5;另一边(−3.5)²+(−5)²=12.25+25=37.25。 D:6²+5²=61;另一边0.5²+1²=1.25。 E:6²+7²=85;另一边0.5²+3²=9.25。 F:8²+5²=89;另一边2.5²+1²=7.25。
比较可见A、B、C去簇1,D、E、F去簇2。只有C转组:它到簇1的平方距离5,小于到簇2的37.25。
再求新均值:μ1=((0+0+2)/3,(0+2+0)/3)=(2/3,2/3);μ2=((6+6+8)/3,(6+8+6)/3)=(20/3,20/3)。分母用各自簇里的3点,不能继续沿用第一轮的2和4。
Q3(c)稳定性表:把两列比较完,再只加所属簇那一列
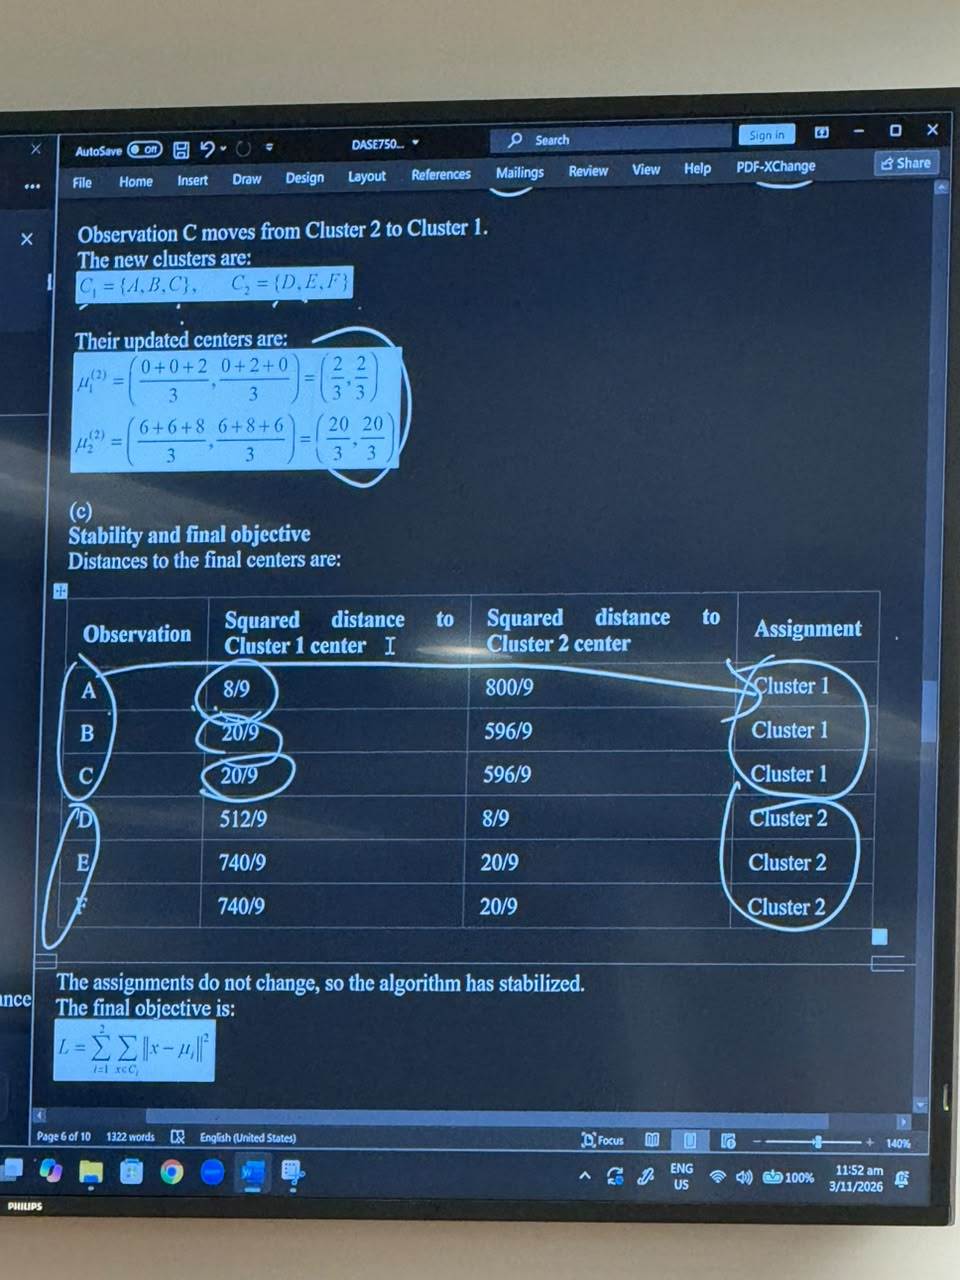
最终中心为μ1=(2/3,2/3),μ2=(20/3,20/3)。把坐标写成分母3。从 D=(18/3,18/3) 减去 μ₂=(20/3,20/3),两个差都是 −2/3,分别平方各得 4/9,相加是 8/9。对下列各行沿用该方法,保留分母9来比较。
A=(0,0):到μ1为(4+4)/9=8/9;到μ2为(400+400)/9=800/9。 B=(0,2):到μ1为(4+16)/9=20/9;到μ2为(400+196)/9=596/9。 C=(2,0):到μ1为(16+4)/9=20/9;到μ2为(196+400)/9=596/9。 D=(6,6):到μ1为(256+256)/9=512/9;到μ2为(4+4)/9=8/9。 E=(6,8):到μ1为(256+484)/9=740/9;到μ2为(4+16)/9=20/9。 F=(8,6):到μ1为(484+256)/9=740/9;到μ2为(16+4)/9=20/9。
每行挑更小者,仍得{A,B,C}和{D,E,F},归属没变,中心再平均也没变,所以稳定。
目标 J=Σ簇Σ所属点||x−μ||² 只累加被选中的六个数:8/9+20/9+20/9+8/9+20/9+20/9=96/9=32/3。
Q4全题面:感知机按A、B、C顺序更新,完整解题
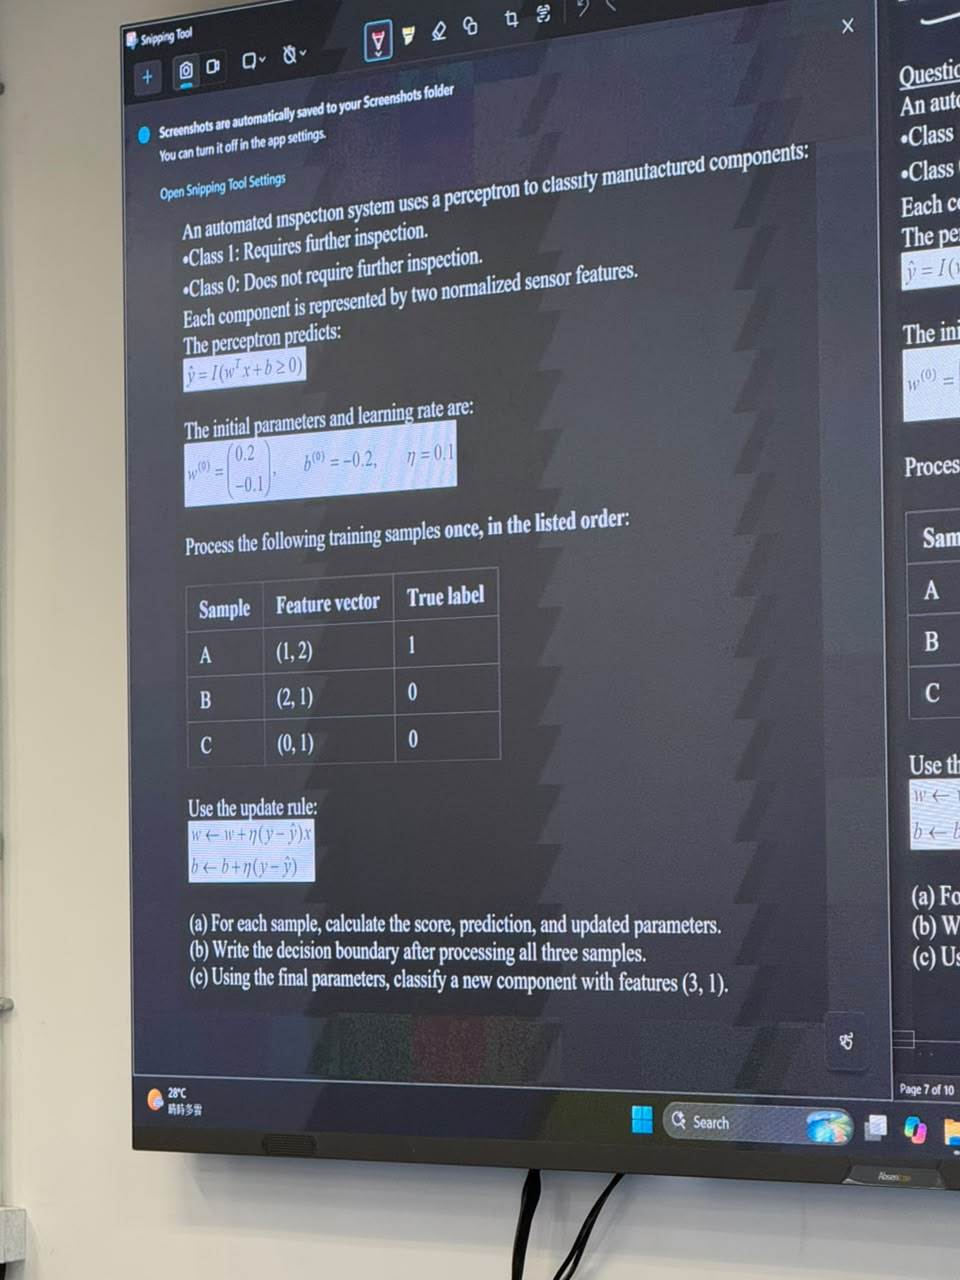
类别1表示需要进一步检查,0表示不需要。输入两个归一化特征;预测 ŷ=I(wᵀx+b≥0),意思是分数≥0判1,否则0。初始w=(0.2,−0.1)、b=−0.2,学习率η=0.1。依次只处理一次A=(1,2),y=1;B=(2,1),y=0;C=(0,1),y=0。更新规则 w←w+η(y−ŷ)x,b←b+η(y−ŷ)。
A:分数0.2×1+(−0.1)×2−0.2=−0.2,预测0,误差e=1−0=1。逐项更新w1=0.2+0.1×1×1=0.3,w2=−0.1+0.1×1×2=0.1,b=−0.2+0.1×1=−0.1。
B必须用刚更新的参数:分数0.3×2+0.1×1−0.1=0.6,预测1,e=0−1=−1。w1=0.3+0.1×(−1)×2=0.1;w2=0.1+0.1×(−1)×1=0;b=−0.1+0.1×(−1)=−0.2。
C用B后的参数:分数0.1×0+0×1−0.2=−0.2,预测0,与真值0相同,e=0。三个增量全为0,所以最后w=(0.1,0),b=−0.2。
(b)边界令分数=0:0.1x1+0x2−0.2=0,得到x1=2。规则含等号,因此边界本身判1;x1≥2判1,x1<2判0。
(c)新点(3,1)分数0.1×3+0×1−0.2=0.1≥0,预测1,需要进一步检查。只做一遍题目给定序列,不擅自增加训练轮次。
Q4(a)第一次更新:把漏报的A往类别1方向推
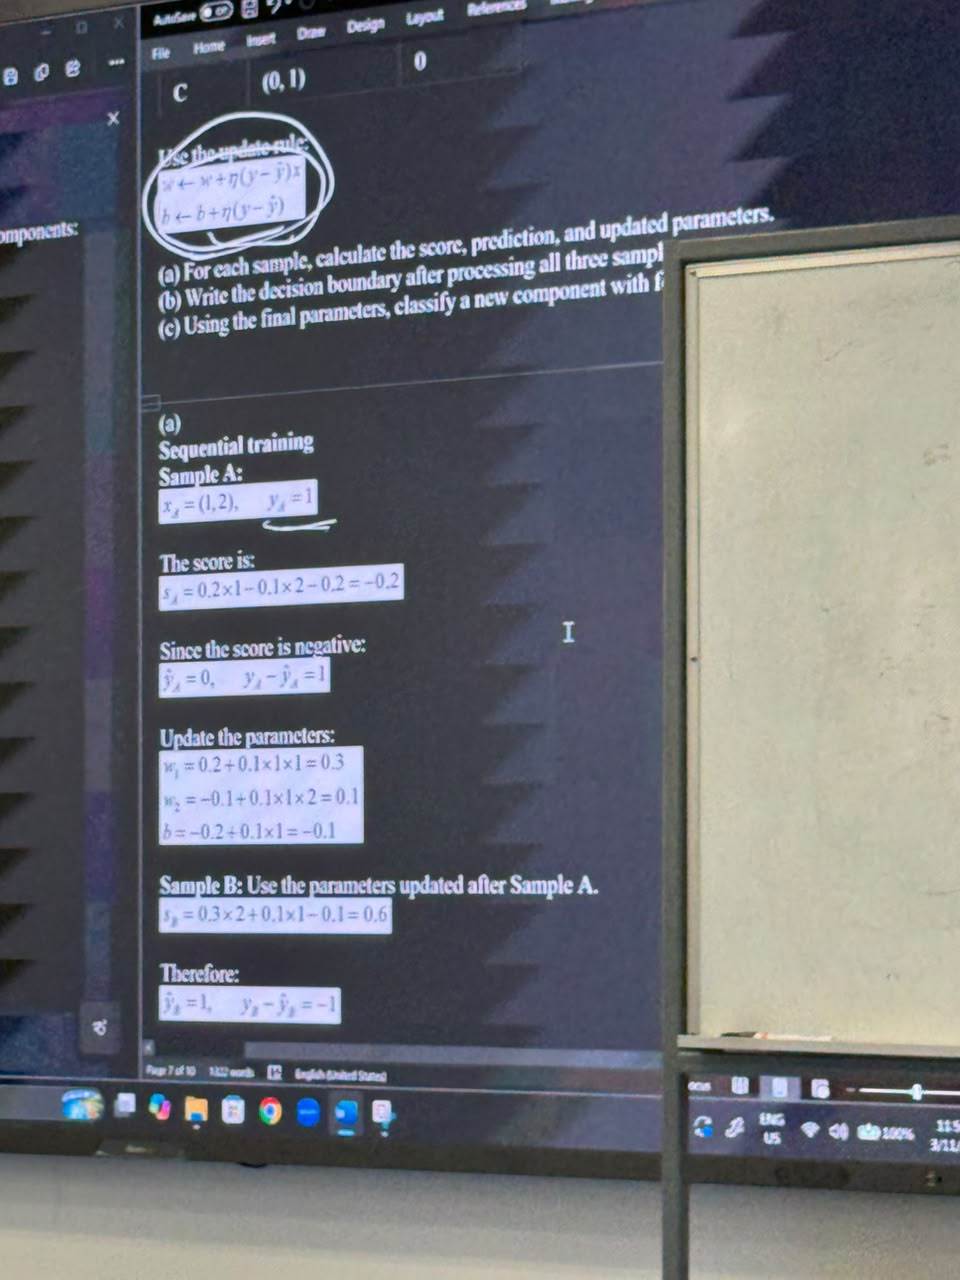
先处理样本A。A=(1,2),真实类别1,初始w=(0.2,−0.1)、b=−0.2。
先算 s=0.2×1−0.1×2−0.2=0.2−0.2−0.2=−0.2。因为小于0,预测ŷ=0;这是真值1被漏报,e=y−ŷ=1。
乘上学习率η=0.1和输入,权重增量为(0.1×1×1,0.1×1×2)=(0.1,0.2)。加到旧权重后,w=(0.3,0.1)。偏置不乘输入坐标,增量就是0.1,所以b=−0.1。不要给偏置也乘第二个特征2。
把同一个A代回新参数,分数由 −0.2 增加到 0.3×1+0.1×2−0.1=0.4。三个增量分别贡献 0.1×1、0.2×2、0.1,总共加了0.6。
紧接着处理B=(2,1),应使用w=(0.3,0.1)、b=−0.1,得分0.6。不能重置回最初的参数;“顺序训练”意味着前一个样本会改变后一个样本看到的模型。
Q4(a)第二次更新:误差为−1,权重和偏置怎样减
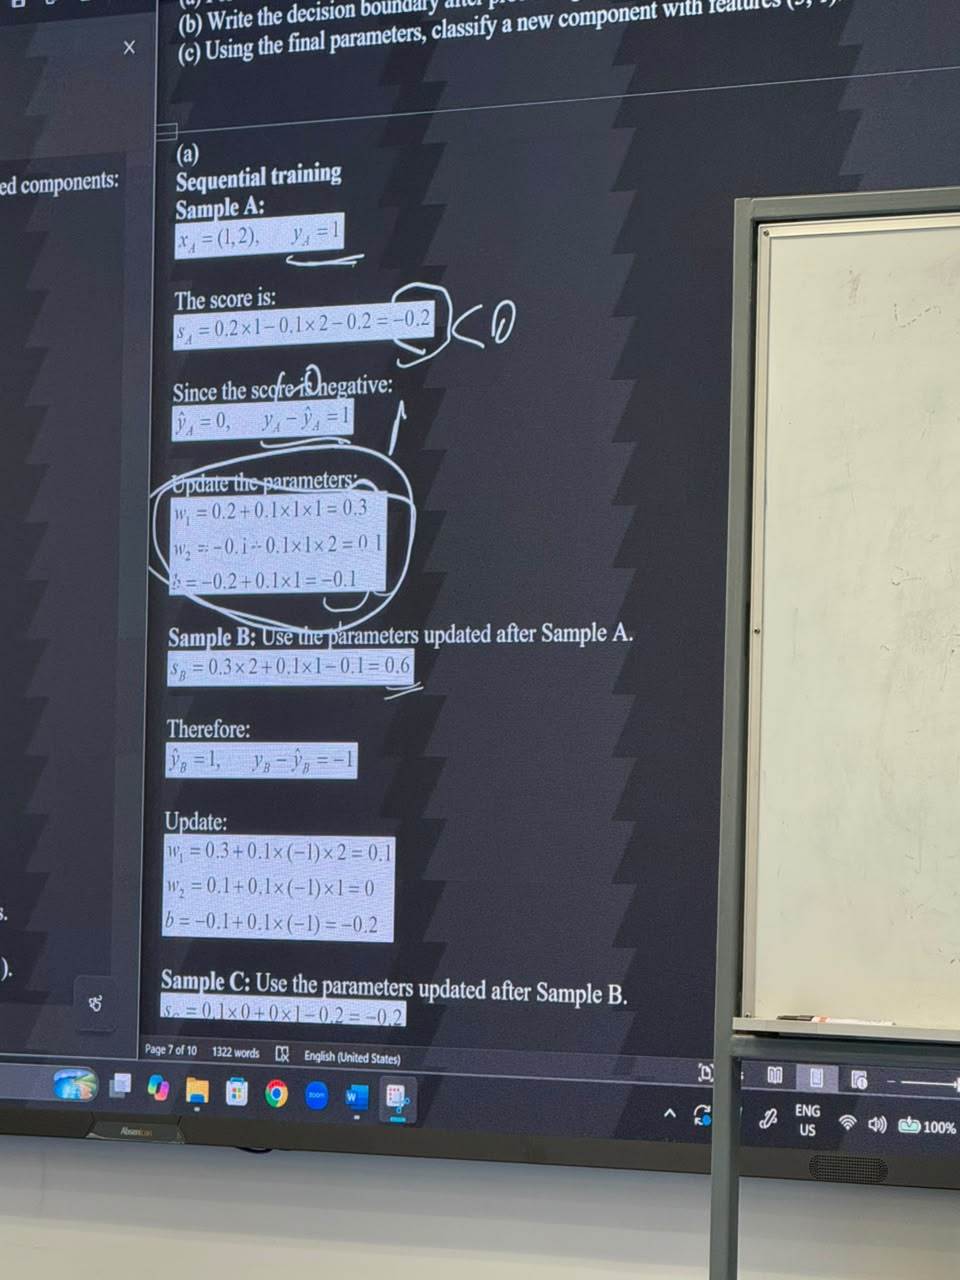
接着处理样本B。A处理后参数是w=(0.3,0.1)、b=−0.1。
B=(2,1)、真值0。分数 0.3×2+0.1×1−0.1=0.6,大于等于0,所以预测1。误差e=0−1=−1,不能把它误写成+1;本次要降低B方向上的得分。
第一个权重增量0.1×(−1)×2=−0.2,所以0.3−0.2=0.1;第二个增量0.1×(−1)×1=−0.1,所以0.1−0.1=0;偏置增量−0.1,所以−0.1−0.1=−0.2。B之后的参数为w=(0.1,0)、b=−0.2。
注意b的更新是“加上一个负数”,不是把原有负号去掉。学习率仍为正0.1,更新方向由误差和特征决定。
下一张C=(0,1)要使用这一组新参数,分数0.1×0+0×1−0.2=−0.2。
Q4(a)第三个样本:预测正确时为什么不更新
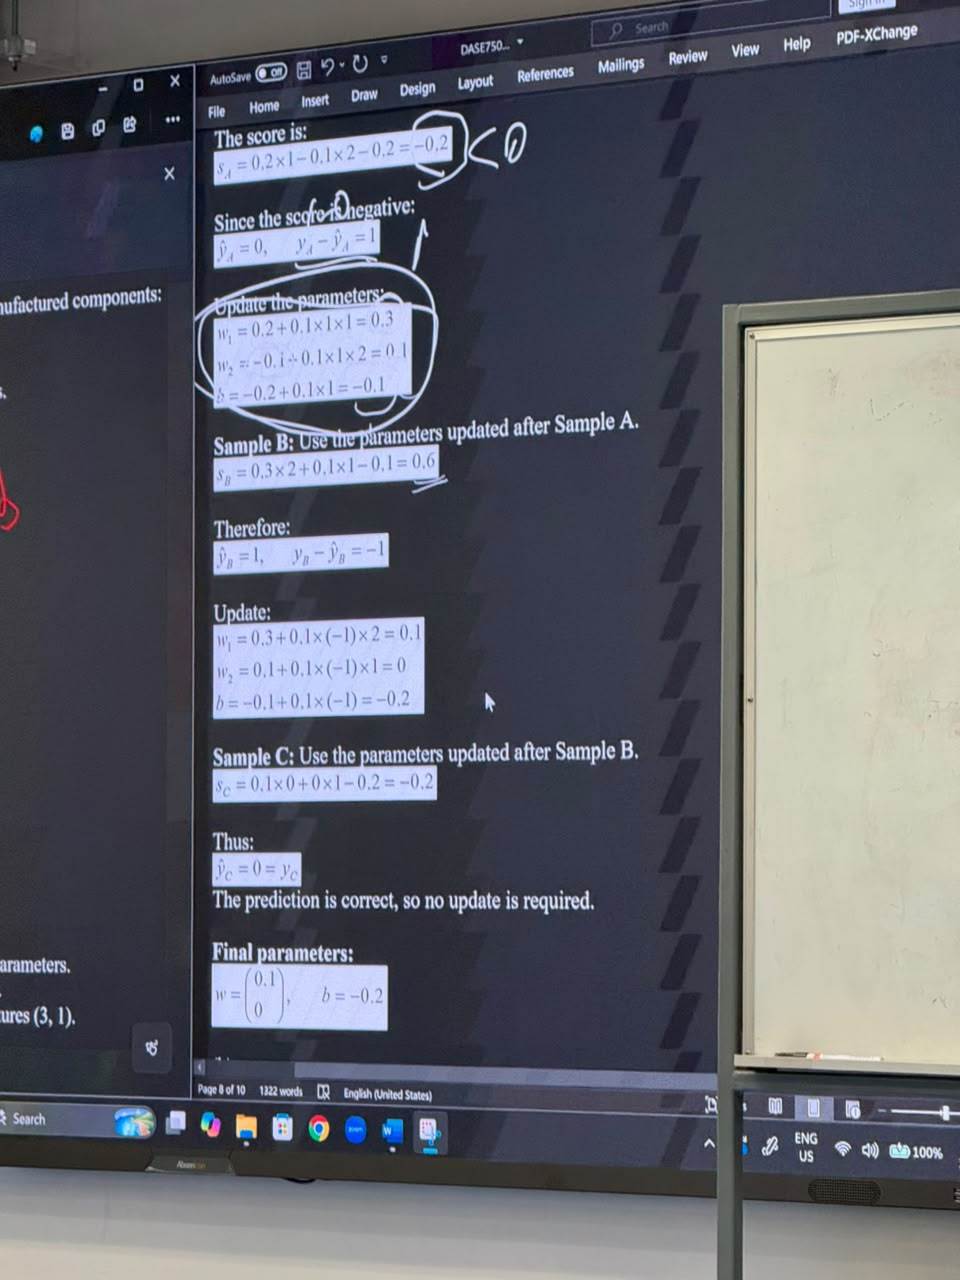
最后处理样本C。进入C前,w=(0.1,0)、b=−0.2。
C=(0,1),y=0。先算分数 s=0.1×0+0×1−0.2=−0.2,因此预测ŷ=0。误差e=0−0=0。更新式中的每个增量都含e,所以Δw1=0.1×0×0=0,Δw2=0.1×0×1=0,Δb=0.1×0=0。
C的三个更新量都是0,最后仍为 w=(0.1,0)、b=−0.2。
把全过程串成状态:初始(0.2,−0.1;−0.2)→A后(0.3,0.1;−0.1)→B后(0.1,0;−0.2)→C后不变。分号后表示偏置,防止把b当成第三个输入特征。
这里完成了题目要求的一轮更新。将A=(1,2)代回最终模型,得分仍为−0.1,预测0:后面样本的更新可能改变前面样本的分类。因此“完成一轮”与“所有训练样本都分对”是两回事。
Q4(b)决策边界:为什么第二个特征在最后不起作用
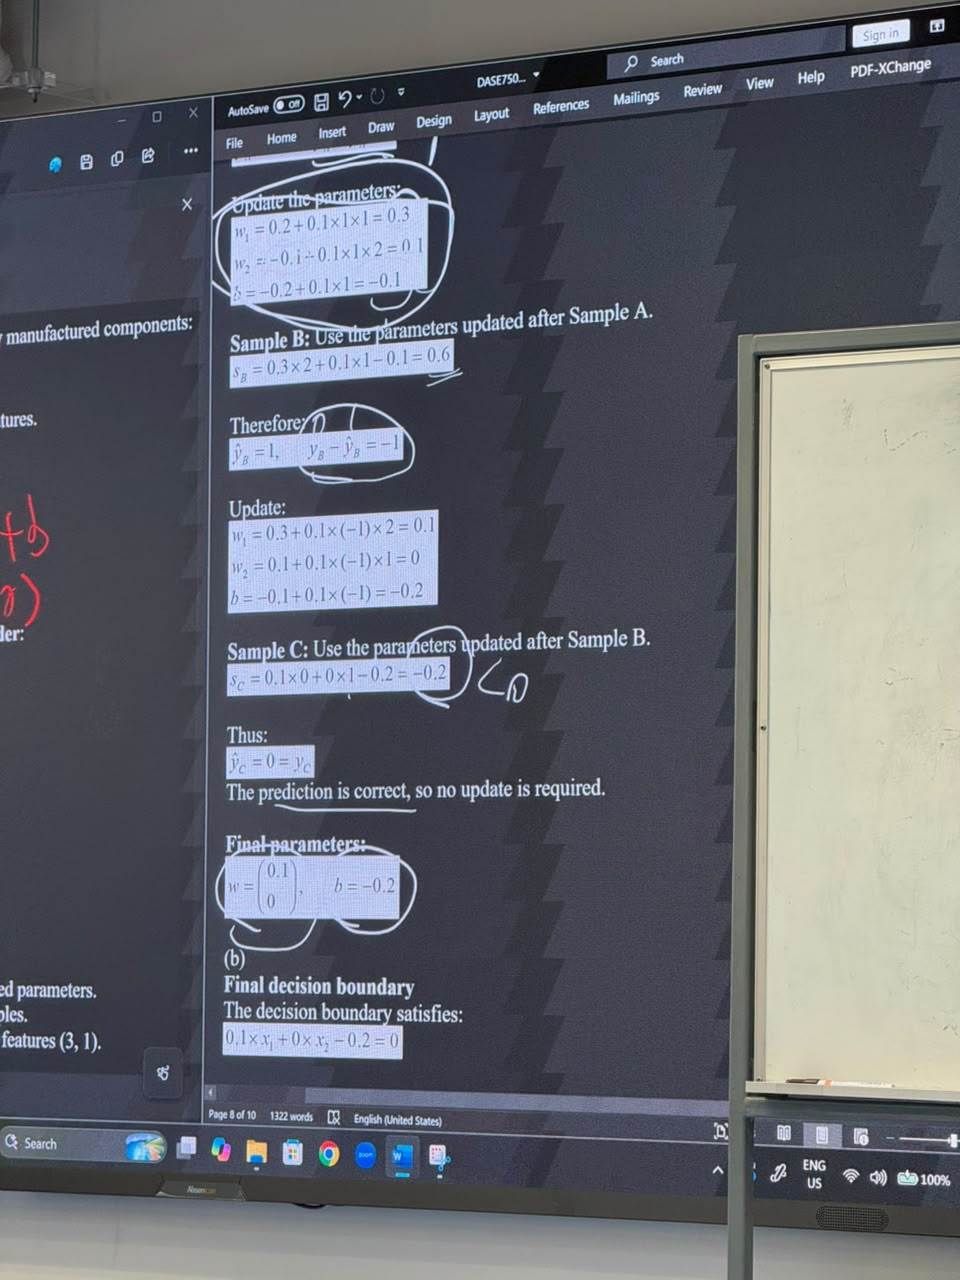
最终参数为w=(0.1,0)、b=−0.2,由它写出决策边界。
决策边界是把类别0和1隔开的“分数恰为0”的位置。代入最终参数:0.1x1+0x2−0.2=0,移项得到0.1x1=0.2,两边除0.1,得 x1=2。
第二个权重最终为0,所以此模型的分数与x2无关。若横轴画x1、纵轴画x2,边界是一条通过x1=2的竖线,而不是x2=2的横线。只要 x₁ 固定,改变第二个特征 x₂ 后仍有 0×x₂=0,本题这组训练参数给出的分数不变。
分类规则是≥0判1。因此x1=2时分数0,也属于类别1;x1>2时正,判1;x1<2时负,判0。边界方程只写等式,不足以说明两边各是哪类,还应结合原指示函数。
固定 x₂=1,从 (1,1) 走到 (2,1)、(3,1),分数依次是 −0.1、0、0.1,对应 0、1、1。
Q4(c)到Q5的交界:新点预测与另一种分类规则
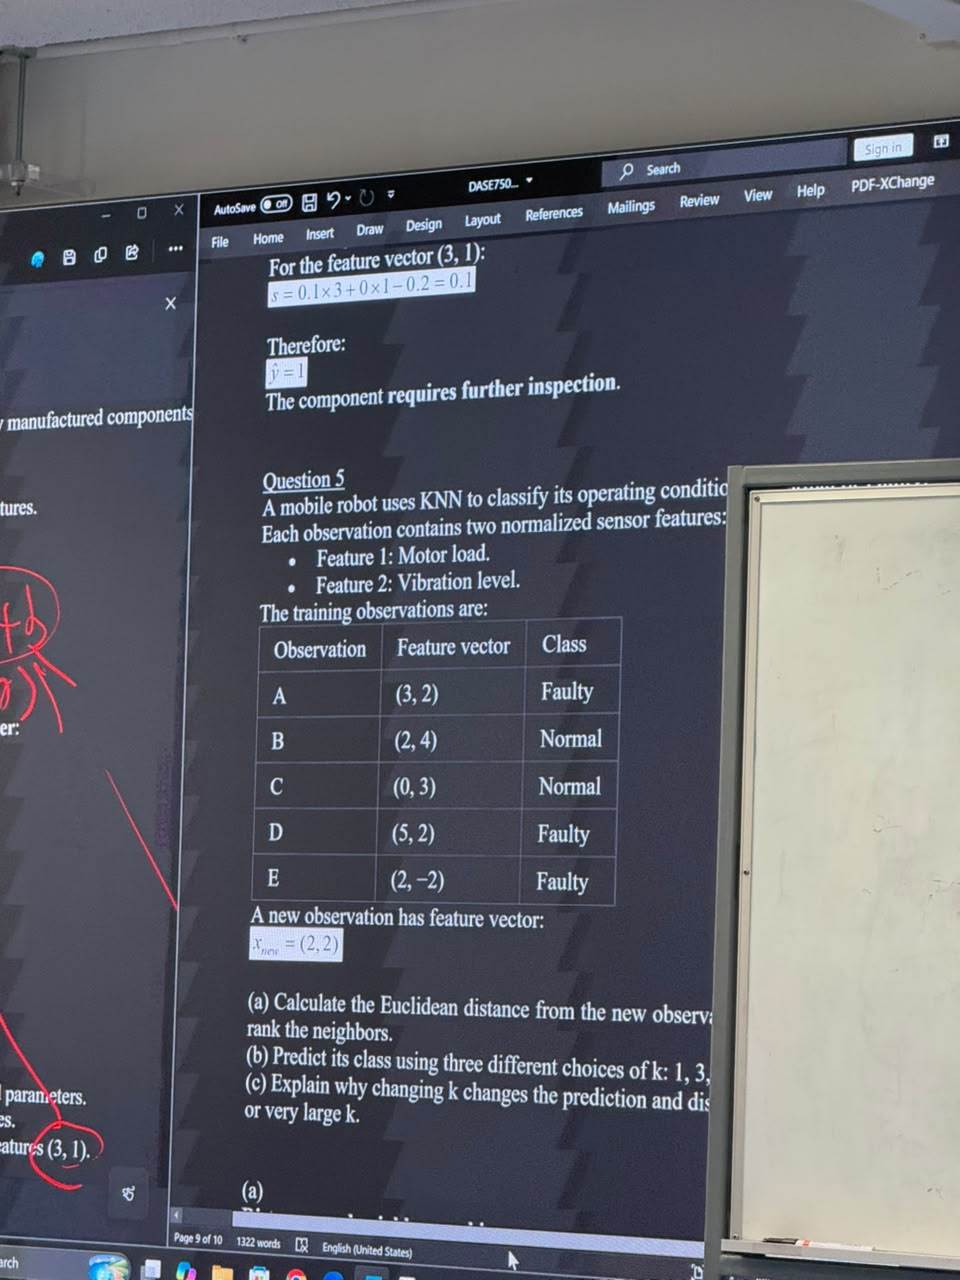
先用训练后的感知机预测新点(3,1),再转入kNN的距离投票。两种模型的输入都有两个特征,但前者算加权分数,后者比较参考样本。
Q4使用最终w=(0.1,0)、b=−0.2,算 s=0.1×3+0×1−0.2=0.3−0.2=0.1。0.1≥0,因此ŷ=1,含义是该零件需要进一步检查,不是已经证实坏了。
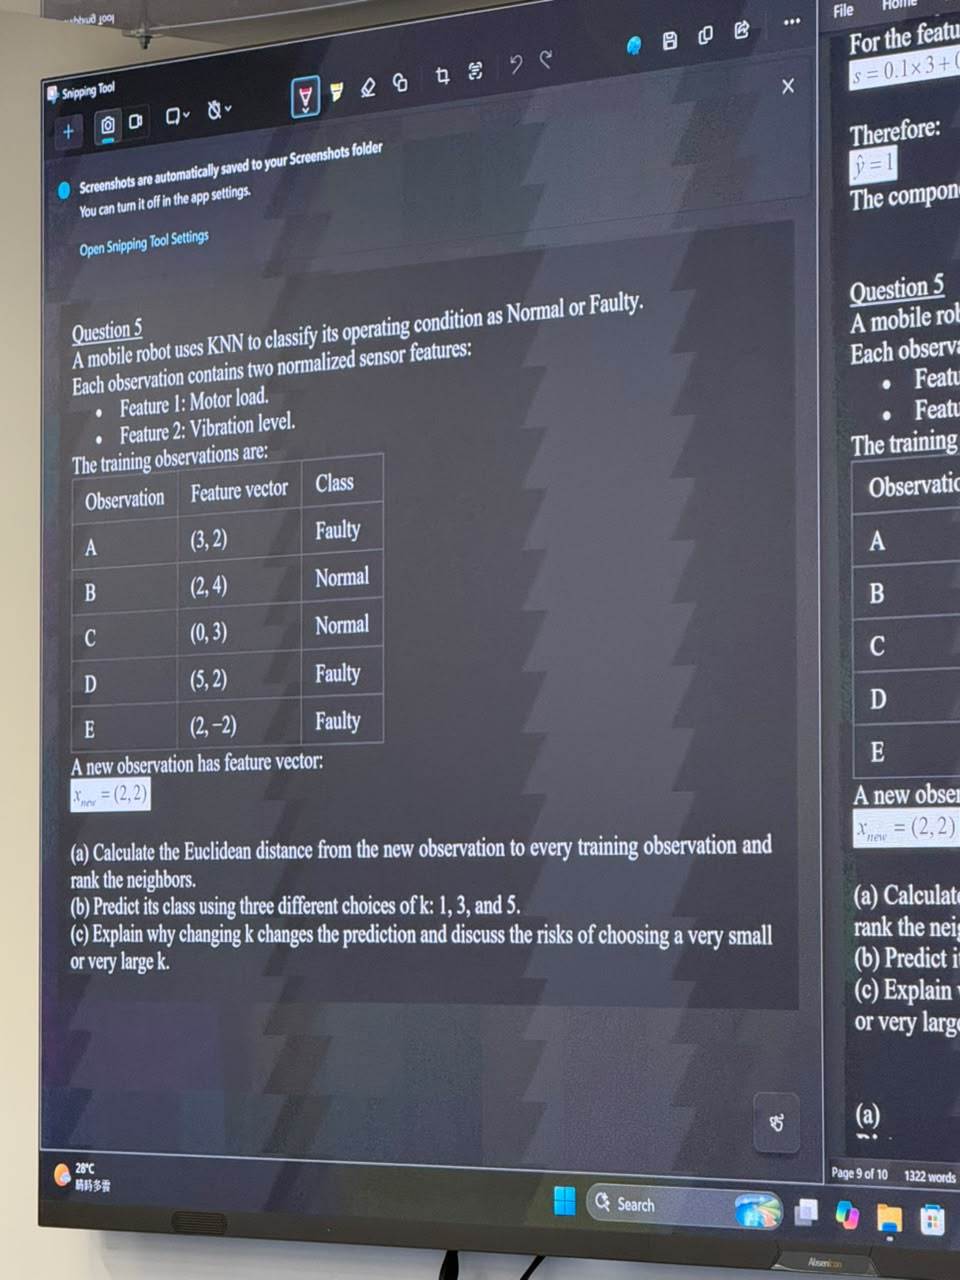
Q5给定带标签参考观测:A(3,2)故障、B(2,4)正常、C(0,3)正常、D(5,2)故障、E(2,−2)故障;新点是(2,2)。它要求按欧氏距离排序,然后比较k=1、3、5的投票。
先快速算平方距离为1、4、5、9、16,开方为1、2、√5、3、4,顺序A、B、C、D、E。前1个故障;前3个有2正常1故障,正常;全部5个有3故障2正常,故障。下一张完整题面会把每个距离和解释都拆开。
Q5全题面:五个距离、三种k与预测改变的原因
动手试试 · 切换k,看哪些邻居投票
移动机器人两个特征是电机负载和振动。已知A=(3,2)故障,B=(2,4)正常,C=(0,3)正常,D=(5,2)故障,E=(2,−2)故障。待测点q=(2,2),要求欧氏距离排序、k=1/3/5分类,并解释k的影响。
(a)逐点计算。欧氏距离 d(x,q)=sqrt((x1−2)²+(x2−2)²)。A:sqrt((3−2)²+(2−2)²)=sqrt(1+0)=1。B:sqrt(0²+2²)=2。C:sqrt((−2)²+1²)=sqrt5≈2.2361。D:sqrt3²=3。E:第二坐标差为−2−2=−4,不是0,所以sqrt(0²+(−4)²)=4。严格次序为A、B、C、D、E,无平局。
(b)普通多数投票。k=1只取A,故障1票,预测Faulty。k=3取A、B、C,故障1票、正常2票,预测Normal。k=5取全部,故障A/D/E共3票,正常B/C共2票,预测Faulty。不是对数字坐标投票,也不是把距离平均后和某阈值比较。
(c)为什么会故障→正常→故障?k改变参与投票的集合,新加入的邻居改变了多数类。k很小容易受单个噪声、异常参考点影响;k过大可能纳入很远且不能代表当前局部工况的点,并偏向全体多数类。实际应在验证数据上选k,不能为了让这一个测试点得到想要的类别临时挑k。
本题是有标签分类,和Q3不带类别标签、反复更新中心的k-means不同。
Q5(a)距离表前半:平方、相加、开根号的顺序
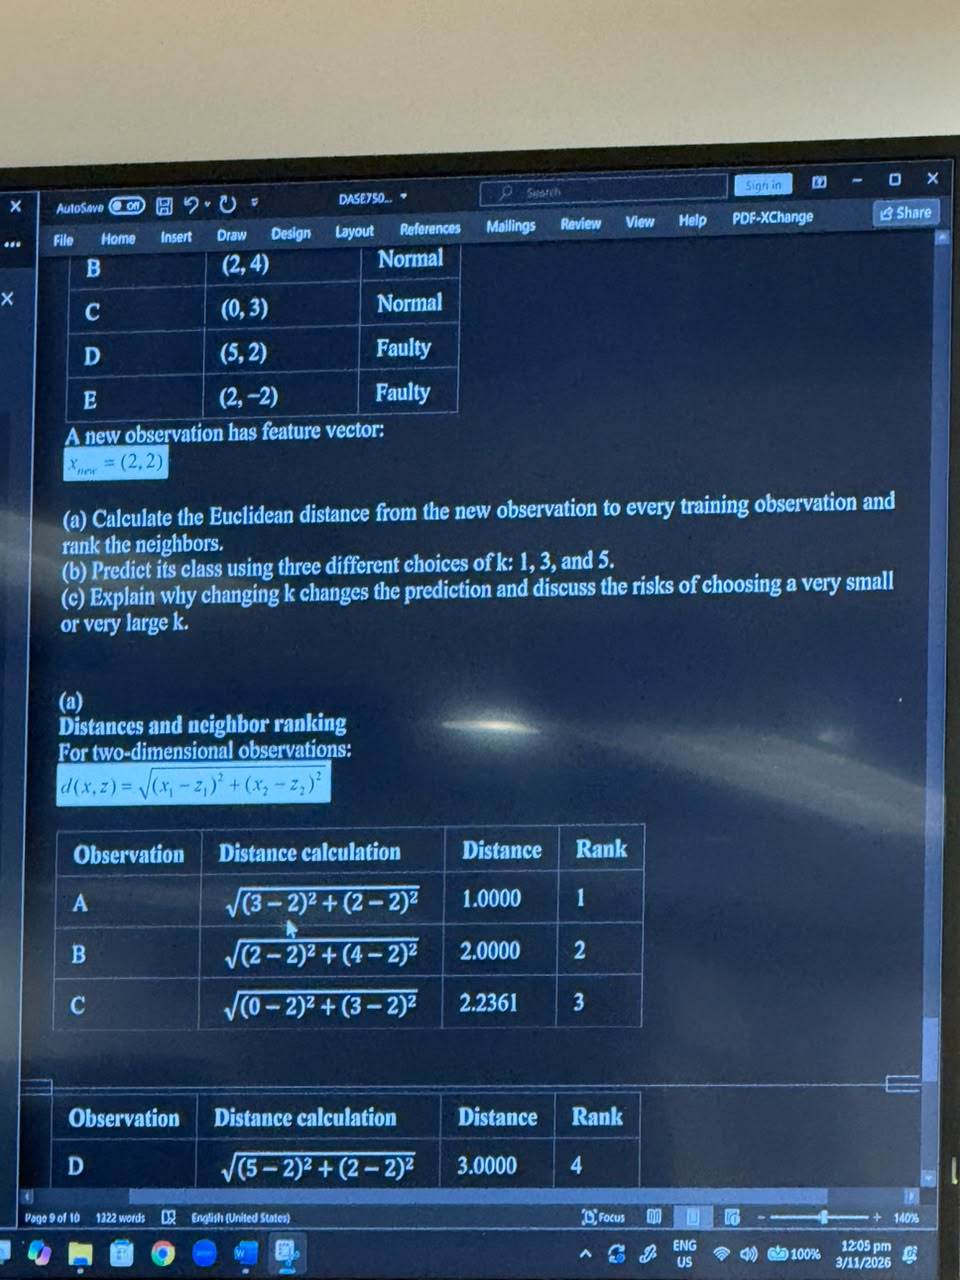
对于待测点 q=(2,2),第一维与负载比较,第二维与振动比较。每对数值相减,再把两个差分别平方、相加、开方。
A=(3,2):差(1,0),平方(1,0),相加1,开方1,所以排名第1。B=(2,4):差(0,2),平方(0,4),相加4,开方2,所以第2。C=(0,3):差(−2,1),平方(4,1),相加5,开方√5≈2.2361,所以第3。
不要把差先合并:C若算sqrt((−2+1)²)会得1,错把两个方向的偏差抵消。也不要把负坐标当负距离,欧氏距离从平方求和而来,始终非负。
下一点D=(5,2)差(3,0),距离3;E=(2,−2)差(0,−4),距离4。既然1<2<2.2361<3<4,前三名就确实是A、B、C。
距离排序阶段不使用正常/故障标签,标签只在取好邻居后用于投票。若把标签也加进距离,就把答案信息误当输入特征。
Q5(a)完整距离表:看清E的负坐标与五个排名
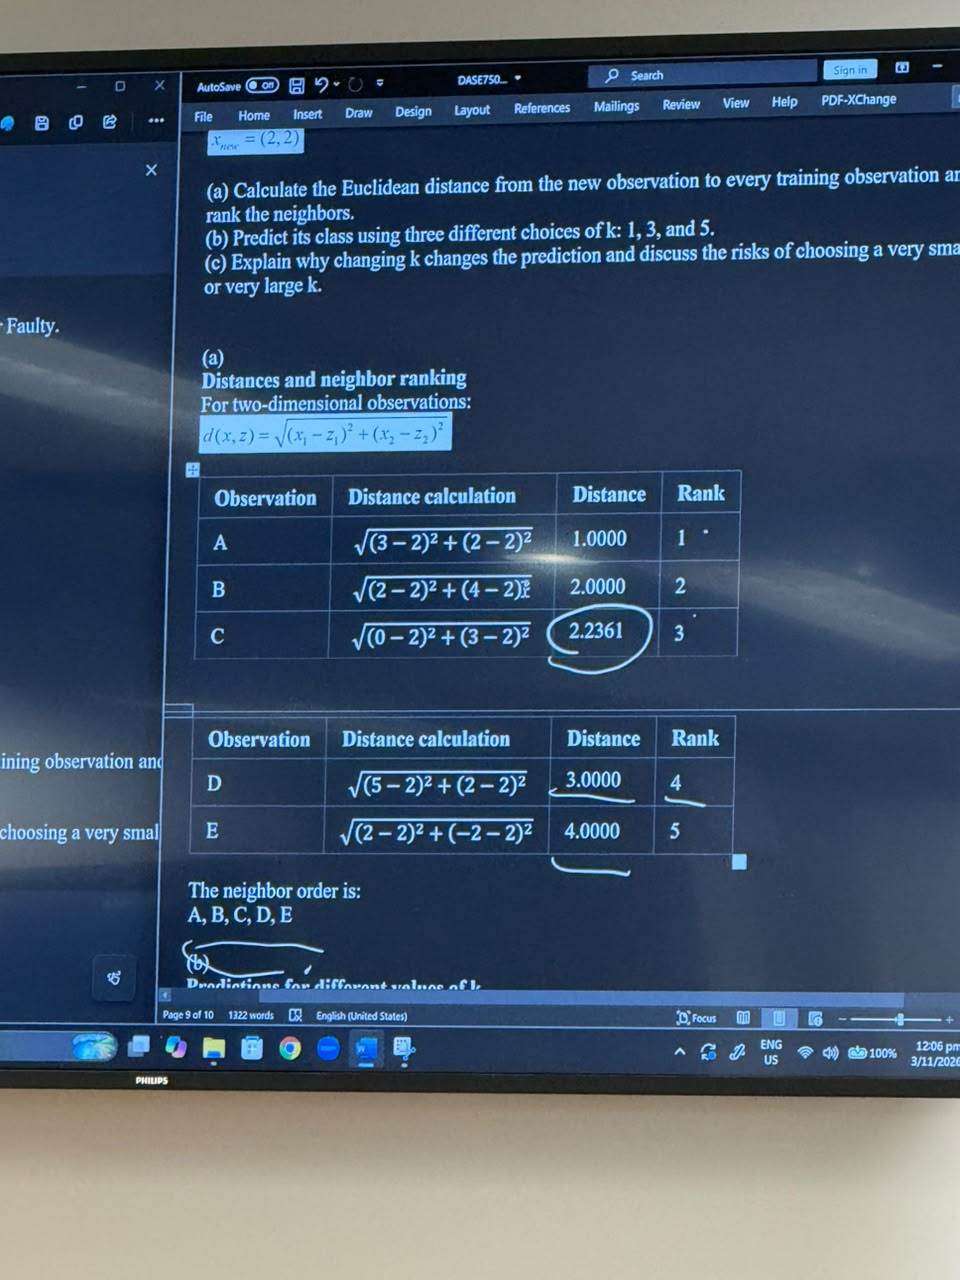
把五个距离按从小到大排列:A的距离1,B为2,C为√5≈2.2361,D为3,E为4,顺序A、B、C、D、E。
D=(5,2)离q=(2,2)只有横向差3,纵向差0,所以d=sqrt(9)=3。E=(2,−2)横向差0,纵向从−2到2相隔4,所以d=sqrt(16)=4。注意“两个2”符号不同,−2−2=−4,平方后16;若漏掉负号,会把最远点误判成距离0。
题目问欧氏距离,因此表中报告开方后的数;如果只是程序内部为排序,可以比较平方距离1、4、5、9、16,因平方根单调,排名相同。但不要把C的平方距离5写成欧氏距离5。
这一表只完成“找邻居”。接下来取前k个,依据它们已经给定的类别投票,不需要再更新任何聚类中心,也不需要训练感知机权重。
Q5(b)三种k的投票:逐个列出谁有资格投票
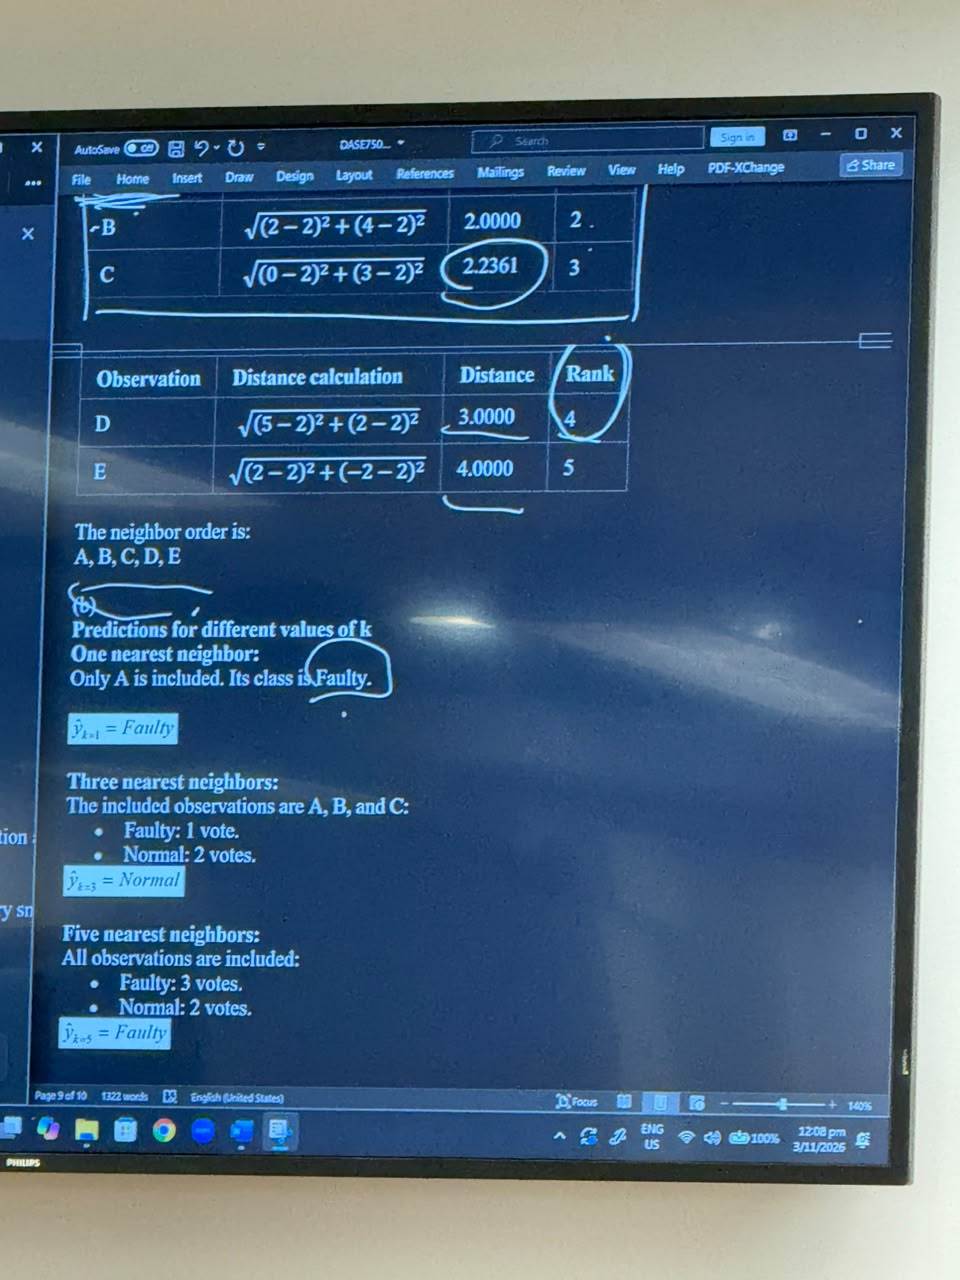
分别取最近的1个、3个、5个邻居。邻居排序已固定为A、B、C、D、E;类别顺序为故障、正常、正常、故障、故障。
| k | 选中的邻居 | 故障票 | 正常票 | 预测 |
|---|---|---|---|---|
| 1 | A | 1(A) | 0 | Faulty |
| 3 | A、B、C | 1(A) | 2(B、C) | Normal |
| 5 | A、B、C、D、E | 3(A、D、E) | 2(B、C) | Faulty |
三种结果用的是同一个待测点和同一份参考数据,只改变了邻居数量。新增邻居可能改变多数类,所以本题的预测依次为故障、正常、故障。
这是普通多数投票,每个入选邻居一票。不能看到A更近,就擅自让A的票乘某个距离权重;距离加权kNN是另一种需事先定义的方法。由于这里k为奇数且只有两类,所列三次没有票数平局。
Q5(c)解释与选k:用验证集决定,不能迎合一个答案
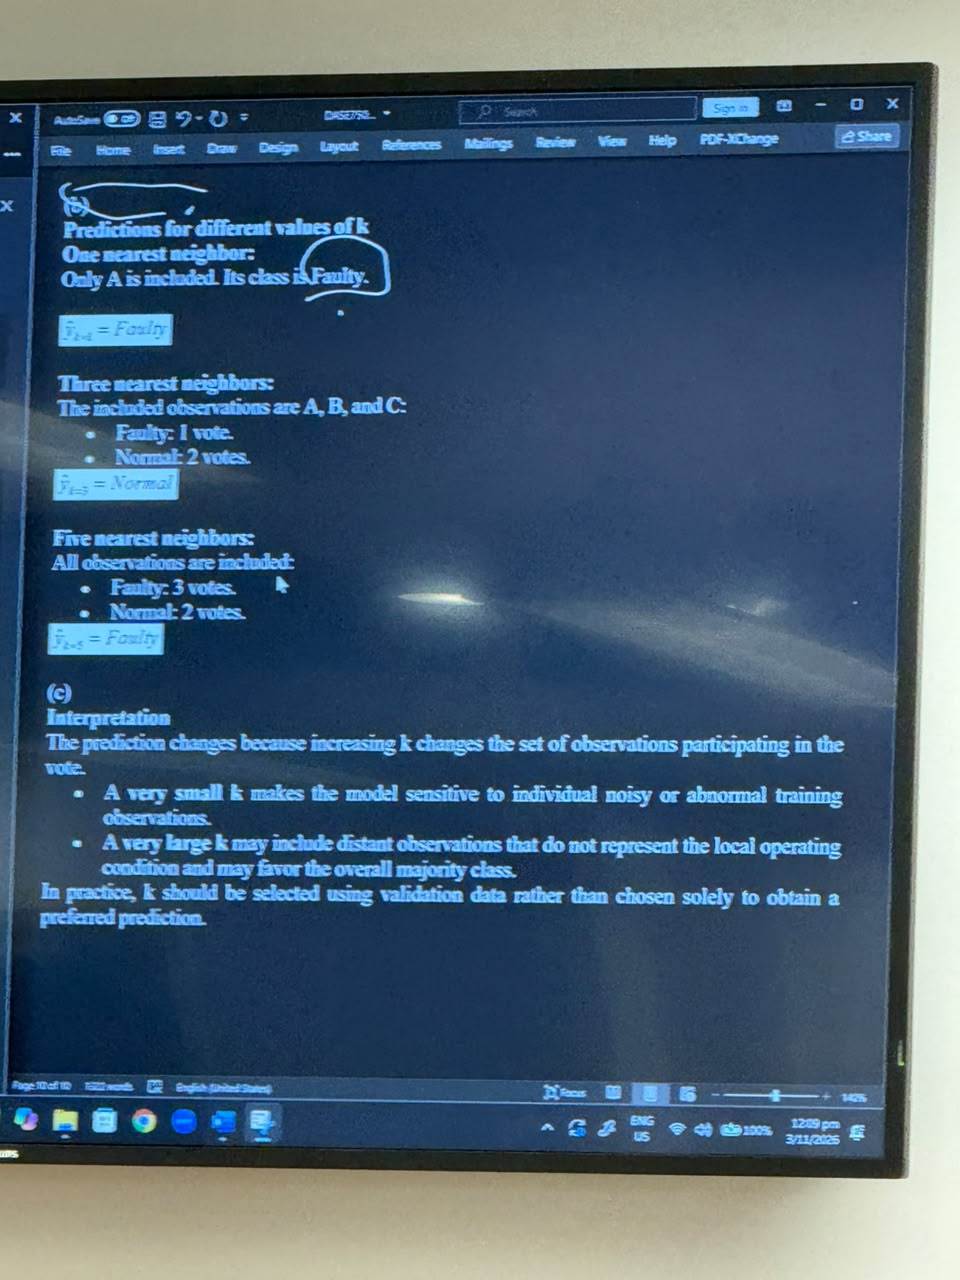
比较三种投票结果:k=1只看最近的A,因此对A这一个样本特别敏感;若A是误标、噪声或特殊工况,新点可能跟着被误导。k=3引入两个正常邻居B、C,改变多数;k=5再引入较远的故障D、E,多数又反转。
小k的风险是局部波动大;过大的k可能纳入远处、不代表当前工况的观测,并倾向整体多数类。在普通等权投票中,一旦 k 等于参考点总数,每个待测点都让同一批参考点投票。本题 k=5 时,任何待测位置都会收到3票故障和2票正常。
实际选择步骤:先固定训练参考集与特征缩放→设定若干候选k→在独立验证集上分别计算准确率等所需指标→选好k→冻结规则,再对测试数据预测。不能先想让q=(2,2)判正常,就专挑k=3;这会把想要的答案偷偷变成选模型的依据。