左右键翻页;“连续阅读”展开整份;搜索可定位概念。
MNIST任务、手写算法要求与训练验证测试
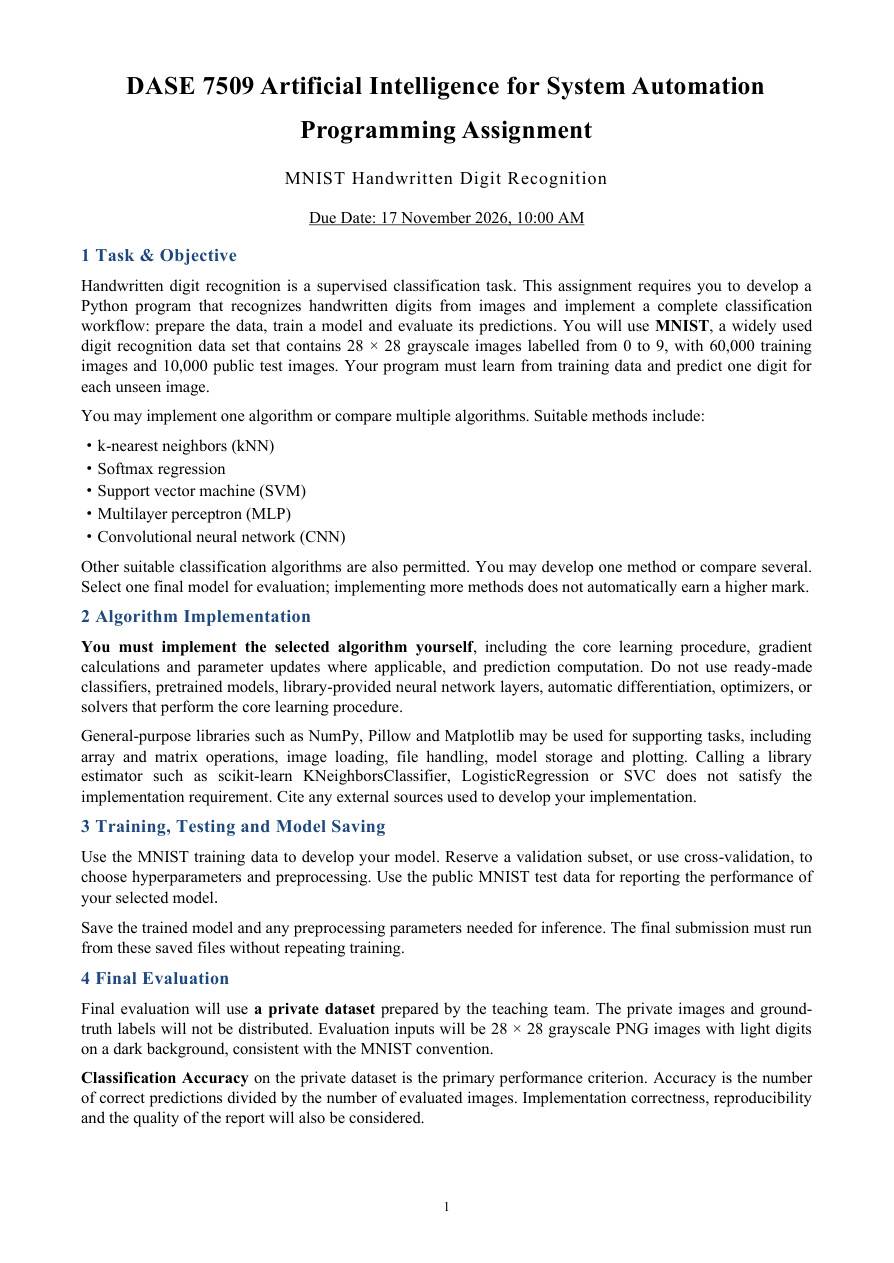
MNIST每张图是28×28灰度图,展开后有784个像素,标签为0–9。任务是学习“像素→数字类别”的对应关系,再为新图输出一个数字。数据包含60000张训练图与10000张公开测试图,最终还会在教学团队的私有图像上评价。
可选择kNN、Softmax回归、SVM、MLP、CNN等方法,最终提交一个选定的模型。比较模型时使用同一验证划分。
核心算法需要自己实现:预测计算,以及适用时的损失、梯度和参数更新。NumPy用于数组与矩阵计算,Pillow用于读图,Matplotlib用于画图;现成分类器、神经网络层、自动求导和核心求解器属于本作业禁止的封装。
数据流程:从训练集留出验证部分→用训练部分学参数→用验证集选择超参数和预处理→选定模型→在公开测试集报告表现。
准确率 正确张数/总张数。例子1000张正确970,准确率97%。它不解释哪些类别错得多,还可看混淆矩阵与典型错误。保存模型时要连同推理需要的预处理参数一起保存,最终加载后直接预测,不重新训练。
作业PDF给出的截止时间为2026年11月17日10:00。
两个接口与示例代码:每一行在做什么
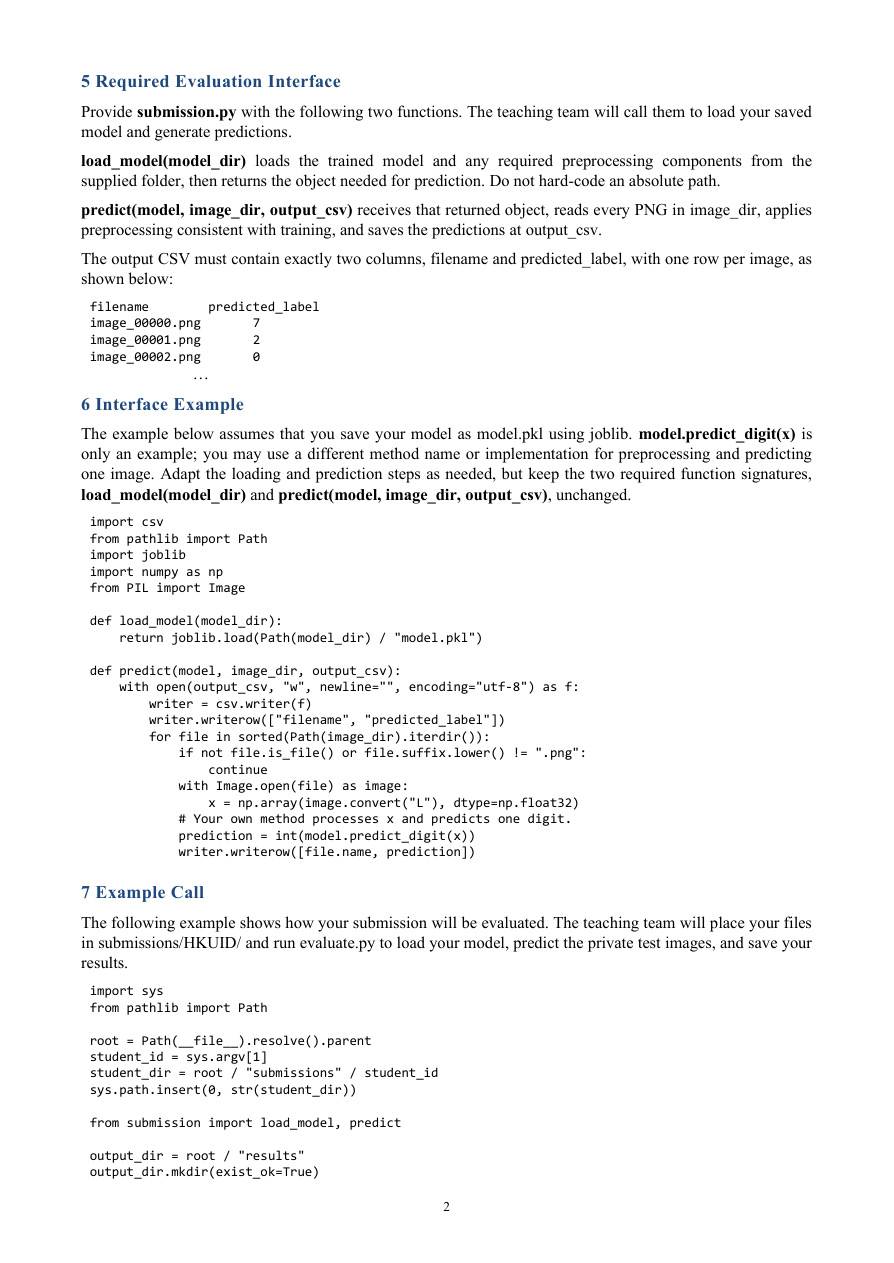
保留两个函数:load_model(model_dir)读取保存模型与预处理参数,返回预测所需对象;predict(model,image_dir,output_csv)读取指定文件夹的PNG,生成每张图的预测,写到给定CSV路径。
导入工具:csv写表,Path拼路径,joblib加载保存对象,NumPy处理像素数组,Pillow的Image读图。joblib.load(Path(model_dir)/"model.pkl")从模型目录下读model.pkl,返回其中保存的对象。
open(output_csv,"w",newline="",encoding="utf-8") 新建/写输出表;csv.writer建立写行工具;第一行必须是 filename,predicted_label。循环用sorted固定文件顺序;is_file()排除目录;suffix.lower判断扩展名,所以.PNG也识别;continue跳过非PNG。
with Image.open(file)结束后关闭图像句柄;convert("L")转灰度;np.array(...,dtype=np.float32)得到28×28浮点数组。它尚未自动除255、中心化或Flatten;这些必须按自己训练时同一规则做。int(model.predict_digit(x))是占位的自定义预测方法,不是Python自带功能。writer.writerow([file.name,prediction])写文件名与0–9标签,一张图一行。
评测端怎样找到你的代码
| 代码 | 这一行完成的动作 |
|---|---|
root = Path(__file__).resolve().parent |
找到评测脚本所在文件夹。 |
student_id = sys.argv[1] |
取命令中的第一个参数。例如运行 python evaluate.py 3634119900,这里得到字符串 3634119900。 |
student_dir = root / "submissions" / student_id |
拼出 submissions/3634119900。 |
sys.path.insert(0, str(student_dir)) |
把学生目录放在模块搜索列表最前面。 |
from submission import load_model, predict |
从这一目录的submission.py取出两个接口。 |
output_dir = root / "results" |
拼出保存预测的目录。 |
output_dir.mkdir(exist_ok=True) |
创建results。如果它已存在,可以继续写入。 |
自测:CSV写成 index,filename,label 三列可不可以?不行,题面要求恰两列且列名固定。示例函数名predict_digit可改,两个外部接口签名不可改。
评测调用、压缩包结构与报告:接上上一页执行链
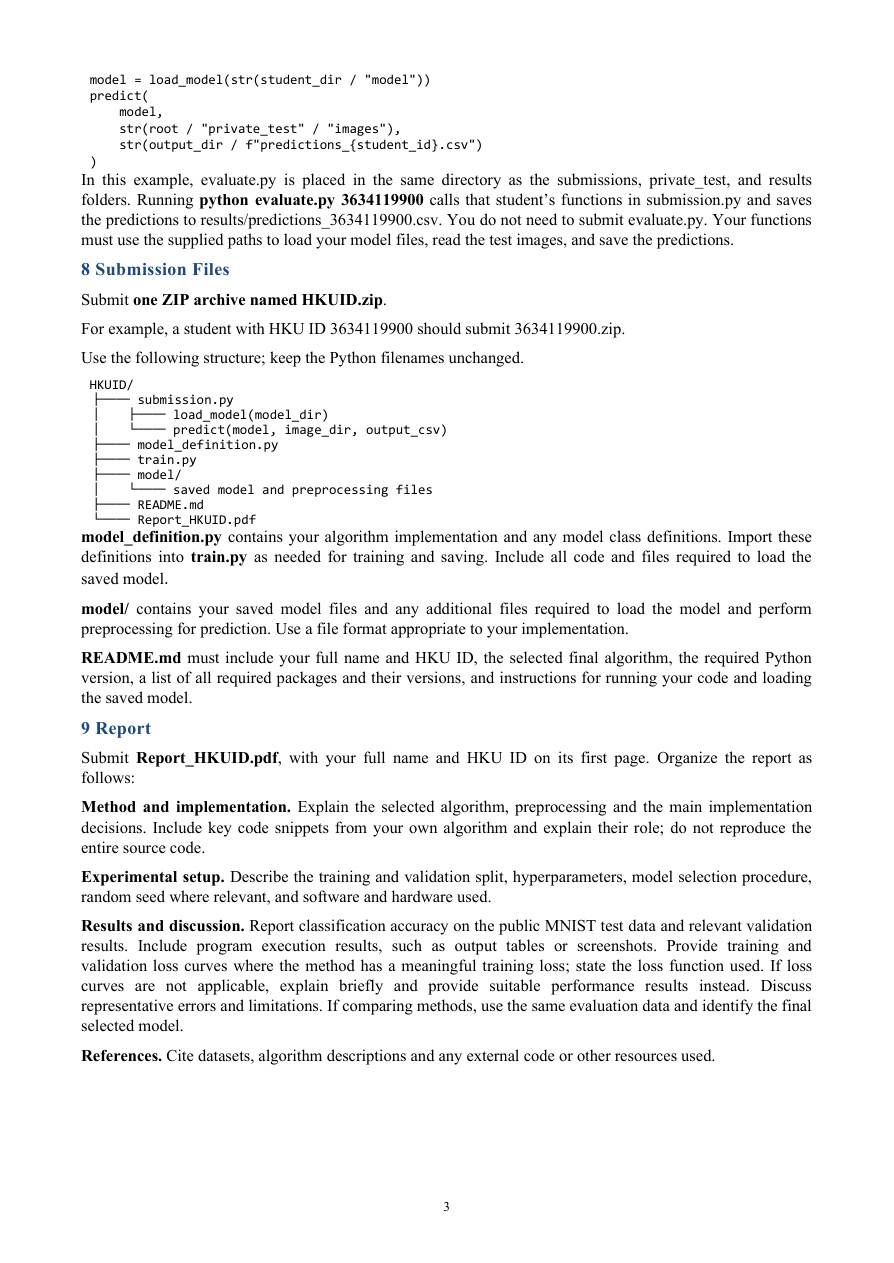
上页找到两个接口后,这页真正开始调用。
model = load_model(str(student_dir / "model"))拼出submissions/3634119900/model,把路径传给加载函数,把返回对象存在model中。predict(model, ...)用刚载入的model,两条路径分别告诉它去哪读图、去哪写表。- 输入路径由
root / "private_test" / "images"拼出。输出路径里的f"predictions_{student_id}.csv"将学号带入文件名,形成results/predictions_3634119900.csv。
本页要求一个 HKUID.zip,内部顶层为学号文件夹,包含submission.py、model_definition.py、train.py、model目录、README.md、Report_HKUID.pdf。model_definition.py放自己算法/模型类;train.py用于训练保存;submission.py提供统一加载与预测入口;model保存权重及预处理。加载对象若依赖类定义,也必须随包提供,不能只放一个无法独立加载的序列化文件。
README写姓名学号、最终算法、Python与包版本、训练/推理运行方式。报告第一面写姓名学号;Method解释方法与关键实现,不复制全部源码;Experimental setup交代数据划分、超参数选择、随机种子、软硬件;Results给公开测试/验证结果、执行证据、适用的损失曲线、错误分析;References注明数据、算法和外部资源。
普通kNN没有迭代损失曲线,报告准确率等合适评价即可。比较方法时使用同一评价数据,并标明最终选用的模型。
打包后检查:在新文件夹解压→加载保存模型→读取一组PNG并预测→检查每张图对应一行,标签为0–9,CSV列名正确→检查ZIP中的文件结构。