左右键翻页;“连续阅读”展开整份;搜索可定位概念。
本讲主题
这讲学习线性回归与Logistic回归:前者预测能耗、温度等连续数值,后者预测某个类别的概率。两者都从加权输入开始,区别在输出含义、损失和最后的决策方法。
两种回归名称
线性回归直接输出线性分数,用平方损失衡量数值偏差;Logistic回归把分数送入Sigmoid,输出正类概率,用负对数损失训练。先学“怎样预测→怎样衡量错误→怎样求参数→怎样评价”,就能抓住整讲路线。
线性回归的建模假设
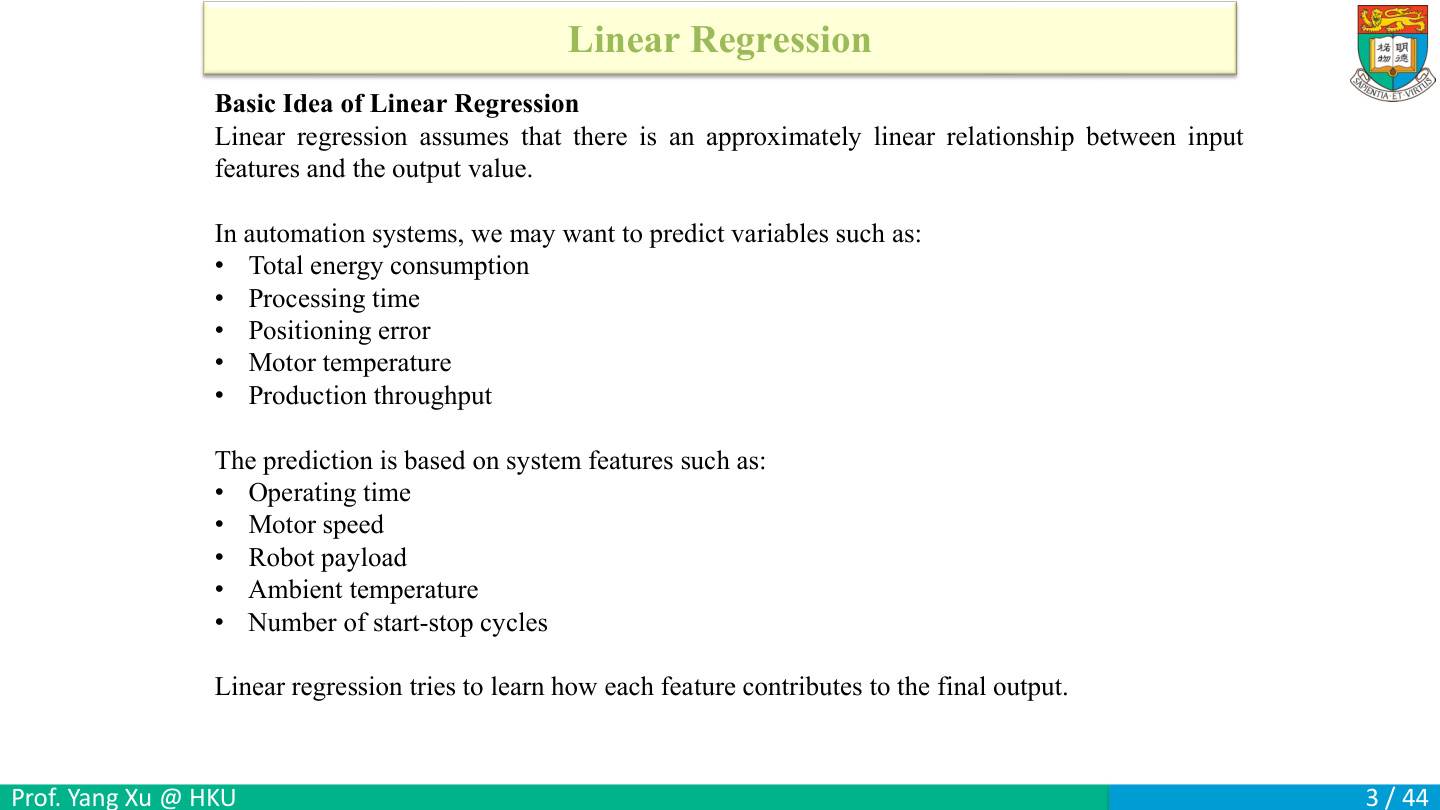
输入可以是运行时间、速度、载荷、环境温度和启停次数,目标可以是能耗、处理时间、误差、温度或吞吐量。线性模型将各特征贡献按权重相加,近似描述某个工况范围内的输入输出关系。特征是预测时可获得的输入,标签是要预测的结果。若把任务结束后的总能耗又作为输入预测同一个能耗,会发生信息泄露。
“线性”指模型对权重的组合形式:每项wⱼxⱼ加起来。例子能耗ŷ=2×运行小时+0.5×载荷+3,运行2小时、载荷4时预测4+2+3=9。它假设在目前使用区间内,用这样的加法近似足够好;超过训练过的工况,真实机器可能有饱和、启停阈值等非线性变化。
练一练。如果输入包含x和x²,模型ŷ=w₀+w₁x+w₂x²是否仍可按线性回归求w?答案:可以,因为它对参数w仍是线性的,只是用了变换后的特征。另一个检查是预测时输入能否获得:若要任务开始前预测总耗电,就不能把任务结束才知道的某项结果当成可用特征,除非明确改成事后估计任务。
还可加入交互特征,例如运行时间×载荷,表示载荷影响可能随运行时间积累;线性回归不是禁止这类预先构造的输入。关键是先定义特征,再保持预测对其权重线性,最后用验证检查是否改善泛化。
向量形式与偏置
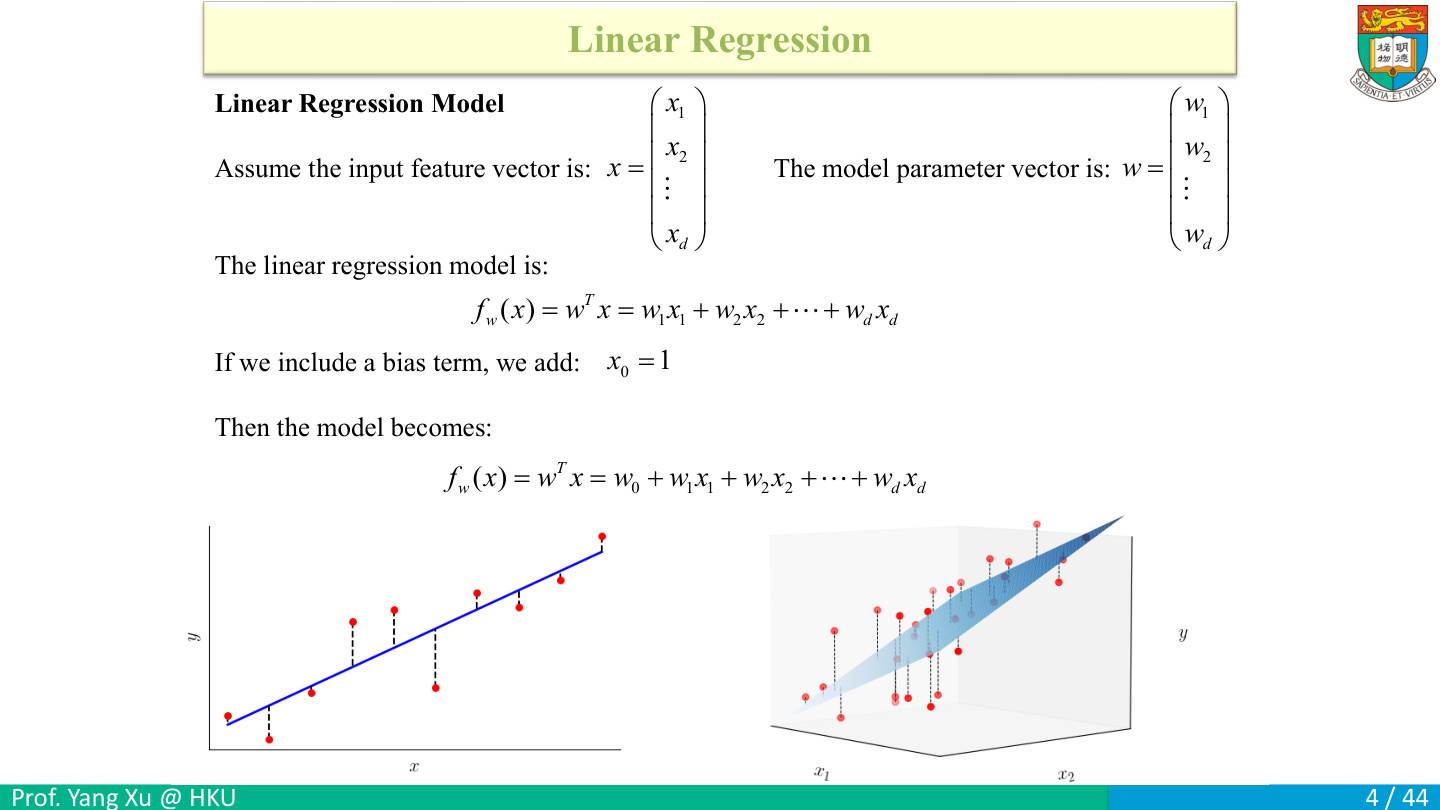
原模型f_w(x)=w^T x=sum_j w_j x_j。x和w均d维,内积输出标量。加入x_0=1就可把偏置w_0一起写进扩展向量,成为w_0+sum_j w_j x_j。偏置不乘真实测量特征,表示所有输入为0时的基础预测。例子x=(2,3),w=(4,−1),w_0=5,预测5+8−3=10。若X中已含常数列,再另加一个偏置会冗余。
把转置T读成“列变行”。二维x=(x₁,x₂)ᵀ、w=(w₁,w₂)ᵀ时,wᵀx是1×2乘2×1,得到一个数w₁x₁+w₂x₂。加入偏置后,使用扩展输入(1,x₁,x₂)与扩展权重(w₀,w₁,w₂),现在内积有三项,但真实测量特征仍然只有两种。
逐项手算。取x₁=2、x₂=3、w₁=4、w₂=−1、w₀=5:第一项8,第二项−3,基础项5,总和10。若误把wᵀx理解为逐元素乘法,得到(8,−3)还不是最终预测,必须相加。自测所有真实输入为0,预测是多少?答案:有偏置时w₀;无偏置时强制为0,这正是偏置增加的表达能力。
生产线能耗模型
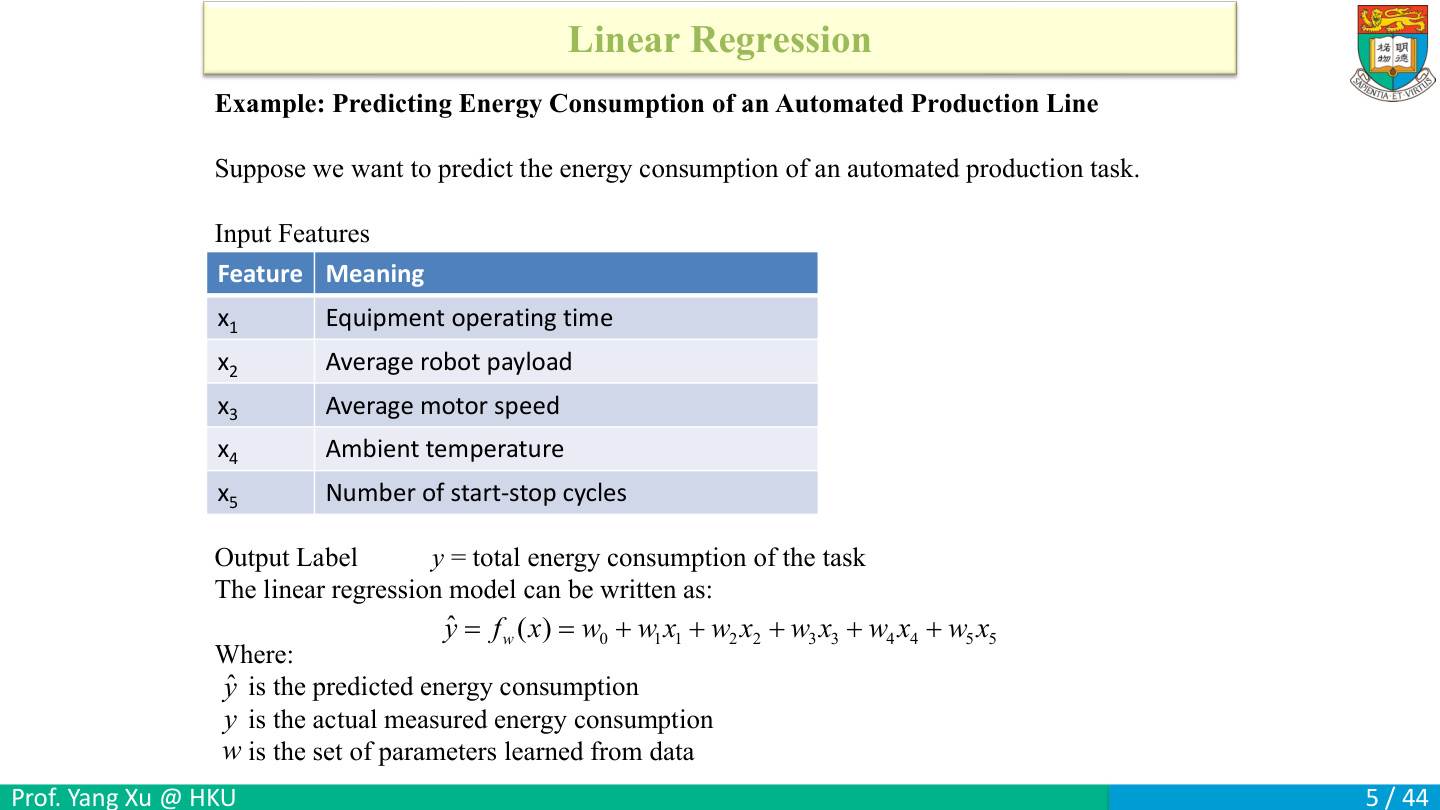
五个特征分别运行时间、平均载荷、平均电机速度、环境温度、启停次数,标签y为总能耗,预测y_hat=w_0+w_1x_1+…+w_5x_5。y是真实测量,y_hat是模型输出,二者不能混用。权重单位取决于对应特征单位,例如时间若从小时改分钟,数值权重应相应变化。例子固定其他特征后,运行时间增加1单位使预测增加w_1,但不能直接解释为因果效应。
一条生产任务记录包含五项特征,许多任务记录排在一起才形成数据集。每项乘权重时单位也要对:若x₁用小时、y用kWh,w₁对应kWh/小时;如果改用分钟,相同物理贡献要求w₁数值除以60。不能换了输入单位却照搬原权重。
算一遍。假定只看运行时间和启停,其余影响暂固定:ŷ=1+2t+0.1s,t=3小时、s=10次,预测1+6+1=8 kWh。真实值9时残差y−ŷ=1 kWh。自测ŷ和y哪一个是标签?答案:y是测量真值。
平方损失
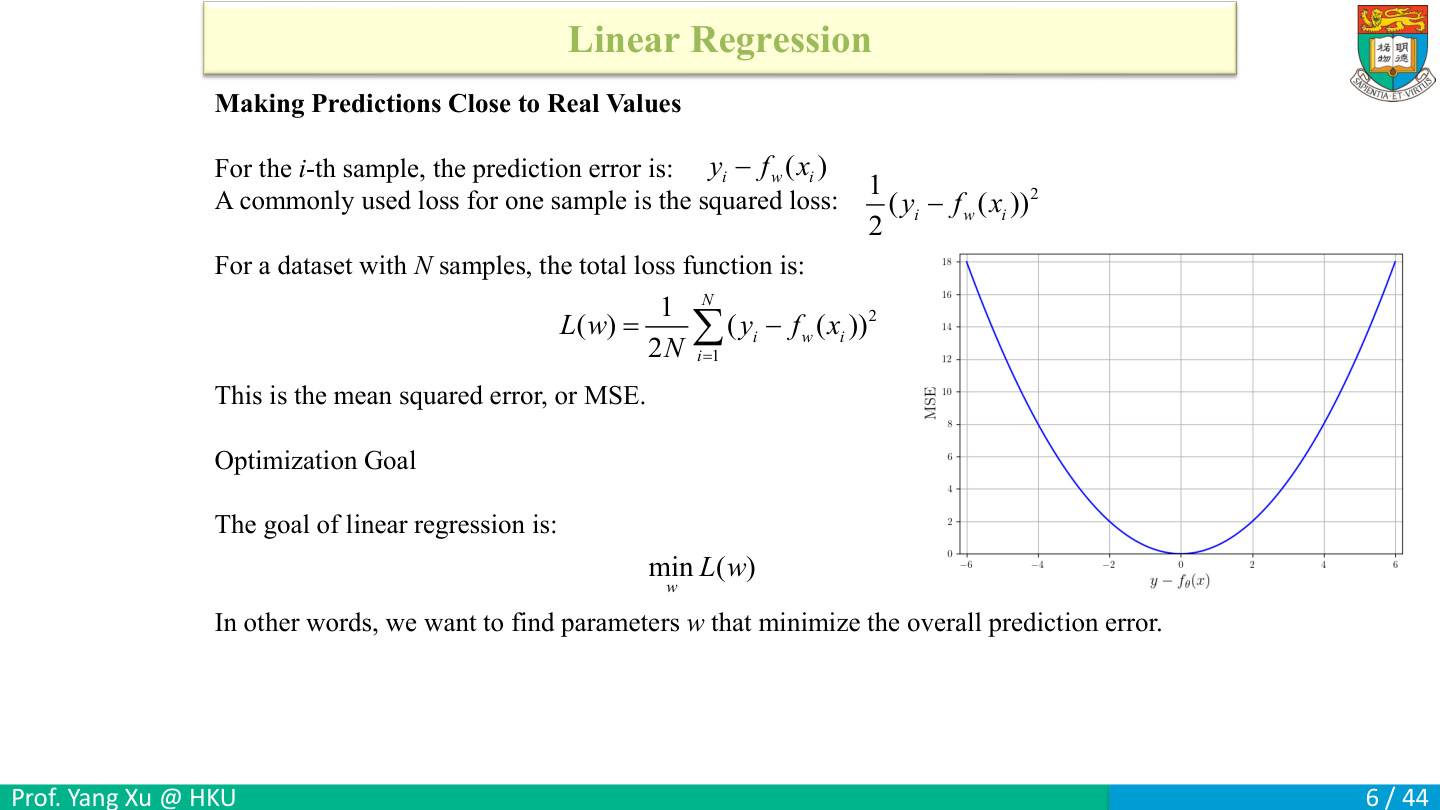
单条样本先算残差,再算平方损失。设 y=(3,5),ŷ=(1,6)。
| 样本 | 真实 yᵢ | 预测 ŷᵢ | 残差 yᵢ−ŷᵢ | 残差平方 |
|---|---|---|---|---|
| 1 | 3 | 1 | 2 | 4 |
| 2 | 5 | 6 | −1 | 1 |
残差平方和是 4+1=5。以 N=2 条样本平均得到普通 MSE=5/2=2.5。课件再乘 1/2,定义 L(w)=Σᵢ(yᵢ−f_w(xᵢ))²/(2N)=1.25。所有候选 w 的损失都乘相同的正数,最优 w 不变。求导时 1/2 正好消去平方产生的 2。
残差 2 和 −2 的平均值为 0,但平方和为 8,所以平方损失仍能看到两次预测偏差。若把同样的数据原样复制一份,平方和与 N 都加倍,平均损失不变。
设计矩阵与正规方程
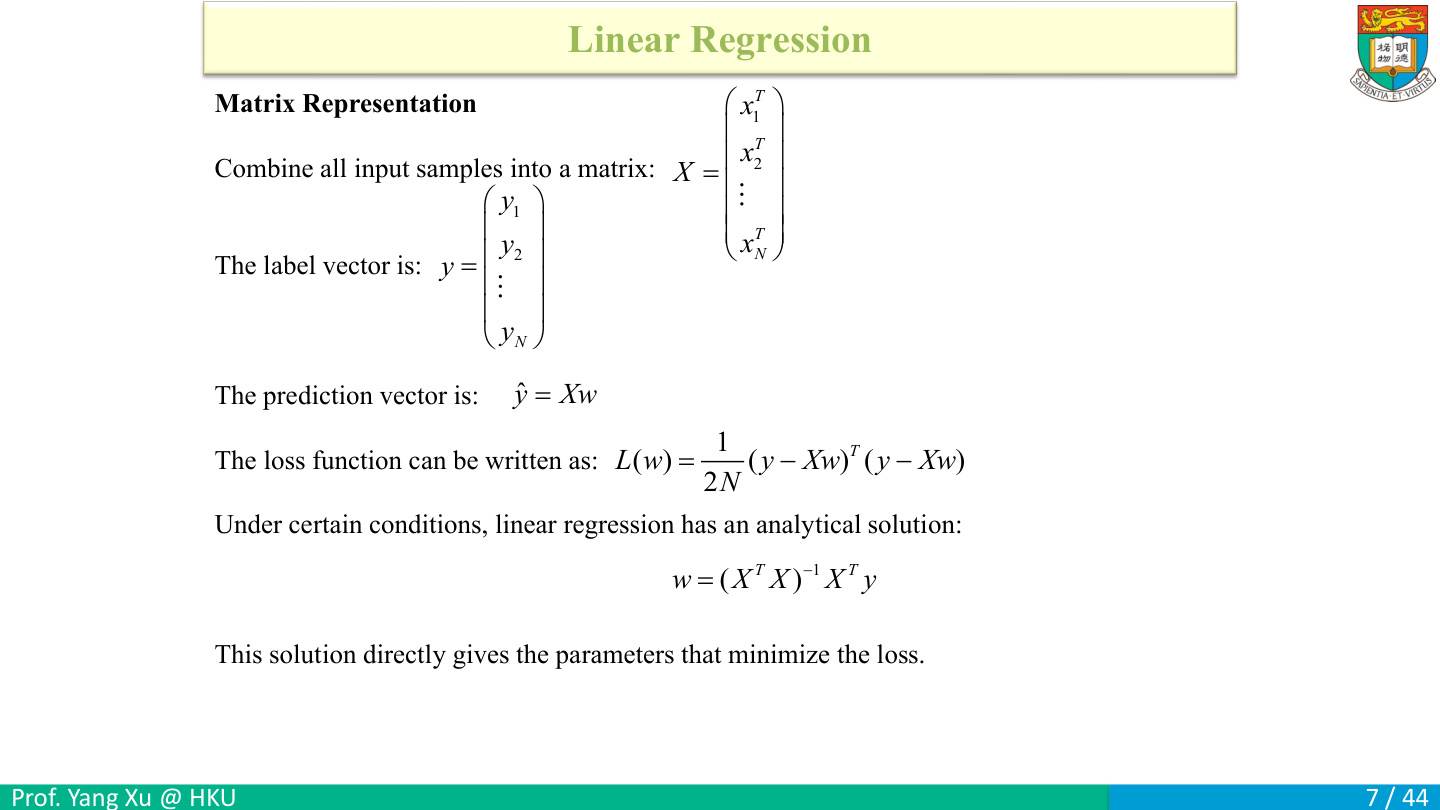
把每条样本按行排进X,就能一次算出所有预测。N是样本数,d是权重个数;若用一列常数1表示偏置,d也包括这一列。
以三条样本为例,原始输入t分别1、2、3,真实值y分别3、5、7,模型为ŷ=b+at。每行写成xᵢᵀ=(1,tᵢ),权重写成w=(b,a)ᵀ:
| 样本i | X的第i行 | 真实yᵢ | 该行乘w得到的预测 |
|---|---|---|---|
| 1 | (1,1) | 3 | b+a |
| 2 | (1,2) | 5 | b+2a |
| 3 | (1,3) | 7 | b+3a |
因此X=[[1,1],[1,2],[1,3]]为3×2,w为2×1,Xw为3×1;y=(3,5,7)ᵀ也为3×1。取w=(1,2)ᵀ,预测依次1+2=3、1+4=5、1+6=7。
残差r=y−Xw,半均方损失为L=rᵀr/(2N)。这里rᵀr是将每条残差平方再相加,维度为1×1的标量;上述w恰使三条残差全0。
下一步要从数据求w,而不是先猜w。正规方程为XᵀXw=Xᵀy:XᵀX是2×2,Xᵀy是2×1,所以解仍为2×1。X满列秩时,写为w=(XᵀX)⁻¹Xᵀy;下一页逐步推导它。
最小二乘解的每一步
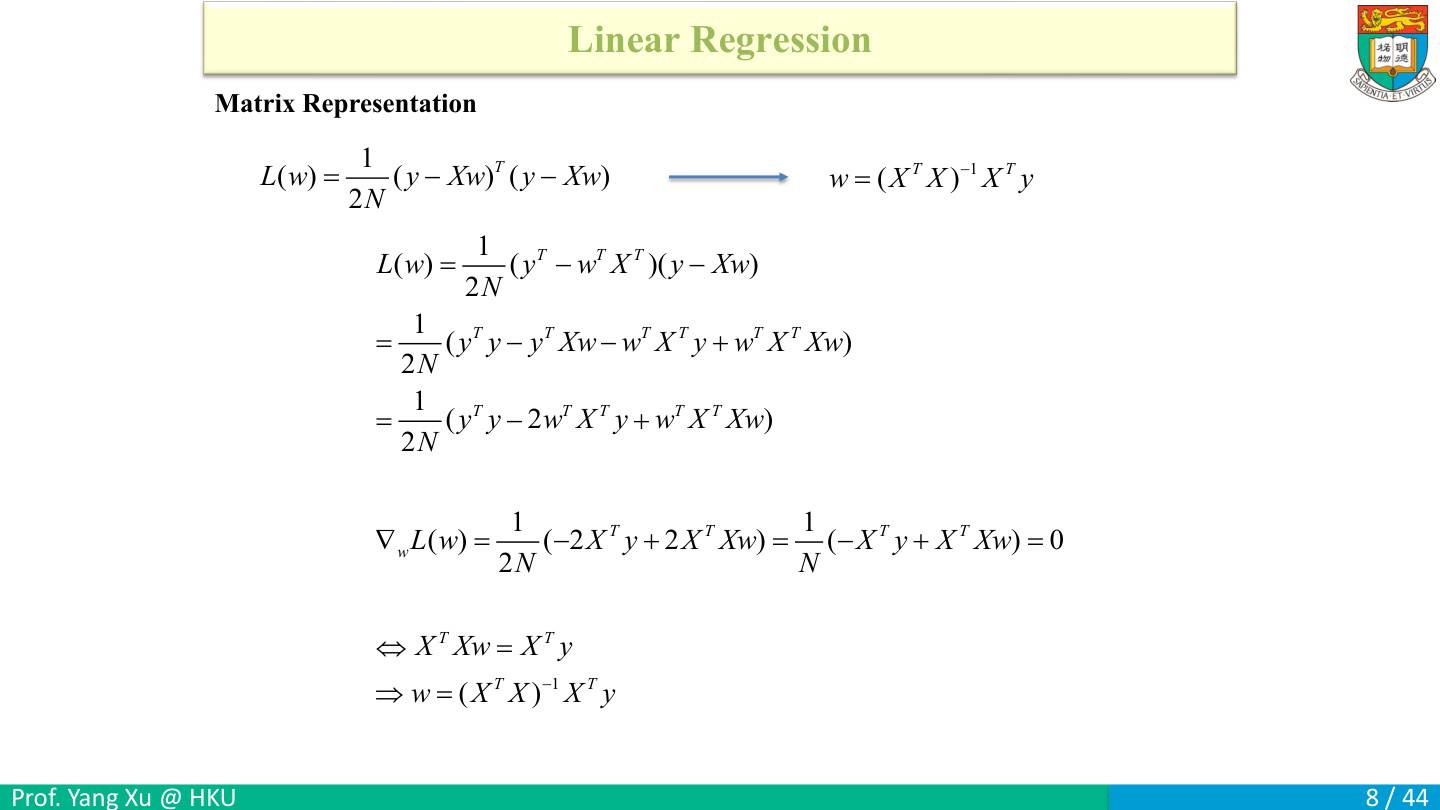
从L(w)=(y−Xw)ᵀ(y−Xw)/(2N)出发,目标是求使它最小的w。
先展开平方。转置后(y−Xw)ᵀ=yᵀ−wᵀXᵀ,相乘得到:
2N L=yᵀy−yᵀXw−wᵀXᵀy+wᵀXᵀXw。
yᵀXw是一个数,转置后数值不变,而转置乘积要倒序,所以(yᵀXw)ᵀ=wᵀXᵀy;两个交叉项相等,合为−2wᵀXᵀy。
再逐项求导。yᵀy与w无关,梯度0;−2wᵀXᵀy对w的梯度为−2Xᵀy。把A=XᵀX暂作简记,最后一项wᵀAw=ΣᵢΣⱼAᵢⱼwᵢwⱼ。对wₖ求导会收到两组贡献:wᵢ中的i=k给ΣⱼAₖⱼwⱼ,wⱼ中的j=k给ΣᵢAᵢₖwᵢ。A对称,这两组相同,合为2(Aw)ₖ,因此梯度为2XᵀXw。
除回2N,得到∇L=(XᵀXw−Xᵀy)/N。令它为0,乘N并移项,就是XᵀXw=Xᵀy;可逆时左乘(XᵀX)⁻¹得到正规方程解。
用前页数据算到底。XᵀX的三项分别为3个1相加得3、1+2+3=6、1²+2²+3²=14;Xᵀy的两项为3+5+7=15、1×3+2×5+3×7=34。因此:
3b+6a=15;6b+14a=34。
第一式乘2得到6b+12a=30,用第二式减它得2a=4,所以a=2;代回3b+12=15得b=1。平方损失是凸函数,满列秩时这个解是唯一全局最小点。
满列秩与岭修正
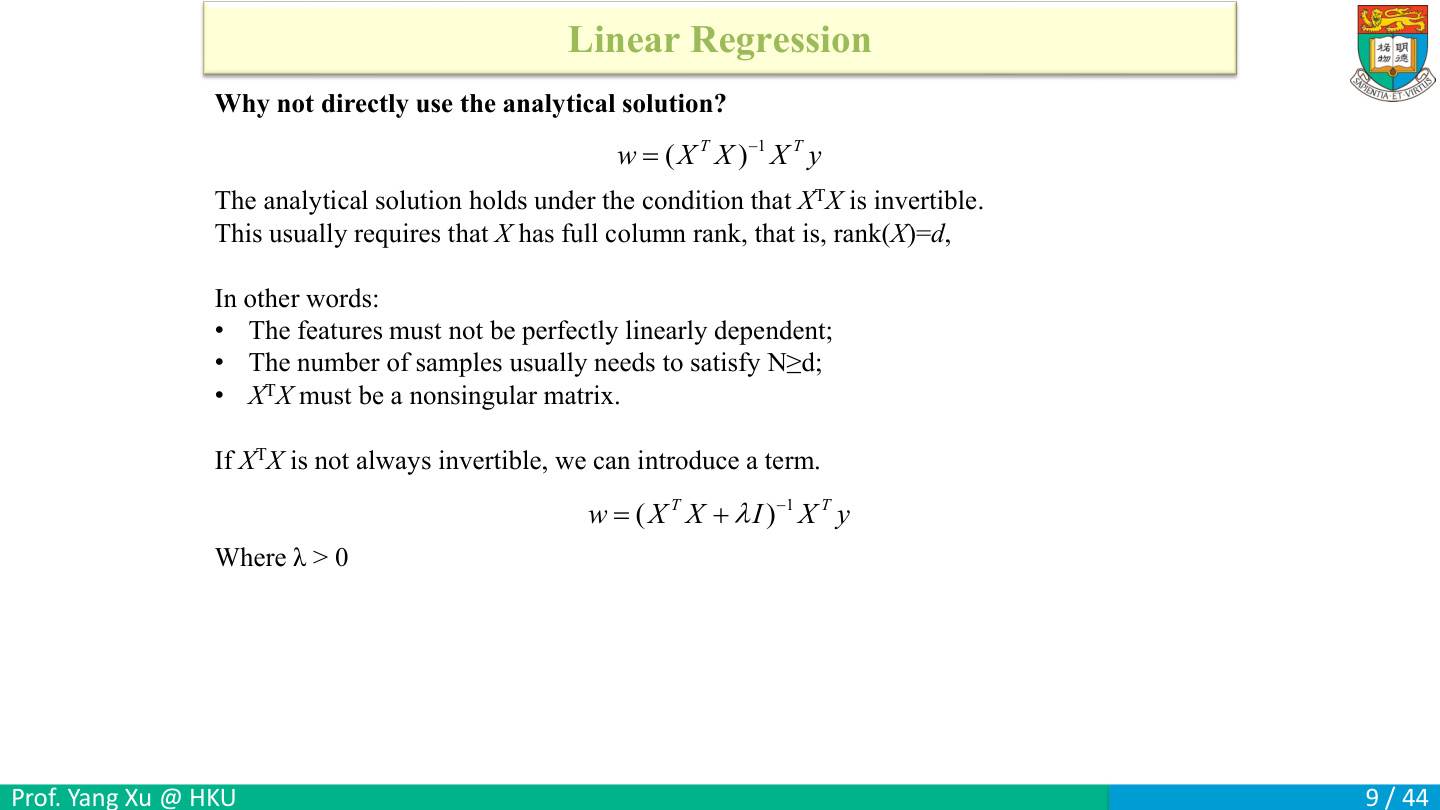
XᵀX 可逆的条件是 X 满列秩,也就是 X 的 d 列线性无关。样本数 N≥d 只是必要条件。以 X=[[1,1],[2,2]] 为例,虽然 N=d=2,但两列一样,预测只取决于 w₁+w₂。
取 y=(3,6)ᵀ。w=(1,2)ᵀ 和 w=(0,3)ᵀ 都给出 Xw=(3,6)ᵀ,都能把平方误差降到 0。矩阵也能解释原因:XᵀX=[[5,5],[5,5]],两行相同,行列式是 5×5−5×5=0,所以没有普通逆。
加入 L₂ 罚项后,正规方程左边改为 XᵀX+λI。令 λ=1,本例得到 [[6,5],[5,6]],行列式 36−25=11,因而可逆。数据原先无法判定两列应各分多少权重,岭回归按新的优化目标给出唯一选择。第10–12页分别解释为何原矩阵的特征值非负、加 λ 为什么有效,以及 λI 如何从求导中出现。
X转置X为何半正定
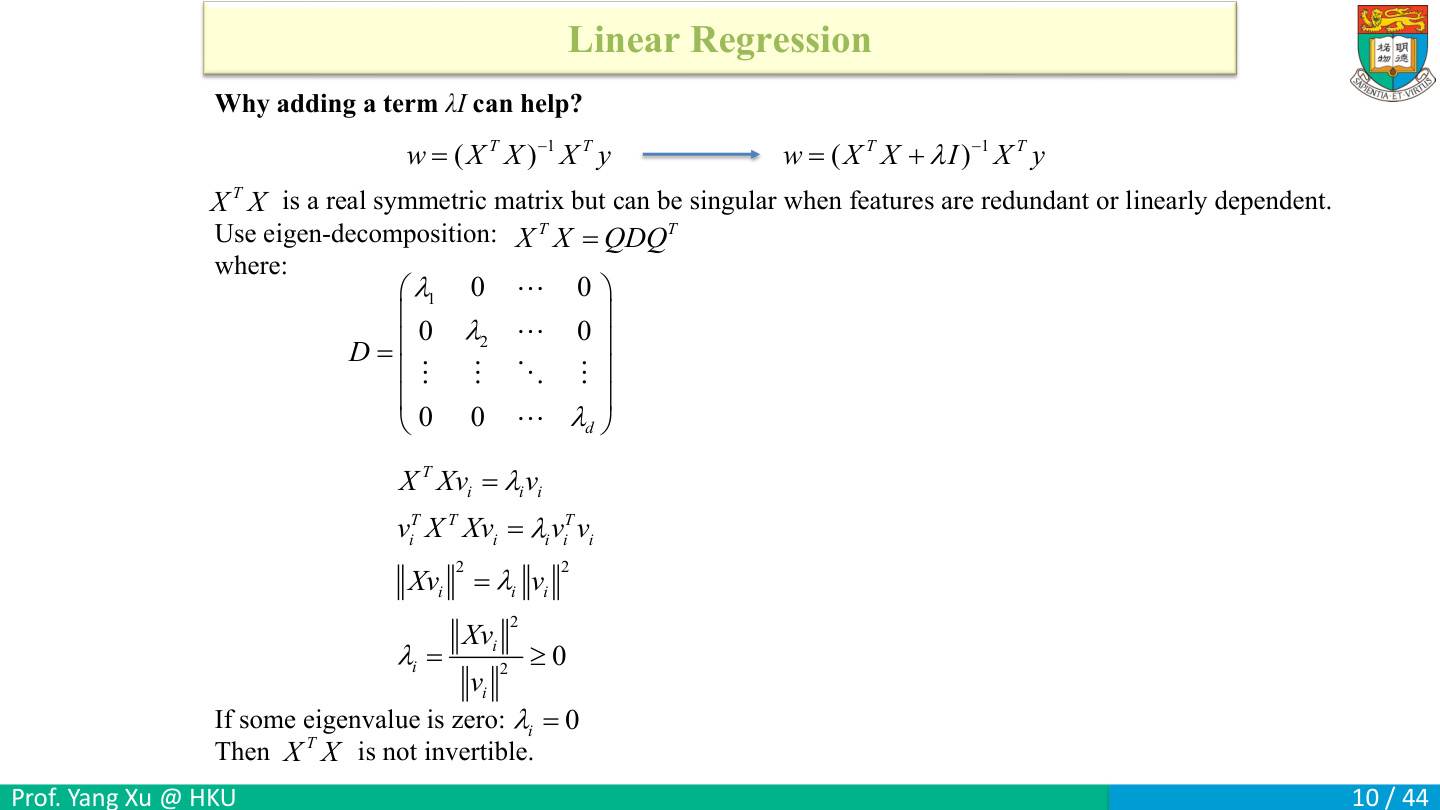
对实对称X^TX做特征分解QDQ^T。若v为非零特征向量、特征值mu,则v^TX^TXv=mu v^Tv。左边=(Xv)^T(Xv)=||Xv||²≥0,除||v||²>0得mu≥0。若某特征值0,对应方向被压成0,无法逆向恢复,因此矩阵不可逆。这里mu是特征值,避免和正则强度lambda混名。
从定义证明比背“半正定”容易。任取向量v,先算u=Xv,那么vᵀXᵀXv=uᵀu=Σuᵢ²,绝不会负。这就叫半正定:某些非零v可能仍给0,例如v正好在X的零空间。若v是特征向量,再用XᵀXv=μv,便得μ||v||²=||Xv||²≥0,因为||v||²>0,所以μ≥0。
练一练。X=[[1,1],[2,2]]、v=(1,−1)ᵀ,Xv=(0,0)ᵀ;对应μ=0。为什么会不可逆?答案:该方向被压为0,无法从结果恢复它。这里μ是为避免重名而写的特征值,课件用λᵢ;加到矩阵上的正则λ是另一个量,不能把下标漏掉混为一谈。
对称性也可直接核查:(XᵀX)ᵀ=Xᵀ(Xᵀ)ᵀ=XᵀX。正定与半正定不同:正定要求每个非零v都给严格正值;只要存在一个非零方向给0,就只能保证半正定而非正定。
加lambda I为何可逆
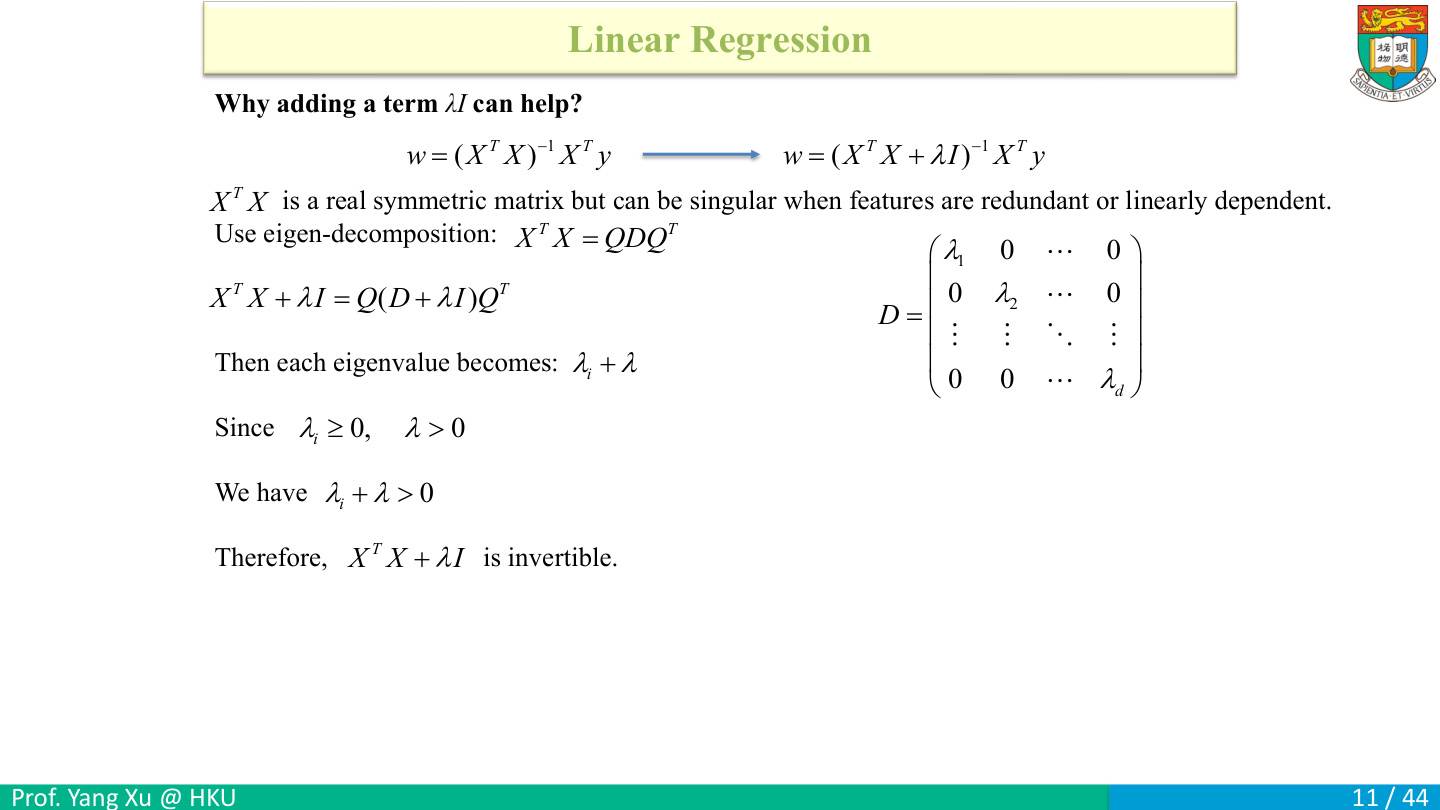
设第10页分解得到 XᵀX=QDQᵀ,D 的对角线上是 μ₁,…,μ_d,均不小于 0。因为 Q 正交,QQᵀ=I,所以:
XᵀX+λI = QDQᵀ+λQQᵀ = Q(D+λI)Qᵀ。
中间的 D+λI 给每个特征方向的缩放倍数加 λ。若原来的两个倍数是 0 和 5,λ=1 后就是 1 和 6,逆变换对应乘 1 和 1/6。一般地,λ>0 时每个 μⱼ+λ 都严格为正,因此矩阵正定且可逆,原来的特征向量可以继续使用。
单位矩阵只在主对角线上是 1。因此 diag(0,5)+I=diag(1,6)。用第9页的 [[5,5],[5,5]] 代入,得到 [[6,5],[5,6]],非对角的两个 5 保持原样。
L2正则到岭回归
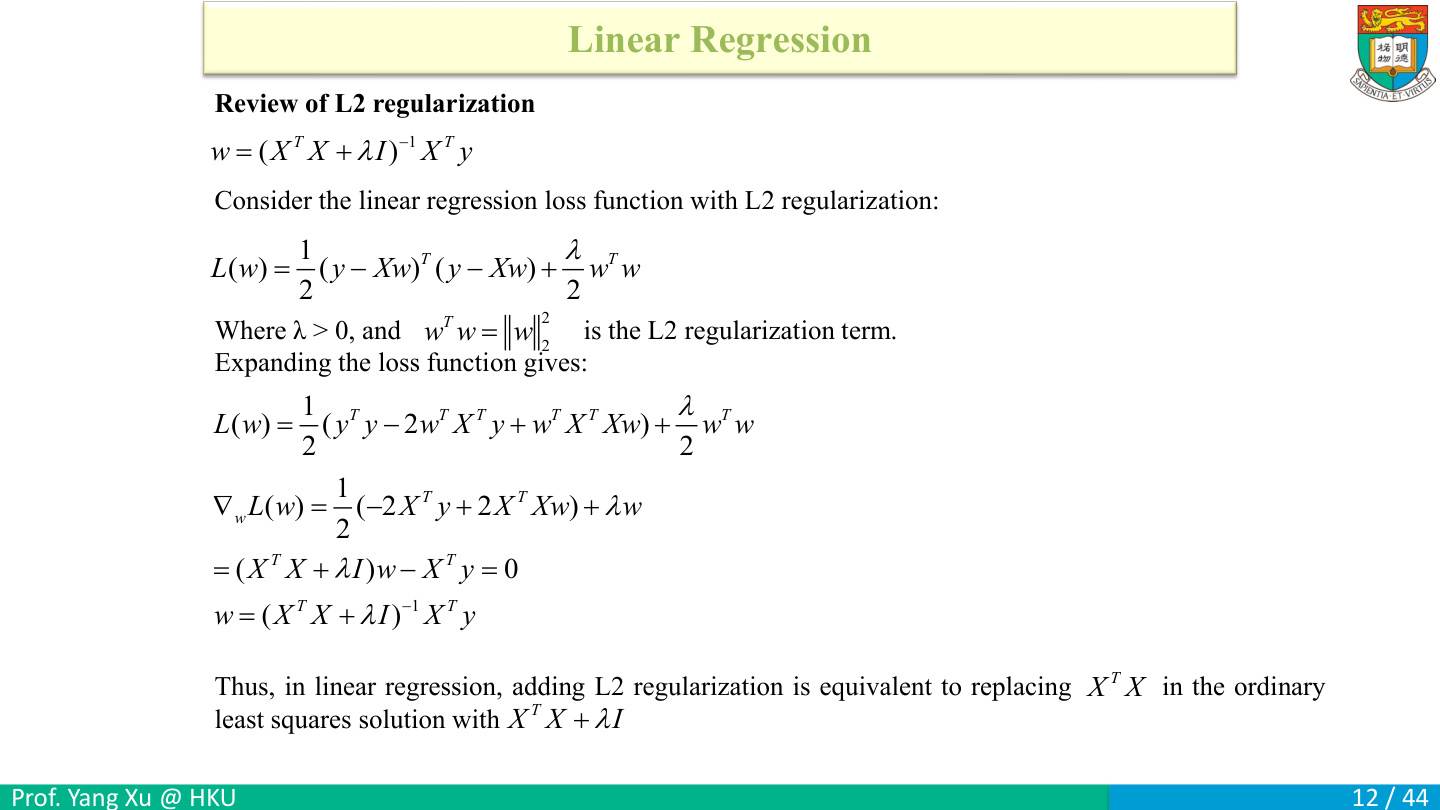
岭回归目标在这里采用总和形式:
L(w)=||y−Xw||²/2+λ||w||²/2。
先对数据项求导。将平方展开为[yᵀy−2wᵀXᵀy+wᵀXᵀXw]/2,三项梯度分别为0、−Xᵀy、XᵀXw,所以数据梯度是Xᵀ(Xw−y)。
再对惩罚求导:||w||²=w₁²+…+w_d²,每项λwⱼ²/2的偏导是λwⱼ,排成向量λw。两部分相加并令0:
XᵀXw−Xᵀy+λw=0,即(XᵀX+λI)w=Xᵀy。
λ>0时得到w=(XᵀX+λI)⁻¹Xᵀy。这解释了λI为何出现:它来自L2惩罚的梯度。
算一遍:一维目标(w−3)²/2+λw²/2,λ=2时导数(w−3)+2w=0,解w=1,较无惩罚的3收缩。
若数据项改为平均损失||y−Xw||²/(2N),但惩罚仍是λ||w||²/2,梯度方程乘回N后会出现NλI。因此比较λ前要统一总和或平均的约定。这里惩罚完整w;若保留截距不受惩罚,则对相应坐标的惩罚设为0。
解析解的计算成本
自动化中的传感器、PLC、机器人、视觉、能耗数据量大,特征多时矩阵运算昂贵。X^TX需存d×d量,求解成本随维度上升;不是“有公式”就一定最快。实际数值实现通常解线性方程或用矩阵分解,比显式构造逆更稳定。
把计算成本拆开:存X需要约Nd个数,构造XᵀX需要约Nd²级别计算并存d²个数,求解该d维线性系统还需要额外代价。这里N是样本数量,d是特征维度,二者增加会卡在不同地方。对于大型稀疏或流式数据,迭代方法可能更合适;小问题上直接解线性方程也可能很好。
练一练。d=10000时,d²=一亿个数;若每个用8字节,单这个稠密矩阵约8亿字节,不含其他数据。它帮助理解“维度高”为什么昂贵,而不是精确预测某台机器耗时。所谓解析解只是数学表达清楚,实际编程通常避免显式求逆,使用稳定分解或方程求解;不能把有闭式公式等同没有计算成本。
例如N=1000、d=2与N=2、d=1000的原矩阵都只有2000项,但后者的XᵀX有一百万项,前者只有4项。因此除了Nd总量,还要看特征维度d,因为正规方程的矩阵是d×d。
线性回归梯度下降
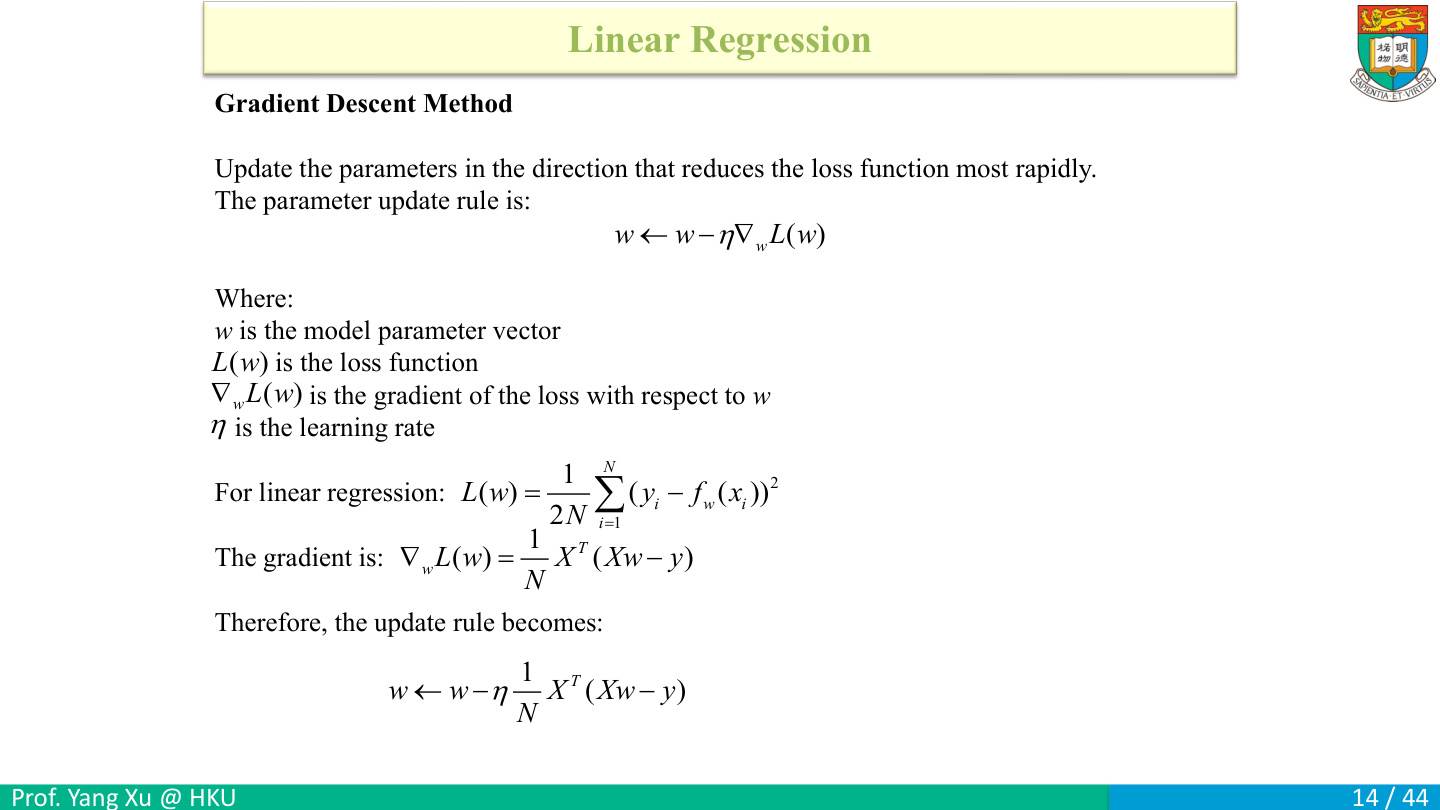
线性回归的平均损失梯度是 g=Xᵀ(Xw−y)/N。一次梯度下降先用旧的 w 预测,再按每个特征分别汇总残差,最后令 w_new=w−ηg。
沿第7页数据,模型为 ŷ=b+at,初始 (b,a)=(0,0),样本 (t,y) 依次为 (1,3)、(2,5)、(3,7)。
| 操作 | 算式与结果 |
|---|---|
| 预测 | ŷ=(0,0,0)ᵀ |
| 残差 | r=ŷ−y=(−3,−5,−7)ᵀ |
| 截距梯度 | g_b=[1×(−3)+1×(−5)+1×(−7)]/3=−5 |
| 斜率梯度 | g_a=[1×(−3)+2×(−5)+3×(−7)]/3=−34/3 |
| 同时更新 | 取 η=0.1,b_new=0.5,a_new=17/15≈1.133 |
首轮最后一条样本的新预测是 0.5+3×17/15=3.9,比旧预测 0 更接近 7。矩阵乘法 Xᵀr 做的就是表里两次「对应项相乘再求和」。下一轮要先用新参数重新计算三条残差。
休息页
休息时把线性回归连成四步:ŷ=Xw,残差r=ŷ−y,梯度g=Xᵀr/N,更新w←w−ηg。再检查XᵀX何时可逆,以及L2惩罚为何给正规方程加上λI。
转入Logistic
接下来把目标从温度85°C这样的连续数值,换成“过热=1、正常=0”。线性分数仍为wᵀx,Sigmoid把它变成概率,负对数损失再指导参数更新。
硬阈值的梯度问题
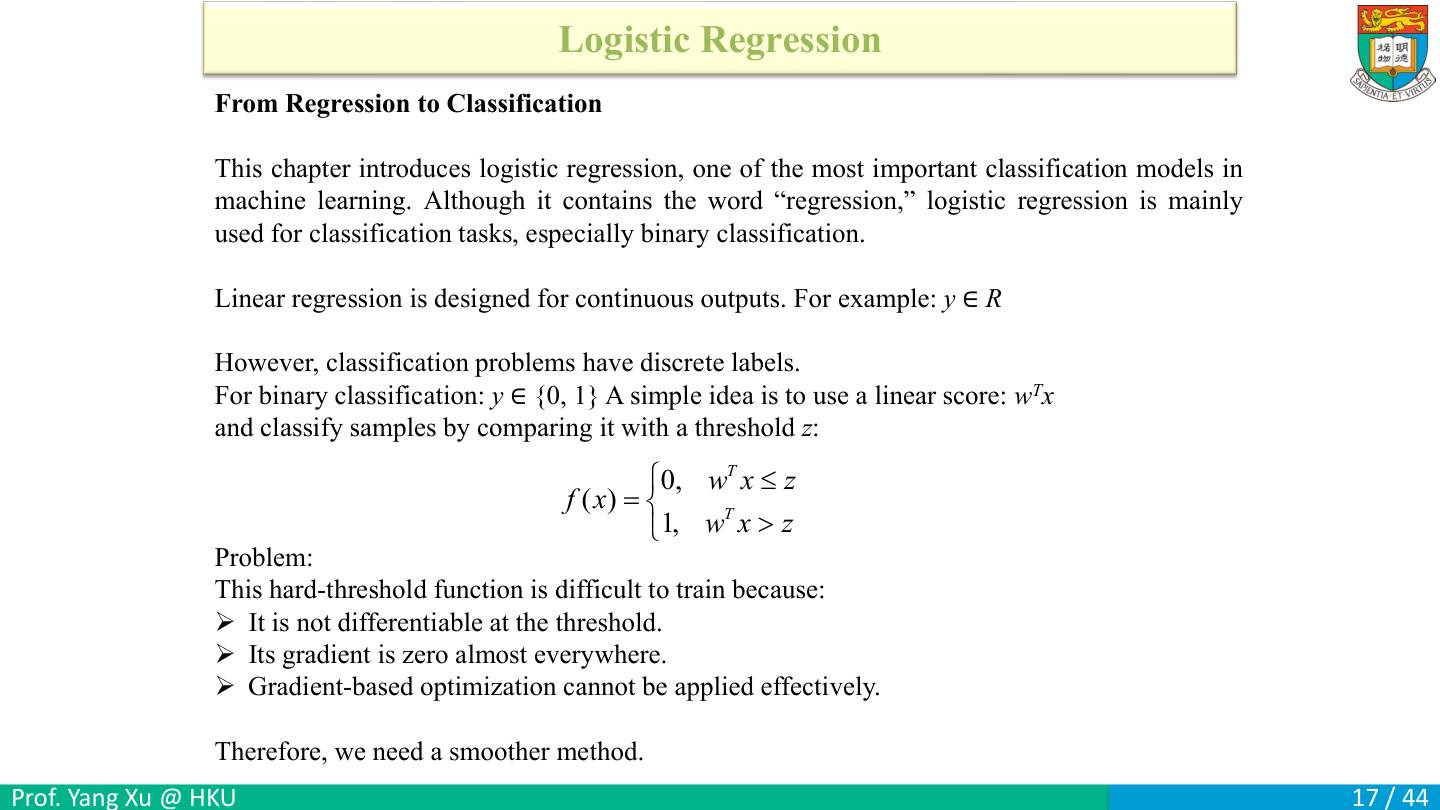
把线性分数 z 变成类别的硬阈值像开关。以 0 为门槛,z<0 时固定输出 0,z>0 时固定输出 1。这两段的斜率都是 0,门槛处又发生跳变,所以直接用硬输出做梯度训练时,很难知道该如何改参数。
| 真实标签 y | 分数 z | 硬分类 | Sigmoid 正类概率 p | 负对数损失 −ln p |
|---|---|---|---|---|
| 1 | −2.0 | 0 | 约 0.119 | 约 2.127 |
| 1 | −1.9 | 0 | 约 0.130 | 约 2.039 |
这两个预测都错,但第二个已略微接近真实正类,平滑损失能反映这个变化。训练按「分数 → 概率 → 损失 → 参数更新」进行;判断类别时再将概率与阈值比较。
概率视角
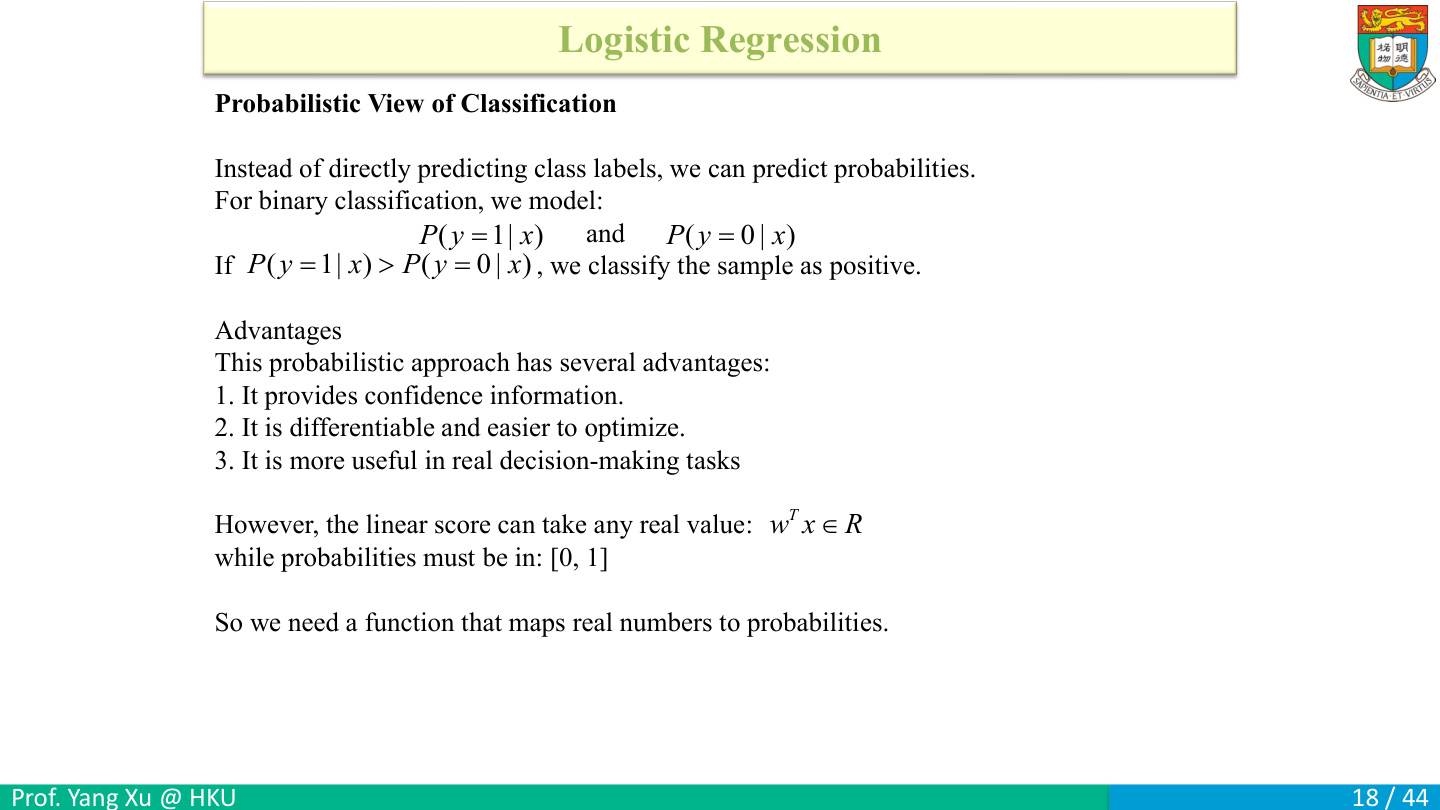
概率分类先预测P(y=1|x)与P(y=0|x)。竖线“|x”读作“已知输入x”;正负两类互斥且包含全部可能标签,所以只需给出正类概率p,负类概率就是1−p。
例如p=0.8时,两类概率为(0.8,0.2)。按“概率较大的类别获胜”作决定,比较p>1−p,两边加p得2p>1,再除2得p>0.5,这就是默认阈值0.5的来源。
线性分数z=wᵀx可以是任意实数,例如2、−3或100;概率则在0到1之间。Sigmoid负责将分数变成合法概率,分数2经过它会得到约0.881。
概率表达的是模型对类别的不确定性。若一个校准良好的模型给很多样本都报0.8,那么这一组样本里应约80%为正类;概率校准关注这类频率是否相符。错误成本不同时,决策阈值还可以结合验证结果另选。
Logistic函数及导数
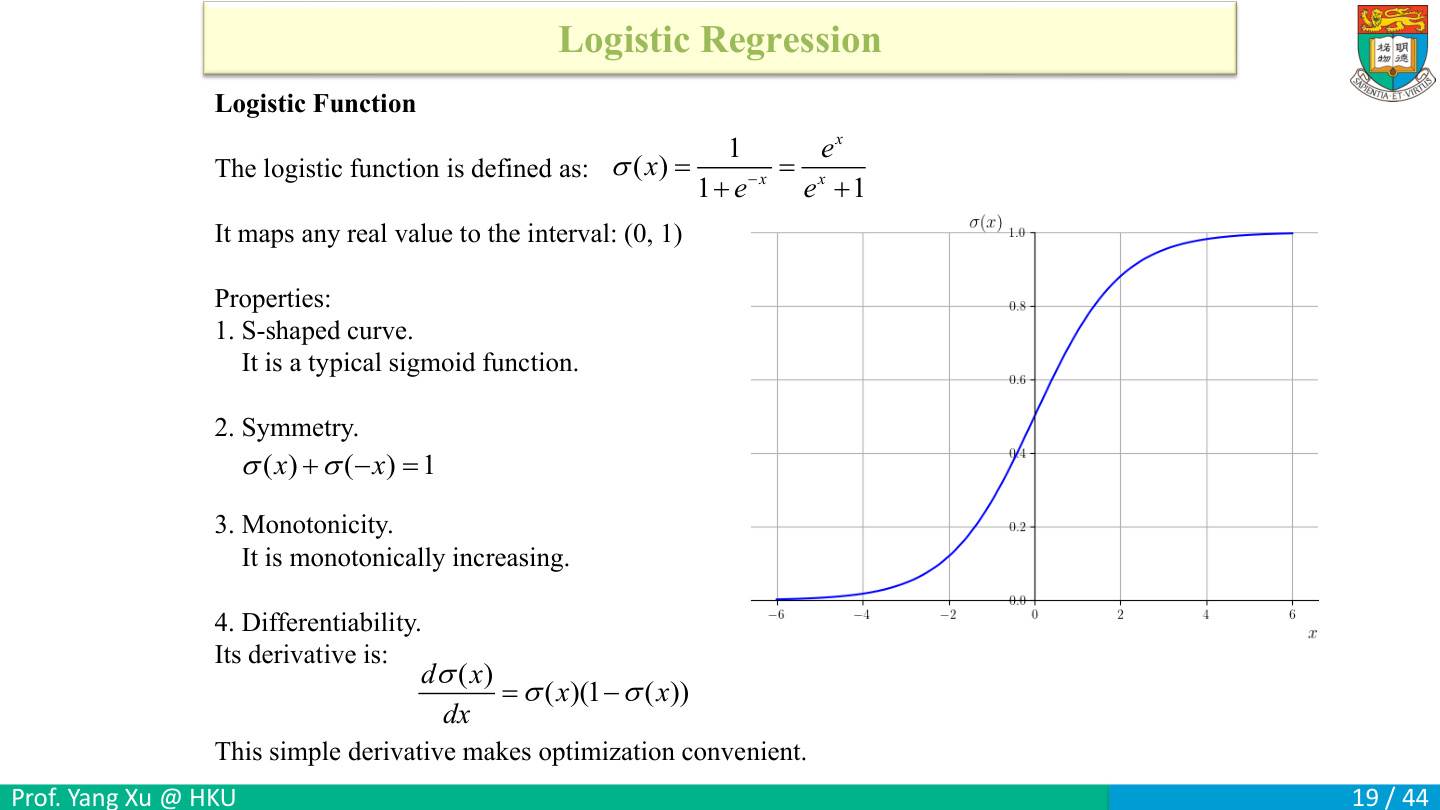
原函数sigma(z)=1/(1+exp(−z))=exp(z)/(1+exp(z)),范围(0,1),单调递增,sigma(z)+sigma(−z)=1。求导先把分母看整体:sigma'=exp(−z)/(1+exp(−z))²;拆成[1/(1+exp(−z))]×[exp(−z)/(1+exp(−z))],即sigma(1−sigma)。在z=0,概率0.5、导数0.25;两端趋于饱和,导数接近0。
完整求导可写成σ(z)=(1+e^(−z))^(−1)。外层导数是−(1+e^(−z))^(−2),内层e^(−z)的导数是−e^(−z),两个负号相乘得正,故σ'=e^(−z)/(1+e^(−z))²。再拆成σ(z)与1−σ(z)的乘积,得到课件结论。导数始终正说明单调递增。
算一遍。z=ln3时e^(−z)=1/3,σ=1/(1+1/3)=3/4,导数(3/4)(1/4)=3/16。z=−ln3时概率1/4,与前者相加1。自测z=0为什么是S形中点?答案:e⁰=1,概率1/2,导数1/4,左右对称。实际实现极大正负z时还需稳定计算,不能把数学有限值与浮点溢出混淆。
Logistic模型与边界
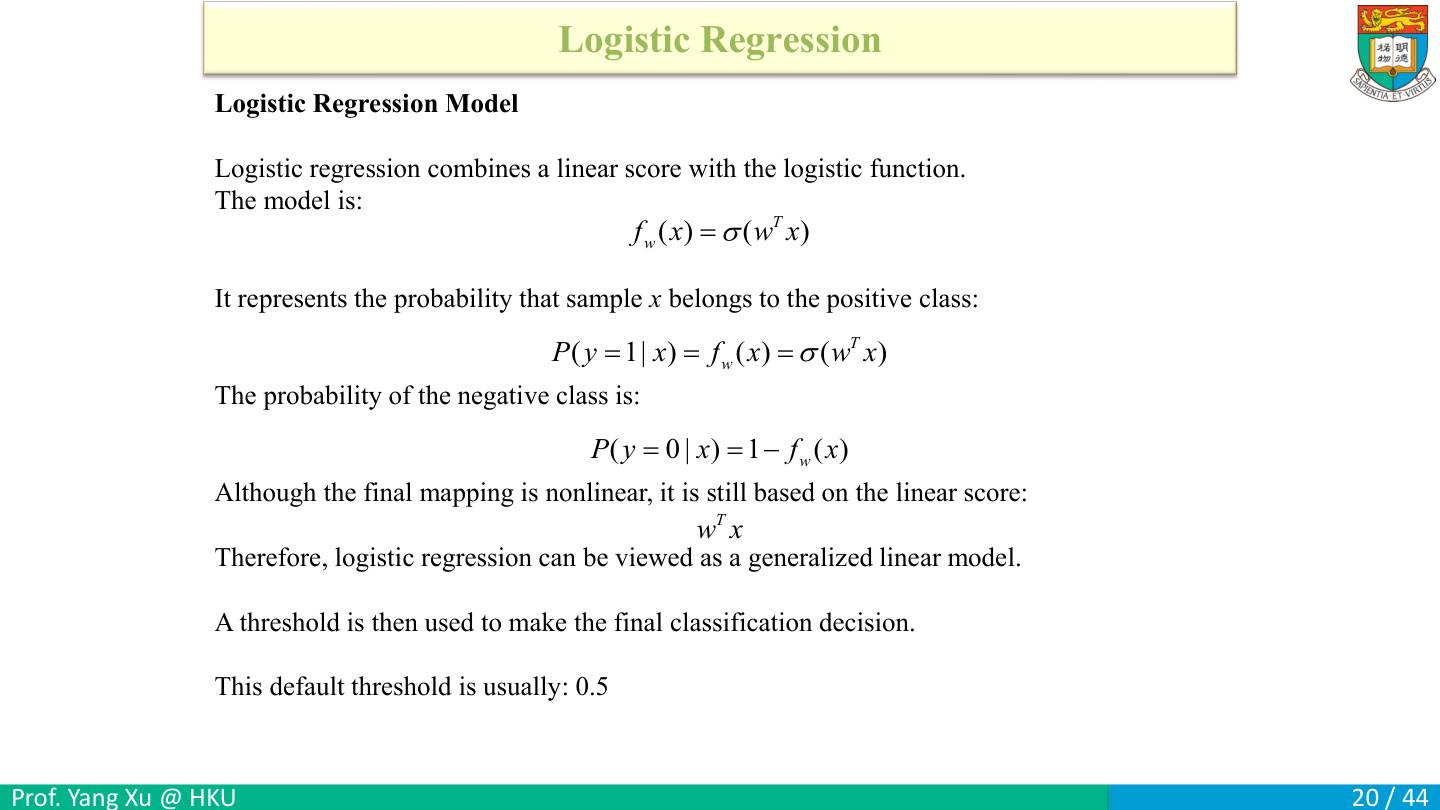
原模型p=sigma(w^Tx),P(y=0|x)=1−p,默认阈值0.5。由于sigma单调且sigma(0)=0.5,p≥0.5等价w^Tx≥0;若加入偏置就是w^Tx+b≥0。因此概率曲线非线性,但原特征空间的默认决策边界仍线性。w^Tx=ln3时p=3/(1+3)=0.75。
模型的两层计算要各自保留:先z=wᵀx+b,再p=1/(1+e^(−z)),最后按阈值输出类别。阈值0.5时,因为Sigmoid严格递增且σ(0)=0.5,只需要看z的正负;等式z=0定义一条线或更高维超平面。因此Sigmoid概率虽为非线性映射,默认决策边界在原始特征空间仍是线性的。
练一练。w=(1,−1)、b=0,点(3,1)的分数2、概率约0.881,默认判1;点(1,3)分数−2、概率约0.119,判0。边界x₁=x₂。如果数据是圆内一类圆外另一类,仅原始两维的线性分数通常不够,需要新的特征或更灵活模型;不能因为用了非线性Sigmoid就认为所有边界都能表示。
最大似然
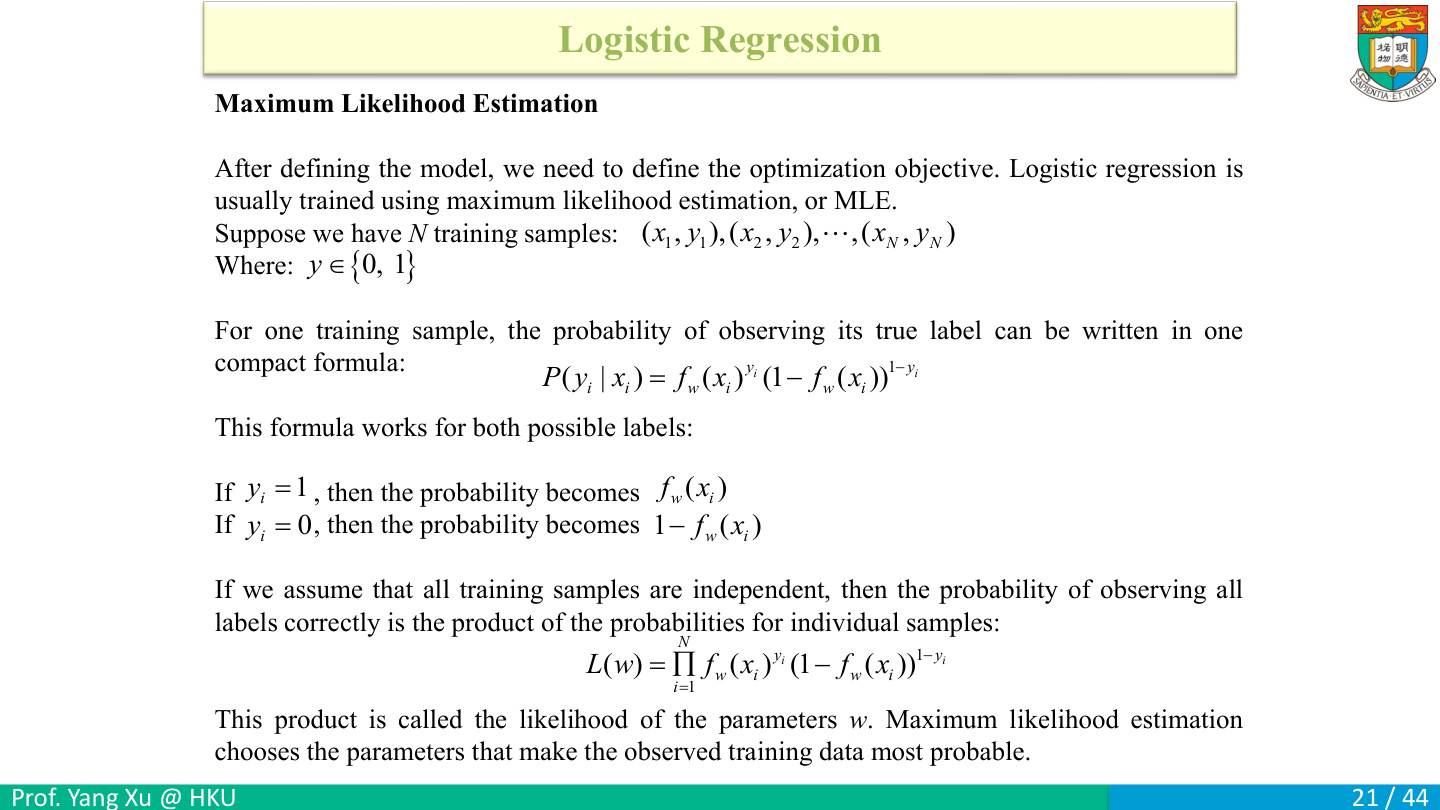
单样本P(y_i|x_i)=p_i^(y_i)(1−p_i)^(1−y_i)。当y_i=1,指数分别1和0,概率为p_i;当y_i=0,概率为1−p_i。假设给定特征与参数后样本标签独立,联合概率为各项乘积。似然把已观察数据固定、把w当变量,找使观察最可能的参数。两个真值为1的样本,模型概率0.8、0.6,联合0.48;不能将两项相加称联合概率。
把紧凑公式代入两种标签即可检验:y=1时p¹(1−p)⁰=p;y=0时p⁰(1−p)¹=1−p。这里p⁰=1,所以没有被选中的那一项消失。似然将已观察的x、y固定,把w当作可调整的自变量;比较不同w给这些标签分配的概率。贝叶斯推断进一步给参数引入先验分布。
算一遍。两标签为(1,0),模型正类概率(0.8,0.3),观察到这两标签的条件联合概率0.8×(1−0.3)=0.56;若另一模型(0.6,0.6),则0.6×0.4=0.24,前者在这批观测上似然更大。自测为何不能0.8+0.7?答案:两事件共同发生在此独立假设下取乘积,不是把互斥事件概率相加。
从乘积到交叉熵
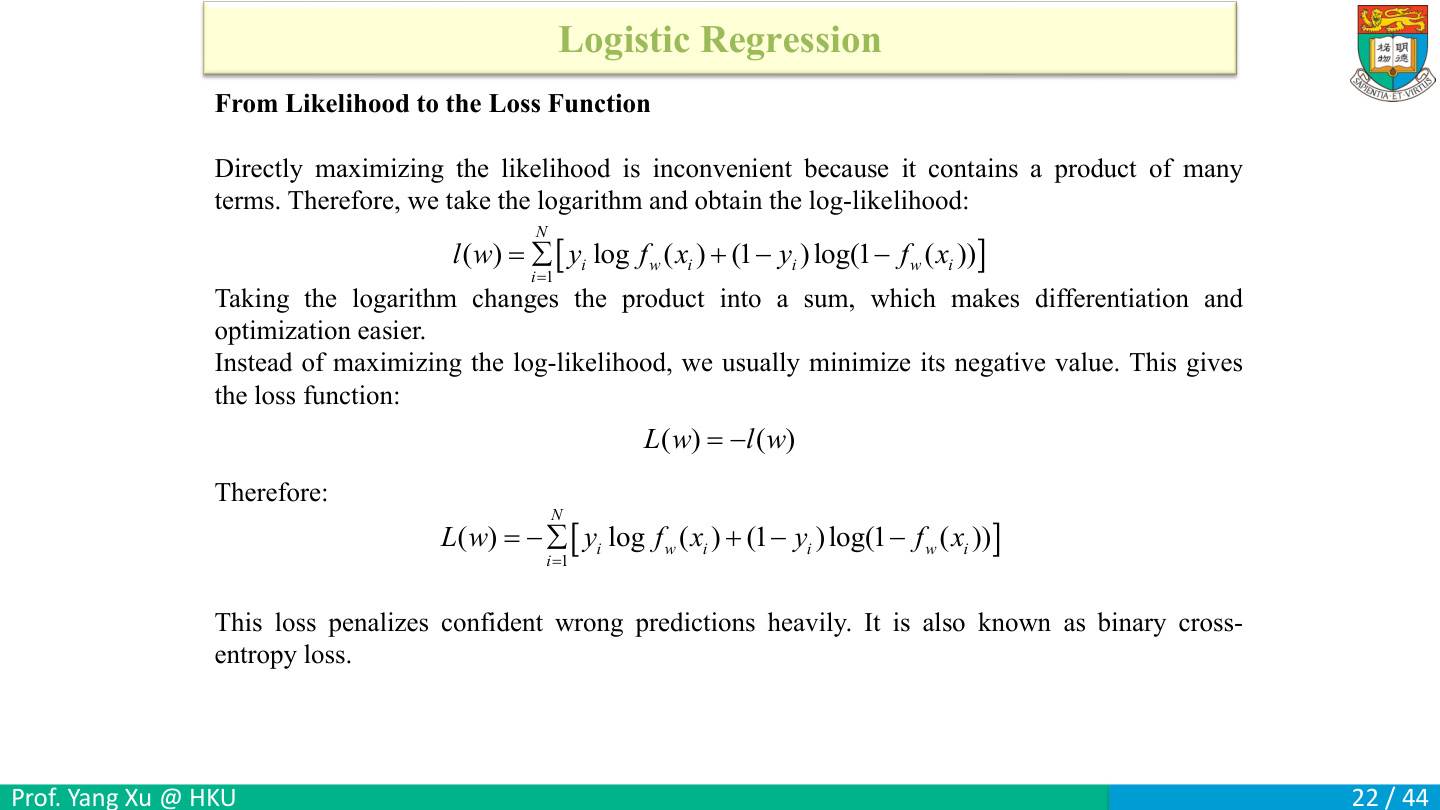
取log后,log乘积=sum log,得ell(w)=sum_i[y_i log p_i+(1−y_i)log(1−p_i)]。log严格递增,最大化原似然等价最大化ell;为统一最小化习惯,损失L=−ell。log概率≤0,负号使损失≥0。乘很多小概率易下溢,求log也更稳定。这里是总损失,若除N变平均损失,应同步调整学习率和正则尺度。
取对数时三条规则各用一次:log(ab)=log a+log b把样本乘积变求和;log(p^y)=y log p把指数移下来;log在正数上严格递增,所以最优w的位置不变。再乘−1,最大化就变最小化,便可沿用梯度下降。不要在最后一步忘记负号,否则会反着训练。
算一遍。上页似然0.56,负对数为−ln0.56≈0.580;逐项算−ln0.8−ln0.7≈0.223+0.357=0.580,两种算法一致。自测似然0.24的损失更大还是更小?答案:−ln0.24≈1.427,更大,所以最小负对数偏向似然0.56的模型。平均损失再除样本数,不会改变无正则时的最优位置,但梯度数值也随之缩放。
损失惩罚什么
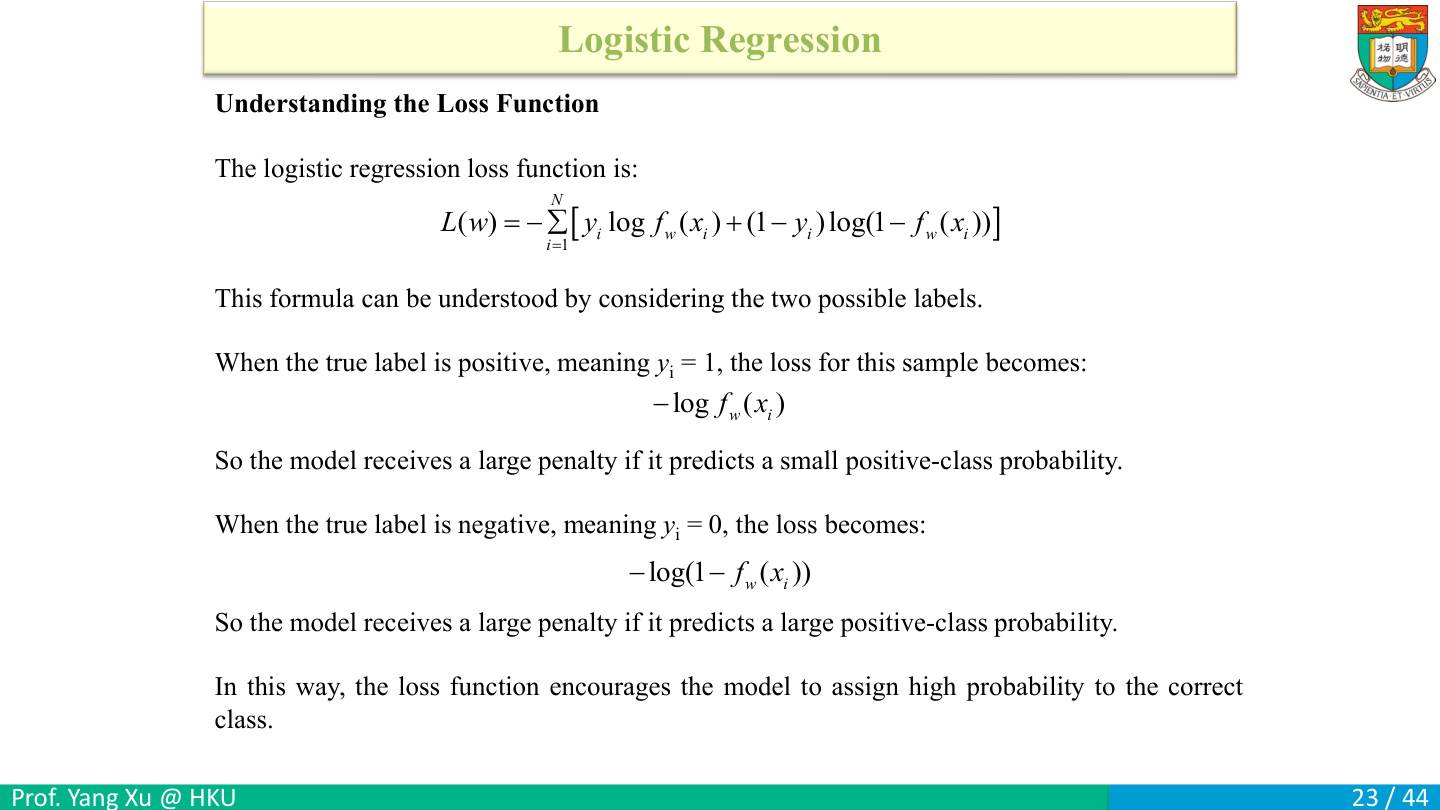
把模型分给真实标签的概率记作 q,损失就是 −ln q。真实标签 y=1 时,q=p;y=0 时,q=1−p。
| 模型给出的正类概率 p | y=1 时的损失 | y=0 时的损失 |
|---|---|---|
| 0.01 | −ln(0.01)≈4.605 | −ln(0.99)≈0.010 |
| 0.60 | −ln(0.60)≈0.511 | −ln(0.40)≈0.916 |
| 0.90 | −ln(0.90)≈0.105 | −ln(0.10)≈2.303 |
同一个 p=0.90,在真实正类上损失低,在真实负类上损失高。q 趋近 1 时损失趋近 0,q 趋近 0 时损失增长得很快。两个模型都判对时,损失还可区分它们给真类多少概率。
在代码里可直接从分数 z 算损失。y=1 时,代入 p=1/(1+e^(−z)) 得 −ln p=ln(1+e^(−z));y=0 时,1−p=1/(1+e^z),损失是 ln(1+e^z)。令 t=(1−2y)z,两式合为 ln(1+e^t)。t>0 时从括号里提出 e^t,得到 t+ln(1+e^(−t));t≤0 时直接计算。因此代码可以写成 max(0,t) + log1p(exp(-abs(t))),其中 log1p(v) 计算 ln(1+v)。指数的输入始终≤0,避免极端分数让指数溢出,或先求概率时舍入到 0 或 1。
梯度推导起点
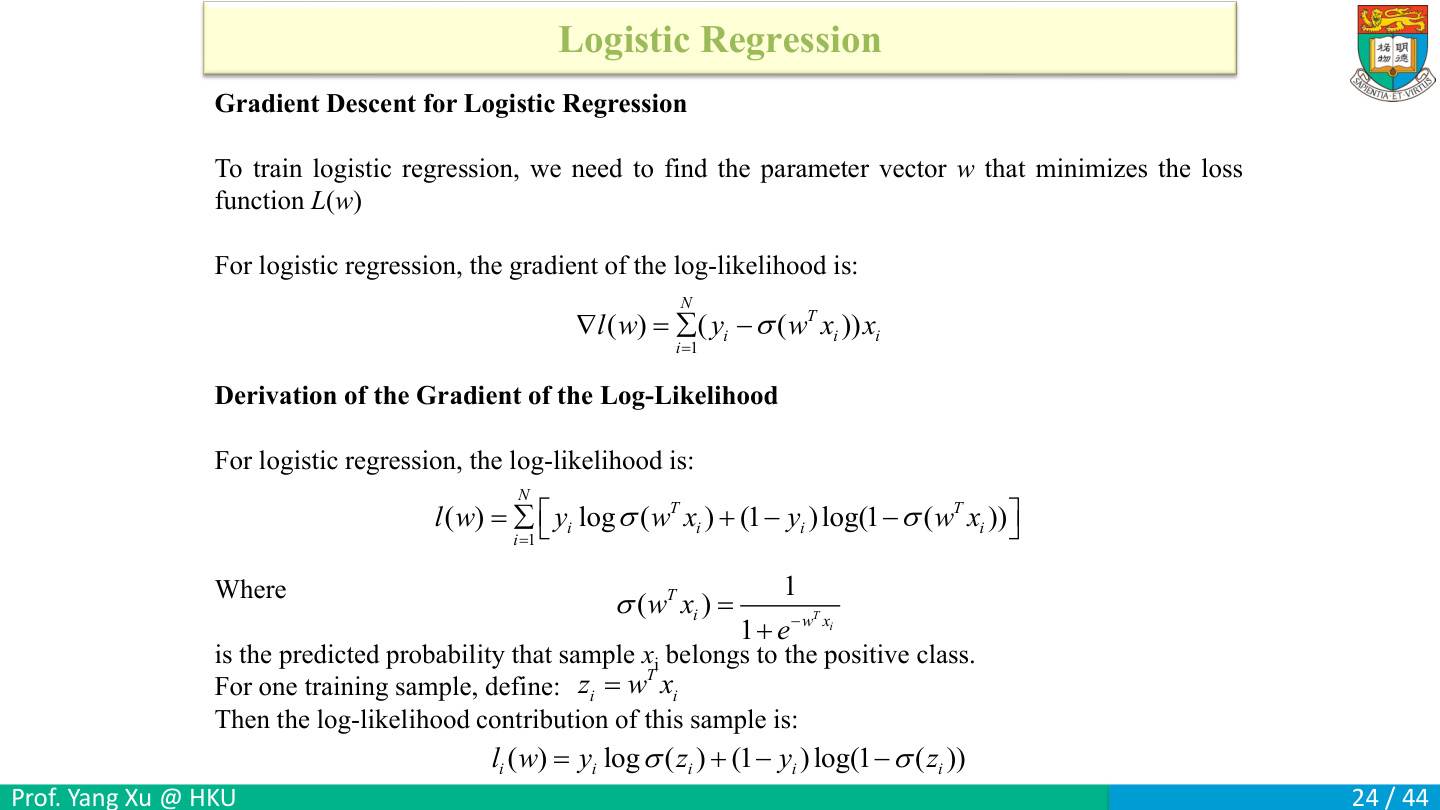
定义z_i=w^Tx_i,p_i=sigma(z_i),ell_i=y_i log p_i+(1−y_i)log(1−p_i),并给最终grad ell=sum_i(y_i−p_i)x_i。要理解结果,需要先对p求导,再乘dp/dz,再乘dz/dw,而非凭残差外形猜测。注意本页求的是对数似然的梯度,后面损失梯度符号相反。
给中间变量命名是为了避免一行塞进三层函数:w先影响zᵢ,zᵢ影响pᵢ,pᵢ再影响ℓᵢ。写成依赖链w→zᵢ=wᵀxᵢ→pᵢ=σ(zᵢ)→ℓᵢ=yᵢlog pᵢ+(1−yᵢ)log(1−pᵢ)。最后对w求导,必须沿链把每一步变化率相乘,再汇总所有样本。
练一练。w有d个分量,z与p各有几维?答案:对单条样本,z和p都是标量,ℓ也是标量;∇wℓ必须是d维向量。梯度要与w同维,最后保留xᵢ这个向量因子,就能逐项给出每个参数的偏导。又因为此页求对数似然的梯度,它与后面负对数损失的梯度差一个负号,不能看到熟悉的y−p便盲目套更新。
链式法则每一步
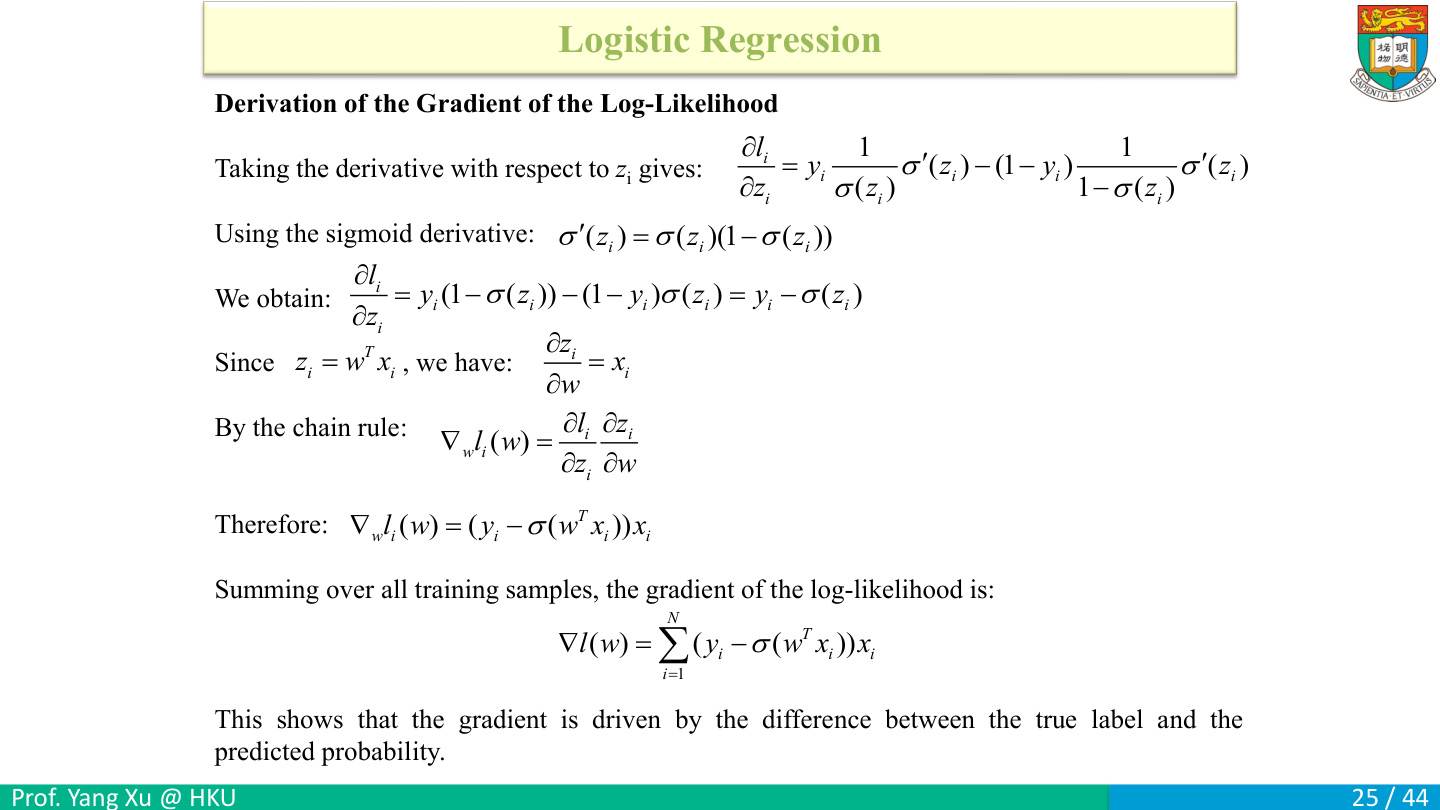
先只看一条样本,把下标i暂时省掉。x是已知输入向量,y是0/1标签,w是权重;三个中间量依次为:
w → z=wᵀx → p=σ(z) → ℓ=y ln p+(1−y)ln(1−p)。
ℓ是对数似然。要知道w怎样影响ℓ,沿这条链把每一步导数相乘:
| 哪一层变化 | 导数 | 原因 |
|---|---|---|
| 概率p影响ℓ | dℓ/dp=y/p−(1−y)/(1−p) | ln p导数1/p;ln(1−p)还需乘内层导数−1 |
| 分数z影响p | dp/dz=p(1−p) | Sigmoid导数 |
| 权重w影响z | ∇w z=x | z=w₁x₁+…+w_dx_d,每项对wⱼ求导得xⱼ |
先乘前两行:
dℓ/dz=[y/p−(1−y)/(1−p)]p(1−p)
=y(1−p)−(1−y)p=y−yp−p+yp=y−p。
再乘第三行,得到∇wℓ=(y−p)x。x有d项,梯度也有d项。
算一遍:x=(2,−1)、y=1、p=0.5,残差y−p=0.5,乘每个特征得到∇ℓ=(1,−0.5)。训练最小化的L=−ℓ,因此∇L=(−1,0.5),符号整体反过来。
恢复样本下标后,N条样本的总梯度为Σᵢ(yᵢ−pᵢ)xᵢ;平均目标则再除N。硬阈值是在预测阶段把概率转为类别,训练求导沿的是上面的平滑概率链。
梯度下降与上升同一件事
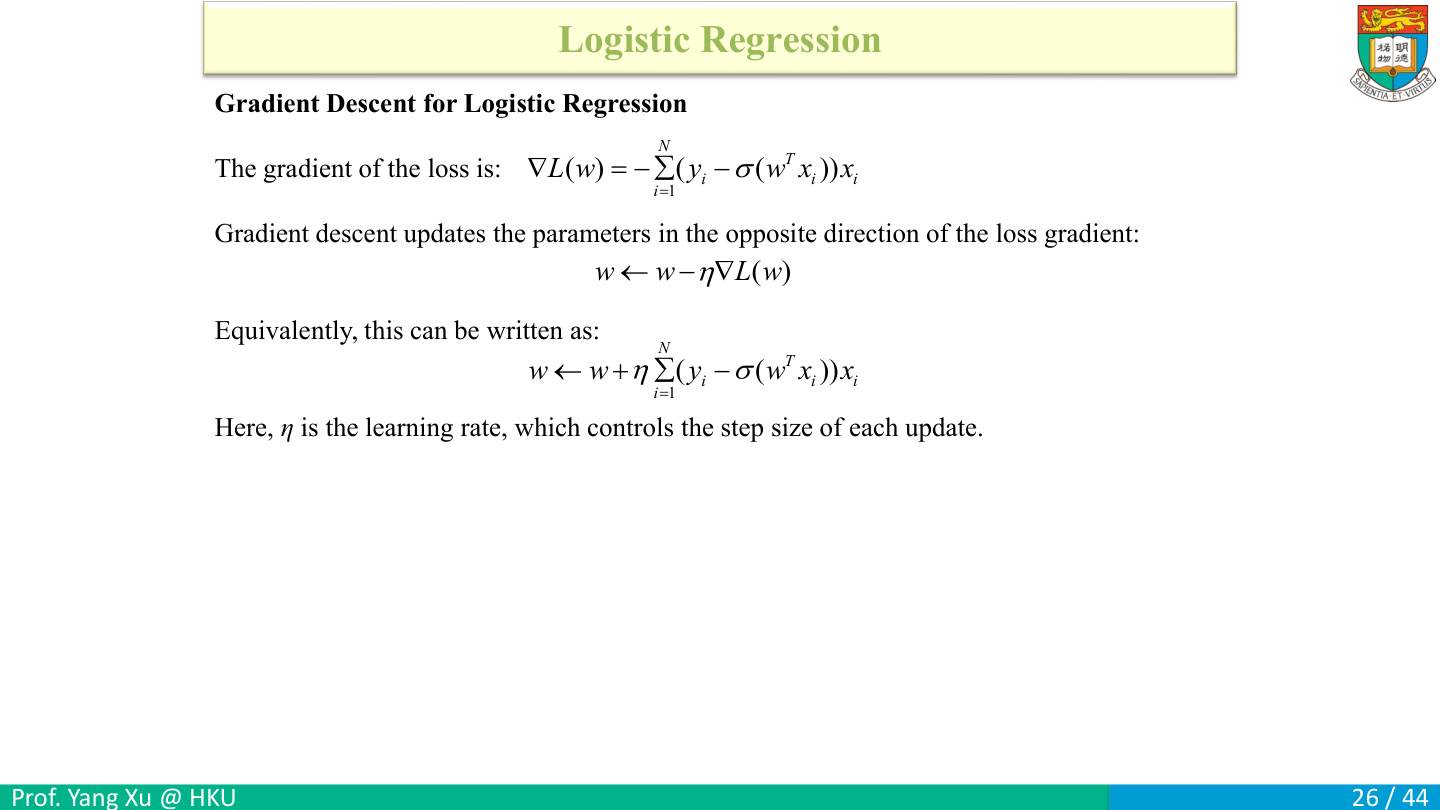
同一组参数可以沿两个等价方向写更新。设对数似然为 ℓ,损失 L=−ℓ,则 ∇L=−∇ℓ,所以:
w_new=w−η∇L=w+η∇ℓ。
也就是说,损失下降和对数似然上升给出同一个新参数。沿第25页结果,∇L=Σᵢ(pᵢ−yᵢ)xᵢ,所以代码若算的是 p−y 就减梯度,若算的是 y−p 就加这项。
固定单样本 x=2、旧 w=0,没有偏置。初始分数 0、概率 0.5,取 η=0.1。
| 真实 y | 损失梯度 (p−y)x | 新 w | 新分数 wx | 新正类概率 |
|---|---|---|---|---|
| 1 | (0.5−1)×2=−1 | 0−0.1×(−1)=0.1 | 0.2 | 约 0.550 |
| 0 | (0.5−0)×2=1 | 0−0.1×1=−0.1 | −0.2 | 约 0.450 |
每一条样本都先把自己的概率残差乘自己的特征,之后再对所有样本求和。若训练用平均损失,梯度和还要除以 N。
L2正则与Softmax
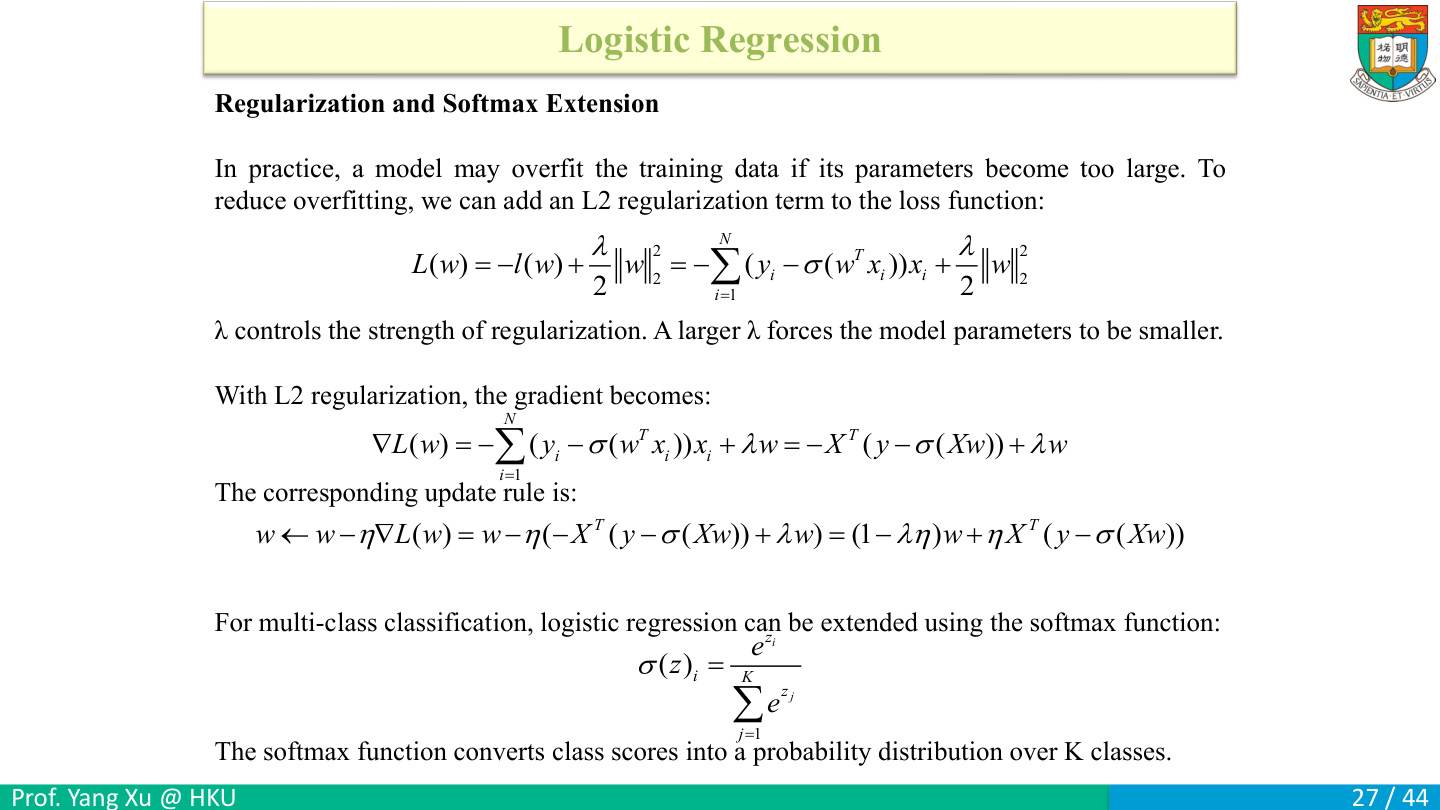
L₂ 正则把交叉熵和参数平方惩罚相加。课件第一行把交叉熵写成了带 xᵢ 的向量求和,正确的标量损失为:
L(w)=−Σᵢ[yᵢ ln pᵢ+(1−yᵢ)ln(1−pᵢ)]+λ||w||²/2,其中 pᵢ=σ(wᵀxᵢ)。
数据项的梯度为 Xᵀ(p−y),参数惩罚的梯度为 λw。减去 η 倍总梯度,并把 w 和 −ηλw 合并:
w_new=w−η[Xᵀ(p−y)+λw]=(1−ηλ)w+ηXᵀ(y−p)。
当 0<ηλ<1 时,仅看正则部分,w 会按比例缩小;再加上数据项才是完整更新。例如 w=2、数据梯度为 −1、λ=0.5 时,总梯度 −1+0.5×2=0,这一步两项正好抵消。
多分类用 Softmax:对每一类的分数 zₖ 取指数,再除以所有类的指数之和。分数 (ln2,0,0) 变成指数 (2,1,1),除以 4 得 (0.5,0.25,0.25),三项合计 1。若先减最大分数 ln2,指数变为 (1,0.5,0.5),除以 2 仍得到相同概率。一般地,减去共同常数会让分子和分母同时乘同一个因子,计算时这样做可防止指数溢出。
阈值方向的纠错
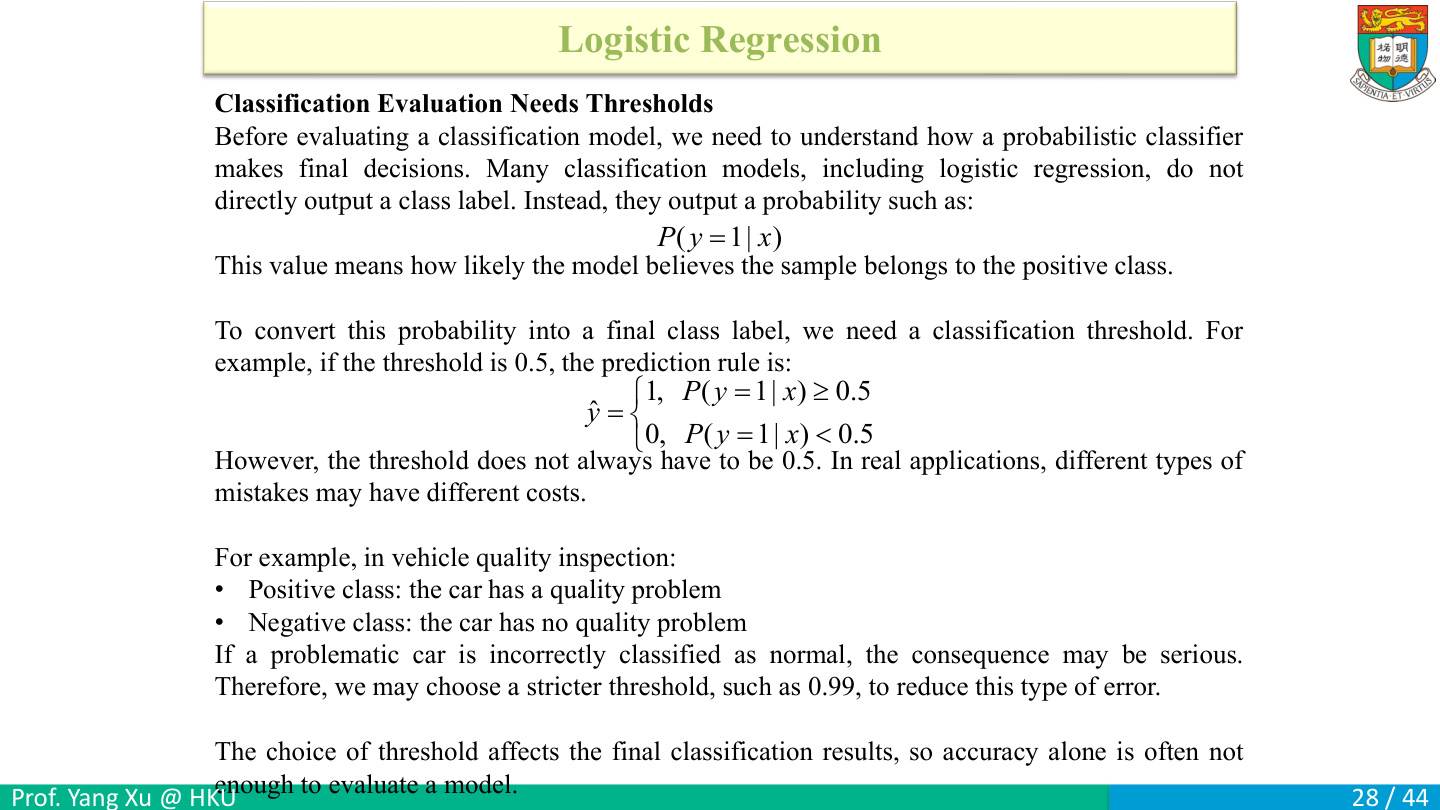
先定义正类:有质量问题=1,p表示“有问题的概率”。决策规则为p≥阈值就判有问题;因此降低阈值会扩大报警范围,提高阈值会缩小报警范围。
用三辆真实有问题的车算一遍,p分别为0.4、0.7、0.95:
- 阈值0.5:检出后两辆,漏掉第一辆。
- 阈值0.99:三辆都判正常,全部漏检。
- 阈值0.3:三辆全部检出。
因此要减少漏检,可以降低“有问题概率”的正类阈值。图中把阈值升至0.99与少漏检联系起来,方向与本页正类定义相反。
降低阈值也会让一些正常车进入报警集合,可能增加误报。选阈值时,用同一验证集分别统计漏检FN与误报FP,再结合两种错误代价决定。若输出改成“正常概率”,判定方向也应随这个新含义改写;先写清概率代表什么,再选阈值。
混淆矩阵的方向
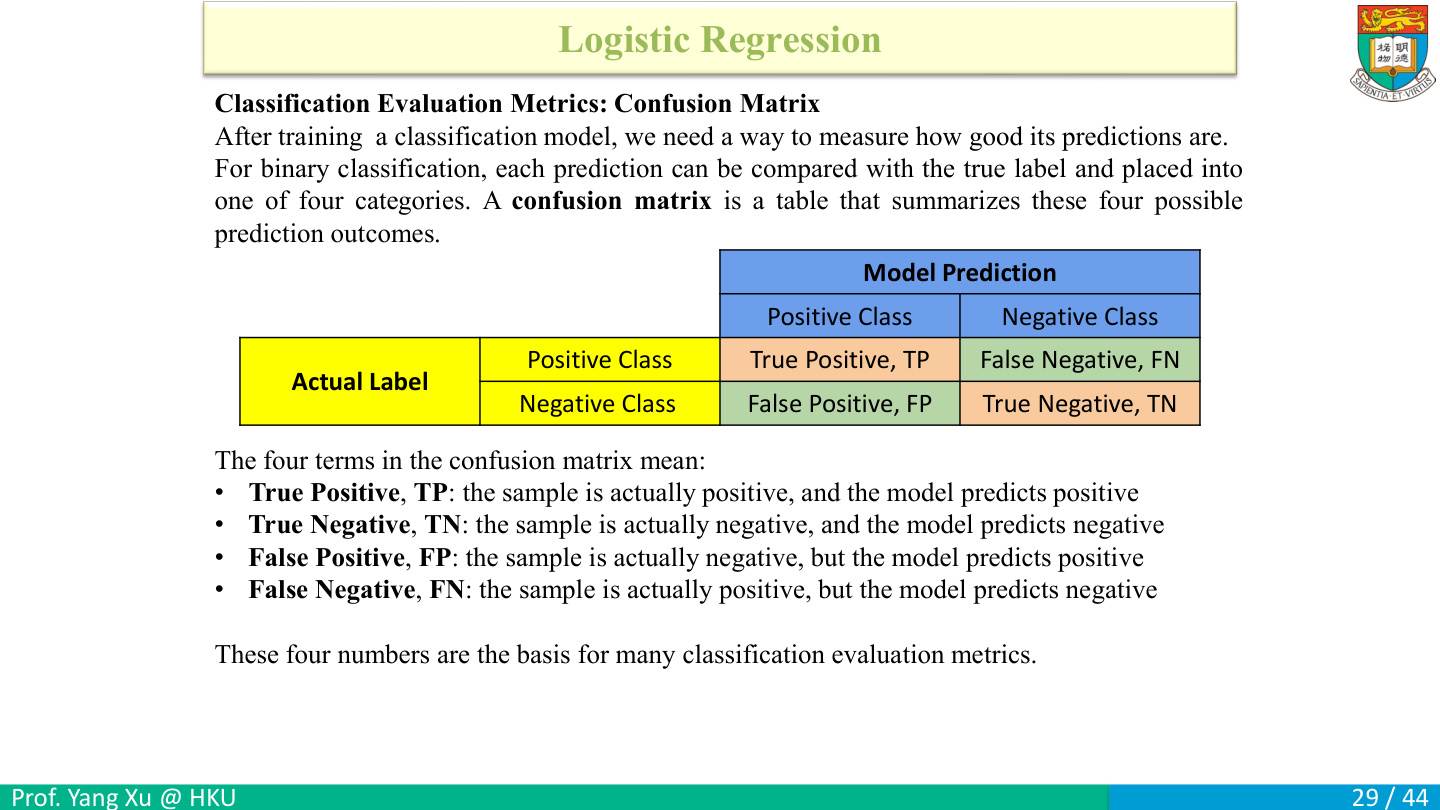
混淆矩阵把“实际是什么”和“模型报什么”交叉起来。这里定义正类为有缺陷、负类为正常;行看实际类别,列看预测类别。
| 实际类别 ↓ / 预测类别 → | 报有缺陷(正) | 报正常(负) | 实际总数 |
|---|---|---|---|
| 实际有缺陷(正) | TP:检出8 | FN:漏检2 | 10 |
| 实际正常(负) | FP:误报4 | TN:正确放行86 | 90 |
| 预测总数 | 12 | 88 | 100 |
这四个数怎样得到?100件中实际10件缺陷;检出8件,所以剩10−8=2件漏掉,FN=2。正常件100−10=90,其中4件被误报,所以正确放行90−4=86,TN=86。
缩写可拆成两部分:后面的Positive/Negative指模型报正还是报负,前面的True/False指这次判断对不对。因此FN是假阴性——模型报“正常”,但实际有缺陷;FP是假阳性——模型报“有缺陷”,但实际正常。
最后核对两个方向:实际正类TP+FN=8+2=10;所有报警TP+FP=8+4=12。它们是不同集合,后面分别成为Recall与Precision的分母。
练一练。报出的12件中有几件误报?答案4;实际10件缺陷中有几件漏检?答案2。先把问题对应到行或列,再找格子。
准确率的局限
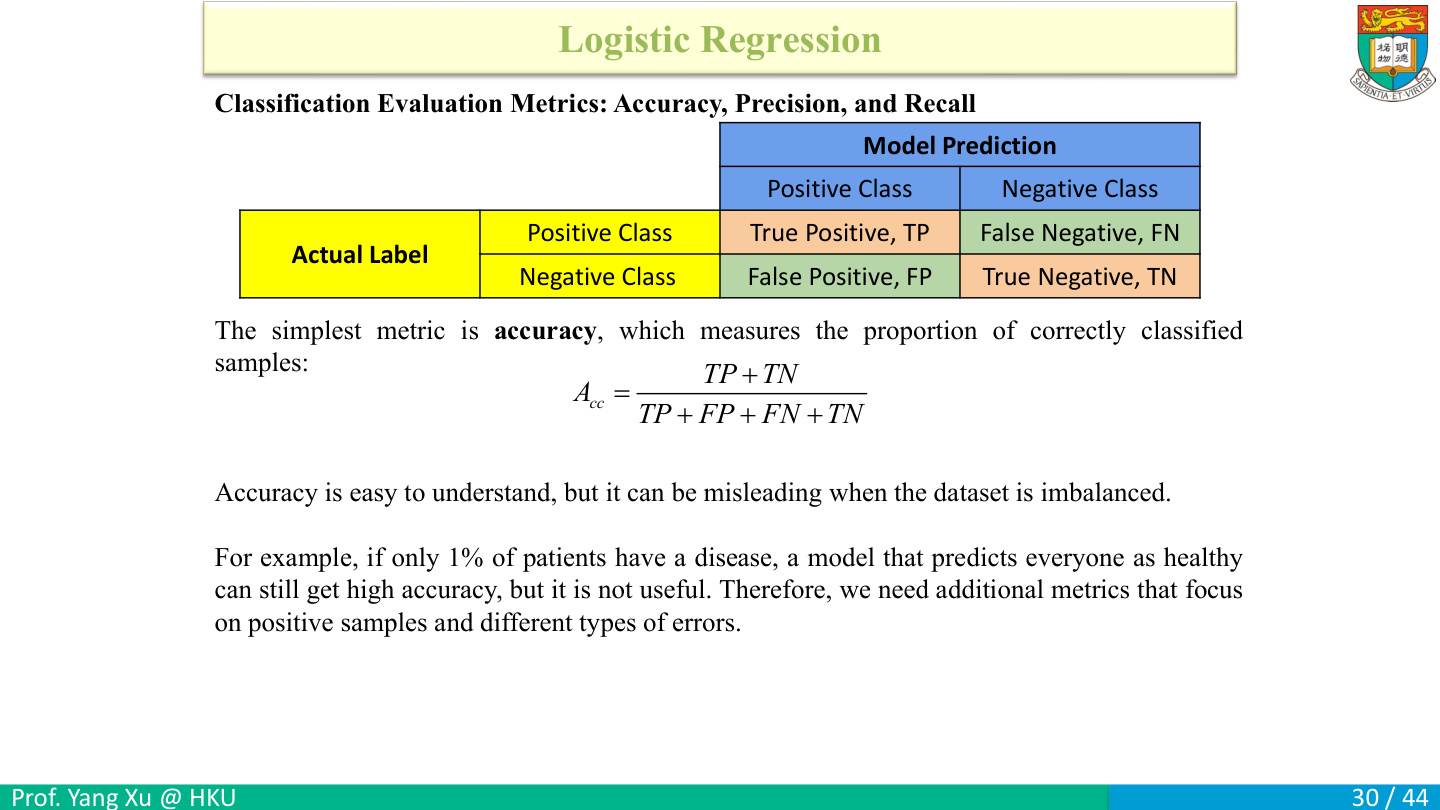
准确率 Accuracy=(TP+TN)/(TP+FP+FN+TN)。分子是判对的两个格子,分母是全部样本。在上一页的 100 件例子中,正确检出 8 件、正确放行 86 件,所以 Accuracy=(8+86)/100=94%。
课件给出极不均衡的场景。假定 1000 件里有 10 件缺陷,模型把全部样本都报成正常。
| TP 正确检出 | FP 误报 | FN 漏检 | TN 正确放行 |
|---|---|---|---|
| 0 | 0 | 10 | 990 |
准确率是 990/1000=99%,但实际 10 件缺陷都漏掉了。这里高分来自正常件占 99%。若应用在乎找到少数类,接着看召回率;若也在乎报警是否可靠,再看精确率。
Recall召回率
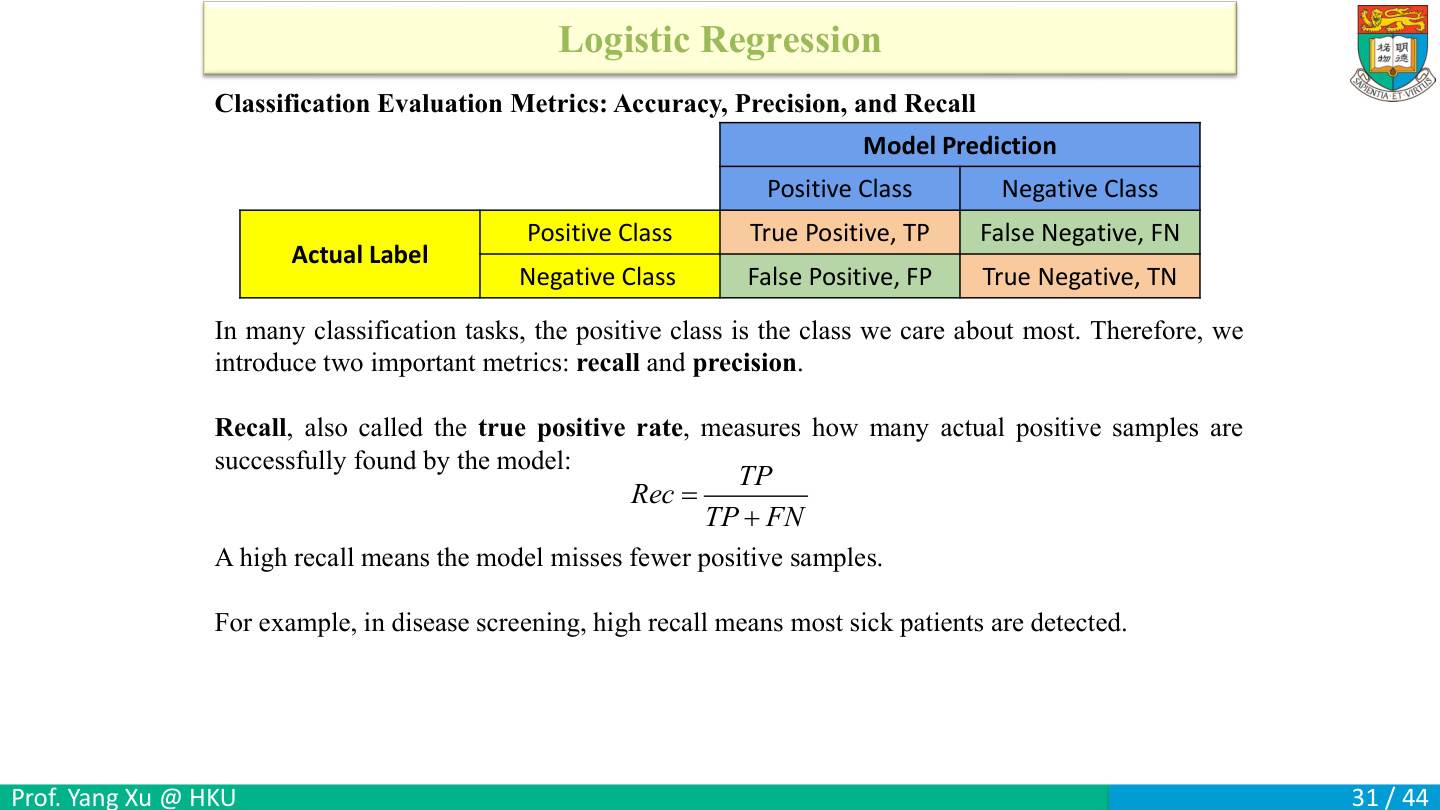
召回率 Recall=TP/(TP+FN),问实际正类中有多少被找到。第29页实际有缺陷的共 10 件,其中 8 件检出、2 件漏检,所以 Recall=8/(8+2)=80%。
固定一批评价样本时,分母「实际缺陷数」不会随阈值变化。若降低阈值后多抓到一件确有缺陷的产品,TP 从 8 变 9,FN 从 2 变 1,召回率升至 90%。若只多报了一件正常产品,TP 与 FN 不变,召回仍为 80%。
极端情况下,对 100 件全部报警会抓到 10/10 件缺陷,召回 100%,同时误报 90 件。召回率描述漏检这一面。若评价集没有实际正类,TP+FN=0,需报告指标未定义或说明采用的零分母约定。
Precision精确率
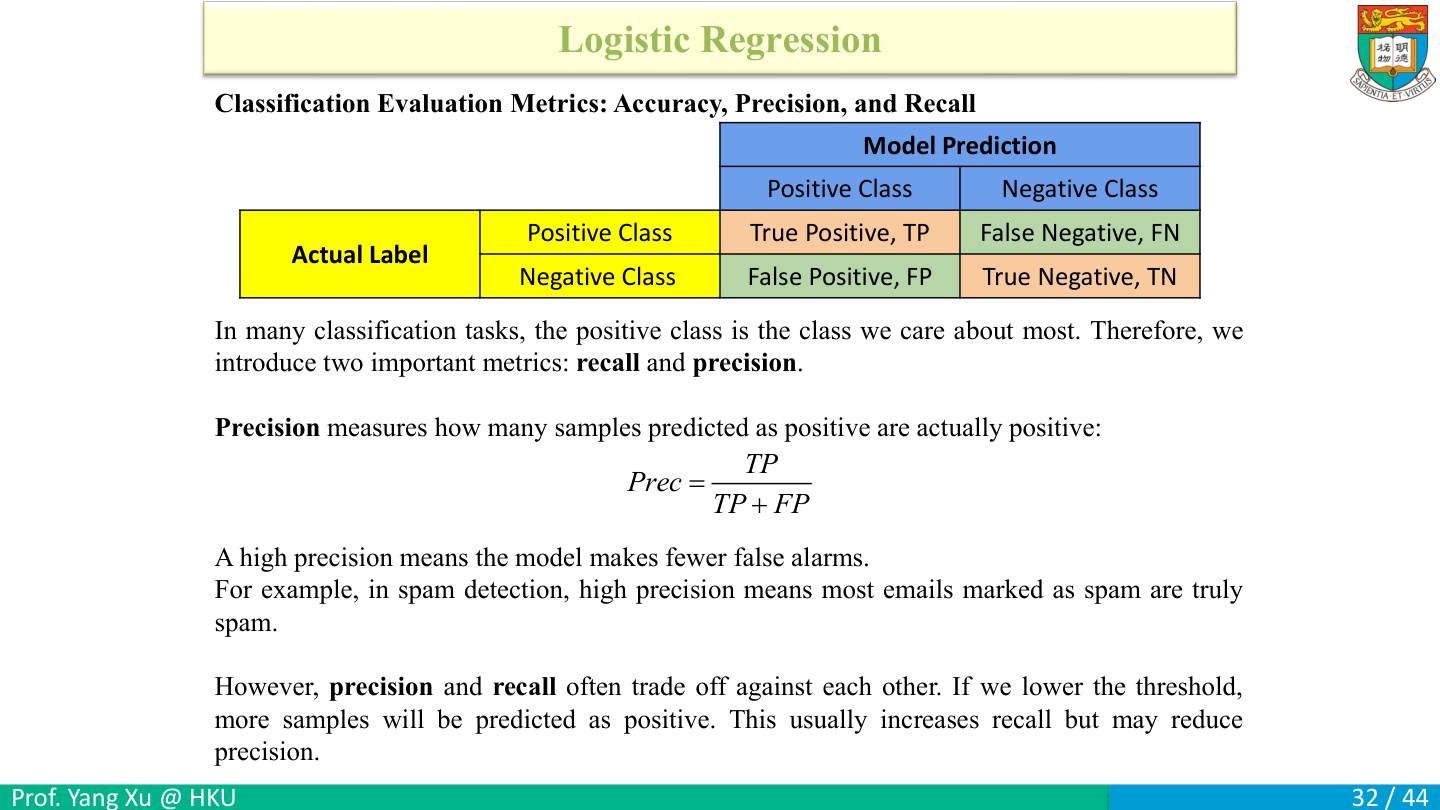
Precision=TP/(TP+FP),分母是所有被模型报为正类的样本,问“报出来的有多少是真的”。例如报警12件,其中8件真缺陷、4件正常,Precision=8/12≈66.7%。若实际共有10件缺陷,Recall=8/10=80%。
再看一个极端:模型只报警1件,而且确实有缺陷,Precision=100%;但10件缺陷只找到1件,Recall=10%。精确率看报警是否可靠,召回率看缺陷是否找全。
降低阈值会扩大报警集合,精确率怎样变化要看新加入样本的构成。例如新增2件真缺陷、没有新增误报,Precision从8/12升至10/14≈71.4%;若新增的都是正常件,精确率则下降。这解释了精确率与召回率之间常见的权衡,也说明不能仅由阈值方向断定精确率必然升降。
当模型完全不报正时,TP+FP=0,公式出现零分母,计算时需统一约定并说明。名称也要分开:Precision是“报正样本中的正确比例”,Accuracy则是全部样本的正确比例。
F1与F beta
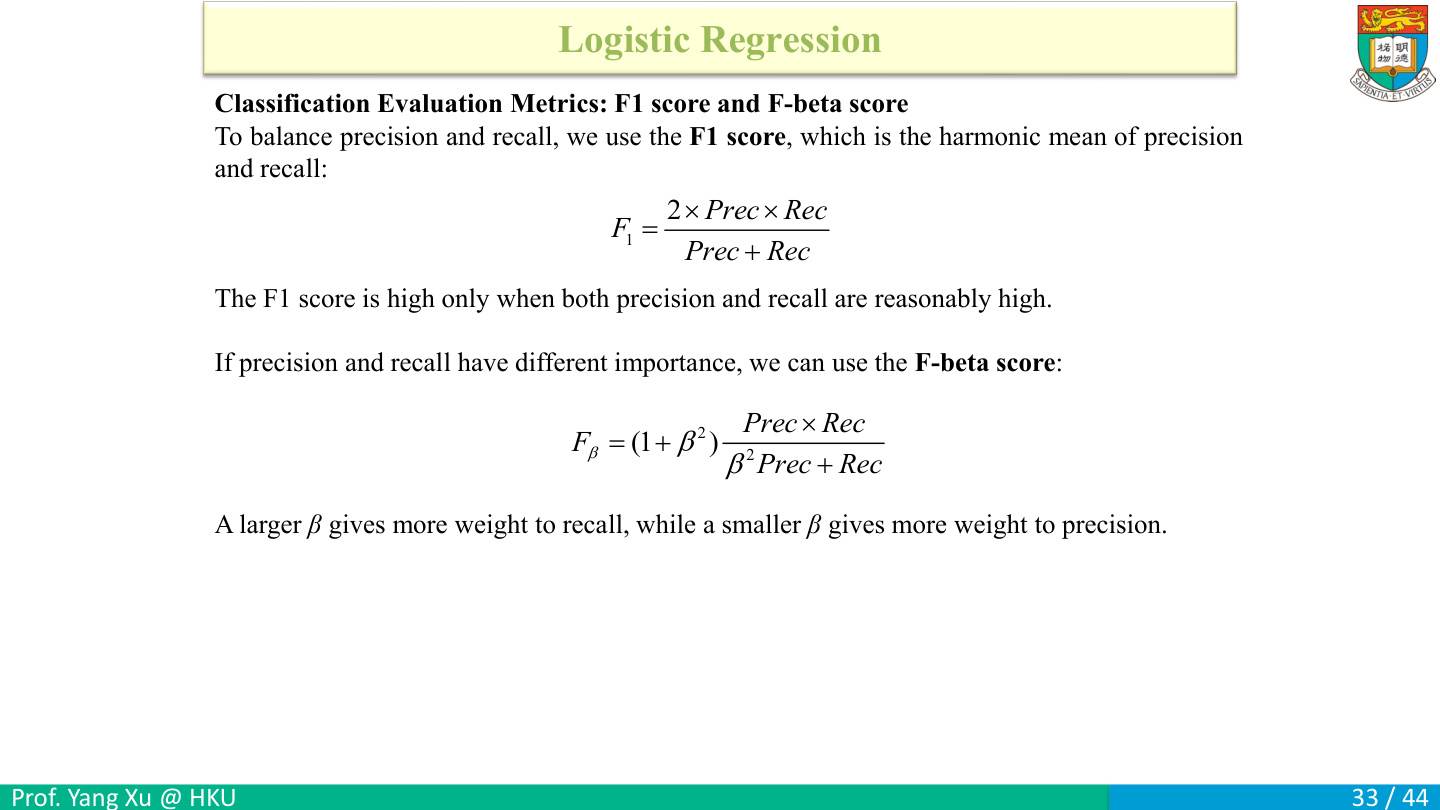
记精确率为 P、召回率为 R。F1 是两者的调和平均。先平均倒数,再对结果取倒数:
F1 = 1 / [(1/P+1/R)/2] = 2 / [(P+R)/(PR)] = 2PR/(P+R)。
从混淆矩阵直接算时,可以令 A=TP+FP、B=TP+FN,暂设 TP>0。代入 P=TP/A、R=TP/B,分子 2PR=2TP²/(AB),分母 P+R=TP(A+B)/(AB)。相除后约去 AB 和一个 TP,得到 F1=2TP/(2TP+FP+FN)。用第29页数据算,F1=16/(16+4+2)=16/22≈0.7273。这个写法也适用于 TP=0 且分母非零的情况。
P=1、R=0.1 时,F1=0.2/1.1≈0.182,能看出其中一项很低。想改变两项的相对权重,可用 Fβ=(1+β²)PR/(β²P+R)。取倒数为 [1/P+β²/R]/(1+β²),因此 β>1 时加重了低召回带来的惩罚,0<β<1 时更重视精确率。F1 不直接使用 TN;如果 TP、FP、FN 都是 0,四格公式的分母也为 0,需要说明采用的计算约定。
TPR与FPR
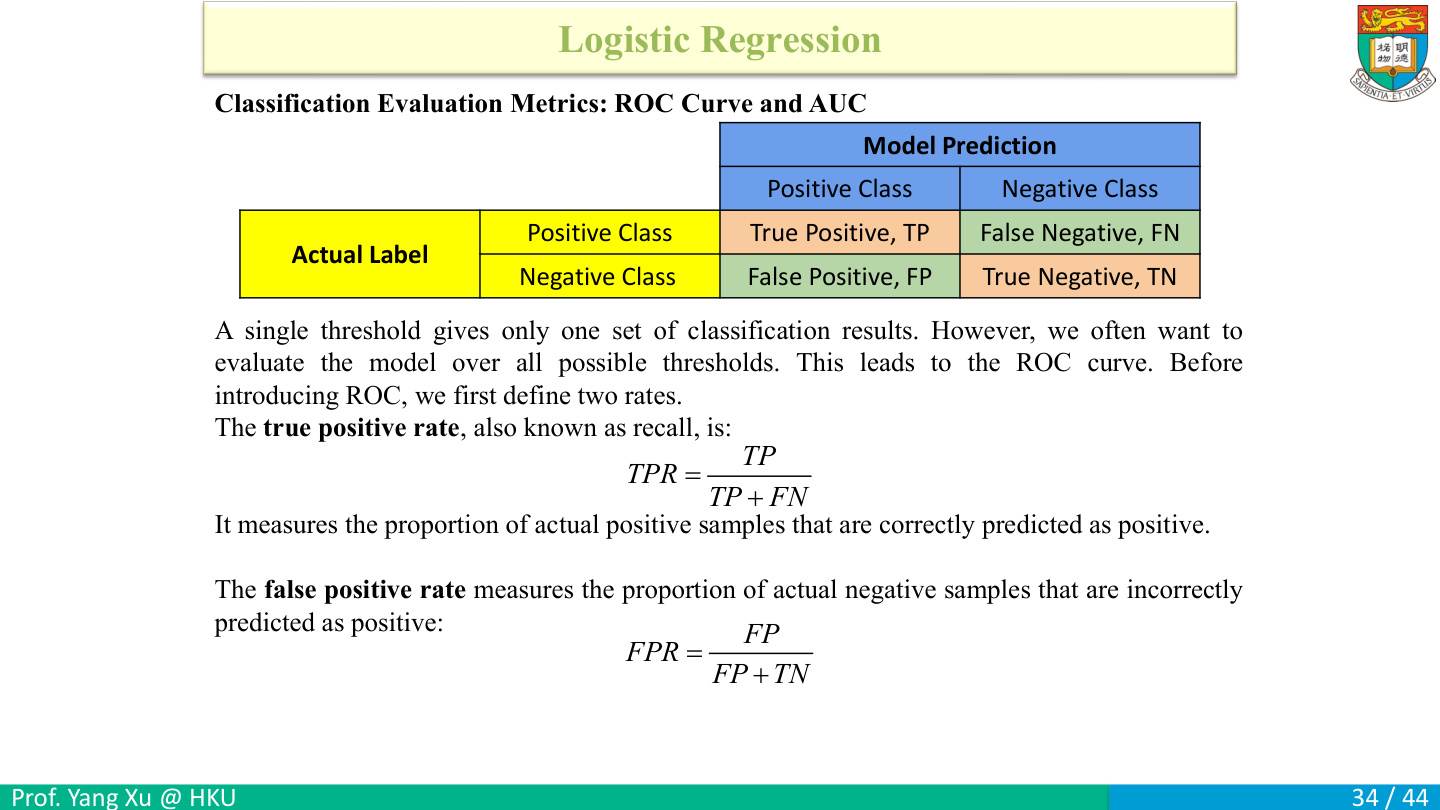
画 ROC 时,每次先按当前阈值填混淆矩阵,再用实际类别总数作分母。
| 指标 | 统计范围 | 第29页的计算 |
|---|---|---|
| TPR 真正率,与 Recall 相同 | 全部实际有缺陷的产品 | TP/(TP+FN)=8/10=0.8 |
| FPR 假正率 | 全部实际正常的产品 | FP/(FP+TN)=4/90≈0.0444 |
| 1−Precision | 全部收到报警的产品 | FP/(TP+FP)=4/12≈0.3333 |
一个误报数 4,会因分母不同而回答两个问题。FPR 是问正常件会被错报的比例。第三行则问收到一条报警时,它是误报的比例。
将这组计数对应的结果画到 ROC 上,横坐标取 FPR≈0.0444,纵坐标取 TPR=0.8。改变阈值时,TP、FP 可变;实际正类总数 10 和实际负类总数 90 固定。
ROC的生成顺序
动手试试 · 拖动阈值,看ROC点怎么走
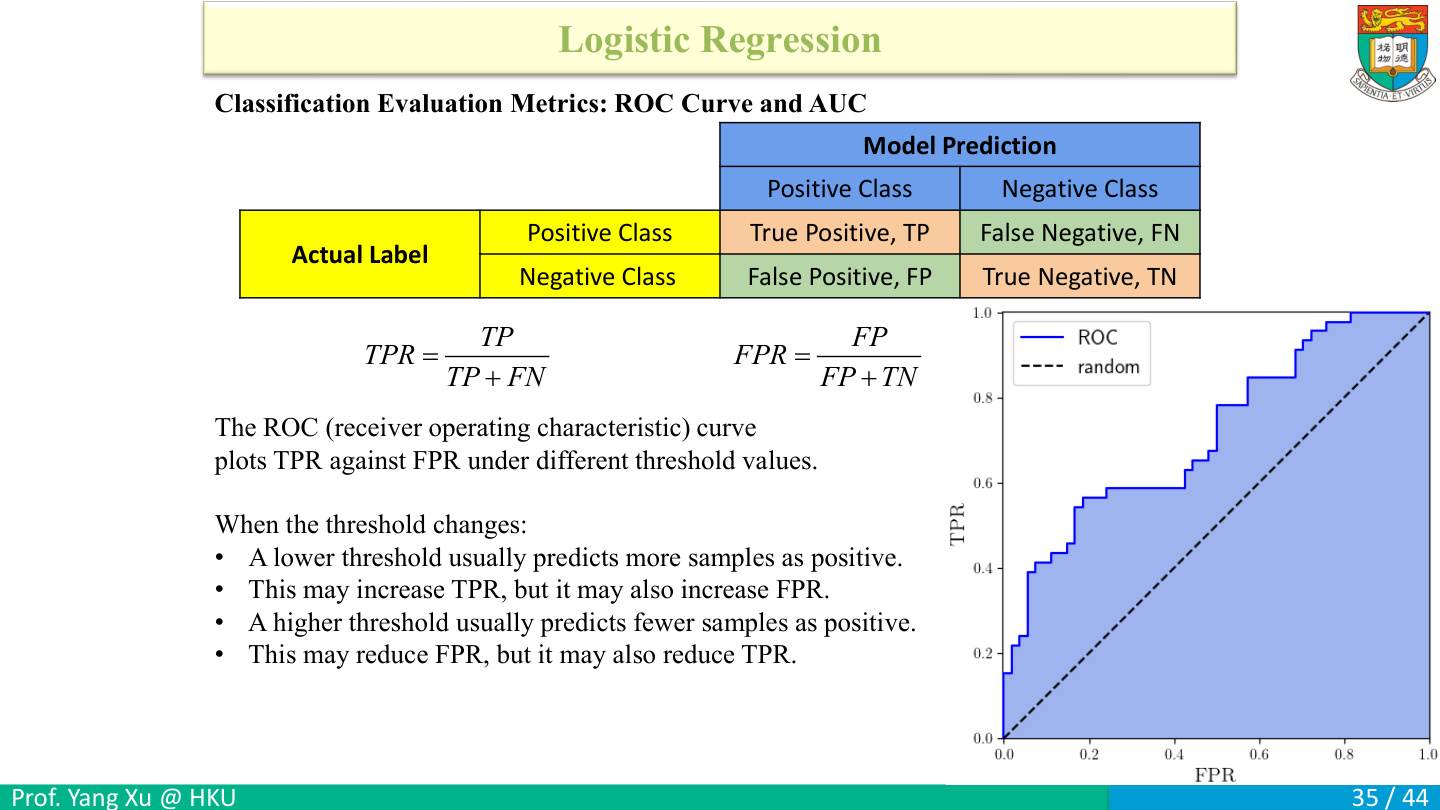
ROC由同一组分数在不同阈值下的预测结果组成。约定正类概率p≥阈值τ就判正;降低τ会逐步把更多样本纳入预测正类集合。
四个样本按分数从高到低为:(0.9,正)、(0.8,负)、(0.6,正)、(0.2,负)。实际正类2个、负类2个,因此TPR=TP/2、FPR=FP/2。
| 阈值τ | 已判正的分数 | TP | FP | FN | TN | ROC点(FPR,TPR) |
|---|---|---|---|---|---|---|
| 1.0 | 无 | 0 | 0 | 2 | 2 | (0,0) |
| 0.9 | 0.9 | 1 | 0 | 1 | 2 | (0,0.5) |
| 0.8 | 0.9、0.8 | 1 | 1 | 1 | 1 | (0.5,0.5) |
| 0.6 | 0.9、0.8、0.6 | 2 | 1 | 0 | 1 | (0.5,1) |
| 0.2 | 全部 | 2 | 2 | 0 | 0 | (1,1) |
跟着表看两次移动:阈值从0.9降至0.8,新加入一个实际负类,FP从0变1,ROC向右;降至0.6,新加入一个实际正类,TP从1变2,ROC向上。
把这些点按阈值顺序连接,就是经验ROC。横轴右移表示更多误报,纵轴上移表示更多检出,因此同一FPR下TPR更高的曲线更好。分数相同的样本在同一阈值一起进入,按一致规则连线。
练一练。画五个点要训练五次吗?答案:分数保持不变,只改阈值、重数四格。模型训练与阈值评价是两个步骤。
用正负排序理解AUC
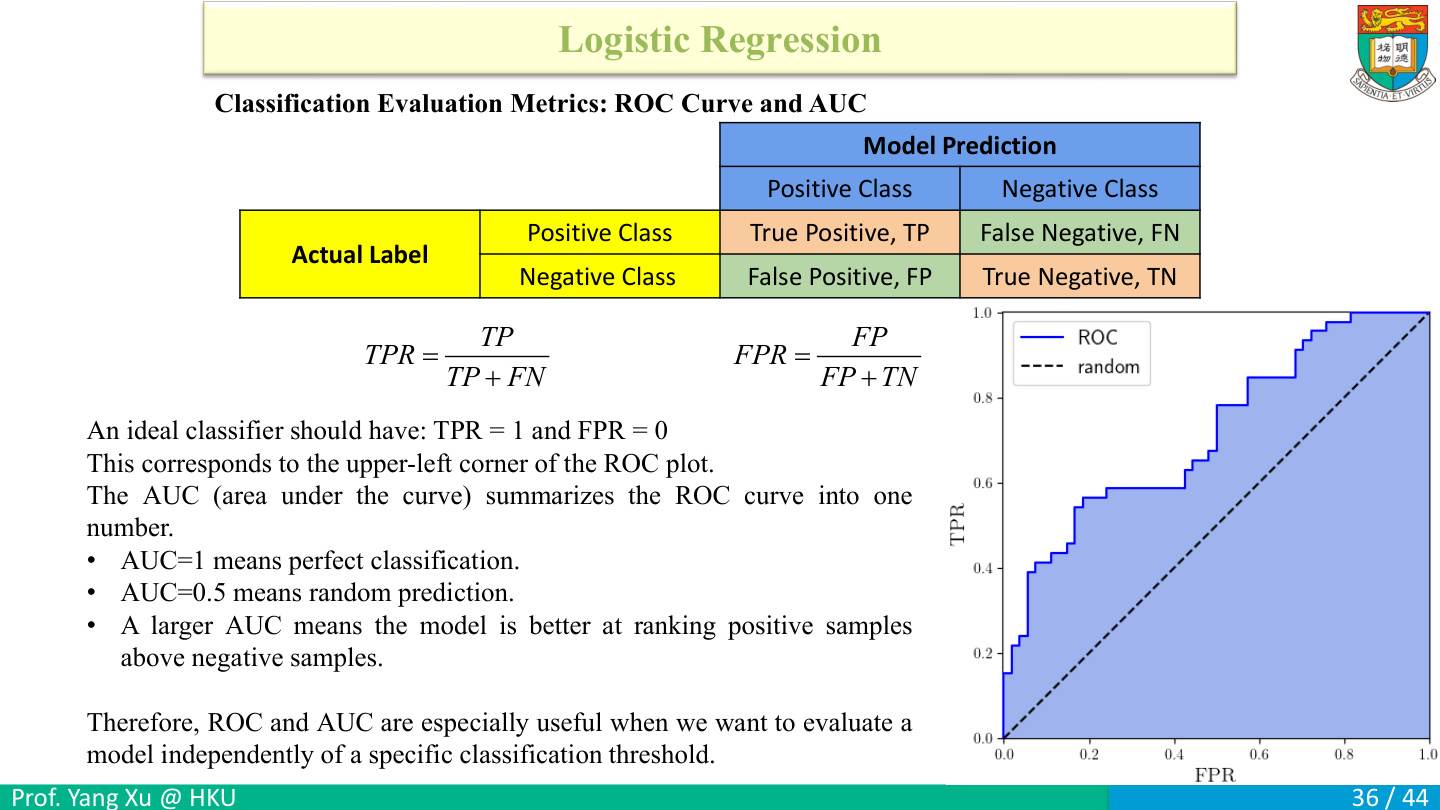
课件右图蓝色阴影是 ROC 下方的面积 AUC。左上角 (0,1) 表示无误报且全部检出;下方对角虚线是随机排序的参考,面积为 1/2。
沿用上一页的折线 (0,0) → (0,0.5) → (0.5,0.5) → (0.5,1) → (1,1)。竖直段的横向宽度为 0,面积为 0。有宽度的是两个矩形:
| FPR 范围 | 宽度 | TPR 高度 | 面积 |
|---|---|---|---|
| 0 至 0.5 | 0.5 | 0.5 | 0.25 |
| 0.5 至 1 | 0.5 | 1 | 0.50 |
AUC=0.25+0.50=0.75。也可按正负样本两两比较。正类 0.9 胜过负类 0.8 和 0.2,正类 0.6 胜过负类 0.2,共赢 3 对;总共 2×2=4 对,得 3/4=0.75。同分通常计半胜。
每当阈值遇到一个负类,折线会走过一段横向宽度,当时的高度是分数高过这个负类的正类比例,所以两种算法得到同一个数。严格递增地变换分数会保持排名与 AUC,原工作阈值对应的分数刻度则会改变。
信息论路线
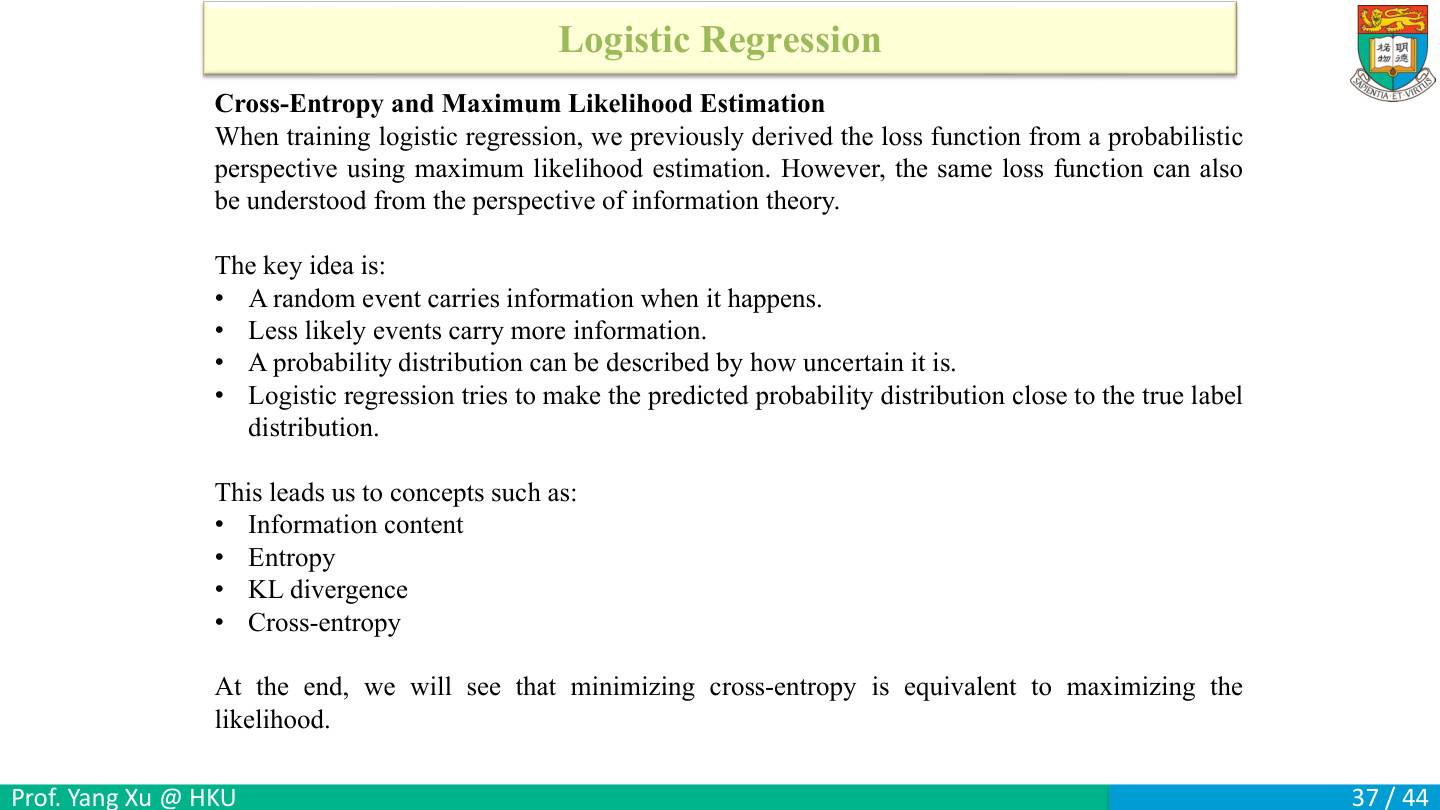
最大似然问“哪套参数让已观察标签更可能”,信息论问“用模型的预测分布描述真实事件,平均要付出多少信息代价”。两条路线会得到同一个负对数损失。
先固定记号:p是真实或目标分布,q是预测分布。熵H(p)描述目标本身的不确定性,交叉熵H(p,q)描述用q处理来自p的数据时的平均代价,KL则表示相对于真实分布额外付出的代价。
以真实正类为例,模型A给正类概率0.6,B给0.9,两者都能在0.5阈值下判对;但交叉熵分别−ln0.6≈0.511、−ln0.9≈0.105,区分了概率质量。分类对错与概率损失关注不同细节。
接下来统一使用自然对数,信息单位是nat;若用log₂,单位为bit,数值按固定比例改变。前面单条样本的正类概率也曾记p,为区分角色,可在这里改记s,把p、q留给两个分布。
自信息与熵
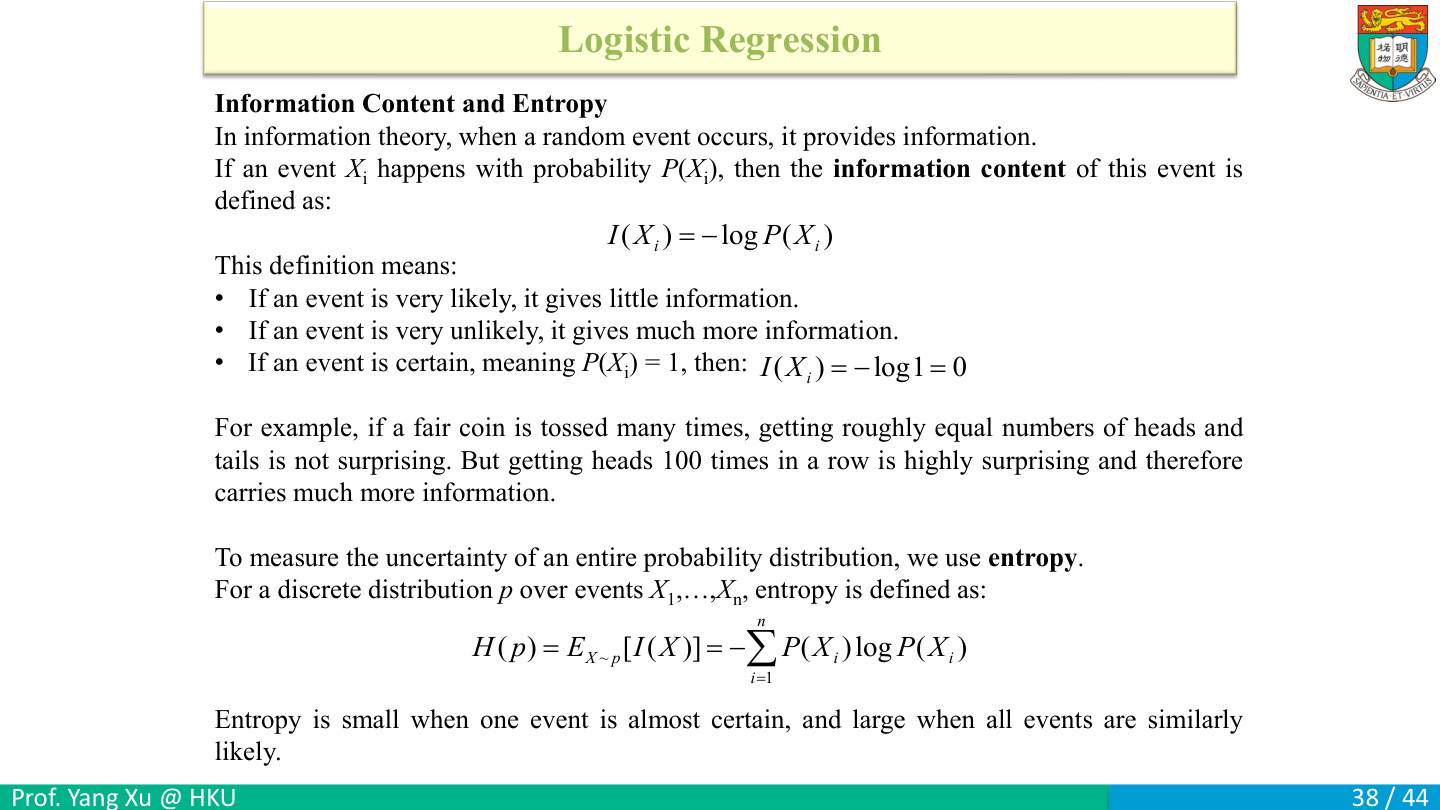
原定义I(x)=−log p(x),H(p)=E_p[I(X)]=−sum_x p(x)log p(x)。概率1事件信息0,概率越低越意外。公平硬币每面p=1/2,若用自然log则每次信息ln2约0.693 nat;用log2则1 bit,需保持同一底数。熵对所有可能事件按概率求平均,不是某次最罕见结果的信息量。
自信息是单次事件的意外程度,熵是按真实概率加权后的平均。偏硬币p=(0.9,0.1):常见一面信息−ln0.9≈0.105,罕见一面−ln0.1≈2.303;平均熵0.9×0.105+0.1×2.303≈0.325 nat。它不是把两项直接平均,因为两事件出现频率不同。
练一练。公平硬币连续100次全正面的联合概率是多少?答案:(1/2)¹⁰⁰,信息−ln[(1/2)¹⁰⁰]=100ln2。这里是在讨论一整段具体序列的事件,不是说每次正面的信息突然改变。符号E表示期望,即按概率加权求平均;对离散事件写成求和,就得到课件的熵公式。
确定与均匀分布
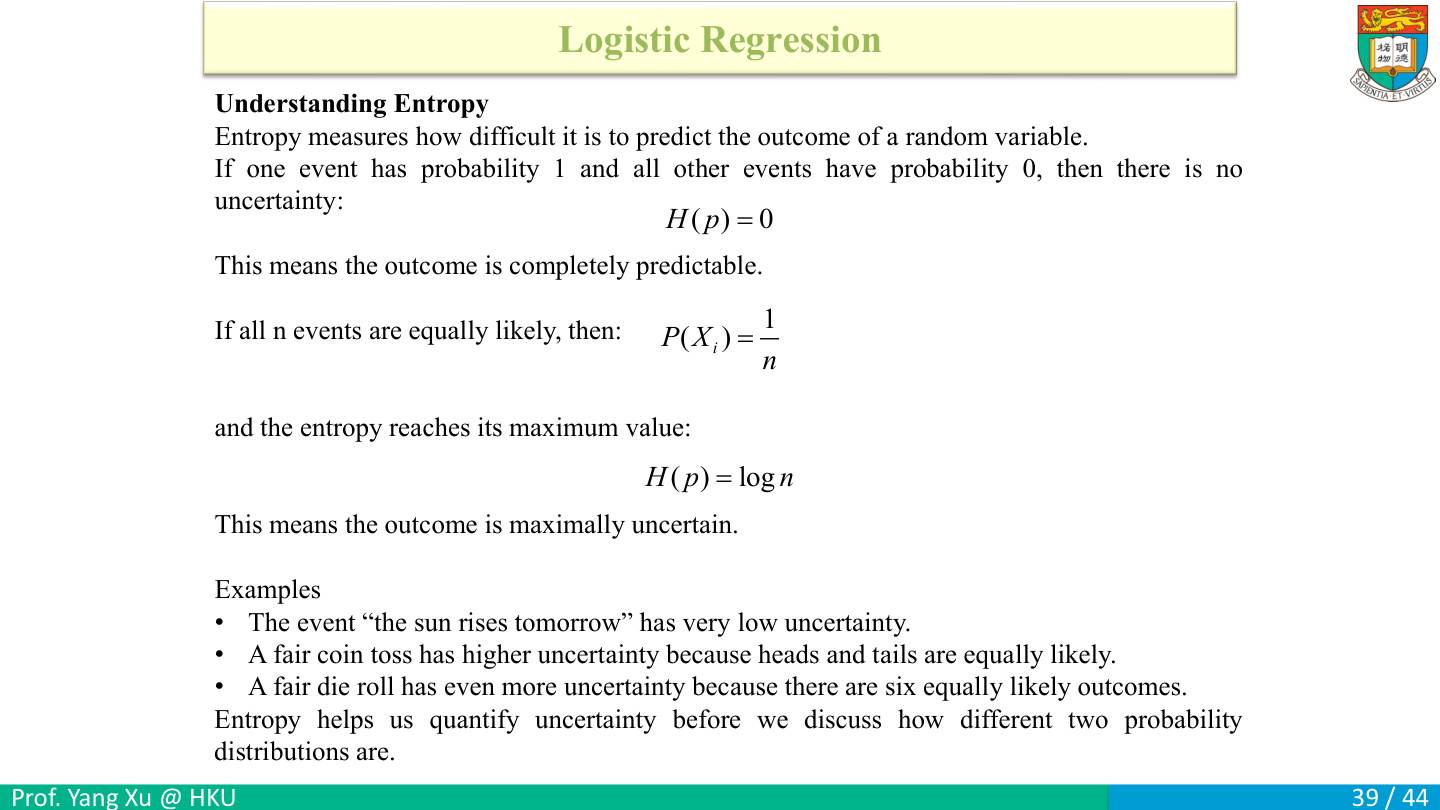
熵 H(p)=−Σ pᵢ ln pᵢ 用概率加权平均信息量。固定为 n 个可能类别,先算课件的两个极端。
| 分布 | 单项如何计算 | 总熵 |
|---|---|---|
| 一个事件的概率为 1 | 概率 1 的项为 −1×ln1=0,其余按极限 p ln p→0 | 0 |
| n 个事件均匀分布 | 每项为 −(1/n)ln(1/n)=(ln n)/n | n×(ln n)/n=ln n |
二分类里,(1,0) 的熵为 0,(0.9,0.1) 约为 0.325,(0.5,0.5) 为 ln2≈0.693。均匀时最难猜,达到相同类别总数下的最大值。
也能用第40页的 KL 性质证明最大值。令 uᵢ=1/n,KL(p||u)=Σpᵢ ln pᵢ+ln n×Σpᵢ=−H(p)+ln n。因为 KL≥0,所以 H(p)≤ln n,只有 p=u 时取等号。自然对数的单位为 nat;如果对四类均匀分布用 log₂,得到 log₂4=2 bit。
KL散度
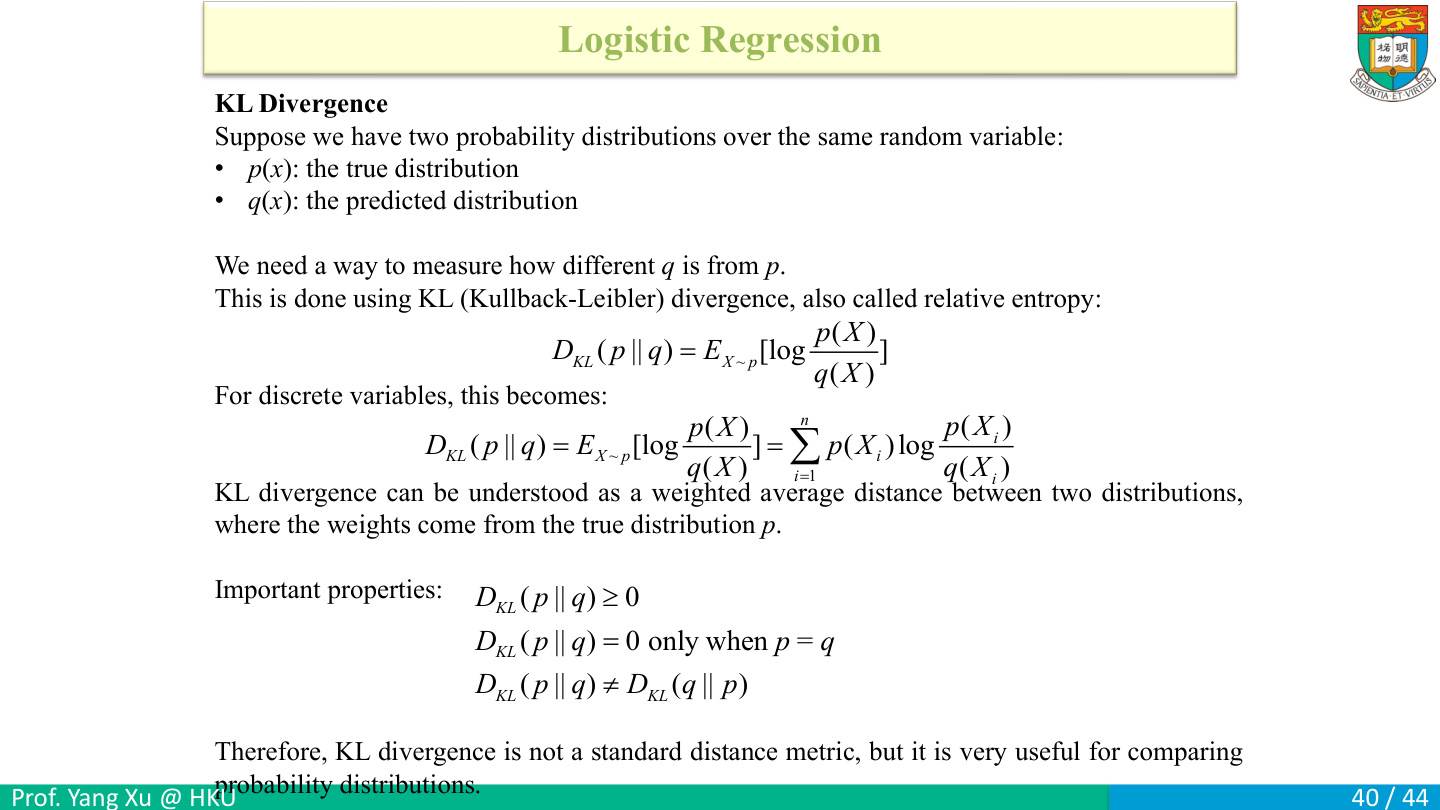
KL 散度 D_KL(p||q)=Σᵢ pᵢ ln(pᵢ/qᵢ)。p、q 定义在同一组事件上。每一项先取概率比、再取对数,最后用真实分布 pᵢ 作权重。
以 p=(0.5,0.5)、q=(0.75,0.25) 为例,正向计算为 0.5ln(2/3)+0.5ln2=0.5ln(4/3)≈0.1438。第一项为负,第二项为正。反过来权重与比值均改变,0.75ln1.5+0.25ln0.5≈0.1308,体现 KL 的方向性。
为什么整体非负?先看 g(u)=u−1−ln u(u>0)。导数 1−1/u 在 u<1 时为负、u>1 时为正,因此 g 在 u=1 取最小值 0,也就是 ln u≤u−1,且等号只在 u=1。对每个 pᵢ>0 且 qᵢ>0 的格子,取 u=qᵢ/pᵢ,得到 pᵢ ln(pᵢ/qᵢ)≥pᵢ−qᵢ。对 pᵢ>0 的格子相加,右边为 1−Σ_(pᵢ>0)qᵢ≥0。pᵢ=0 的格子在期望中贡献 0;若某格 pᵢ>0 而 qᵢ=0,KL 为无穷。只有两个分布相同时 KL 为 0。
例如 p=(1,0)、q=(0.5,0.5),正向 KL=ln2。反向时第二格目标概率为 0.5,比较的分布却给 0,KL 为无穷。
KL等于交叉熵减熵
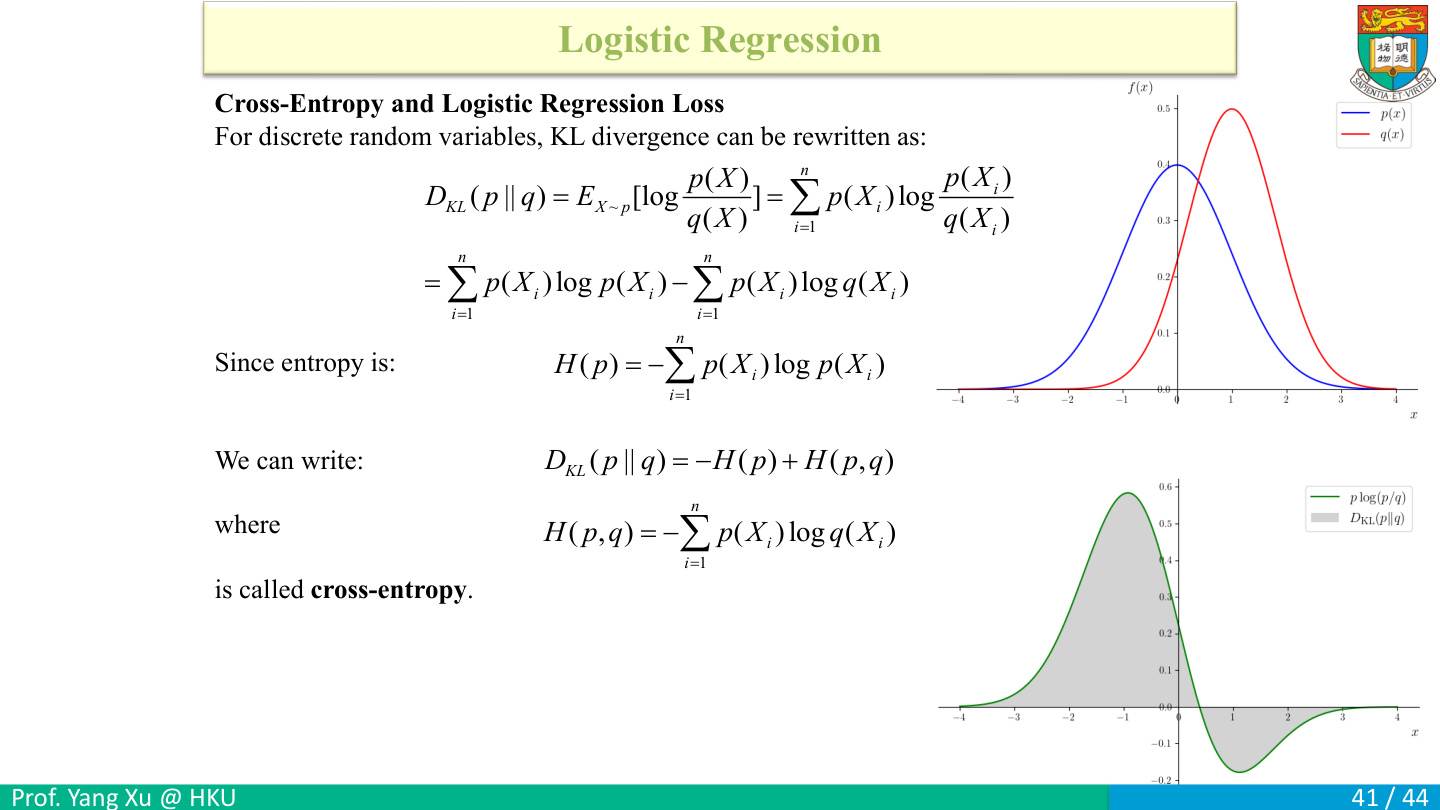
log(p/q)=log p−log q,故KL=sum p log p−sum p log q。定义H(p)=−sum p log p,H(p,q)=−sum p log q,得到KL=−H(p)+H(p,q)。当真实分布p固定,H(p)是常数,最小化交叉熵等价最小化KL。不是对p和q都任意变动时仍可删去H(p)。
把符号关系独立算一遍:H(p,q)=−Σp log q;H(p)=−Σp log p;二者相减得到Σp log p−Σp log q=Σp log(p/q)=KL(p||q)。因此交叉熵=熵+KL。若p是固定数据对应的目标,H(p)与模型参数无关,训练只需降低交叉熵,就同时降低KL。
练一练。取p=(1,0),H(p)=0,q=(0.8,0.2),交叉熵与KL分别多少?答案:都等于−ln0.8≈0.2231,因为真实类别的目标分布完全确定。若p本身也随优化变化,H(p)就不能简单当常数删掉。这一限制解释了公式为什么要明确“固定真实分布”,不是看到加减常数的样子就一律忽略。
二分类交叉熵及符号纠错
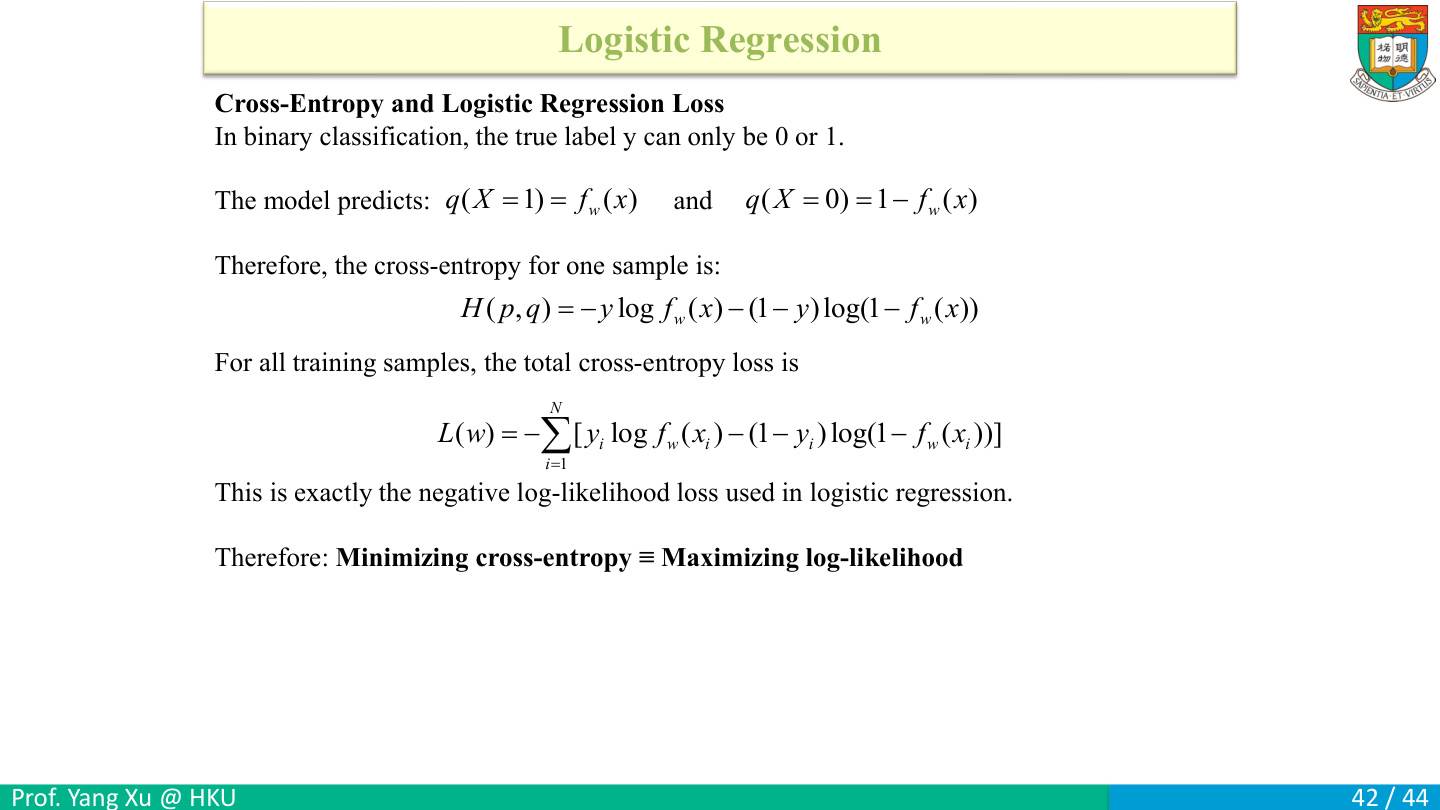
二分类的真实标签y是0或1,可写成目标分布(y,1−y);模型正类概率记s=σ(wᵀx),预测分布为(s,1−s)。把两格逐项代入交叉熵:
H=−y ln s−(1−y)ln(1−s)。
第一格贡献−y ln s,第二格贡献−(1−y)ln(1−s),两项都带负号。对N条样本求和,并将共同负号提到括号外,得到:
L(w)=−Σᵢ[yᵢ ln sᵢ+(1−yᵢ)ln(1−sᵢ)]。
图中下方括号内的第二项误写成减号;外面的负号再展开会使该项变正。可以代一个负类立即检查:y=0、s=0.9时,正确损失为−ln0.1≈2.303,自信地误判正类受到较大惩罚;错式则给−2.303,方向相反。
这个求和式与第22页的负对数似然相同,所以最小化交叉熵等价于最大化对数似然。记号上把单条预测写s,是为了与信息论中表示真实分布的p区分。
全讲回顾
原总结仍为Linear和Logistic Regression。线性回归:实数输出、平方损失、正规方程或梯度下降;Logistic:Sigmoid概率、二元交叉熵、梯度更新。两者均要检查尺度、正则、数据划分。自测可复述为何X^TX不可逆、为何sigmoid与对数求导后只剩p−y、为何少漏检对应较低正类概率阈值。具体答案在第9至12、24至28页。
做一张口头对照卡:线性回归的单样本输出是wᵀx,标签实数,半平方损失,梯度含“预测减真实”;Logistic输出σ(wᵀx),标签0/1,负对数损失,梯度同样含“概率减真实”,但形成这一简洁残差是链式求导约分的结果。二者虽出现相似的残差形式,仍要分别按连续数值和类别概率来解释标签与损失。
练一练。真实故障=1、p=0.4,阈值0.5时是哪一格?答案FN。降阈值0.3后该点变TP;但还需看其他正常样本是否新增FP。再问正则λ是否由该梯度自动训练?答案:本课设定里它是用验证选的超参数,w才是内层学习参数。最后测试应在选择结束后进行,指标与阈值都要写清。
本讲结束
结束前完成三件事:用几条样本列出X、y并算一次梯度;把y=0或1代入交叉熵检查符号;填一张混淆矩阵并计算Precision与Recall。它们分别检验你是否掌握训练、概率损失和分类评价。