左右键翻页;“连续阅读”展开整份;搜索可定位概念。
分类(二):先把SVM学完,再学决策树
本讲继续学习支持向量机SVM,再学习决策树:SVM用分界面判断类别,决策树通过一连串问题走到预测结果。两者都利用输入特征和已知标签学习分类规则。
路线图:模型、训练、预测是三个不同问题
前半讲按“最大间隔目标→对偶问题→支持向量→SMO求解→核方法”学习SVM。后半讲按“沿节点预测→选择分裂→熵与信息增益→ID3、C4.5、CART”学习决策树。先弄清模型怎样预测,再学怎样从数据中确定模型。
硬间隔SVM:把最近的点推离分界面
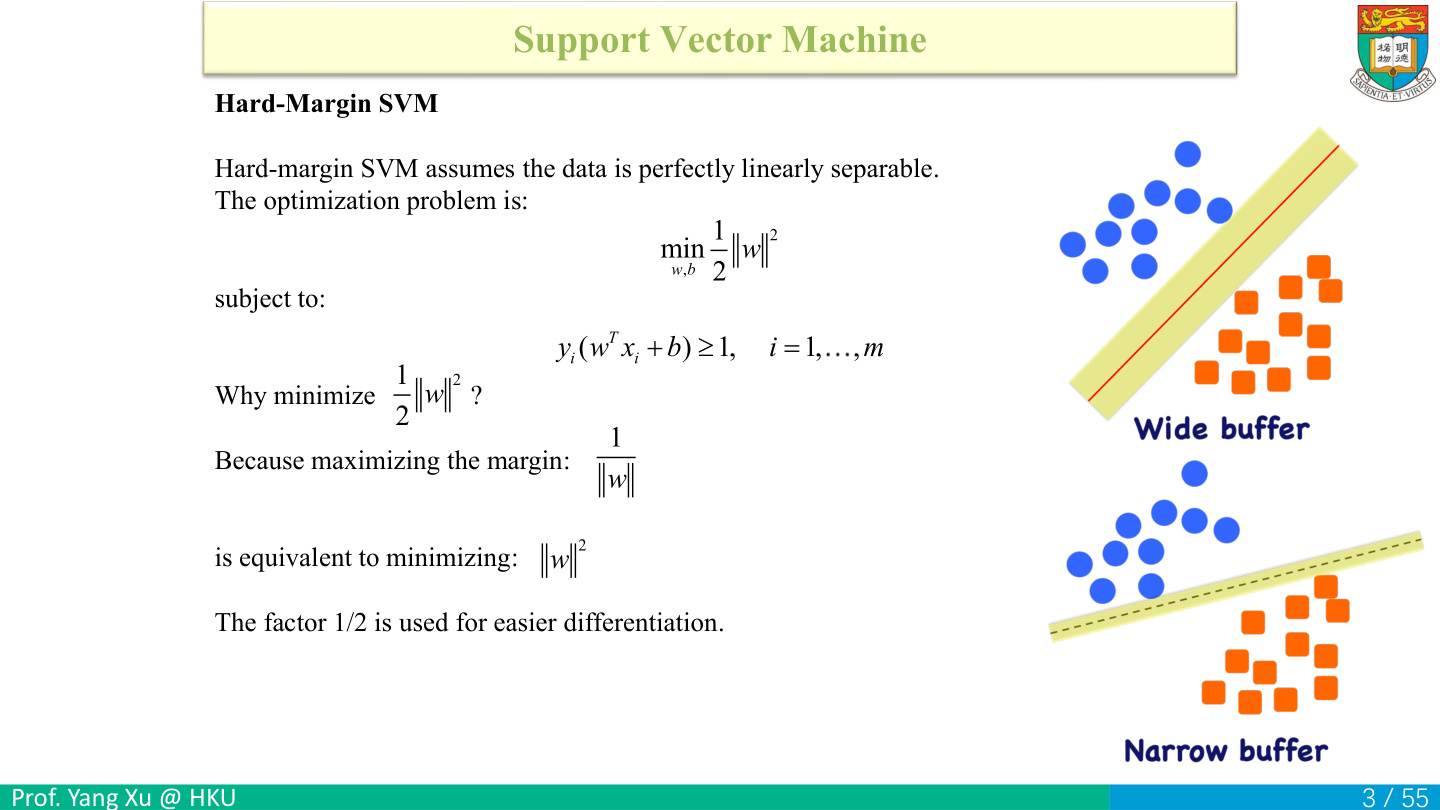
令训练标签 yᵢ∈{−1,+1},分数 g(x)=wᵀx+b。正类希望g为正,负类希望g为负,两类要求可以合成一个式子:yᵢg(xᵢ)≥1。例如负类yᵢ=−1时,约束等于 −g(xᵢ)≥1,即 g(xᵢ)≤−1。因此正类落在g≥1一侧,负类落在g≤−1一侧。
决策面是g=0,两条间隔边界是g=1和g=−1。为什么要除以 ||w||?沿垂直于决策面的单位方向 u=w/||w|| 走t,分数变成 g(x+tu)=g(x)+t||w||。令分数为0,得到 t=−g(x)/||w||。因此到分界面的距离是 |t|=|g(x)|/||w||。在规范化约束下,最近点至少距离 1/||w||,两侧边界之间的全宽为 2/||w||。因此最大化间隔等价于减小||w||,也等价于最小化 ||w||²/2。平方保持非负数的大小顺序,系数1/2让求导后梯度恰好为w。
例如,一维点x=−2为负类、x=2为正类。取w=0.5、b=0,两个点的yg均为1,约束恰好满足;决策点为0,一侧间隔2,全宽4。若w=1,仍可正确分类,但规范化间隔缩为1,因此w=0.5的间隔更宽。
硬间隔假设所有训练数据线性可分。若正负类无法用直线或超平面分开,这组硬约束就没有可行解,需要改用后面的软间隔。
自测: 只需分类正确时yg>0,为何这里要求≥1?答案:把w和b都乘以同一个正数,分界面g=0不动。若最近训练点的 yg=m>0,将w、b同时除以m,就能把最小的yg变成1,便于用 1/||w|| 比较间隔。
软间隔:允许违反边界,但要付代价
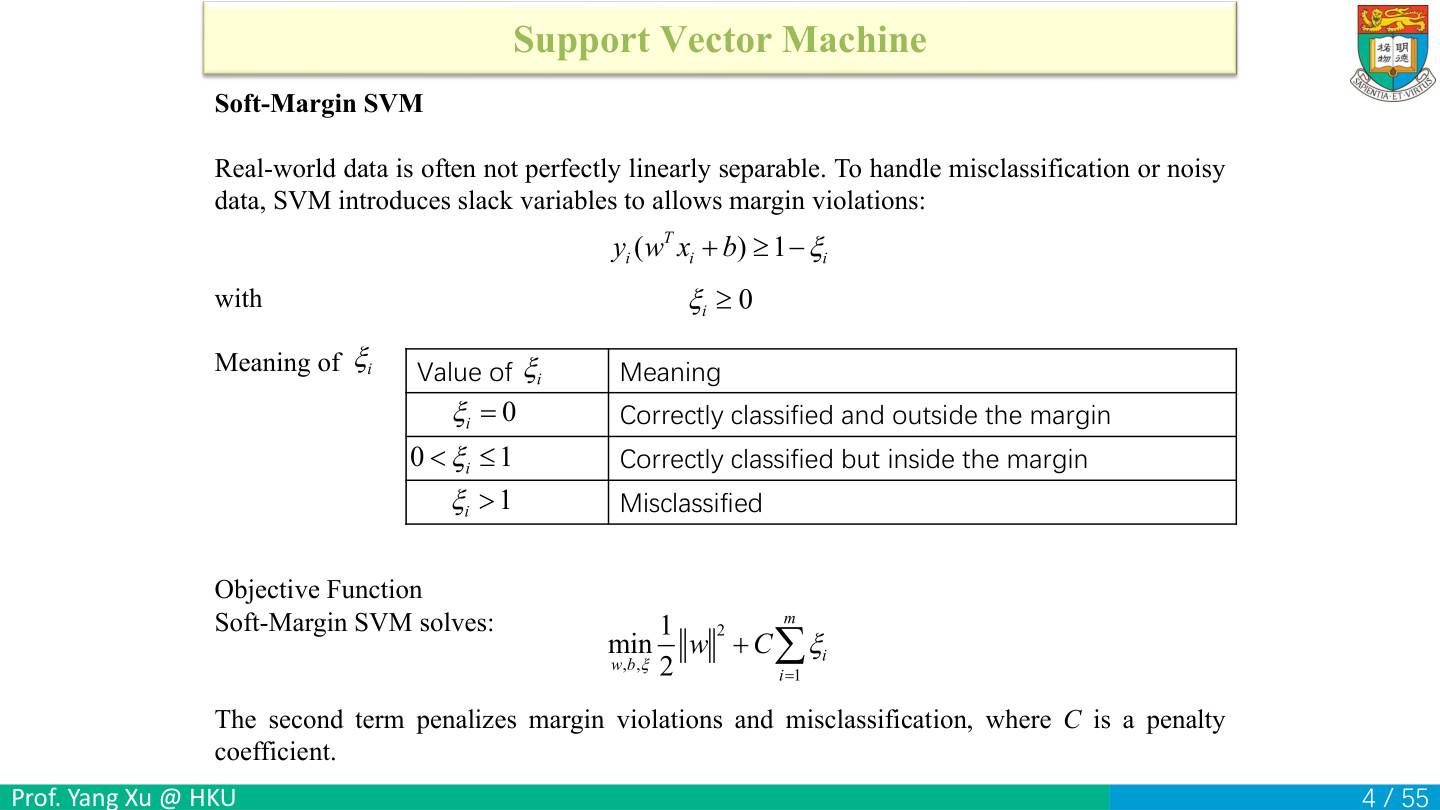
软间隔把约束改成 yᵢg(xᵢ)≥1−ξᵢ,并要求ξᵢ≥0。ξ读作xi,是每个样本自己的松弛量。目标为 ||w||²/2+CΣᵢξᵢ:第一项偏好宽间隔,第二项处罚违规,C>0控制对违规有多不宽容。最优时可取 ξᵢ=max(0,1−yᵢg(xᵢ)),即hinge loss(合页损失)。
逐类看边界:ξ=0表示样本可以在间隔边界上或更外面;0<ξ<1对应分数符号仍正确、但进入间隔;ξ=1对应恰好在决策面g=0,需要用平局规则决定类别;ξ>1对应错分。这里按最小松弛 ξ=max(0,1−yg) 解释各段位置。
例如,若y=+1、g=0.3,则yg=0.3,需要ξ≥0.7;若g=−0.2,需要ξ≥1.2。两点都违规,但后者还分错了。取C=2,最小松弛对应罚项分别1.4与2.4。
C较大通常更努力拟合训练标签,可能为异常点牺牲较宽间隔;C较小更愿意容忍违规。C控制目标函数中违规处罚的强度,学习率则控制参数更新的步长,两者作用不同。
自测: ξ=0是否一定表示离边界很远?答案:不一定,也可能恰好在yg=1的间隔边界上。
对偶问题:从调w、b改成调每个样本的α
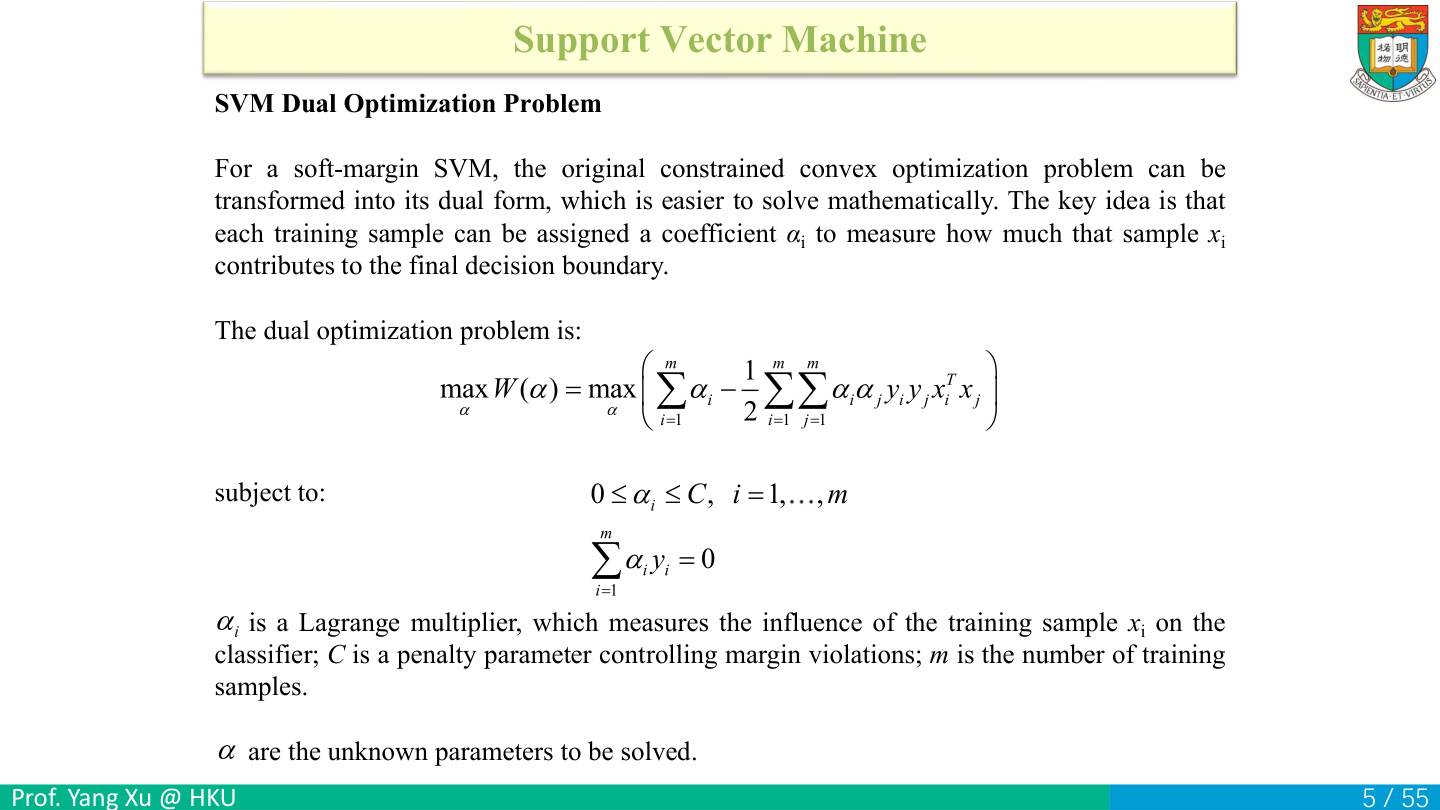
先分清要解什么。训练数据有m条,每条xᵢ有d个特征,标签yᵢ取±1。原问题调的是权重w、偏置b和各样本松弛量ξᵢ;对偶问题则为每条样本求一个系数αᵢ。
第一步:把约束放进同一个式子。 原目标为 ½||w||²+CΣξᵢ,约束写成 1−ξᵢ−yᵢ(wᵀxᵢ+b)≤0 与 −ξᵢ≤0。分别给它们非负乘子αᵢ、μᵢ,得到拉格朗日函数:
L=½||w||²+CΣξᵢ+Σαᵢ[1−ξᵢ−yᵢ(wᵀxᵢ+b)]−Σμᵢξᵢ。
令 v=Σαᵢyᵢxᵢ,按变量分组,就是:
L=½||w||²−wᵀv−bΣαᵢyᵢ+Σαᵢ+Σξᵢ(C−αᵢ−μᵢ)。
第二步:先固定α、μ,求L关于w、b、ξ的最小值。 w的项是开口向上的二次式,导数为0时最小。b和ξ的项都是线性的,系数只要不为0,就能朝某个方向取任意小的值。因此这两个系数必须为0。
| 变量 | 导数等于0 | 得到的关系 |
|---|---|---|
| w | w−v=0 | w=Σαᵢyᵢxᵢ |
| b | −Σαᵢyᵢ=0 | Σαᵢyᵢ=0 |
| ξᵢ | C−αᵢ−μᵢ=0 | αᵢ+μᵢ=C |
αᵢ、μᵢ都非负,因此最后一行给出 0≤αᵢ≤C。
第三步:代回,消去w、b、ξ。 b项因Σαᵢyᵢ=0而消失;ξ项因C−αᵢ−μᵢ=0而消失。w=v,所以 ½||w||²−wᵀv=½||v||²−||v||²=−½||v||²。剩下 W(α)=Σαᵢ−½||Σαᵢyᵢxᵢ||²。
把平方范数写成向量与自身的内积,再展开两个求和,得到本页对偶目标:
W(α)=Σᵢαᵢ−½ΣᵢΣⱼαᵢαⱼyᵢyⱼ(xᵢᵀxⱼ)。
为什么求最大值?原问题的可行参数满足两条约束,所以L中乘子新增的项都不大于0。把L关于原变量取最小得到W,W是原目标最优值的一个下界。对偶就是在 0≤αᵢ≤C 和 Σαᵢyᵢ=0 下找最高的下界。样本只通过成对内积出现,因此后面可以把内积换成核函数。
例如,只有一正一负两点时,等式约束是α正−α负=0,即两个系数相等。原问题有d维权重,对偶有m个样本系数;用核矩阵时需存储m×m个核值。
自测: αᵢ的上界C从哪来?答案:由αᵢ+μᵢ=C且μᵢ≥0,得到αᵢ≤C。
支持向量与KKT:用哪些点计算偏置
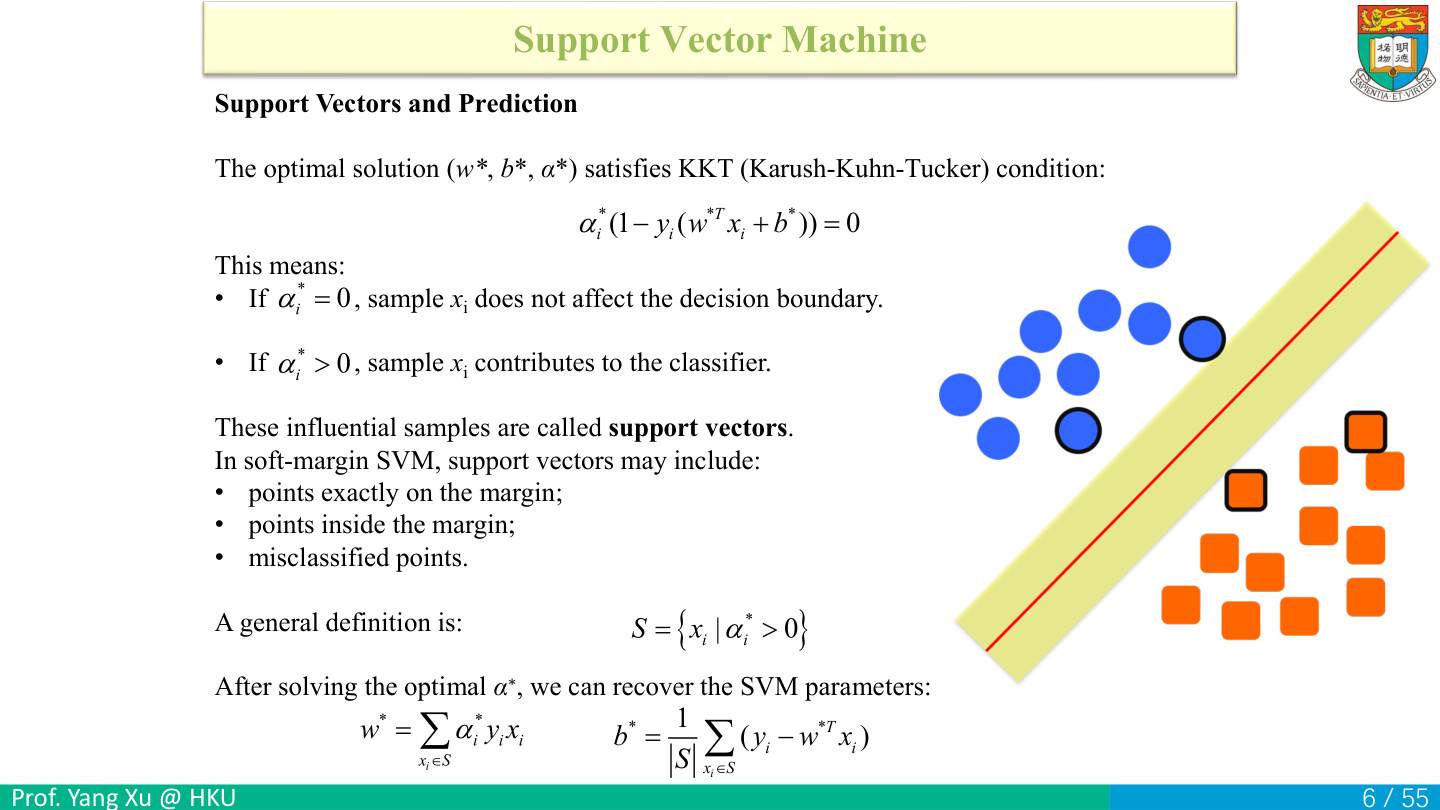
支持向量就是αᵢ>0的训练样本,因为 w=Σαᵢyᵢxᵢ 中只有这些项有贡献。记 g(x)=wᵀx+b;判断一个点处在哪里,要看乘积yᵢg(xᵢ):它把正负类统一成同一套间隔条件。
软间隔有两条互补条件:
αᵢ[1−ξᵢ−yᵢg(xᵢ)]=0;
(C−αᵢ)ξᵢ=0。
“互补”的关键是乘积为0:一个因子非零,另一个就必须为0。按α的位置分三种情况:
| αᵢ | 由互补条件推出 | 点的位置 |
|---|---|---|
| αᵢ=0 | C−αᵢ>0,故ξᵢ=0;可行约束给yg≥1 | 间隔边界或外侧,求和系数为0 |
| 0<αᵢ<C | 第二式给ξᵢ=0;第一式再给1−yg=0 | 恰好在yg=1的边界上 |
| αᵢ=C | 第一式给yg=1−ξᵢ≤1 | 可在边界、间隔内部或错分区域 |
中间这一行叫自由支持向量。它满足 yᵢ(wᵀxᵢ+b)=1。两边乘yᵢ,利用yᵢ²=1,得到 wᵀxᵢ+b=yᵢ,再移项:b=yᵢ−wᵀxᵢ。通常把多个自由支持向量给出的b取平均。
例如,正类y=1、x=2、w=0.5,且0<α<C,则 b=1−0.5×2=0。若另一正类点α=C、g=0.2,则 ξ=1−yg=0.8,它在间隔内部,使用的是包含ξ的互补条件。没有自由支持向量时,令 uᵢ=wᵀxᵢ,用同一张表给b找上下界:
| 样本情况 | 正类 yᵢ=+1 | 负类 yᵢ=−1 |
|---|---|---|
αᵢ=0,要求 yᵢ(uᵢ+b)≥1 |
b≥1−uᵢ |
b≤−1−uᵢ |
αᵢ=C,要求 yᵢ(uᵢ+b)≤1 |
b≤1−uᵢ |
b≥−1−uᵢ |
取所有下界的最大值与所有上界的最小值。比如一对α=C的正、负点,其u分别是0.8和−0.6,就得到 −0.4≤b≤0.2,可取中点−0.1。
自测: α=C的点一定分错了吗?答案:不一定;若yg=0.2,它仍分对但进入间隔;若yg<0,才是错分。
预测:把支持向量的贡献加起来,再取正负号
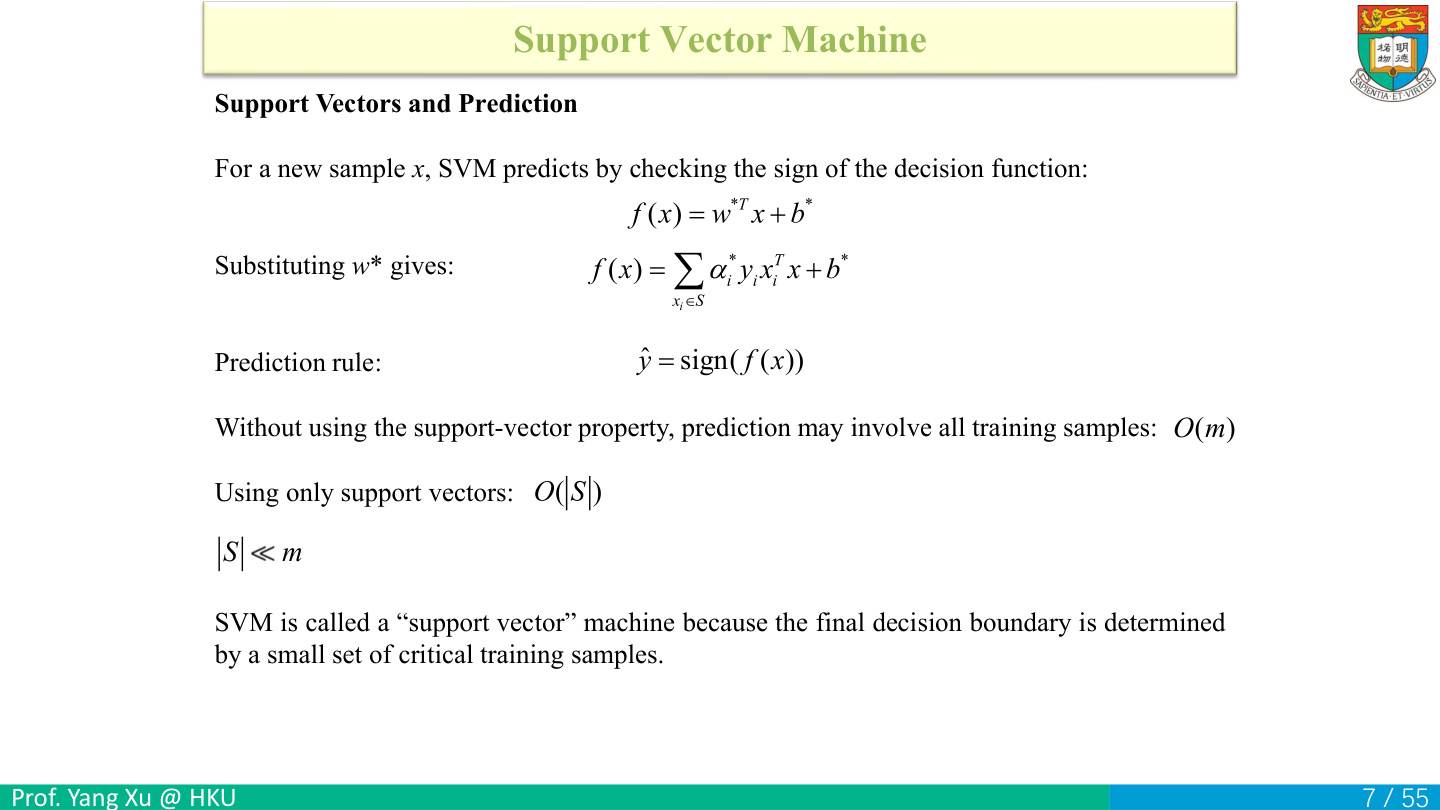
线性SVM的分数是 g(x)=w*ᵀx+b*。用训练得到的表达式替换w,就得到 g(x)=Σᵢ∈Sαᵢ*yᵢ(xᵢᵀx)+b*。每个支持向量先和新样本做内积,再乘它的标签与系数,全部加总后加偏置。最后 ŷ=sign(g(x)),正数判+1、负数判−1;恰好0时需预先约定平局规则。
例如,一维支持向量x₁=−2、y₁=−1、α₁=0.125;x₂=2、y₂=1、α₂=0.125,b=0。先合成w:0.125×(−1)×(−2)+0.125×1×2=0.5。新点x=3,分数0.5×3=1.5,预测+1。也可逐项算核贡献:0.75+0.75=1.5,两种方式一致。
g是带符号的分界分数:正负决定类别,几何距离为 |g(x)|/||w||。例如g=1.5、||w||=0.5时,点到分界面距离为3。
计算量还要计入每次内积或核运算。d维直接逐点内积约O(|S|d);线性SVM若预先存好w,单点预测可O(d),不必每次遍历支持向量。非线性核预测通常才需要逐个支持向量计算核值。支持向量越少,这种逐点求和的预测越快。
自测: 去掉一个α=0的样本,这个已固定的分数表达式会变吗?答案:不会,因为它对应的求和项为0。
SMO为什么一次至少调整两个α
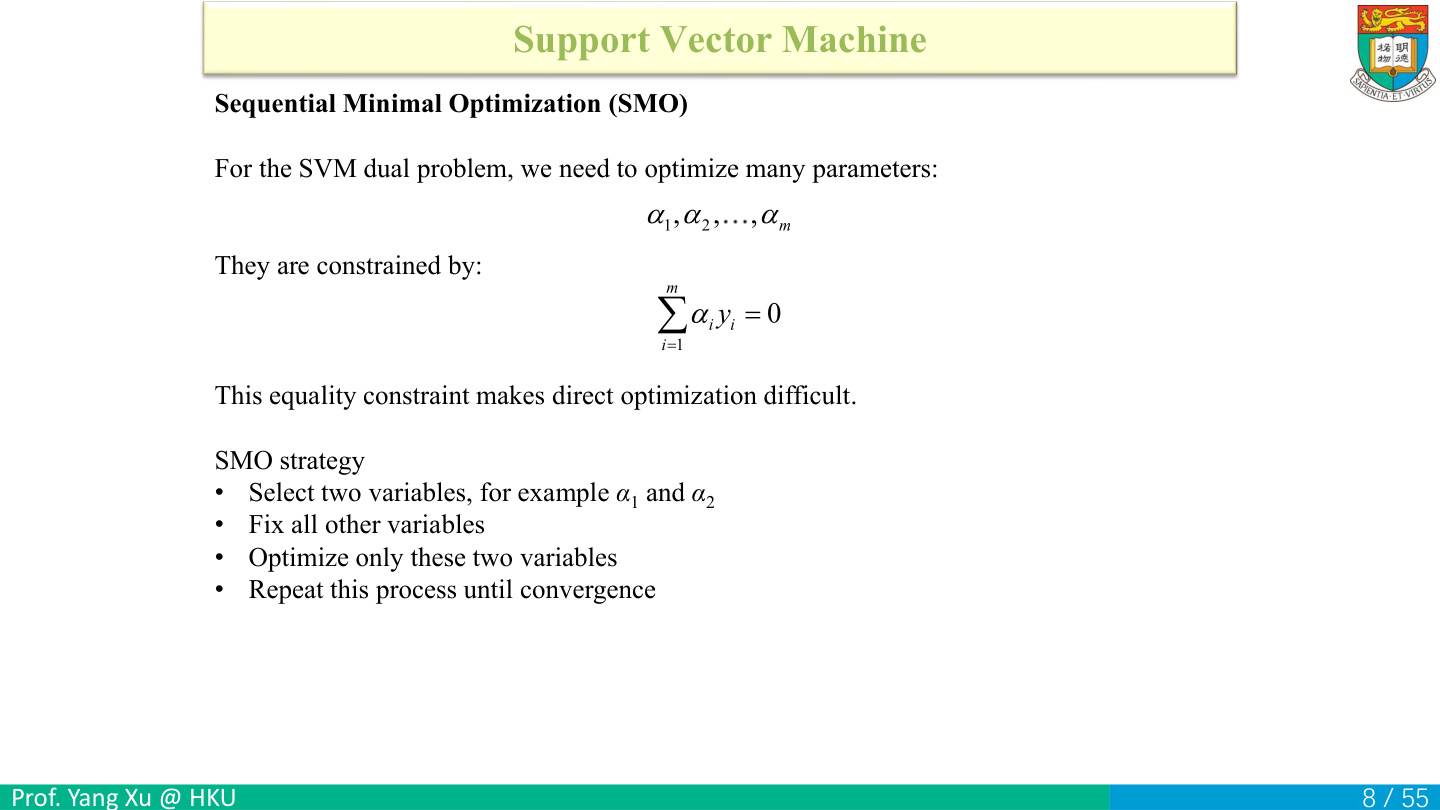
SMO是Sequential Minimal Optimization,序列最小优化。它固定大部分α,每次挑两个变量求解一个小问题,再不断换一对变量继续改进。
不能只任意改一个α,是因为等式 Σαᵢyᵢ=0 必须一直成立。其他变量固定时,若只改α₁一个量Δα₁,等式左边就变化y₁Δα₁;y₁为±1,因此除非Δα₁=0,否则约束被破坏。选择两个变量后,可以用第二个变量抵消第一个带来的变化:y₁Δα₁+y₂Δα₂=0。
例如,若两点标签相反,y₁=+1、y₂=−1,则Δα₂=Δα₁,两者要同增同减,保持α₁−α₂不变。若标签相同,两者必须反向变化,保持α₁+α₂不变。比如C=1、当前(0.2,0.3)、同标签,第一项增加0.1,第二项应减少0.1为(0.3,0.2)。
每次更新都保持这条等式成立。随后换样本对重复计算,逐步使整个解满足KKT条件;误差缓存可以减少重复的预测计算。
自测: 对标签相反的两点,把α₁加0.1、α₂减0.1能保持约束吗?答案:不能,差值增加0.2;应同向改变。
把固定的其余样本压成一个常数ζ
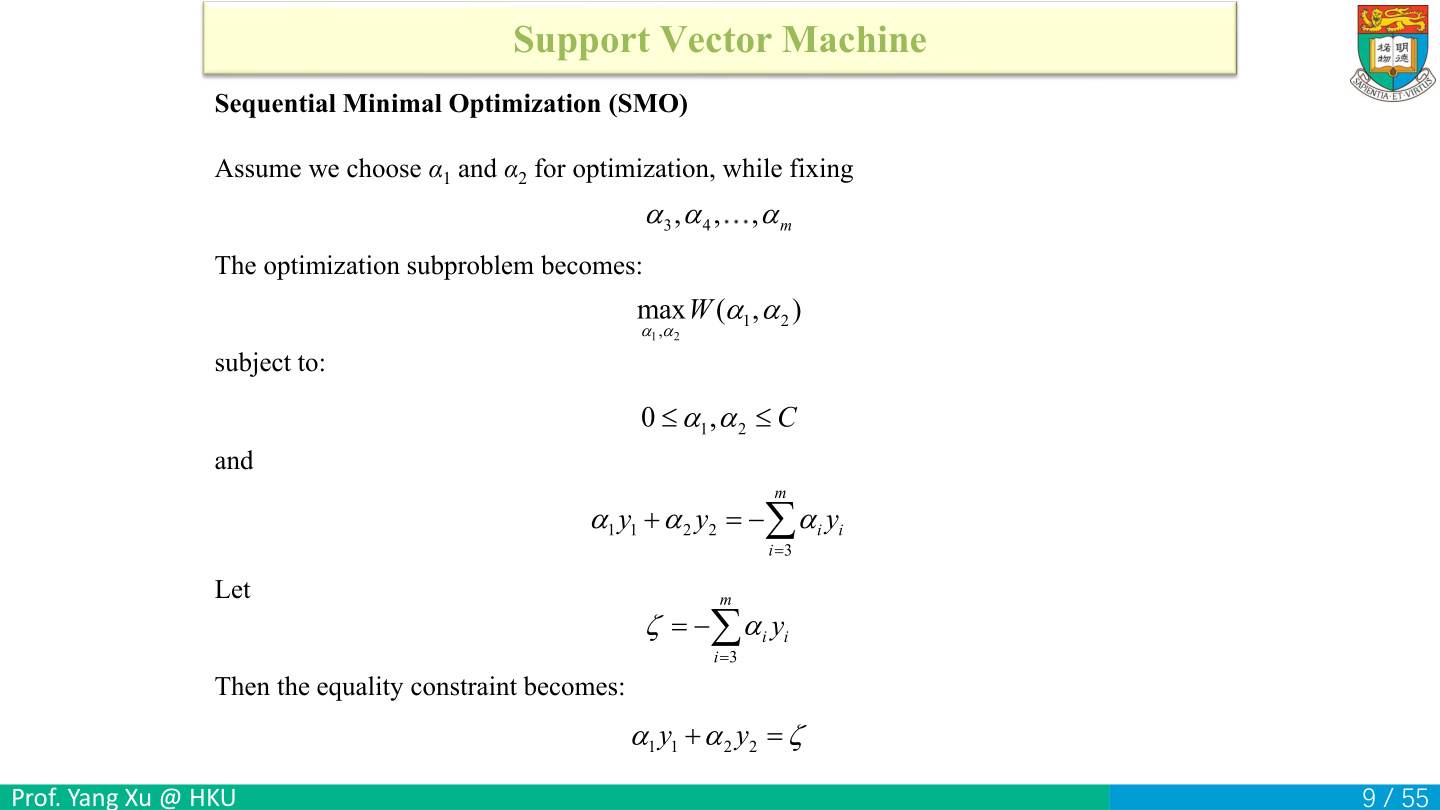
选定α₁、α₂后,α₃到αₘ都先不动。把约束拆开:α₁y₁+α₂y₂+Σᵢ≥3αᵢyᵢ=0,移项得到 α₁y₁+α₂y₂=−Σᵢ≥3αᵢyᵢ。右边记为ζ。ζ在当前小问题中固定;换一对样本后,要按新的其余样本重新计算ζ。
于是本次只需在 0≤α₁,α₂≤C 的正方形中,沿直线 α₁y₁+α₂y₂=ζ 找让W最大的点。这条直线把两个自由变量减少成一个自由度;下一页仍写两个变量,是为了先整理目标函数。
例如,y₁=+1、y₂=−1,其他点贡献和为−0.2,则ζ=0.2,约束是α₁−α₂=0.2。若C=1,选α₁=0.6就必须α₂=0.4;选α₁=0.1则要求α₂=−0.1,不可行。因此要同时满足两个变量的上下界。
下标i从3开始,是因为当前选中的两个样本已单独列出。每次都可以把新选的一对临时编号为1、2,其余样本编号3到m。
自测: ζ是不是希望最大化的量?答案:不是,它只记录当前被固定变量对等式约束的贡献,真正最大化的仍是W。
把对偶双重求和拆成能变与不能变的部分
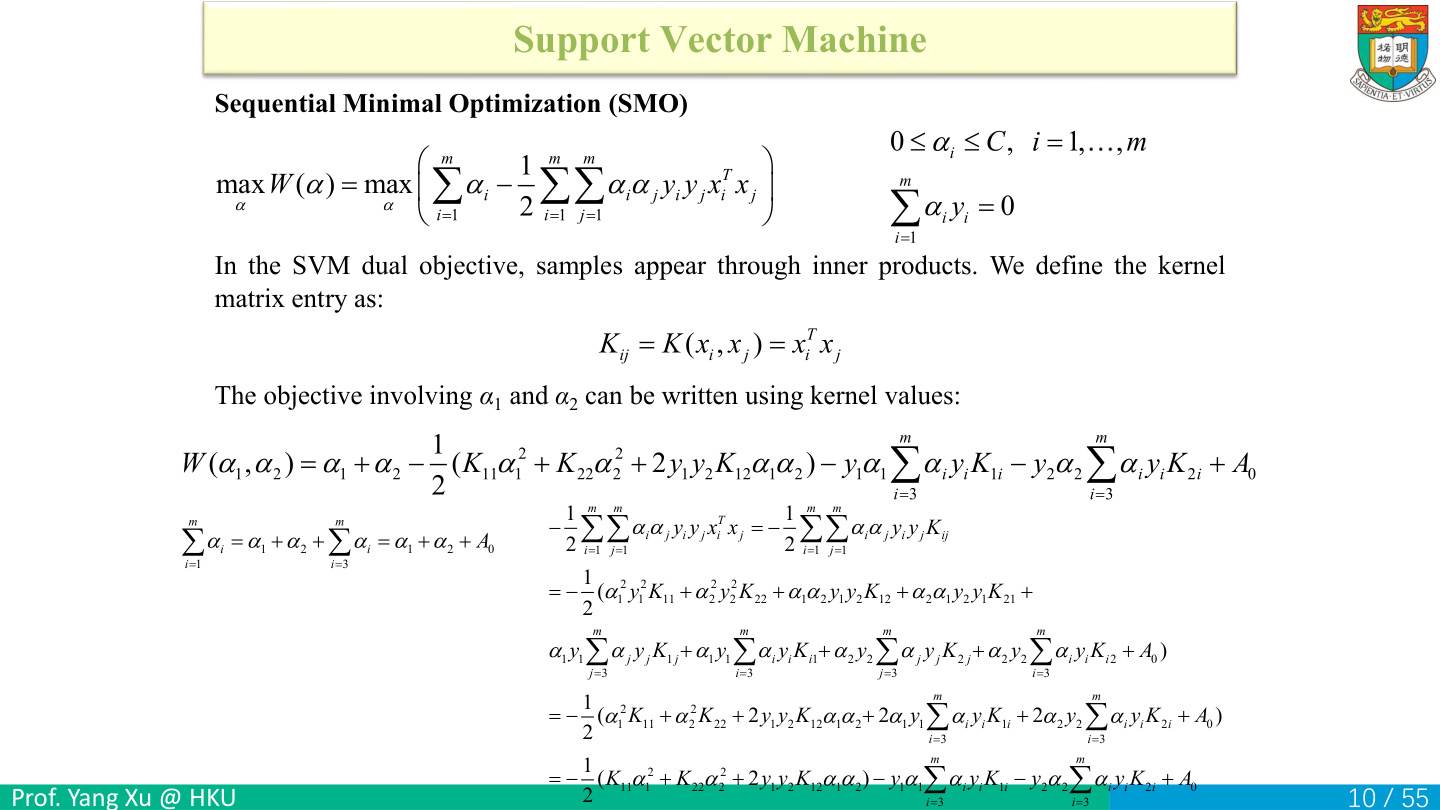
定义 Kᵢⱼ=xᵢᵀxⱼ,线性核下有Kᵢⱼ=Kⱼᵢ。原目标的双重求和包含所有样本对,本次只有α₁、α₂会变。按下标分组后,可写为:
W=α₁+α₂−½(K₁₁α₁²+K₂₂α₂²+2y₁y₂K₁₂α₁α₂)−y₁α₁A−y₂α₂B+常数,其中 A=Σᵢ≥3αᵢyᵢK₁ᵢ、B=Σᵢ≥3αᵢyᵢK₂ᵢ。
逐项理解:i=j=1给α₁²y₁²K₁₁,因y₁²=1,留下α₁²K₁₁;i=1,j=2与i=2,j=1是相同标量,合并成两倍交叉项;一个下标为1、另一个≥3的两组也对称,外面的1/2与两倍抵消,得到−y₁α₁A。两下标都≥3的部分不随本次变量变化,吸收到常数中。
例如,三样本时,A只有一项α₃y₃K₁₃,B只有一项α₃y₃K₂₃。A、B本身固定,但它们分别乘着会变化的α₁、α₂,因此要留在目标里。完全不含本次变量的项才归入常数。
自测: 交叉项为什么有2?答案:双重求和分别包含(1,2)和(2,1),利用核的对称性合并。
消去α₂:两个变量变成一个抛物线
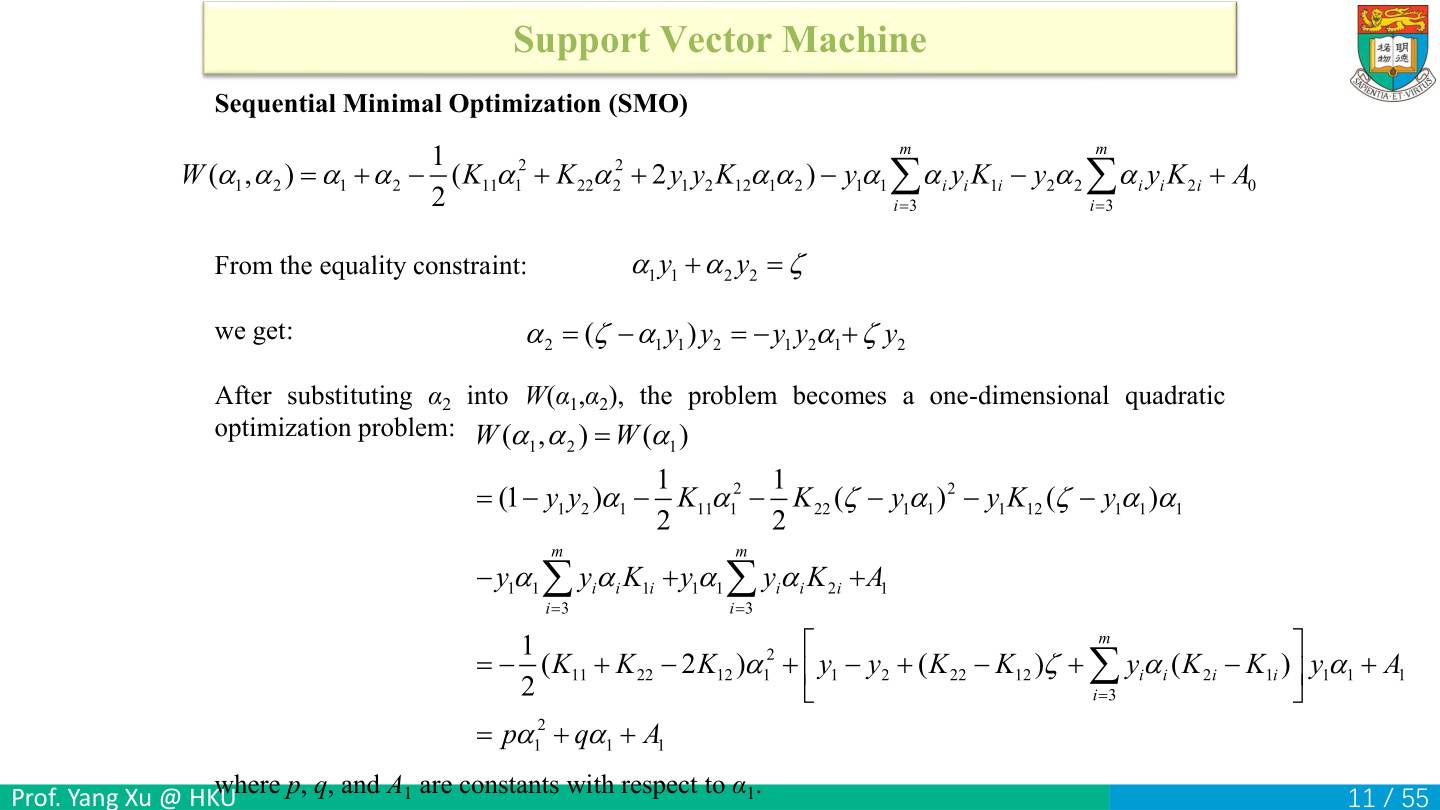
本页把两变量问题缩成一个变量。先由约束 α₁y₁+α₂y₂=ζ 移项,再乘y₂;因y₂²=1,得到 α₂=y₂ζ−y₁y₂α₁。
为了看清展开,暂记 a=α₁、s=y₁y₂、t=y₂ζ,所以 α₂=t−sa,且s²=1。再记固定部分 A=Σᵢ≥3αᵢyᵢK₁ᵢ、B=Σᵢ≥3αᵢyᵢK₂ᵢ。把它们代入上一页目标:
W=a+(t−sa)−½[K₁₁a²+K₂₂(t−sa)²+2sK₁₂a(t−sa)]−y₁Aa−y₂B(t−sa)+常数。
接下来只做“展开括号、合并同类项”。每一项对a²和a分别贡献多少:
| 原来的一项 | a²的系数 | a的系数 |
|---|---|---|
| a+(t−sa) | 0 | 1−s |
| −½K₁₁a² | −½K₁₁ | 0 |
| −½K₂₂(t−sa)² | −½K₂₂s²=−½K₂₂ | K₂₂ts |
| −sK₁₂a(t−sa) | s²K₁₂=K₁₂ | −sK₁₂t |
| −y₁Aa−y₂B(t−sa) | 0 | −y₁A+y₂sB=y₁(B−A) |
因此二次系数为 p=−½K₁₁−½K₂₂+K₁₂=−½(K₁₁+K₂₂−2K₁₂)。一次系数为 q=1−s+st(K₂₂−K₁₂)+y₁(B−A)。
利用st=y₁ζ、1−s=y₁(y₁−y₂),也可写成 q=y₁[y₁−y₂+ζ(K₂₂−K₁₂)+B−A]。把a设为0,剩下的 t−½K₂₂t²−y₂Bt+A₀ 就是常数A₁,这里的A₀是上页留下的常数。最终 W(a)=pa²+qa+A₁。
例如,两点标签相反、ζ=0、K₁₁=K₂₂=1、K₁₂=−1,且没有其他点,则α₂=α₁=a:
W(a)=2a−½(1+1+2)a²=2a−2a²。
导数为 2−4a,令它为0得a=0.5。代入a=0、0.5、1,W分别为0、0.5、0,能看到中间最高。
自测: 为什么不含a的A₁可以暂时忽略?答案:它对a的导数为0,改变A₁只会上下平移曲线。
二次系数为什么一定不大于0
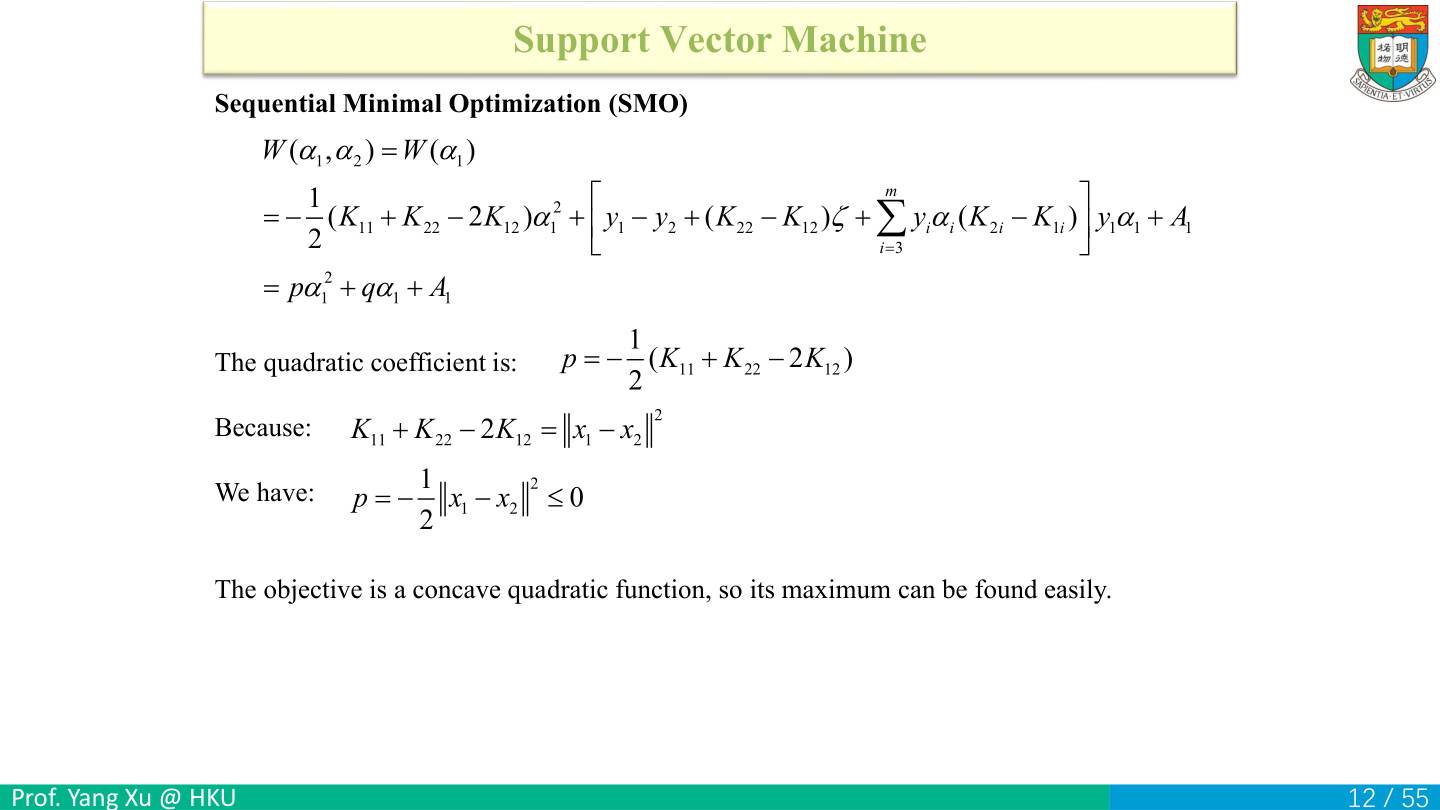
线性核下 K₁₁=x₁ᵀx₁、K₂₂=x₂ᵀx₂、K₁₂=x₁ᵀx₂。展开差向量的长度平方:||x₁−x₂||²=(x₁−x₂)ᵀ(x₁−x₂)=x₁ᵀx₁+x₂ᵀx₂−2x₁ᵀx₂。因此 K₁₁+K₂₂−2K₁₂=||x₁−x₂||²≥0。
乘−1/2得到 p=−||x₁−x₂||²/2≤0。p<0时W是一条开口向下的抛物线,因此峰顶就是无约束最大点。
例如,x₁=(1,0)、x₂=(0,1),K₁₁=K₂₂=1、K₁₂=0,p=−1。两点相距√2,长度平方2,代入−2/2也是−1,两种算法一致。
若x₁=x₂,则长度平方0,p=0,W不再是严格二次曲线,而是线性函数或常数。此时按线性目标比较可行区间端点;若目标为常数,就保持当前值。对半正定核,同一推导对应特征空间中的距离平方,因此仍有p≤0。
对一般半正定核,也可以直接检查对应的2×2核矩阵。用向量 v=(1,−1)ᵀ 左右相乘得到 vᵀKv=K₁₁+K₂₂−2K₁₂≥0,因此不必实际算出映射后的向量,就能确定曲线开口的方向。
自测: p=0、q>0时,在有限可行区间[L,U]哪里最大?答案:U,因为W=qα₁+A₁随α₁增大而增大。
先找峰顶,再裁到真正可行的区间
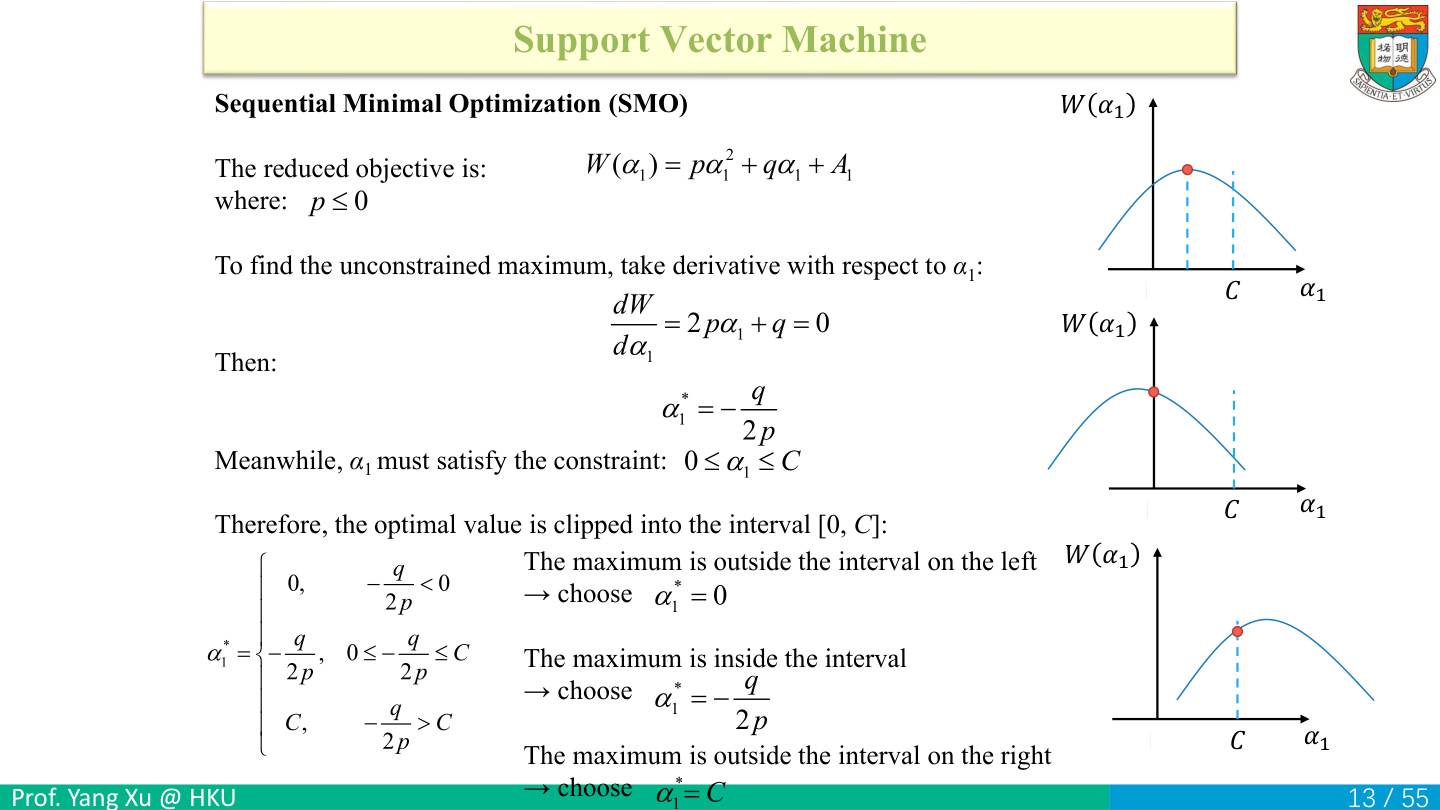
上一页把目标写成 W(a)=pa²+qa+A₁,这里a表示α₁。p<0时曲线开口向下:先找峰顶,再检查峰顶是否落在允许的区间[L,U]。
求导时,pa²变成2pa,qa变成q,常数A₁变成0。因此:
W′(a)=2pa+q=0 → 2pa=−q → a*=−q/(2p)。
这一步先不考虑边界。随后按三种位置处理:
| 峰顶位置 | 可行的最优值 | 原因 |
|---|---|---|
| a*<L | L | 整个可行区间已在峰顶右侧,越往右越低 |
| L≤a*≤U | a* | 峰顶本身合法 |
| a*>U | U | 整个可行区间在峰顶左侧,越往右越高 |
合成一个式子就是 a_new=min(U,max(L,a*)):内层max先把a*抬到至少L,外层min再把结果压到至多U。
例如 W(a)=−2a²+2a,有p=−2、q=2,故峰顶 −2/[2×(−2)]=0.5。区间若为[0.7,1],先max(0.7,0.5)=0.7,再min(1,0.7)=0.7;W(0.7)=0.42,W(1)=0。区间若为[0.2,0.8],峰顶0.5可以保留,W=0.5。
SMO的[L,U]要同时满足α₁与α₂的上下界,下一页求这个共同区间。p=0时目标是线性函数:q>0选U,q<0选L,q=0时区间内各点一样好。
自测: 峰顶1.3、允许区间[0.2,0.9],取多少?答案:0.9;峰顶在区间右边,选右端点。
用α₂的约束收紧区间,再继续换样本对
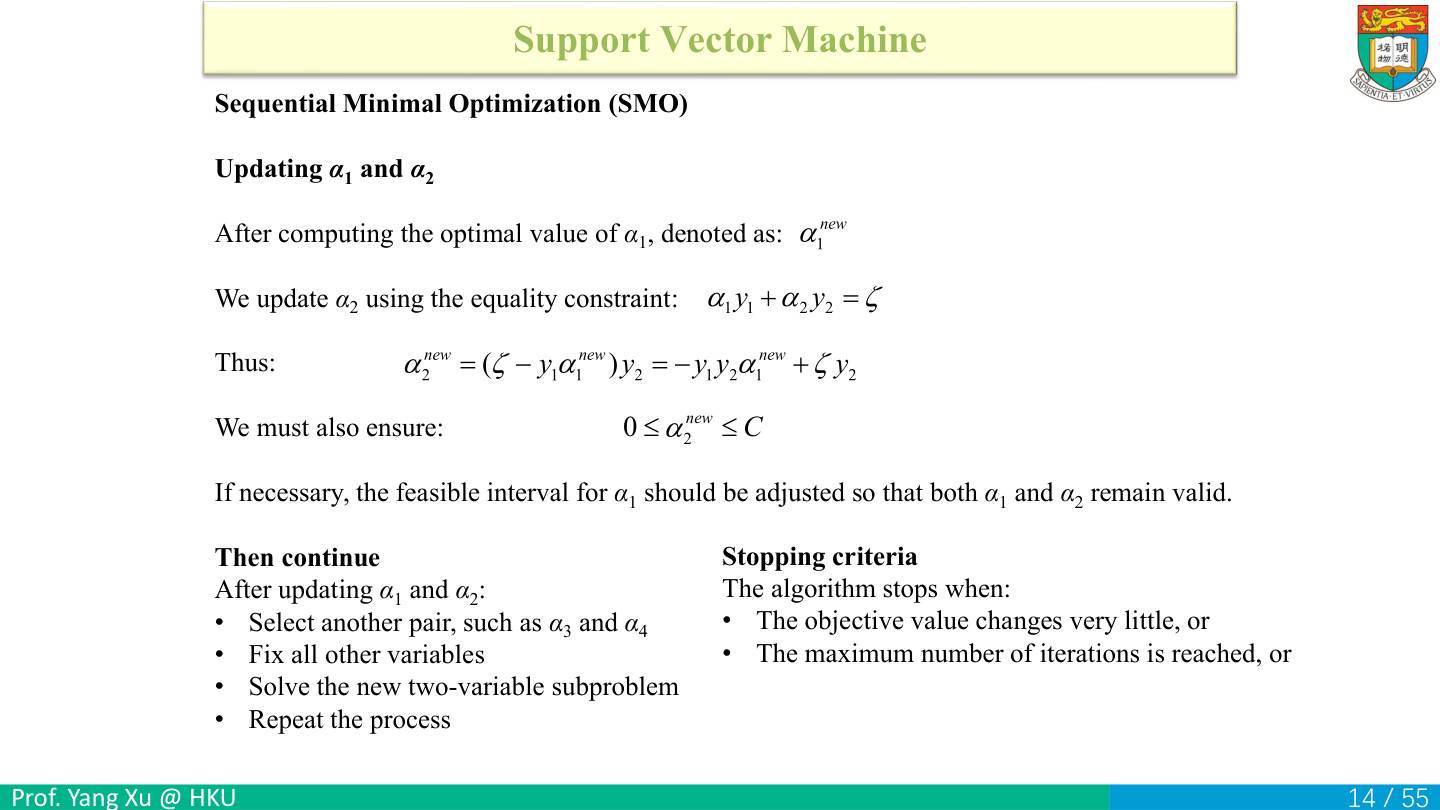
α₁、α₂都必须在[0,C]内,且 α₁y₁+α₂y₂=ζ。先用等式把α₂写成α₁,再把α₂的上下界变成对α₁的限制,最后与α₁自己的[0,C]取交集。
标签相同。 因y₁=y₂,把等式两边乘y₁,得 α₁+α₂=ζy₁。记s=ζy₁,则 α₂=s−α₁:
- α₂≥0给
s−α₁≥0,即α₁≤s。 - α₂≤C给
s−α₁≤C,即α₁≥s−C。 - 再结合0≤α₁≤C,得到
L=max(0,s−C)、U=min(C,s)。
标签相反。 此时y₁y₂=−1,两边乘y₁后得 α₁−α₂=ζy₁。记d=ζy₁,则 α₂=α₁−d:
- α₂≥0给α₁≥d;α₂≤C给α₁≤C+d。
- 与[0,C]取交集,得到
L=max(0,d)、U=min(C,C+d)。
例如标签相反,C=1、d=0.4,因此α₂=α₁−0.4,允许区间为 [max(0,0.4),min(1,1.4)]=[0.4,1]。
| 试选α₁ | 由等式得到α₂ | 是否合法 |
|---|---|---|
| 0.2 | −0.2 | α₂小于0 |
| 0.4 | 0 | 两者均在[0,1] |
| 1 | 0.6 | 两者均在[0,1] |
若算出的无约束峰顶是0.2,就先把α₁裁成0.4,再恢复α₂=0。顺序是先求共同区间、再裁剪、再恢复另一个变量。
一对α更新完后,若其中某个点的新系数满足 0<αᵢ<C,把它代入第6页的边界条件 g(xᵢ)=yᵢ,即可算出新偏置 b=yᵢ−ΣⱼαⱼyⱼK(xⱼ,xᵢ)。再用新模型更新误差缓存,挑下一对继续。可用KKT违反程度、目标变化量与迭代上限决定何时停止。
自测: 同标签、C=1、s=0.3时,α₁最大多少?答案:U=min(1,0.3)=0.3;此时α₂=0。
核SVM预测:保留支持向量就能算新样本
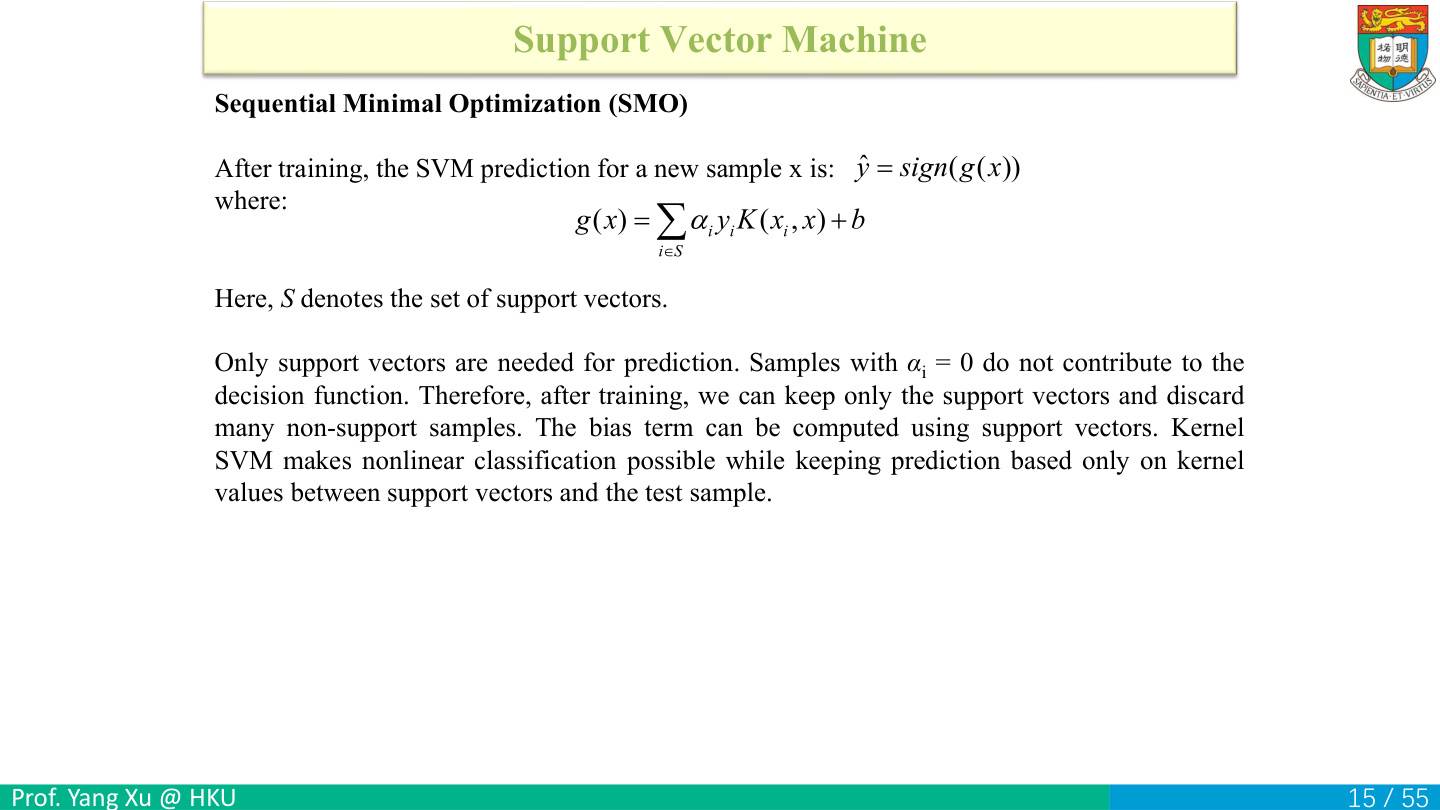
预测公式为 g(x)=Σᵢ∈SαᵢyᵢK(xᵢ,x)+b,再 ŷ=sign(g(x))。需要保存的内容包括支持向量xᵢ、它们的系数αᵢyᵢ、偏置b以及核函数和核参数,计算K(xᵢ,x)时会用到这些支持向量的特征。
例如,若支持向量只有正、负两点,两个α都为0.8,乘标签后系数为+0.8和−0.8,符合 Σαᵢyᵢ=0。新点与它们的核值分别为0.9和0.2,b=−0.1,于是 g=0.8×0.9−0.8×0.2−0.1=0.46,输出+1。其中正系数项推高总分,负系数项压低总分。
若使用高斯核,K比较新点与每个支持向量的局部相似性,得到的原空间边界可弯曲;不需要显式列出一个高维w。若使用线性核,则可事先把支持向量贡献合并成w,减少预测存储与计算。
训练时所有样本共同约束分界面;训练完成后,预测求和中只保留α>0的项。偏置b可由第6页的自由支持向量条件恢复。
自测: 新样本的真实标签需要进入这个求和吗?答案:不需要。求和中的yᵢ是历史支持向量的训练标签,不是未知的新标签。
用预测误差写出SMO的快速更新
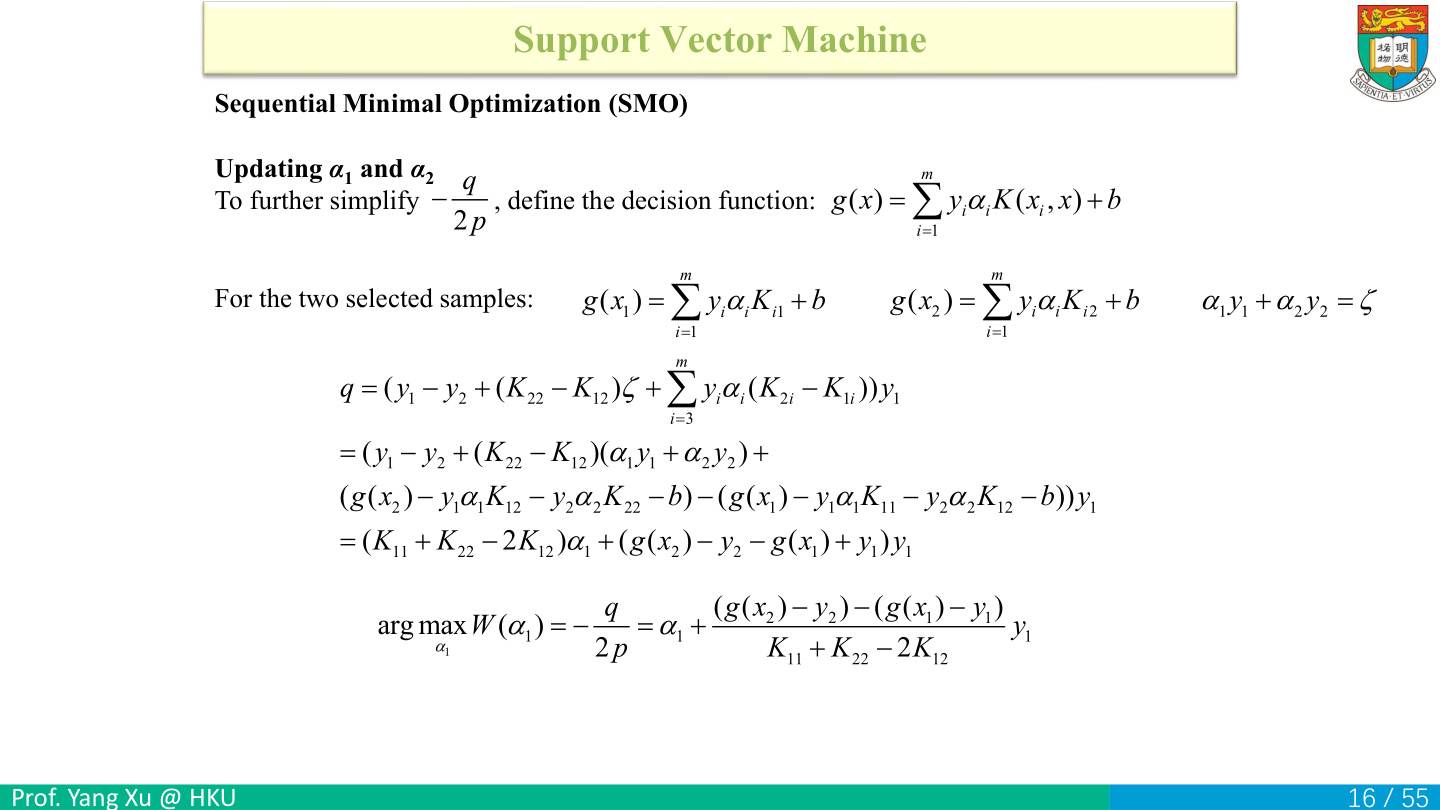
用旧模型分数定义 E₁=g(x₁)−y₁、E₂=g(x₂)−y₂。再记 ηₖ=K₁₁+K₂₂−2K₁₂,它是当前样本对的曲率量。目标是把峰顶 −q/(2p) 改写成“旧α加一个误差修正”。
1.先写出分数差。 仍令 A=Σᵢ≥3αᵢyᵢK₁ᵢ、B=Σᵢ≥3αᵢyᵢK₂ᵢ。两个分数分别是:
g(x₁)=α₁y₁K₁₁+α₂y₂K₁₂+A+b;
g(x₂)=α₁y₁K₁₂+α₂y₂K₂₂+B+b。
相减时b抵消,得到 g(x₂)−g(x₁)=α₁y₁(K₁₂−K₁₁)+α₂y₂(K₂₂−K₁₂)+B−A。
2.用等式约束整理固定部分。 把 ζ=α₁y₁+α₂y₂ 代入,比较两边的系数可得:
ζ(K₂₂−K₁₂)+B−A=g(x₂)−g(x₁)+α₁y₁ηₖ。
例如α₁y₁的系数由 (K₁₂−K₁₁)+ηₖ 化成 K₂₂−K₁₂,正好与左侧一致。
3.代回q。 第11页的 q=y₁[y₁−y₂+ζ(K₂₂−K₁₂)+B−A] 变成:
q=α₁ηₖ+y₁[(g(x₂)−y₂)−(g(x₁)−y₁)]=α₁ηₖ+y₁(E₂−E₁)。
因为p=−ηₖ/2,所以 −q/(2p)=q/ηₖ。ηₖ>0时,得到无约束更新:
α₁,new=α₁,old+y₁(E₂−E₁)/ηₖ。
4.把数字一项项代入。 旧α₁=0.3、y₁=1、E₁=−0.4、E₂=0.2、ηₖ=2:
| 计算 | 结果 |
|---|---|
| E₂−E₁=0.2−(−0.4) | 0.6 |
| y₁(E₂−E₁)/ηₖ=1×0.6/2 | 0.3 |
| 旧α₁+修正=0.3+0.3 | 0.6 |
| 若共同区间为[0.1,0.5],裁剪后 | 0.5 |
若本例取两点标签相反、C=0.5且约束是 α₁−α₂=0.1,这个区间正是[0.1,0.5]。旧α₂为0.2,新α₂为 0.5−0.1=0.4,两个α都增加了0.2,差仍为0.1。新α₂在(0,C)内,所以用第二个点恢复b,再重新计算误差。ηₖ=0时比较可行区间端点的目标值。
自测: E₁=E₂时,公式中的修正量是多少?答案:0,故这次无约束更新保留旧α₁。
软间隔与核技巧解决的是不同困难
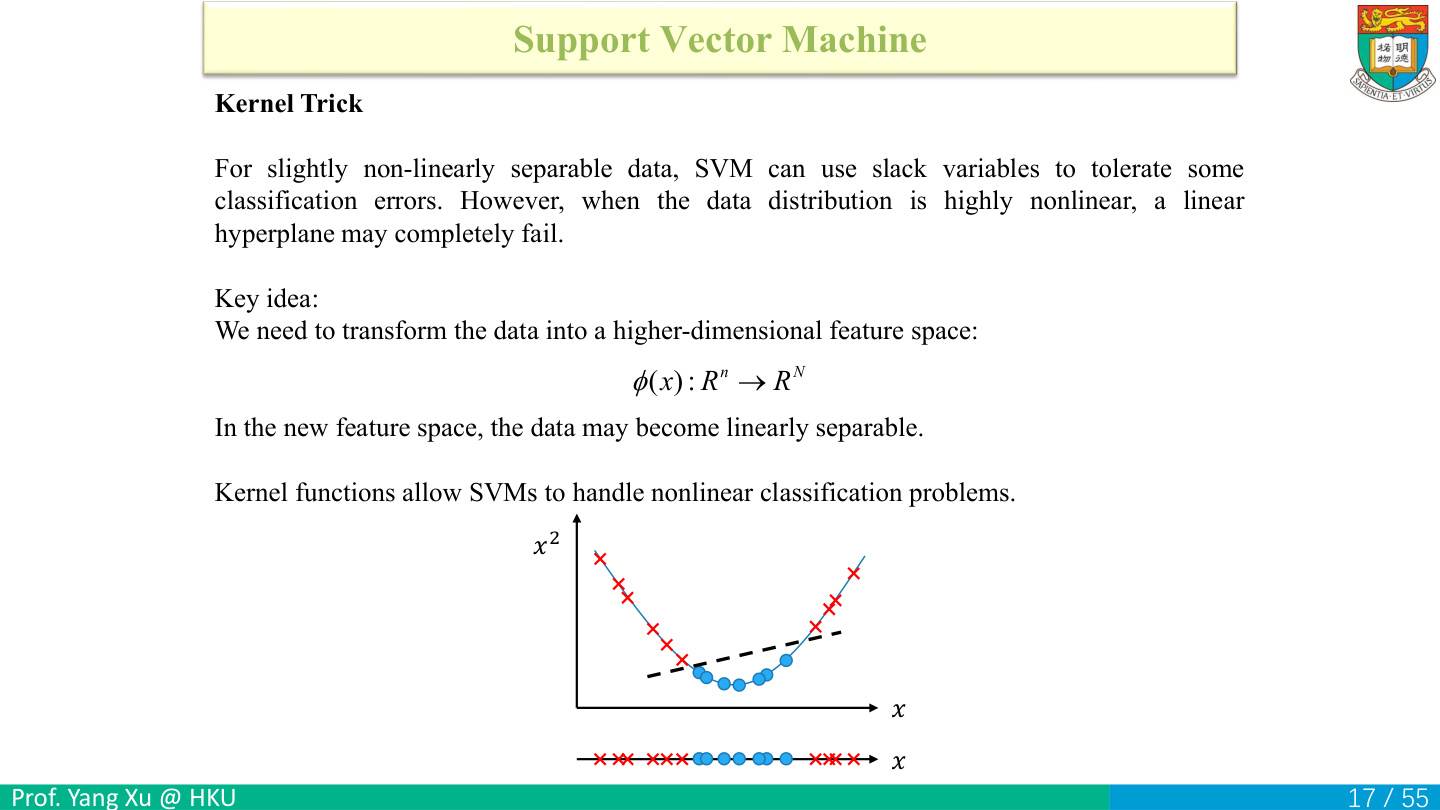
软间隔允许样本侵犯间隔或错分;核方法则改变输入表示,使模型能描述弯曲边界。例如“圆内一类、圆外一类”需要非线性表示。核方法引入特征映射 φ:Rⁿ→Rᴺ,在新的表示空间中学习线性分界面。
例如,二维样本按到原点距离是否小于1分类。增加特征 z=x₁²+x₂² 后,规则 z≤1 就是在新特征空间里的线性阈值;在原平面看回去仍是一条圆。这解释“高维空间线性”与“原空间非线性”能够同时成立。
核SVM通常配合软间隔:核提供非线性表达能力,松弛变量处理噪声和类别重叠。
图中的升维表示给每个样本重新计算一组坐标。维数N可很大,有的核对应无限维表示,下一页会说明怎样避开显式计算这些坐标。
自测: 增大C是否等价于换一个非线性核?答案:不等价。C改变违规与间隔的权衡,核改变模型使用的相似性与特征表示。
核技巧:只算内积,不必先写出所有高维坐标
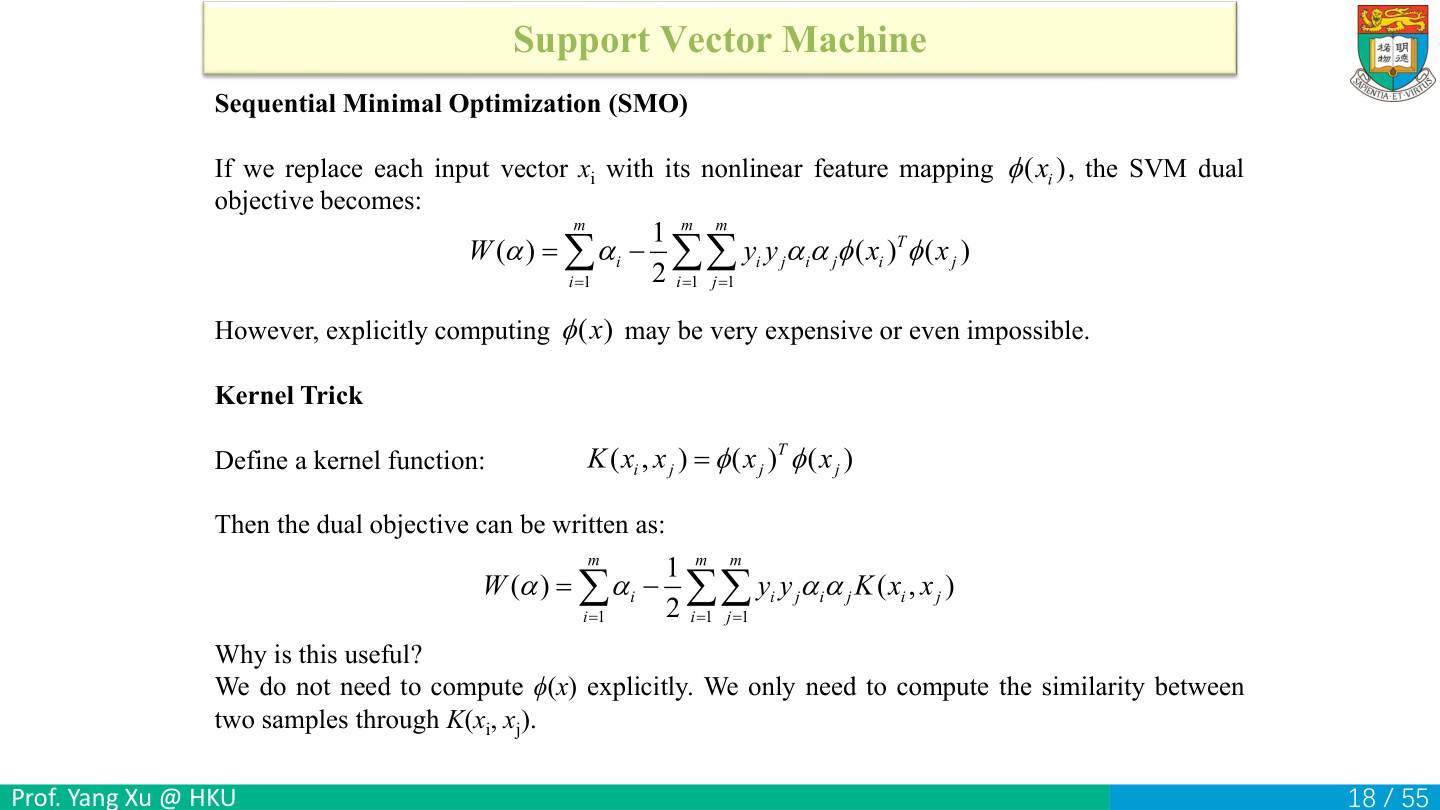
把原样本替换为φ(x)后,对偶中只出现 φ(xᵢ)ᵀφ(xⱼ)。若能用一个便宜的函数直接算出这个内积,定义 K(xᵢ,xⱼ)=φ(xᵢ)ᵀφ(xⱼ),就不必真的建立高维向量。右侧两个索引分别是i和j,表示两个样本映射后的内积;若都写j,就只剩第二个样本自己的长度平方。
算一遍:二维二次齐次核 K(x,z)=(xᵀz)²。展开 (x₁z₁+x₂z₂)²=x₁²z₁²+2x₁x₂z₁z₂+x₂²z₂²,对应映射 φ(x)=(x₁²,√2x₁x₂,x₂²)。两映射内积正好等于核值。取x=(1,2)、z=(3,4),原内积11,核121;映射内积 1×9+(2√2)(12√2)+4×16=9+48+64=121。
核值提供样本对的特征空间内积。训练用它求解α,预测用它加权求和;有效核的Gram矩阵应为半正定,使对偶目标保持所需的凹性。
自测: 使用核技巧后是否不用训练?答案:仍要训练;它省掉的是显式高维特征计算,不是模型参数的求解。
常见核:看清尺度、范围和条件
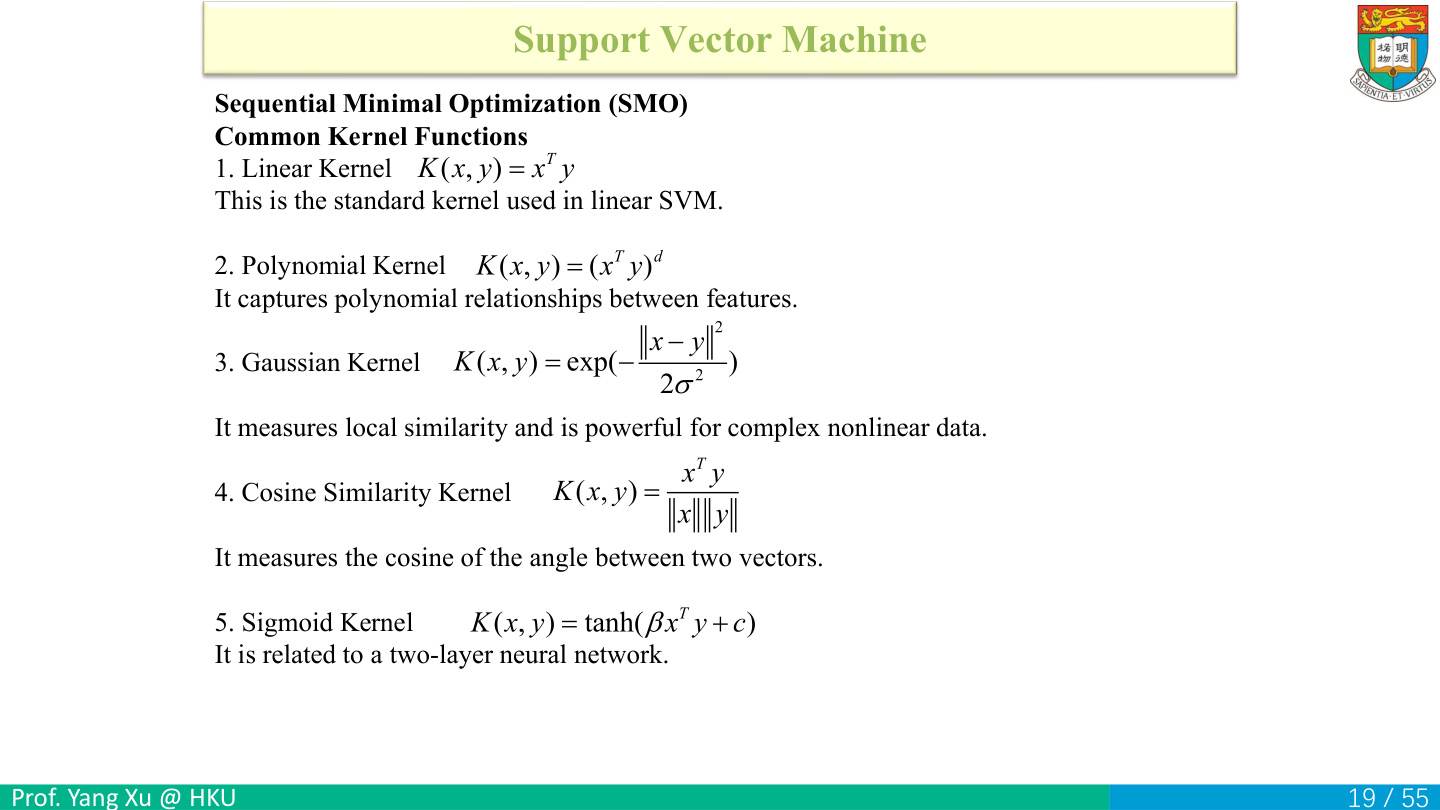
线性核 K(x,z)=xᵀz,仍使用原特征空间的线性边界。多项式核 写作 (xᵀz)^d,d通常取正整数;带常数项的常见形式为 (xᵀz+c)^d,计算时先确认使用哪一种定义。d=2会引入二次交互关系。
高斯/RBF核 exp(−||x−z||²/(2σ²))。同一个点距离0,核值1;距离越大核值越小。σ很小则相似性只集中在很近的点,可能形成很细碎的边界;σ很大时许多点彼此相似,表达更平滑。特征单位会影响距离,因此常需使用只在训练集拟合的尺度处理。
余弦核 xᵀz/(||x||||z||),关注方向,适用于非零向量;若存在零向量,分母为0需明确处理。Sigmoid核 tanh(βxᵀz+c) 需要选择满足核条件的β、c,才能得到半正定Gram矩阵。
例如,x=(1,0)、z=(0,1),线性核0,二次齐次核0;RBF若σ=1,距离平方2,核e^(−1)≈0.3679;余弦为0。这里0.3679衡量RBF相似性,最终类别由各支持向量的加权总分决定。
自测: 把温度从°C换成放大100倍的数,RBF结果一定不变吗?答案:不会,距离会改变,应统一尺度或相应调整核参数。
休息页:用两个问题收束SVM
休息15分钟。
决策树的三个位置:根、内部节点、叶子
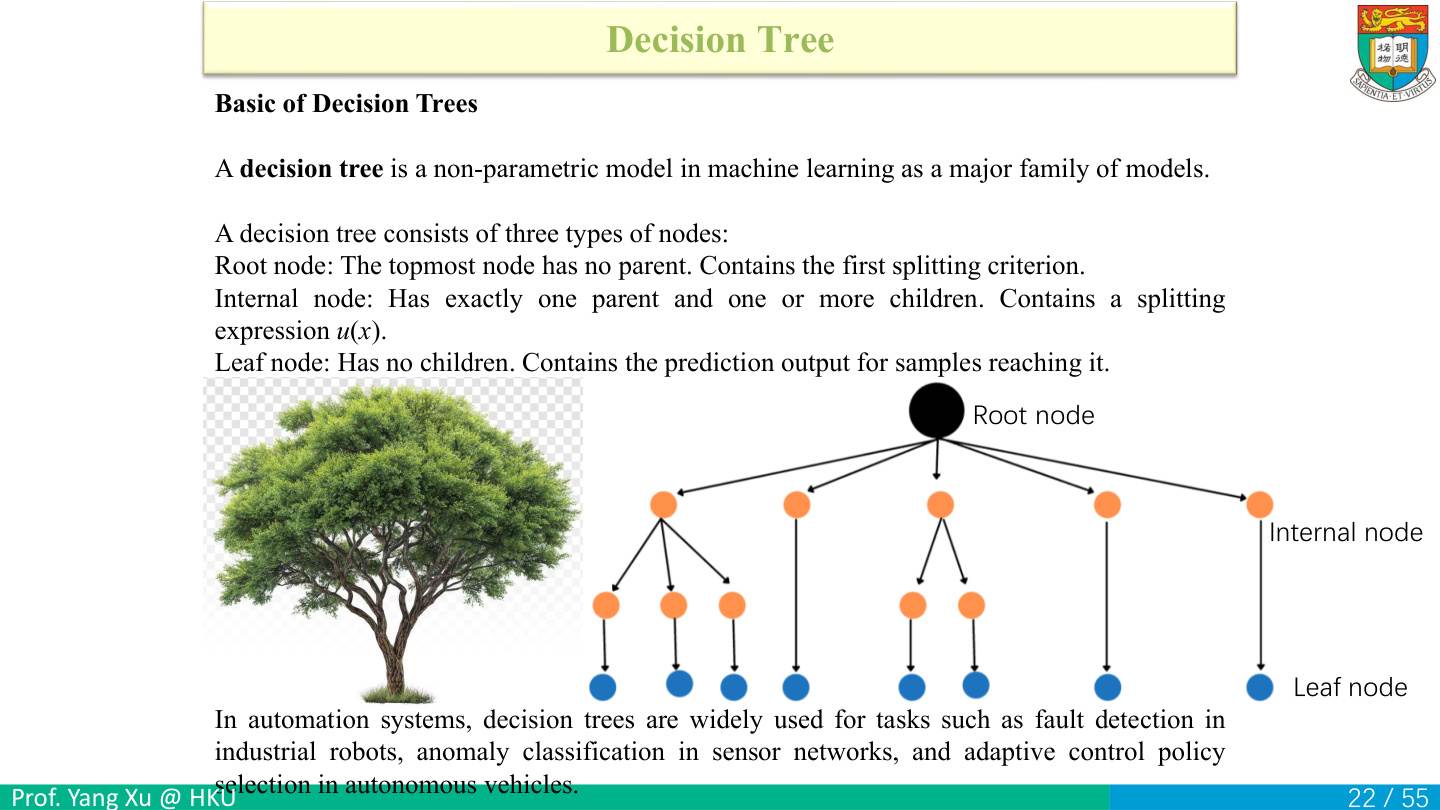
决策树像一张会自动走下去的问诊表。根节点在最上面,没有父节点,放第一道问题;内部节点接着问问题;叶节点没有子节点,给出最终预测。图中从一个节点分出的线叫分支,表示问题的不同回答。
例如,根节点问“振动>4.5g吗?”若否,走右边;若是,走左边,继续问温度。走到“正常”或“故障”叶子时停止。一次预测沿一条从根到叶的路径进行。叶子可以存类别,也可以存一个数,因此后面既有分类树也有回归树。
决策树属于non-parametric(非参数)模型:树的规模和结构可随数据变化。节点特征、阈值和叶子预测仍要从数据中学出来。
读图时注意根只有一个,内部节点通常包括根以外的分裂节点;不同教材也会把根归入内部节点,这是命名习惯。二叉树每个分裂有两个孩子,但一般决策树也可多分支,本页先讲通用结构。
自测: 叶子上还需要再判断一个特征吗?答案:不需要,叶子表示这条路径已经得出预测。
沿条件从根节点走到叶子
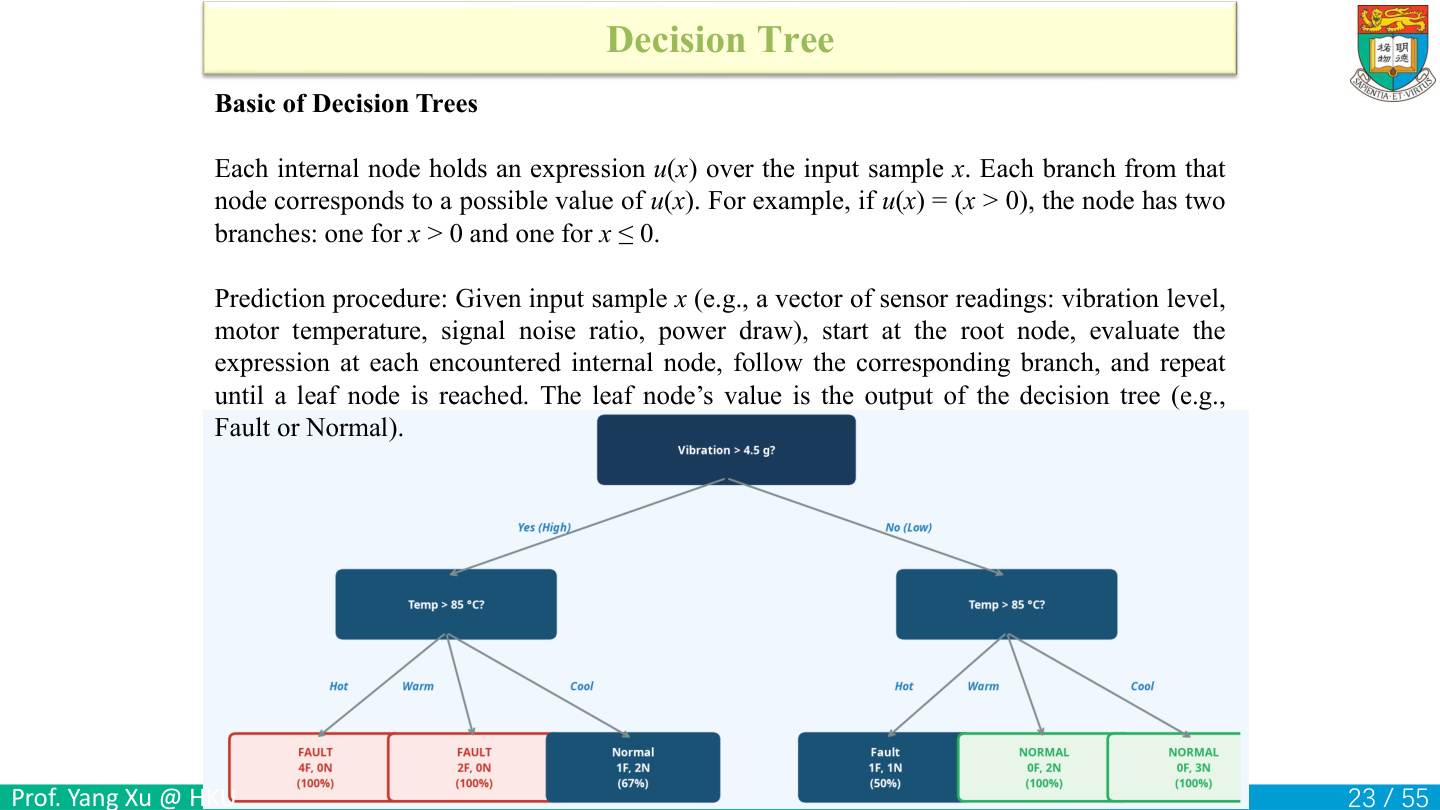
节点保存表达式u(x),分支对应表达式的结果。例如 u(x)=I(xⱼ>0),真与假分别走一边。对于向量输入,xⱼ表示当前节点选中的第j个特征,按这个特征的条件选路。
照本页图走一次。 输入振动5g、温度60°C。先判断5>4.5为真,进入左侧高振动分支;温度属于Cool,走到左边第三个叶子,输出Normal。该叶子的统计为1F、2N,表示训练时落入此处的三条记录中一条故障、两条正常,因此叶子按多数类输出正常。
再看振动3g、温度90°C:先走Low,再走Hot,落入1F、1N的叶子。两类各占一半,按预先约定的平局规则选Fault。
图中温度节点有三条路。落实到代码,就是先判断 温度>85,满足就走Hot。否则再判断 温度≥70,满足走Warm,剩下走Cool。
自测: 左侧Cool叶子的67%指哪一类?答案:正常类;该叶3条训练记录中有2条正常,2/3≈67%。
建树要兼顾训练误差和复杂程度
训练树时要从带标签的样本中选择每个节点的问题。若无限拆分,许多数据集可以分到每个叶子只有一个训练样本,训练误差接近0,却可能只记住噪声,遇到新样本表现很差。完全相同输入但标签冲突时,甚至不能靠分裂使每个叶子纯净。
建树要在准确与简单之间折中。简单可用叶子数、深度等衡量,但叶子数与期望深度不是严格等价:同样四个叶子,可以是很平衡的树,也可以是一条很偏的长链;样本沿不同路径的概率还会影响平均需要问几次。
例如,100条机器记录中有一个异常读数。为了单独识别它,树可能新增好几个分裂,把偶然噪声当规则。限制最大深度、叶子最少样本数或进行剪枝,可以减少这种记忆倾向。设置限制也可能增加偏差,需要验证集比较。
根节点应选择有助于区分类别的特征。唯一编号虽然取值最多,却只识别记录;信息增益与增益率用来衡量特征对标签的帮助,并修正多取值偏好。
自测: 训练准确率100%的树一定比90%的树好吗?答案:不能,必须看未用于训练的数据以及模型复杂度,不能只比较训练集。
机器人故障数据:先分清特征与标签
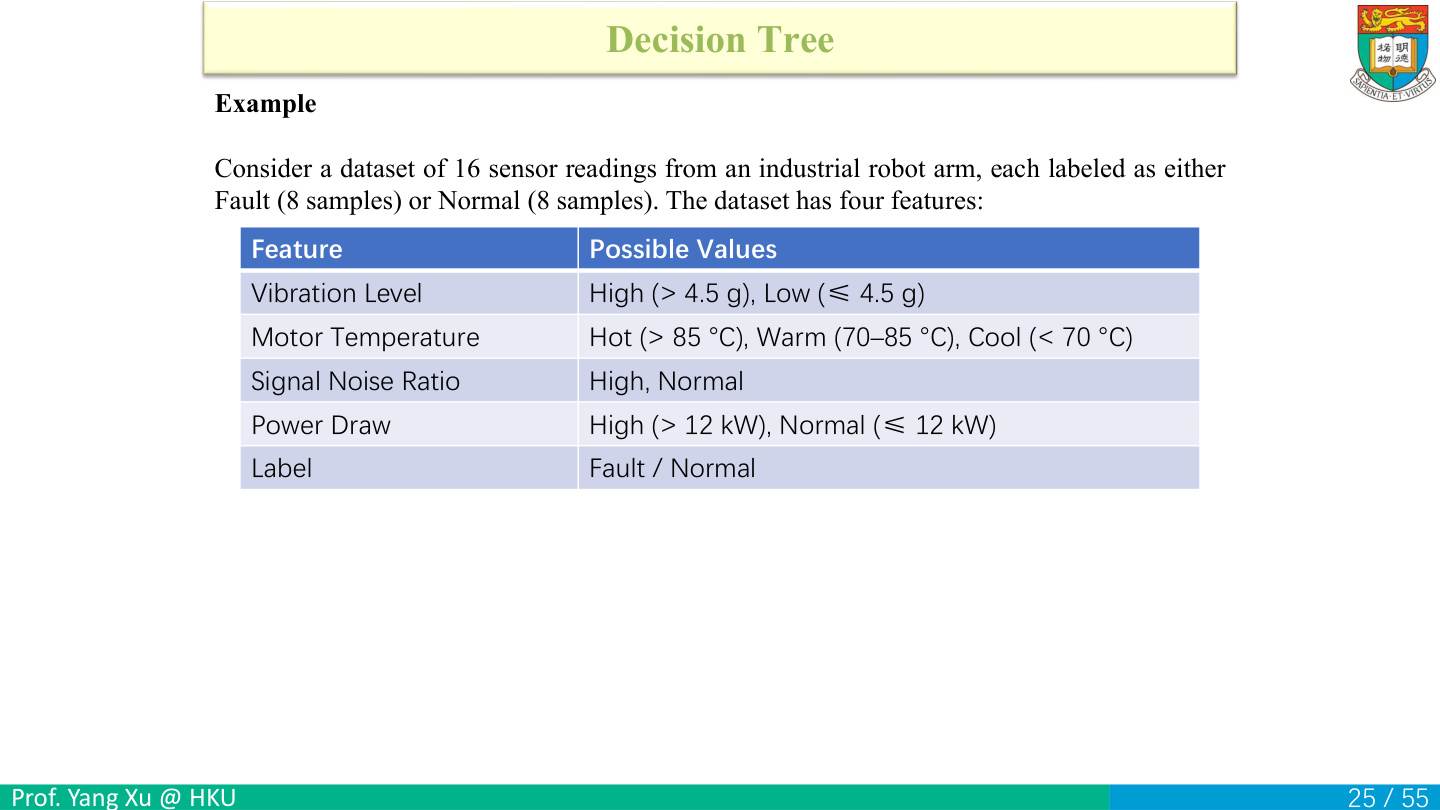
这份例子有16条机器人传感器记录,其中8条Fault(故障)、8条Normal(正常)。四个输入特征是振动、温度、信噪比和功率;标签是要预测的故障/正常。
振动分High(>4.5g)与Low(≤4.5g);g在此是加速度单位的倍数。温度分Hot(>85°C)、Warm(70–85°C)与Cool(<70°C);边界70归Warm,85也归Warm,避免同一个值落入两档。信噪比是High/Normal;功率分High(>12kW)与Normal(≤12kW)。
例如,振动4.5g、温度85°C、功率12kW,应编码为Low、Warm、Normal。严格的大于号和大于等于号决定路径,程序实现必须与文字一致。
这个例子使用已经划好的档位。若由数据学习阈值,就用训练集选好,再固定下来用于后续预测。
自测: 振动4.5g、温度70°C各属于哪档?答案:Low与Warm,因为前者使用≤4.5,后者包含70这个下界。
16行原表怎样数:一行一条记录,一列一种变量
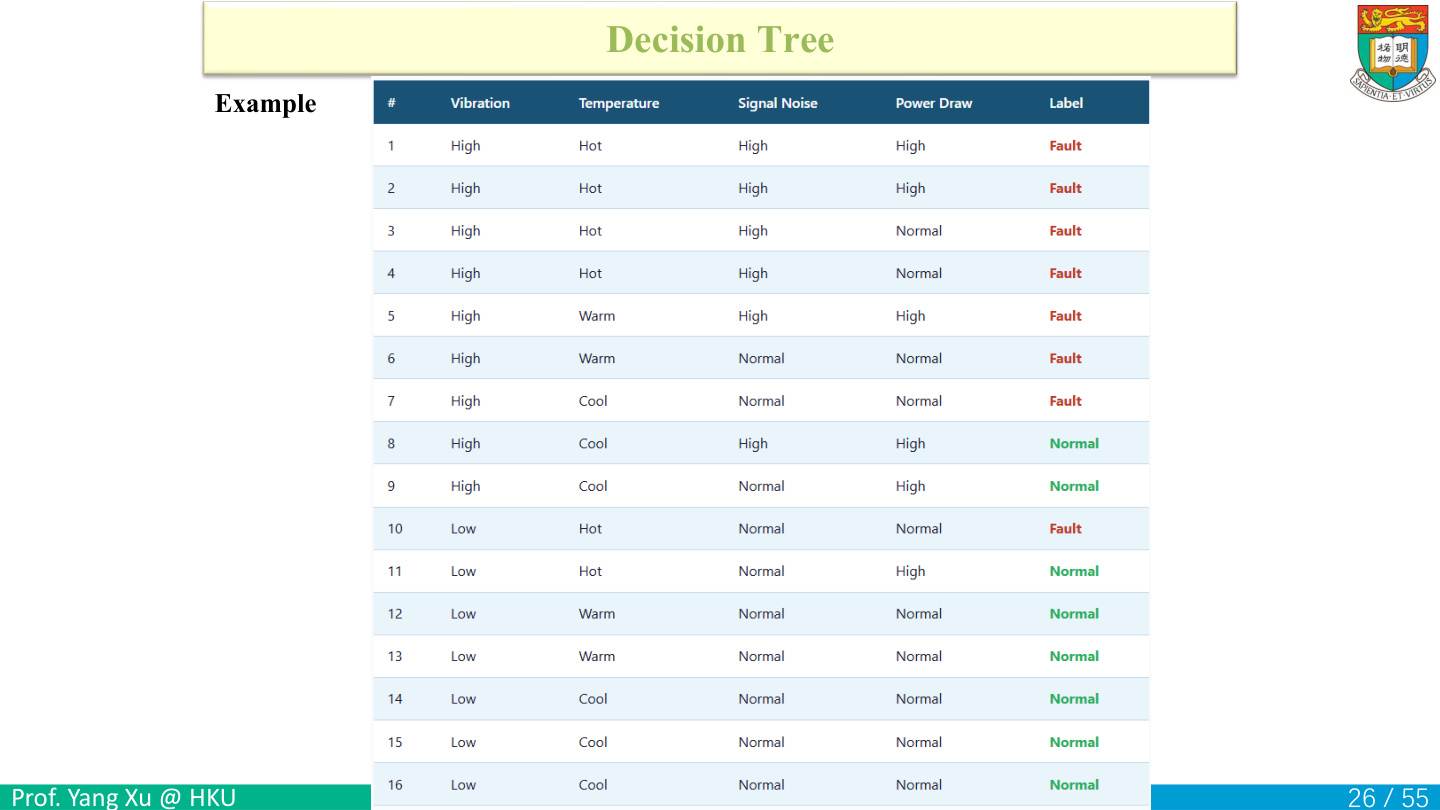
先按行读这张数据表。第1行是High振动、Hot温度、High信噪比、High功率,标签Fault;第10行是Low振动、Hot温度、Normal信噪比、Normal功率,标签Fault。行号只是索引,不属于本例四个有效特征。
把各组人数数出来: 振动High为行1–9,共7F、2N;Low为行10–16,共1F、6N。温度Hot为1、2、3、4、10、11,共5F、1N;Warm为5、6、12、13,共2F、2N;Cool为7、8、9、14、15、16,共1F、5N。信噪比High为1、2、3、4、5、8,共5F、1N;Normal为其他10行,共3F、7N。
功率High为1、2、5、8、9、11,共3F、3N;Normal为其他10行,共5F、5N。两功率分支都正好一半故障一半正常,所以按这份表,功率单独分裂完全不降低标签熵。计算功率的信息增益时,就用这两组计数。
计数的检查法:每个特征各分支样本总数应加到16;故障数应加到8,正常数也应加到8。三个总数相符,再代入熵公式。
自测: 温度Cool是4条还是6条?答案:6条,即行7、8、9、14、15、16。
比较分裂效果:要看各分支里的类别组成
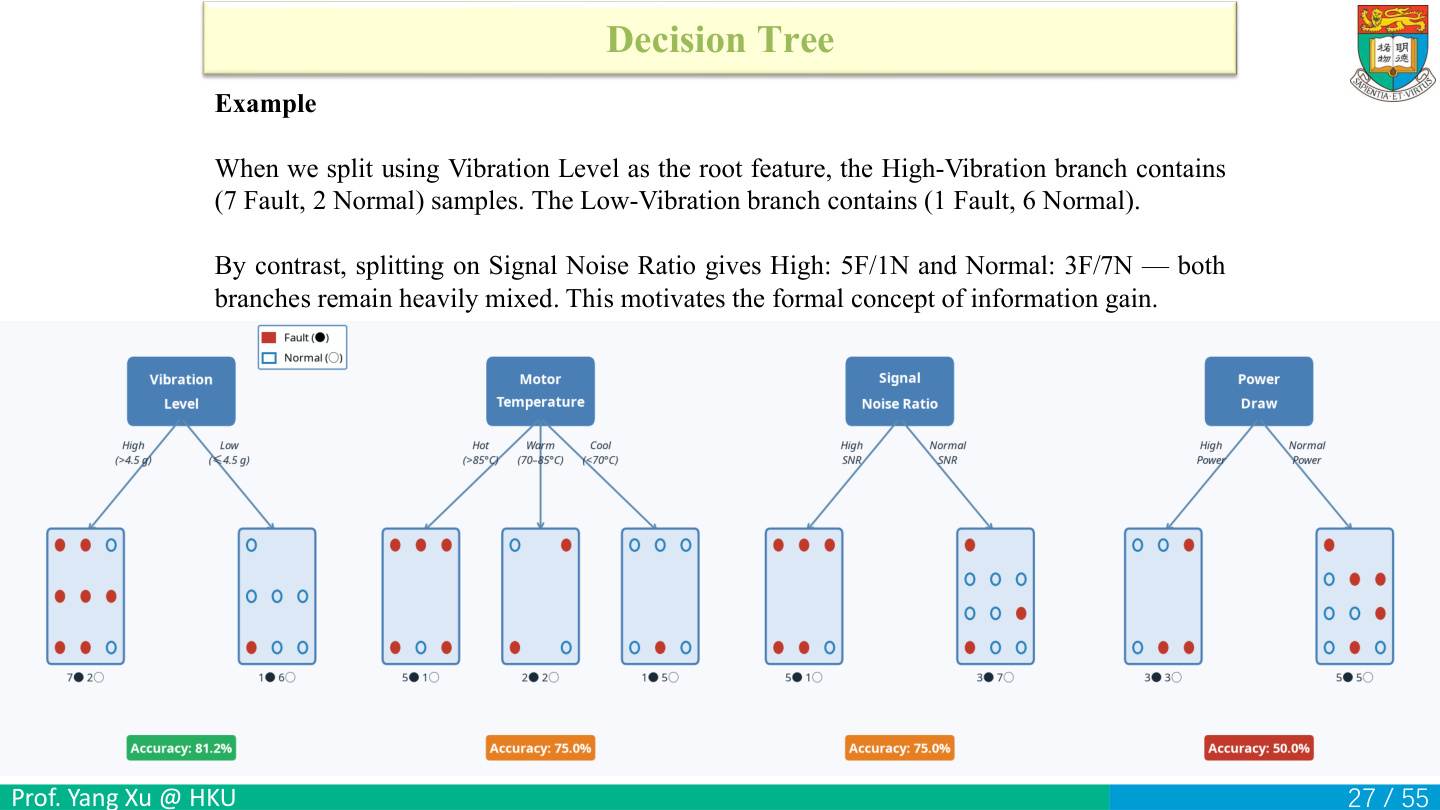
按振动分:High有7F、2N,若直接作多数类叶子,判Fault,错2条;Low有1F、6N,判Normal,错1条。总正确 7+6=13,训练准确率 13/16=81.25%。这是只分裂一层时的训练准确率。
按温度分:Hot预测Fault可对5条,Warm为2F/2N平局最多对2条,Cool预测Normal可对5条,共12/16=75%。按信噪比分:High多数故障对5条,Normal多数正常对7条,也是12/16=75%。功率两组各一半,不论各组平局选哪类,最多对3+5=8条,即50%。
为什么还要学熵? 准确率只看多数类别数量,可能把某些不同的分布视为一样。信息熵使用整个类别概率分布,描述分裂后还剩多少不确定性。比较整次分裂时,再按各分支样本比例加权。
读图红点表示故障,空心蓝点表示正常;比较时必须同时看颜色比例与盒子里的点数。大分支在总体评价中占更大权重,因此要同时考虑纯度和人数。
自测: 振动分裂错3条,是不是“误差率3%”?答案:不是,误差率为3/16=18.75%,分母是样本数16。
两层树逐条验算:87.5%从哪里来
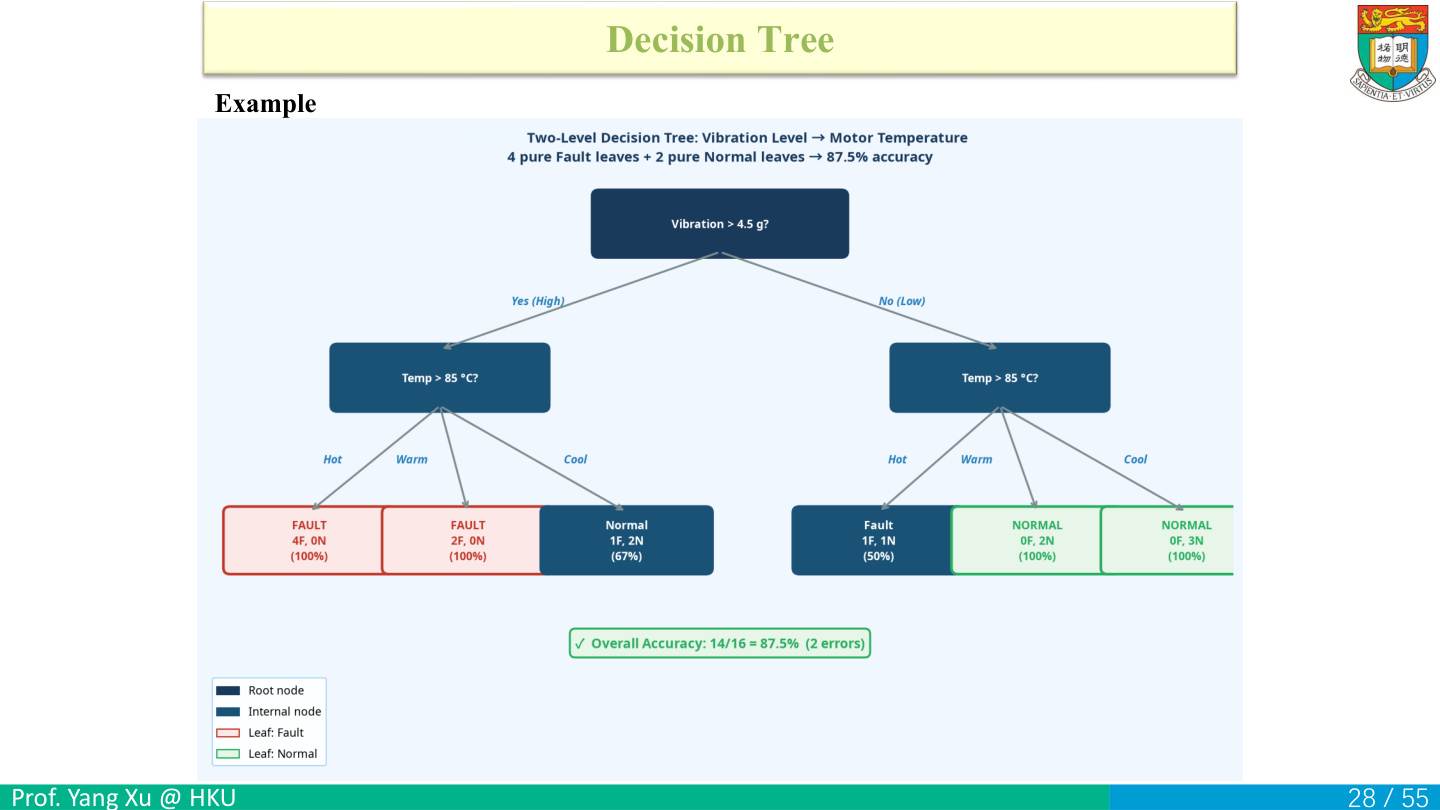
照第25页的原表,先按振动分左右,再在各组内按温度分。每个叶子用多数类预测,平局时这张图选择Fault。
| 振动 | 温度 | 原表行号 | 故障/正常 | 叶子输出 | 答对数 |
|---|---|---|---|---|---|
| High | Hot | 1–4 | 4F/0N | Fault | 4 |
| High | Warm | 5、6 | 2F/0N | Fault | 2 |
| High | Cool | 7–9 | 1F/2N | Normal | 2 |
| Low | Hot | 10、11 | 1F/1N | Fault | 1 |
| Low | Warm | 12、13 | 0F/2N | Normal | 2 |
| Low | Cool | 14–16 | 0F/3N | Normal | 3 |
答对 4+2+2+1+2+3=14 条,准确率 14/16=87.5%。第7行是High+Cool里的故障,却被判成正常。第11行是Low+Hot里的正常,却因平局规则被判成故障。
六个叶子中有2个纯故障叶、2个纯正常叶,另2叶混合;顶部“4 pure Fault leaves”的文字应改成2个。温度节点按Hot/Warm/Cool三档分支。
自测: 把Low+Hot平局改判Normal,总训练准确率会变吗?答案:不会,这组仍只能对1条,但具体被错分的样本会交换。
熵:用一个数表示标签有多难猜
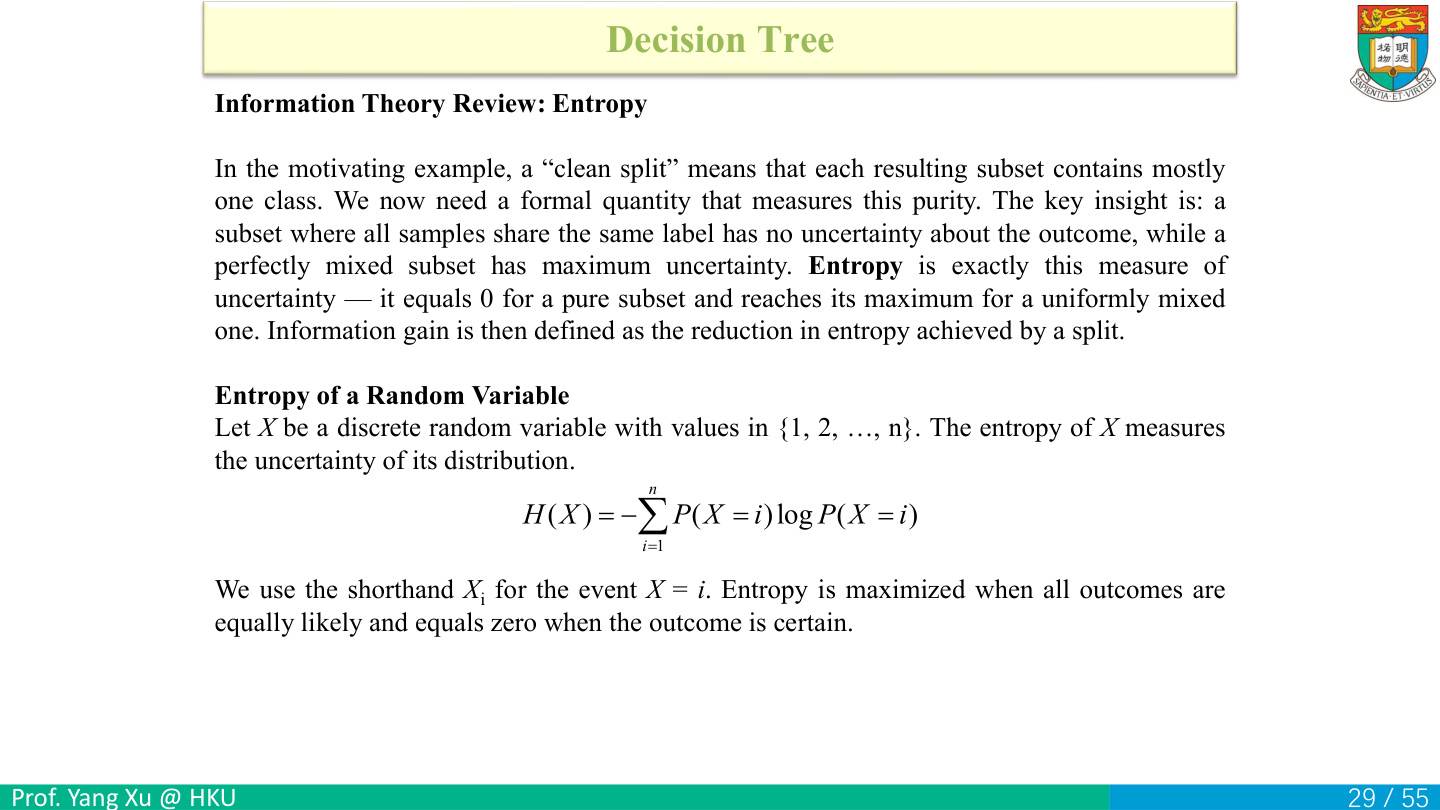
设随机变量X取若干类别,概率为pᵢ,熵 H(X)=−Σᵢpᵢlog₂pᵢ。可先理解 −log₂p 为看到一个事件时的信息量:越罕见,信息量越大;再按它发生的概率p加权平均。使用log₂时单位叫bit。若换自然对数,数值单位变成nat,比较时必须统一底数。
算一遍:故障和正常各一半,H=−0.5log₂0.5−0.5log₂0.5=−0.5×(−1)−0.5×(−1)=1。若全部故障,概率(1,0),熵0;0log0按极限约定为0,不能在计算器中直接求log0。若故障概率0.9,正常0.1,熵约0.469,说明比五五开更容易猜。
对于固定K类,熵在均匀分布时最大,为log₂K;因此二分类最大1,三分类最大约1.585。
在决策树中,我们希望一个节点分裂后的子集标签更集中、熵更低。这里X暂时用来表示类别随机变量,和有时写作输入向量x的记号不同,要从上下文区分。
自测: 一个子集全为正常,熵是不是很大,因为正常样本很多?答案:不是。熵看类别的不确定性,纯子集熵为0,与样本绝对数量无关。
联合熵、条件熵:先知道一个变量后还剩多少不确定
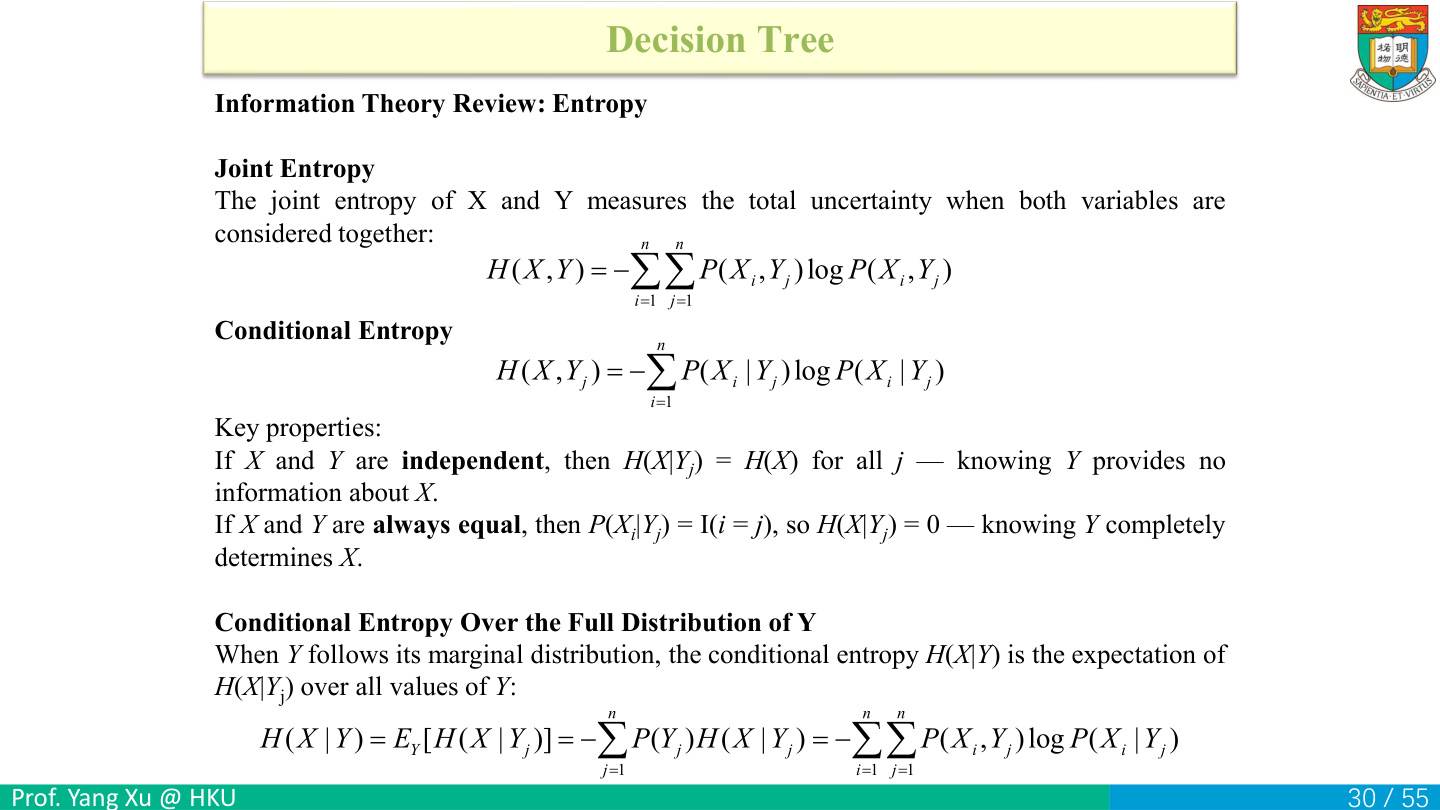
联合熵 H(X,Y)=−ΣᵢΣⱼp(xᵢ,yⱼ)log₂p(xᵢ,yⱼ),描述同时不知道X、Y时的总不确定性。固定观察Y=yⱼ后,条件熵是 H(X|Y=yⱼ)=−Σᵢp(xᵢ|yⱼ)log₂p(xᵢ|yⱼ),只对X求和。
再把各种Y值按其出现概率平均:H(X|Y)=Σⱼp(yⱼ)H(X|Y=yⱼ)=−ΣᵢΣⱼp(xᵢ,yⱼ)log₂p(xᵢ|yⱼ)。第一种“平均子熵”的写法前面没有负号,因为子熵本身已经包含负号。固定Y的条件熵记作H(X|Y=yⱼ),竖线表示已经知道Y的取值。
例如,Y表示振动高/低,概率9/16、7/16;两组标签熵分别0.7642、0.5917,则平均是 9/16×0.7642+7/16×0.5917,各项非负。这里两组人数不同,权重分别为9/16与7/16。
若X与Y独立,知道Y不改变X分布,所以H(X|Y)=H(X)。若Y完全确定X,例如X=Y,所有条件分布都纯净,条件熵为0。链式关系也能直接推出。把 p(x,y)=p(y)p(x|y) 代入联合熵,log₂p(x,y)=log₂p(y)+log₂p(x|y)。第二项的加权和就是H(X|Y)。第一项中,对所有x求和时 Σₓp(x,y)=p(y),所以这一项就是H(Y)。两项相加得到 H(X,Y)=H(Y)+H(X|Y)。
自测: 为什么必须按p(Y)加权?答案:常见的分支在总体残余不确定性中出现得更频繁,不能和极少见分支一律各占一半。
信息增益:分裂前的不确定减去分裂后的不确定
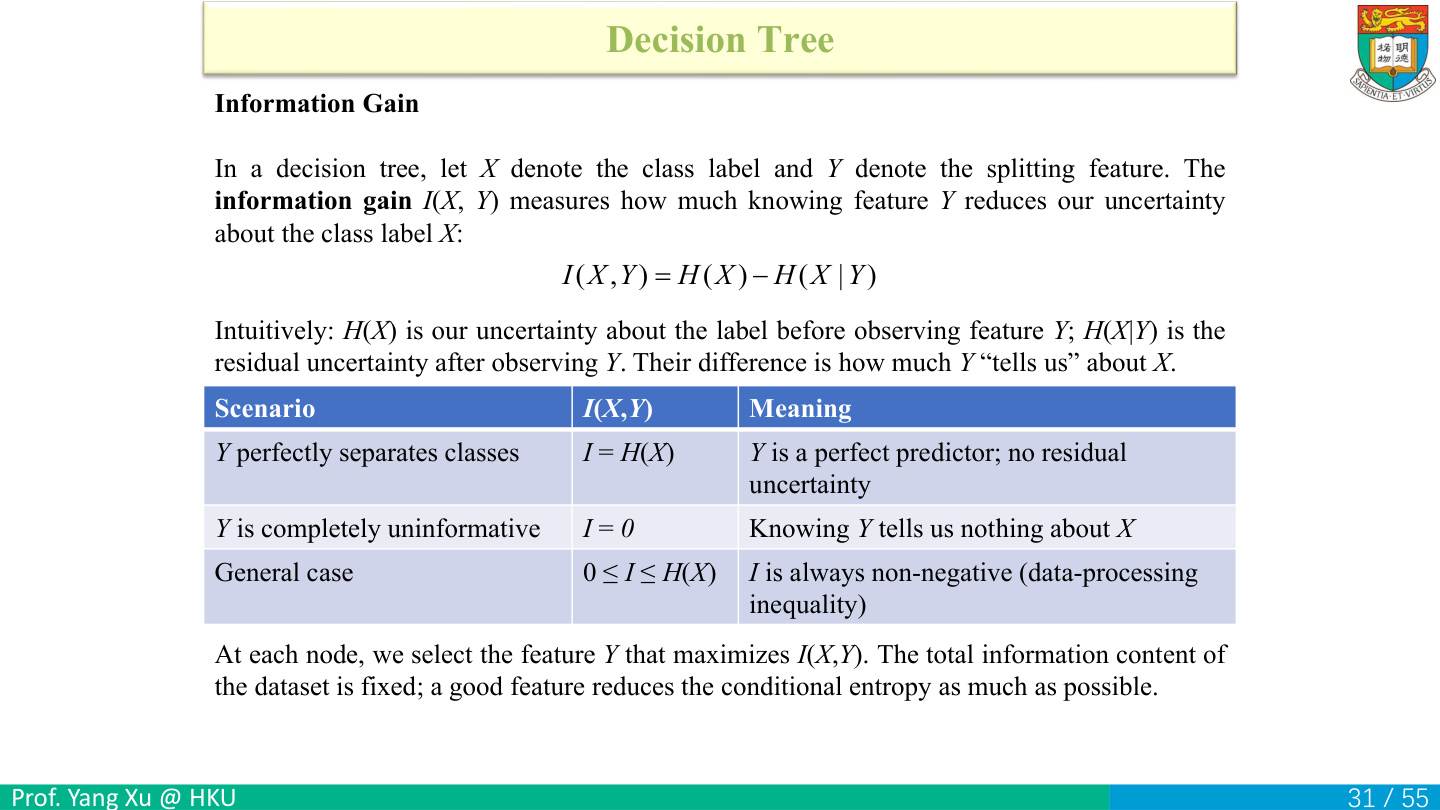
令X为类别、Y为候选分裂特征,信息增益 I(X;Y)=H(X)−H(X|Y)。分裂前不知道Y,标签有H(X)的不确定;知道Y后还剩H(X|Y);相减就是这个特征带来的信息。树在当前节点比较候选特征,常选择信息增益最大者。
例如,原节点两类各半,H(X)=1。若某特征把两类完全分开,每个子集都纯,条件熵0,增益1。若某特征的每个分支仍都五五开,条件熵1,增益0。若残余0.7,增益0.3bit。增益越大,表示这次分裂平均消除了更多标签不确定性。
从公式看,把 H(X)=−Σₓp(x)log₂p(x) 按各分支展开成 −ΣₓΣᵧp(x,y)log₂p(x),再减去 H(X|Y)=−ΣₓΣᵧp(x,y)log₂p(x|y)。同权重两项合并,得到 I(X;Y)=ΣₓΣᵧp(x,y)log₂[p(x|y)/p(x)]。因此增益量化的是知道分支y之后,对标签概率的判断改变了多少。
信息增益是概率分布层面的量;这里用有限训练样本频数估计。样本少时偶然纯净的分裂可能显得很好,因此还需复杂度约束与验证。
自测: H(X)=0时还能获得正的信息增益吗?答案:不能,标签已确定,没有剩余标签不确定性可被特征消除。
振动两组的熵:逐项带入分数
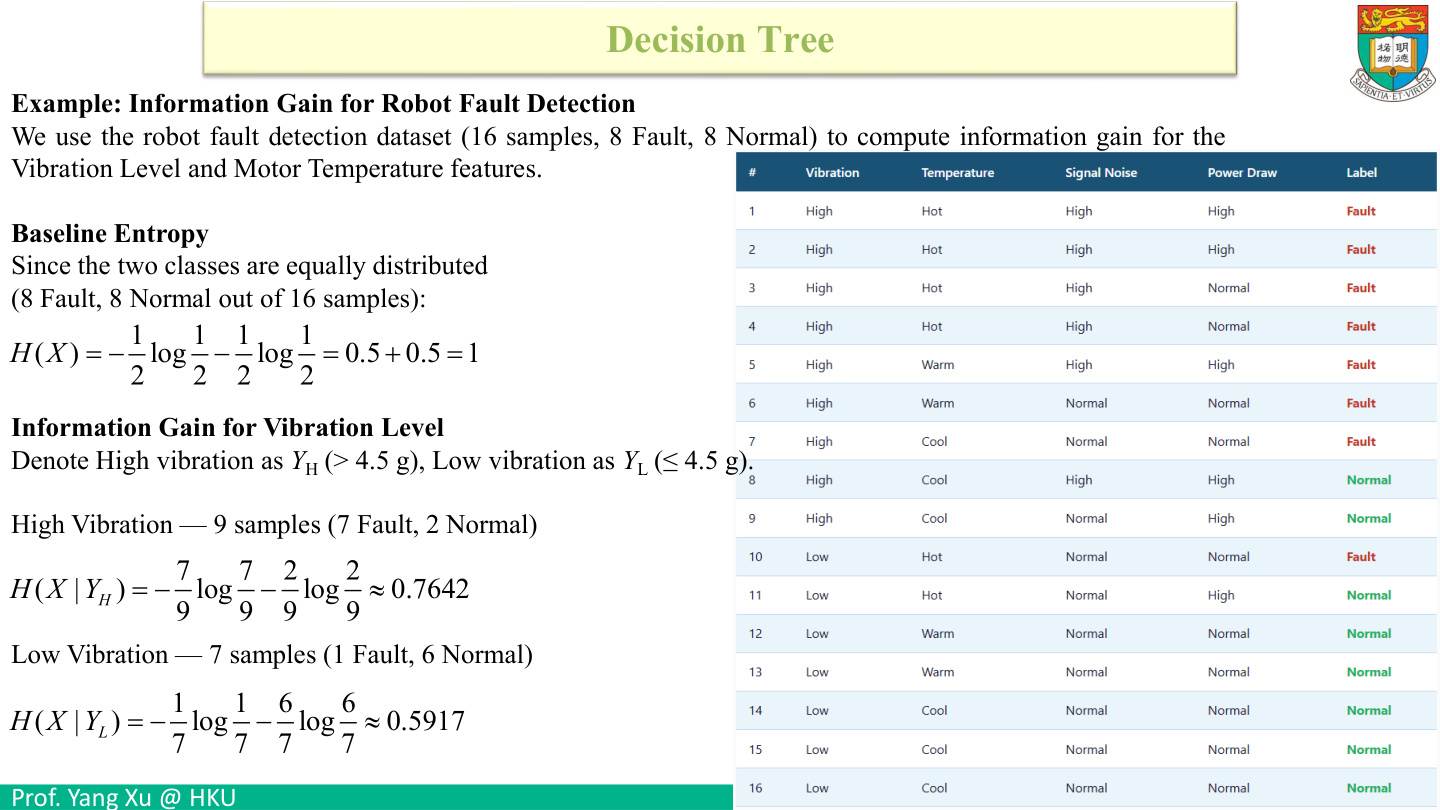
16个样本中故障和正常各8个,所以基准标签熵 −(8/16)log₂(8/16)−(8/16)log₂(8/16)=1。这页先算两组各自的熵,还没有把它们合成整体条件熵。
High振动组共9条:7F、2N,因此pF=7/9、pN=2/9。HHigh=−(7/9)log₂(7/9)−(2/9)log₂(2/9)。其中log₂(7/9)≈−0.3626,第一项约0.2820;log₂(2/9)≈−2.1699,第二项约0.4822;加起来约0.7642bit。
Low振动组共7条:1F、6N。HLow=−(1/7)log₂(1/7)−(6/7)log₂(6/7)。第一项约0.4011,第二项约0.1906,总和约0.5917。低振动组更偏向正常,因而标签更容易猜,熵更低。
留意这两种分母: 计算某组内部的类别比例,要除该组人数9或7,不是除总数16。总数16将在下一页作为“走进哪组的概率”使用。先算组内概率,再按组大小加权,就能把条件熵算完整。
自测: High组的熵为何不是7/9?答案:7/9是故障比例;熵要将两类概率分别乘它们的负对数后相加,是另一种量。
把两组熵加权,得到振动的信息增益
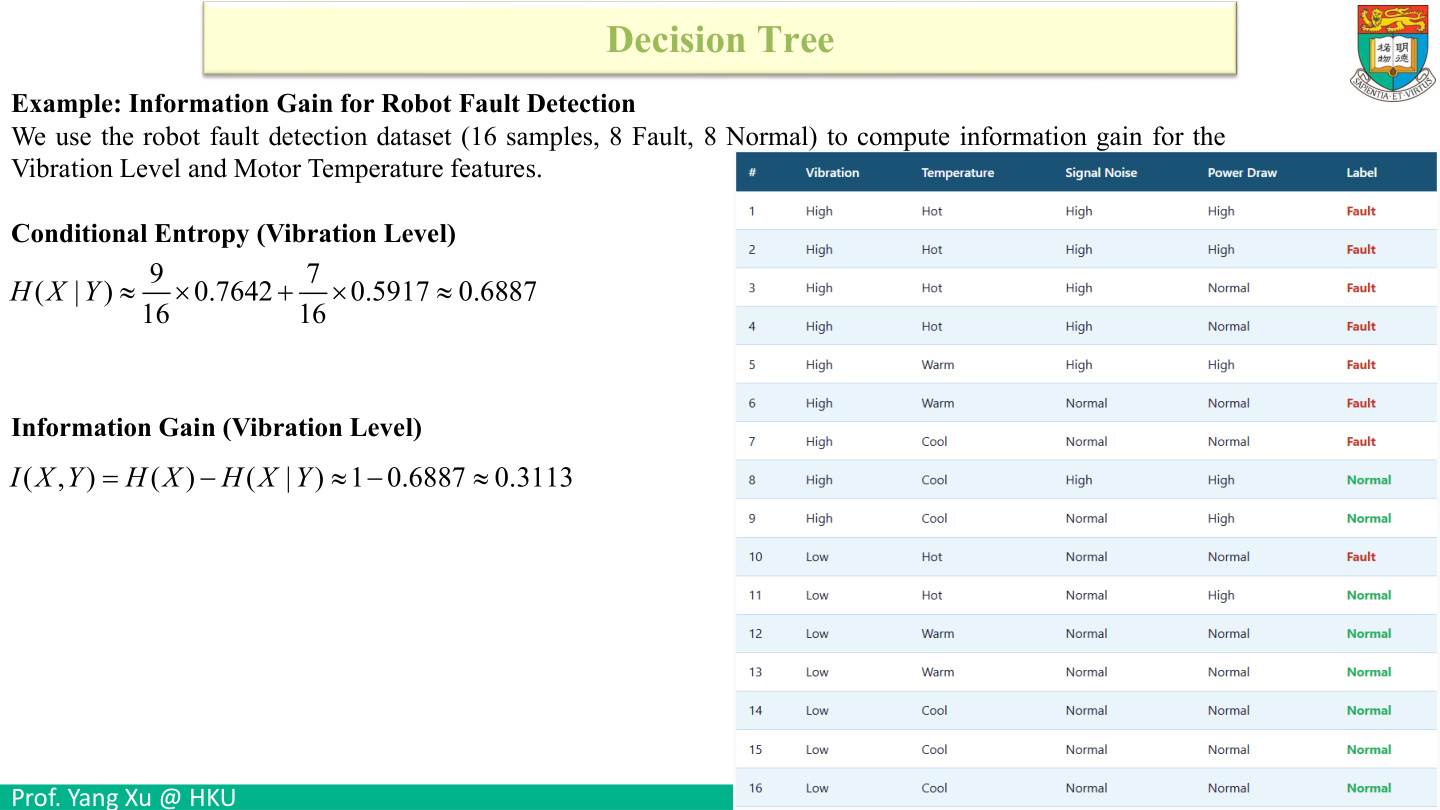
上页得到High组熵0.7642、Low组熵0.5917。现在随机抽取一条原样本,落到High的概率为9/16,落到Low的概率为7/16。因此 H(X|Y)=9/16×0.7642+7/16×0.5917。
逐步算:9/16=0.5625,第一部分约0.42986,7/16=0.4375,第二部分约0.25886。保留中间精度再相加,得到约0.68872bit。基准熵1,所以增益 I=1−0.6887=0.3113bit。这意味着知道振动档位后,标签的不确定性平均减少0.3113bit,单位是bit。准确率则按预测对的样本比例计算。
对比一下:若错误地把两个子熵直接平均,得到(0.7642+0.5917)/2≈0.6780,增益就会被算成0.3220。错误来自忘记High有9条、Low只有7条。差异在本例不大,但极不平衡的分支会造成很大偏差。
自测: 如果把每条记录复制一次,比例不变,熵与信息增益会变吗?答案:不会,基于相同概率分布计算的这些值保持不变。
温度三分支的加权熵
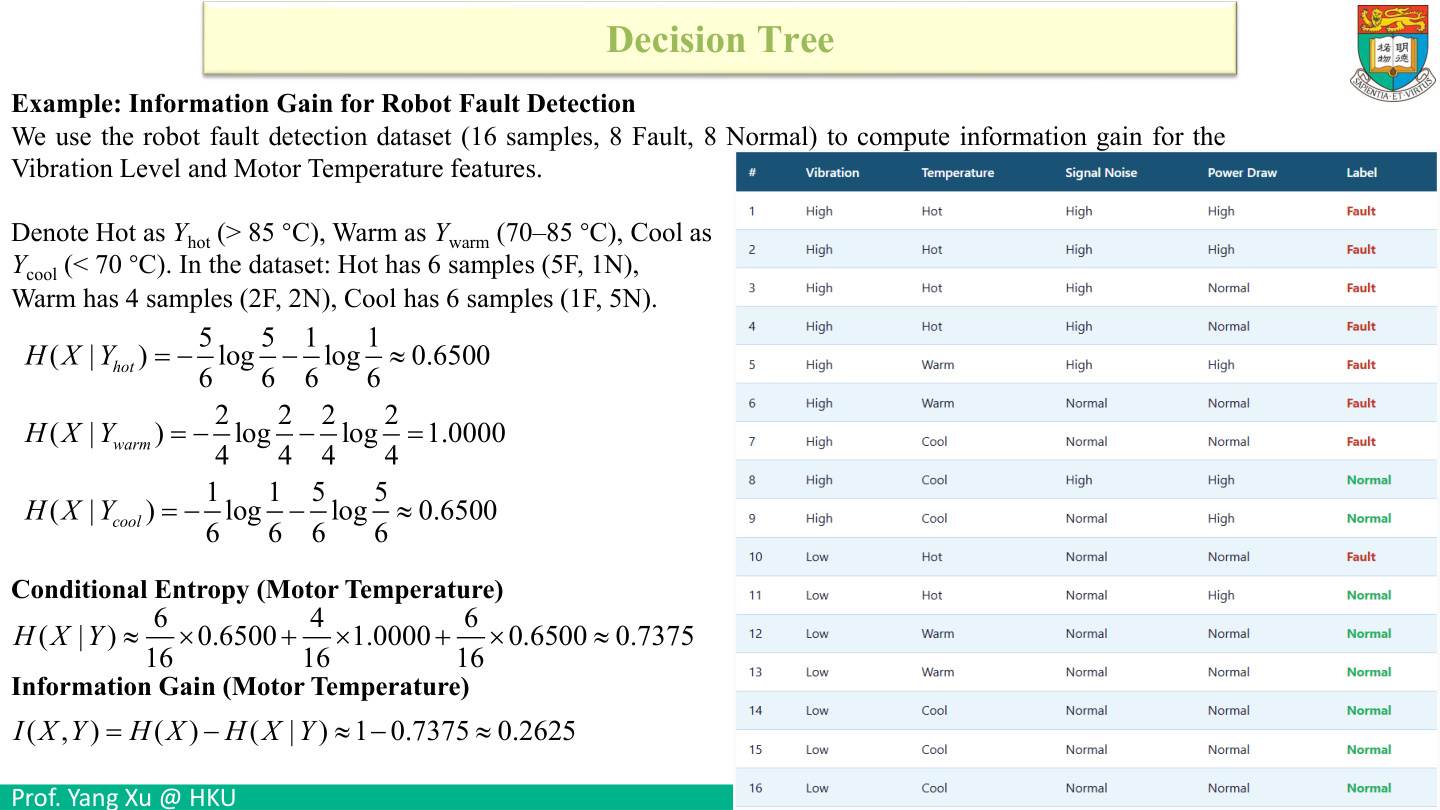
温度Hot有6条,5F/1N;Warm有4条,2F/2N;Cool有6条,1F/5N。Hot的熵是 −5/6 log₂(5/6)−1/6 log₂(1/6)≈0.6500。Cool只是交换两类概率,熵同样约0.6500。Warm各一半,熵1。
总体条件熵 H(X|温度)=6/16×0.6500+4/16×1+6/16×0.6500。两端各约0.24375,中间0.25,加得0.7375。信息增益 1−0.7375=0.2625bit。因为0.2625<振动的0.3113,按信息增益选根节点时,振动比温度更好。
Warm标签最混杂,4条样本贡献0.25的残余熵。三组权重分别为6/16、4/16、6/16,取决于人数。
这里温度作为已经离散化的三档特征来分。若改用连续温度并只允许二叉分裂,要比较不同阈值,每个阈值分别产生两组,需要按新分组重新计算。
自测: Hot和Cool熵相同是否说明它们预测同一类?答案:不是。Hot多数故障,Cool多数正常;熵只描述混杂程度,不记录哪个类别占多数。
四个特征的信息增益比较
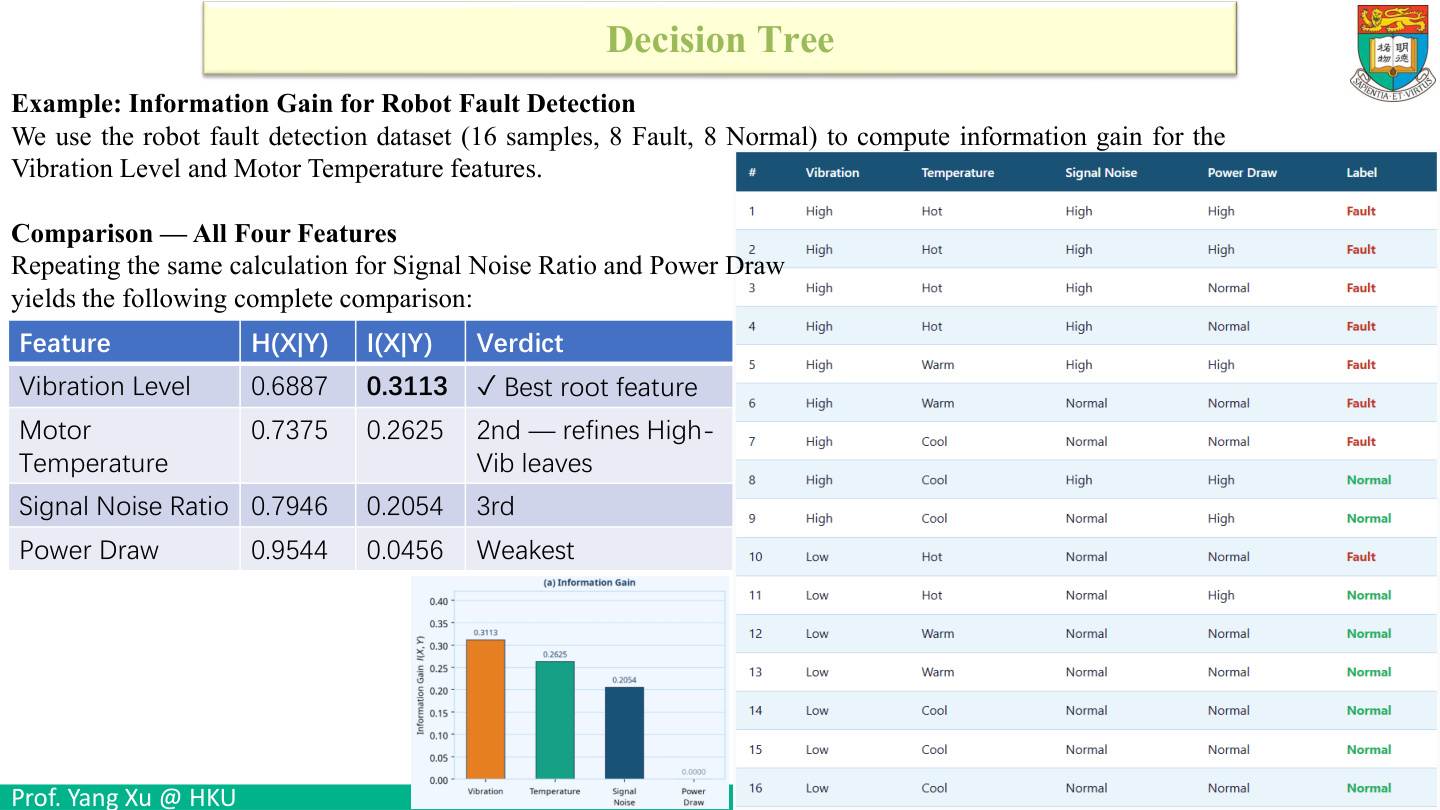
本页比较条件熵与信息增益。振动得到条件熵约0.6887、增益0.3113;温度约0.7375、增益0.2625;信噪比High为5F/1N、Normal为3F/7N,条件熵约 6/16×0.6500+10/16×0.8813=0.7946,增益0.2054。因此前三者的信息增益顺序是振动、温度、信噪比。
功率这一列用第25页的计数:High功率为3F/3N,Normal功率为5F/5N,两组标签熵都等于1。按6/16与10/16加权后仍为1,增益0。所以功率的标签条件熵应为1、增益应为0。0.9544是由分支人数6与10算出的分支熵,描述的是分支大小,而不是分支内标签混杂程度。
| 特征 | 分裂后条件熵(bit) | 信息增益(bit) |
|---|---|---|
| 振动 | 0.6887 | 0.3113 |
| 温度 | 0.7375 | 0.2625 |
| 信噪比 | 0.7946 | 0.2054 |
| 功率 | 1.0000 | 0.0000 |
自测: 一个特征分支人数很不均衡,就一定减少标签熵吗?答案:不一定,关键是分支里的标签比例是否改变。
增益率:用分支复杂程度修正信息增益
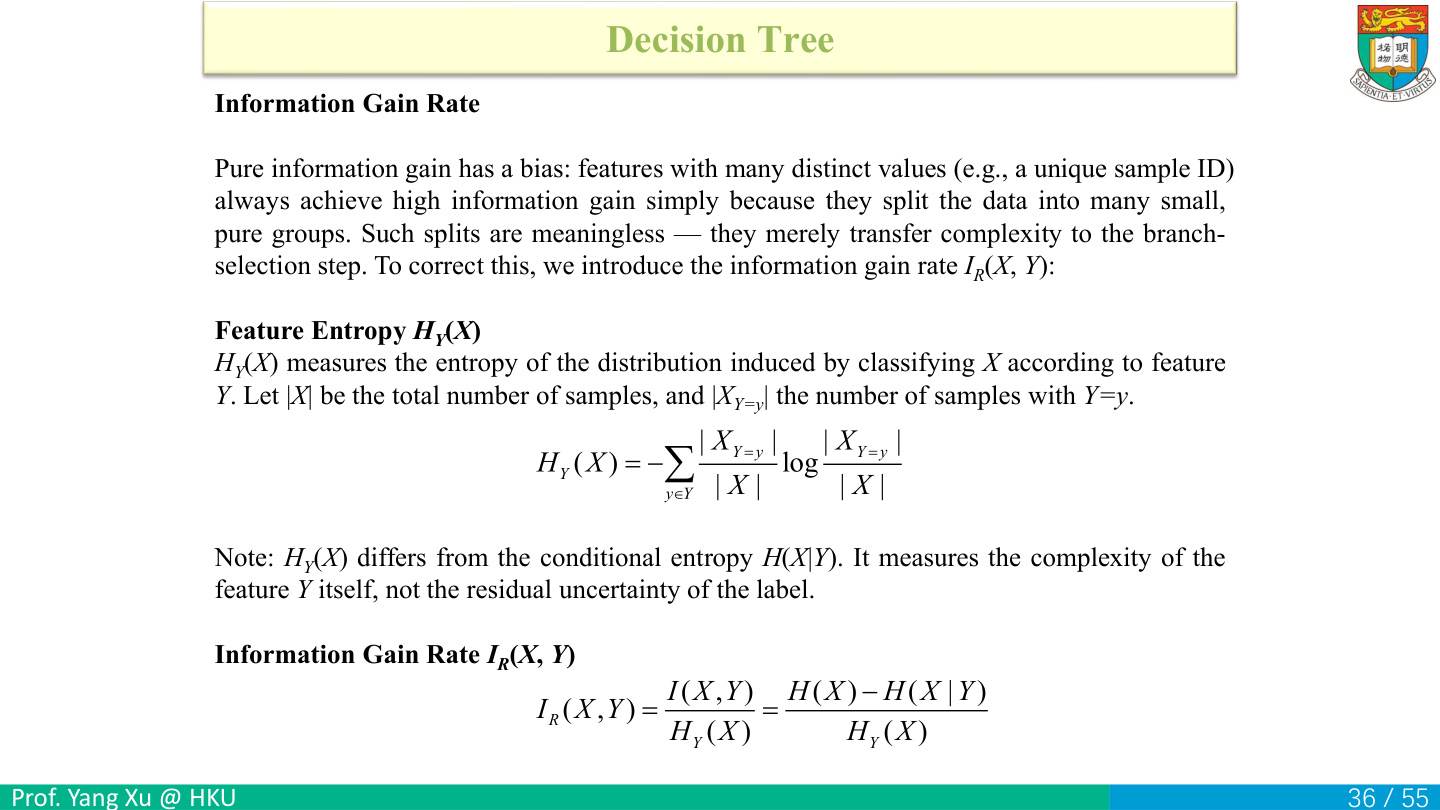
一个每条记录都不同的ID会把训练集分成许多单样本叶子,条件熵0,信息增益看似完美,却不能预测新ID。纯信息增益倾向偏好多取值特征。增益率把标签信息增益除以分支本身的熵,减少这种偏向。
令第v个分支占比qᵥ,分支熵 SplitInfo(Y)=−Σᵥqᵥlog₂qᵥ。Hᵧ(X)也是这个量的记号。它只看分支人数比例;标签条件熵H(X|Y)才看分支里故障与正常的组成。增益率 GainRatio=I(X;Y)/SplitInfo(Y)。
例如,16个互异ID,每个分支概率1/16,分支熵4bit;标签原熵1,ID增益1,增益率1/4。若一个二分特征近乎均分且增益0.31,分支熵约1,增益率约0.31,这时就可能优于ID。
所有样本落入同一分支时,SplitInfo=0,这个候选没有实际分裂,应跳过。分母很小时比值容易偏大,因此实际选候选时还要结合信息增益本身与停止条件。
自测: SplitInfo是否等于H(标签|特征)?答案:不是。前者看各分支多大,后者看走进分支后标签仍多混杂。
振动与温度增益率逐项计算
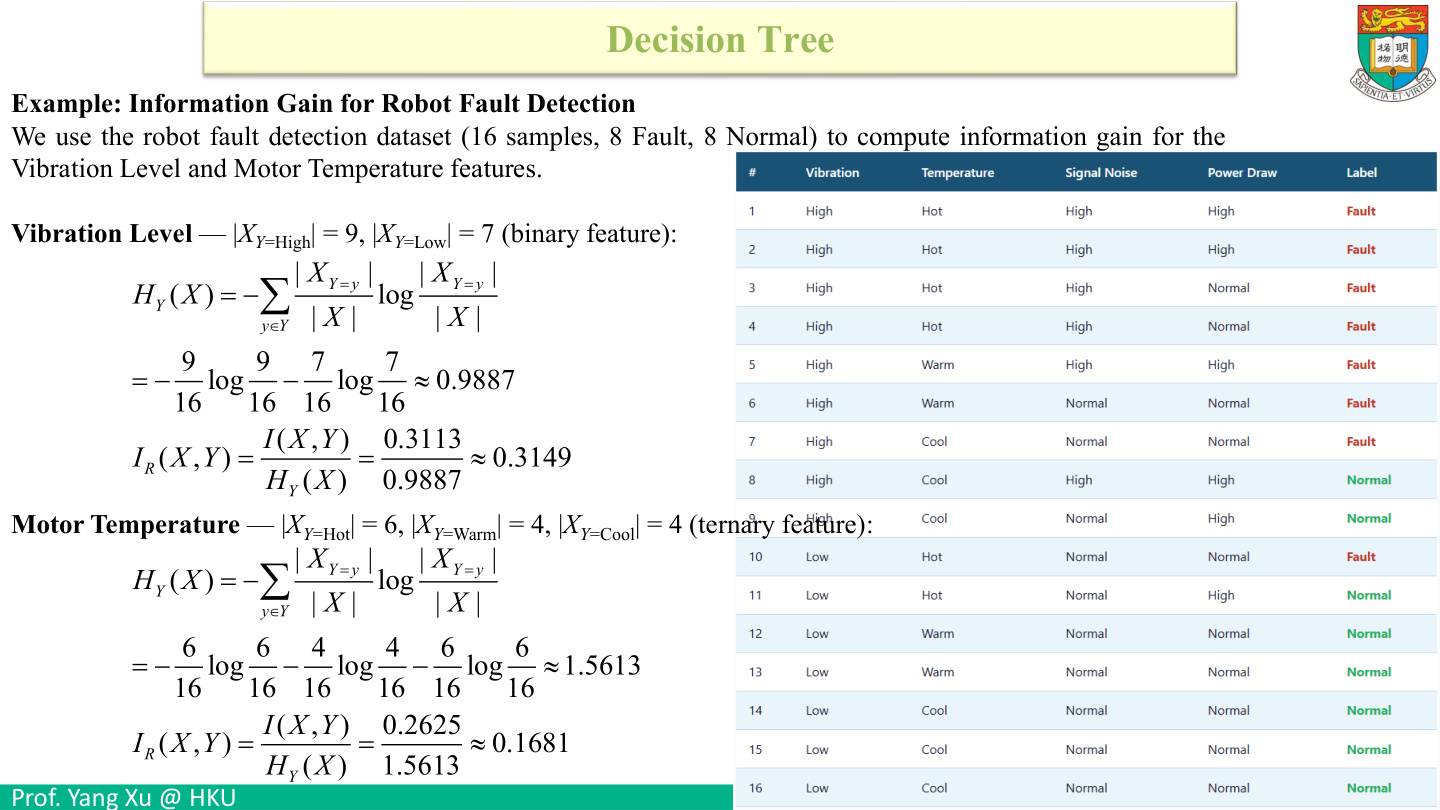
振动的分支人数是9与7,概率9/16、7/16,所以分支熵 −9/16 log₂(9/16)−7/16 log₂(7/16)≈0.9887。标签增益0.3113,除以分支熵得到 0.3113/0.9887≈0.3149。
温度的分支人数为6、4、6,概率6/16、4/16、6/16。分支熵 −6/16 log₂(6/16)−4/16 log₂(4/16)−6/16 log₂(6/16)≈1.5613。于是增益率 0.2625/1.5613≈0.1681。Cool的人数是6,三组加起来6+4+6=16。
三分支分布的熵可以大于1,完全正常,因为log₂3≈1.585是三分支均匀时的上限。这里计算的是三档温度的分支熵;故障/正常这两类标签的熵上限仍为1。
计算顺序是: 先列人数,验证加到16;再除16变概率,验证加到1;再算每项−qlog₂q;最后才拿标签增益去除。若一开始就把9/16与7/16错写成组内7/9、1/7,就把不同问题的分母混在一起了。
自测: 温度增益率下降较多的直接原因是什么?答案:它的增益较小,同时三分支的SplitInfo较大,作为分母进一步压低比值。
增益率会改排序:信噪比超过温度
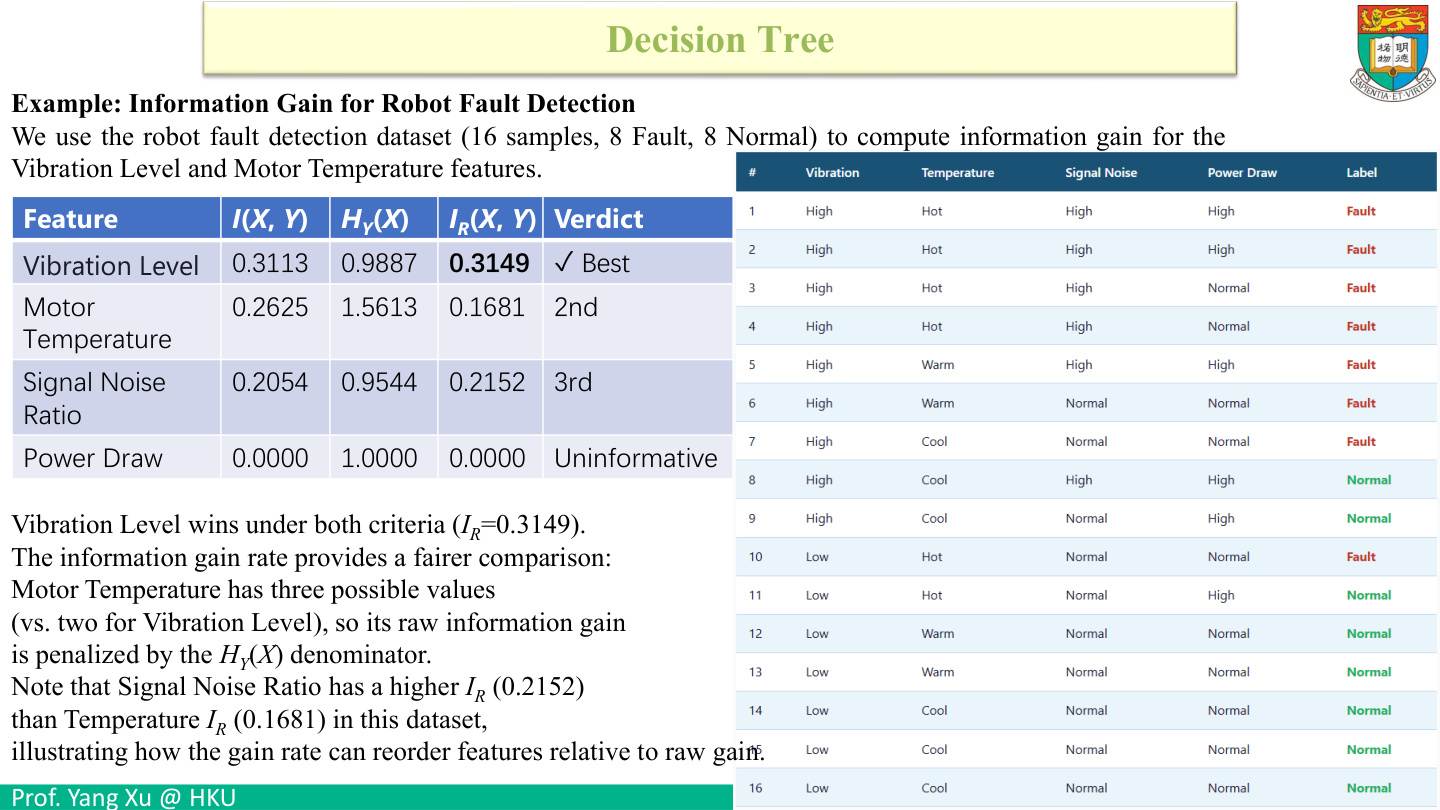
用原表一致计算:振动信息增益0.3113、分支熵0.9887、增益率0.3149;温度0.2625、1.5613、0.1681;信噪比0.2054、0.9544、0.2152;功率0、0.9544、0。
信噪比的两个分支人数6与10,因此SplitInfo约0.9544;它的标签信息增益虽然小于温度,但分母也小得多,最终比值0.2152反而大于温度0.1681。按增益率排序应为振动>信噪比>温度>功率。因此温度排第三,信噪比排第二。
功率的分支人数也为6与10,故分支熵约0.9544;增益为0,增益率 0/0.9544=0。
选择根节点时振动在两种标准下都获胜;但其他特征排序确实能改变。增益率按每个特征各自的分支分布归一化,所以能改变排序。
自测: 原始增益较大的特征,增益率也一定较大吗?答案:不一定,分母不同,温度与信噪比就是本页的反例。
ID3:在每个子集里重新选最有信息的问题
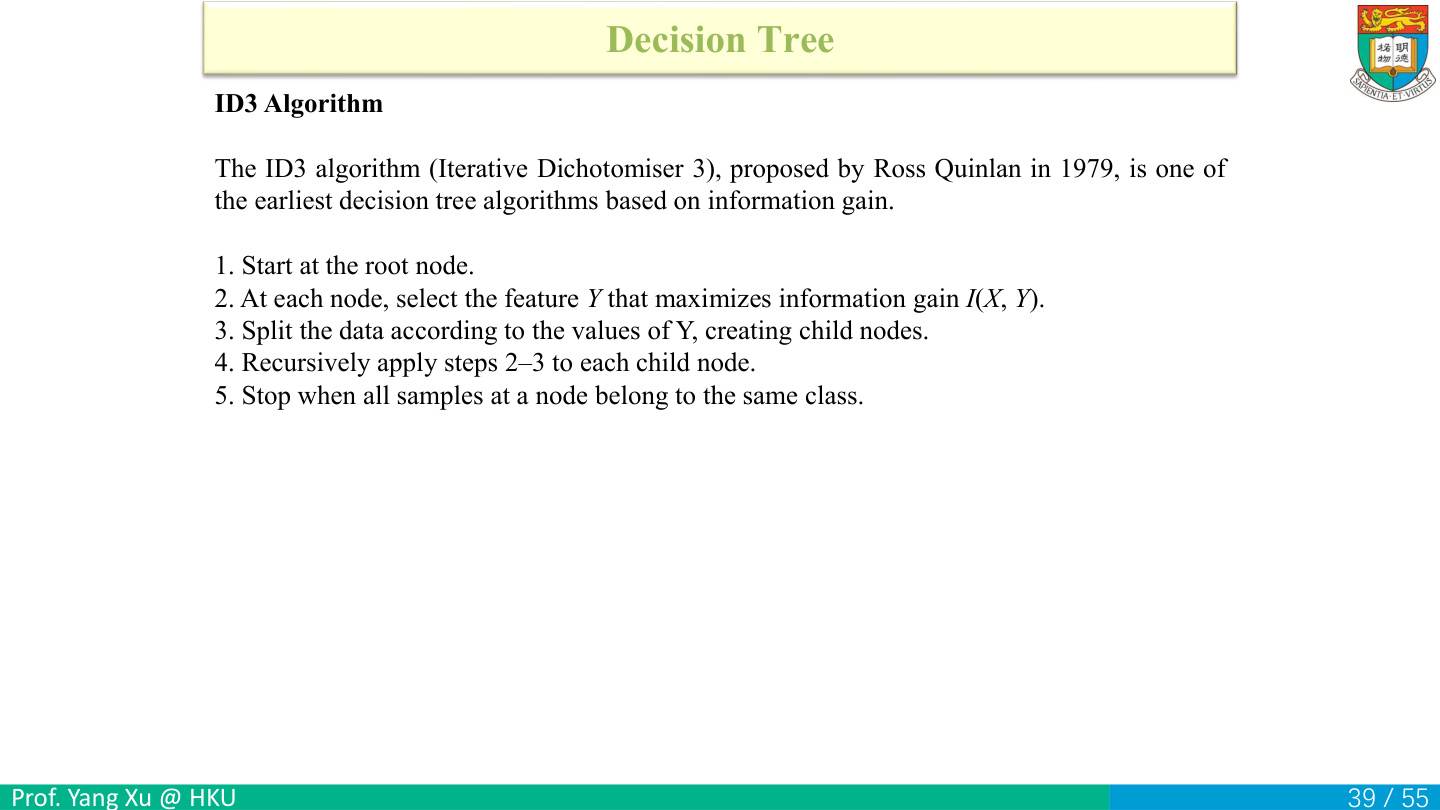
ID3的基本流程是:从根节点当前训练子集出发,计算每个候选特征的信息增益;选最大者,按该特征取值分成子集;对子集重复同样步骤;在达到停止条件时做成叶子。这里“递归”就是在更小的数据子集上,再做一次相同的建树过程。
根节点分出High振动的9条后,这个节点的标签熵是0.7642。试按温度分,这9条会变成Hot的4F/0N、Warm的2F/0N、Cool的1F/2N。前两组熵为0,末组熵约0.9183,故加权熵为 (4/9)×0+(2/9)×0+(3/9)×0.9183≈0.3061,本节点温度增益约 0.7642−0.3061=0.4581。在同一节点比较信噪比和功率时,也只用这9条。另一侧Low用它自己的7条另算。
纯节点的标签已全相同,可以停止并输出该类。其他停止情形包括:若可用特征用完、没有有效分裂、样本太少或标签冲突,也必须有停止与输出规则,常用多数类,平局则需固定规则。
本例使用离散特征:按各个取值建分支,在当前子集上递归选择特征。
自测: 下一层选特征要用全数据还是到达该节点的子集?答案:该节点子集,因为此时已经知道前面路径条件成立。
ID3的两类风险:多取值偏好与过拟合
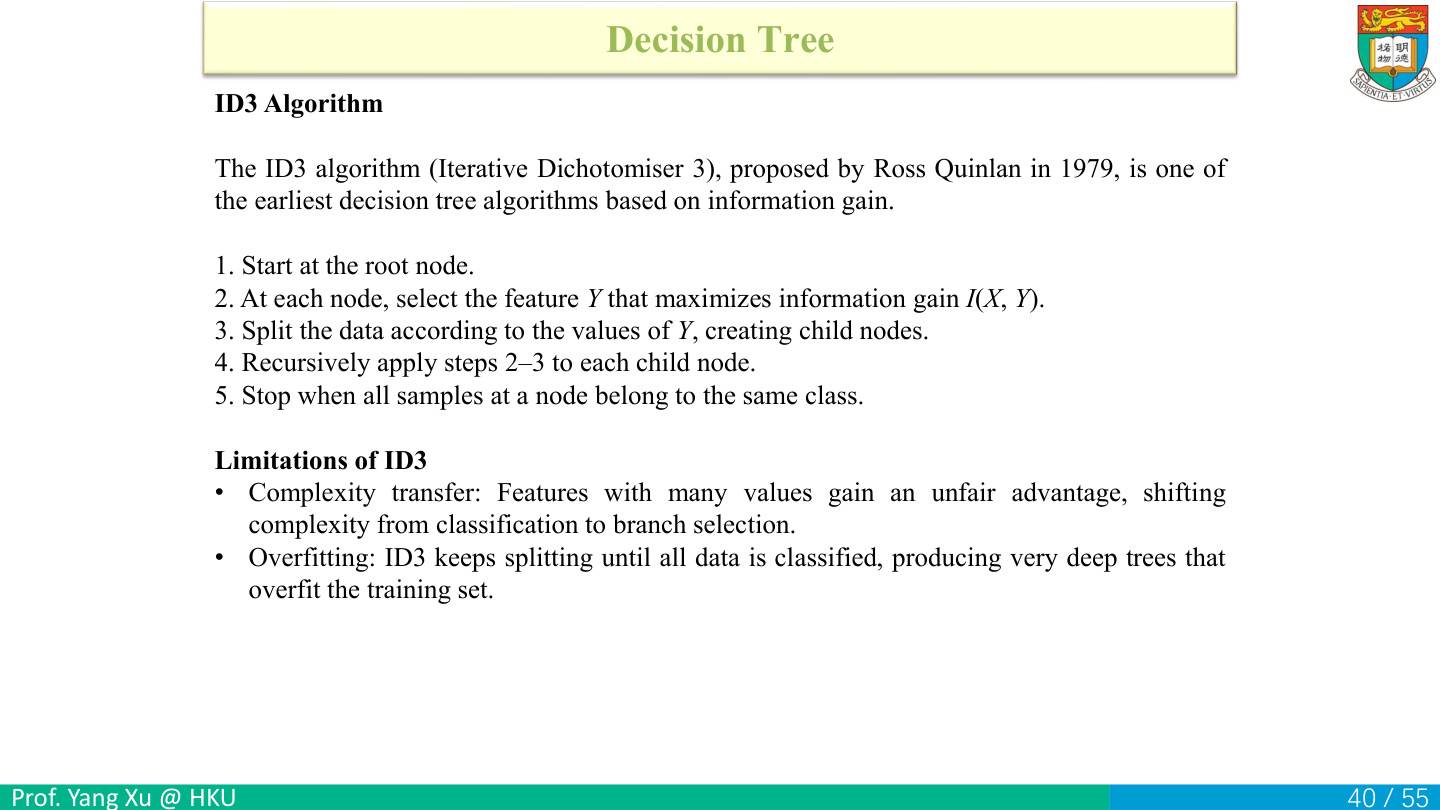
ID3有两类典型问题。第一类是取值多的特征容易把训练样本分成小而纯的组,信息增益被抬高;第二类是不断分裂直到训练组纯净,会产生过复杂的规则,可能把噪声也记下来。
看一个反例: 设16条样本有唯一编号,每个编号只出现一次。按编号分成16叶,训练条件熵0,增益达到1bit。但新机器记录是第17号,树没有学到温度或振动怎样影响故障,只记住旧编号。这个例子同时体现多取值偏好和泛化失败。
“复杂度转移”可以理解为:表面上每个叶子很简单,实际上根节点要区分很多分支,预测工作仍很复杂。与之相比,少量有意义的传感器阈值可能更容易部署、更有泛化价值。
应对思路包括使用增益率、限制深度、要求叶子有足够样本、停止收益很小的分裂、剪枝,以及用验证集选择合适的复杂度。
自测: 增益率和限制深度各解决什么?答案:增益率修正多取值特征偏好;限制深度控制整棵树的复杂度。
树的代价:拟合误差加叶子数处罚
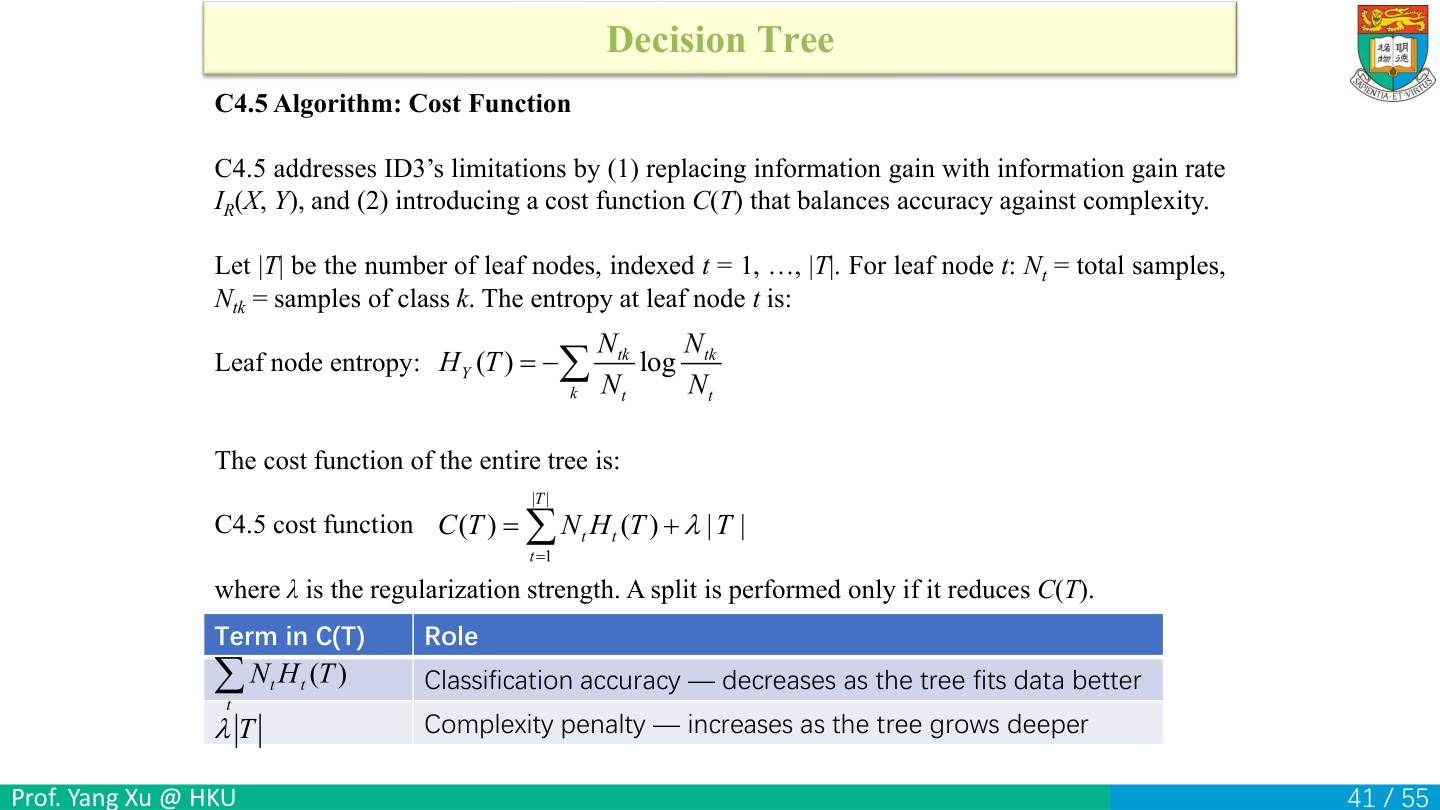
把拟合与复杂度合成一个代价:C(T)=ΣₜNₜH(Tₜ)+λ|T|。T表示整棵树,|T|为叶子数;Nₜ是第t叶包含的样本数;H(Tₜ)=−Σₖ(Nₜₖ/Nₜ)log₂(Nₜₖ/Nₜ),Nₜₖ是该叶第k类样本数。H(Tₜ)表示第t个叶子自己的标签熵。
第一项把每个叶的混杂程度按样本数相加,越纯越小;第二项处罚叶子过多,λ越大越偏好简单树。第一项使用标签熵衡量拟合;0/1错分条数则只统计最终判错了几条,两种量的定义不同。
算一遍:一个4样本叶,2正2负,熵1,未分时总成本 4+λ。若分成两个纯叶,拟合项0,成本2λ。只有 2λ<4+λ 即λ<4,才在这个示例目标下值得分。λ=1时成本从5降为2;λ=5时从9升为10,不分更好。
每次选择当前代价下降最多的分裂,属于贪心策略。增益率与复杂度处罚也承担不同作用:一个比较分裂信息效率,一个控制整棵树规模。
自测: λ增大通常会偏好更多叶子吗?答案:相反,叶子数处罚更重,通常偏好更简单的树。
CART:每次一分为二,分类与回归分别算损失
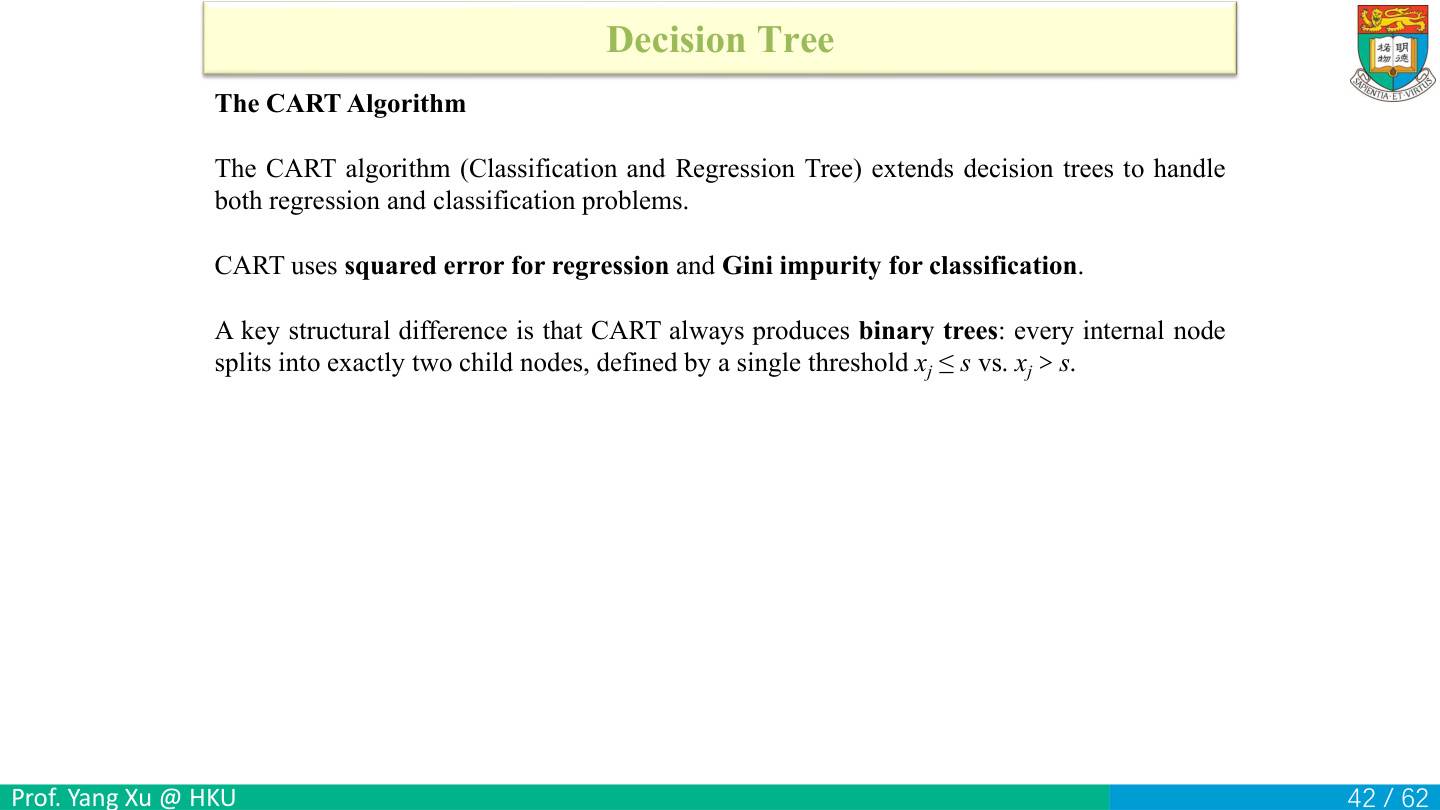
CART全称Classification and Regression Tree,分类与回归树。结构上每个内部节点只有两个子节点;训练时仍要决定用哪个特征j、哪个阈值s。连续特征常问 xⱼ≤s 与 xⱼ>s,两个条件互补,刚好覆盖输入,不重不漏。
回归预测实数,常选择使子区域平方误差小的分裂;分类预测类别,使用Gini不纯度比较分裂。先根据目标是数值还是类别,选相应的训练标准。
例如,用温度预测电流,可以问“温度≤80°C吗”,左叶输出平均电流3A,右叶输出7A。这是回归树。如果两叶输出“正常/故障”,并用类别组成选分裂,就是分类树。
二叉结构指每次有两个分支;叶子仍可从多个目标类别中选择一个。离散特征也能以“属于某类集合/不属于”二分;本讲后面先举单个值对其余的简单形式。
自测: 三分类任务能用二叉CART吗?答案:能,二叉说的是每个分裂的分支数,不是目标类别数。
回归树叶子为什么预测平均值
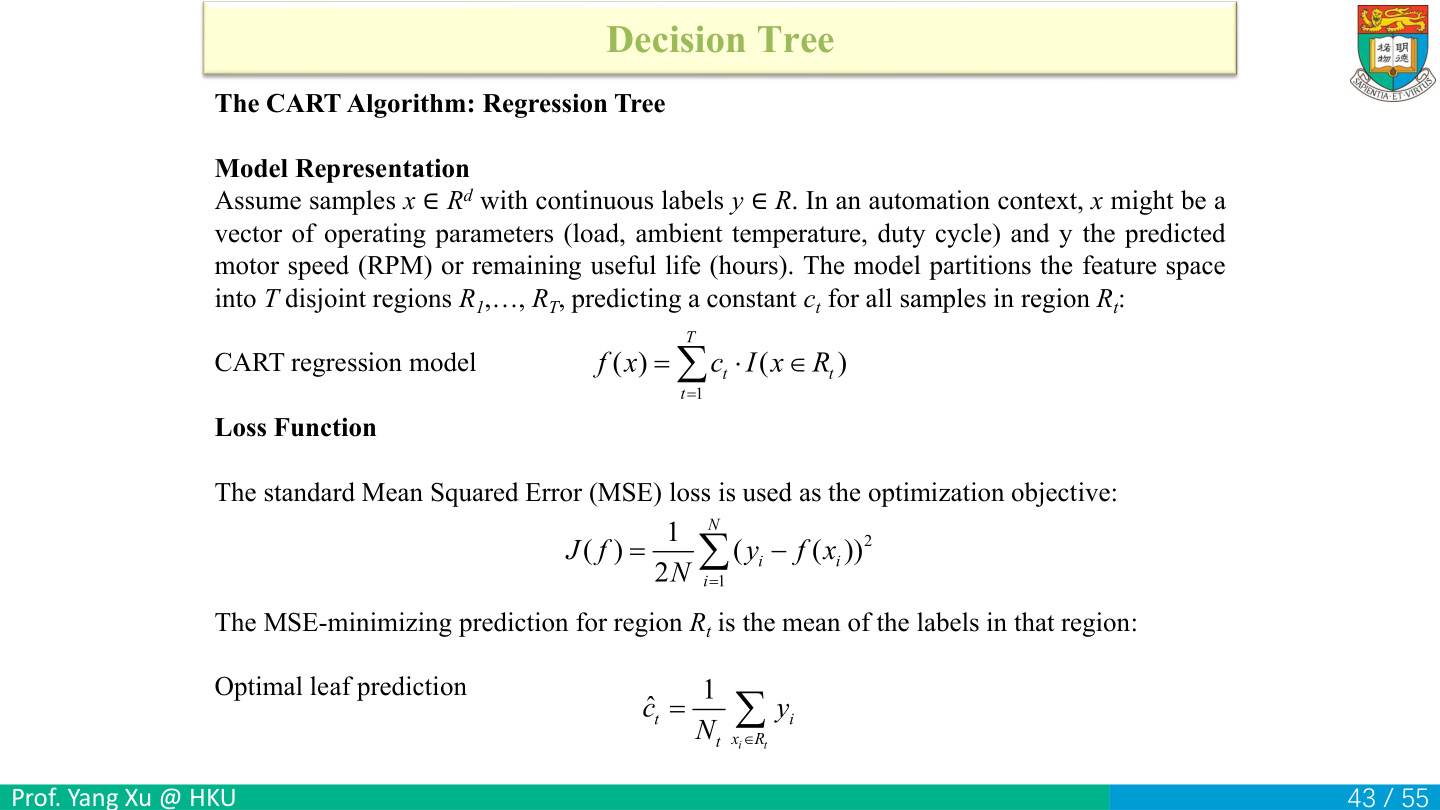
模型 f(x)=ΣₜcₜI(x∈Rₜ) 把输入空间分成互不重叠的区域Rₜ,每个区域输出一个常数cₜ。指示函数只有在x落入该区域时为1,因此一次预测只会选中一个叶子的常数。
对固定叶子,选c使 Σᵢ∈R(yᵢ−c)² 最小。逐步求导:每项对c导数为 2(c−yᵢ),求和后为 2Nᵣc−2Σyᵢ;令0得到 c=Σyᵢ/Nᵣ,即标签平均值。二阶导数2Nᵣ>0,所以确实是最小点。注意平均的是目标y,不是切分依据的输入x。
例如,一个叶子有电流2、3、7A,平均4A。预测4时平方误差和 (2−4)²+(3−4)²+(7−4)²=4+1+9=14;预测3时为1+0+16=17,较大。
常规MSE为 Σ误差²/N。这里用 Σ误差²/(2N),即一半MSE,方便求导;常数缩放不改变最优预测,但损失数值相差一倍。
自测: 一个叶子有1000RPM与2000RPM输入,但目标电流是3A、5A,叶子输出多少?答案:4A,不是1500RPM。
选特征与阈值:每个候选都要重算两边均值
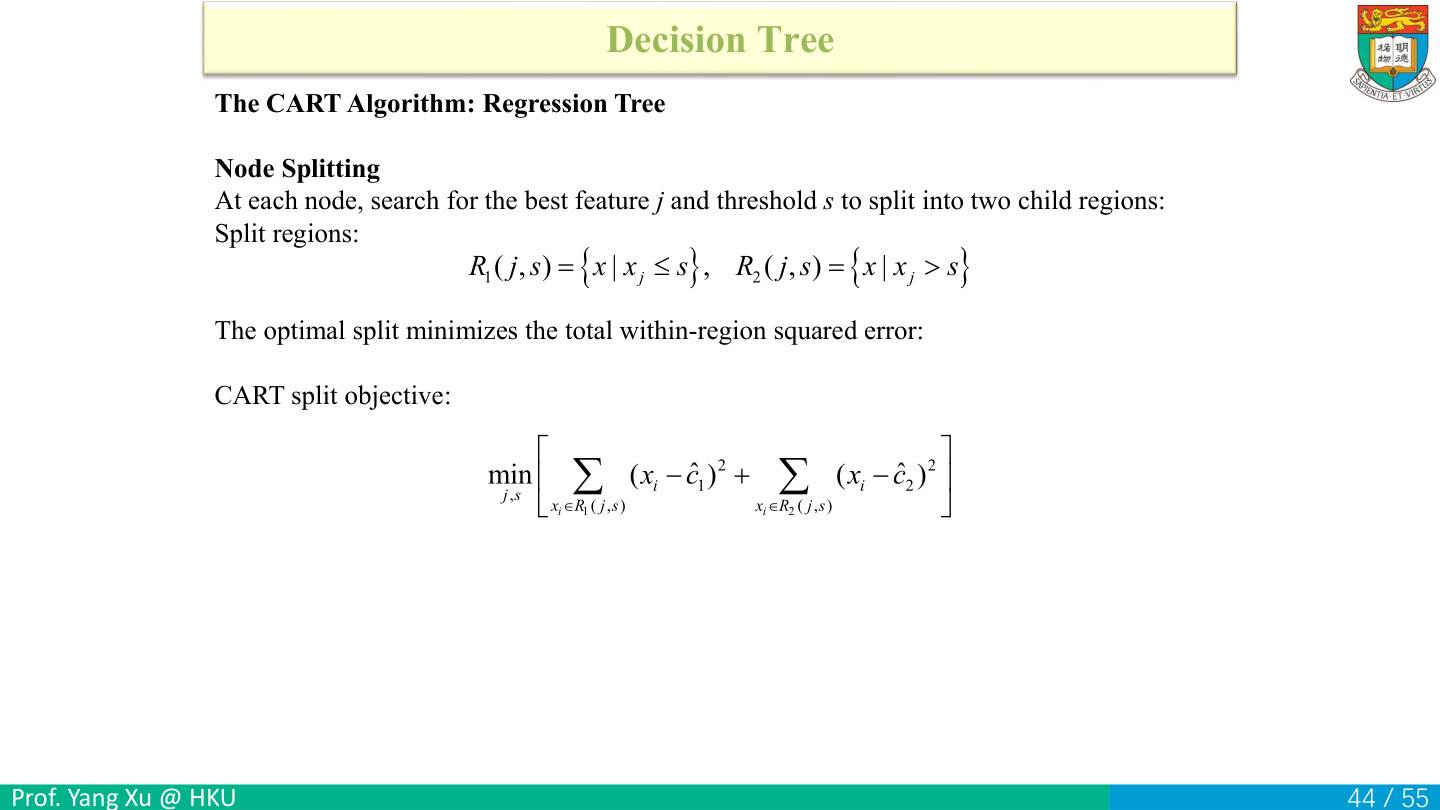
对候选特征j、阈值s,分成 R₁={x:xⱼ≤s}、R₂={x:xⱼ>s}。先按这个分法计算两叶标签均值ĉ₁、ĉ₂,再评价 SSE=Σᵢ∈R₁(yᵢ−ĉ₁)²+Σᵢ∈R₂(yᵢ−ĉ₂)²,选择总平方误差最小的候选。
误差项使用 (yᵢ−ĉ)²,比较真实目标与预测。例如目标和预测都是电流,误差单位是安培;输入速度只用于决定样本走向哪边。
算一遍:输入速度1、2、3、4,对应电流1、2、8、9。阈值2.5时左均值1.5、右均值8.5,SSE=0.25+0.25+0.25+0.25=1。阈值1.5时左只有1,右均值19/3≈6.333,右SSE≈28.667。分组随阈值改变,因此每个候选都重算自己的均值。
训练时需要标签来挑分裂;新样本预测时只检查阈值,再读已保存的叶子均值,不需要重新计算SSE。候选分裂必须让两边都有样本,或满足额外最少叶样本数要求。
自测: 训练目标应把两个子SSE直接相加,还是各自除人数后随意相加?答案:本页用总SSE;若用子MSE,应按人数加权才与同一目标一致。
前缀和推导左叶SSE:先排序输入,再累计标签
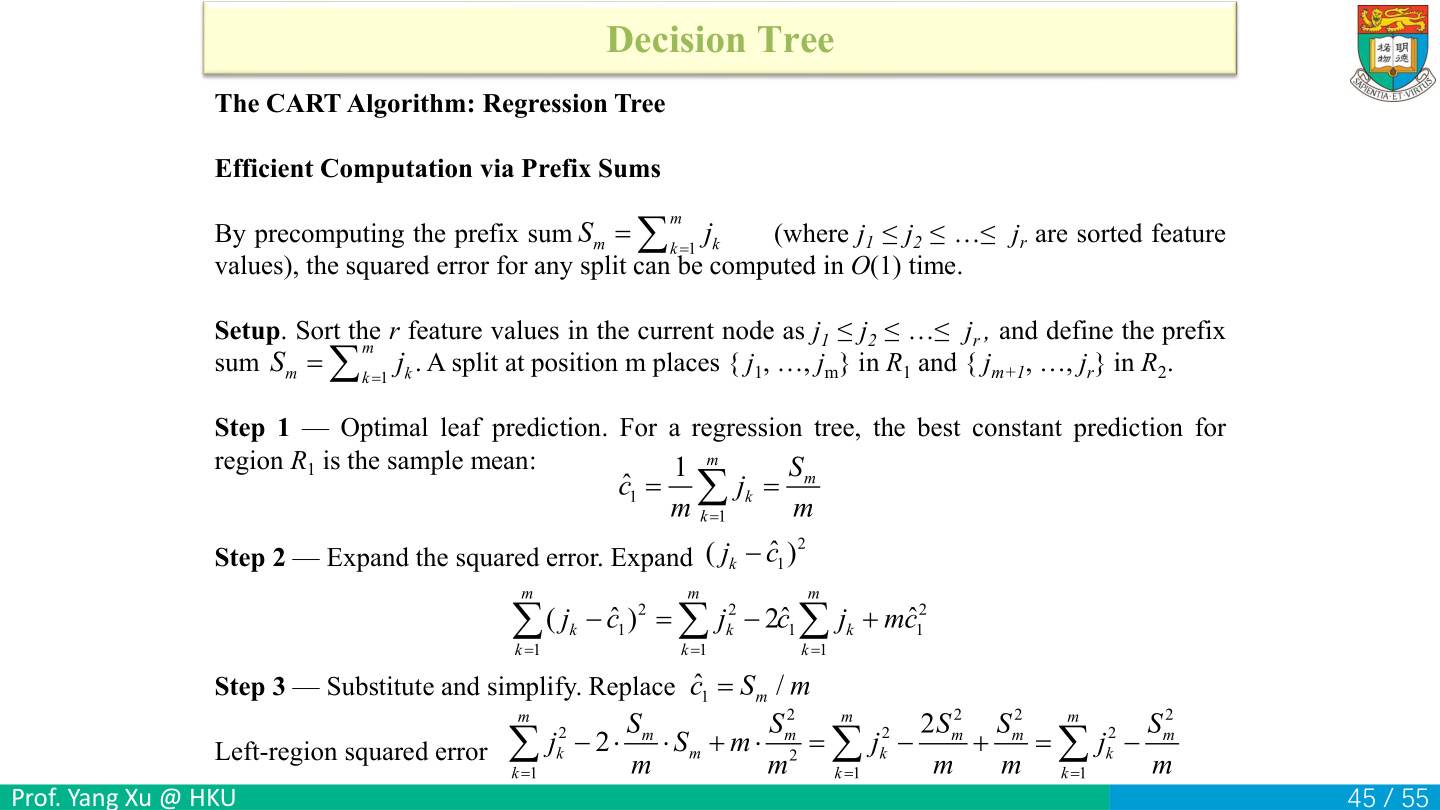
先把两个步骤分清:按某个输入特征x排序后,同时按同一顺序排列对应标签y₁,…,yᵣ。定义标签前缀和 Sₘ=Σₖ₌₁ᵐyₖ,累计的是目标标签。左边有m条,最优预测 ĉ₁=Sₘ/m。
展开左SSE:Σ(yₖ−ĉ₁)²=Σyₖ²−2ĉ₁Σyₖ+mĉ₁²。代入ĉ₁=Sₘ/m后,第二项是 −2(Sₘ/m)Sₘ=−2Sₘ²/m;第三项是 m(Sₘ/m)²=Sₘ²/m;合并得到 Σₖ≤ₘyₖ²−Sₘ²/m。最后一个m来自有m项相同的ĉ₁²,所以该项为mĉ₁²。
例如,左标签2、4、6,m=3、Sₘ=12、平方和56。公式给 56−144/3=8;直接用均值4计算也是 (2−4)²+0+(6−4)²=8。两种算法应一致。
从空前缀 S₀=0 开始,依次用 Sₘ=Sₘ₋₁+yₘ 算。比如刚算完 S₂=2+4=6,再向右移动一个位置,只用算 S₃=6+6=12,之前两项已经在S₂里。若需要单独左右SSE,也可累计标签平方和;只比较总SSE时,下一页的全局平方和是常数。
自测: m=0能用公式吗?答案:不能,分母为0,而且会产生空叶,候选必须排除。
合并两叶SSE:常数减去两个平方项
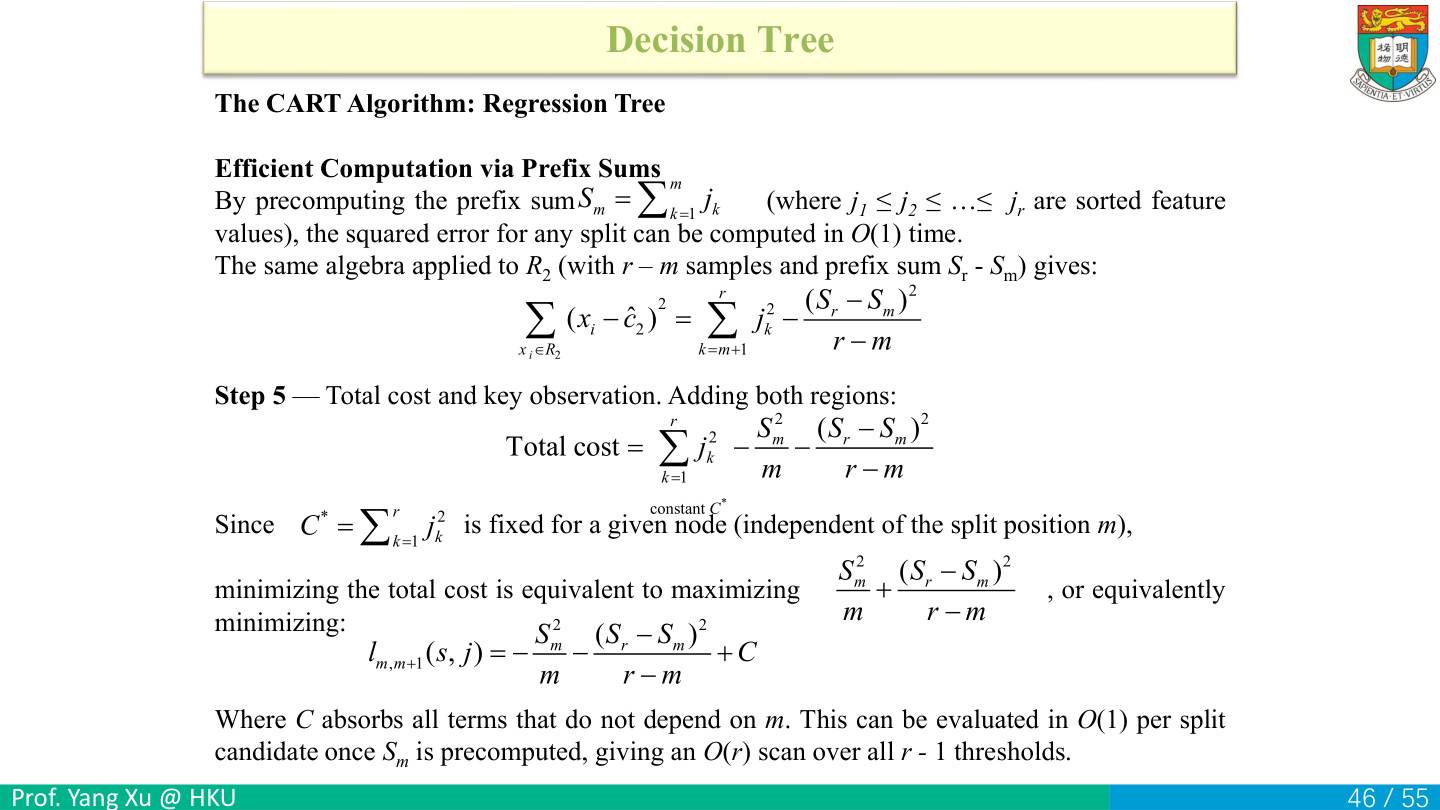
右叶有r−m条,标签总和 Sᵣ−Sₘ,均值 (Sᵣ−Sₘ)/(r−m)。像左边一样展开并代入,右SSE等于 Σₖ>ₘyₖ²−(Sᵣ−Sₘ)²/(r−m)。两边相加,平方和合成全节点常数 C*=Σₖ₌₁ʳyₖ²。
所以总SSE=C*−Sₘ²/m−(Sᵣ−Sₘ)²/(r−m)。比较同一节点的不同切点时C*完全相同,最小化SSE等价于最大化正分数 Score=Sₘ²/m+(Sᵣ−Sₘ)²/(r−m)。因此选Score最大的一刀。
例如,标签(1,2,8,9),总和20、平方和150;m=2时Sₘ=3,Score=9/2+17²/2=149,SSE=150−149=1。m=1时Score=1+19²/3≈121.333,SSE≈28.667。Score更大者SSE更小。
有了前缀和,每个候选只查几次数并做固定数量运算,是O(1);扫描r−1个位置为O(r)。加上输入排序,当前特征的成本为O(rlog r)+O(r);其他特征也要各自比较。相邻输入值相同时跳过该间隙,因为同一个阈值无法把相等值分开。
自测: 为何右侧分母是r−m?答案:它是右叶样本数,不是右边标签总和。
六个样本的第3刀和第4刀:分母跟着人数变
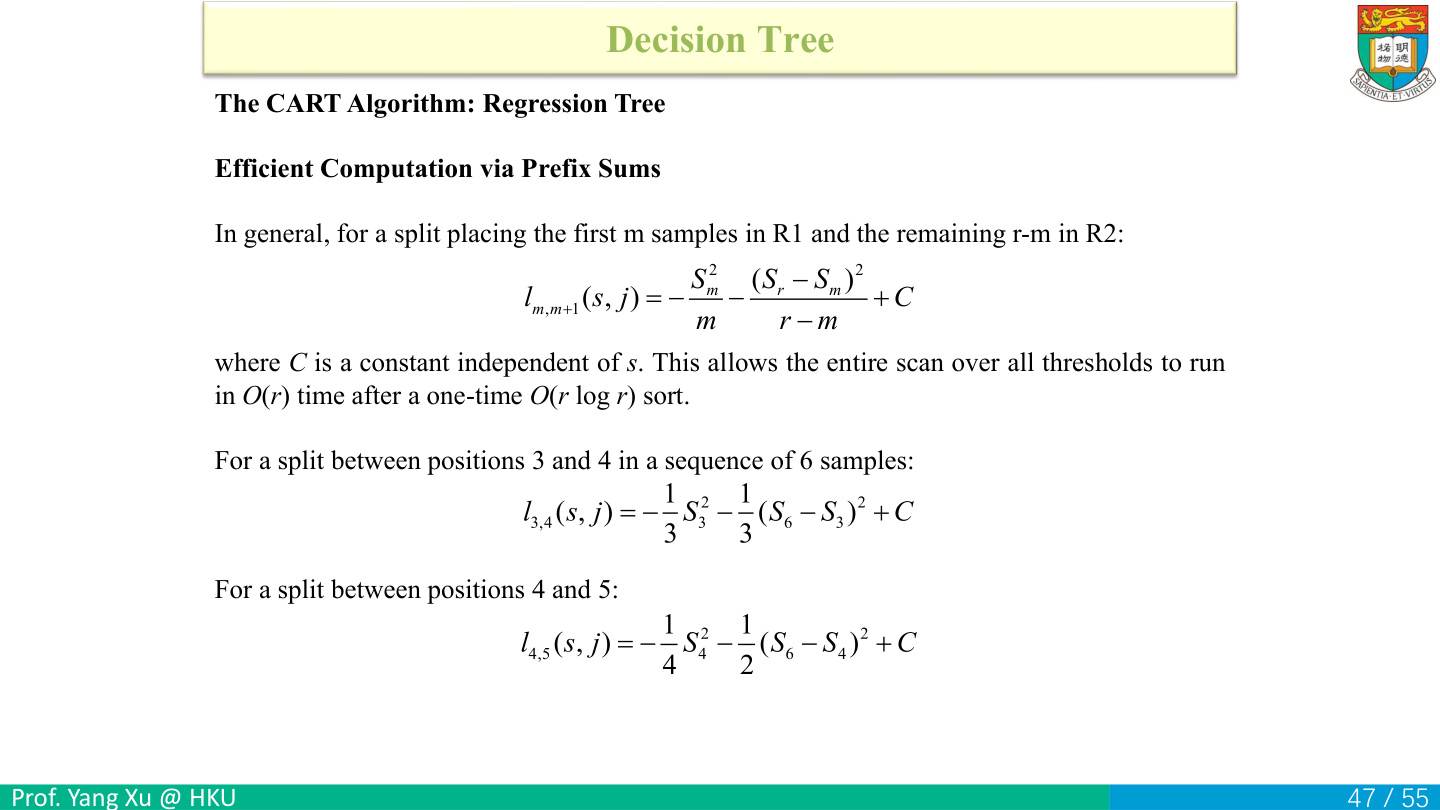
r=6,候选位置m表示左边保留前m条、右边保留后6−m条。m=3时,两边各3条,代价 C*−S₃²/3−(S₆−S₃)²/3;m=4时左4条右2条,代价 C*−S₄²/4−(S₆−S₄)²/2。两个分母始终对应左右样本数。
例如,用电流标签(3.2,4.1,5.0,7.8,8.5,9.1),S₃=12.3、S₄=20.1、S₆=37.7。m=3的Score=12.3²/3+25.4²/3≈265.4833;m=4的Score=20.1²/4+17.6²/2≈255.8825。常数相同,选Score更大的m=3。
阈值s与位置m不同:m决定哪些样本分到两边;s是输入特征上的数值,通常取相邻不同输入值中点。例如第3和4条速度2400与3000,取s=2700RPM。阈值来自输入速度的间隙,叶子均值则来自标签电流。
自测: 六个互不相同输入为什么只有5个内部切点?答案:相邻样本间有5个空隙,切在最左或最右会形成空叶,不属于本例候选。
用电机速度预测电流:输入与目标
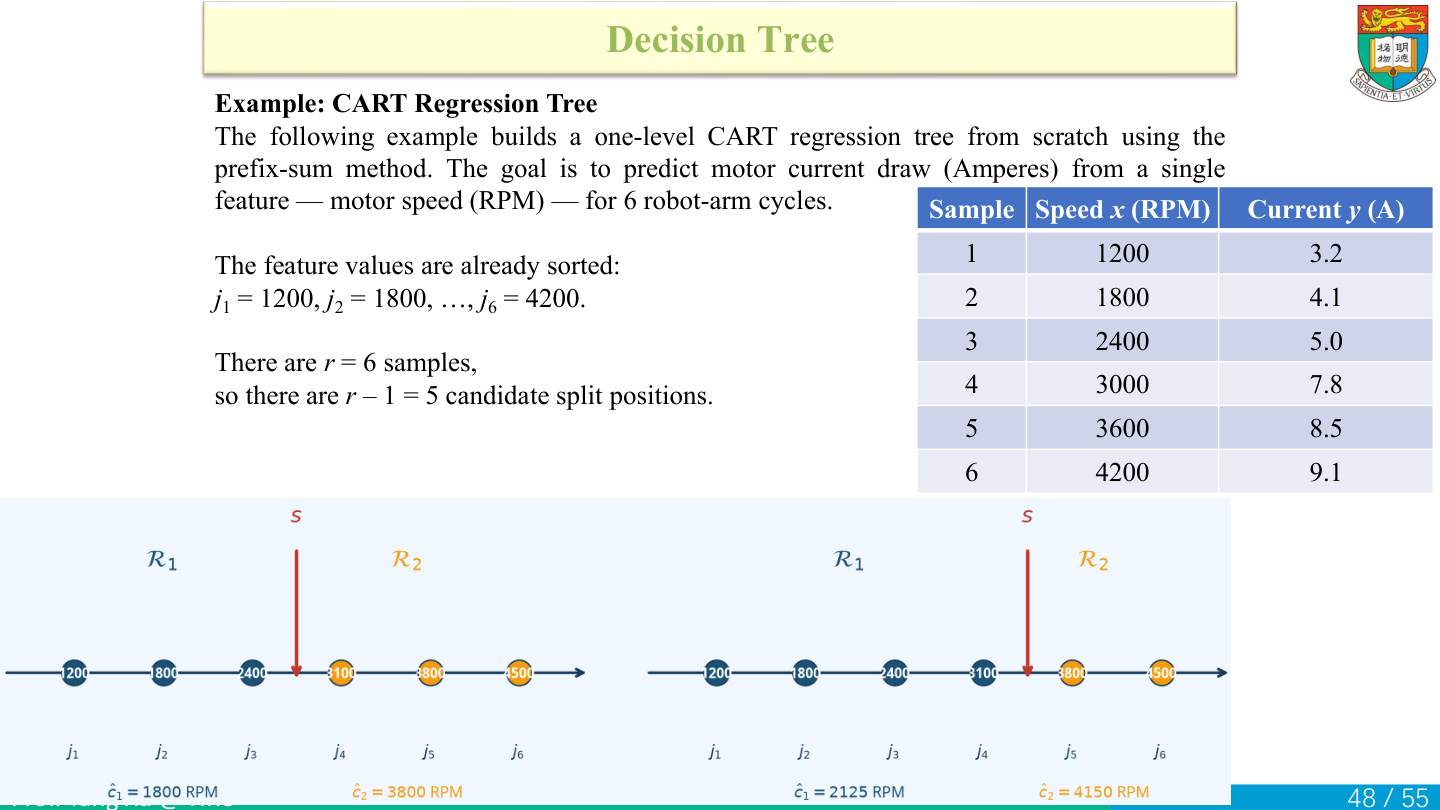
本例输入速度x为1200、1800、2400、3000、3600、4200RPM,目标电流y为3.2、4.1、5.0、7.8、8.5、9.1A。速度已升序排列,可以直接依相邻速度间隙生成5个候选阈值:1500、2100、2700、3300、3900RPM。
这是一棵单层回归树:选一个阈值,把数据分两组,每组预测一个平均电流。因此模型表示分段常数关系,在阈值处可以跳变。
先整理计算所需的量: 样本数r=6;每个候选两边人数必须加到6;总标签和37.7A;所有标签平方和单位A²。切分阈值单位RPM,叶子输出单位A,平方误差单位A²。
例如切在2400与3000之间,前3条进左叶,后3条进右叶。选择中点 (2400+3000)/2=2700 后,新速度2700走左叶,2701走右叶。
自测: 新速度2500RPM时,需要知道该次真实电流才能预测吗?答案:不需要,比较训练好的阈值后输出左叶均值。
逐一计算五个候选,选出最佳阈值
动手试试 · 移动回归树的切分线
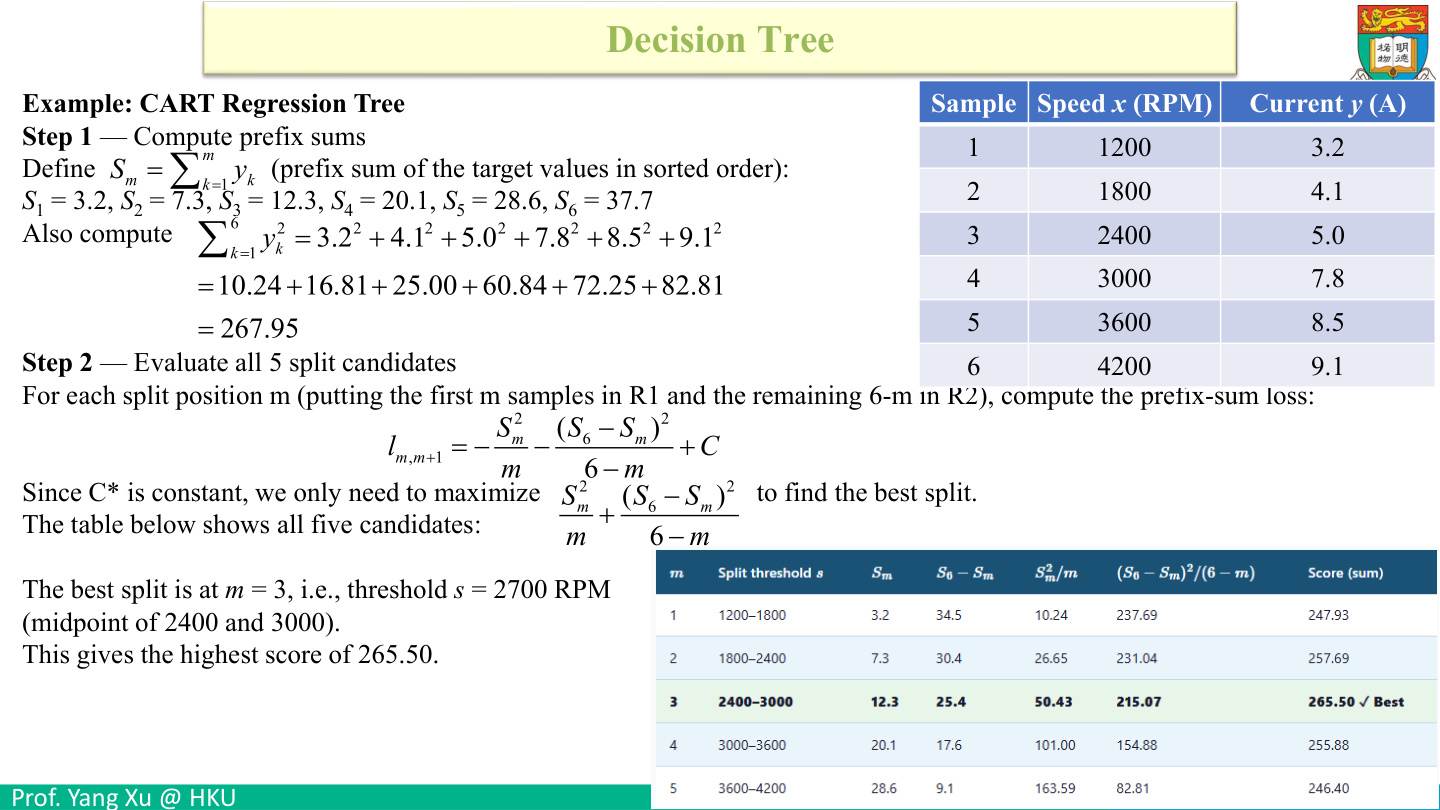
依标签累计:S₁=3.2、S₂=7.3、S₃=12.3、S₄=20.1、S₅=28.6、S₆=37.7;平方和 C*=10.24+16.81+25+60.84+72.25+82.81=267.95。
使用 Score=Sₘ²/m+(37.7−Sₘ)²/(6−m),五个结果为:
| m | 阈值RPM | Score | 总SSE=267.95−Score |
|---|---|---|---|
| 1 | 1500 | 248.2900 | 19.6600 |
| 2 | 2100 | 257.6850 | 10.2650 |
| 3 | 2700 | 265.4833 | 2.4667 |
| 4 | 3300 | 255.8825 | 12.0675 |
| 5 | 3900 | 246.4020 | 21.5480 |
例如m=3,左边和12.3,右边和 37.7−12.3=25.4。两组各3条,左项 12.3²/3=50.43,右项 25.4²/3≈215.0533,相加得265.4833。五个Score中它最大,SSE最小,阈值为2700RPM。
用Python扫描五个切点。 rows 存每个候选的阈值和SSE。
x = [1200, 1800, 2400, 3000, 3600, 4200]
y = [3.2, 4.1, 5.0, 7.8, 8.5, 9.1]
n = len(y)
total = sum(y)
sum_squares = sum(value ** 2 for value in y)

left_sum = 0
rows = []
for m in range(1, n):
    left_sum += y[m - 1]
    if x[m - 1] == x[m]:
        continue
    right_sum = total - left_sum
    score = left_sum ** 2 / m + right_sum ** 2 / (n - m)
    threshold = (x[m - 1] + x[m]) / 2
    rows.append((threshold, sum_squares - score))

threshold, sse = min(rows, key=lambda row: row[1])
print(threshold, round(sse, 4))  # 2700.0 2.4667
代码中的m表示左边人数。列表从0编号,所以新进左叶的标签是 y[m−1]。比较的是 x[m−1] 和 x[m] 之间的空隙。若两值相同,continue 只跳过这个候选,已累计的 left_sum 会带到下一个位置。最后的 row[1] 选中每个候选元组的第二项SSE,让 min 按SSE找最优阈值。
自测: 为什么选最大Score而非最小?答案:SSE等于固定常数减Score,二者方向相反。
叶子预测、总SSE和MSE分开计算
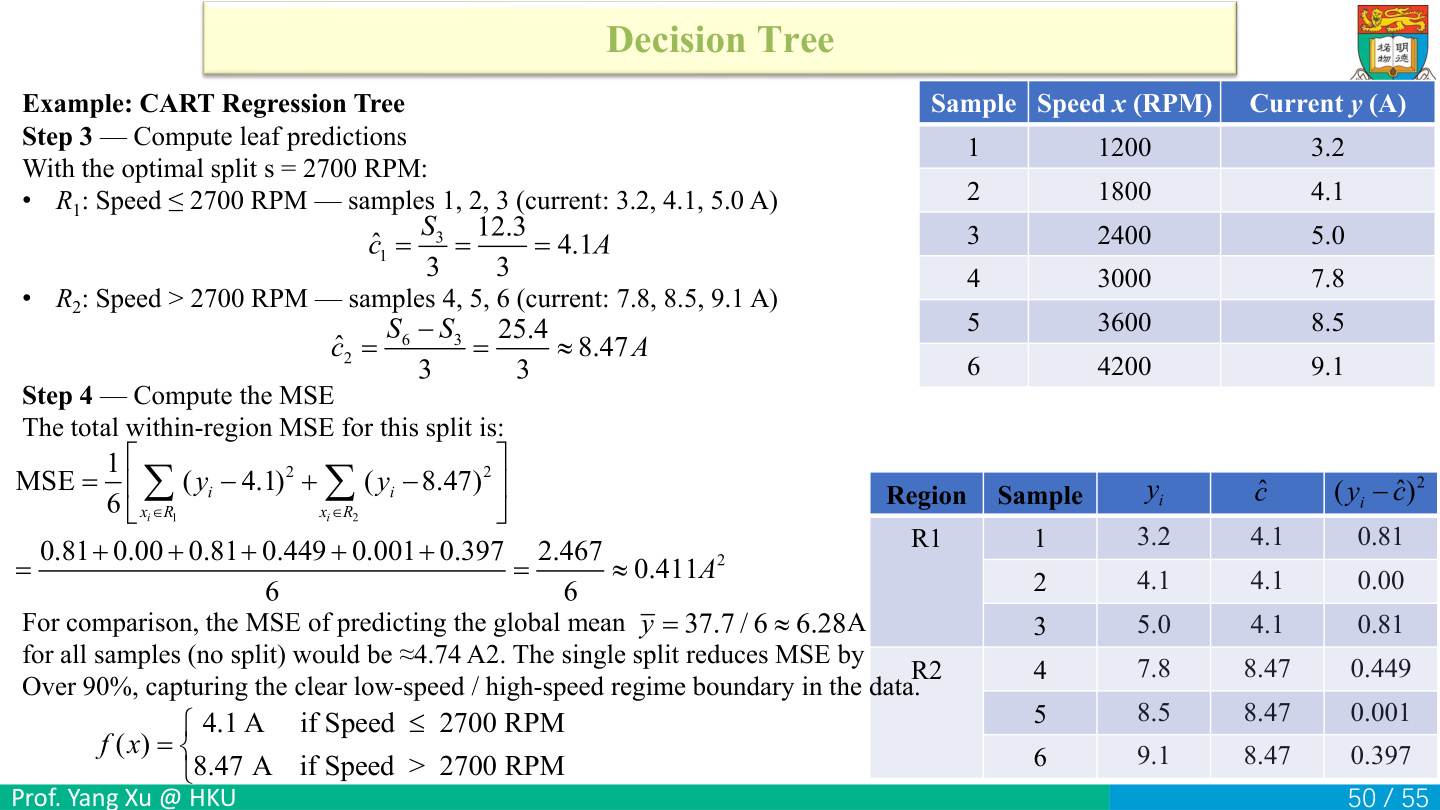
最佳阈值2700RPM,左边标签3.2、4.1、5.0,均值 (3.2+4.1+5.0)/3=4.1A。右边7.8、8.5、9.1,总和25.4,均值 25.4/3≈8.4667A。模型为速度≤2700输出4.1,否则输出8.4667。
左SSE (−0.9)²+0²+0.9²=1.62;右SSE (-0.6667)²+0.0333²+0.6333²≈0.846667;总SSE≈2.466667A²,常规MSE除6,得0.411111A²。若沿第42页半MSE定义,还需再除2,得到0.205556A²。计算时保留右均值的精度,最后才四舍五入。
再算无分裂的基准: 全局均值37.7/6≈6.283333A,无分裂MSE=[267.95−37.7²/6]/6≈5.178056A²。相对下降 1−0.411111/5.178056≈92.06%。
自测: 预测5000RPM会输出更大电流吗?答案:这棵单层树仍输出右叶8.4667A,回归树在叶内是常数,不能自动外推线性趋势。
Gini不纯度:不用对数也能衡量类别混杂
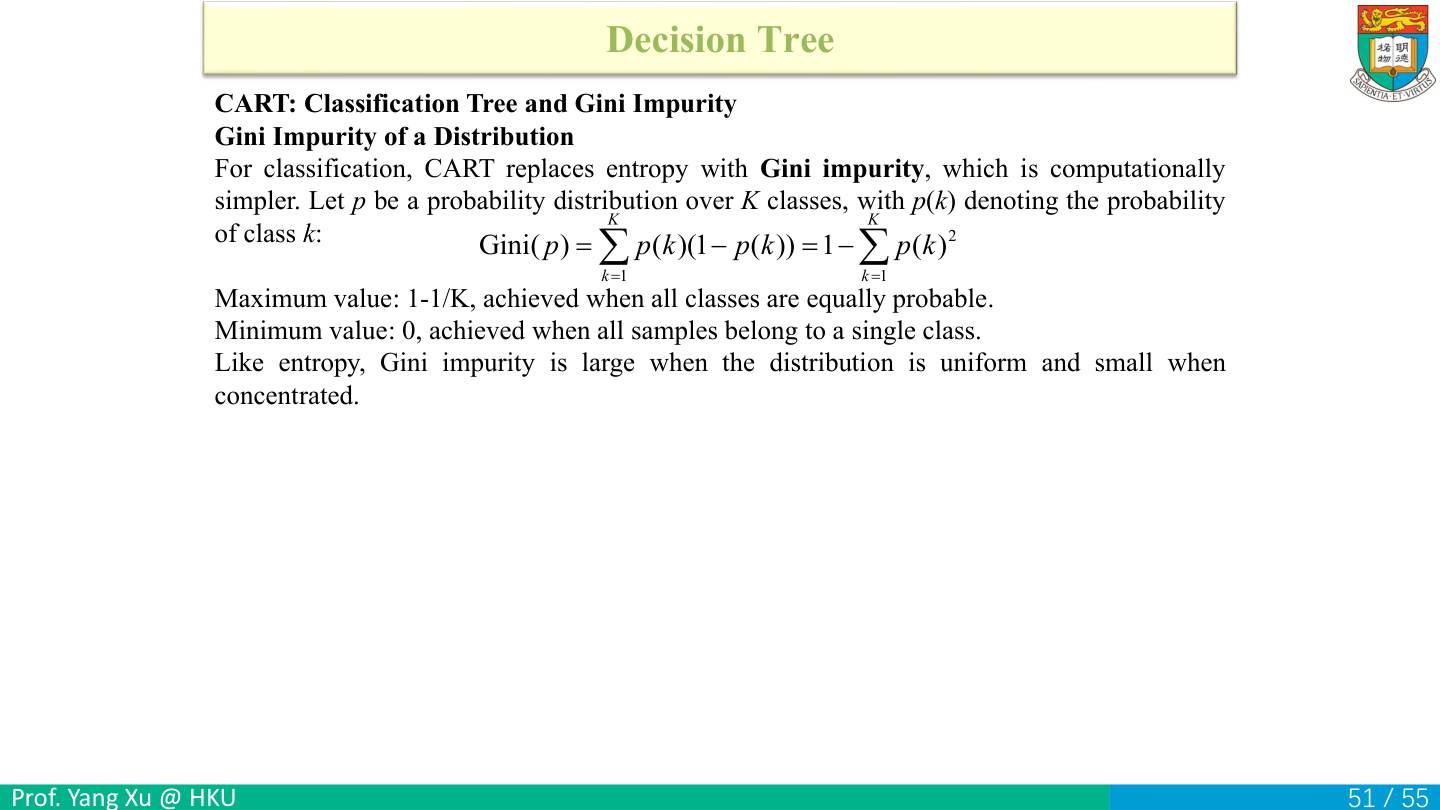
对K类分布p,Gini=Σₖpₖ(1−pₖ)=1−Σₖpₖ²。第一种写法展开为Σpₖ−Σpₖ²,因为所有类别概率和为1,得到第二种。注意每个pₖ先平方,再把平方相加;若先求和再平方,就会因Σpₖ=1而恒得0。
例如,二分类各半,Gini=1−0.5²−0.5²=0.5;若概率0.9、0.1,Gini=1−0.81−0.01=0.18;纯类(1,0)给0。混杂越多值越大。也可把它理解为按同一类别分布独立抽两次,两次标签不一样的概率。
为什么平均分配时Gini最大?展开平方差 Σₖ(pₖ−1/K)²=Σₖpₖ²−1/K≥0。所以 Σₖpₖ² 的最小值为1/K,恰好在每类概率都是1/K时达到。代入得到Gini的最大值 1−1/K,二分类上限0.5,三分类上限2/3。
熵使用负对数,Gini使用概率平方;例如二分类各半时,熵为1bit,Gini为0.5。
自测: 某节点3类概率(1/3,1/3,1/3),Gini多少?答案:1−3×1/9=2/3。
分类CART:比较分裂后加权Gini
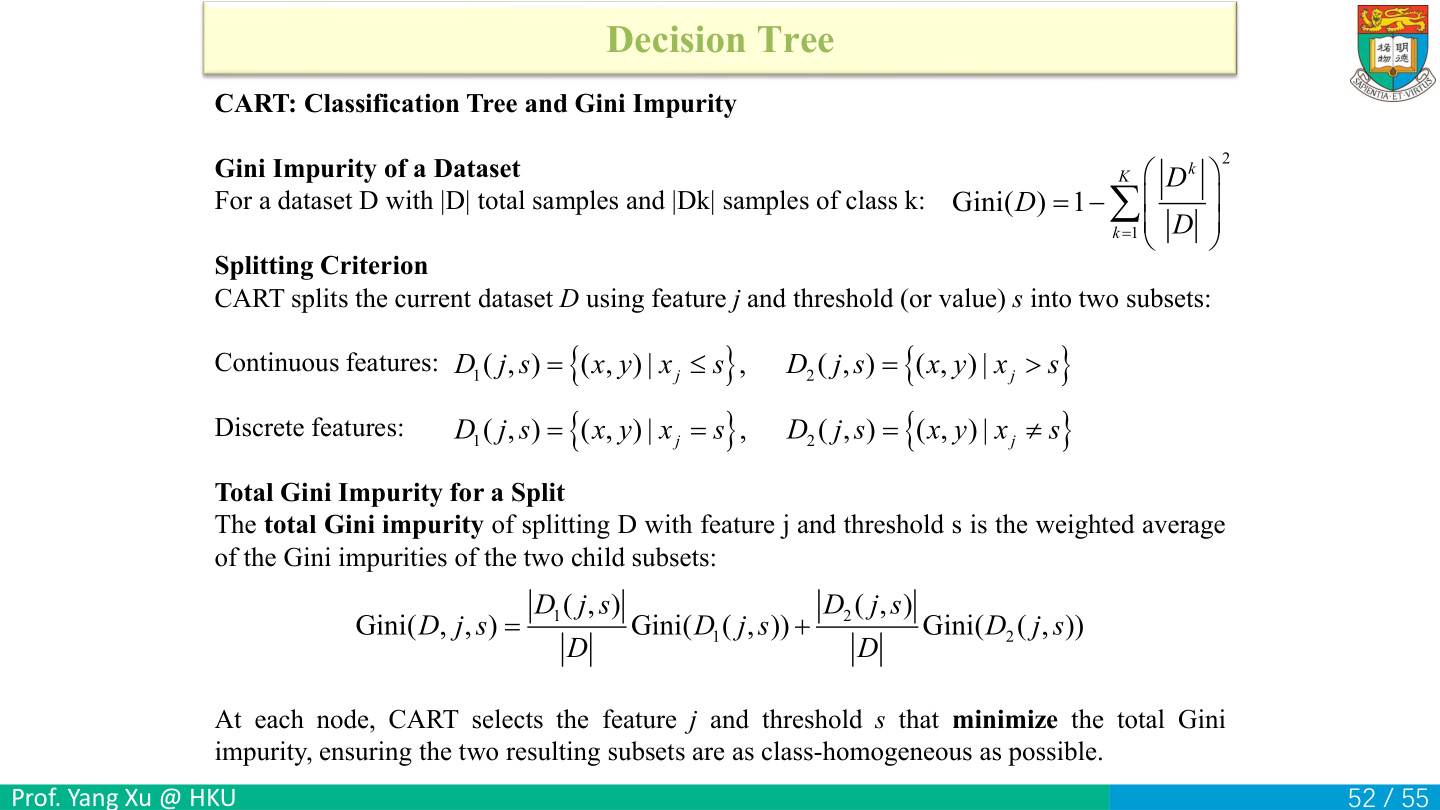
在当前节点数据D中,类别k频数为|Dₖ|,概率 pₖ=|Dₖ|/|D|,代入 Gini(D)=1−Σpₖ²。对特征j与候选s分成D₁、D₂后,评价 Gsplit=(|D₁|/|D|)Gini(D₁)+(|D₂|/|D|)Gini(D₂),选最小者。
例如,父节点10条、两类各5,Gini0.5。某分裂左4条全正类,Gini0;右6条1正5负,Gini=1−(1/6)²−(5/6)²=10/36≈0.2778;总体 4/10×0+6/10×0.2778≈0.1667。若另一分裂总体为0.3,前者更好。比较Gini下降量也一样,因为父节点0.5对所有候选相同。
连续特征用≤s和>s;离散特征可以用“等于某值/不等于该值”,这是一个二分形式,多类别特征也可比较类别集合的二分,具体候选由算法实现决定。无论比较单值还是类别集合,每次都保持两条分支。
分类叶子一般输出该叶多数类,或保存类别比例供后续使用;这和回归叶子对数值标签求平均不同。Gini用于评价分裂,叶子类别由该叶的标签组成确定。
自测: 左右子集大小不同时能直接把两个Gini除以2吗?答案:不能,应按样本占比加权。
振动分裂的Gini完整计算
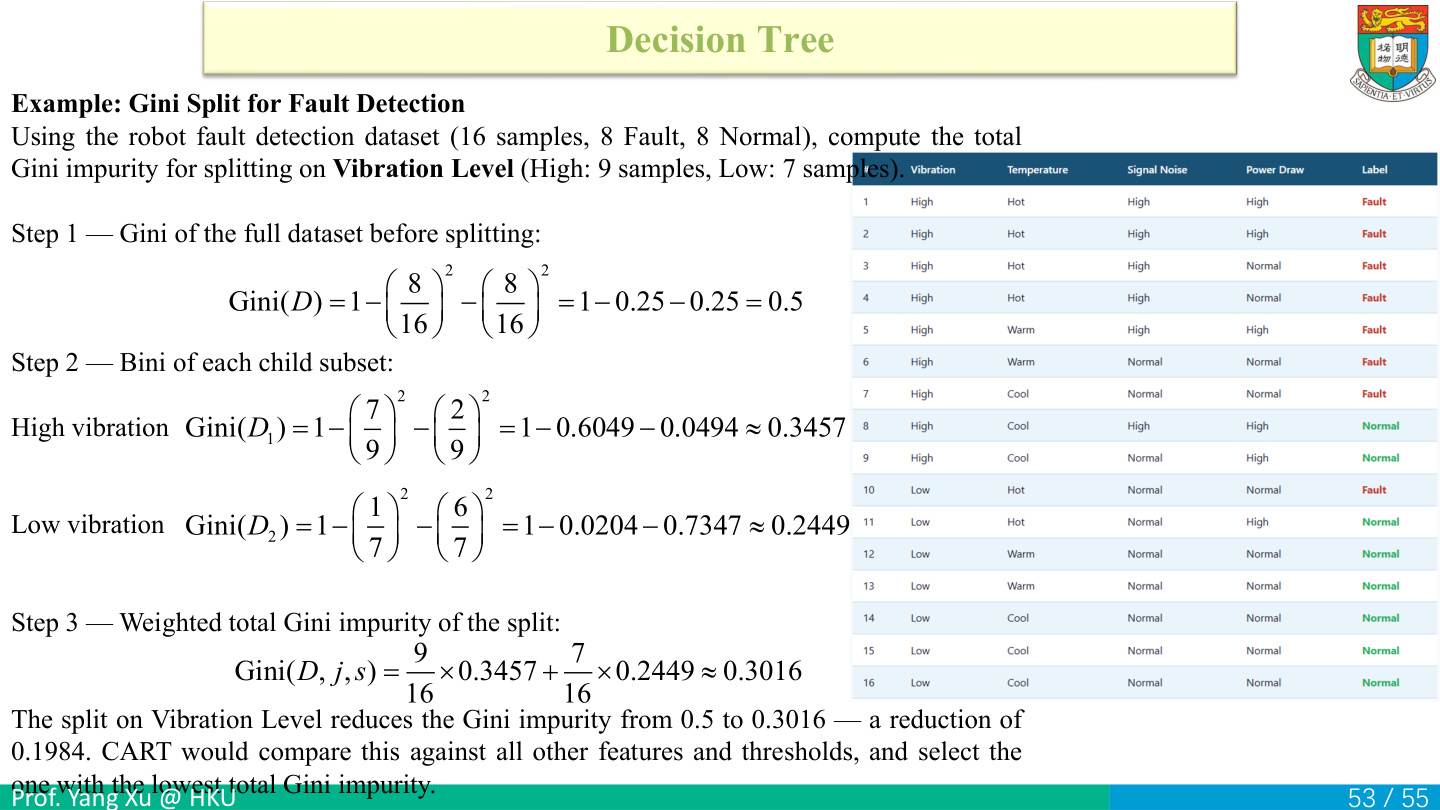
父节点8F/8N,Gini(D)=1−(8/16)²−(8/16)²=0.5。High振动9条,7F/2N:GiniHigh=1−49/81−4/81=28/81≈0.345679。Low振动7条,1F/6N:GiniLow=1−1/49−36/49=12/49≈0.244898。
按人数加权:Gsplit=9/16×28/81+7/16×12/49。先约分,第一项为7/36≈0.194444,第二项为3/28≈0.107143;合计19/63≈0.301587。相对父节点下降 0.5−0.301587≈0.198413。保留四位小数分别为0.3016与0.1984。
0.3016是分裂后的总体Gini,使用全部类别比例计算。本例一层振动树判错3条,误分类率为3/16=0.1875,使用错分条数计算。
再比较一个同为二叉的候选。按“信噪比High吗”会分成6条(5F/1N)和10条(3F/7N),加权Gini为 (6/16)×[1−(5/6)²−(1/6)²]+(10/16)×[1−(3/10)²−(7/10)²]≈0.3667。它高于振动的0.3016,因此在这两个候选中选择振动。
自测: Low组Gini小于High组,是否说明整个模型只要保留Low组?答案:不是,两组都覆盖实际输入,必须一起保留并按频率评价。
本讲复习:SVM与三种树标准各管什么
SVM通过最大间隔目标训练分界面,再用支持向量和核值预测。决策树沿根到叶判断,建树时逐个比较候选分裂:ID3用信息增益,C4.5使用增益率思想,CART回归用平方误差、分类用Gini。复习时把每种模型的“怎样预测”和“怎样训练”连成一条流程。
图片结束页:Thank you,Class is over
下一讲以CART为例,把多个模型的预测组合起来。