左右键翻页;“连续阅读”展开整份;搜索可定位概念。
这讲把一个判断器变成多层网络
本讲学习多层感知机MLP:先看一个神经元怎样乘加、判断,再把它们连成多层网络。最后用反向传播计算梯度,用梯度下降更新参数。
本讲两条任务:理解MLP,再读作业要求
MLP把“乘权重、加偏置、过激活函数”一层层串起来。例如784→128→10表示把784个输入数变成128个中间特征,再输出10个类别分数。本讲先学这些计算,再接到MNIST编程作业。
生物神经元是灵感,人工神经元是数学运算
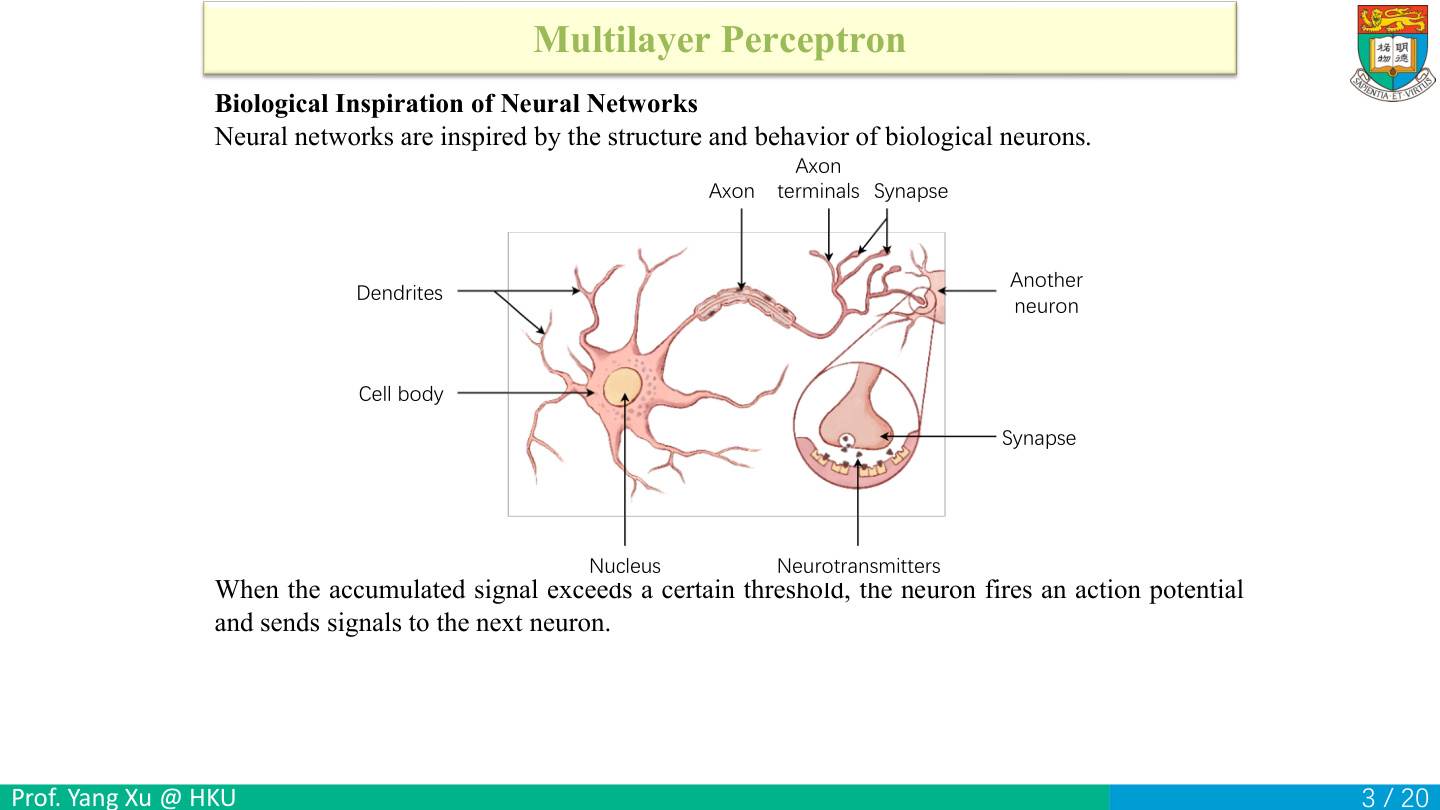
图上的 dendrites(树突)接收信号,cell body(细胞体)整合信号,axon(轴突)把信号向外传,synapse(突触)连接其他神经元。生物神经元综合收到的输入,在达到触发条件时产生输出。这启发了人工神经元的“汇总→判断→传递”结构。
把这个过程写成数学运算:输入 x₁,x₂,… 是收到的数字,权重 w₁,w₂,… 决定每路信号影响多大,偏置 b 调节容易触发还是难以触发,激活函数把总分转成输出。先算 z=Σwᵢxᵢ+b,再算 a=φ(z)。
例如,两路输入为3和2,权重为0.5和−1,偏置为1,则总分 z=0.5×3+(−1)×2+1=0.5。正权重的输入增大会推高分数,负权重的输入增大会压低分数。若用“分数非负输出1”的激活,此时输出1。
读图时沿接收端→汇总处→输出端看,就对应输入→加权求和→激活输出。
自测: 偏置是另一个传感器读数吗?答案:不是,它是模型可调的常数项,相当于调整触发门槛。
感知机:把加权总分变成0或1
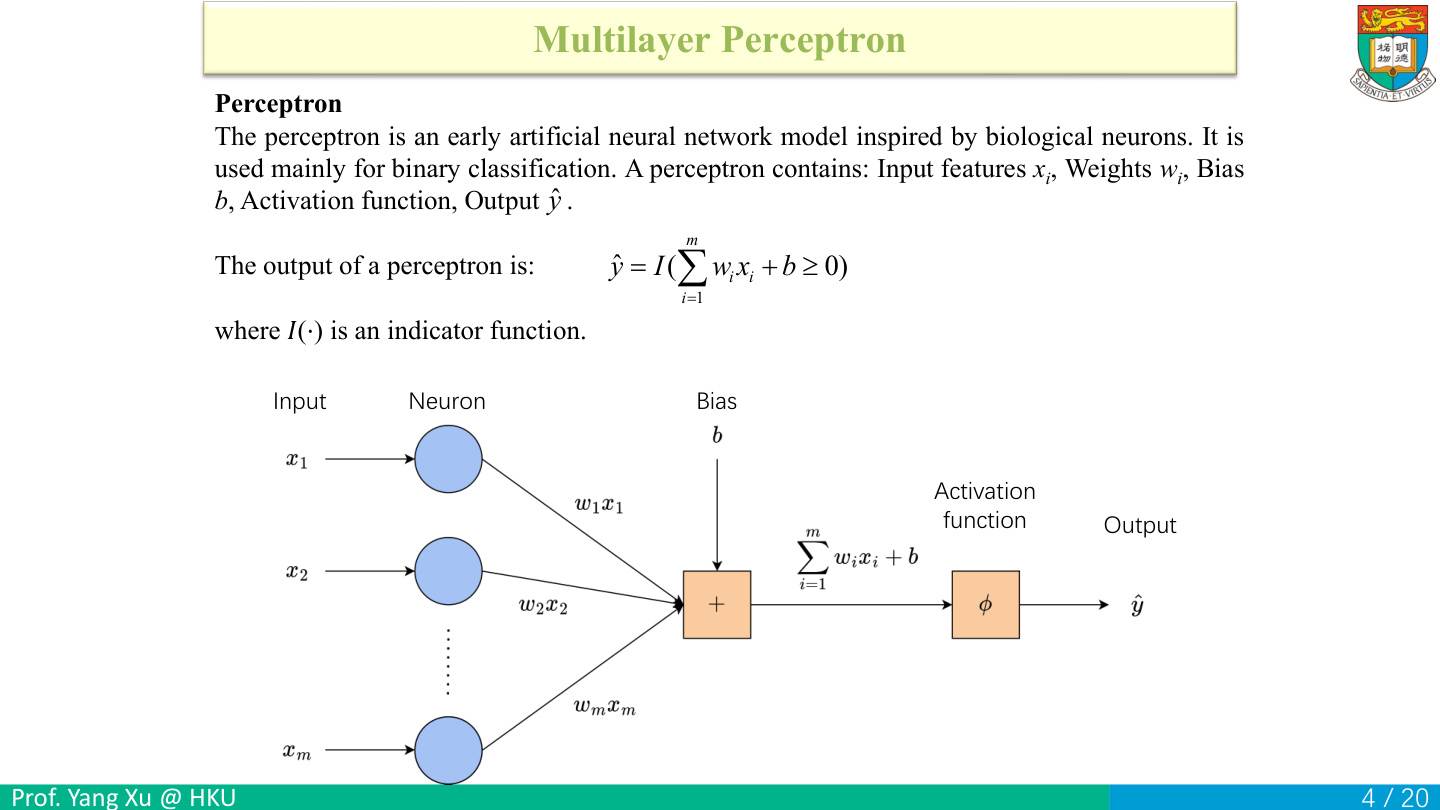
感知机的公式为 ŷ=I(Σᵢwᵢxᵢ+b≥0)。xᵢ 是第i个输入,wᵢ 是其权重,b 是偏置,ŷ 读作“预测的y”。I(条件) 是指示函数:条件真返回1,条件假返回0。先算括号里的总分,再判断其是否大于等于0;I执行固定的真假判断,训练调整的是w和b。
算一遍:输入 x=(2,−1),权重 w=(0.5,1),偏置 b=−0.2。第一项 0.5×2=1;第二项 1×(−1)=−1;相加再加偏置得 z=1−1−0.2=−0.2;因为 −0.2≥0 为假,输出 ŷ=0。若只把偏置改成0,则z=0,这里采用“≥0”,输出便是1。
二维时 w₁x₁+w₂x₂+b=0 是一条分界直线;三维是一个平面;更高维叫超平面。权重决定方向,偏置决定位置。输入维度为m时,w也必须有m个数,才能逐项相乘后相加。
自测: z=−3 和 z=−0.001 输出是否相同?答案:相同,均为0;但离边界的远近不同。
感知机更新:错向哪边,就把分数往正确方向推
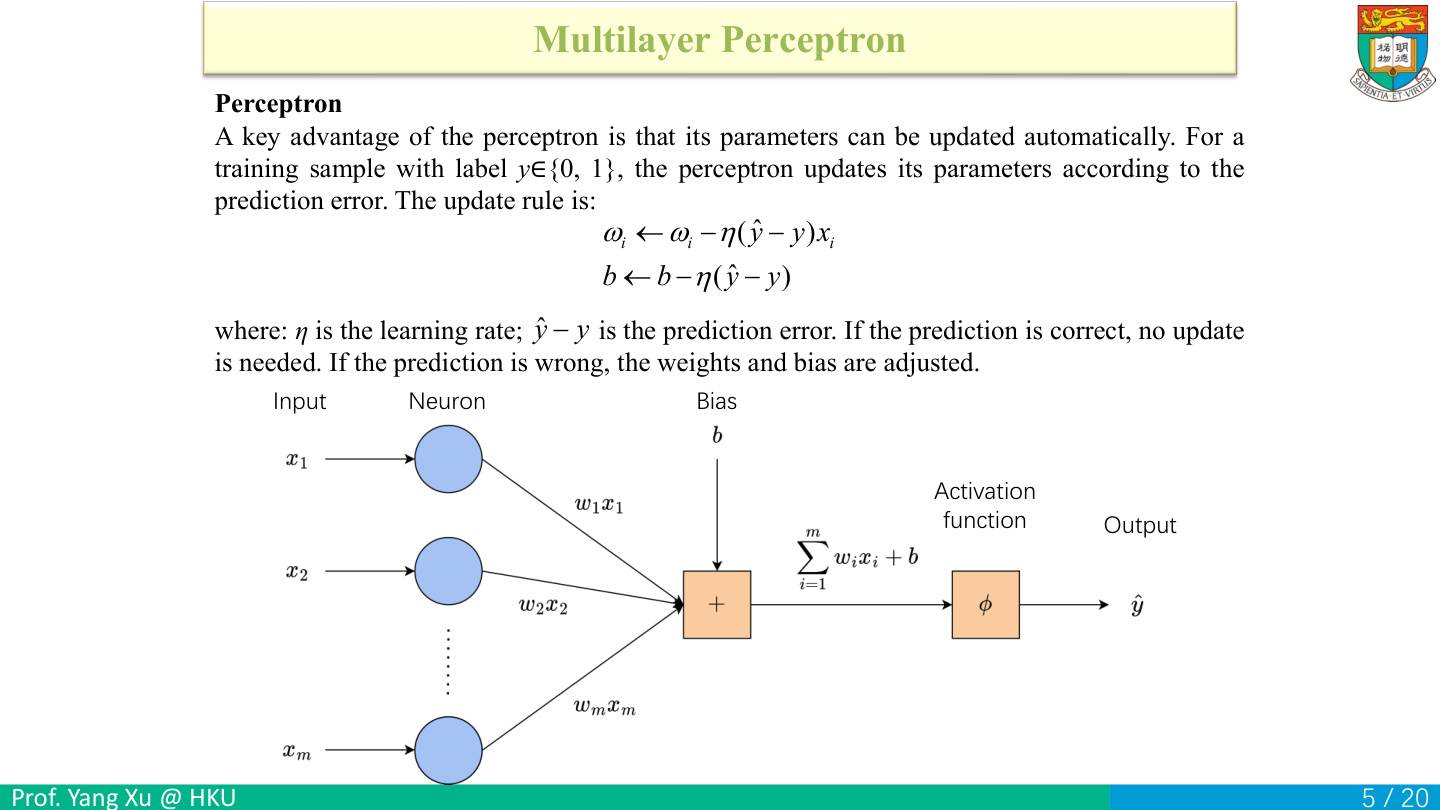
更新式是 wᵢ←wᵢ−η(ŷ−y)xᵢ,b←b−η(ŷ−y)。箭头表示用右侧结果替换旧参数。y∈{0,1} 是真实标签,ŷ 是本次预测,η>0 是学习率;同一次更新要先用旧参数算完ŷ,再用这个同一个误差更新全部参数。
分三种情况理解。预测正确时 ŷ−y=0,所有参数都不变。真实为1却预测0时,误差为−1,因此 w←w+ηx、b←b+η,会把这个样本的分数推高。真实为0却预测1时,误差为1,参数朝相反方向调整。对同一条输入,更新后的分数减去原分数为 Δz=(Δw)ᵀx+Δb=−η(ŷ−y)(Σxᵢ²+1)。括号一定为正,因此误差−1会抬高分数,误差+1会压低分数。
算一遍:x=(2,1)、w=(0,0)、b=−1、η=0.1,真实y=1。旧分数为−1,故ŷ=0,误差−1。得到 w₁=0−0.1×(−1)×2=0.2,w₂=0.1,b=−0.9。新分数 0.2×2+0.1×1−0.9=−0.4,虽然暂时仍预测0,却已由−1向正确方向移动。再遇到这个误分类样本时,规则会继续把它的分数往上推。
这里使用专门的误分类更新规则。后面的多层网络要通过激活函数导数反传,因此会换用Sigmoid、ReLU等激活。
自测: xᵢ=0时wᵢ会更新吗?答案:这一次不会,因为该项的更新量含xᵢ;偏置仍可能更新。
为什么一条直线解决不了XOR
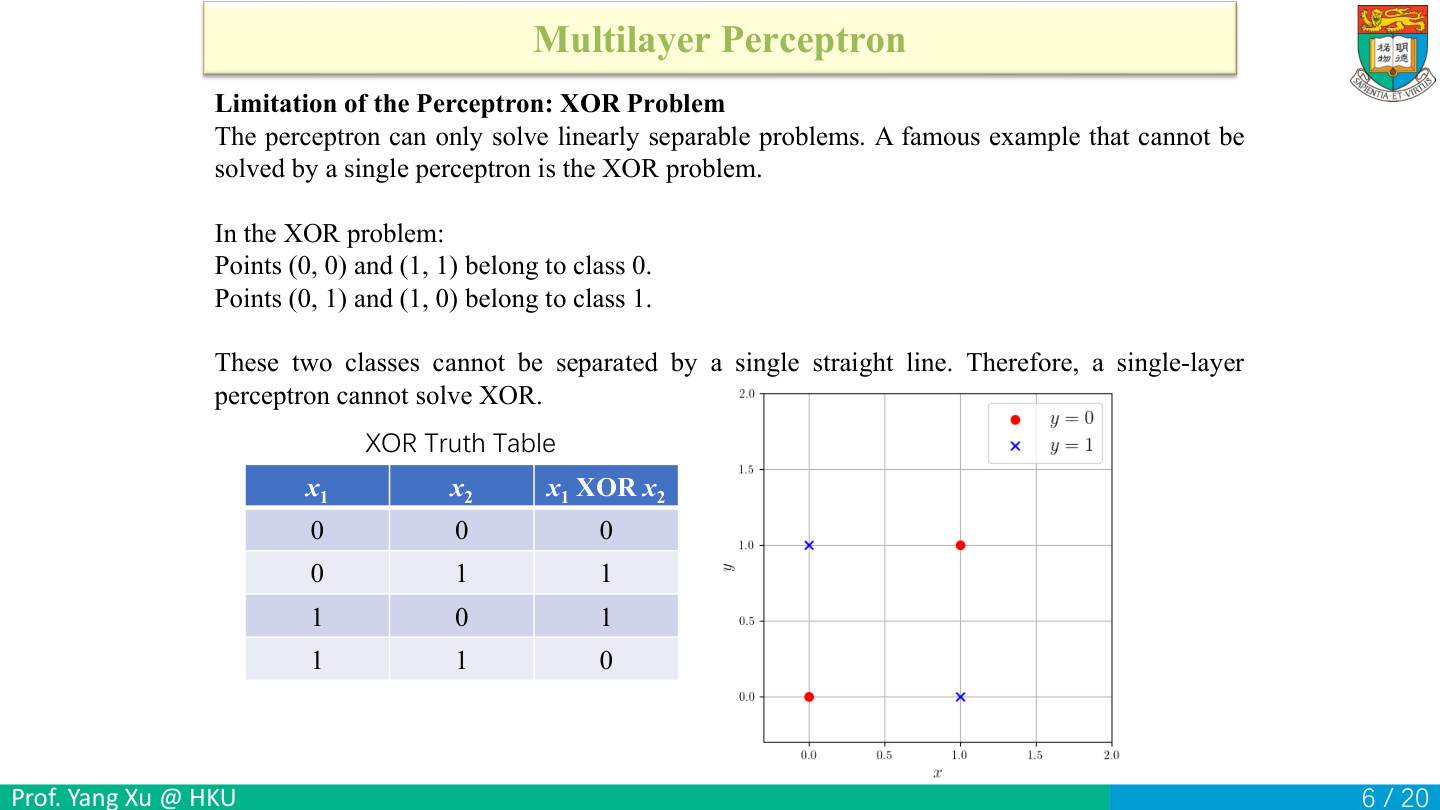
XOR(异或)的规则是“两输入不同输出1,相同输出0”。四个点为 (0,0)→0、(1,1)→0、(0,1)→1、(1,0)→1。两类各占正方形的对角,任何一条直线都不能把两条对角上的同类同时分到各自一侧。
也能直接用不等式证明。沿用本讲 z≥0 输出1:点(0,0)属于0,所以 b<0;点(1,0)属于1,所以 w₁+b≥0;点(0,1)属于1,所以 w₂+b≥0。把后两式相加得 w₁+w₂+2b≥0,因此 w₁+w₂+b≥−b>0。这会把(1,1)预测为1,和真实标签0矛盾。因此不存在满足四个点的线性参数。
也可以看这四个点的连线。两个0类点的中点是(0.5,0.5),两个1类点的中点也是(0.5,0.5)。若一条直线把两类放在两侧,两条同类连线的中点也要在各自那一侧。同一个中点做不到这一点。
自测: XOR训练失败时,只把学习率从0.1减成0.001能解决吗?答案:不能。学习率改变寻找参数的过程,不能让直线变成非线性边界。
隐藏层:先做几个简单判断,再组合
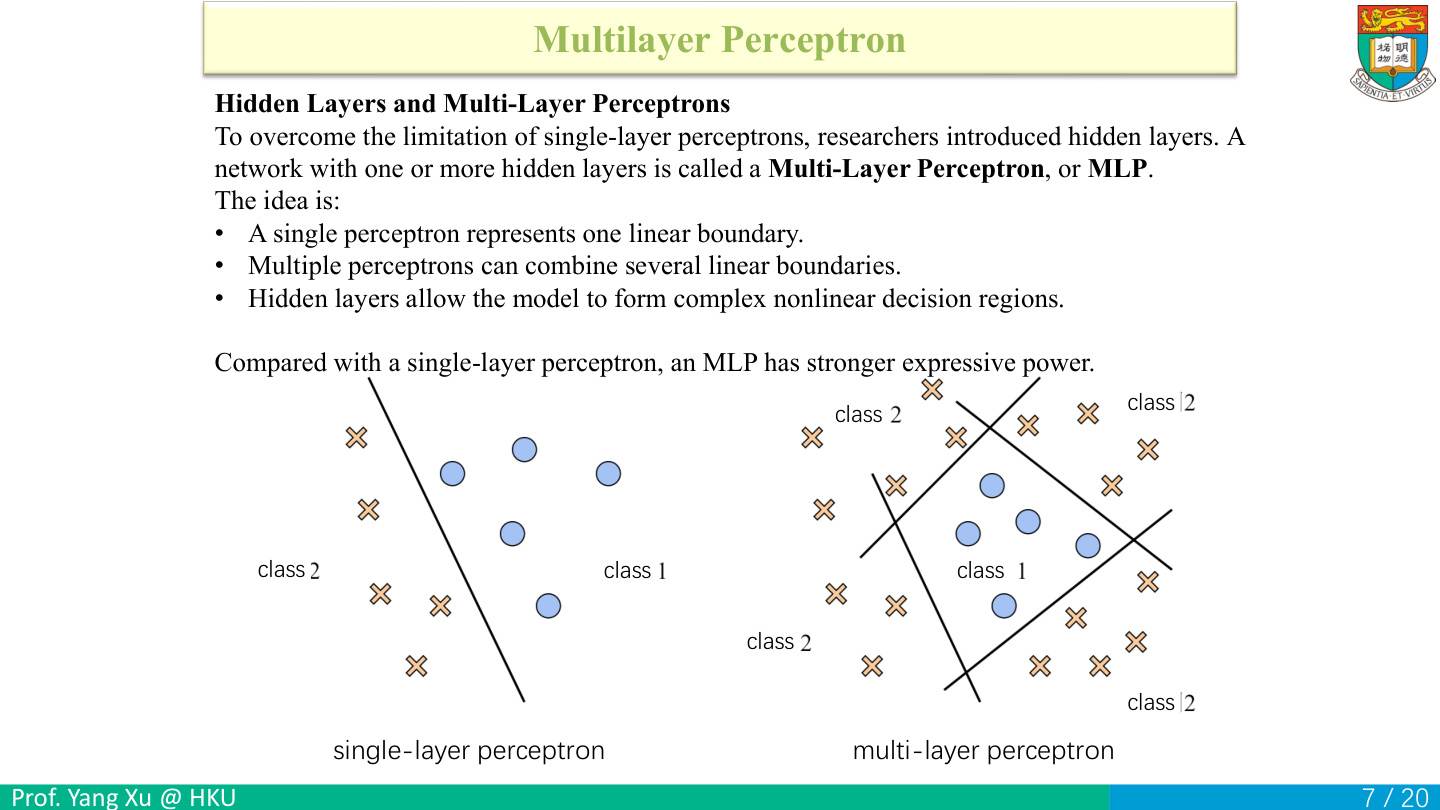
隐藏层是输入和最终输出之间的计算层。隐藏层神经元的参数根据最终任务的损失一起训练。多个简单边界经过非线性组合,能形成比一条直线复杂得多的区域。
把XOR完整算一遍:使用 I(z≥0),设 h₁=I(x₁+x₂−0.5≥0),表示“至少有一个输入为1”;h₂=I(x₁+x₂−1.5≥0),表示“两个都是1”;输出 ŷ=I(h₁−2h₂−0.5≥0)。先数输入里有几个1,再算两个隐藏节点,最后算输出分数:
| 输入x | x₁+x₂ | h₁ | h₂ | 输出分数 h₁−2h₂−0.5 | 输出ŷ |
|---|---|---|---|---|---|
| (0,0) | 0 | 0 | 0 | −0.5 | 0 |
| (0,1) | 1 | 1 | 0 | 0.5 | 1 |
| (1,0) | 1 | 1 | 0 | 0.5 | 1 |
| (1,1) | 2 | 1 | 1 | −1.5 | 0 |
在这四个点中,只有总和等于1的两点通过。第一条隐藏边界让它们进入正类候选,第二条隐藏边界把总和为2的点划出去。
隐藏层要配合非线性激活。如果每层只有矩阵乘法和加法,最终仍可折叠成一个仿射变换,第10页会展开证明。
自测: 本例隐藏层两个节点解决了什么?答案:把原来的输入改写为两个更有用的中间判断,使输出层能用简单规则组合。
前馈网络:数字从左往右走一遍
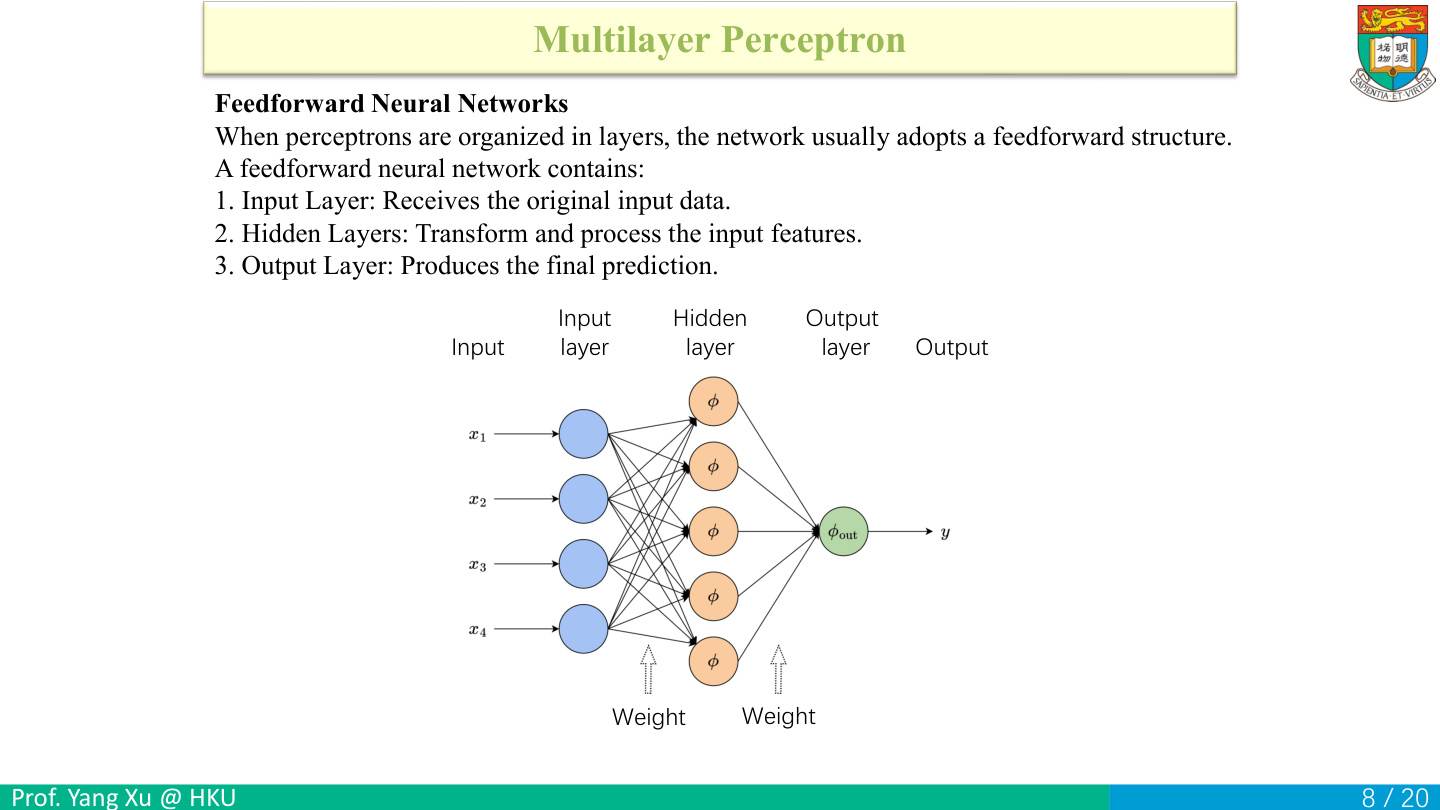
图的 Input Layer(输入层)接收原始特征,Hidden Layers(隐藏层)计算中间表示,Output Layer(输出层)给出预测。前馈的意思是:这次计算中,数据按层从输入流向输出,没有回到前一层形成循环。图中连线上的权重决定上一层各个输出怎样参与下一层的乘加。
看一个小网络: 输入 x=(1,2);隐藏层两个节点:z₁=1×1+1×2+0=3,z₂=(−1)×1+1×2−2=−1;用ReLU得到 h=(3,0)。输出层算 ŷ=2×3+(−1)×0+1=7。顺序是输入→两组乘加→两次激活→输出乘加。训练时在这次预测之后计算误差,再更新参数。
对一个全连接层,每个输出节点都读取上一层的全部输入。若上一层2个数、这一层3个节点,则有 2×3=6 个权重,再加3个偏置,共9个可训练参数。输入层本身只是摆放输入数字,通常不计为有参数的计算层;因此“几层网络”必须先说清是否把输入层算进去。
自测: 2维输入、3个隐藏节点、1个输出节点,若均为全连接且带偏置,共多少参数?答案:2×3+3+3×1+1=13。
逐层检查矩阵形状:3→4→2→1
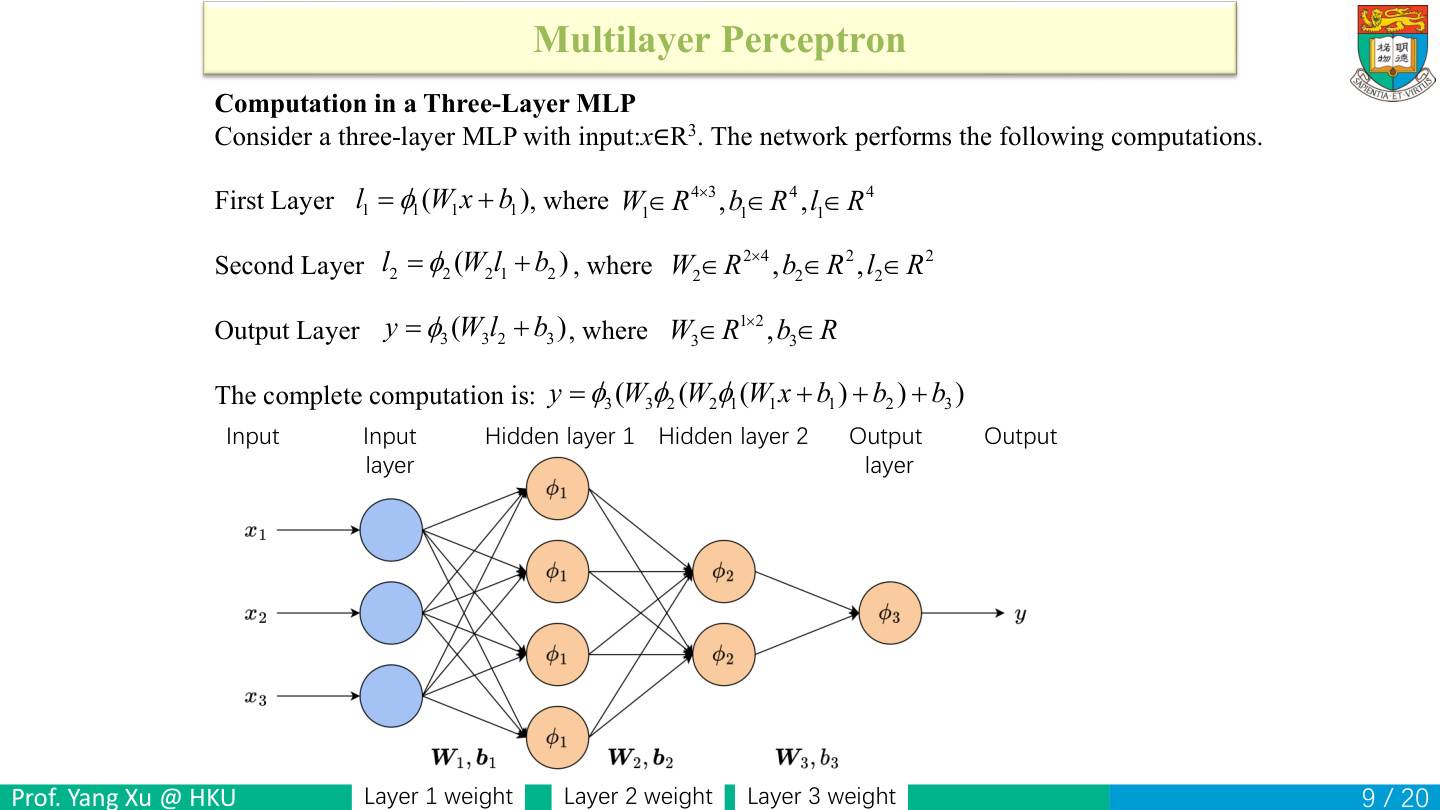
把x看成列向量,输入为 x∈R³,即3×1。第一层 a₁=W₁x+b₁:W₁为4×3,故 (4×3)(3×1)=4×1;b₁有4个数,逐项相加后仍为4×1;激活 l₁=φ₁(a₁) 不改变长度。
第二层 a₂=W₂l₁+b₂:W₂为2×4,得到2×1;b₂长2,激活后l₂仍长2。第三层 a₃=W₃l₂+b₃:W₃为1×2,得到一个数;加一个偏置,经过φ₃,得到标量输出。写成完整式是 ŷ=φ₃(W₃φ₂(W₂φ₁(W₁x+b₁)+b₂)+b₃)。从最里面开始,每层都是“乘权重、加偏置、过激活”。
| 本层 | 输入列向量 | 权重形状 | 偏置形状 | 输出列向量 |
|---|---|---|---|---|
| 1 | 3×1 | 4×3 | 4×1 | 4×1 |
| 2 | 4×1 | 2×4 | 2×1 | 2×1 |
| 3 | 2×1 | 1×2 | 1×1 | 1×1 |
参数量逐项算。 第一层 4×3+4=16;第二层 2×4+2=10;输出层 1×2+1=3;总计29。激活函数本身在此不带可训练参数,不额外计数。
例如,若第一行权重为(1,0,−1),输入(2,3,1),对应偏置0.5,则第一个激活前值为 1×2+0×3−1×1+0.5=1.5。这一行只产生一个输出,其余三行分别产生另三个输出。
列向量约定下使用 W₁x,形状为 (4×3)(3×1)。若一批输入按行排列,例如5条数据构成5×3的X,NumPy中计算 X @ W1.T + b1。矩阵乘法是 (5×3)(3×4)=5×4,把一维长4的b1加到每行,得到每条输入的4个激活前值。
自测: 第二层偏置为什么不是4维?答案:它为本层每个输出各加一个常数,本层只有2个输出。
没有非线性,多层只是一次乘加
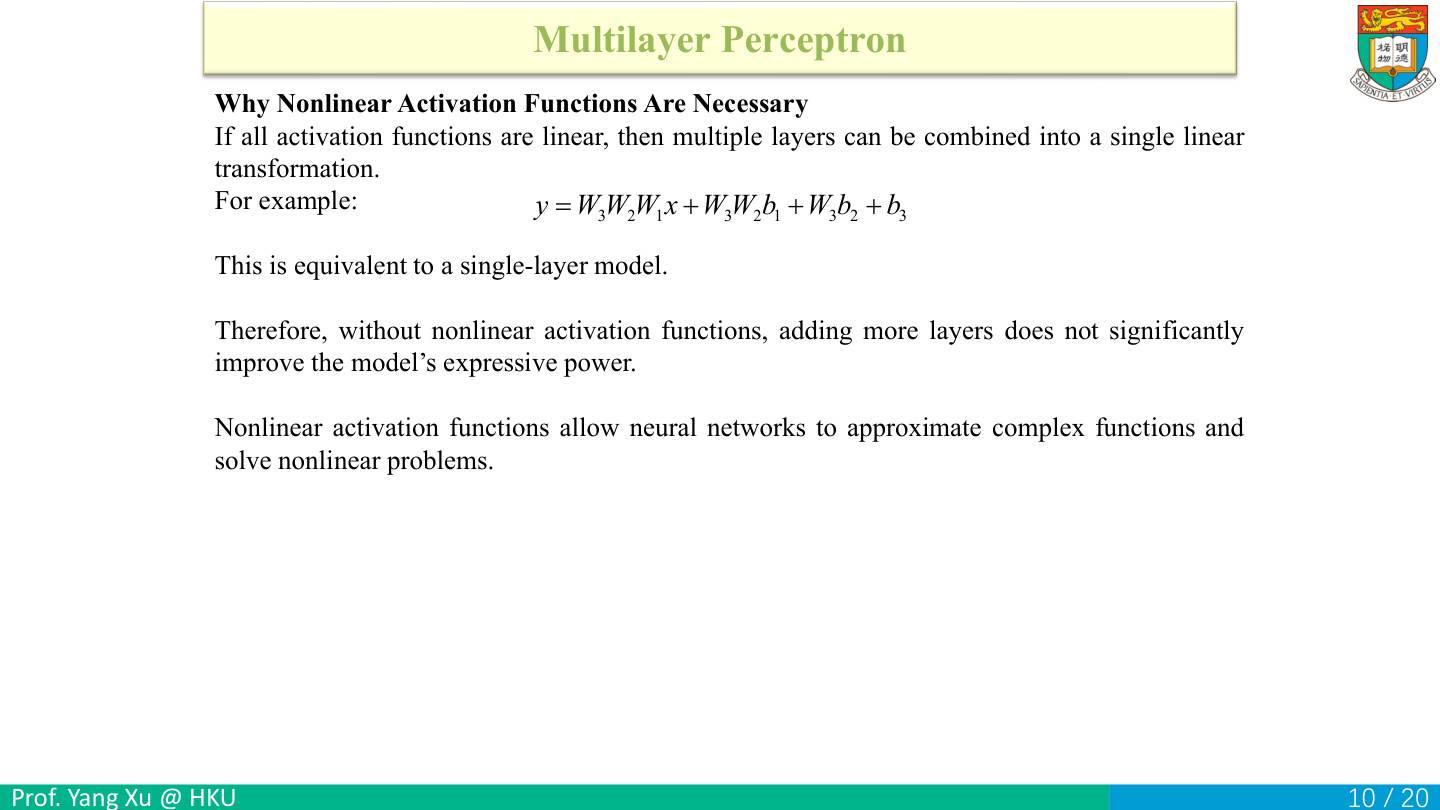
假设把三个激活函数都换成恒等函数φ(z)=z。先写第一层 l₁=W₁x+b₁,第二层 l₂=W₂l₁+b₂。代入得到 l₂=W₂W₁x+W₂b₁+b₂。输出再代入:y=W₃l₂+b₃=W₃W₂W₁x+W₃W₂b₁+W₃b₂+b₃。
把 W=W₃W₂W₁,b=W₃W₂b₁+W₃b₂+b₃ 记作新的有效参数,就变成 y=Wx+b。它仍是一层仿射模型。严格说“线性”不含偏置,“仿射”含偏置;这里的Wx+b属于仿射变换。
例如,两层标量计算:h=2x+1,y=3h−4,代入得 y=3(2x+1)−4=6x−1。虽然执行了两层,输入输出仍只是一条直线。若改成 h=max(0,2x+1),则x≤−0.5时y=−4,x>−0.5时y=6x−1,整体就成了折线。
因此,网络要表达非线性边界,关键是层间加入非线性激活。增加纯乘加层数,输入输出仍可归并为Wx+b。
自测: y=2(3(4x)+1)+5 能表示XOR吗?答案:它可化简为 24x+7,仍无非线性,不能凭堆叠解决XOR。
三种激活:Sigmoid、Tanh、ReLU
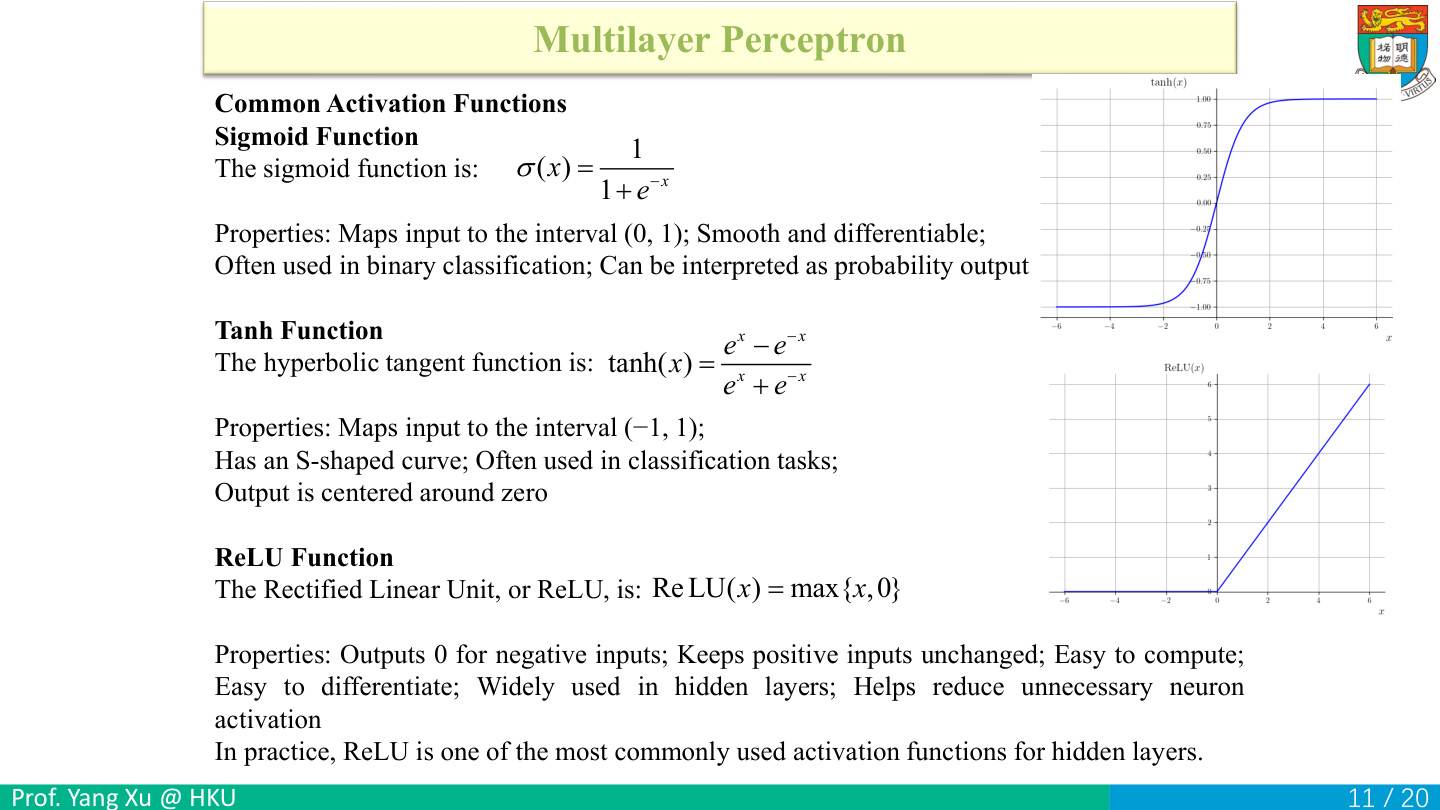
Sigmoid: σ(z)=1/(1+e^(−z))。z=0时e⁰=1,所以输出1/2;z很大时e^(−z)接近0,输出接近1;z很负时分母很大,输出接近0。把σ写成 (1+e^(−z))^(−1),链式求导得 σ′=e^(−z)/(1+e^(−z))²。将分式拆成 1/(1+e^(−z)) 与 e^(−z)/(1+e^(−z)) 的乘积,就得到 σ′=σ(1−σ)。σ为0.5时导数最大0.25,两端接近0,多层连乘时梯度可能很小。用于二分类输出时,可解释为模型估计的正类概率。
Tanh: (eᶻ−e^(−z))/(eᶻ+e^(−z)),范围−1到1,tanh(0)=0,导数 1−tanh²(z)。把分子和分母同除以eᶻ,得到 tanh(z)=(1−e^(−2z))/(1+e^(−2z))=2σ(2z)−1。令s=σ(2z),用上面的Sigmoid导数,得到 tanh′(z)=4s(1−s)=1−(2s−1)²。它以0为中心,两端的导数也接近0。
ReLU: max(z,0)。z=−2输出0,z=3输出3;z<0导数0,z>0导数1,z=0不可导,程序通常采用约定的次梯度。它在正区间是线性的,但整个函数在0处折弯,所以仍是非线性函数。长时间落在负区间的节点可能不再更新,这种现象常称为“死亡ReLU”。
例如,同一激活前值z=0,Sigmoid给0.5,Tanh给0,ReLU给0。选函数会改变下一层收到的数据尺度与反向传播的梯度。
自测: ReLU输出是否只能在0与1之间?答案:不是,它不小于0,但没有上界,例如输入10就输出10。
隐藏层和输出层为什么选不同激活
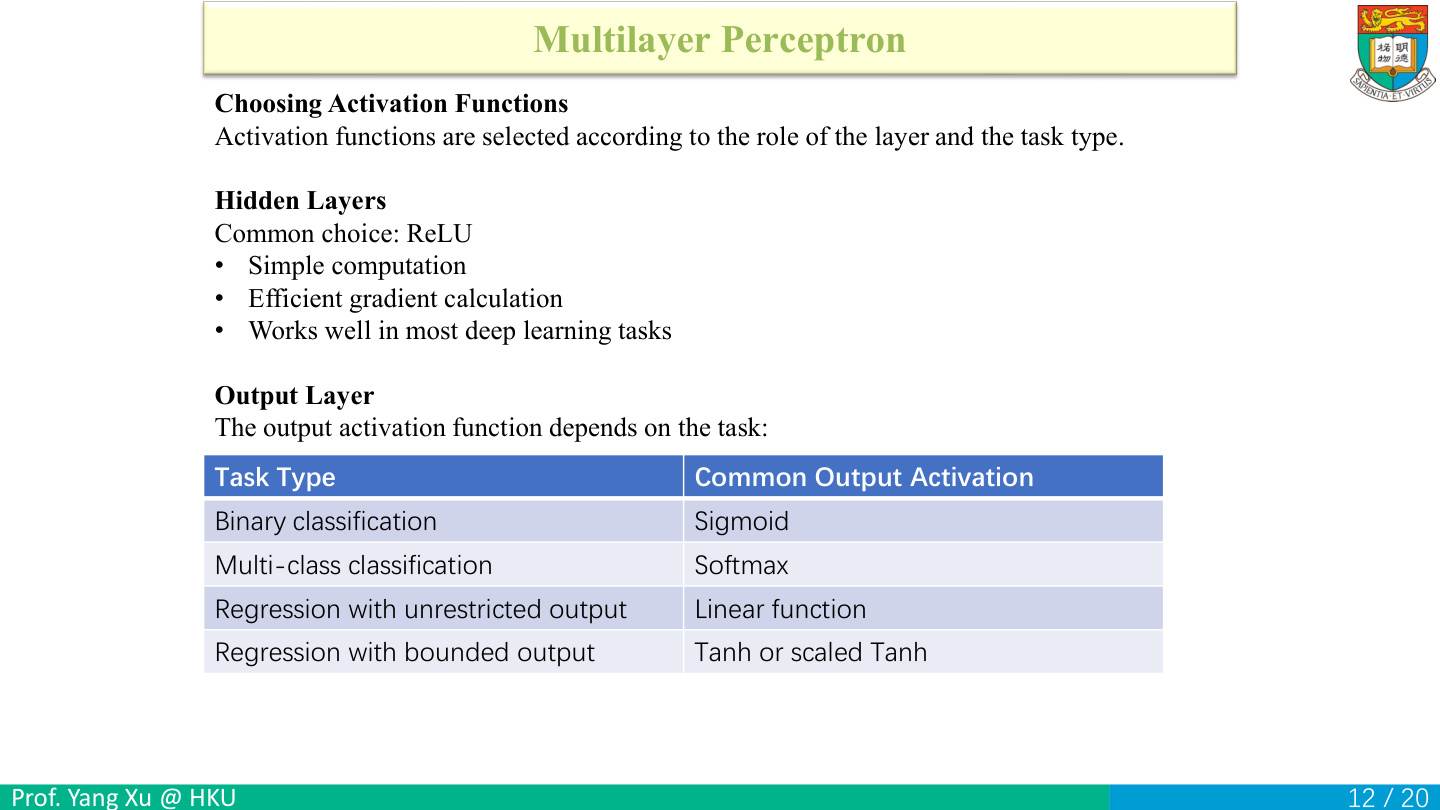
隐藏层构造有用表示,常用ReLU;输出层要匹配目标含义,按标签的类型选择激活。
二分类: 一个分数z经Sigmoid变成p,预测正类概率p、负类概率1−p,再选阈值作类别判断。互斥多分类: K个分数zₖ经 pₖ=e^(zₖ)/Σⱼe^(zⱼ)(Softmax)得到和为1的概率。例如分数(1001,1000),可先减最大值1001,换成(0,−1)。分子分母同时乘e^(−1001),所以比值不变。现在指数为1和0.3679,除以两者之和1.3679,得到概率约(0.7311,0.2689),避免直接算很大的指数。
不限范围的回归: 线性输出φ(z)=z,允许负数或很大的值。有界回归: 若目标必须在[a,b]内,可用 a+(b−a)(tanh(z)+1)/2。先将tanh的−1到1平移缩放到0到1,再映射到[a,b];例如[a,b]=[0,100]、z=0,则输出50。有限z严格落在区间内部,靠近上下端点时,tanh会逐渐饱和。
选激活还要配合损失:Sigmoid常配二元交叉熵,Softmax常配多类交叉熵,实数回归常配平方误差。若损失函数接收原始分数logits,它内部已包含相应激活计算,直接传入logits即可。
自测: 预测温差,可能为−5°C,最后一层用ReLU有什么问题?答案:它永远不能输出负数,模型被人为限制了。
万能逼近定理:网络能表达什么
“连续函数”指输入变化足够小时,输出变化也能足够小;“紧致域”在这里可先理解为有界且包含边界的输入范围,例如温度[0,100]与压力[0,10]组成的闭矩形。“逼近”指在指定误差容许范围内接近目标函数。
在适当激活函数等条件下,足够大的MLP能逼近紧致域上的连续函数。这说明网络具有这样的表达能力:存在一组参数,使它在给定范围内达到指定的逼近精度。找到这组参数,则是训练优化要解决的问题。
以 y=x² 为例,先在[−1,1]上用折线连接(−1,1)、(0,0)、(1,1),它就是 ReLU(−x)+ReLU(x)。当x=0.5时折线预测0.5,实际值0.25,误差0.25。把(0.5,0.25)也变成折点,这一点的误差就降到0。再看x=0.25,新线段预测0.125,实际值0.0625,误差是0.0625。加密折点让折线逐渐贴近曲线。
必须区分三件事:网络有没有能力表示(表达误差)、训练能否找到好参数(优化误差)、有限样本上学到的规律能否用于新样本(泛化误差)。三者分别涉及结构选择、训练算法和学习到的规律。
自测: “存在一组参数能逼近目标”属于表达问题还是优化问题?答案:表达问题;怎样通过训练找到好参数才属于优化问题。
非线性特征映射:圆形边界与XOR
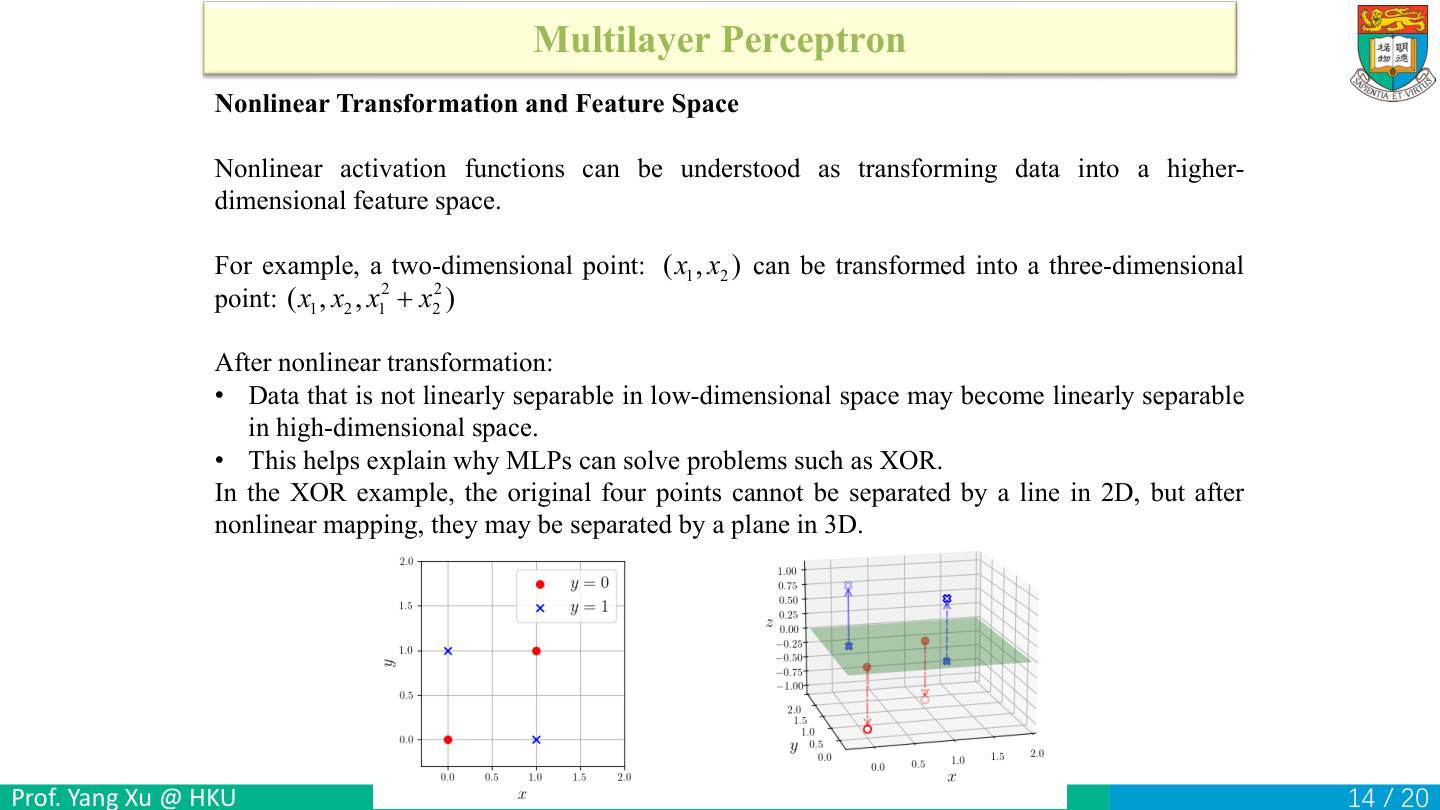
考虑映射 (x₁,x₂)→(x₁,x₂,x₁²+x₂²)。新增的第三个坐标记录到原点的平方距离。对于“圆内一类、圆外一类”的数据,第三坐标很有用:圆的条件 x₁²+x₂²≤r² 在新空间变成平面 z≤r²。原空间里的曲线边界可以对应新空间的线性边界。
这个平方距离特征适合圆形边界,但对标准XOR要换一种映射。对x₁,x₂∈{0,1},恒有 x₁²=x₁、x₂²=x₂,所以新增坐标就是x₁+x₂,没有增加可用于线性分离的新信息。新空间任意线性分数 a x₁+b x₂+c(x₁+x₂)+d 仍等于 (a+c)x₁+(b+c)x₂+d,仍是一条原空间的线性分界,无法解决XOR。
对XOR,增加乘积特征 x₁x₂,再令 g=x₁+x₂−2x₁x₂−0.5。对(0,0)得−0.5;对(0,1)、(1,0)得0.5;对(1,1)得−0.5,按g≥0判为1,四点全对。在新特征(x₁,x₂,x₁x₂)里,g是线性分数,已经能分开XOR。
神经网络也能把表示降维;维数升降与表示是否适合任务,是两个不同问题。
自测: 添加任意一个特征就一定能解决不可分问题吗?答案:不能,新增特征必须提供对当前任务有用的非线性信息。
反向传播从链式法则开始
动手试试 · 逐步走完前向与反向传播
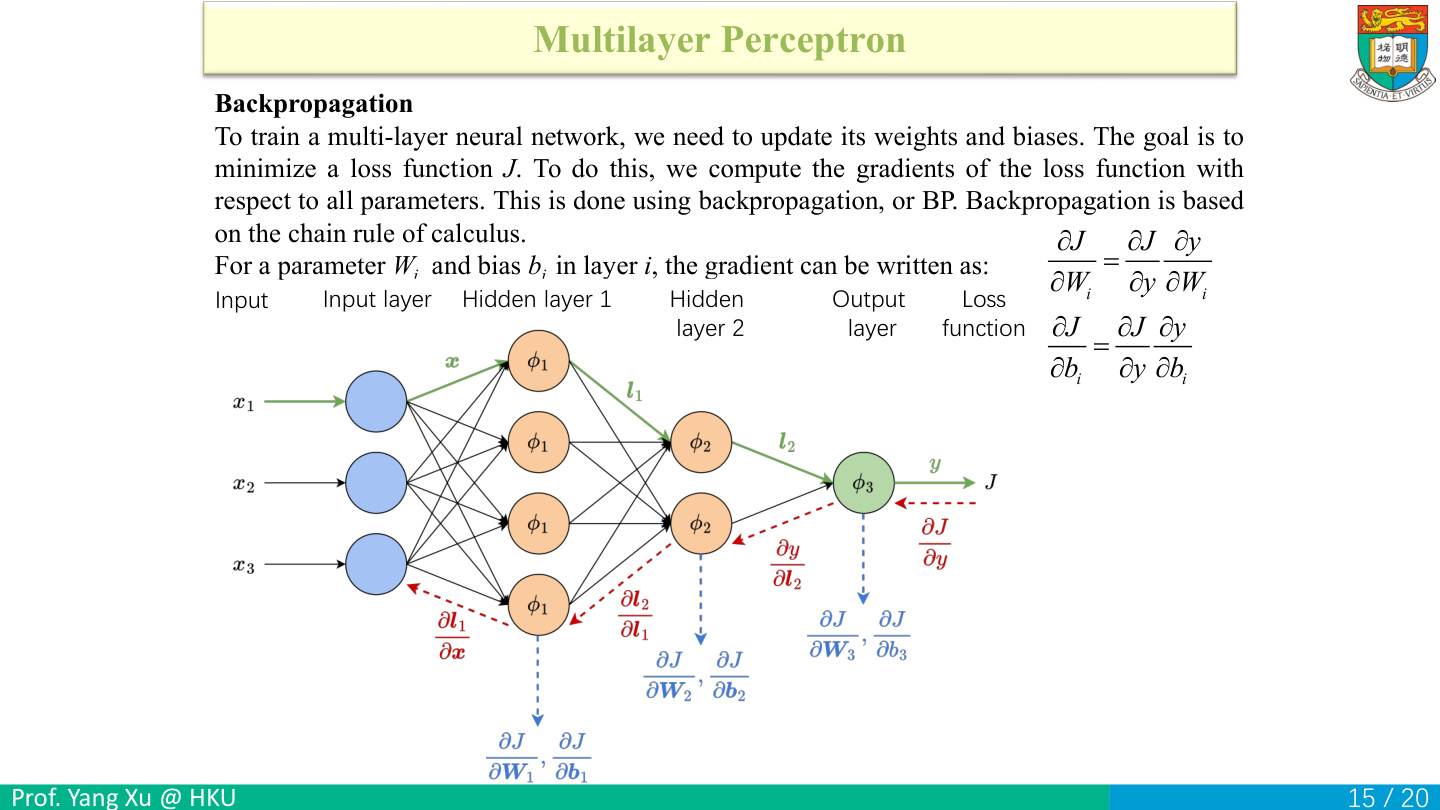
训练要让损失J变小,就要知道某个参数增加一点会让J如何变化,即求偏导数。反向传播(Backpropagation,BP)以链式法则把总变化拆成沿计算路径的局部变化。标量例 J=(ŷ−y)²/2、ŷ=wh 中,有 ∂J/∂ŷ=ŷ−y、∂ŷ/∂w=h,相乘得 ∂J/∂w=(ŷ−y)h。
完整算一遍:输入x=2,模型 h=w₁x、ŷ=w₂h,真实y=1,取w₁=1、w₂=3。前向:h=2、ŷ=6、J=(6−1)²/2=12.5。反向:输出误差导数5;对w₂的梯度是 5×h=10;对h的梯度是 5×w₂=15;对w₁的梯度是 15×x=30。每个乘号都来自一段依赖关系。
沿路径 w₁ → h → ŷ → J,每段局部变化是 ∂h/∂w₁=x=2、∂ŷ/∂h=w₂=3、∂J/∂ŷ=ŷ−y=5。三段相乘正是 ∂J/∂w₁=5×3×2=30。用很小的改动核对,令w₁从1增至1.001,预测从6增至6.006,损失从12.5增至12.530018,差约等于 梯度30×改动0.001=0.03。
自测: BP本身是不是“把权重减小一点”?答案:不是,BP负责算梯度;随后由梯度下降等优化方法决定如何更新。
每层反传:先算误差信号,再算权重梯度
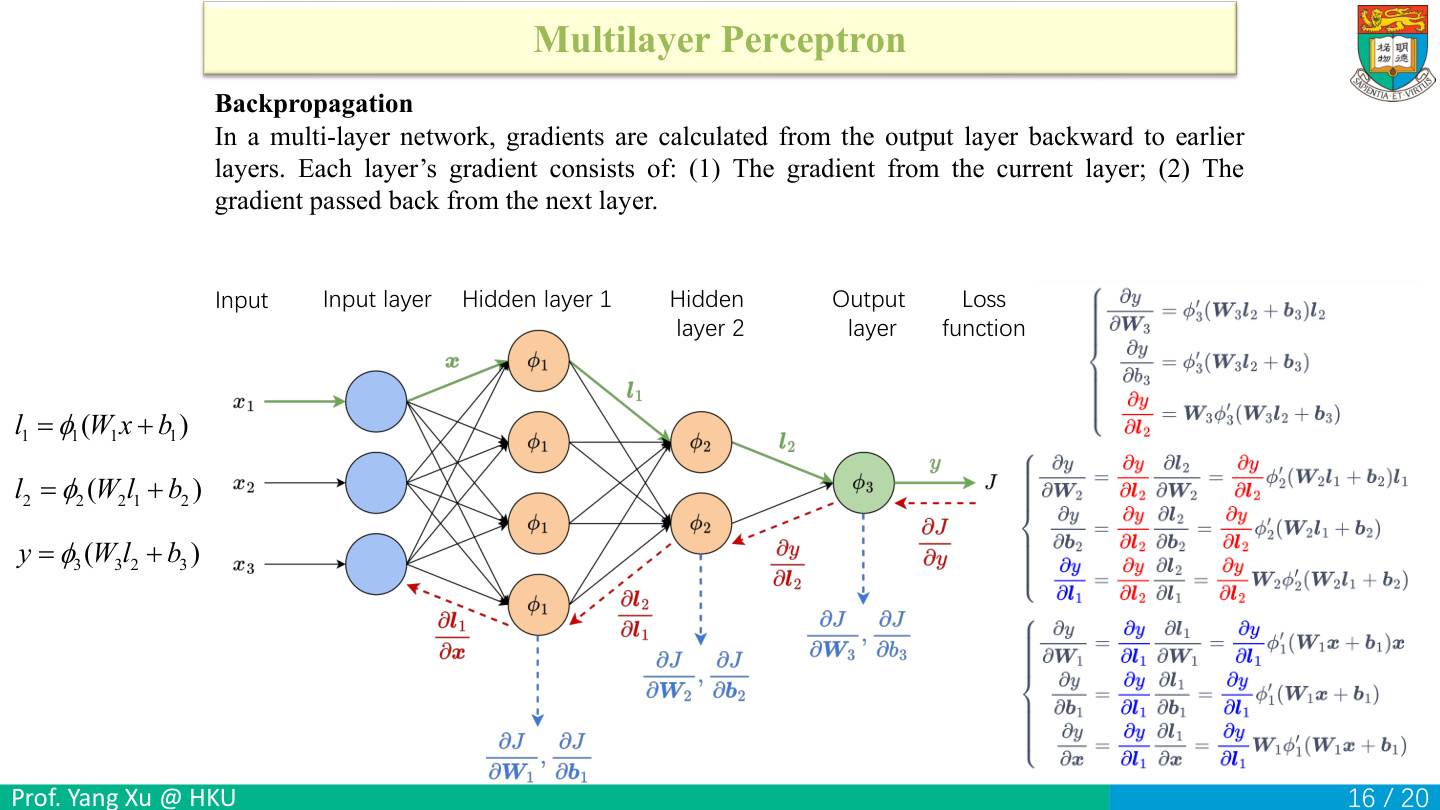
先给各中间结果命名: a₁=W₁x+b₁,l₁=φ₁(a₁),a₂=W₂l₁+b₂,l₂=φ₂(a₂),a₃=W₃l₂+b₃,ŷ=φ₃(a₃)。a是激活前值,l是激活后值。令 δ₃=∂J/∂a₃=(∂J/∂ŷ)⊙φ₃′(a₃),符号⊙表示对应位置逐元素相乘。
先看一个隐藏节点。由于输出激活前值为 a₃=W₃[1,1]l₂[1]+W₃[1,2]l₂[2]+b₃,对第j个隐藏输出求导得到 ∂a₃/∂l₂[j]=W₃[1,j]。再乘 δ₃=∂J/∂a₃,就得到 ∂J/∂l₂[j]=W₃[1,j]δ₃。两节点放在一起,正是 W₃ᵀδ₃。还要经l₂的激活继续退一步,乘 φ₂′(a₂)。
因此 δ₂=(W₃ᵀδ₃)⊙φ₂′(a₂),同理 δ₁=(W₂ᵀδ₂)⊙φ₁′(a₁)。如果下一层有多个节点,矩阵乘法会把每个后续节点传给同一个节点的贡献相加。
对于单条输入,看第二层第j个节点 a₂[j]=ΣₖW₂[j,k]l₁[k]+b₂[j]。它对某个权重 W₂[j,k] 的导数就是 l₁[k],因此该权重的梯度为 δ₂[j]×l₁[k]。它对偏置 b₂[j] 的导数为1,因此偏置梯度为δ₂[j]。把每个连接的结果排回矩阵,权重梯度是外积:∂J/∂W₃=δ₃l₂ᵀ、∂J/∂W₂=δ₂l₁ᵀ、∂J/∂W₁=δ₁xᵀ;偏置梯度就是δ。以第二层为例,δ₂是2×1、l₁ᵀ是1×4,得到2×4,恰好与W₂同形状。
例如,若δ₂=(2,−1)、l₁=(1,3,0,2),则W₂梯度的两行分别为(2,6,0,4)、(−1,−3,0,−2)。每个权重都用“本节点误差信号×它收到的那个输入”。
输入梯度同样可以求出:∂J/∂x=W₁ᵀδ₁,形状为 (3×4)(4×1)=3×1。它表示损失对三个输入分量的敏感度。普通监督训练用这些梯度更新权重和偏置,输入x保持给定值。若求的是输出ŷ对x的导数,就从输出端设 ∂ŷ/∂ŷ=1,再沿同样路径向回传播。
自测: 为什么不是δ₂和l₁逐元素相乘?答案:它们长度不同,全连接层需要为每条连接产生梯度,必须形成外积。
前向保存结果,反向复用结果
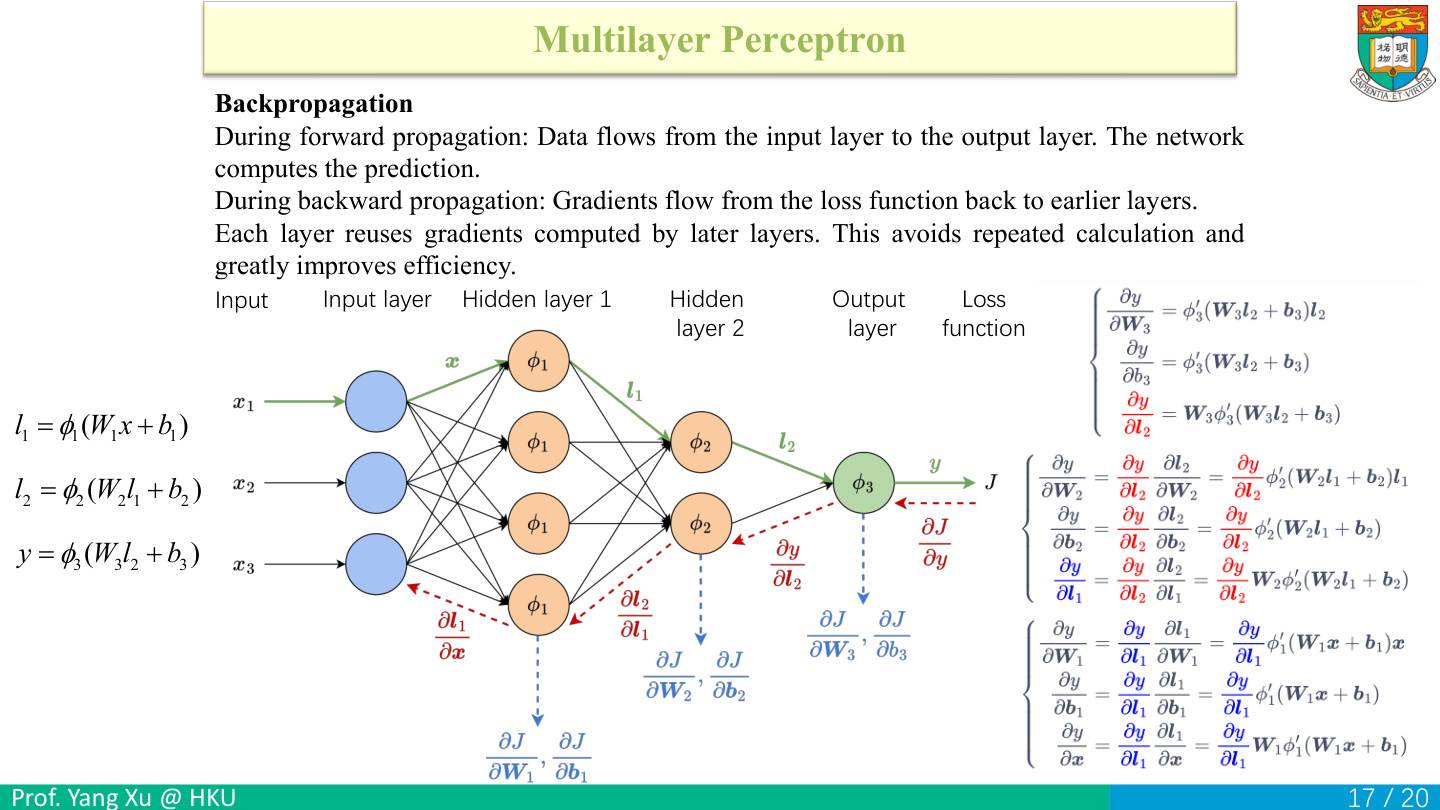
反向传播复用中间结果:前向计算每层a与l,得到预测和损失;反向从损失开始,复用下一层已经算出的梯度,逐层往回传。这样,多条连接可以共享已经算出的下游梯度。一个中间节点若连向多个后续节点,要把来自所有路径的梯度贡献相加。
例如,一个隐藏值h被两个输出使用:o₁=2h、o₂=3h,损失 J=o₁+o₂。通过第一路传回的梯度是2,第二路是3,所以 ∂J/∂h=2+3=5。若只沿一根线往回走就会漏掉另一条路径。更复杂的计算图也是先累加所有后续贡献,再继续向前面的节点传播。
为什么要保存前向的值?Sigmoid导数可用已经算出的σ(a)得到;权重梯度需要本层输入;ReLU导数需要知道前向时a是否为正。如果训练时把这些信息全部丢掉,就可能需要重新计算。
运行一次前向与反向。 沿用第8页的网络,隐藏层用ReLU,令真实值为4。输出为7,损失导数是7−4=3。
import numpy as np

x = np.array([1., 2.])
W1 = np.array([[1., 1.], [-1., 1.]])
b1 = np.array([0., -2.])
W2 = np.array([2., -1.])
b2 = 1.
target = 4.

a1 = W1 @ x + b1
h = np.maximum(a1, 0)
prediction = W2 @ h + b2
loss = 0.5 * (prediction - target) ** 2

delta2 = prediction - target
grad_W2 = delta2 * h
grad_b2 = delta2
delta1 = np.where(a1 > 0, W2 * delta2, 0.0)
grad_W1 = np.outer(delta1, x)
grad_b1 = delta1
print(prediction, loss)  # 7.0 4.5
print(grad_W2)           # [9. 0.]
print(grad_W1)           # [[ 6. 12.]
                         #  [ 0.  0.]]
这里输出只有一个数,W2用一维向量保存。输出的导数3沿两根连线各乘权重2、−1,传回[6,−3]。前向的a1=[3,−1],a1 > 0 得到[真, 假],np.where 在真的位置保留传回的梯度,在假的位置填0,所以 delta1 是[6,0]。np.outer(delta1, x) 分别以6、0乘输入[1,2],给两条权重行各算两个梯度。等四组梯度都算好,再一起更新旧参数。
自测: h分别经过两条路径影响J,两路传回梯度2和3,h的总梯度多少?答案:5,把所有路径的贡献相加。
梯度下降:把算好的梯度变成参数改变
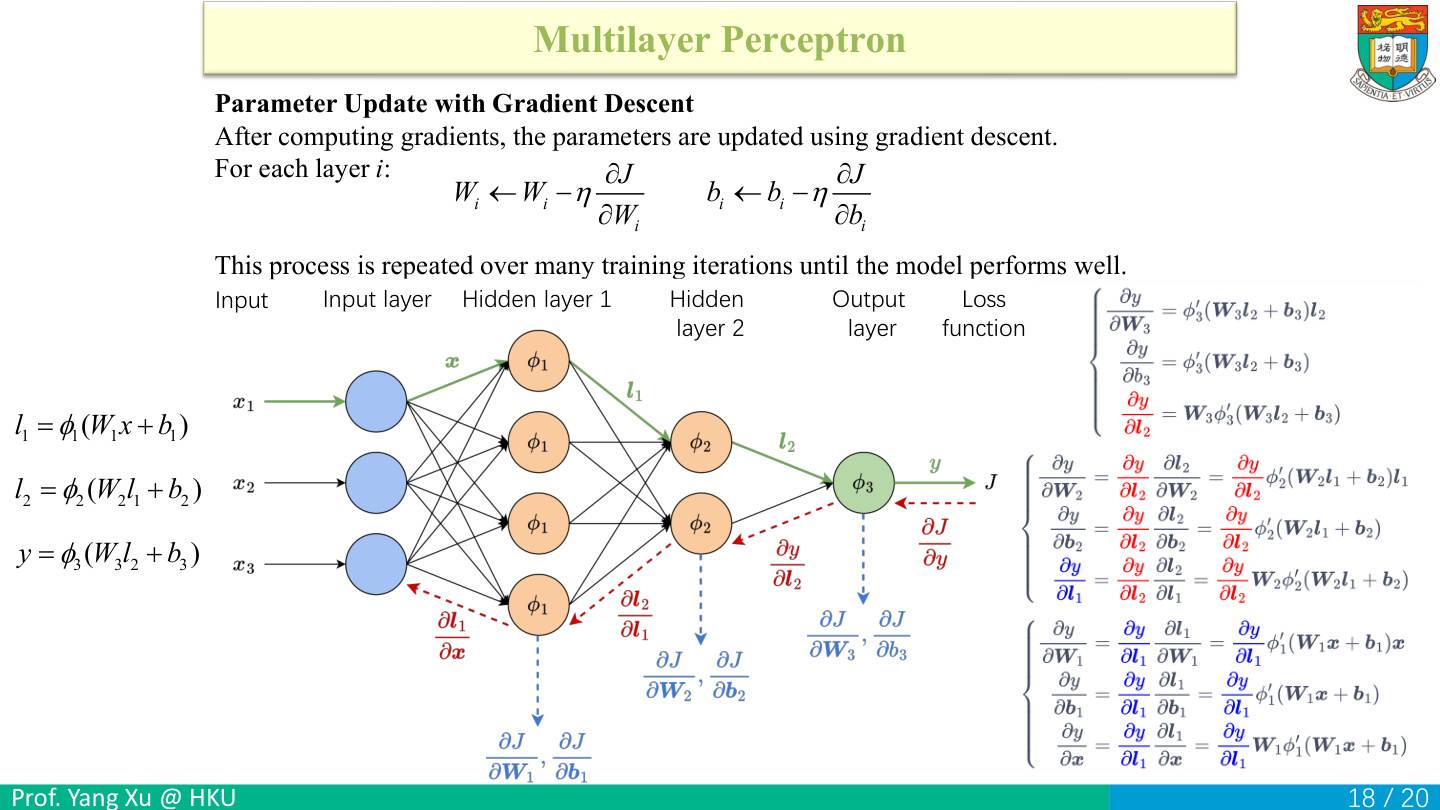
更新式 Wᵢ←Wᵢ−η∂J/∂Wᵢ、bᵢ←bᵢ−η∂J/∂bᵢ 表示沿损失局部上升方向的反方向走一小步。梯度为正时参数减小,梯度为负时参数增大。以单参数θ为例,局部近似 ΔJ≈(∂J/∂θ)Δθ。代入 Δθ=−η∂J/∂θ 得 ΔJ≈−η(∂J/∂θ)²≤0,这给出了小步更新能降低损失的理由。
算一遍:一层模型ŷ=wx+b,x=2,真实y=3,旧w=1、b=0,损失J=(ŷ−y)²/2。前向ŷ=2,误差−1,J=0.5。梯度 ∂J/∂w=(−1)×2=−2,∂J/∂b=−1。取η=0.1,同时更新w=1.2、b=0.1。新预测 1.2×2+0.1=2.5,新损失 (2.5−3)²/2=0.125,本次确实下降。
若η太大,例如η=1,得到w=3、b=1,新预测7,损失8,反而变坏。因此“沿负梯度走”只给局部下降方向,步子过大仍可越过好位置。对一批样本,若损失按平均计算,梯度也应按批大小平均,这样梯度尺度与平均损失的定义一致。
iteration是一次参数更新,epoch是完整遍历训练数据一遍;它们通常不同。例如6000条样本、每批100条,一轮epoch包含60次iteration。
自测: 梯度为−4、学习率0.05、旧参数2,新参数多少?答案:2−0.05×(−4)=2.2。
目录回看:把网络原理接到MNIST作业
以784→128→10的MLP为例,MNIST图像的28×28像素展平成784个输入数,经过128个隐藏节点,输出数字0到9的10个分数。训练时,例如图像标为7,交叉熵取模型给数字7的概率p₇,损失是 −ln(p₇)。反向传播由这个损失算梯度,再更新参数。预测时只做前向计算,取最大分数所在的数字。
休息页:用一条完整计算链自查
休息15分钟。