左右键翻页;“连续阅读”展开整份;搜索可定位概念。
这份 Lab 教什么,以及如何开始
实验主线从 average.py 的三个数组运算开始,再把同样的数组操作用到 28×28 的手写数字。最后通过 load_model 恢复训练好的模型,用 predict 对文件夹里的图片逐张预测,输出 CSV。
第一部分:先让代码有地方运行
先安装Anaconda,创建并激活lab1环境,再安装NumPy;然后在VS Code选择lab1解释器,保存并运行Python文件。编辑器负责写代码,环境负责提供执行代码的Python和工具包。
Anaconda、conda、Python、VS Code 分别负责什么
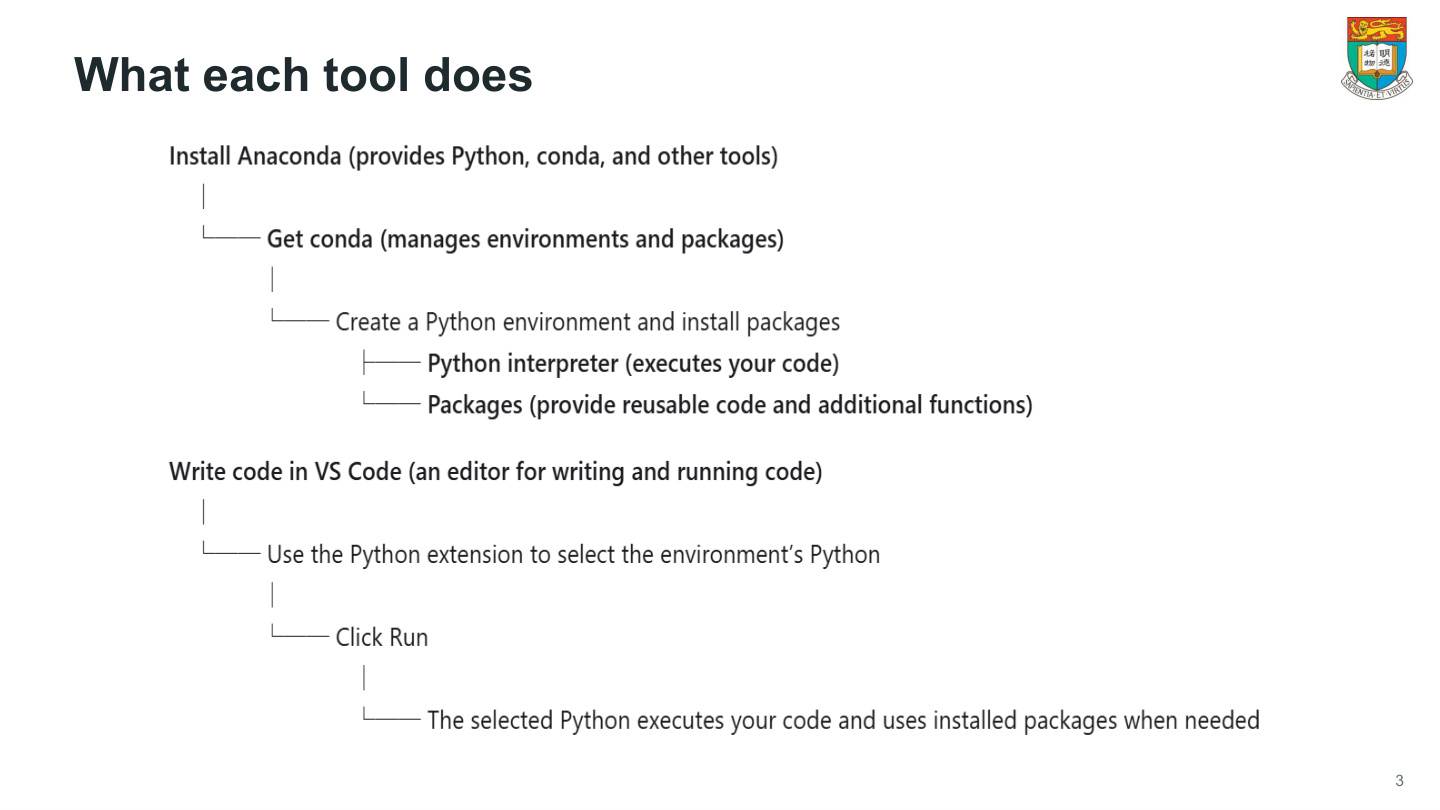
沿图从上向下读:安装 Anaconda 后,得到 Python、conda 和若干工具。conda 管理环境与软件包;环境里包含某个 Python 解释器,以及装在那里的 NumPy 等包。下半图表示:你在 VS Code 中写代码,Python 扩展让你选择解释器,点击运行后真正执行代码的是选中的 Python。
几种工具的分工是:Anaconda 是发行版;conda 是管理工具;Python 是语言及其运行程序;VS Code 是编辑器;扩展负责连接编辑与运行;NumPy 为 Python 增加数组计算功能。
例如同一台电脑有 base 和 lab1 两个环境。你把 NumPy 安装在 lab1,却让编辑器使用 base,那么 lab1 中的包不会自动借给 base。
核查顺序是:当前文件在哪里→选了哪个解释器→该解释器里有没有依赖包→再看代码。
下载 Anaconda:下载文件还不等于安装完成
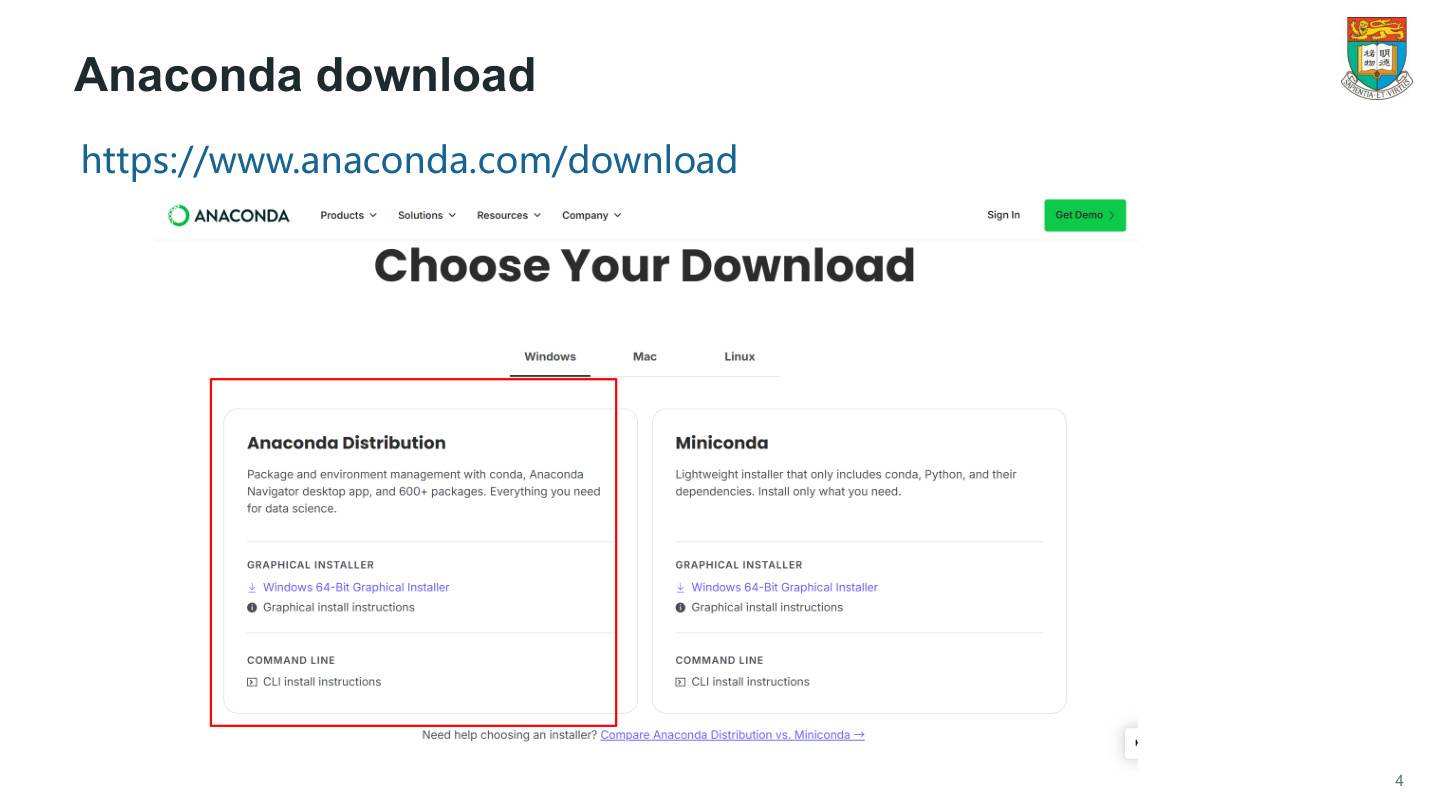
打开Anaconda下载页,选择适合电脑系统与处理器架构的安装器,保存到Downloads文件夹。
下载得到的.exe是安装程序。双击它并完成向导后,Anaconda才会安装到电脑上;接下来还要创建课程使用的lab1环境。
打开安装器:每个按钮把过程推进一步
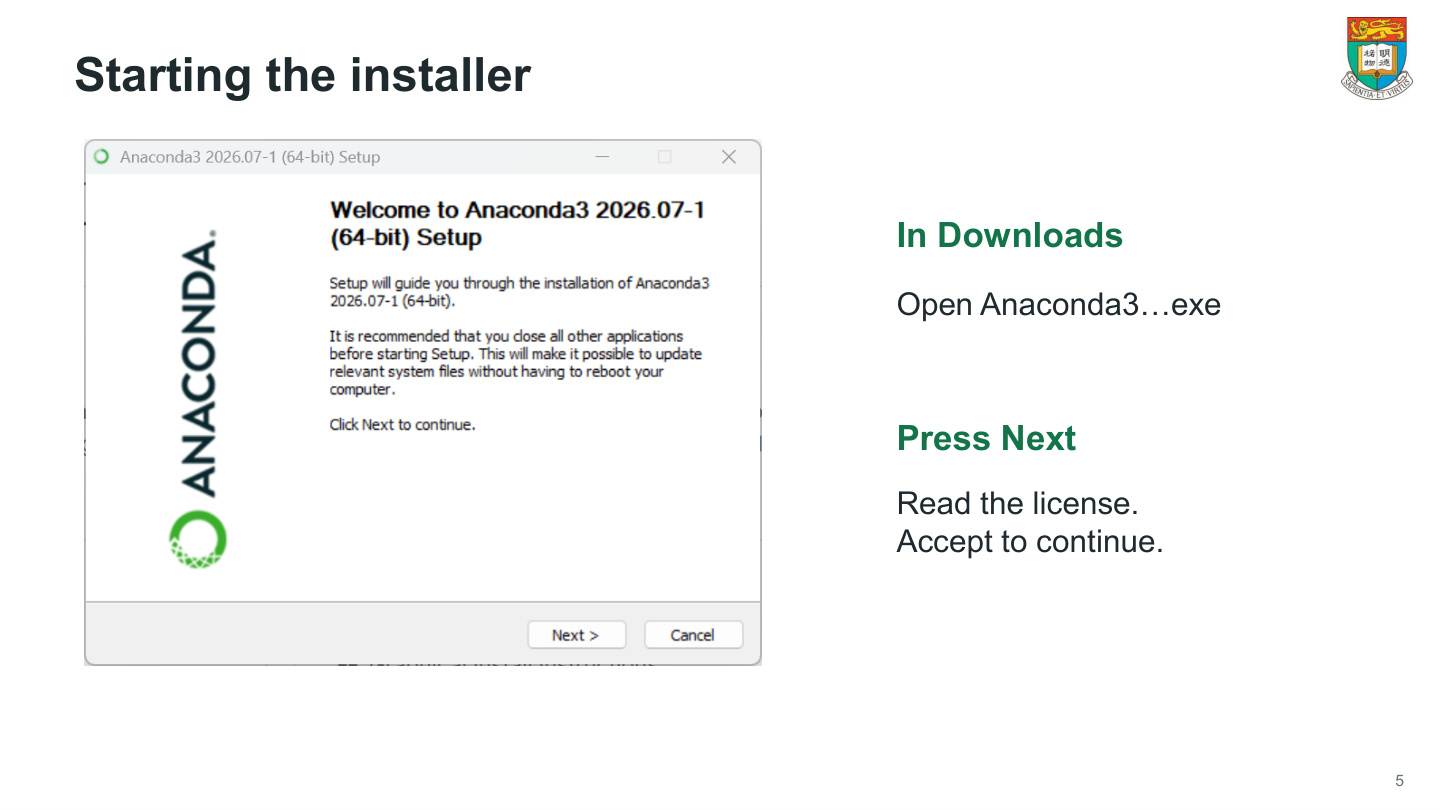
在Downloads中找到Anaconda3…exe并双击。点击Next进入下一屏,阅读并接受许可后继续,随后选择安装范围和路径。
Next是安装窗口里的按钮,直接用鼠标点击。.exe负责安装软件;以后保存为.py的文件才是交给Python执行的代码。
All Users:选择安装给哪些电脑账户使用
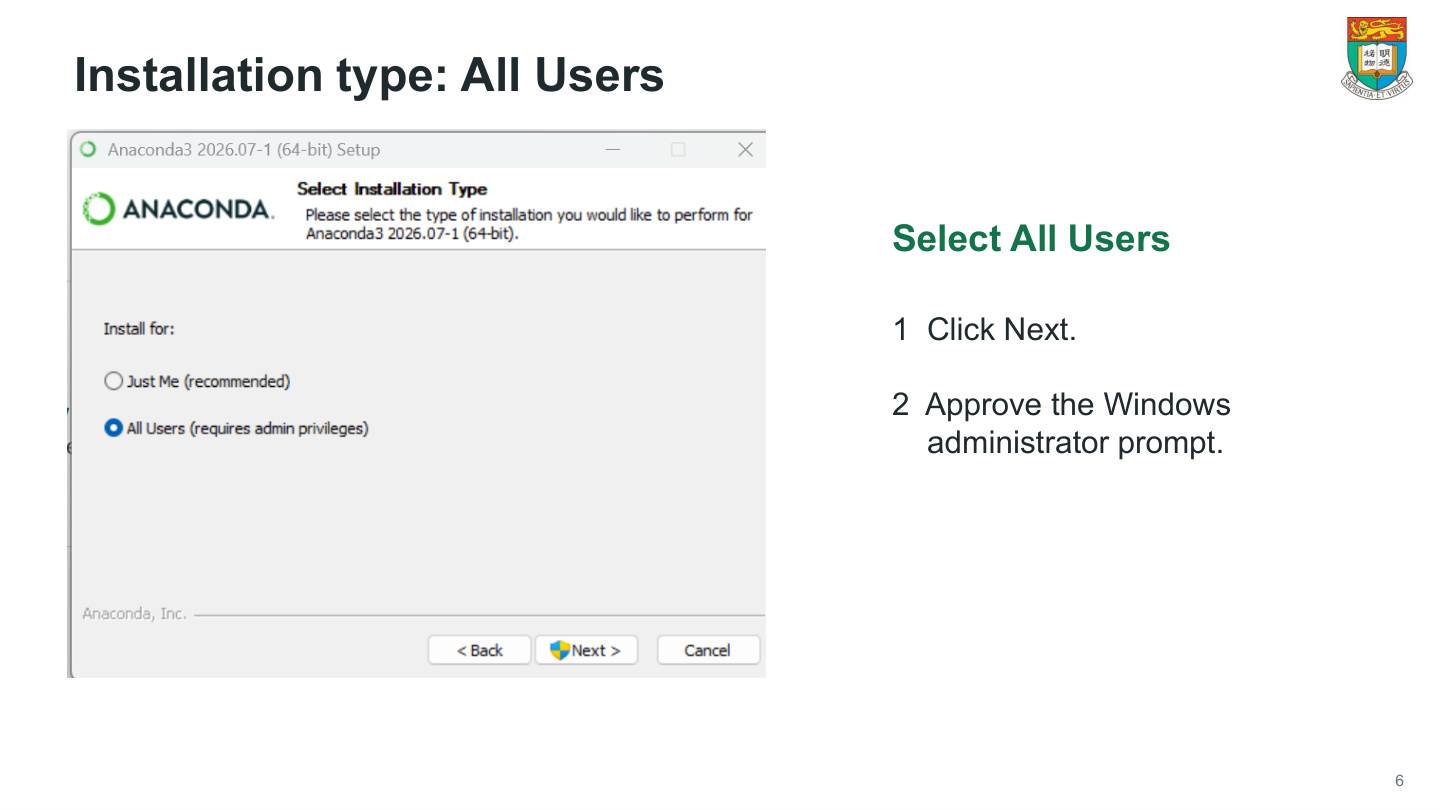
选择All Users,点击Next;出现Windows管理员提示时,按系统要求授权。这个选项表示安装供本机多个账户使用。
如果账户只有个人安装权限,可以采用个人用户安装。安装范围会影响默认路径,例如公共安装可能位于C:\ProgramData\anaconda3,个人安装可能位于用户目录。
记住实际安装位置,后面从这套Anaconda启动conda,创建并激活lab1。
安装位置和高级选项:知道程序到底装到哪里
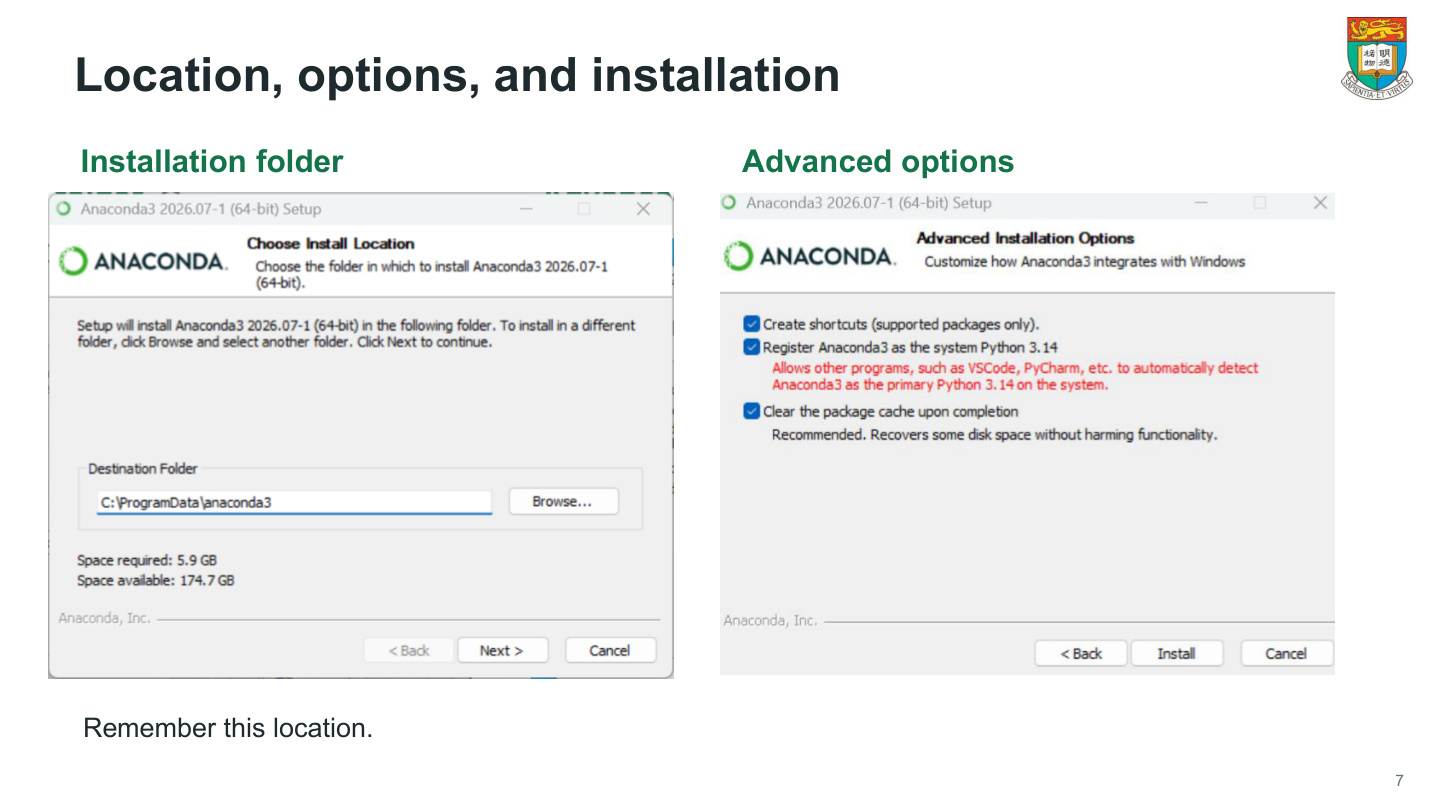
左图选择安装文件夹,右图设置快捷方式、系统Python注册和缓存等选项。记住实际安装路径,后面选择解释器时就能判断它属于哪套安装。
“注册为系统Python”可能影响其他程序默认找到的Python。先阅读选项含义,再决定是否勾选;完成安装后,打开Anaconda Prompt检查conda。
Anaconda自带的基础环境与课程的lab1环境可以使用不同Python版本:后面python=3.11会给lab1单独指定版本。
在 Anaconda Prompt 中检查 conda
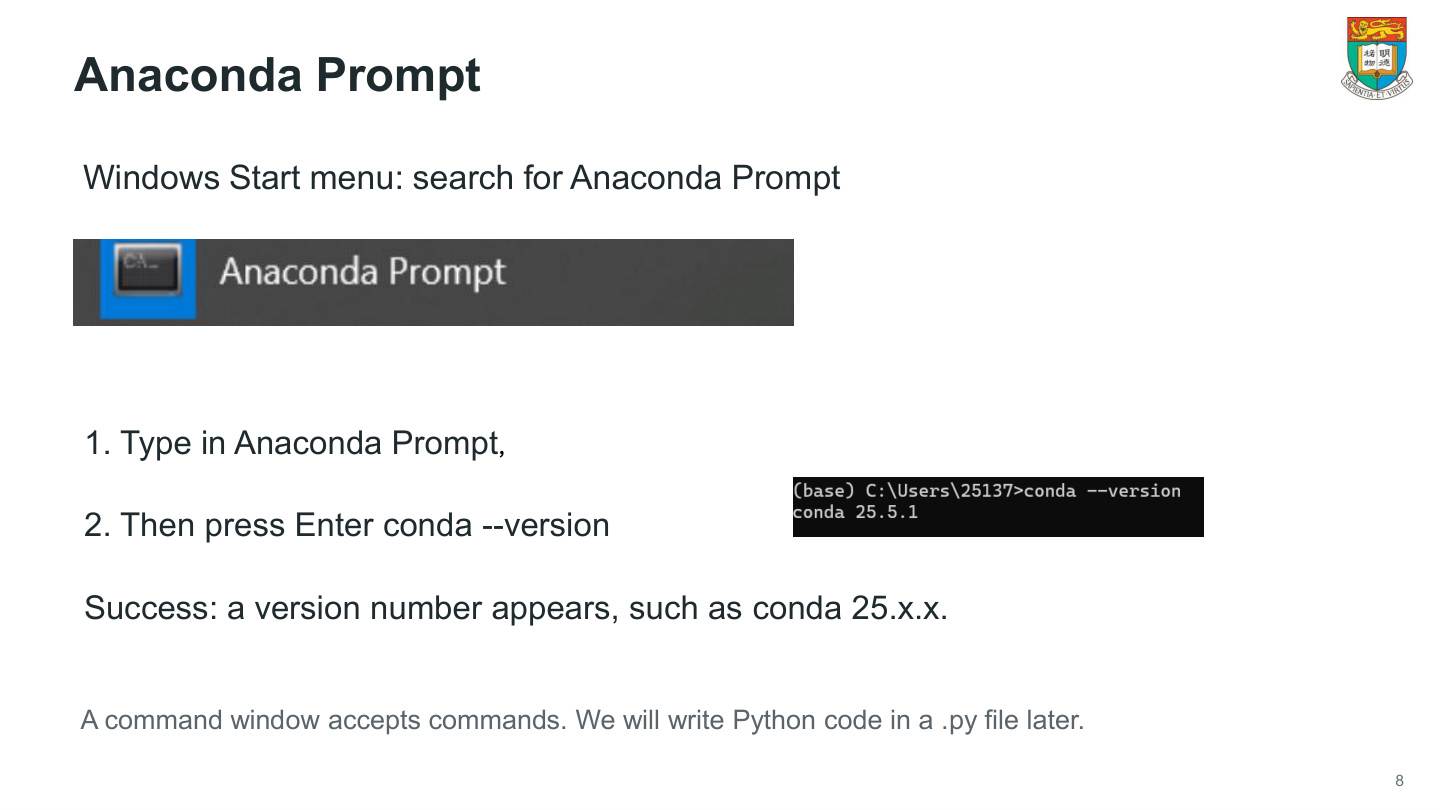
打开 Windows 开始菜单,搜索并启动 Anaconda Prompt。这是已经准备了 conda 相关环境设置的命令窗口,不是 Python 编辑文件。
在提示符后输入:
conda --version
conda 是程序名,空格把参数分开,--version 表示“显示版本”。按 Enter 后,应显示类似 conda 25.x.x 的版本文本。版本号是结果的一部分,不需要和截图完全相同。
这一命令只询问版本,不会创建环境、安装 NumPy,也不会执行你的 .py 文件。不要把它放在 average.py 里;否则 Python 会把不属于本语言的命令当成代码,出现语法错误。
若显示找不到 conda,先检查是否打开了正确的 Prompt,再检查安装是否完成、路径是否正确。成功的判断是有明确版本输出,不是终端窗口能够打开。
创建并激活 lab1:先造一套环境,再使用它
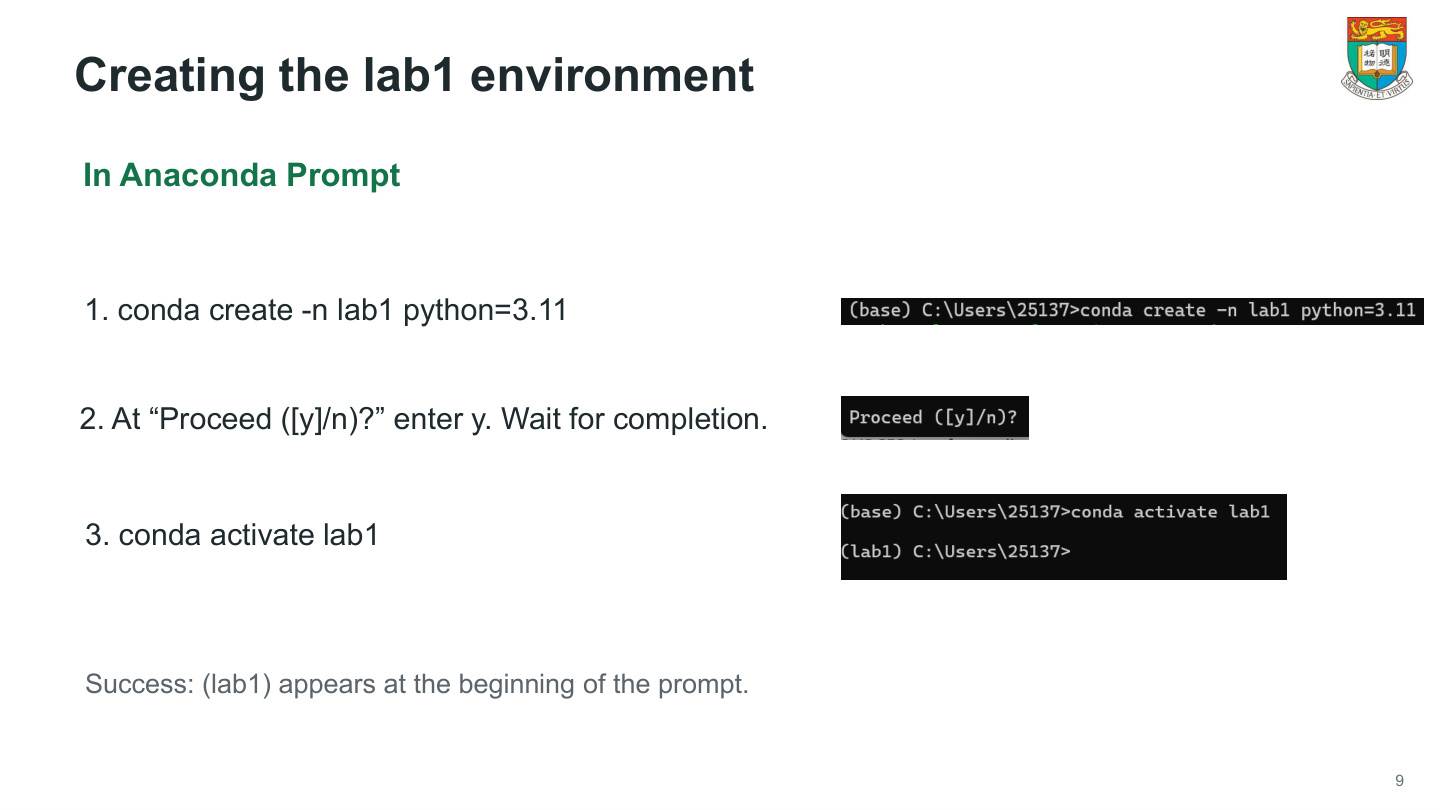
在Anaconda Prompt中依次输入:
conda create -n lab1 python=3.11
conda activate lab1
第一行中,create 是创建;-n lab1 指定环境名;python=3.11 要求在该环境安装 Python 3.11。执行过程中出现 Proceed ([y]/n)? 时,输入 y 并按 Enter,等待创建完成。第二行才把当前终端切到这套环境。
成功激活后,提示符通常出现 (lab1)。这只是当前终端的状态,不会把电脑所有应用都永久切到它。新开的编辑器仍可能选择其他解释器,所以后面还要在 VS Code 中选择一次。
环境不是你保存代码的 Lab1 文件夹。一个环境可以运行不同项目,一个项目也可以选择不同环境。若创建未完成就激活,会找不到环境;若环境已经存在,通常直接激活即可,不必重复创建。
把 NumPy 安装到正确环境:安装与导入是两回事
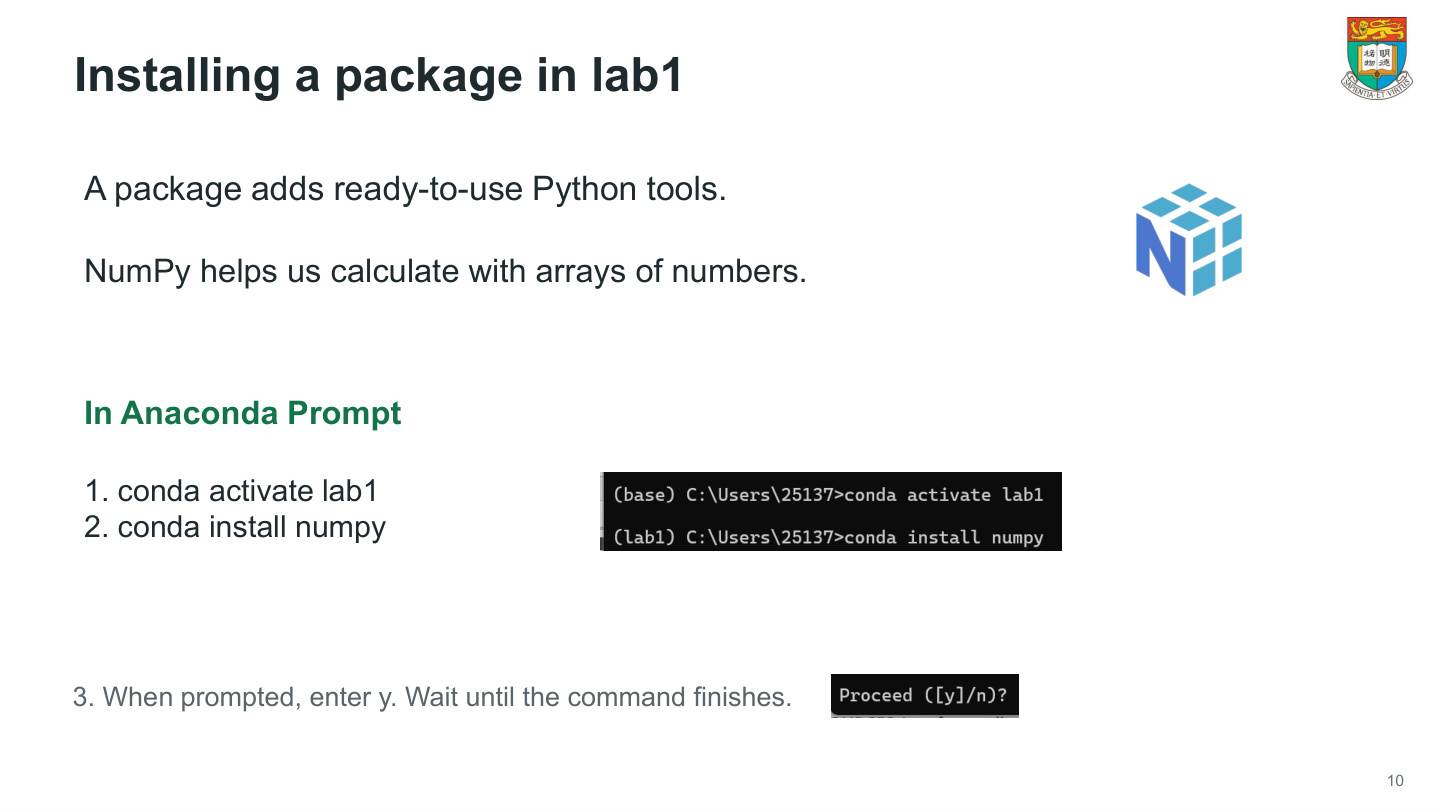
NumPy 是数值计算包,提供数组、求平均、矩阵运算等工具。在Anaconda Prompt依次输入:
conda activate lab1
conda install numpy
第一行选择工具将放入哪套环境;第二行下载、解算并安装依赖。出现确认时输入 y,等待命令结束再进行下一步。
conda install numpy 写在终端,import numpy as np 写在 Python 程序。安装只做一次或在更新时做,程序每次开始仍需导入。
若安装时终端是 (base),运行时却使用 lab1,就可能仍然报找不到包。判断应围绕“运行程序的解释器里是否装了 NumPy”,不能只凭“以前看过安装成功”断定没问题。
安装 VS Code:准备写代码的工作台
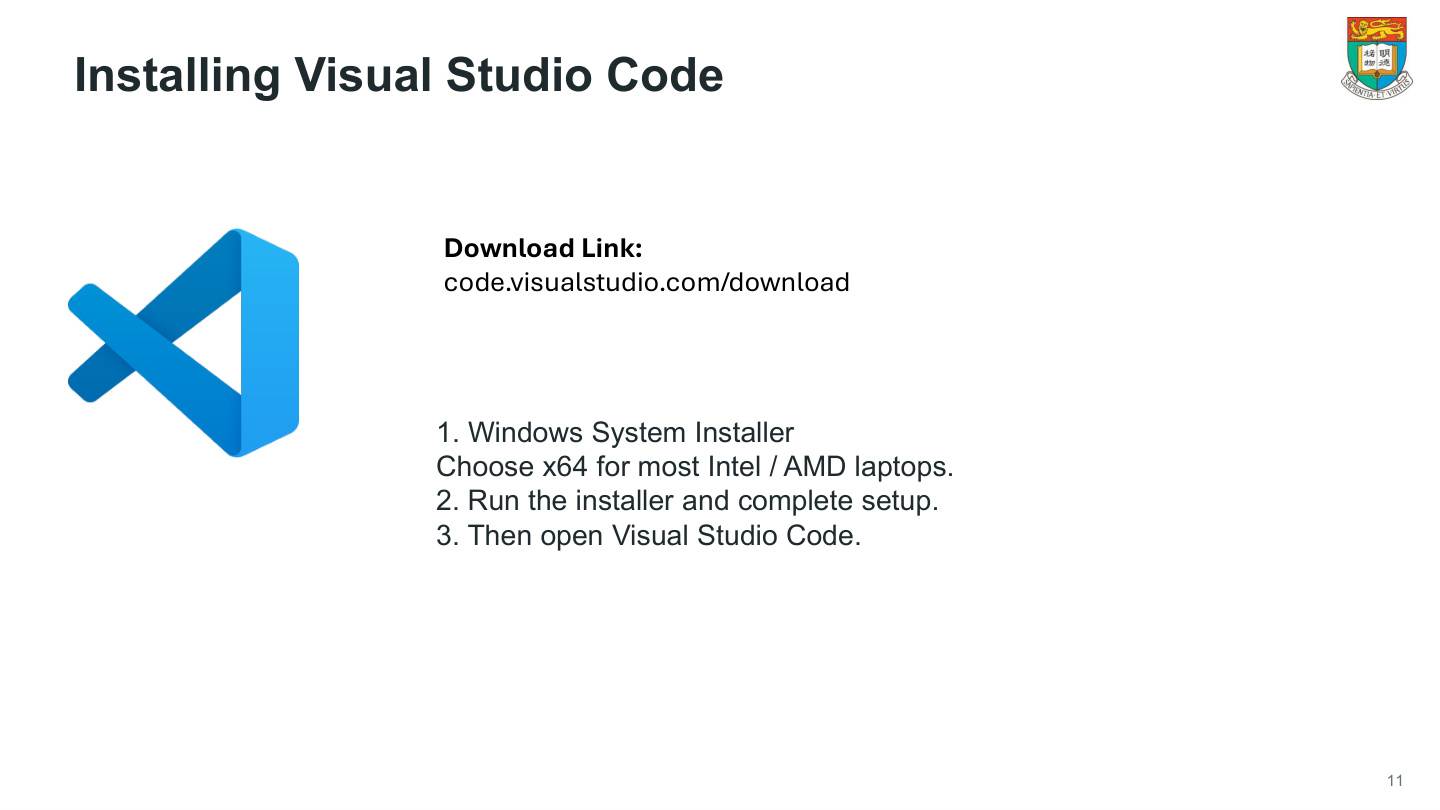
下载并运行VS Code的Windows安装器,普通Intel/AMD笔记本选择x64版本。完成安装后打开Visual Studio Code。
VS Code提供文件树、代码编辑区和终端;Python解释器负责执行代码。下一步安装Python扩展,再把VS Code连接到已经创建的lab1环境。
Microsoft Python 扩展:让编辑器找到解释器
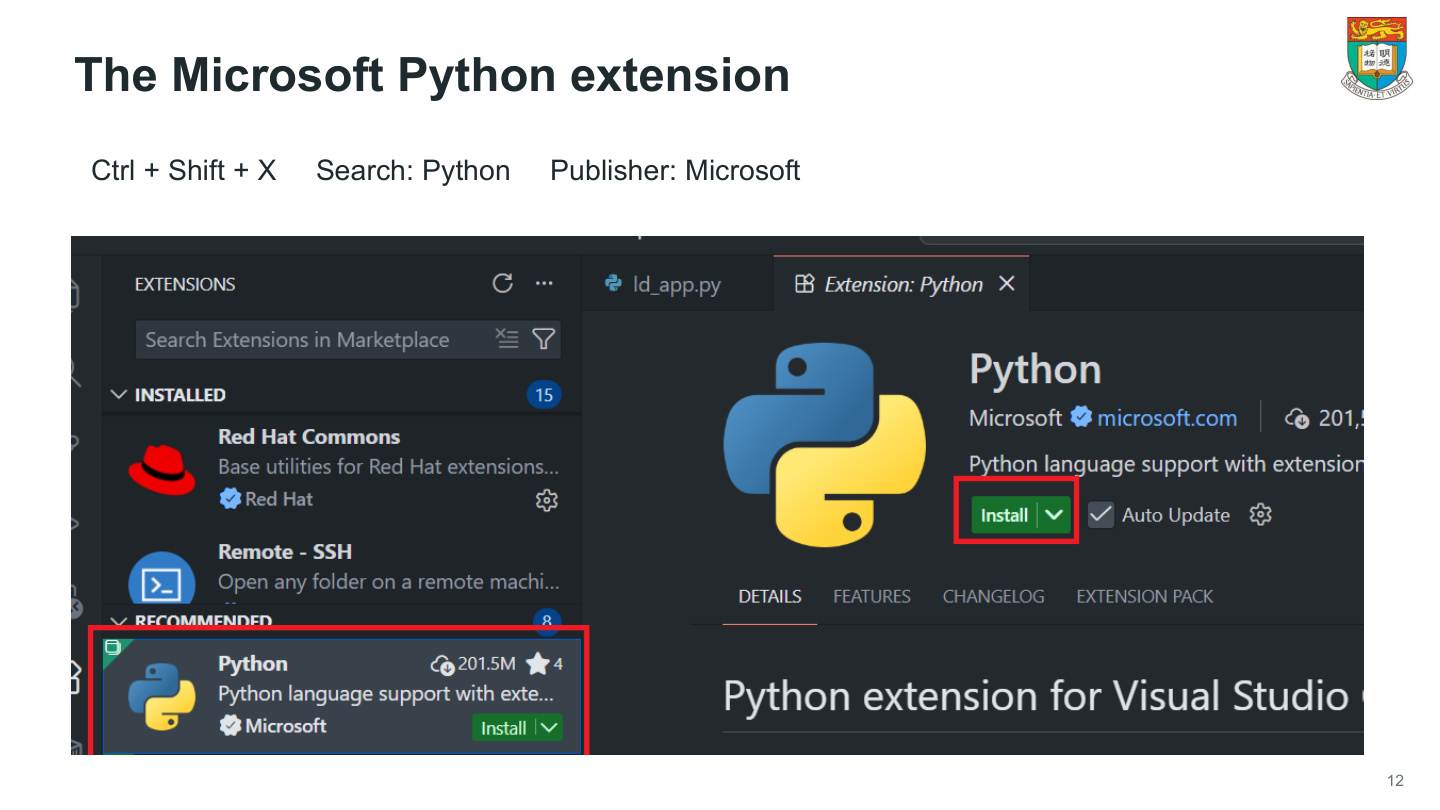
按 Ctrl + Shift + X,打开 VS Code 的扩展面板;搜索 Python,核对发布者为 Microsoft,然后安装对应扩展。
扩展为编辑器提供 Python 文件识别、解释器选择、运行与调试等连接能力。它不等于 Python 解释器,也不等于 NumPy,所以“扩展安装完成”不能替代“环境创建完成”和“NumPy 安装完成”。
接下来打开 Python 文件后,通过命令面板选择 lab1。如果编辑器仍找不到解释器,先确认环境真实存在、扩展已启用,再查看解释器路径。
建立项目文件夹并保存 average.py
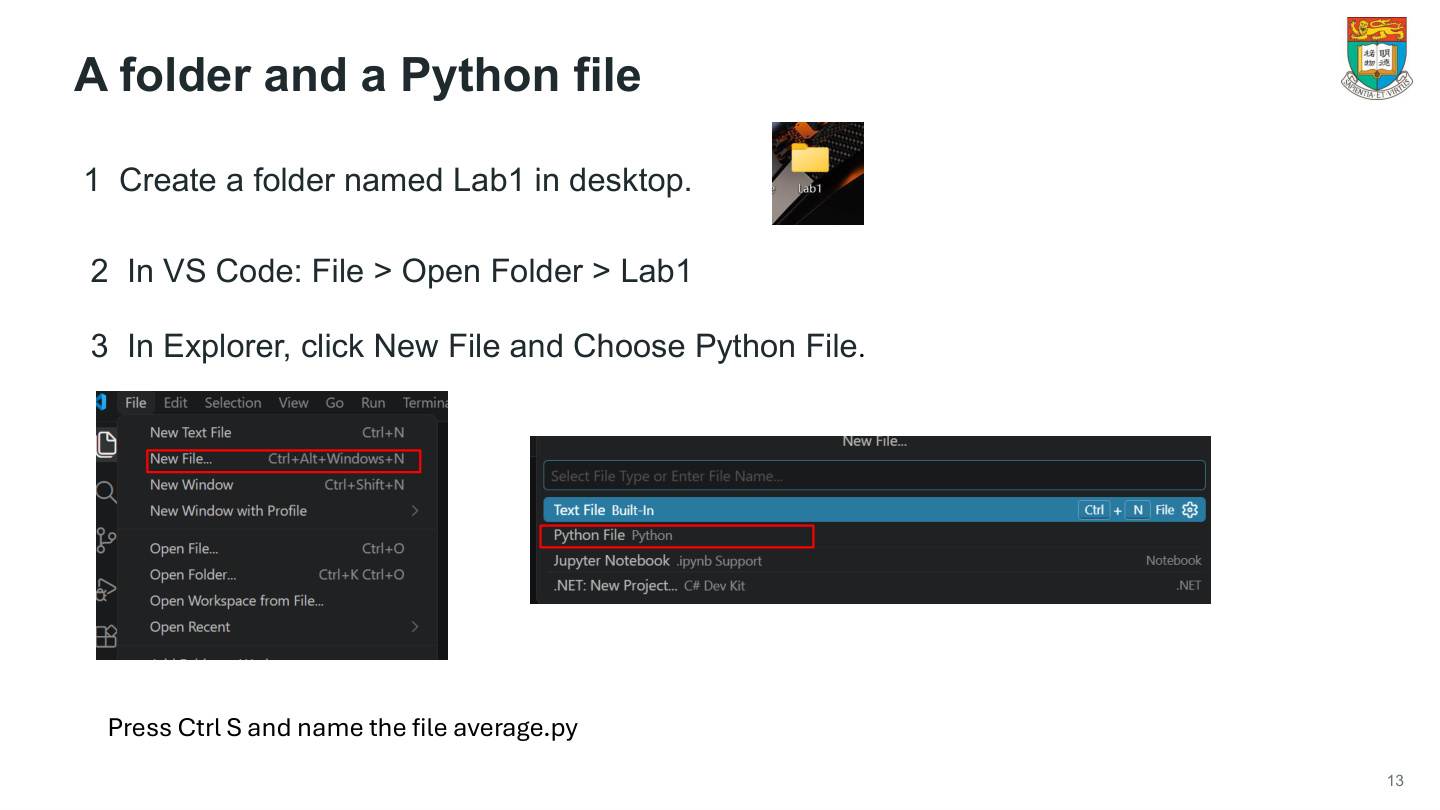
依次操作:在桌面创建 Lab1 文件夹;在 VS Code 选择 File > Open Folder 并打开它;在 Explorer 新建 Python 文件;按 Ctrl + S,保存为 average.py。
文件夹收纳项目,文件存放代码。average 是名字,.py 是扩展名,告诉工具按 Python 源文件处理。Windows 隐藏扩展名时尤其留意,不要实际保存成 average.py.txt。
为什么先打开文件夹?因为编辑器的文件树、终端工作位置和后面读取相对路径,都需要一个清楚的项目起点。把文件散放在 Downloads、桌面和其他目录,会让“程序在哪里”“数据在哪里”变得难查。
Lab1 文件夹和 lab1 环境名称相似,但一个存代码,一个存解释器与包。保存代码也不等于运行代码:保存把文字写进文件,运行才让 Python 执行。完成后应在文件树看见一个真实的 average.py,然后再选择它的解释器。
选择 lab1 解释器:决定由哪个 Python 执行
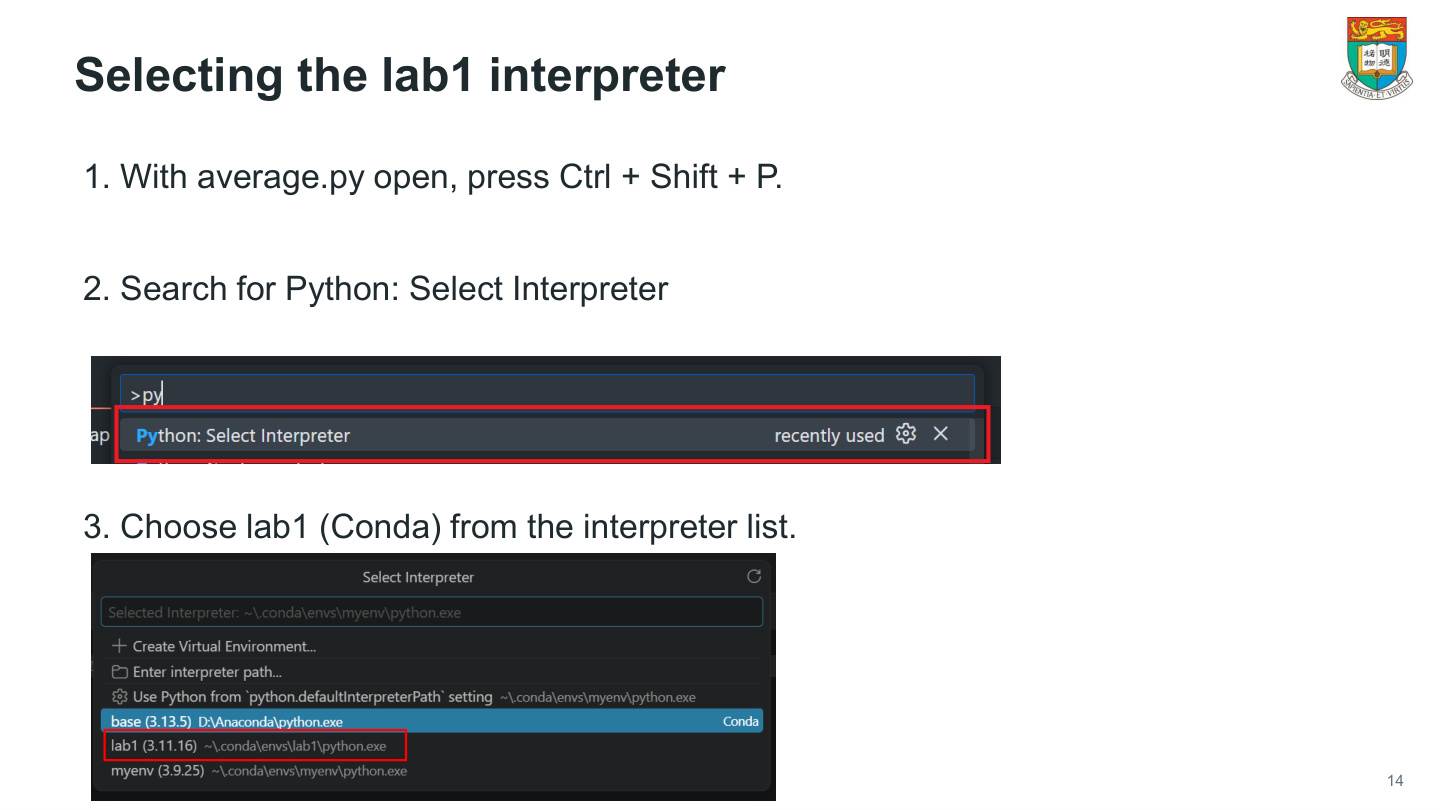
打开 average.py 后,按 Ctrl + Shift + P 打开命令面板,搜索 Python: Select Interpreter,选择列表中的 lab1 (Conda)。
解释器负责逐行执行代码,同时决定能导入哪些包。编辑器可以看到多个 Python,例如系统安装、Anaconda 的 base、课程 lab1。名字都叫 Python,不意味着它们共用所有包。
假设你在外部 Anaconda Prompt 激活 lab1 并安装 NumPy,但 VS Code 运行按钮仍指向另一套 Python,就可能出现 ModuleNotFoundError。所以要核对的是运行按钮实际调用的解释器,而非另一个窗口的提示符。
排查解释器时,运行 import sys 后 print(sys.executable) 查看当前解释器路径。输出的路径就是实际执行当前程序的Python。
完成标准:所选解释器确实属于 lab1,之后首个 NumPy 程序能由这套环境运行。
第一个 NumPy 程序:逐行算出三个输出
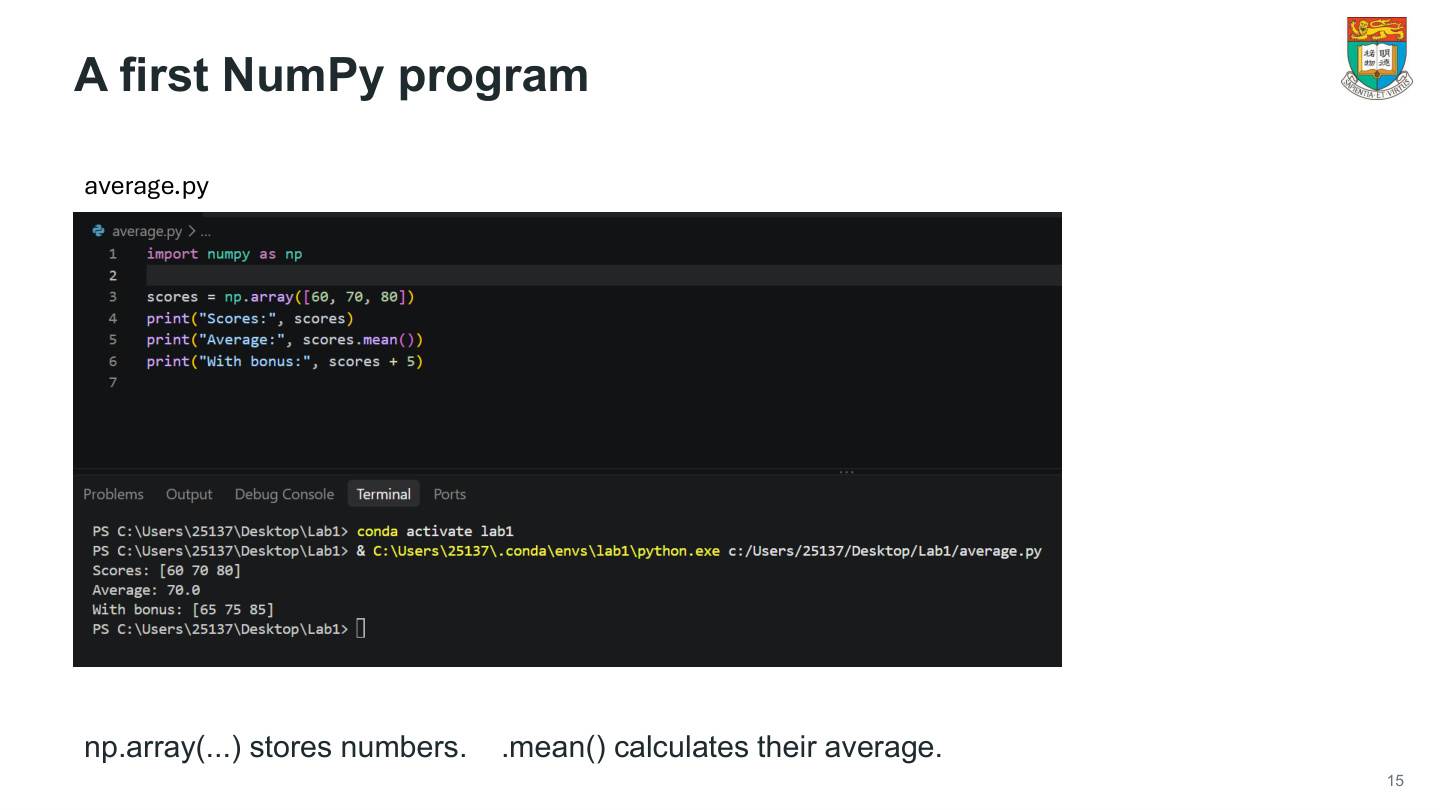
运行下面这段代码:
import numpy as np
scores = np.array([60, 70, 80])
print("Scores:", scores)
print("Average:", scores.mean())
print("With bonus:", scores + 5)
① import numpy as np 让程序使用 NumPy,并把长名字简称为 np;as 不改变库功能。② 方括号列出3个分数,np.array 把它们组成一维数组。其 shape 为 (3,),意思是一个轴、长度3。
③ 第一个 print 输出标签 Scores: 和数组 [60 70 80]。NumPy 数组的显示通常没有列表那样的逗号。④ .mean() 先加总:60+70+80=210,再除以3,得到70.0;所以输出 Average: 70.0。⑤ scores+5 把5加到每个元素:60+5=65、70+5=75、80+5=85,因此输出 [65 75 85]。
最后一行只计算新数组,没有把它重新赋给 scores,所以原来的 scores 仍为 [60,70,80]。如果要永久保留加分结果,才写 scores = scores + 5。
第二部分:从一个程序学到可重复的操作
下面学习变量、类型、列表、NumPy数组、函数、条件和循环。读每段代码时,逐行跟踪变量的值、数组的形状,以及下一行会改变什么。
变量和赋值:右边先算,左边再更新
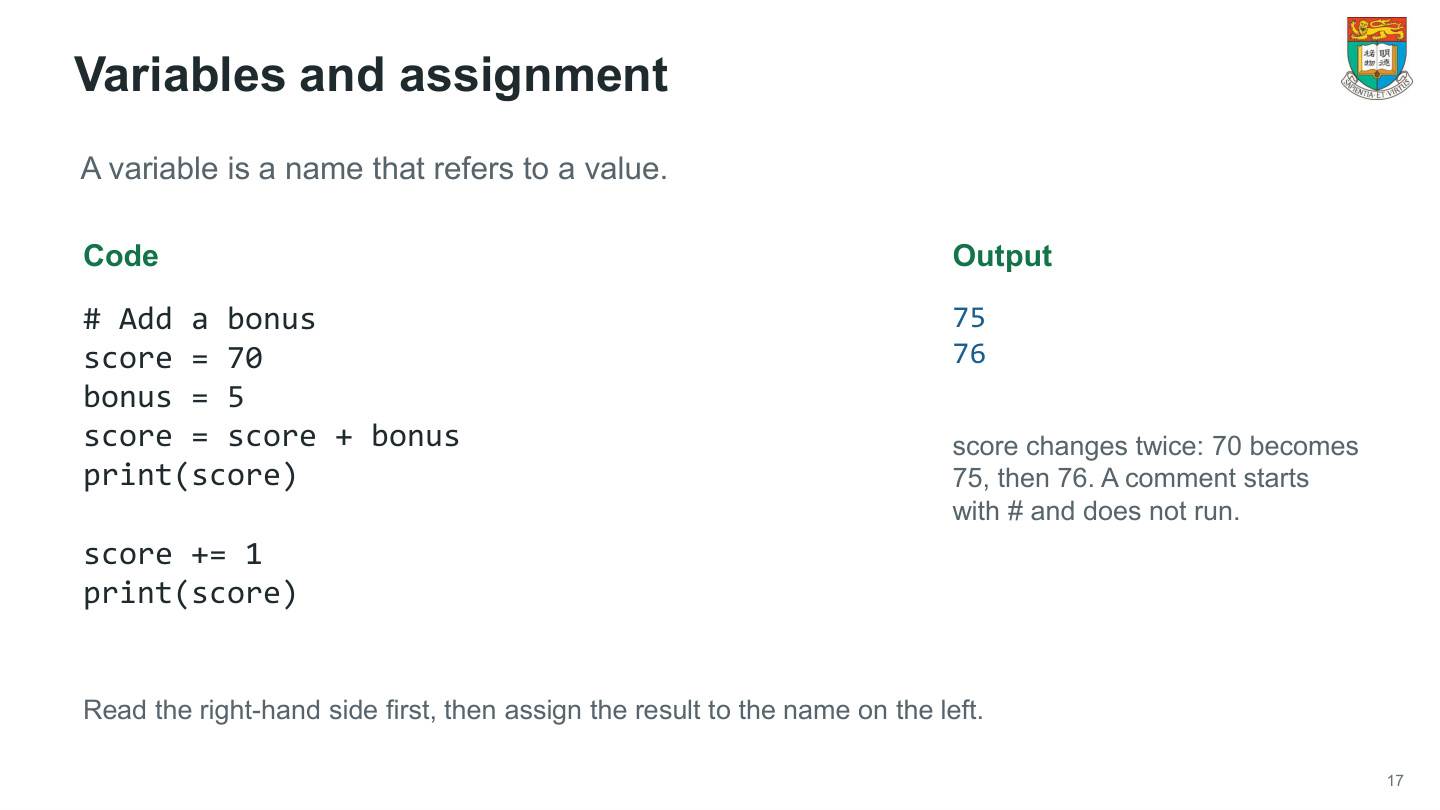
代码:
## Add a bonus
score = 70
bonus = 5
score = score + bonus
print(score)
score += 1
print(score)
第一行 # 后是注释,供人阅读,不执行。第二行让名字 score 指向整数70;第三行把5记作 bonus。第四行不能当数学等式读成“score 两边抵消”:Python 先取右侧旧值70和5,相加得75,再把左边的 score 更新为75。
第一次打印因此是75。score += 1 在这里等价于 score = score + 1,即75+1=76;最后打印76。bonus 没有被重新赋值,仍然是5。
跟踪表就是:开始 score=70→加 bonus 后75→再加1后76。变量保存的是当前值,不会自动记住所有历史值。= 用于赋值;比较两个值是否相等通常用 ==,两者意义不同。
把 bonus=5 改为10,第一次打印80,第二次打印81。
四种常见类型:70 和 "70" 不能混着理解
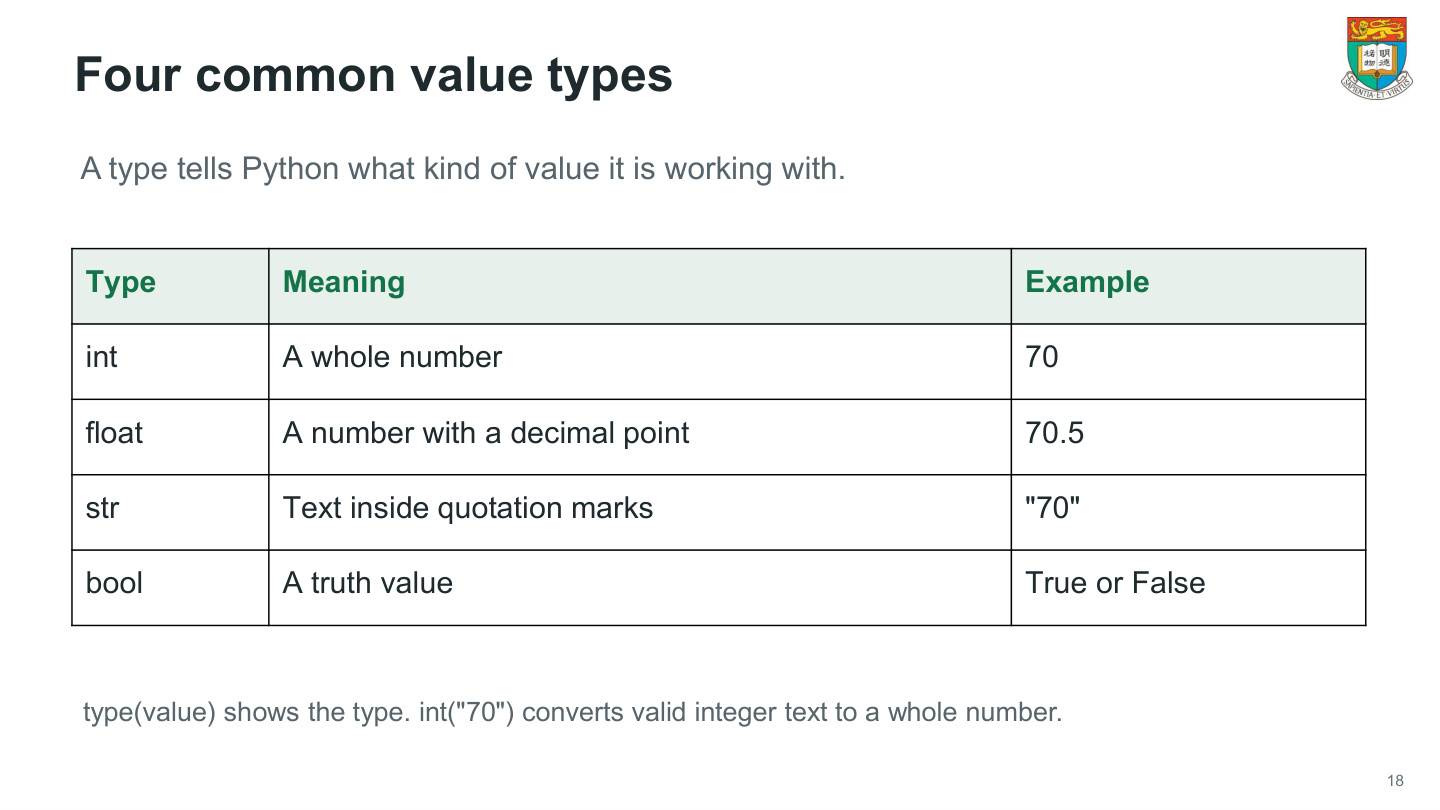
本页列出 int、float、str、bool。int 是整数,例如70;float 是带小数的数值,例如70.5;str 是文本,例如带引号的 "70";bool 是真假值 True 或 False。
引号非常关键:70+5 得75,而 "70"+"5" 拼接成文本 "705"。前者做数值加法,后者连接字符。若直接写 "70"+5,Python 抛出 TypeError。
type(value) 查看数据类型;例如 type(70) 是整数类型,type("70") 是字符串类型。 int("70") 可把合适的整数文本转成数值70,但 int("hello") 无法凭空产生整数,会失败。
后面 input() 读取的是文本,即使用户键入20,也要在需要算术时明确转换。
输入和格式化输出:把用户的文字变成可计算的年龄
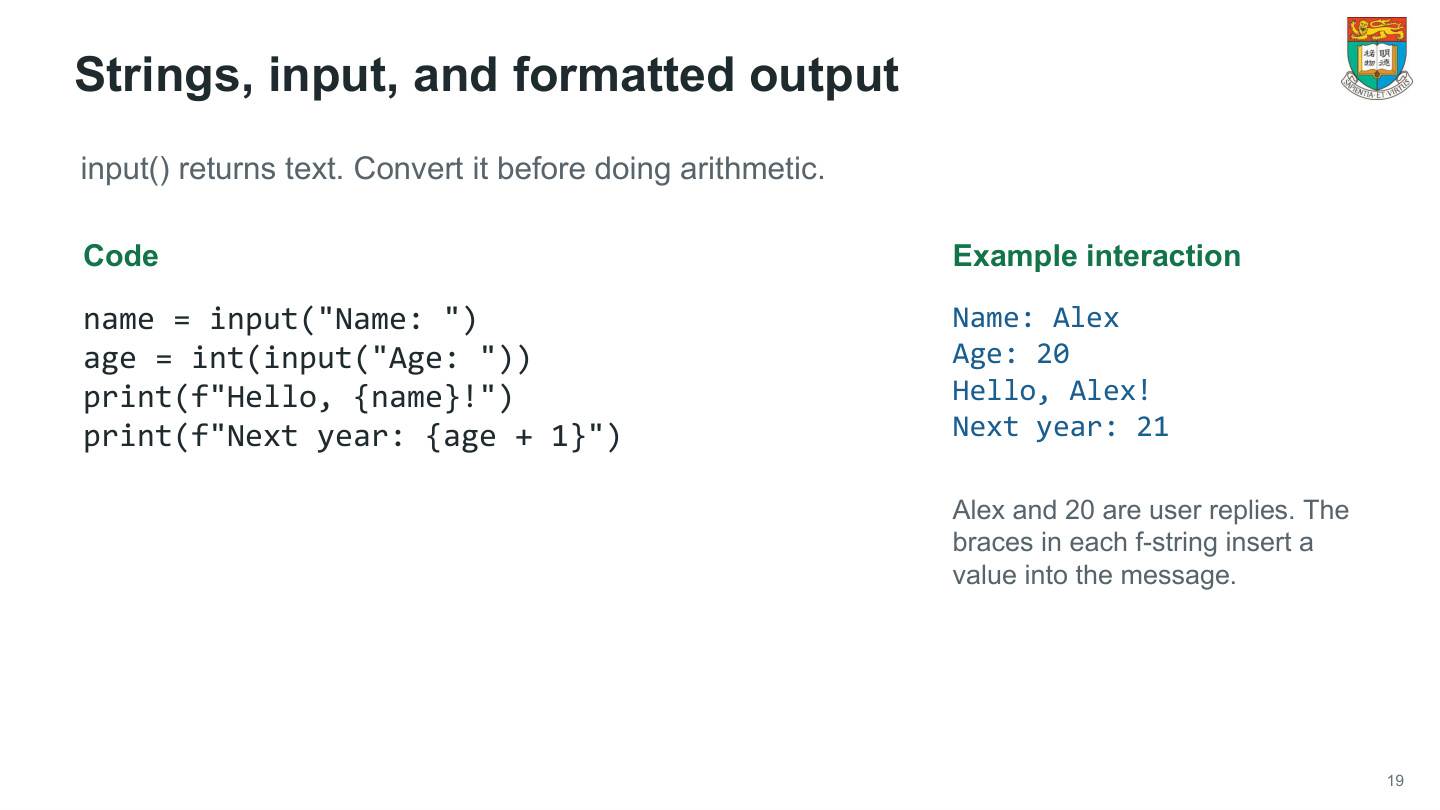
代码:
name = input("Name: ")
age = int(input("Age: "))
print(f"Hello, {name}!")
print(f"Next year: {age + 1}")
① 第一行先显示 Name:,等待用户键入;若输入 Alex,name 保存文本 "Alex"。② 第二行从最里面开始:input 得到文本 "20",int 将其转换为整数20,再赋给 age。所以别把 int(input(...)) 看成同时发生的黑箱。
③ f 表示格式化字符串,花括号内计算变量或表达式。{name} 替换为 Alex,得到 Hello, Alex!。④ {age+1} 先算20+1=21,再插入句子,得到 Next year: 21。
提示文字和用户输入不是程序源代码的一部分;屏幕上的 Name: Alex 表示程序打印了提示,用户随后输入 Alex。若输入 twenty,int 无法转换;若省去 int,age 仍是字符串,不能直接和整数1相加。输入Alex和20时,依次得到上述两行输出。
列表和从零开始的下标:准确找到第几个元素
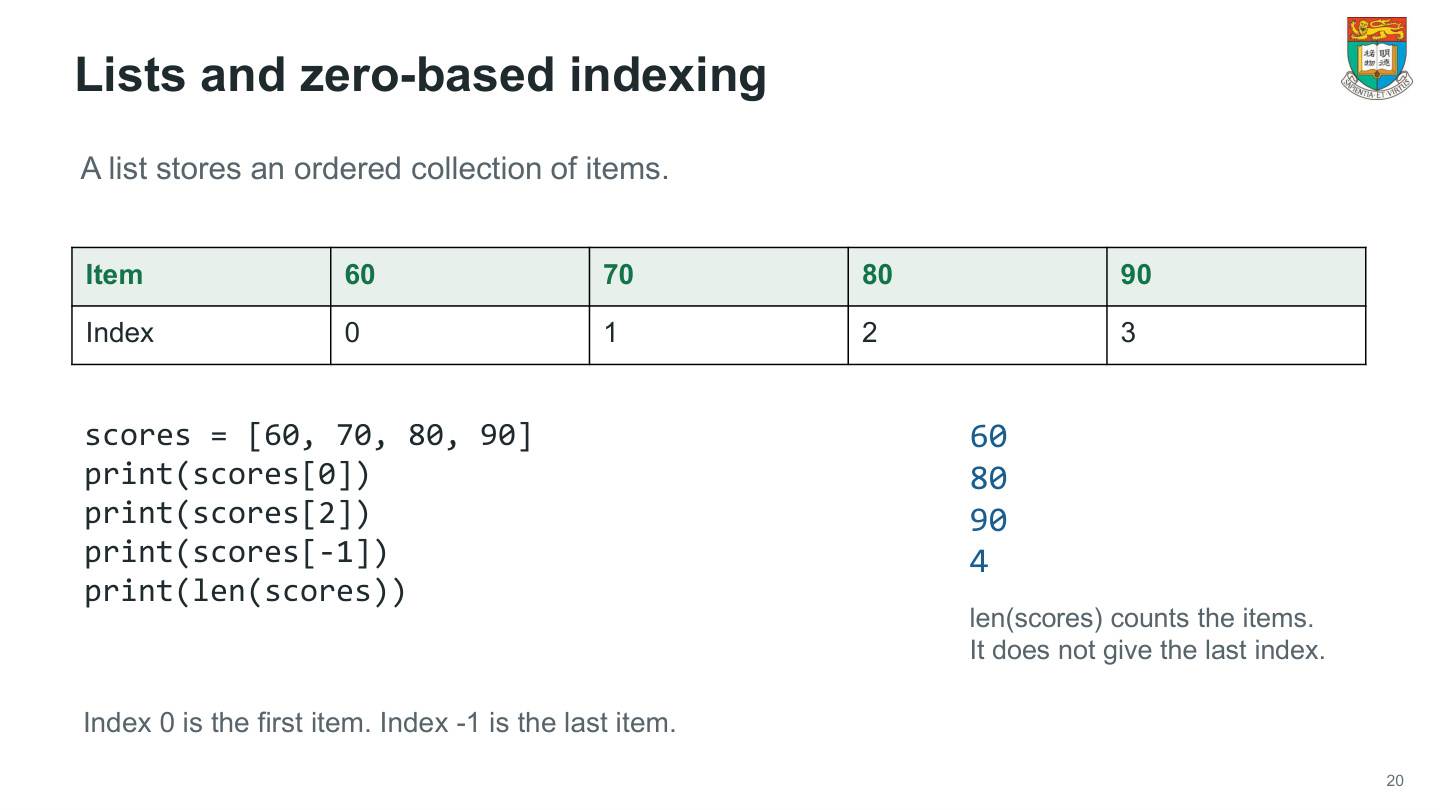
先建立列表:
scores = [60, 70, 80, 90]
print(scores[0])
print(scores[2])
print(scores[-1])
print(len(scores))
列表是按顺序放东西的容器。人说第1、2、3、4个,Python 下标却用0、1、2、3。因此 scores[0] 是60,scores[2] 是80,不能看到2就取第二个70。
负下标从末尾数:-1 是最后一个90,-2 是倒数第二个80。len(scores) 返回元素个数4,不是最大下标3;元素个数与最后下标相差1。
打印顺序为60、80、90、4,每个 print 单独一行。若访问 scores[4],这是第5个位置,已经超出四元素列表范围,会出现 IndexError。
给列表做定位时可以先写一张对应表:0→60、1→70、2→80、3→90。以后图片像素、标签序列和训练样本也会靠下标配对,偏一位就可能把图片和错误标签连在一起。
切片、修改、追加:区分选出一部分和改变原列表
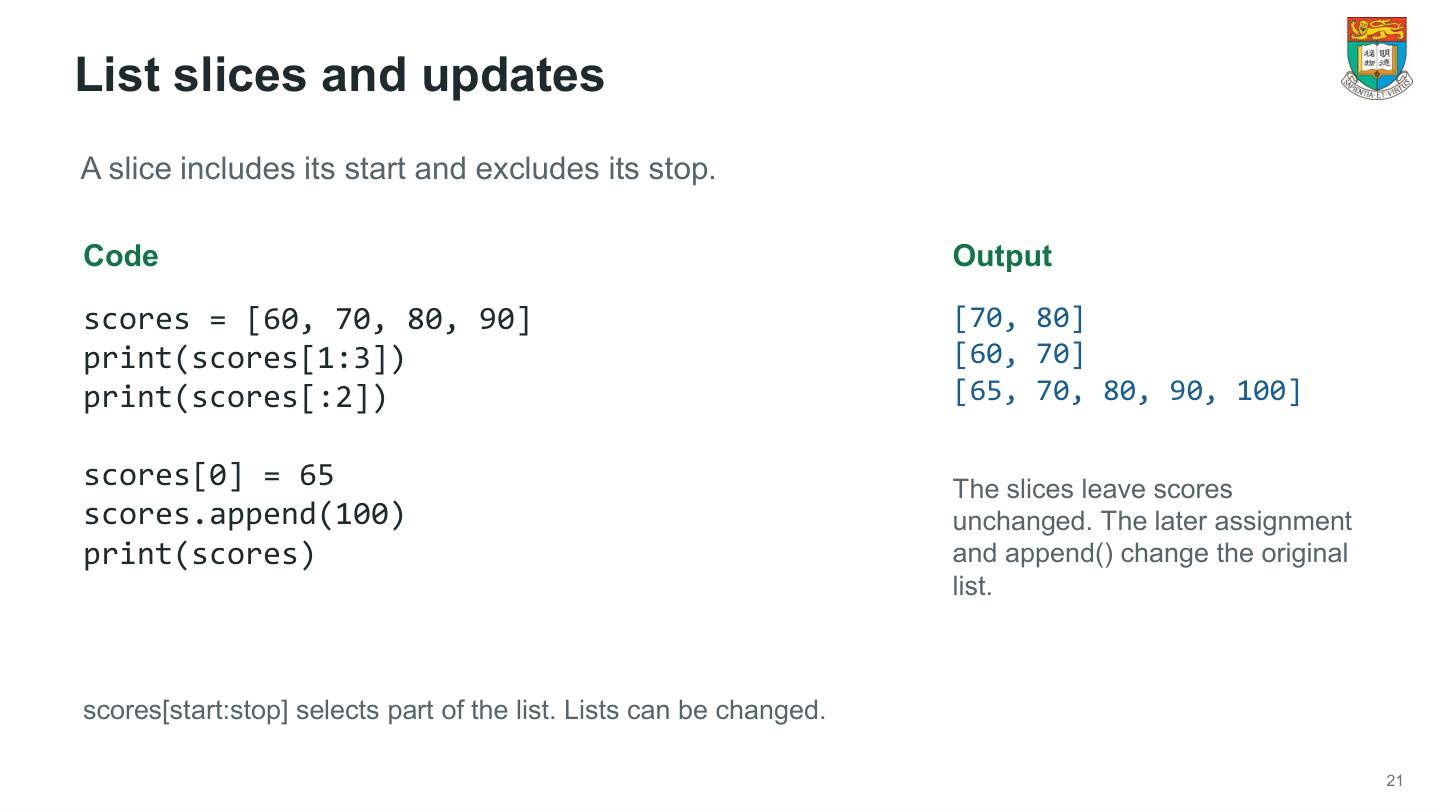
代码:
scores = [60, 70, 80, 90]
print(scores[1:3])
print(scores[:2])
scores[0] = 65
scores.append(100)
print(scores)
① scores[1:3] 从下标1开始,直到下标3之前,所以只选下标1和2,输出 [70, 80]。最容易错的是把右端也算进去;规则是“包含起点,不包含终点”。② scores[:2] 省略起点,相当于从0开始,选0、1,输出 [60, 70]。
这两次切片只是取数据,并没有给 scores 重新赋值。③ scores[0]=65 才真正把第一项从60改成65。④ .append(100) 在末尾增加一个元素;列表从4项变5项。最后得到 [65,70,80,90,100]。
append 的意思是修改原列表,不应写成 scores = scores.append(100);append 返回 None,这样的赋值会把变量 scores 改成 None。练习:最后再次取 scores[1:3] 仍是 [70,80],因为改动的是下标0和末尾,原来的下标1、2没变。
使用别人写好的代码:内置函数、模块、包
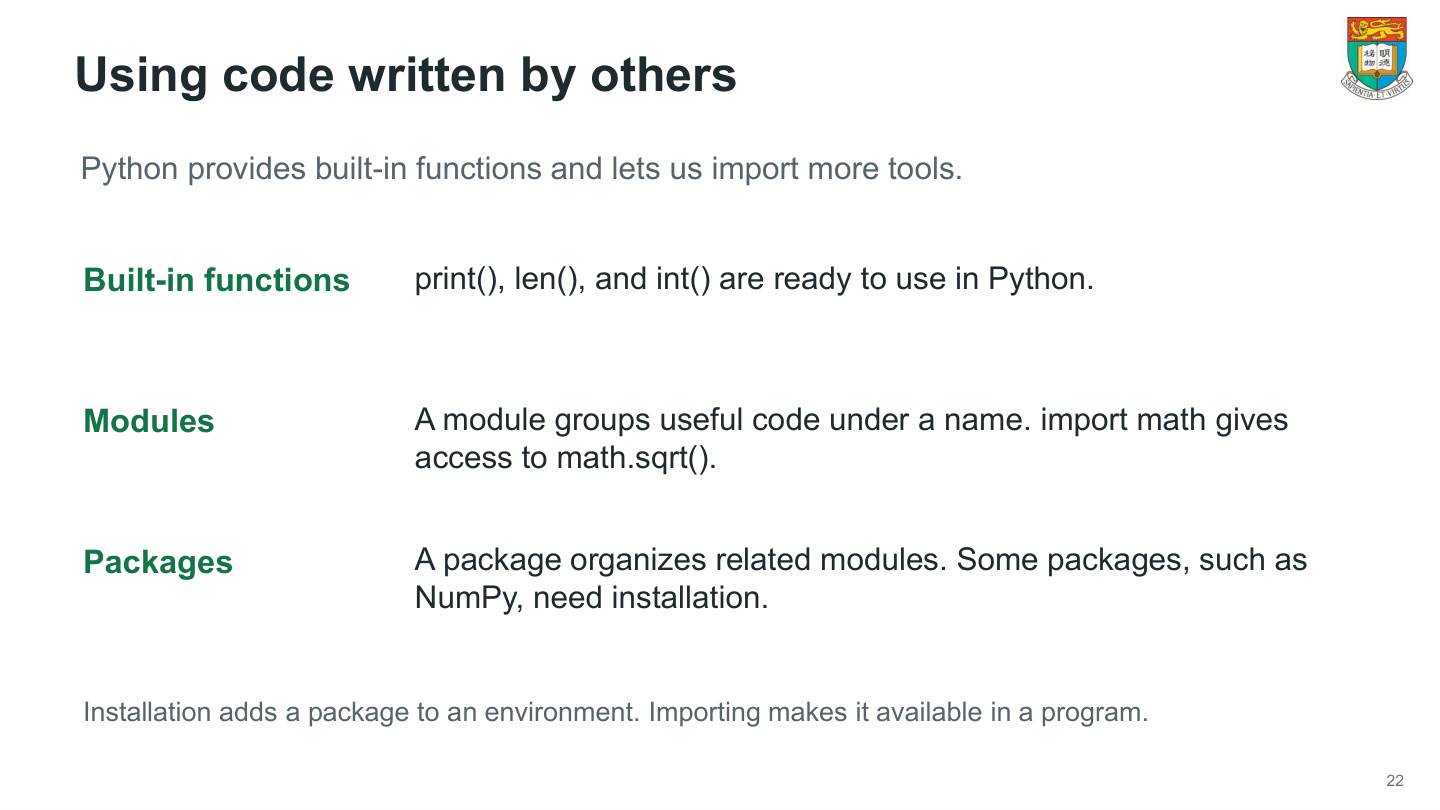
Python中常用的工具有三类。print()、len()、int() 是内置函数,启动 Python 后就能使用。模块是一组放在共同名字下的代码,例如 math;执行 import math 后,可写 math.sqrt(9)。包组织相关模块,例如 NumPy,通常需要先安装。
逐步理解“安装”和“导入”:安装负责把外部包放到某个环境;导入负责让当前这次程序获得使用它的入口。安装过 NumPy,不表示每个脚本会自动出现名字 np;你仍须写 import numpy as np。
点号表示从某个对象或模块取功能。math.sqrt 是 math 里的平方根函数,scores.mean 是数组的求均值方法。括号表示调用,括号里放输入;只写函数名字而不带括号,通常不会执行这项计算。
遇到函数先问“它是内置的,还是来自已导入模块”。若报 NameError: math,先找有没有导入;若报 ModuleNotFoundError,再核查是否安装、是否用对环境。
math 模块:逐行理解平方根、向下取整、四舍五入
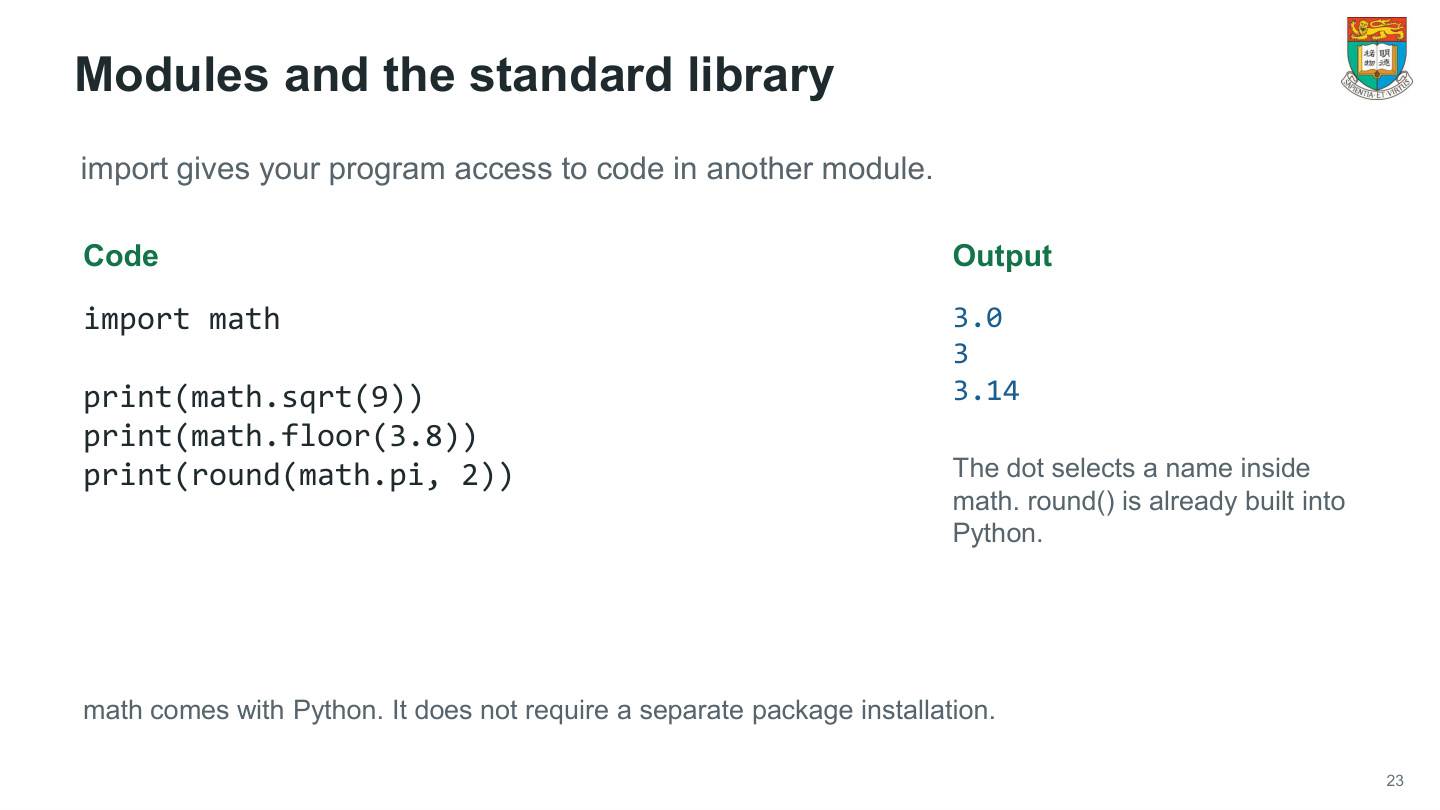
代码:
import math
print(math.sqrt(9))
print(math.floor(3.8))
print(round(math.pi, 2))
第一行导入 Python 标准库 math,它随 Python 提供,不需要像 NumPy 一样另行安装。第二行把9交给 sqrt,求平方根,返回3.0;显示小数点不代表答案不准确,只是结果类型为浮点数。
第三行 floor(3.8) 向下取到不大于3.8的最大整数,因此得3。它不同于一般“四舍五入”;例如 floor(-1.2) 会得到-2,因为-2才在-1.2的下方。
第四行 math.pi 是圆周率数值,round(...,2) 把结果保留到小数点后2位,显示3.14。round 是内置函数,因此没有写 math.round。Python在恰好居中的舍入情况下还受其舍入规则和浮点表示影响;这里3.14159…保留两位得到3.14。
三个输出依次为3.0、3、3.14。数据流都是“取输入→函数计算→print显示”,点号指明工具来自哪个模块。
NumPy 数组:把许多数值作为一个整体处理
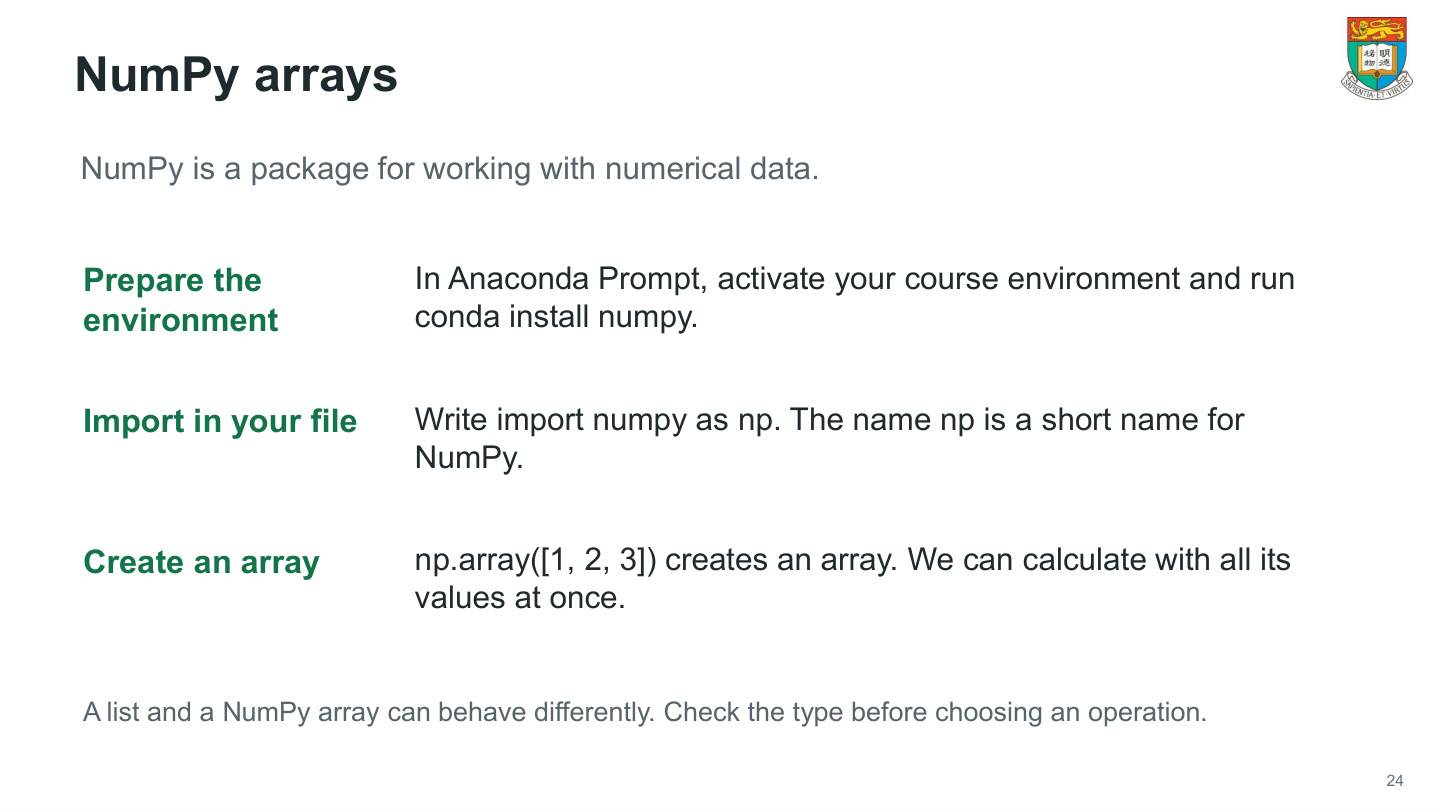
先准备环境,再导入包并创建数组。终端里的安装命令与文件里的代码必须分开:在 lab1 中安装 NumPy;在 .py 文件写:
import numpy as np
numbers = np.array([1, 2, 3])
import 取得包,as np 给它一个短名,np.array 把方括号中的列表转换成数值数组。numbers 的形状为 (3,),含3个元素。数组会记录形状与元素数据类型,方便批量计算。
例如 numbers+10 会对每项计算,得到 [11,12,13];numbers.mean() 先算1+2+3=6,再除3得2.0。省去外层 np.array,只留下普通列表时,某些运算的意义就会不同。
后面一张图片可保存成28×28数组,一批图片可保存成N×28×28数组。每个轴应有明确含义,例如样本、行、列或通道。当前先抓住:同一数组中的数值可以按元素统一计算,而形状告诉我们数据怎样排列。
列表乘2与数组乘2:同一个符号,两个意思
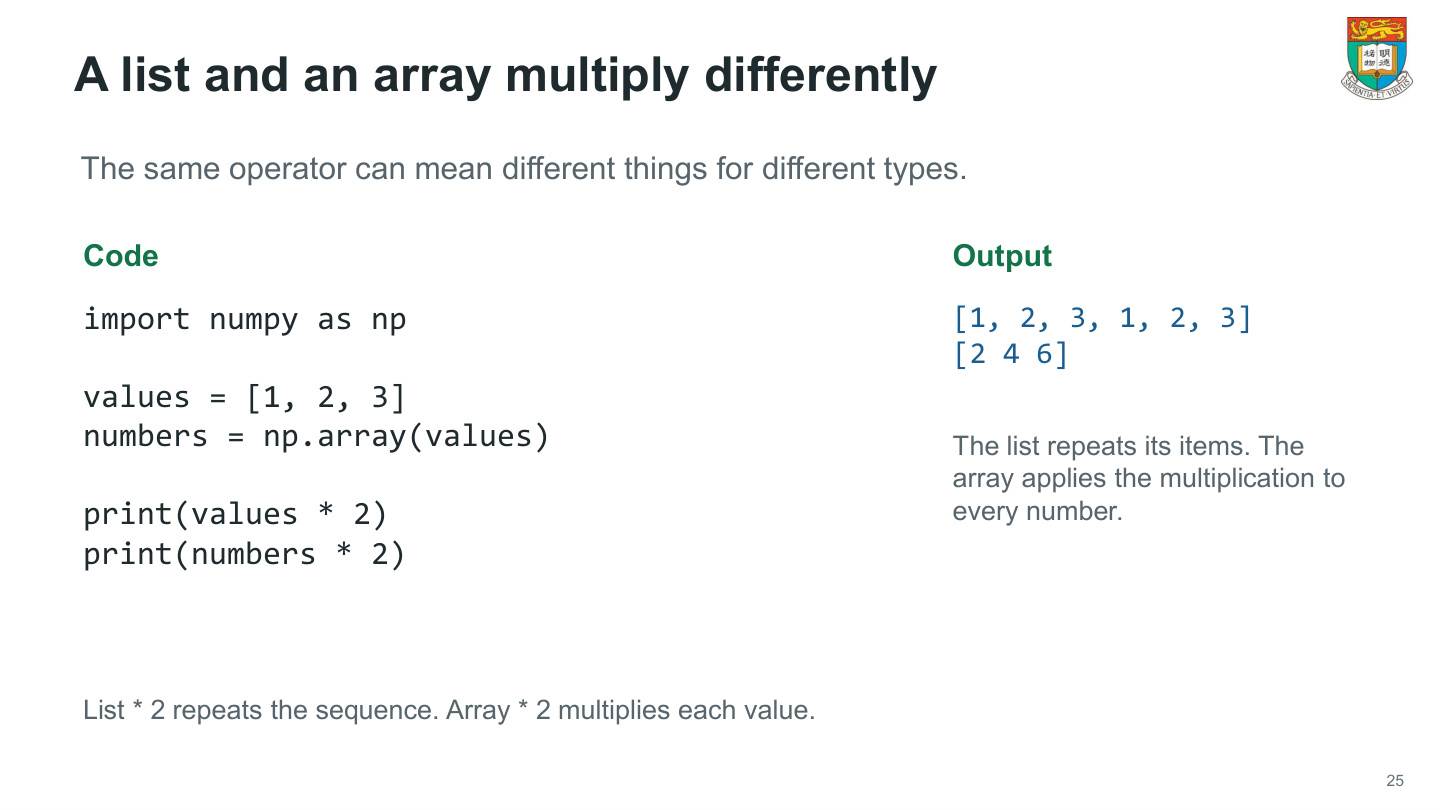
代码:
import numpy as np
values = [1, 2, 3]
numbers = np.array(values)
print(values * 2)
print(numbers * 2)
values 是 Python 列表,numbers 是根据它建立的 NumPy 数组。虽然里面都装1、2、3,但对象类型不同。
values*2 表示把列表内容重复两遍,得到 [1,2,3,1,2,3],长度从3变6。它没有把每个数字加倍。numbers*2 是数组逐元素乘法:1×2=2、2×2=4、3×2=6,得到 [2 4 6],形状仍为 (3,)。
这解释了为什么图像像素常转成数组再做缩放。若想把每个像素除以255,数组能对每项执行相同运算;普通列表不能按同样语法直接实现所有数值运算。
练习:若倍数换成3,列表长度变9,数组长度仍3,值变 [3,6,9]。读取代码时先辨认类型,才知道 * 是重复容器还是计算数值。
shape:用一个元组说明数组有几层、每层多长
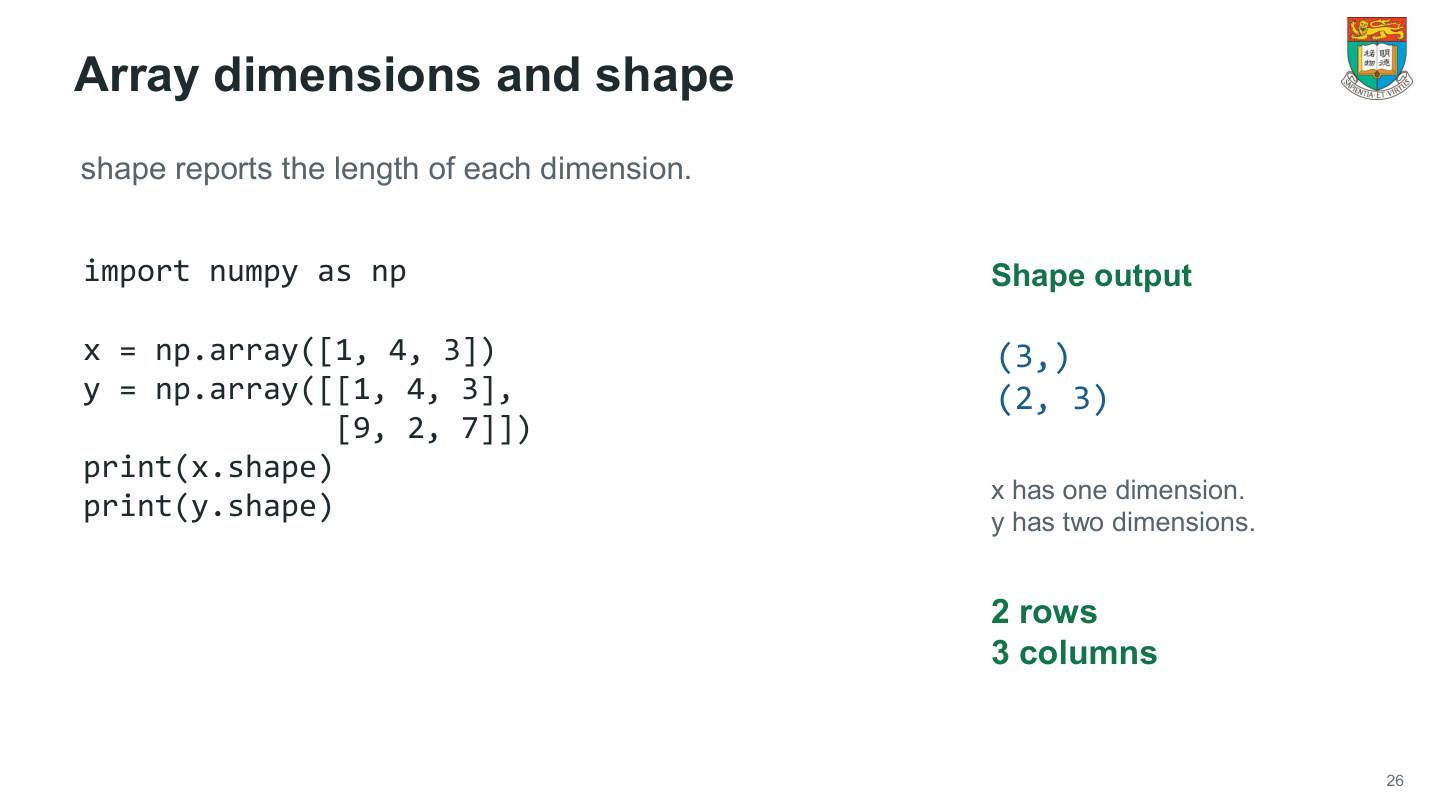
代码:
import numpy as np
x = np.array([1, 4, 3])
y = np.array([[1, 4, 3],
              [9, 2, 7]])
print(x.shape)
print(y.shape)
x 只有一层元素,长度3,所以形状为 (3,)。逗号很重要:它表示只有一项的元组,而非普通括号。y 外面有两份列表,每份3项,因此是2行3列,形状为 (2,3)。
y.shape 按轴报告长度。轴0有2行,轴1有3列,总元素数2×3=6。用同一组数 [1,4,3] 对照三种形状:
| 写法 | 形状 | 如何摆放 |
|---|---|---|
np.array([1,4,3]) |
(3,) |
一个轴,长度3 |
np.array([[1,4,3]]) |
(1,3) |
两个轴,1行3列 |
np.array([[1],[4],[3]]) |
(3,1) |
两个轴,3行1列 |
一张28×28图片共有784个像素,reshape(784) 将行列两个轴合成一个轴,输出 (784,)。
二维索引:先选行,再选列
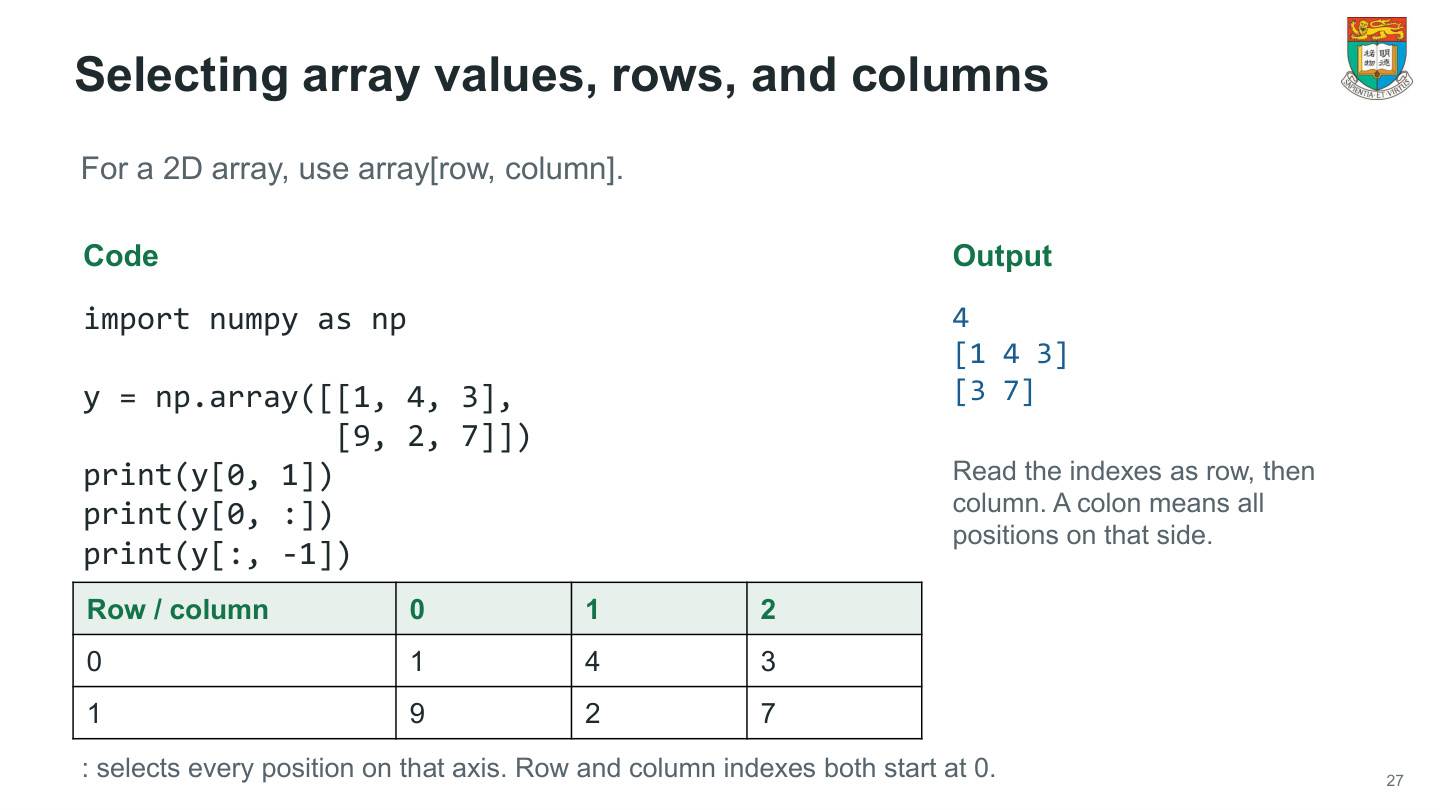
动手试试 · 选行与列,观察取值和shape
代码:
import numpy as np
y = np.array([[1, 4, 3],
              [9, 2, 7]])
print(y[0, 1])
print(y[0, :])
print(y[:, -1])
数组有2行3列,行号0、1,列号0、1、2。y[0,1] 先去第0行 [1,4,3],再取第1列,得到4。不要把两个下标的顺序反过来。
y[0,:] 固定第0行,冒号表示这一轴全部位置,因此输出 [1 4 3],结果形状是 (3,)。y[:,-1] 取全部行,每行最后一列:第一行取3,第二行取7,输出 [3 7],形状 (2,)。
输入是一个 (2,3) 矩阵,三种选择分别得到单个数、一条行向量、一条列的数值序列。所谓“取一列”这里结果仍是一维数组;整数索引 -1 取单个列位置,列轴随之消失。若后续需要二维列,改用切片 y[:, -1:],它仍选最后一列,保留列轴,结果 [[3],[7]],形状 (2,1)。
练习:y[1,0] 应是9;y[:,1] 应是 [4,2]。
为什么需要函数:把输入、工作、结果分开
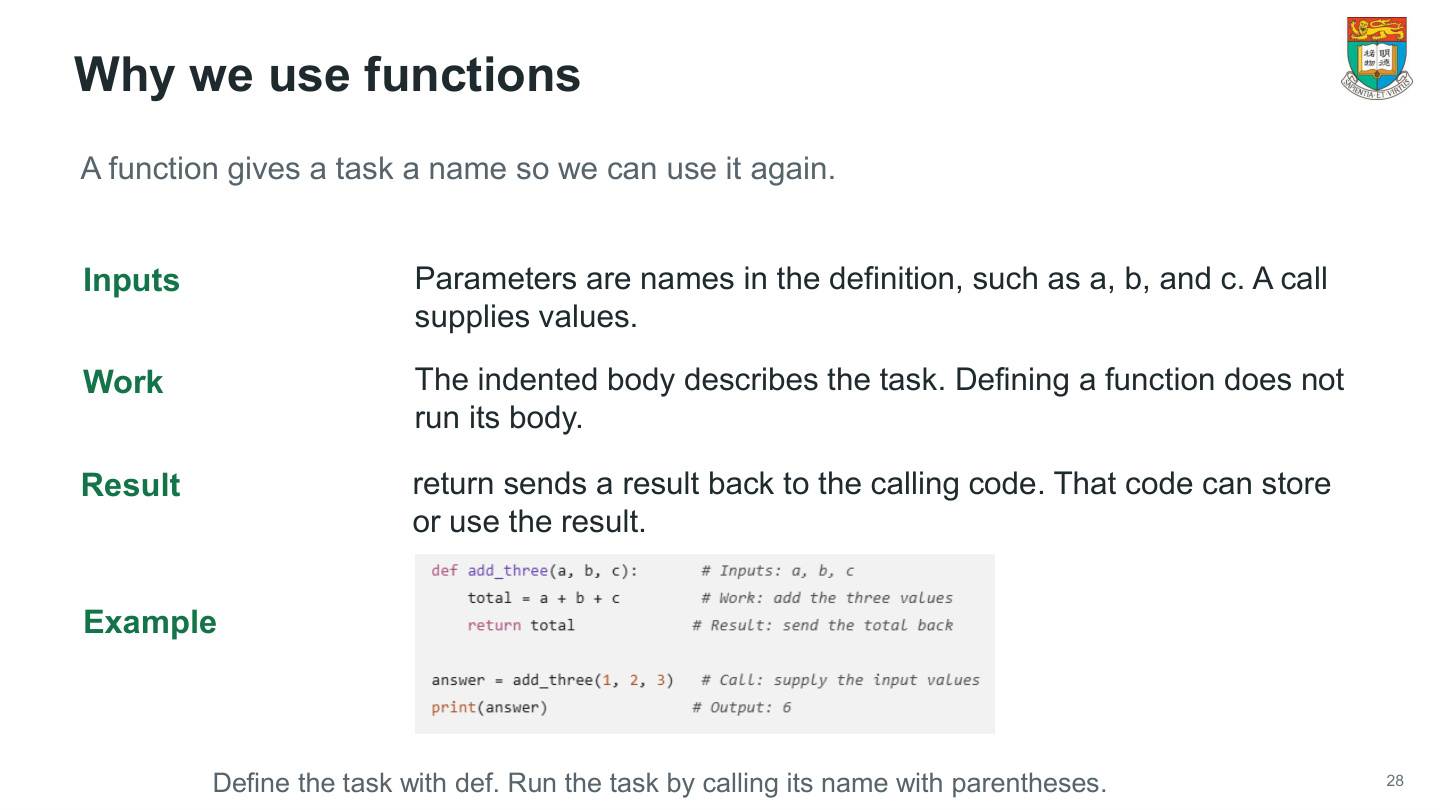
函数由三部分组成。输入由参数接收;工作写在缩进的函数体;结果通过 return 交还给调用位置。
例如把“计算三个数的总和”命名为 add_three。定义中的 a,b,c 是参数名,调用时给出1、2、3,这些实际值才进入参数。函数体算出6,return 把6送回去,外层程序才能继续使用。
执行 def 时先保存函数的定义。调用 add_three(1,2,3) 时才进入函数体。第二次调用会用第二次传入的值重新计算。
print 与 return 也不同:前者把东西显示给人看,后者把结果交给后续代码。如果函数只是打印6却没有返回数值,调用得到的是 None,外部程序无法把它当成数值6继续计算。
在机器学习里,load_model、predict 都是这种结构。评测者传入路径或模型,函数按约定完成工作,再返回对象或保存结果。
定义并调用函数:逐行跟踪 add_three
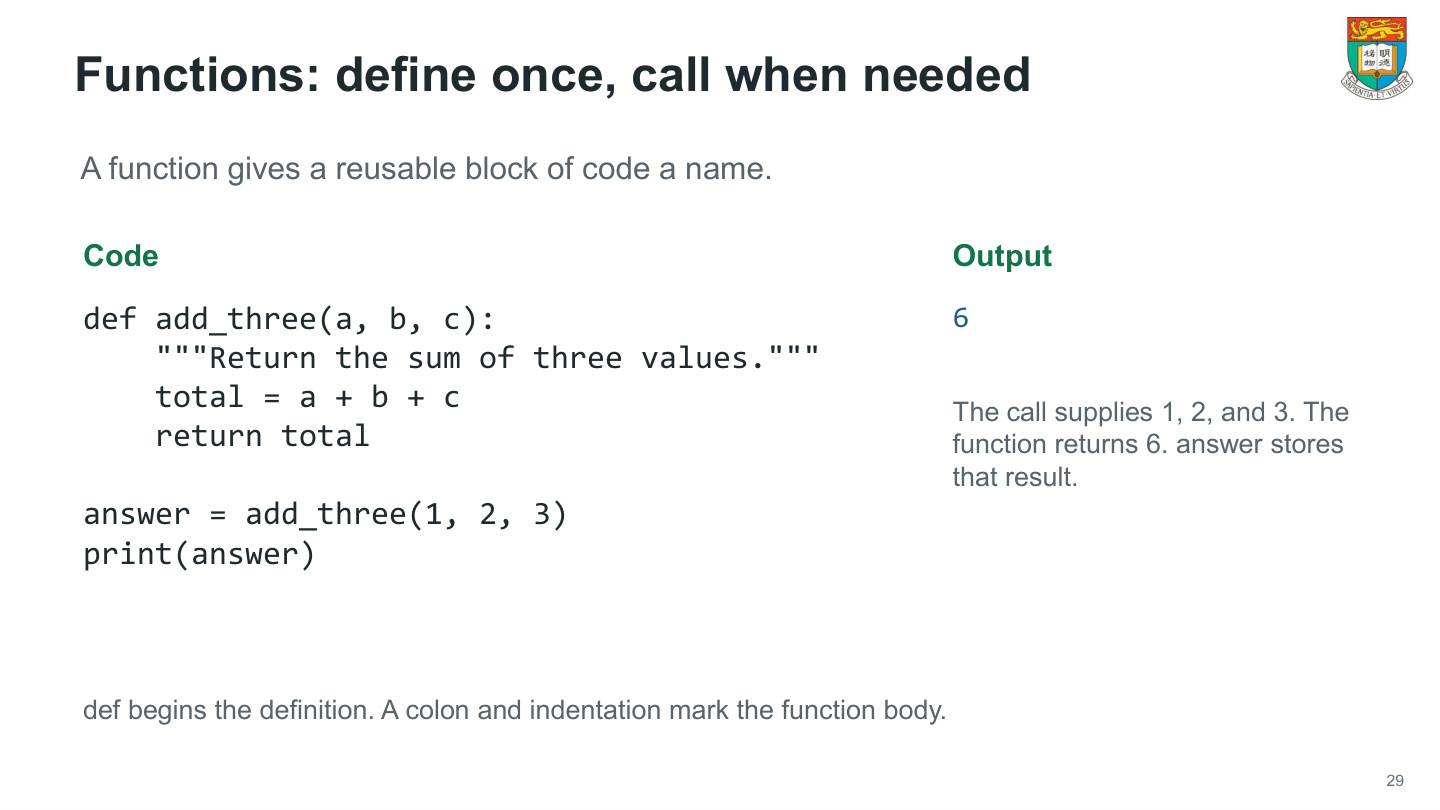
代码:
def add_three(a, b, c):
    """Return the sum of three values."""
    total = a + b + c
    return total

answer = add_three(1, 2, 3)
print(answer)
第一行 def 建立名为 add_three 的函数,括号中是三个参数,冒号表示后面进入函数体。缩进属于语法,说明哪几行归这个函数。三引号文字是说明文档,解释用途,不参与求和。
执行到定义结束时,尚未计算1+2+3。到 answer = add_three(1,2,3) 才调用:a接收1,b接收2,c接收3;函数体先算1+2=3,再加3得6;total 记住6;return total 把6交回调用处,最后 answer=6。
print(answer) 因此显示6。函数内部的 total 是局部名字,不应假定在函数外也能直接使用。若省去 return,执行到函数末尾会返回 None,随后 print(answer) 显示 None。练习:调用 add_three(10,-2,5) 时,仍执行相同流程,结果是13,不需要更改函数定义。
if/else:只执行满足条件的那一条路
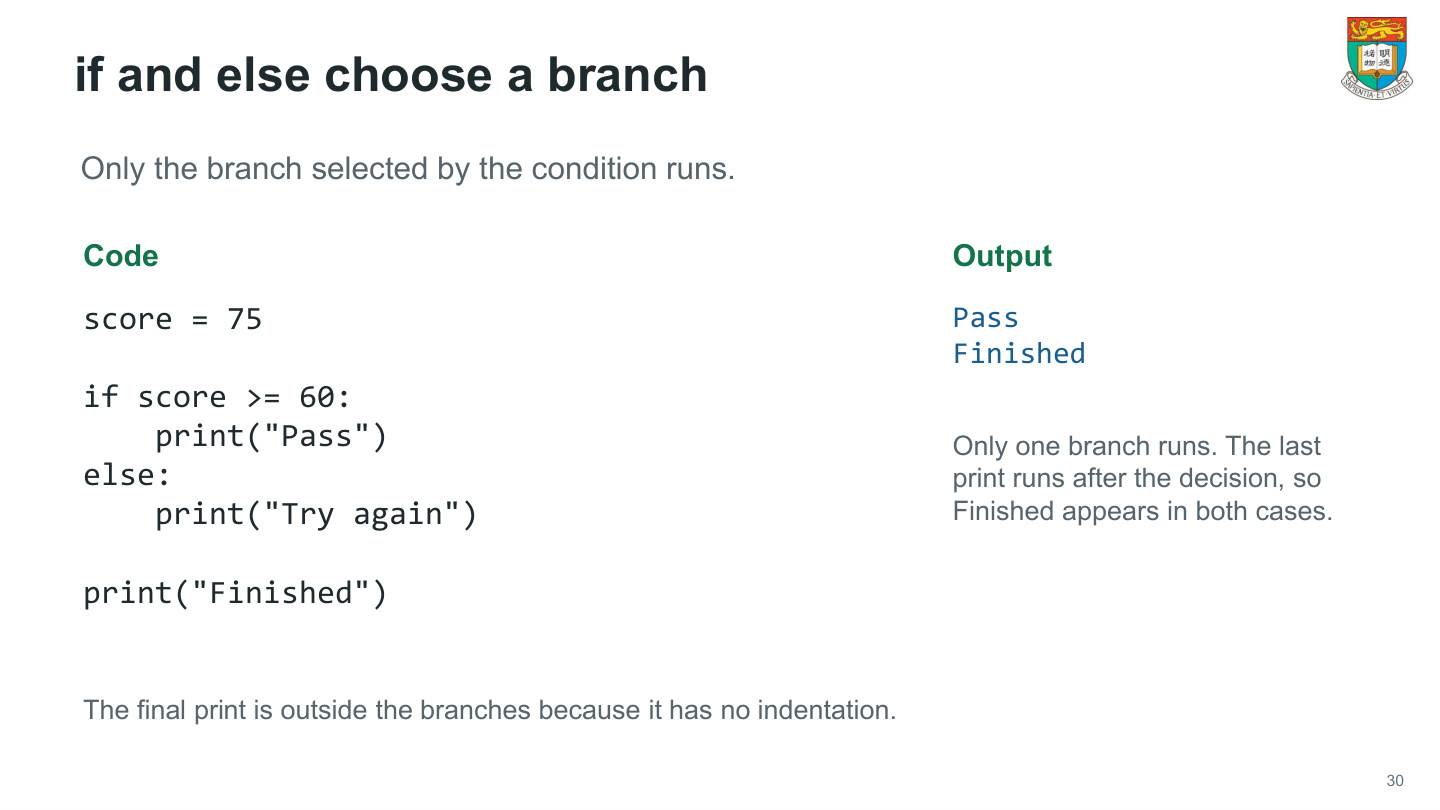
代码:
score = 75
if score >= 60:
    print("Pass")
else:
    print("Try again")
print("Finished")
先保存75,再检查 score>=60。75大于等于60,条件为 True,所以执行缩进的 print("Pass")。else 代表条件不成立时的另一条路,这次不执行,因此不会打印 Try again。
最后一行没有缩进,已经离开这组分支。无论前面走哪条路,正常执行到这里都会显示 Finished。本例输出两行:Pass、Finished。
若把分数改成50,条件为假,就输出 Try again 和 Finished。若分数恰为60,因为是 >= 而不是 >,仍应判 Pass。等号边界不能凭印象略过。
注意冒号与缩进分别表示“接下来有一个代码块”及“这些行属于这个块”。把最后 print 错缩进到 else,就改变了流程。以后异常检测 error>threshold、感知机 score>=0 都需要同样精确地判断符号和边界。
elif:从上到下检查,第一条为真就停
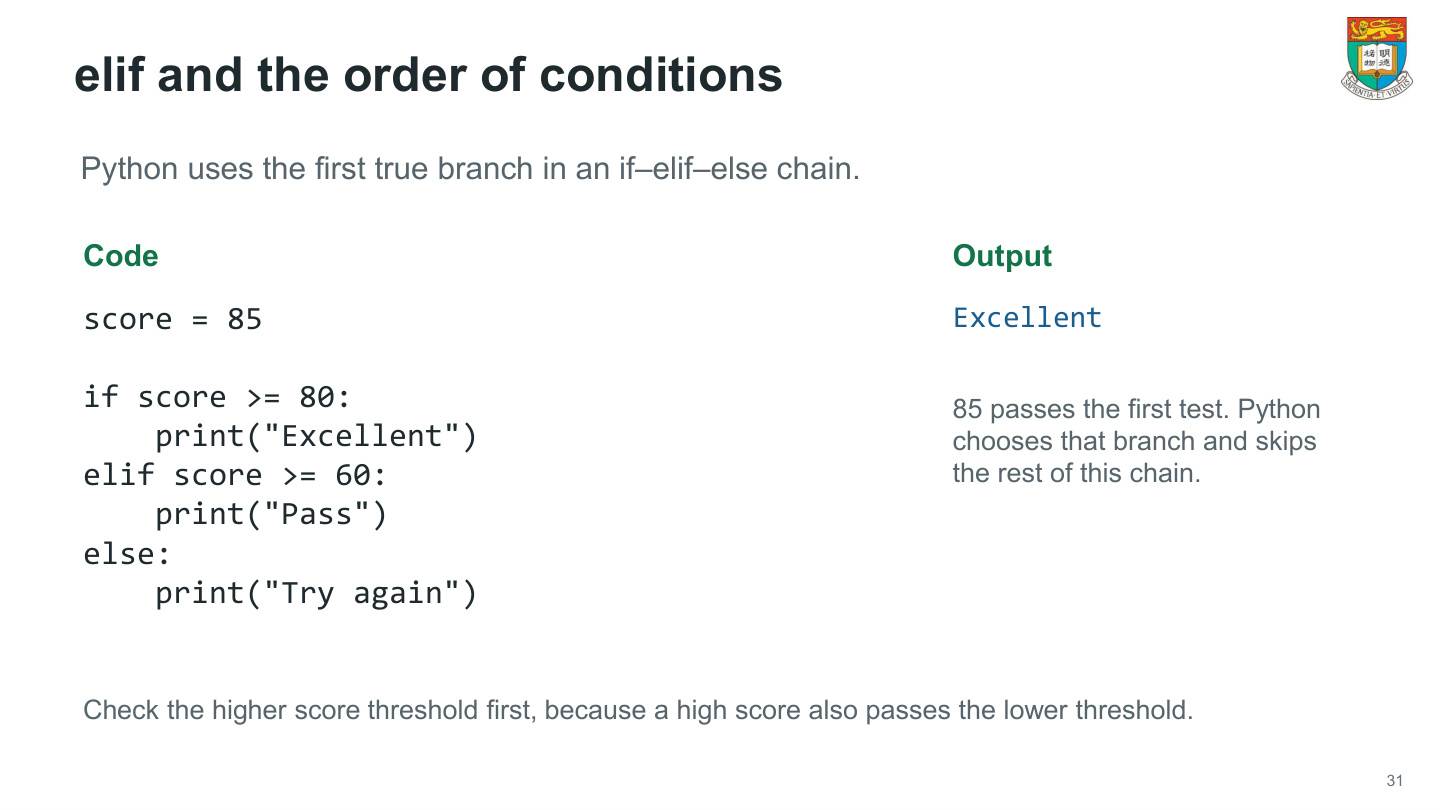
代码:
score = 85
if score >= 80:
    print("Excellent")
elif score >= 60:
    print("Pass")
else:
    print("Try again")
85同时满足“大于等于80”和“大于等于60”,但 if–elif–else 不是把所有真条件都执行。Python 从上往下检查,第一项 85>=80 已为真,因此只打印 Excellent,不再进入后面的 elif。
若分数75,第一项假,第二项 75>=60 真,打印 Pass;若50,两项都假,进入 else,打印 Try again。
为什么高门槛写前面?若先检查 score>=60,85会在这一条就被接住,后面即使写80分门槛也到不了。顺序属于程序逻辑,不只是排版。
自查边界:80输出 Excellent,60输出 Pass,59输出 Try again。再区分三条独立的 if:那样会分别检查,可能打印多个结果;本页则是同一条分支链,只选一条路。
for 和 range:把每次循环都在纸上走一遍
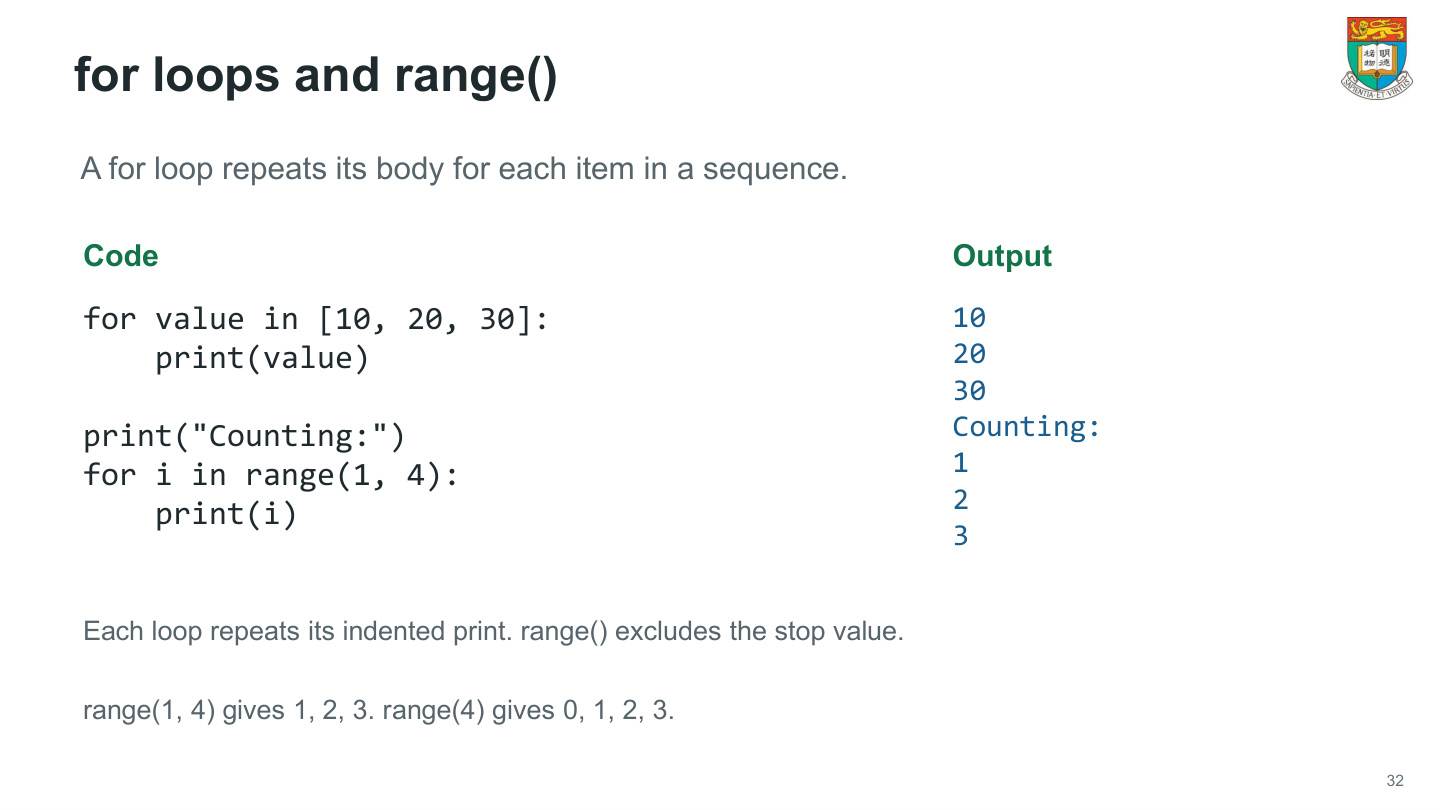
代码:
for value in [10, 20, 30]:
    print(value)
print("Counting:")
for i in range(1, 4):
    print(i)
第一组循环依次取列表元素。第1次 value=10,打印10;第2次20,打印20;第3次30,打印30;没有第4个元素,循环结束。value 不是一开始就同时等于三件东西,而是每轮换一个值。
无缩进的 print("Counting:") 只执行一次。第二组 range(1,4) 产生1、2、3,包含起点1,不含终点4,因此继续分别打印1、2、3。总输出为10、20、30、Counting:、1、2、3。
若只写 range(4),省略起点,得到0、1、2、3,共4次。这与列表从零开始下标相配合,便于依次访问四个位置。
练习:range(2,5) 应给2、3、4,不含5。循环体缩进很关键:若把打印放在循环外,它只会在循环结束后打印最后留下的变量值。
while:先判断,再执行,最后让条件有机会变假
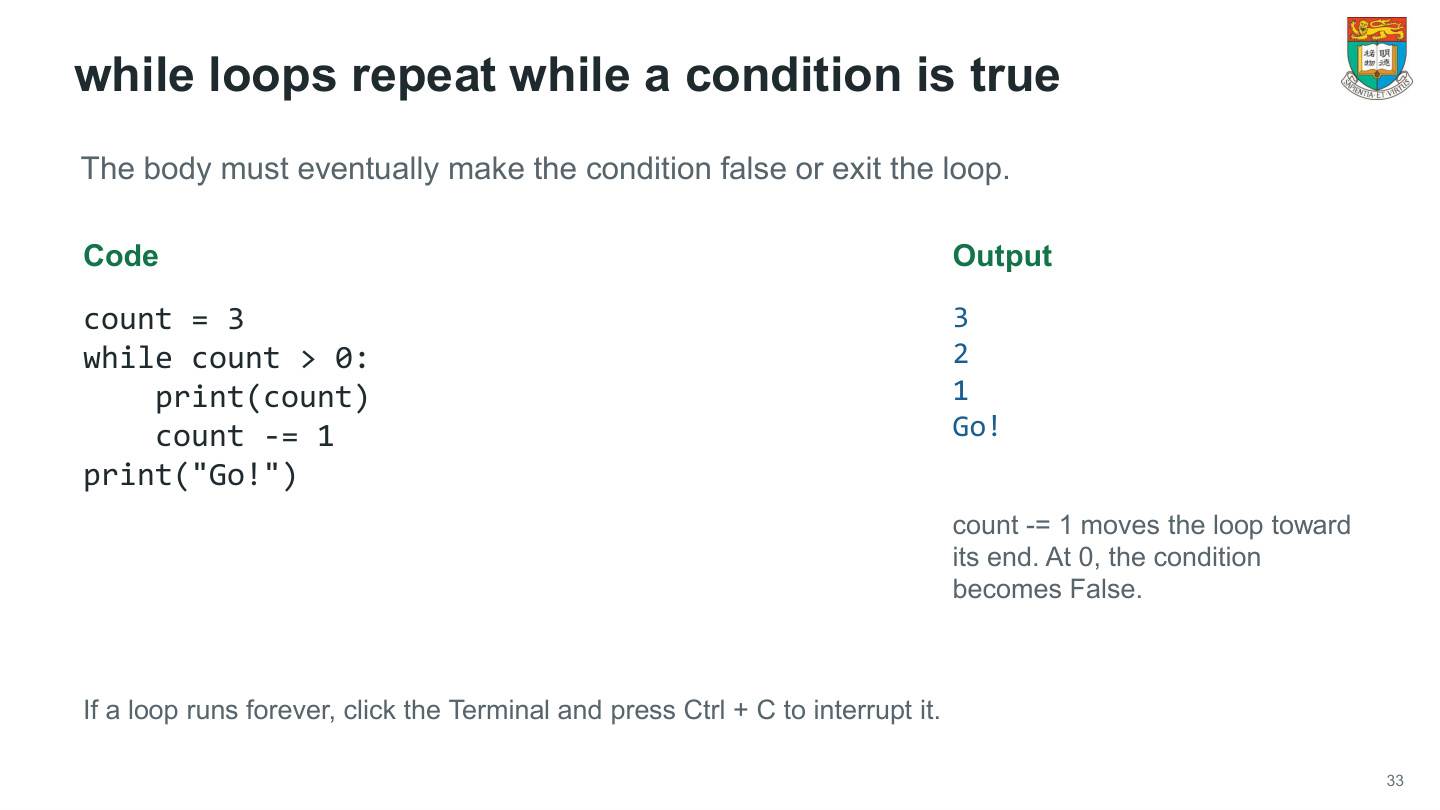
倒计时代码:
count = 3
while count > 0:
    print(count)
    count -= 1
print("Go!")
从 count=3 开始,每次先判断,再执行两行缩进代码:
| 进入判断时的 count | count > 0 |
打印 | 执行 count -= 1 后 |
|---|---|---|---|
| 3 | True | 3 | 2 |
| 2 | True | 2 | 1 |
| 1 | True | 1 | 0 |
| 0 | False | 跳出循环,执行外面的 print("Go!") |
这轮跳过减法 |
因此输出顺序是3、2、1、Go!,不会打印0,因为打印前必须先通过 count>0。
若忘了 count-=1,count一直是3,条件一直为真,程序便不断打印3。在终端按Ctrl+C可以中断无限循环;随后补上更新语句,让count逐步变为0。
while 适合“重复到某个条件满足”,for 适合“依次处理已知序列”。练习:若初值是0,循环体一次都不执行,只打印Go!。
第三部分:把 Python 数值计算接到数字识别任务
接下来用MNIST学习数字识别:先把图片和标签变成数组,再比较kNN、Softmax、SVM、MLP与CNN,最后计算预测准确率。始终沿着“输入是什么→怎样计算→输出什么”来理解每种方法。
MNIST 是什么:一张图、一个标签、十个类别
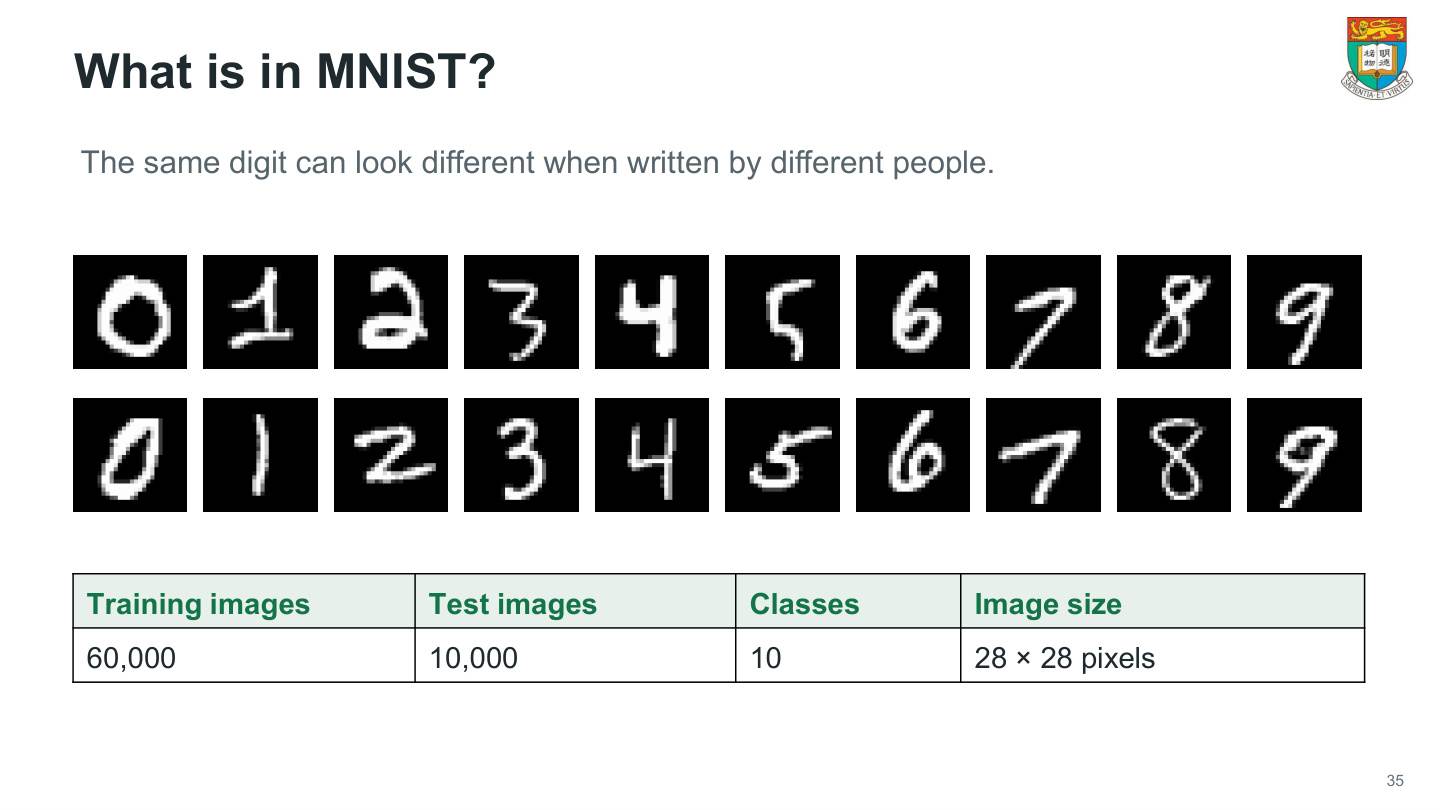
MNIST 包含手写数字图像:标准公开划分中有60,000张训练图片、10,000张测试图片,类别是0–9共10类,每张图28×28个像素。
图中同一个数字出现多种写法,是为了说明困难不在“背一张7”,而在于把不同人的7都认作同一类,并与1、9等区分开。字的倾斜、粗细和位置都会变化。
数据通常成对保存:第i张图 x[i] 对应第i个标签 y[i]。一批训练图像的形状可写 (60000,28,28),标签形状为 (60000,)。首个轴表示样本数;后两个轴表示图像行列。每张图的标签只有一个整数,不是784个标签。
此外,老师会使用另一批私有图片评价最终模型。训练、验证与测试的用途也不同,下一步会进一步拆开。先记住输入规模:28×28=784个像素值;输出类别数量:10。
识别任务:从图片像素到数字类别
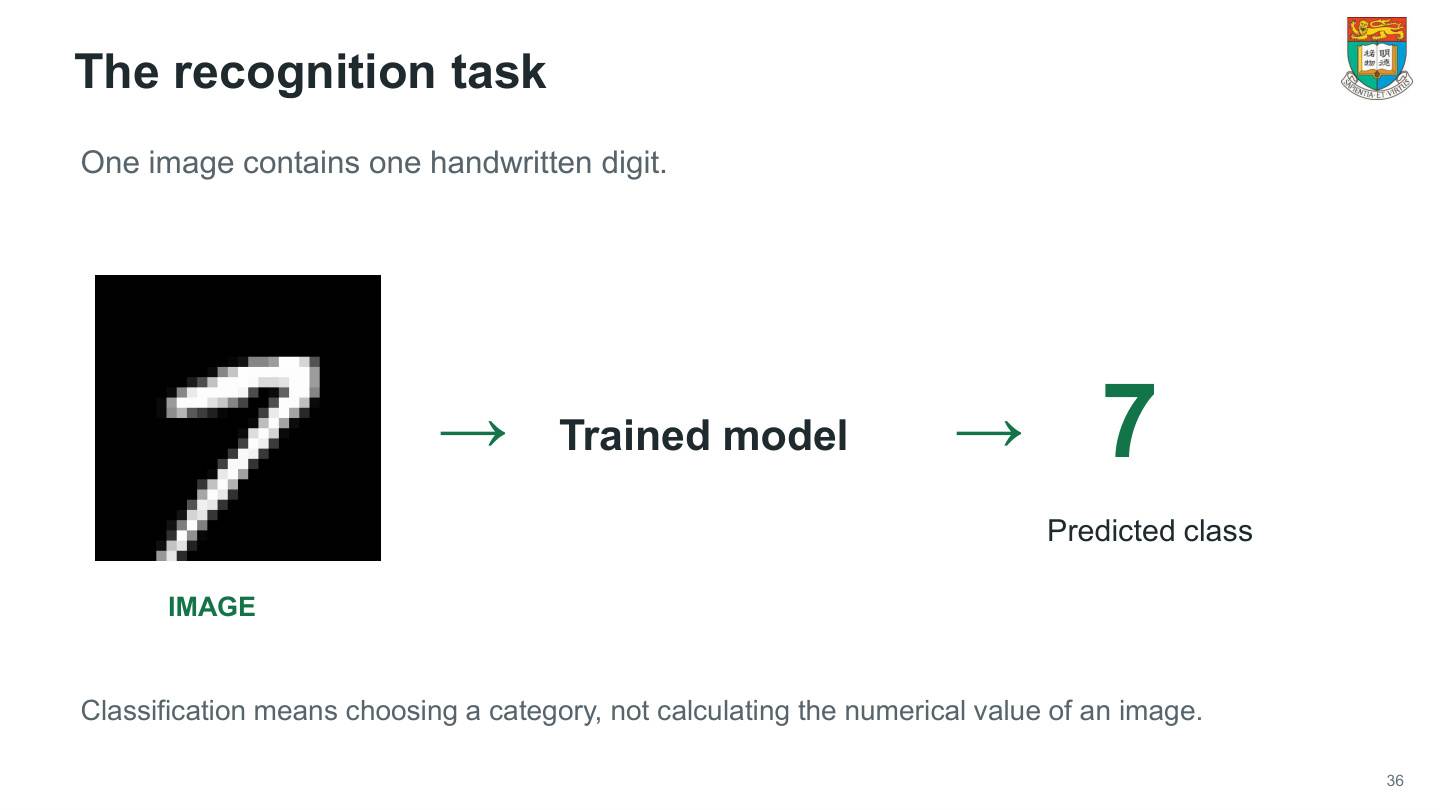
图中流程是“手写7图片→已训练模型→预测类别7”。输入是一张图片,输出是0–9中的一个整数。
这里的7是类别标签。模型不是对图片里的像素做普通加法,算出结果刚好为7;像素可能有784个、数值很大,而标签只表达“这张图属于写着7的那一组”。同理类别0不表示模型什么都没发现,类别9也不意味着质量比类别1高。
训练时我们提供许多 (图片,正确数字) 对,模型根据它们建立规则。预测新图片时,只能读取图像,不能偷偷读取标签。最后将预测与独立保存的真值比较,才能评价准确率。
一个模型可以先产生10个分数或概率,再选最大项。但作业最终接口要提交的是一个标签,不是整幅图或十维列表。若真值为3、预测为5,准确率计数中这张得0分。
图片也是矩阵:像素亮度如何变成0到1
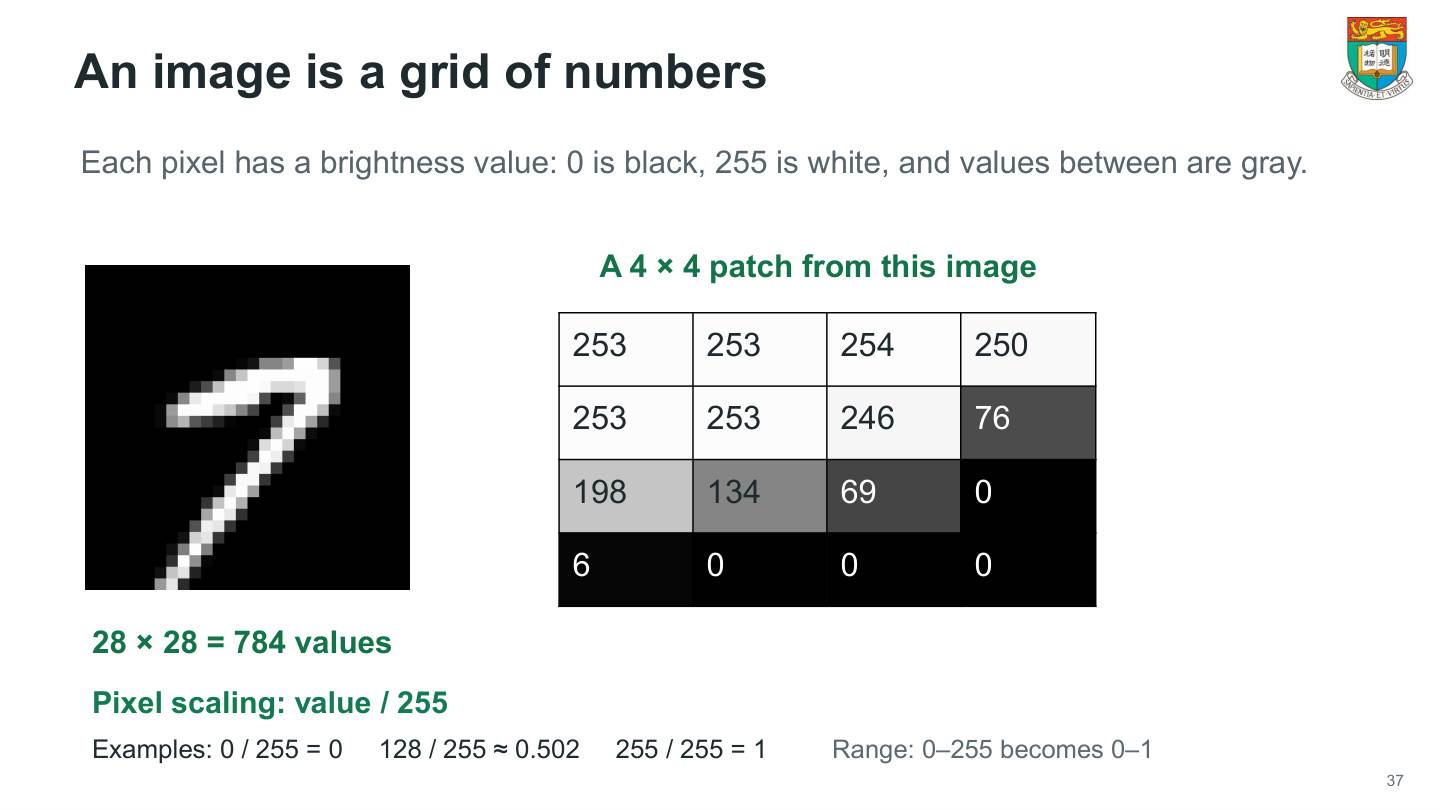
每个像素是一个小格子的亮度:本课 MNIST 约定0为黑,255为白,中间数值为灰色。一张28×28图片共有784个格子。右侧4×4表只是从大图里取出的小块,不是整张图只有16个像素。
缩放规则是 value/255。逐个看:0/255=0;128/255≈0.50196;255/255=1。这样把原来的0–255范围换成0–1,保留亮暗顺序,同时让数值尺度更适合许多学习算法。
例如该图块第一行253、253、254、250,缩放后约0.9922、0.9922、0.9961、0.9804。缩放改变数值范围,不改变图像行列数;输入 (28,28),输出仍 (28,28)。
训练和预测要用同一规则。若训练时除255,预测时忘记除,模型会遇到大约255倍的输入尺度。也别无意把黑底白字反成白底黑字。以一个2×2小图为例,[[0,255],[128,64]] 除以255得到 [[0,1],[0.502,0.251]](约数),再展平得到 [0,1,0.502,0.251]。先看数值,再看形状,就能区分这两步。
784维向量与28×28×1图像:数没变,只是摆法变了
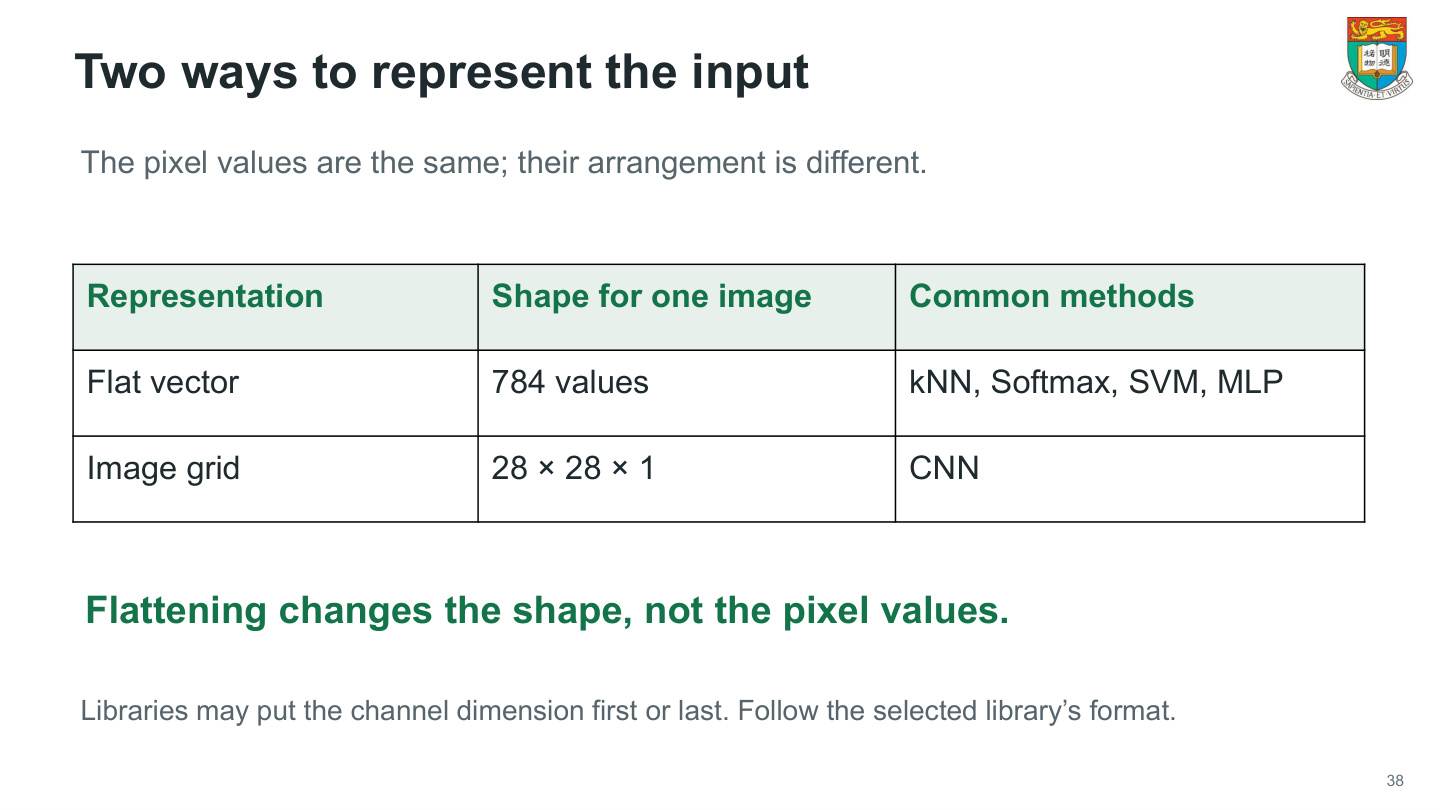
本页对比两种输入表示。平面向量把28行依次接起来,得到784个值,常用于 kNN、Softmax、SVM、MLP。图像网格保留28×28的位置关系,灰度只有1个通道,可写28×28×1,常用于 CNN。
例如:[[1,2],[3,4]] 展平后变 [1,2,3,4],仍是4个数,既没求平均,也没丢掉某个像素。只要固定相同顺序,就能知道每个值原来属于哪个位置。
一批N张图片,向量形式可为 (N,784),网格形式可为 (N,28,28,1)。一些实现把通道放前面,写 (N,1,28,28);这只是布局约定,但训练、卷积代码和预测必须一致。
从 (N,28,28) 出发,x.reshape(N,784) 把每张图变成按行排列的向量。x[..., None] 在末尾加通道轴,得到 (N,28,28,1),使卷积仍能沿两个空间方向滑动。
训练、验证、测试:三份数据各做一件事
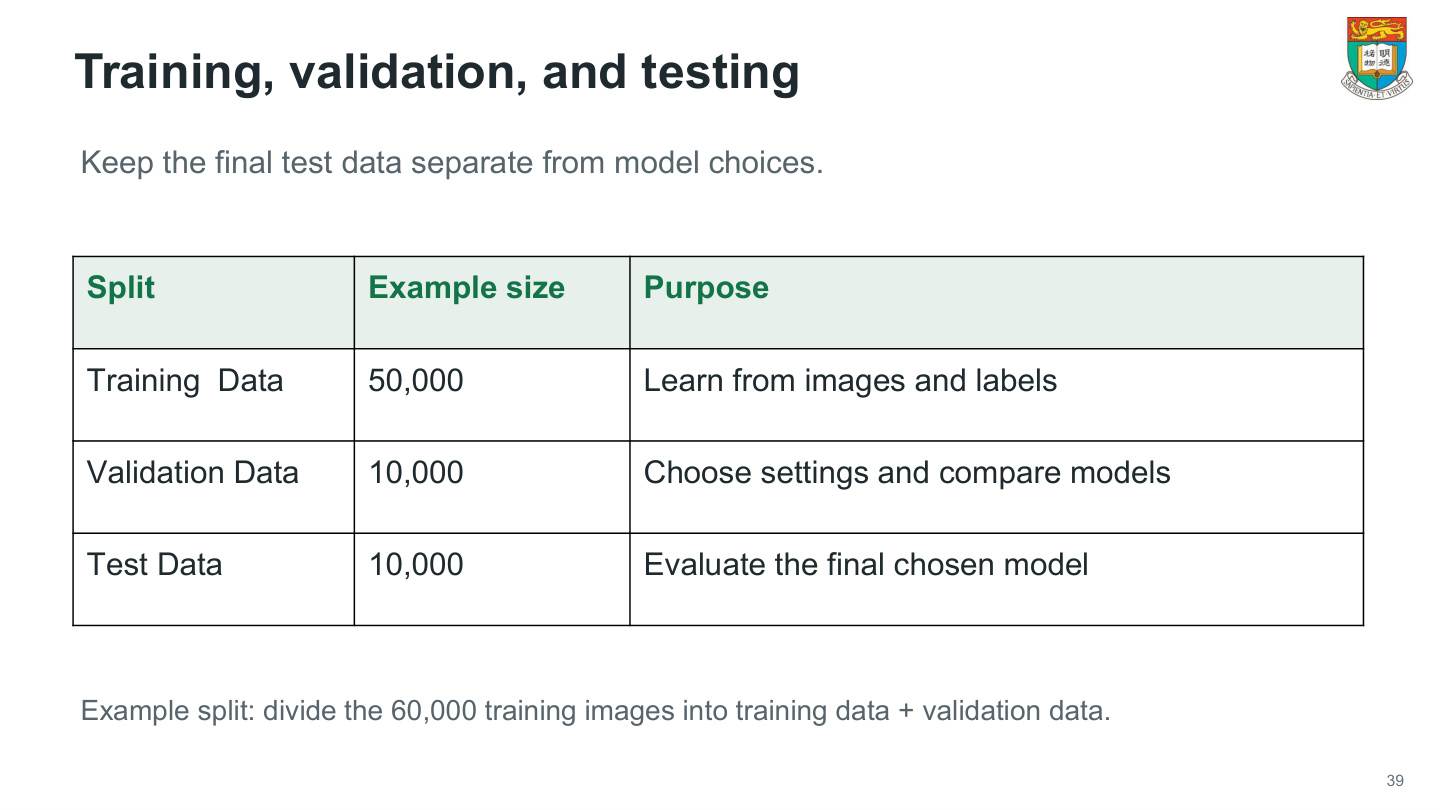
将原60,000张训练图再分为50,000张训练与10,000张验证,另外保留原10,000张公开测试。50,000+10,000仍是原来的60,000张训练图。
①训练集用于改变模型参数,例如让权重根据错误逐步更新。②验证集用于选择设置,例如 kNN 的k、MLP隐藏层大小、学习率或停止轮次。③测试集在这些选择固定后,给最终结果做一次评价。
为什么不能边看测试分数边改?你每改一次都在利用测试信息做选择,测试集便逐渐承担了验证职责,最后的测试分数不再代表完全未参与选择的数据表现。
预处理同样遵守边界:若要根据数据估计均值、方差,应从训练部分拟合,再原样应用于验证和测试;不能先在所有数据上算完再分。
练习:试k=1、3、5要看验证准确率;选好k后,才能报告固定模型的测试准确率。这样“学规则”“选规则”“检验规则”才不会混在一起。
五种识别方法:相同图片输入,不同决策规则
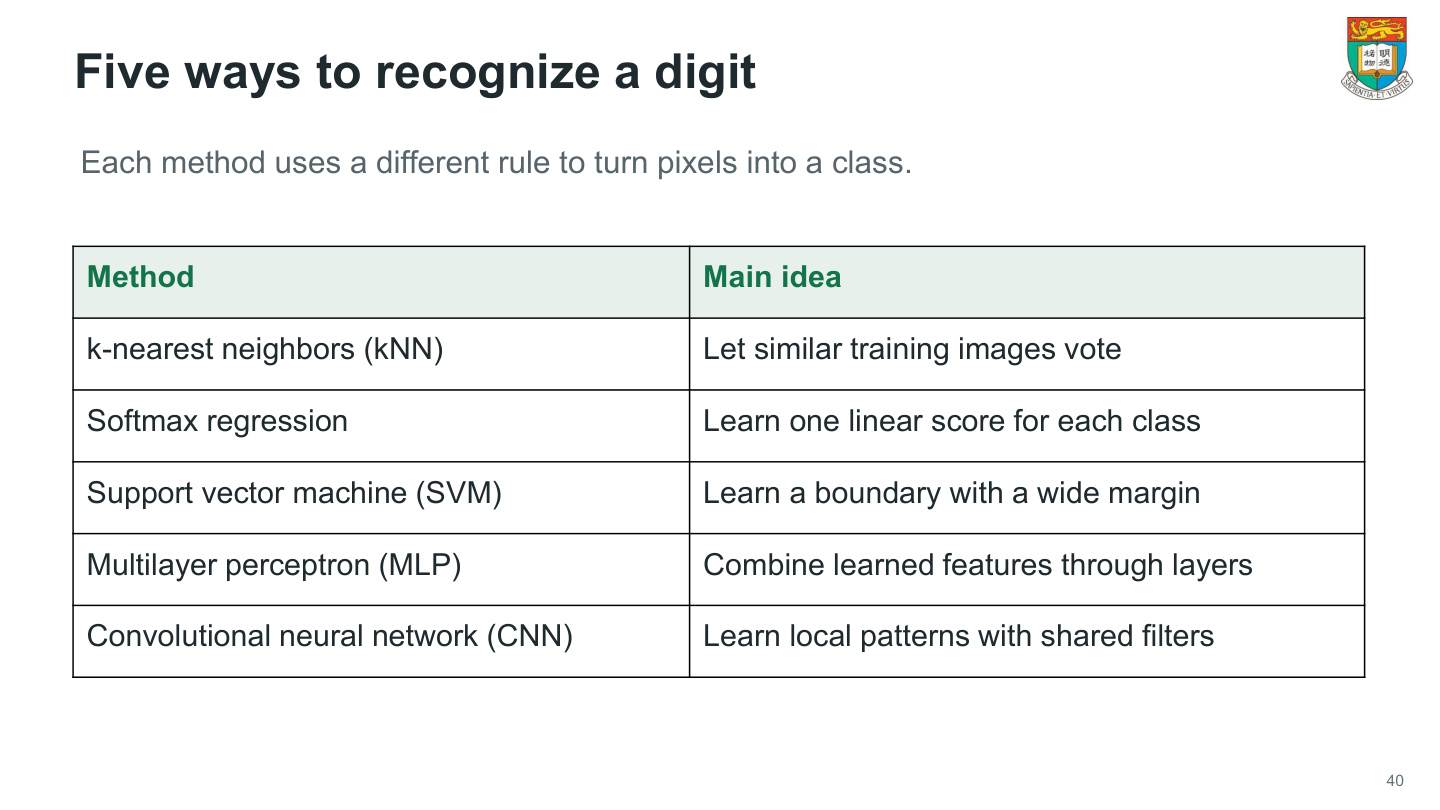
表中五种方法都回答“这张图是哪一个数字”,差别在于中间如何计算。
- kNN 保存带标签的训练图片,新图与它们比较距离,由最近k张投票;它主要依赖相似性。
- Softmax 回归 为每类学习一套像素权重,先算10个线性分数,再变成概率,选最大值。
- SVM 学习把不同类别隔开的边界,并重视边界两侧的间隔;多类需组合多个二分类器等。
- MLP 把784维输入送进全连接隐藏层,经过非线性激活,再输出10类分数。
- CNN 用共享的小卷积核扫描局部区域,保留图像空间结构,逐层学习特征。
比较这些方法时,保持相同的数据划分和评价指标,用验证结果选择适合的模型。
kNN:先算距离,再取邻居,最后投票
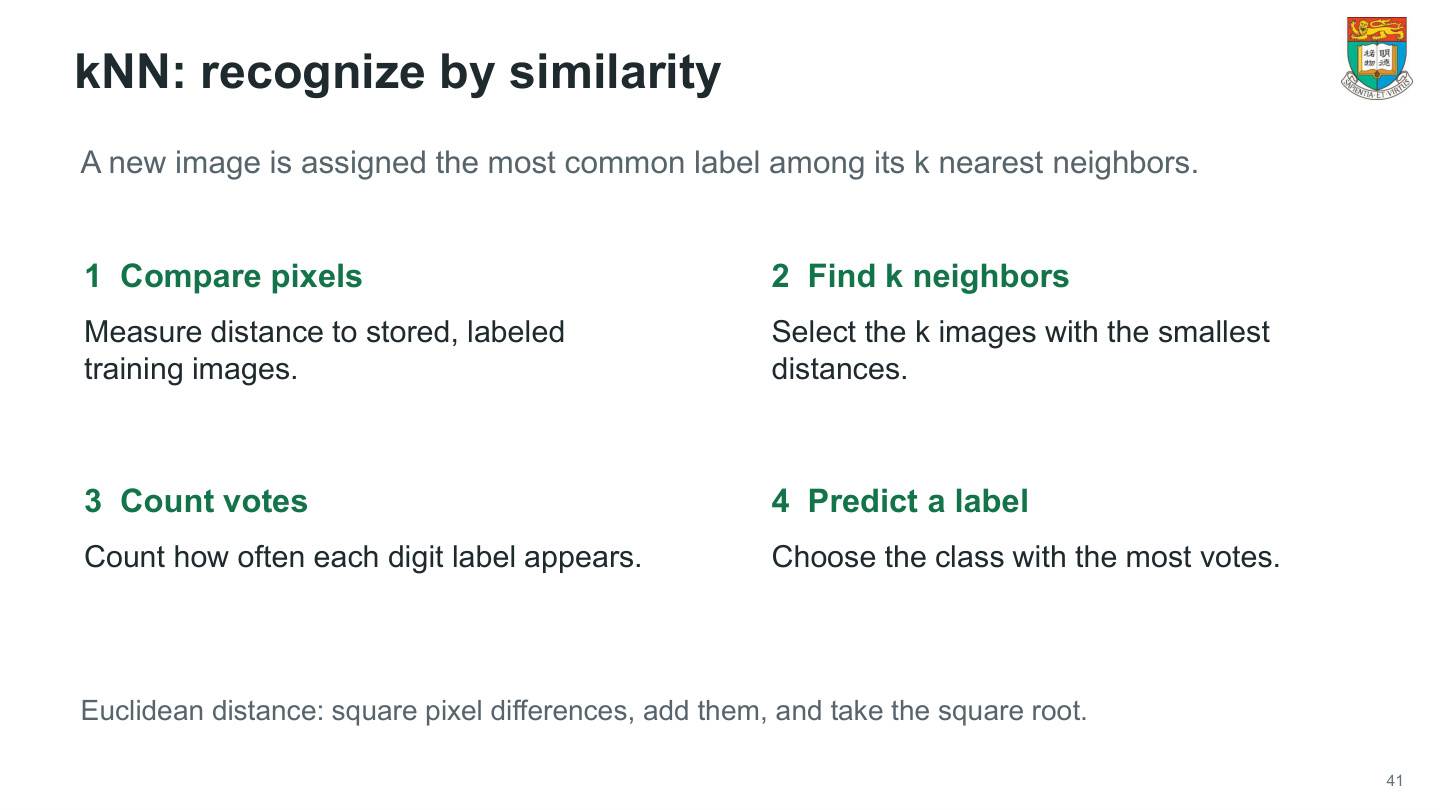
kNN 的k表示要问多少个邻居,NN表示 nearest neighbors。训练阶段通常保存带标签的参考图片;预测时才比较新图与参考图。
把两张图片都按相同顺序展成784维。欧氏距离计算为:逐像素相减→每项平方→784项相加→开平方。例如:新点 (0,1) 与参考点 (1,3) 的差为 (-1,-2),平方得1、4,总和5,距离为√5。平方和越小,两点越近;仅用于排序时,开方不会改变大小顺序。
然后把所有参考图片按距离从小到大排,取前k张,统计它们的标签。若k=3,最近三张标签为4、9、4,数字4获得2票,预测4。不是把标签算术平均得到17/3。
距离必须只用图像特征,不能把正确标签也放进距离向量。若不同位置的同一笔画被错位比较,像素距离可能变大,所以原始像素 kNN 对平移、手写风格敏感。Tutorial的Q5会继续练习二维距离和投票。
五个邻居怎样投出数字4
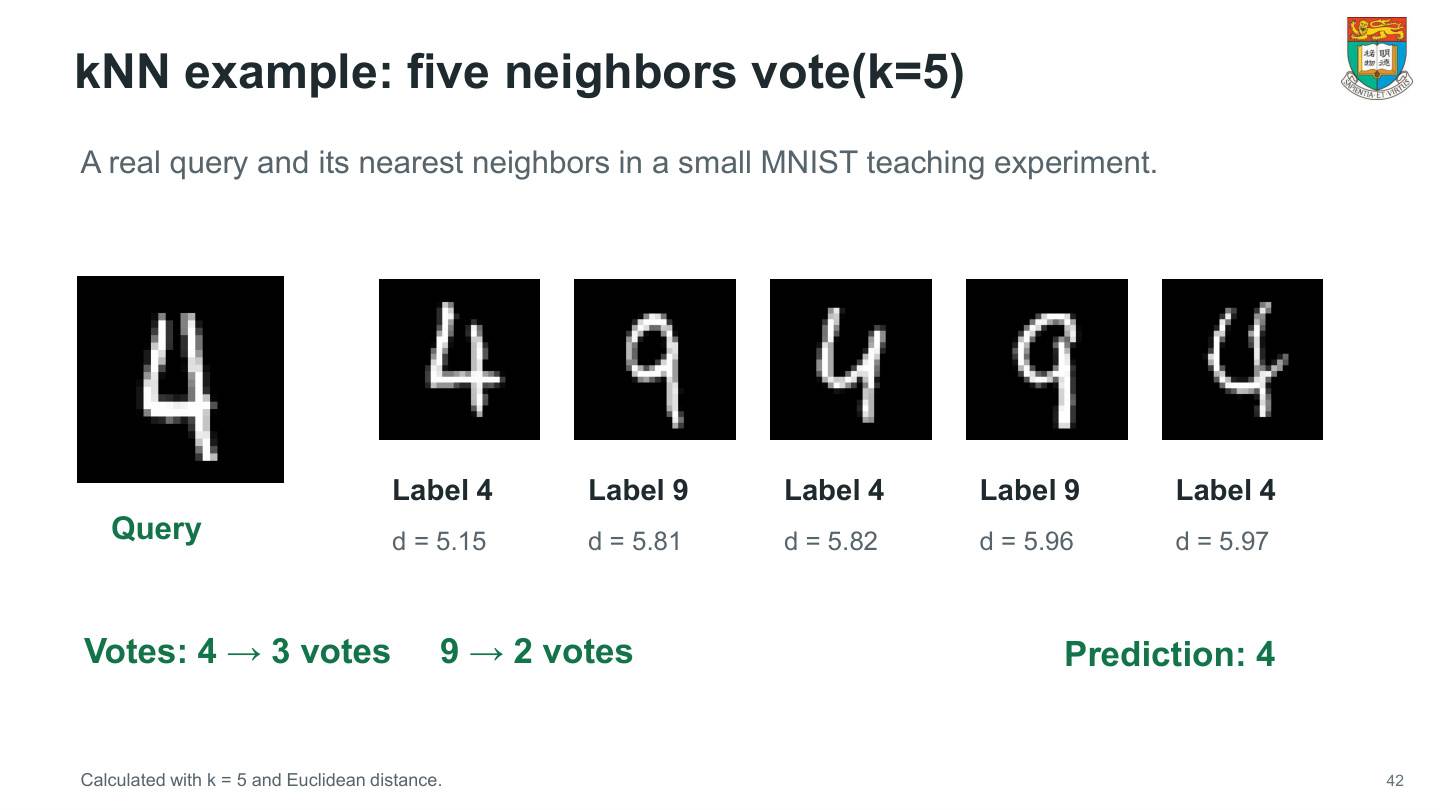
图中给出查询图片与五个最近邻。距离及标签依次为:4(5.15)、9(5.81)、4(5.82)、9(5.96)、4(5.97)。这里已经给出排序,不需要从图片肉眼猜测远近。
沿着距离从小到大累计两类的票数:
| 纳入第几个邻居 | 本次标签 | 4的累计票 | 9的累计票 |
|---|---|---|---|
| 1 | 4 | 1 | 0 |
| 2 | 9 | 1 | 1 |
| 3 | 4 | 2 | 1 |
| 4 | 9 | 2 | 2 |
| 5 | 4 | 3 | 2 |
当 k=5 时读最后一行,4以3票胜过9的2票,预测4。
投票使用离散类别,不把距离直接相加后当类别,也不把4、9、4、9、4取平均。若实现距离加权投票,那是另一条需明确说明的决策规则,不能把它与本页普通多数投票混淆。
要评价整个数据集,需要对所有测试图片重复预测,再计算准确率。练习:若k改3,前三张4、9、4,仍判4;这只说明该查询在这两个k下结果一致。
选k要看验证数据,并理解两端的风险
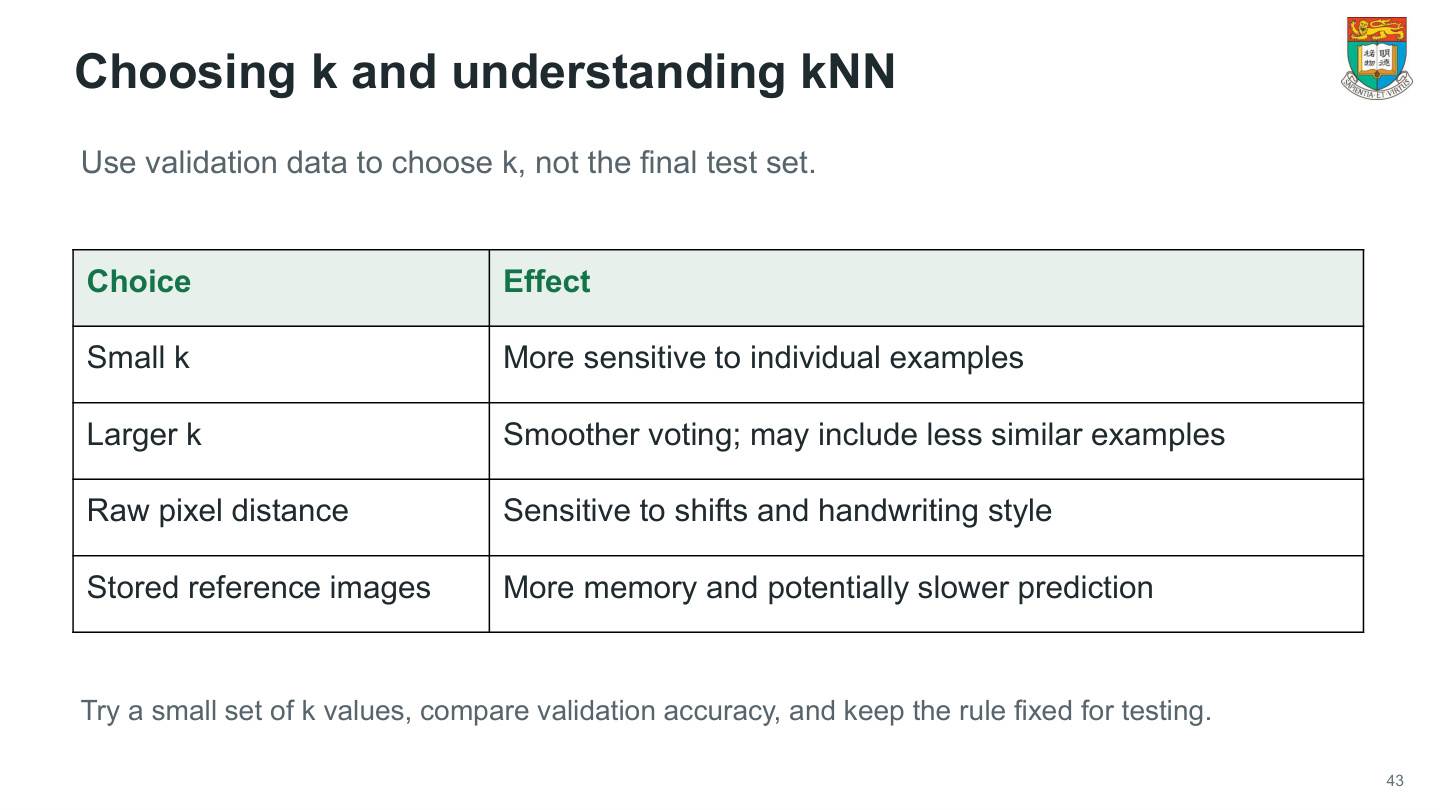
选k时,要考虑几个取舍。k小,例如1,决策高度依赖最近的单个样本;若它恰好标错或受噪声影响,新图可能被带偏。k变大,更多邻居参与,投票较平滑,但也可能把不相似的远处样本甚至其他类引进来。
具体选择流程:①固定训练参考集和预处理;②预先挑若干k候选;③只在验证集上分别计算正确预测数/验证样本数;④选定规则;⑤最后使用固定规则评价测试集。不能看测试分数后持续换k,再把最高分当作完全独立的测试结果。
像素距离还会受位置影响。一张7整体平移一格,人看仍是7,逐像素相减却会在笔画边缘产生很多差值。因此训练和预测的预处理要一致。
kNN 还需存参考图,预测通常要与许多图比较;训练步骤看似少,不代表预测不花时间。Week09 同类题里k=1、3、5的类别可以来回变化,说明“k越大越准”不是定律。
Softmax 回归:从784个像素到10个类别概率
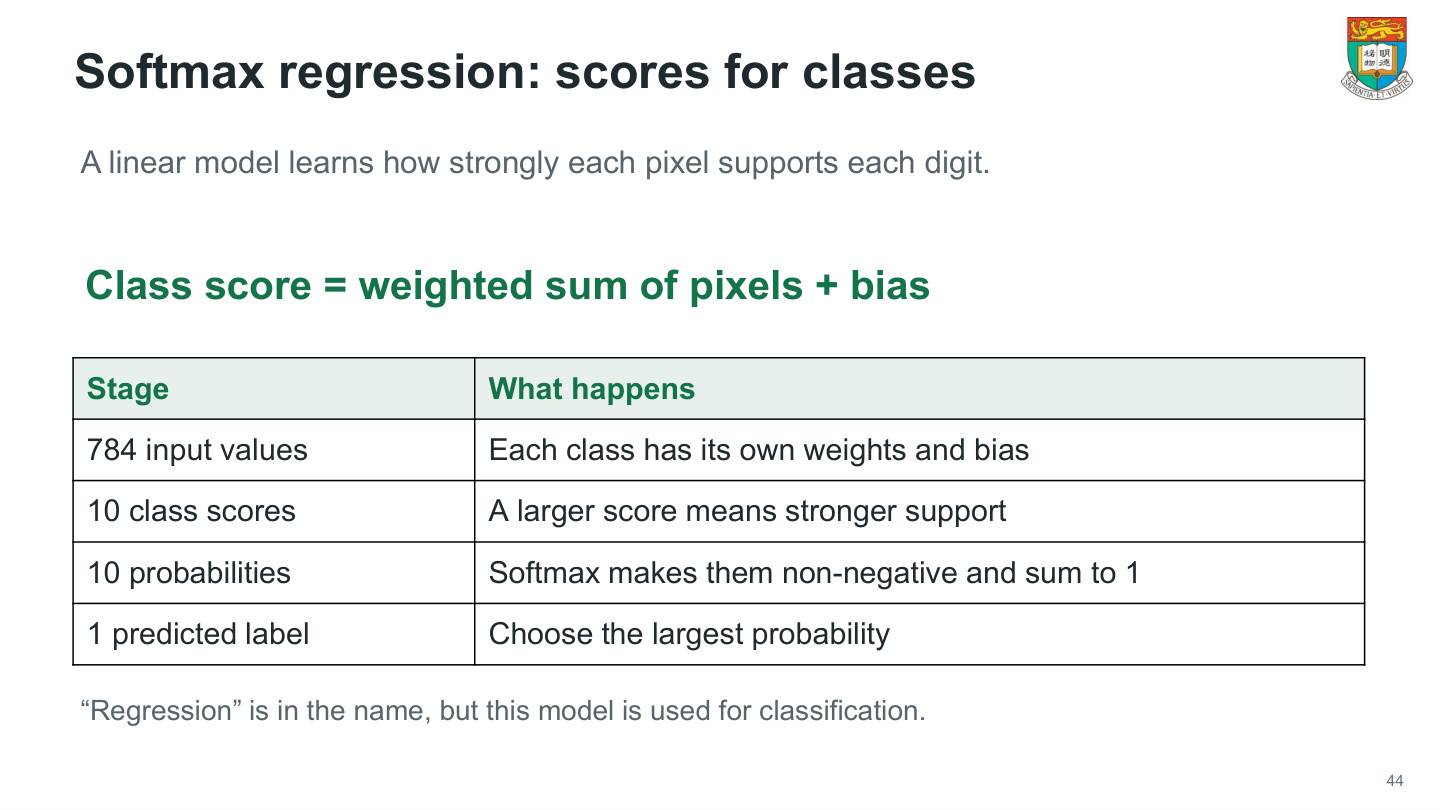
先给每一类一个分数。数字c的分数可写 s_c = w_c·x + b_c:x有784个像素,w_c也有784个权重,对应相乘再相加,最后加一个偏置。十个类别各有自己的w和b,所以得到10个分数。
若按行保存类别权重,W形状为 (10,784),单张x为 (784,),Wx+b 结果为 (10,)。权重数是10×784=7,840,加10个偏置,共7,850个可学习参数。采用列存储也可以,但维数必须一致。
接着对每个分数取指数,再除以全部指数之和。记 Z = Σ_j exp(s_j),其中 j 遍历0到9,则第 c 类的概率是 p_c = exp(s_c) / Z。每个指数为正,分母在各类之间相同,所以 Σ_c p_c = (Σ_c exp(s_c))/Z = Z/Z = 1。最后挑概率最大的类别下标作为数字预测。
名称里有 regression,但这里进行的是多类分类。它学习的是线性类别打分,不代表要预测一个可以取3.7的“数字值”。训练还需用标签定义损失并更新W、b。
Softmax 的三类手算:为什么预测7
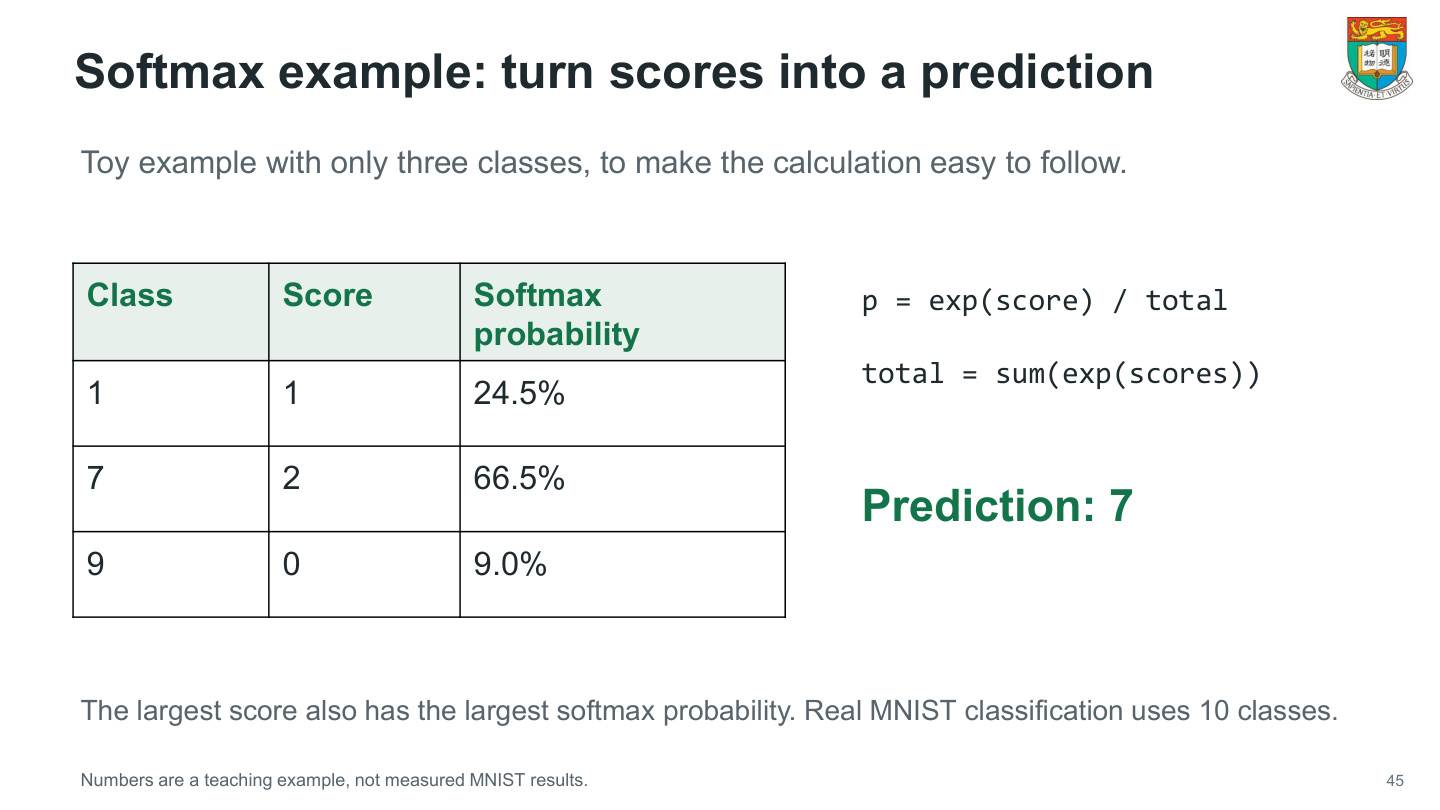
为简化运算,只用类别1、7、9,分数分别为1、2、0。MNIST使用相同算法处理10类。
按公式逐步算:exp(1)≈2.71828,exp(2)≈7.38906,exp(0)=1。分母为2.71828+7.38906+1=11.10734。类别1概率2.71828/11.10734≈0.24473;类别7概率7.38906/11.10734≈0.66524;类别9概率1/11.10734≈0.09003。转成百分比约24.5%、66.5%、9.0%,合计100%。
最大概率属于7,所以预测7。指数函数随分数增大而增大,统一分母不改变排序,因此最大分数也对应最大概率;不是因为“7这个数字比较大”。
程序中常先减去最大分数2,得到(-1,0,-2),再取指数。例如类别7变成 exp(2−2)/(exp(1−2)+exp(2−2)+exp(0−2)) = 1/(0.36788+1+0.13534) ≈ 0.66524。因为 exp(s_c−2)=exp(s_c)×exp(−2),分子和分母的共同因子 exp(−2) 抵消。减去最大分数后,最大的指数为 exp(0)=1,可避免大分数取指数时溢出。
SVM:分界线之外,还要看离最近样本有多远
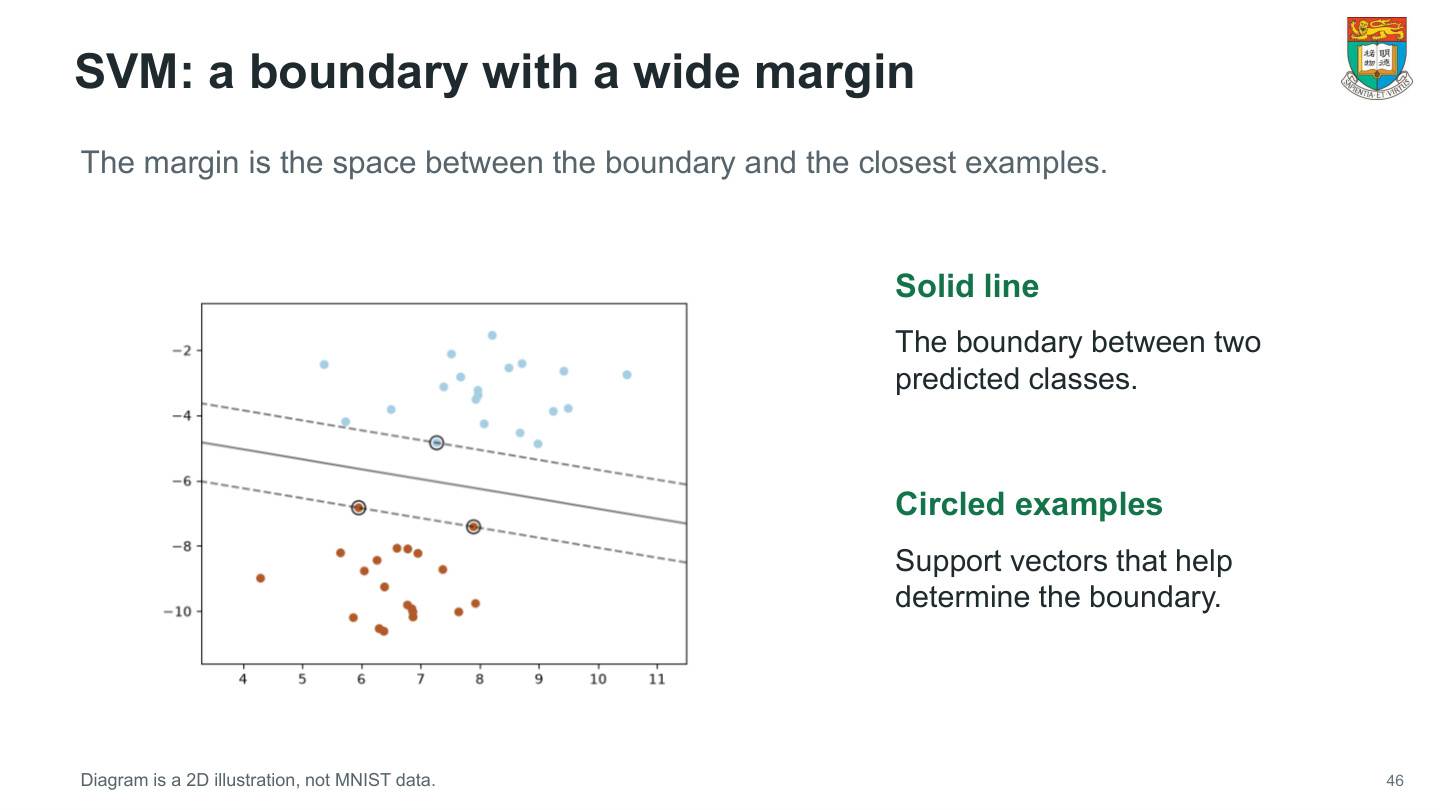
图中有两类二维点,实线是分类边界,靠近边界、被圈出的点为支持向量。先把二维图想成每个样本有两个特征,横轴与纵轴记录它的位置;点的类别由形状或颜色表示。
有许多条线可能把两组训练点分开。SVM 不只追求分开,还希望离边界最近的样本也有较大余地,即最大化间隔。支持向量就是决定这个“最窄空间”的关键样本;把它们移动,最优边界可能跟着改变。
线性边界可写 w·x+b=0。在常用规范下,两条间隔边线写 w·x+b=±1。从 w·x+b=−1 那条线,沿单位法向量 w/||w|| 走距离 d,分数增加 w·(d×w/||w||)=d||w||。走到 +1 的线需要让分数增加 1−(−1)=2,故总间隔 d=2/||w||,中线到任一边线为 1/||w||。硬间隔模型要求正确样本在各自边线外,再缩小 ||w|| 拉宽间隔。数据无法完美分开时,可用软间隔,允许部分样本违反约束。
图用二维点展示边界与间隔;MNIST有784个像素特征,对应高维空间中的超平面。
一对一多分类:10类为什么需要45个SVM
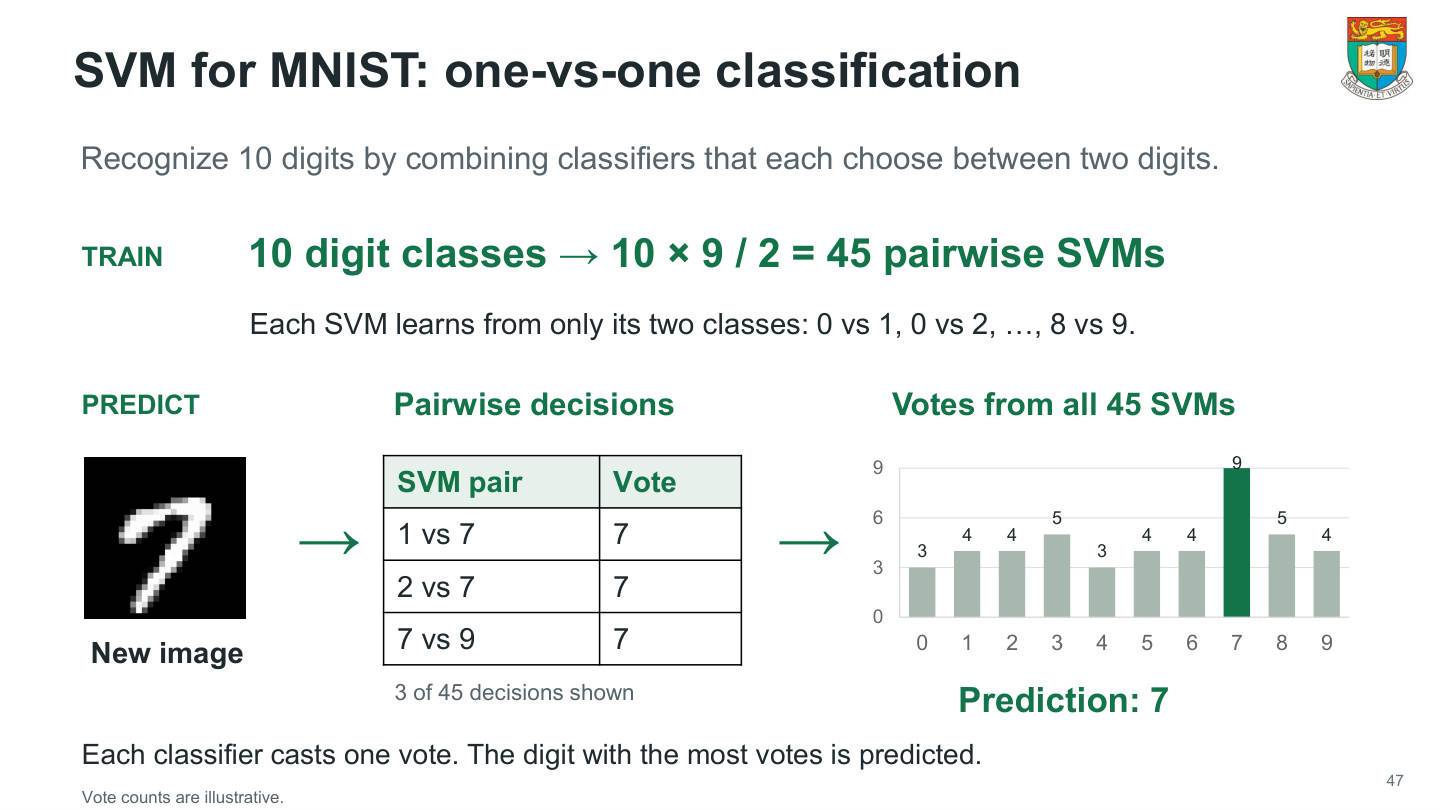
一个二分类 SVM 只能回答两类之间选谁。一对一组合的方法是:0对1、0对2……一直到8对9,每个分类器只用其两种数字训练。
组合数这样来:每个类别能与另外9类配对,先得10×9=90,但“1对7”和“7对1”是同一对,被重复算两次,所以除以2,得到45个分类器。不是10×10,也不是只训练10个。
预测新图时,每个分类器都作一次二选一并投一票。图中只展示45次里的3次:1对7选7、2对7选7、7对9选7。它们只是局部展示,不能只凭这三票代替其余42次。把全部45票按数字累计,票数最多的数字成为结果。
从柱状图按0至9读到 [3,4,4,5,3,4,4,9,5,4],加总得45票。数字7只参加与其余9类的对决,最多得9票,本图恰好9票,因此预测7。若最高票并列,程序需要事先约定如何处理。
MLP:784→128→10,每层具体在做什么
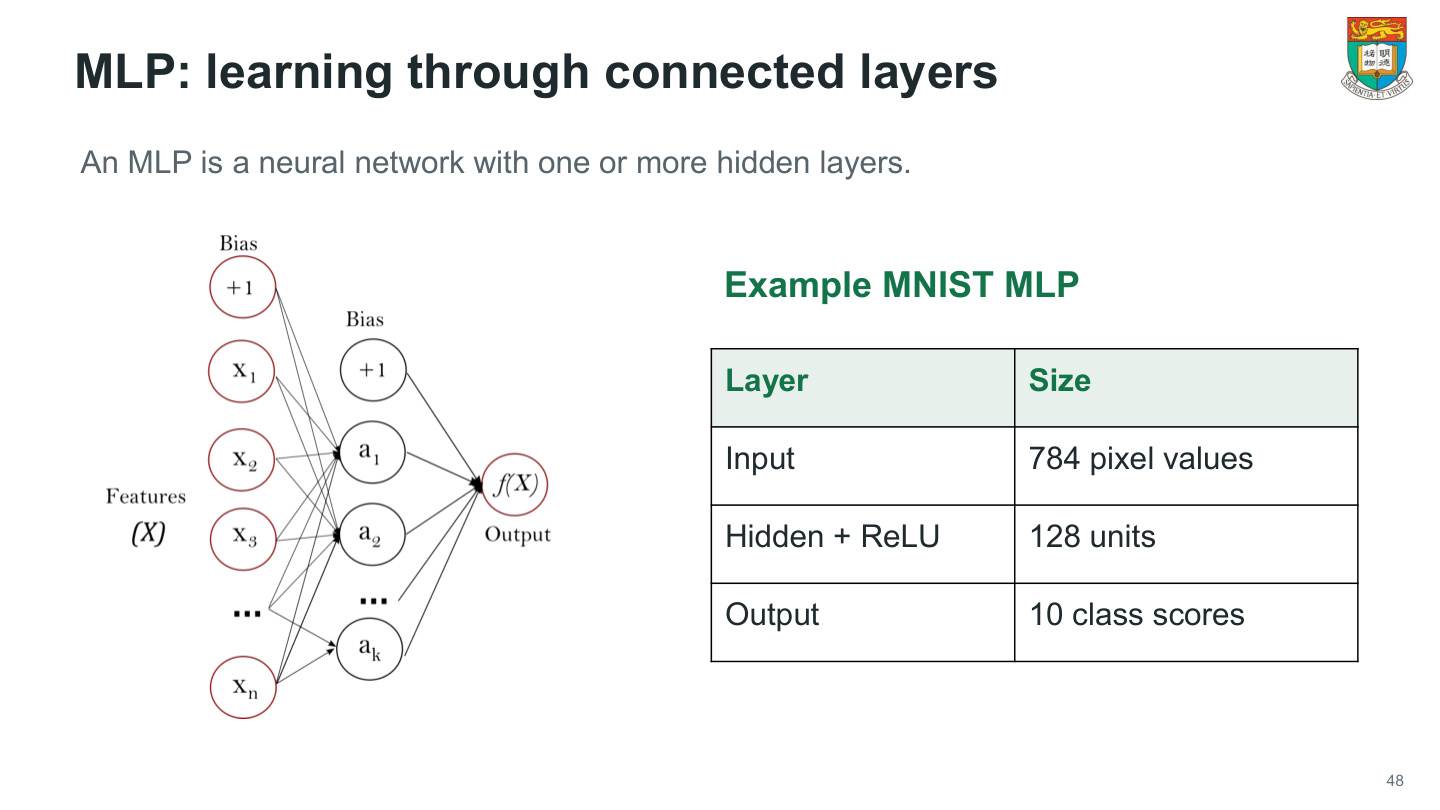
图中MLP的输入是784个像素,隐藏层128个单元并接 ReLU,输出层10个类别分数。MLP 表示多层感知机,属于全连接神经网络。
按单张图追踪:①把28×28图展平为x,形状 (784,);②计算隐藏层 a=W1x+b1,若W1按输出行存储,形状为 (128,784),结果a为 (128,);③逐项计算 h=max(0,a);④输出 s=W2h+b2,W2为 (10,128),得到10个分数;⑤需要概率时再用Softmax。
128不是从784像素中挑出128个,而是128个神经元都可以对全部784个输入加权。若两层均含独立偏置,第一层参数为784×128+128=100,480;第二层为128×10+10=1,290,总计101,770。ReLU没有额外可学习权重。
隐藏层的非线性使模型能表达更复杂的关系。若去掉 ReLU,连续两层可合成带偏置的一次变换:W2(W1x+b1)+b2 = (W2W1)x+(W2b1+b2)。乘积 W2W1 的形状是 (10,128) @ (128,784) → (10,784),又变回直接把784个输入映射成10个分数。
一个神经元:先加权求和,再做ReLU
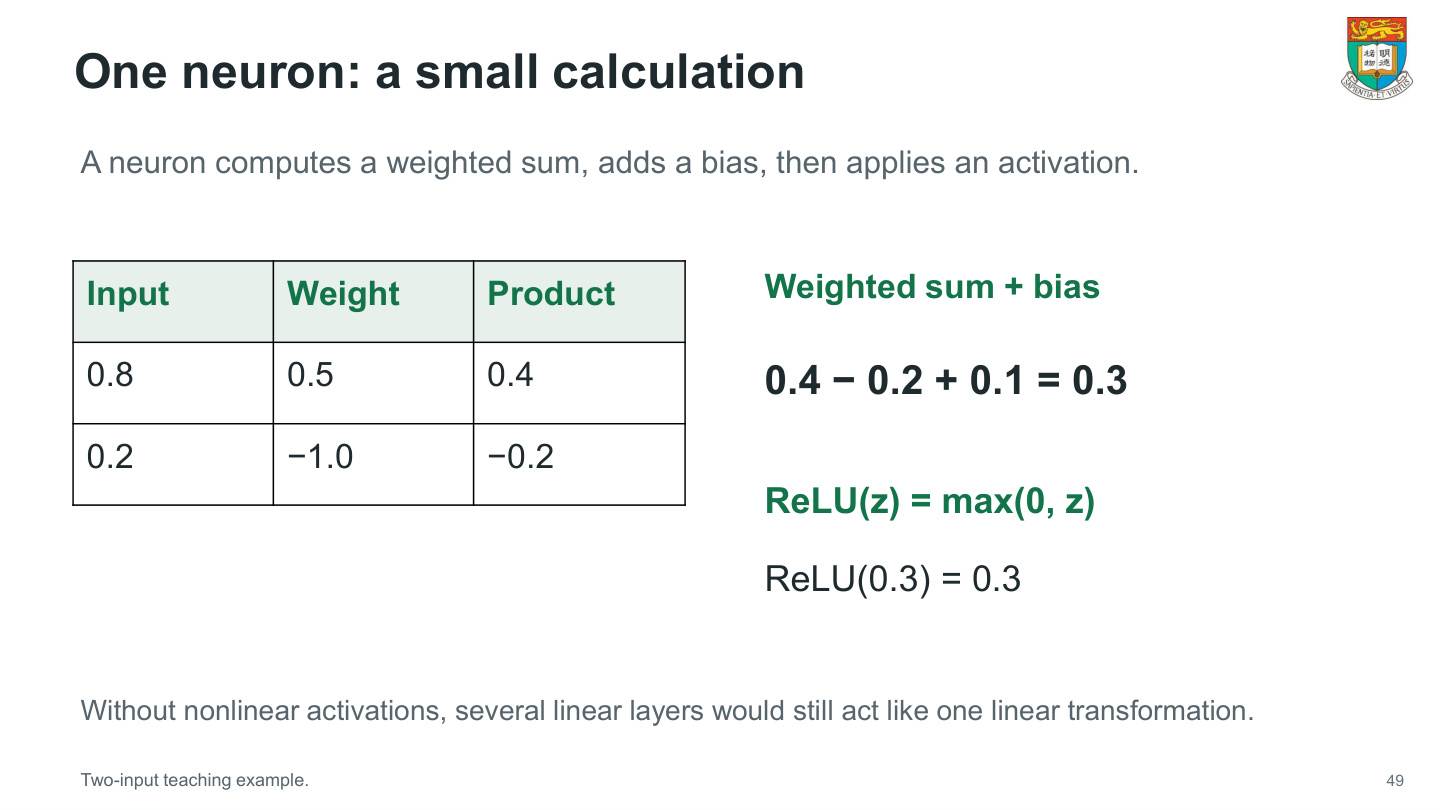
输入为0.8、0.2,权重为0.5、−1.0,偏置为0.1。不要直接把两个输入相加,先分别乘各自权重:0.8×0.5=0.4;0.2×(−1.0)=−0.2。
把乘积与偏置相加,得 z=0.4−0.2+0.1=0.3。然后计算 ReLU(z)=max(0,z):比较0与0.3,取较大者,因此输出0.3。
如果加权和是−0.3,ReLU会输出0,而不是−0.3的绝对值0.3。它不是四舍五入,也不是“低于某个可学习门槛就丢弃”,本页门槛固定为0。
为什么需要非线性?把两层展开:若第一层 h=Ax+a,第二层 y=Bh+b,代入得到 y=BAx+(Ba+b),仍只是一个线性仿射变换。插入ReLU后,不同输入可能让不同单元归零,便不能简单合并成同一条线。
本例有2个权重与1个偏置,共3个可训练参数;ReLU自身没有参数。
训练循环:预测、算错多少、求梯度、更新
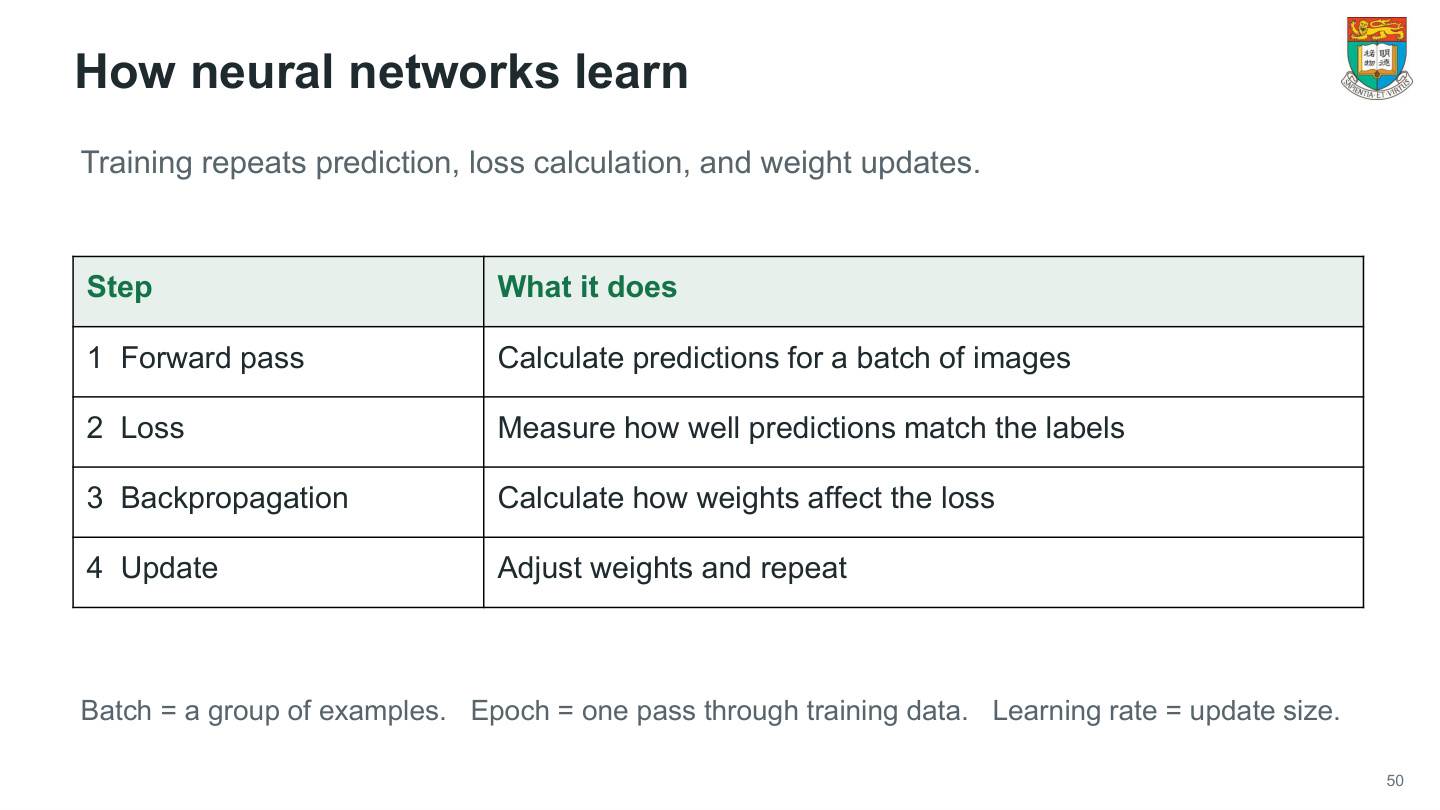
表中四步连起来才是训练。①前向传播:把一批图片送入当前网络,得到预测。②损失:将预测与正确标签比较,量化错多少。③反向传播:按链式法则计算每个参数对损失的影响,即梯度。④更新:按选定学习率修改参数,再处理下一批。
用一个参数演示更新:模型预测w,目标2,损失 L=(w−2)²。若w=1,L=1;令 e=w−2,先求 dL/de=2e,再求 de/dw=1,按链式法则乘起来得 dL/dw=2e×1=2(w−2)。代入 w=1,梯度为−2。学习率0.1时,w新=1−0.1×(−2)=1.2,新损失 (1.2−2)²=0.64,确实减小。多层网络按同样顺序连接导数。沿一条路径从损失往回乘,便能算出上游参数对损失的影响。若一个参数同时影响多条路径,就加总各条路径的贡献。
Batch是一组一起处理的样本;epoch是完整看过一遍训练集;learning rate控制更新步长。假设训练集100张、batch大小20,样本索引依次为0–19、20–39、40–59、60–79、80–99。每批更新一次,这5次更新合为1个epoch。
验证阶段可以做预测和损失计算,但不根据验证样本更新权重。本作业还要求自己实现适用的梯度和更新,不能用自动求导把关键步骤隐藏起来。
CNN:同一个小滤波器怎样扫描整张图
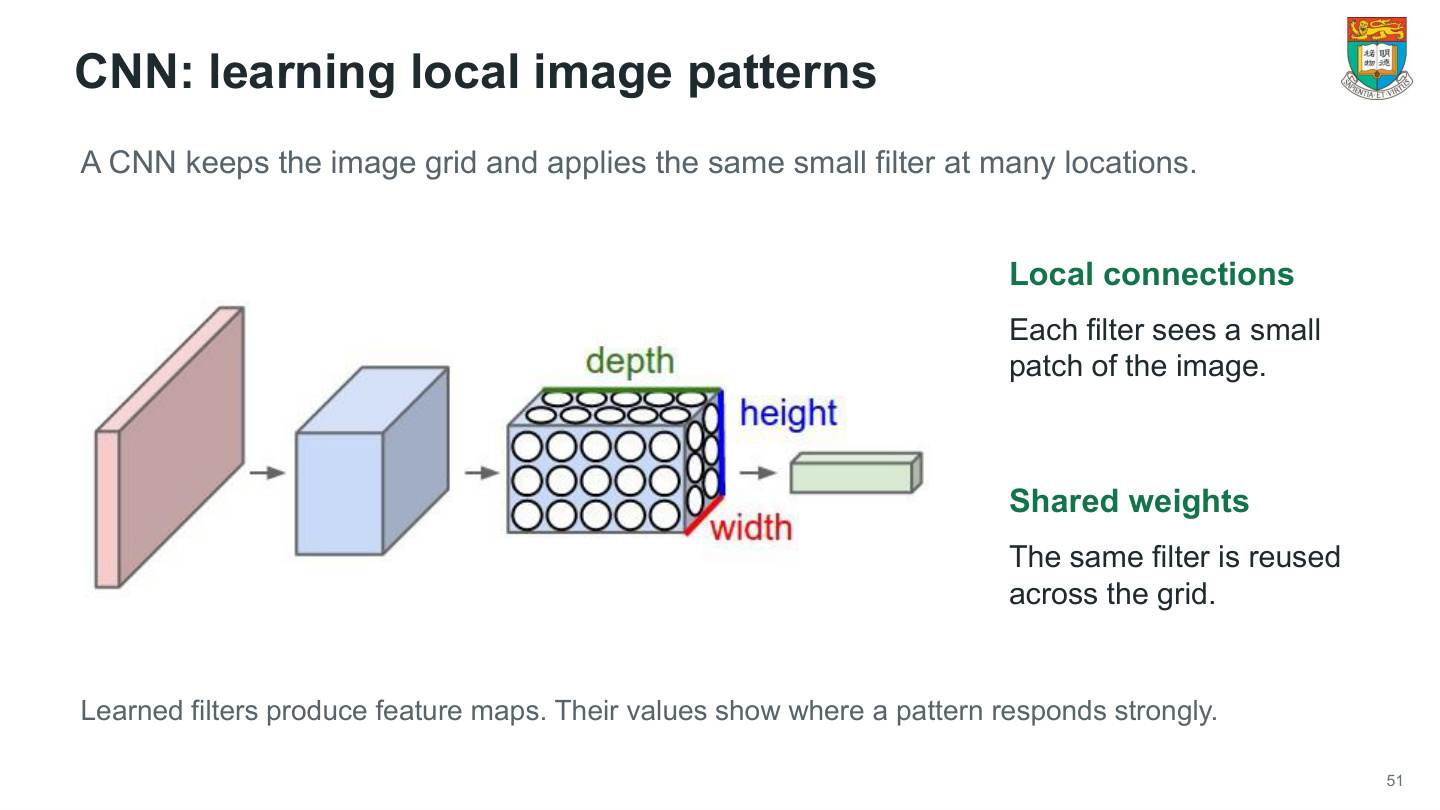
CNN保留图像行列关系。图中小区域表示局部连接:一个输出值先只查看输入中的一个小块,而不是一下连接全部784个像素。小块上的权重排列称为卷积核或滤波器。
共享权重的意思是:核移动到右边或下一行时,继续使用同一组权重。这让模型能在不同位置检测类似笔画,也减少参数。不是每滑到一个位置就新建一套互不相关的权重。
例如灰度输入、3×3核有9个权重,通常再加1个偏置。这10个参数会在整个空间重复使用。多个不同核可以分别学到不同局部模式,每个核输出一张特征图;8个核便产生8个输出通道。
特征图每个位置的数值表示该核在那里作出的响应,不是直接给出数字标签。之后还可接激活、池化与分类层。训练通过损失梯度调整核权重,让不同核学到适合任务的局部模式。
卷积局部计算:四个位置一一相乘,不翻核
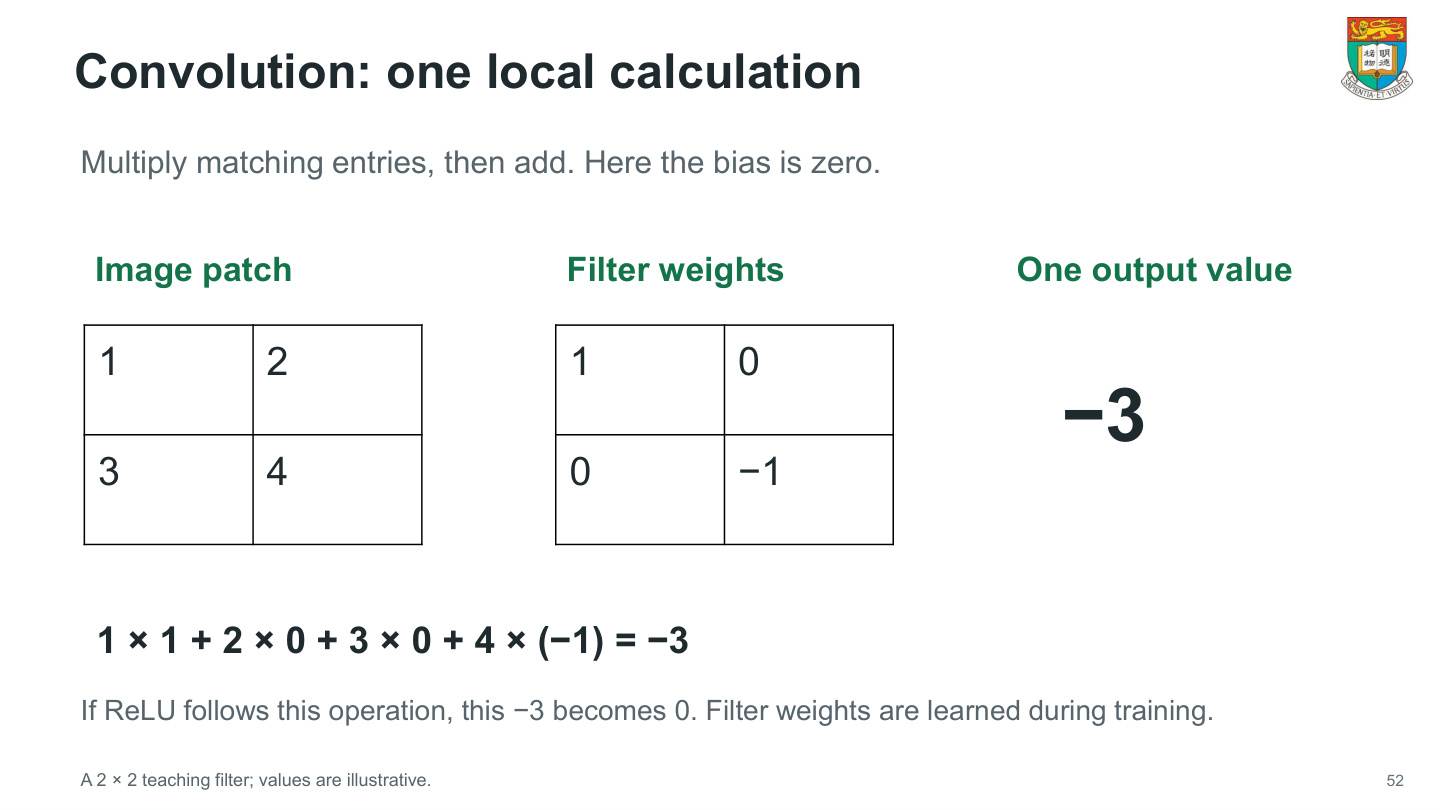
图像块为 [[1,2],[3,4]],滤波器为 [[1,0],[0,−1]],偏置为0。把对应位置相乘再求和:
- 左上:1×1=1。
- 右上:2×0=0。
- 左下:3×0=0。
- 右下:4×(−1)=−4。
- 相加再加偏置:1+0+0−4+0=−3。
所以该位置的输出是−3。若紧接ReLU,取 max(0,−3)=0。滤波器含负权重并不表示非法,它能让某些亮度模式增加响应、另一些降低响应。
这里按CNN常用互相关习惯,不翻转核。数学卷积的翻转定义与实际CNN计算约定需要区分,不能把Lecture7里连续卷积的翻转步骤强行加入这道图像乘法。
这只是一个2×2图块对应一个输出位置;若原图更大,还需移动窗口,分别计算每个位置。Tutorial的Q2用4×4图和bias=−1,逐项计算全部9个输出。
最大池化:四个窗口分别取最大值
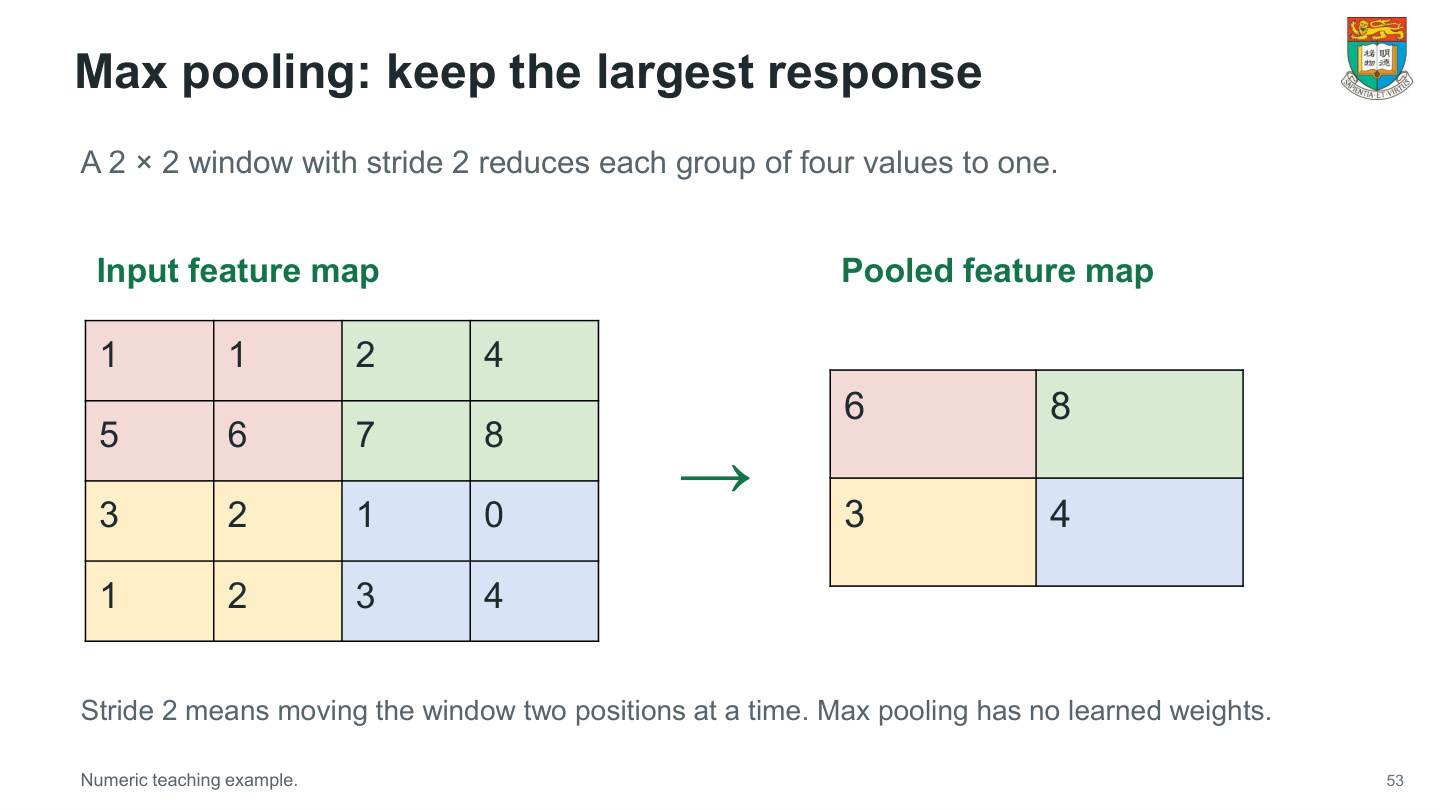
输入特征图为:
1 1 2 4
5 6 7 8
3 2 1 0
1 2 3 4
2×2窗口、stride=2,表示一次看2行2列,每次向右或向下移动2格,因此窗口不重叠。
①左上窗口 [1,1;5,6],最大为6。②右上窗口 [2,4;7,8],最大为8。③左下窗口 [3,2;1,2],最大为3。④右下窗口 [1,0;3,4],最大为4。按原窗口位置排列,输出为 [[6,8],[3,4]]。
窗口左上角在每个轴上可从下标0或2开始。公式写成 floor((4−2)/2)+1=2,其中减2留足窗口的宽度,除2按步长计数,最后加1把起点算进去。两轴各有2个位置,得到2×2。整个过程只比较格子的值,参数数为0。
stride与窗口大小是两个独立设置,不能看到2×2池化就自动认定stride必为2。Week09 Tutorial恰好使用2×2窗口、stride=1,窗口会重叠,结果不同。分别看清“取最大值”和“窗口怎样移动”这两件事。
一个小CNN:每一层的尺寸和参数怎么来
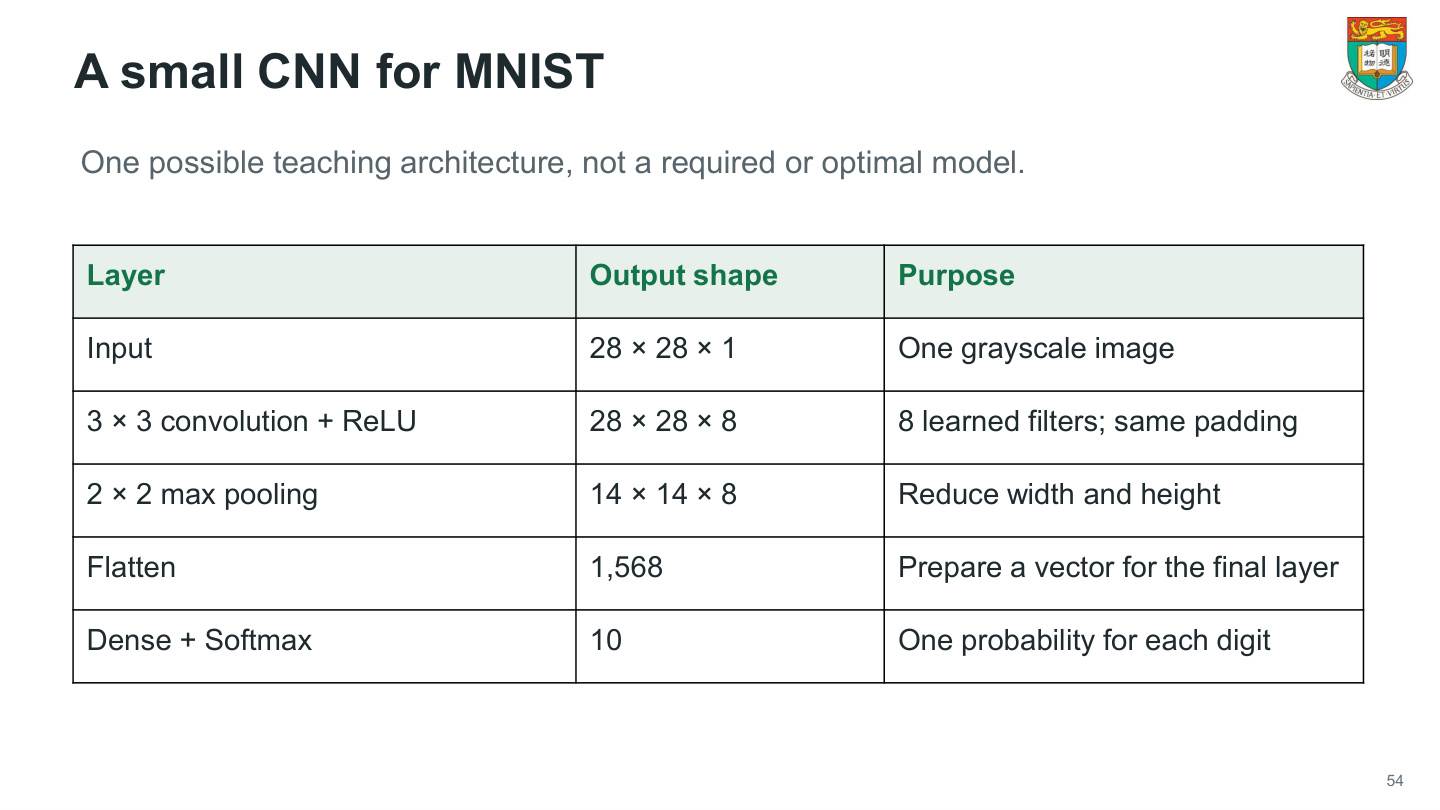
图中结构为输入28×28×1→3×3卷积+ReLU→28×28×8→2×2最大池化→14×14×8→Flatten1568→Dense+Softmax10。
①输入是灰度图,通道数1。②8个卷积核各输出一个通道;stride=1且使用same padding,3×3核在四周补1圈,所以每边 (28+2−3)/1+1=28。若卷积与全连接层均有独立偏置,每核3×3×1=9个权重加1个偏置,8核共80个参数。
③池化窗口2×2、步长2,逐个通道处理。单边的合法起点是0、2、…、26,共 floor((28−2)/2)+1=14 个。每个通道都变14×14,通道数仍为8。④Flatten把所有值接成向量:14×14×8=1568;这一步只改形状,不再学习参数。⑤全连接到10类,参数数1568×10+10=15,690。合计80+15,690=15,770;ReLU、池化和Softmax没有这些形式的可学习权重。
输出10个概率后,最大项对应预测数字。这里的尺寸按单张图写,批量时还会多一个样本轴。调整核数、池化和隐藏层时,也按这个顺序重新计算形状和参数数。
准确率:先数对几张,再除以总张数
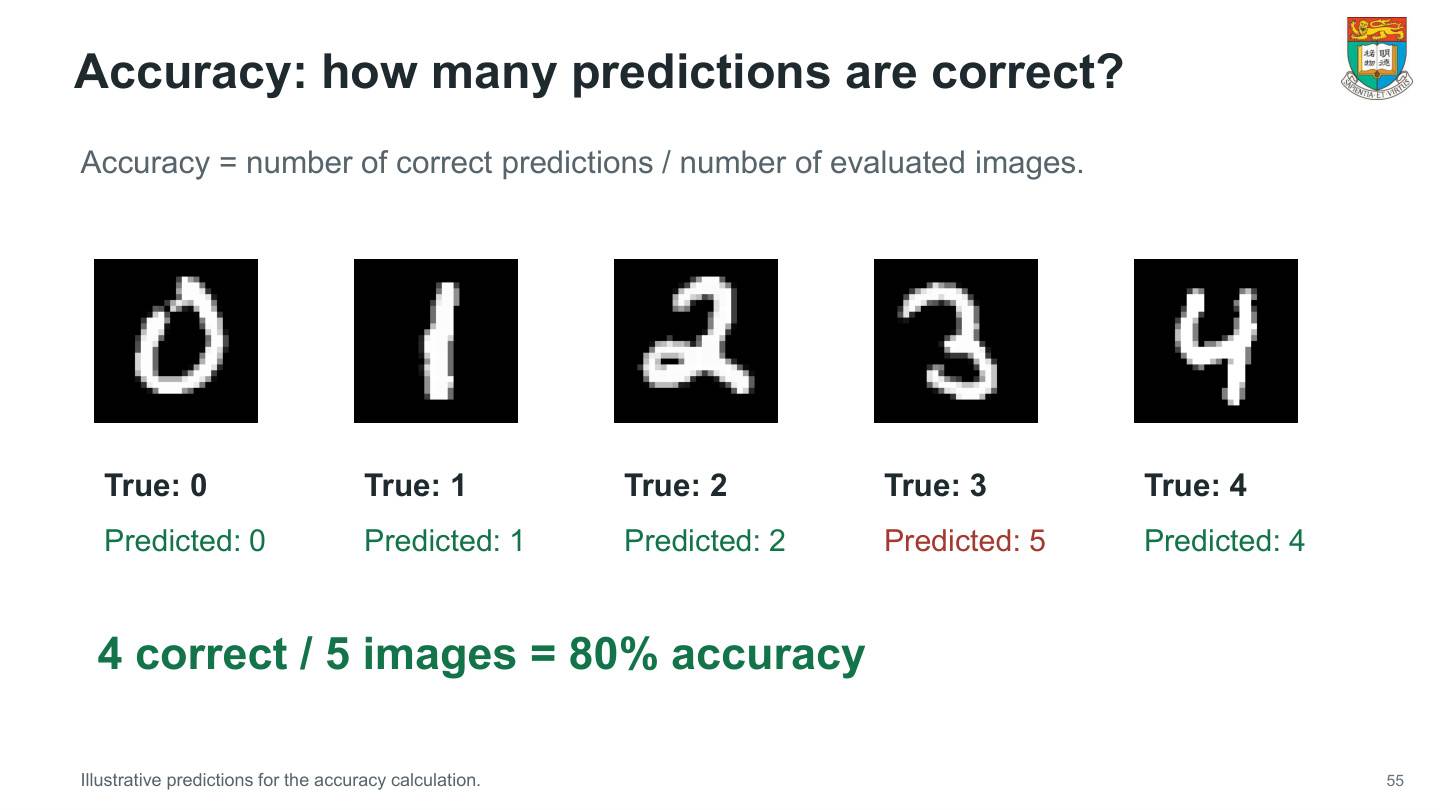
图中5张图片真值依次为0、1、2、3、4,预测依次为0、1、2、5、4。逐张比较:第1张对,第2张对,第3张对,第4张真值3却预测5,错,第5张对。
正确数为4,总数为5,因此 accuracy=4/5=0.8=80%。分母包含所有被评价的图片,不能把错的那张先删掉再算4/4。
准确率只问类别是否一致。3误判为5,与3误判为4,在这项指标中都算一次错误,不按数值距离扣分。反过来,即使预测概率只有0.4,只要它是最大项且类别正确,这张在准确率里仍算对。
单张预测对不对是0或1,整个数据集准确率才是这些指示值的平均。
练习:若100张预测对93张,准确率93%;若遗漏7张文件,只对剩下93张报100%,就没有完整评价100张任务。预测CSV必须覆盖所有输入图像,后面会讲格式。
交叉熵:为什么真类概率越小,损失越大
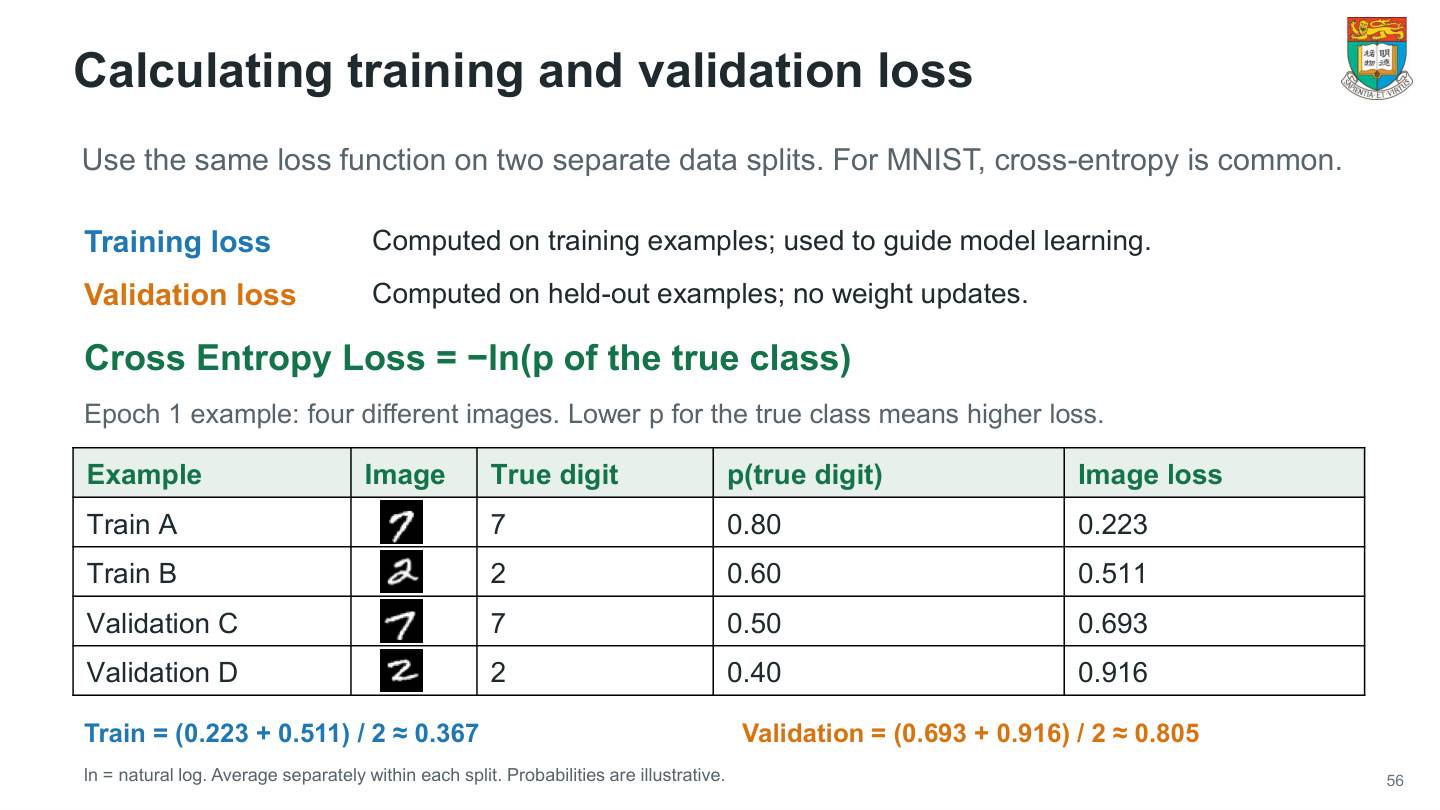
多类交叉熵 L=−Σ_c y_c ln(p_c) 中,p_c 是模型给第 c 类的概率,y_c 是真实标签的独热编码。若真值为7,则 y_7=1,另外9项都是0。求和只剩 L=−1×ln(p_7)=−ln(p_7)。所以始终读真类的那一格。ln 表示自然对数。
训练样本A真值7、p=0.80,损失 −ln(0.8)≈0.22314;训练B真值2、p=0.60,损失≈0.51083。训练平均 (0.22314+0.51083)/2≈0.36698,约0.367。
验证C真值7、p=0.50,损失≈0.69315;验证D真值2、p=0.40,损失≈0.91629。验证平均 (0.69315+0.91629)/2≈0.80472,约0.805。两组分开求平均,不把四张混成一个数。
当p接近1,ln(p)接近0,损失小;当p接近0,负对数变大,因此自信地排斥正确类别会受到较大惩罚。准确率和损失反映不同方面:分类没变,真类概率从0.6升0.8,准确率可能不变,损失却改善。
训练损失用于求梯度更新;验证只评价,不更新。
取得MNIST的NPZ文件:一个压缩包里有图和标签
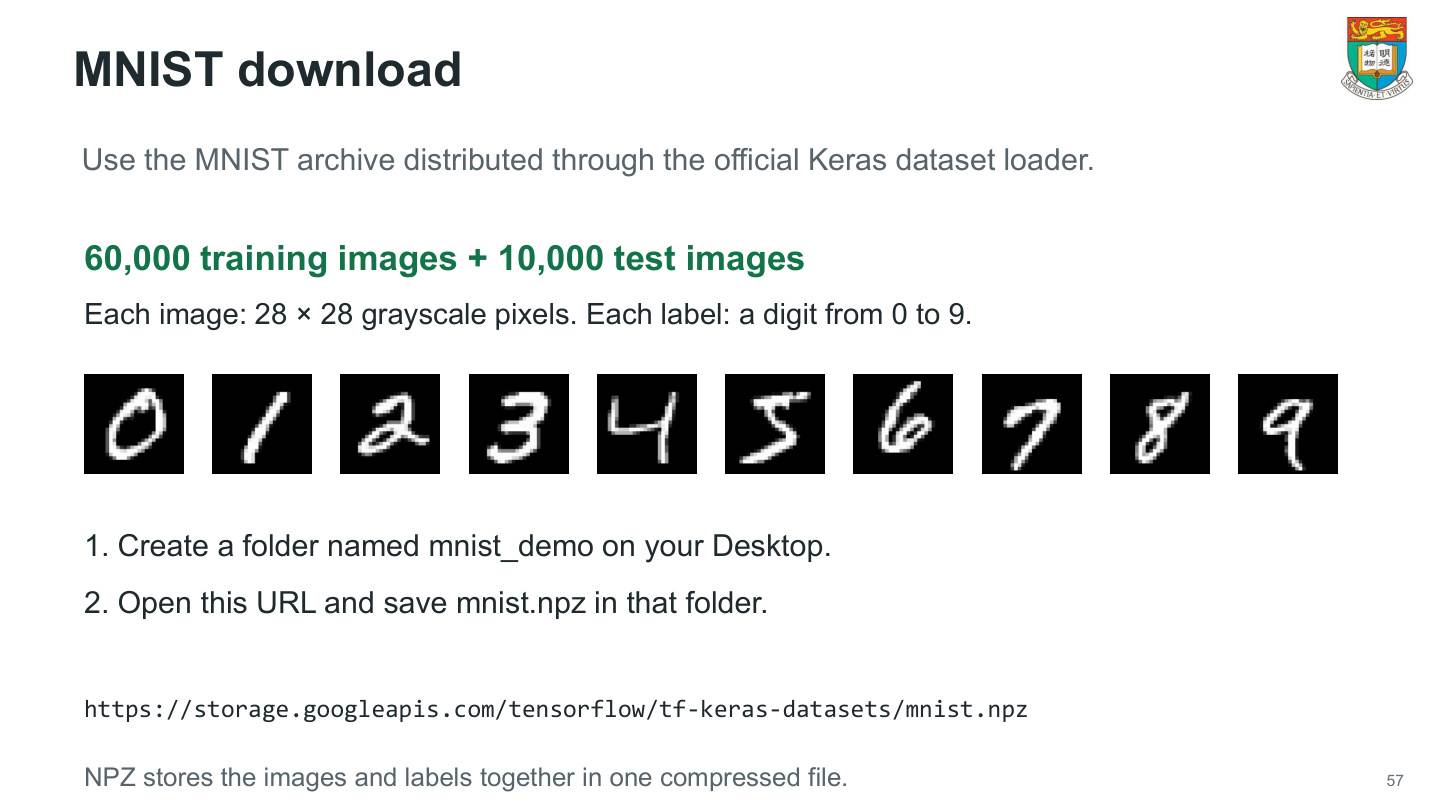
使用 Keras 数据加载器所分发的 mnist.npz。NPZ是NumPy数组的压缩存储格式,可以把多份数组装进同一文件;它不是一张图片,也不是把文件扩展名改成PNG就能查看。
先建 mnist_demo 文件夹,再把给定地址的文件保存为 mnist.npz。其中训练图片应为 (60000,28,28),训练标签为 (60000,),公开测试图片为 (10000,28,28),测试标签为 (10000,)。
这四份数组一一配对:x_train[i] 对应 y_train[i],x_test[i] 对应 y_test[i]。标签是0–9的整数,像素为0–255的灰度数值。后面脚本会将其导出成人易查看的PNG和CSV。
NPZ用于保存数组,读取它只需要NumPy;训练算法仍由自己的代码实现。报告中记录数据集来源。
导出图片所需环境:NumPy读数组,Pillow写PNG
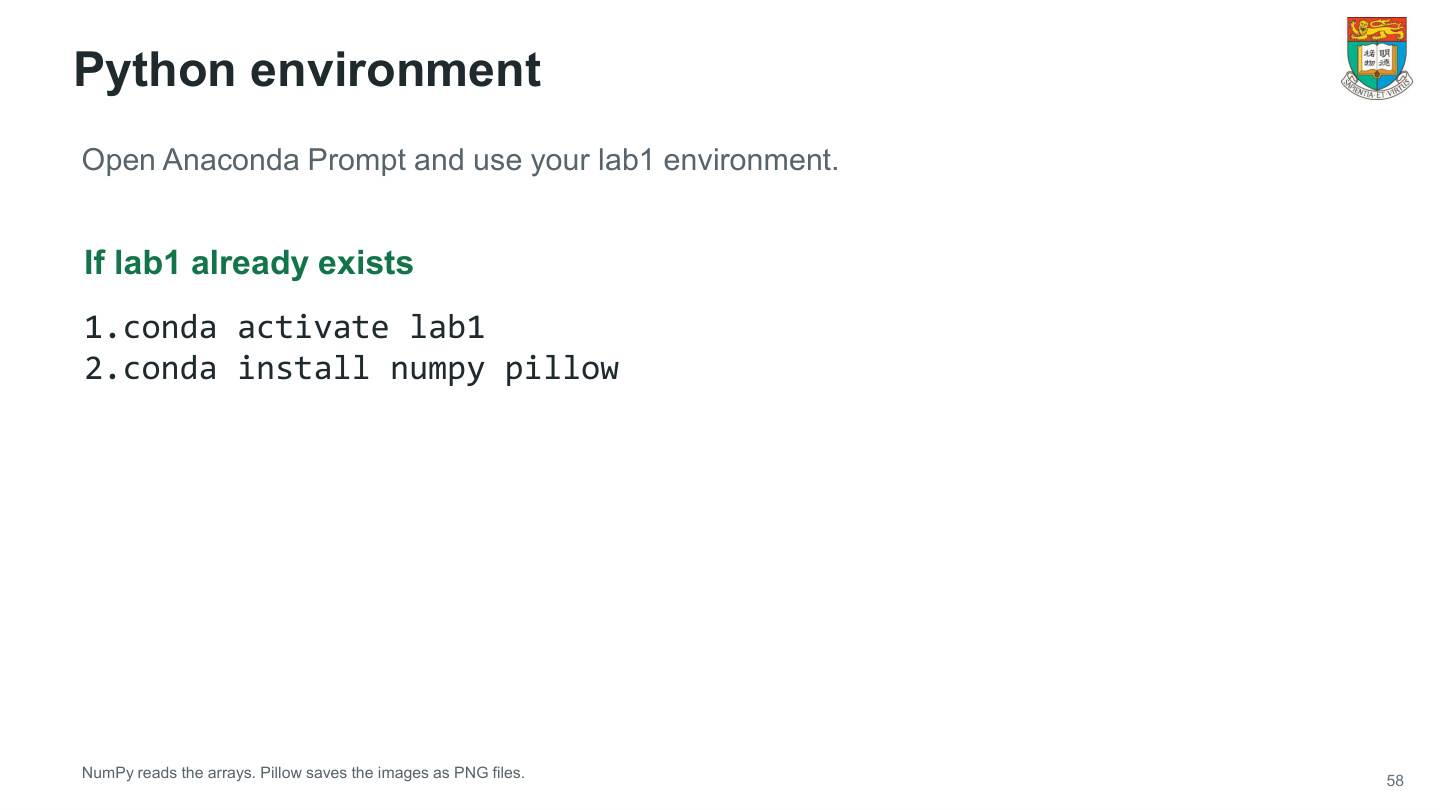
已有lab1时,输入:
conda activate lab1
conda install numpy pillow
第一行选择课程环境;第二行安装两个包。NumPy读NPZ中的数组,Pillow负责把二维像素写成图片。这些是数据处理工具,不替你完成核心分类算法。
包的安装名与导入名可能不同:Pillow在程序中常写 from PIL import Image;不是因为代码写PIL,就还要随意另装一个名字相近的包。Image用于读写图像,np.array用于把图像与数值数组衔接起来。
例如一份 (28,28)、类型 uint8 的数组能直接表示0–255灰度像素。保存成PNG后,人可以查看;再次读取后,模型又能处理数值。保存PNG并不会自动生成正确类别,标签仍需要单独保存并按文件名对应。
若脚本在导入PIL时报错,先核对它是否装在运行脚本的同一个lab1环境中。
执行prepare_mnist:从NPZ导出70000张图片
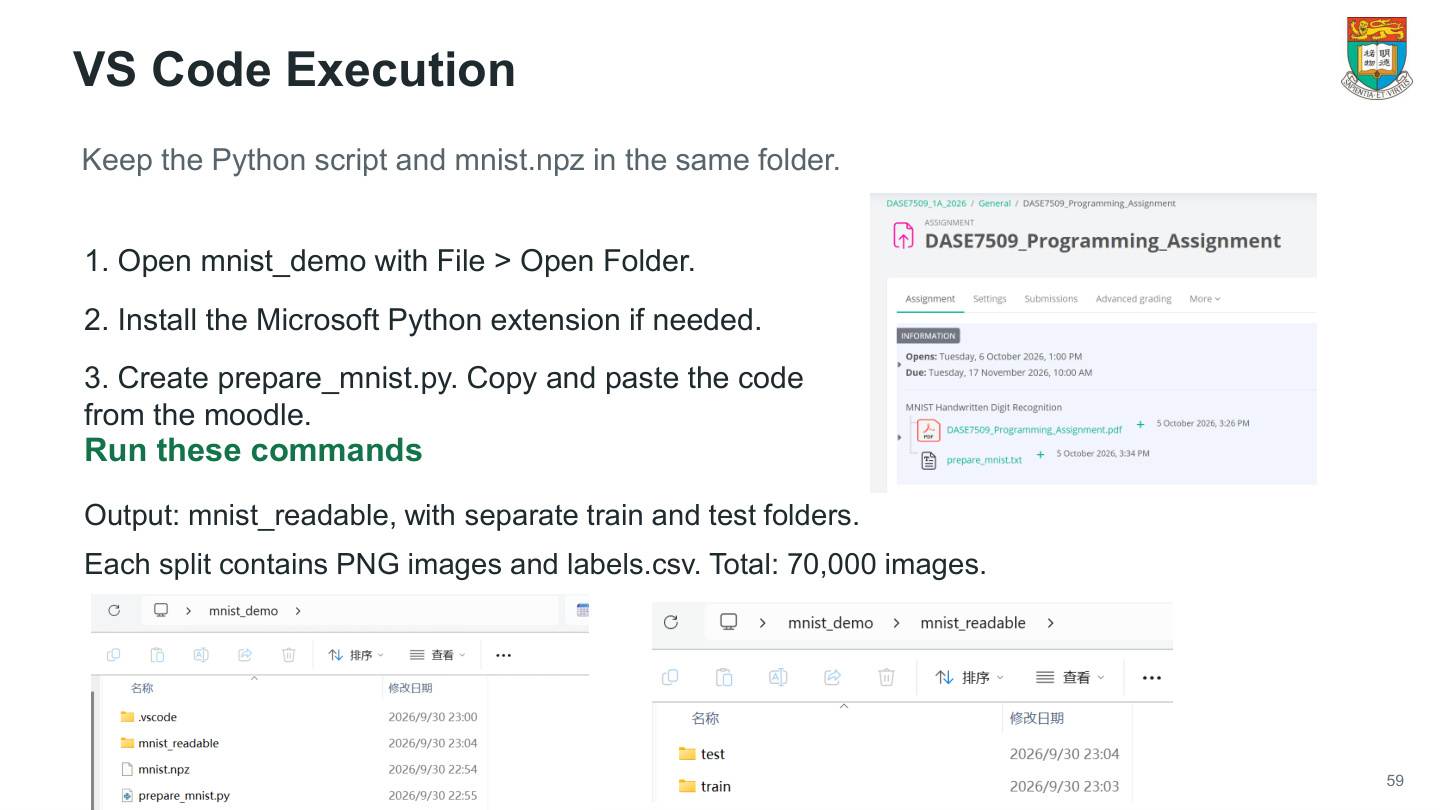
将mnist.npz和配套代码放在同一mnist_demo文件夹。用VS Code打开它,把代码保存为prepare_mnist.py,然后在该文件夹的终端输入:
python prepare_mnist.py
python prepare_mnist.py --limit 20 --output mnist_preview
两行是两种运行方式。第一行默认导出全部到 mnist_readable。第二行把训练集与测试集各自的前20张导出到 mnist_preview,共40张;另有脚本为首图生成的辅助文件。
配套脚本的处理链逐段如下:①导入Path、下载、命令行、CSV、哈希及NumPy/Pillow工具;②定义URL、SHA256和脚本目录BASE;③sha256每次读1MB字节更新摘要,用来检查文件内容;④get_archive在文件缺失时下载到临时.part文件,校验后再改为正式名,已有文件也校验;⑤main读取--input/--output/--limit参数;输出目录已存在时主动报错,避免混入旧结果;⑥np.load(...,allow_pickle=False)取出四份数组,检查shape与uint8类型;⑦main() 依次调用 export_split 导出训练集,再导出测试集。在训练集的第一轮循环,index=0,f"image_{index:05d}.png" 生成 image_00000.png。脚本将 x_train[0] 写入 train/images/image_00000.png,在 train/labels.csv 为它写入 int(y_train[0])。测试集用自己的文件夹和标签表,文件名从 image_00000.png 重新开始;⑧额外导出首图的放大预览、像素CSV和来源说明。
全量结果应有train60000张、test10000张,各自含images与labels.csv。放大的280×280预览只供人看,模型输入仍是28×28。脚本用最近邻插值把每个像素放大成10×10同色格,便于对照 first_train_pixels.csv 中的原始数值。
第四部分:把识别算法整理成可提交的程序
编程作业要求完成MNIST手写数字识别:准备数据、自己实现算法、训练并保存模型,再按固定接口预测新图片。作业书面截止时间为2026年11月17日10:00 AM。
作业的输入和输出:每张未知图只给一个数字标签
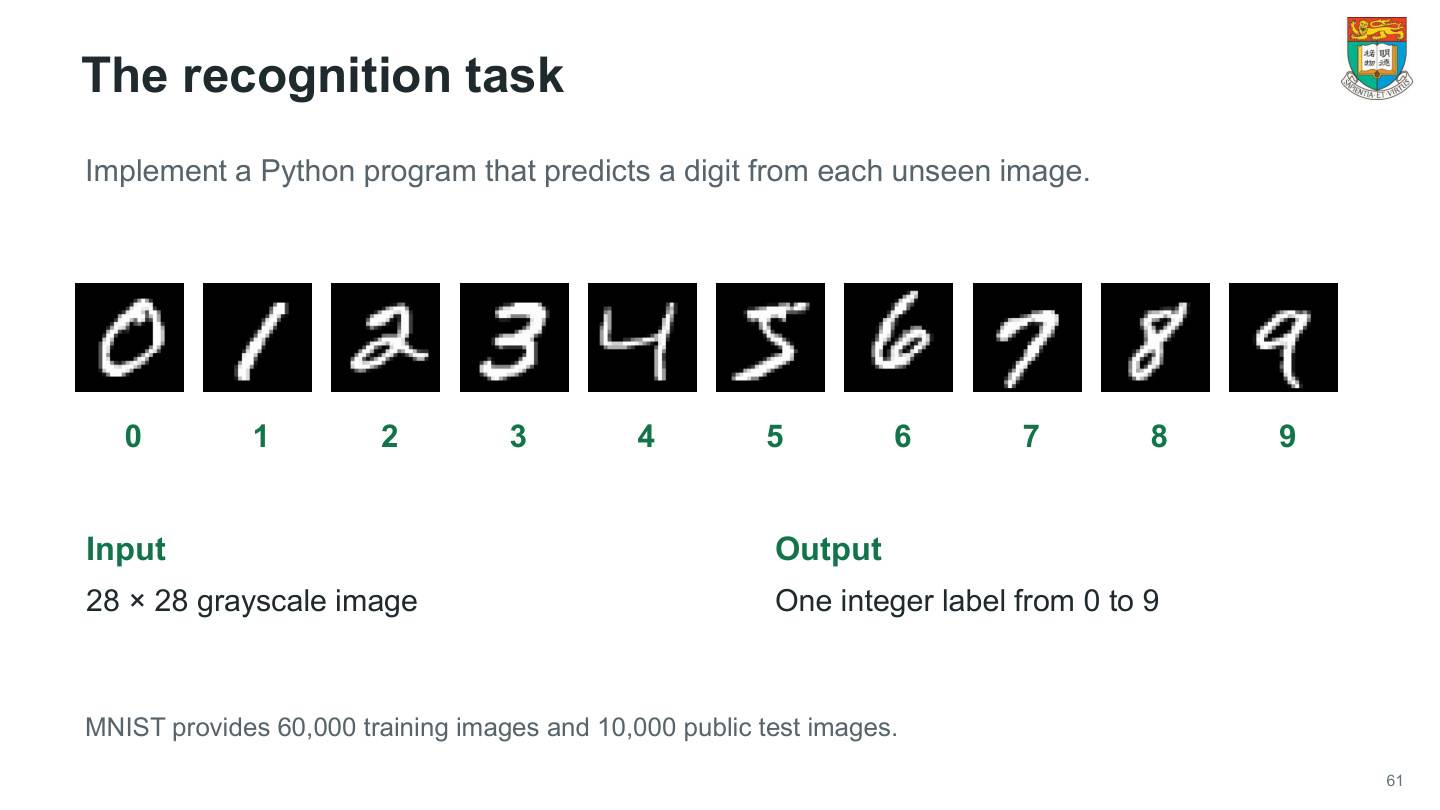
识别任务是:写Python程序,对每张未见的28×28灰度图像预测一个0–9的整数。图片像素是输入,数字类别是输出。
按一张图走:先从PNG读出二维数组→执行与训练一致的缩放、重排等预处理→送给已载入模型→得到10类分数或某种分类决策→选出一个数字。不能把一张图里所有像素相加,再把总和当作答案。
程序要面对的是未知图,不应依赖文件名暗示类别,也不能在预测函数读取正确标签。训练和公开测试分别有60000及10000张;老师另外使用的私有图像与标签不会分发。
如果模型内部输出 [0.01,...,0.8,...] 这类十维概率,提交的最终结果仍需提取最大项对应的0–9标签,而不是直接把整串概率写进 predicted_label 列。类别标号0也是有效预测,不是空值。
练习:输入一个28×28灰度PNG,接口应产生一个整数;输入一个文件夹,应对每个规定PNG产生一行结果。
可以比较多个算法,但最后要选定一个可评测模型
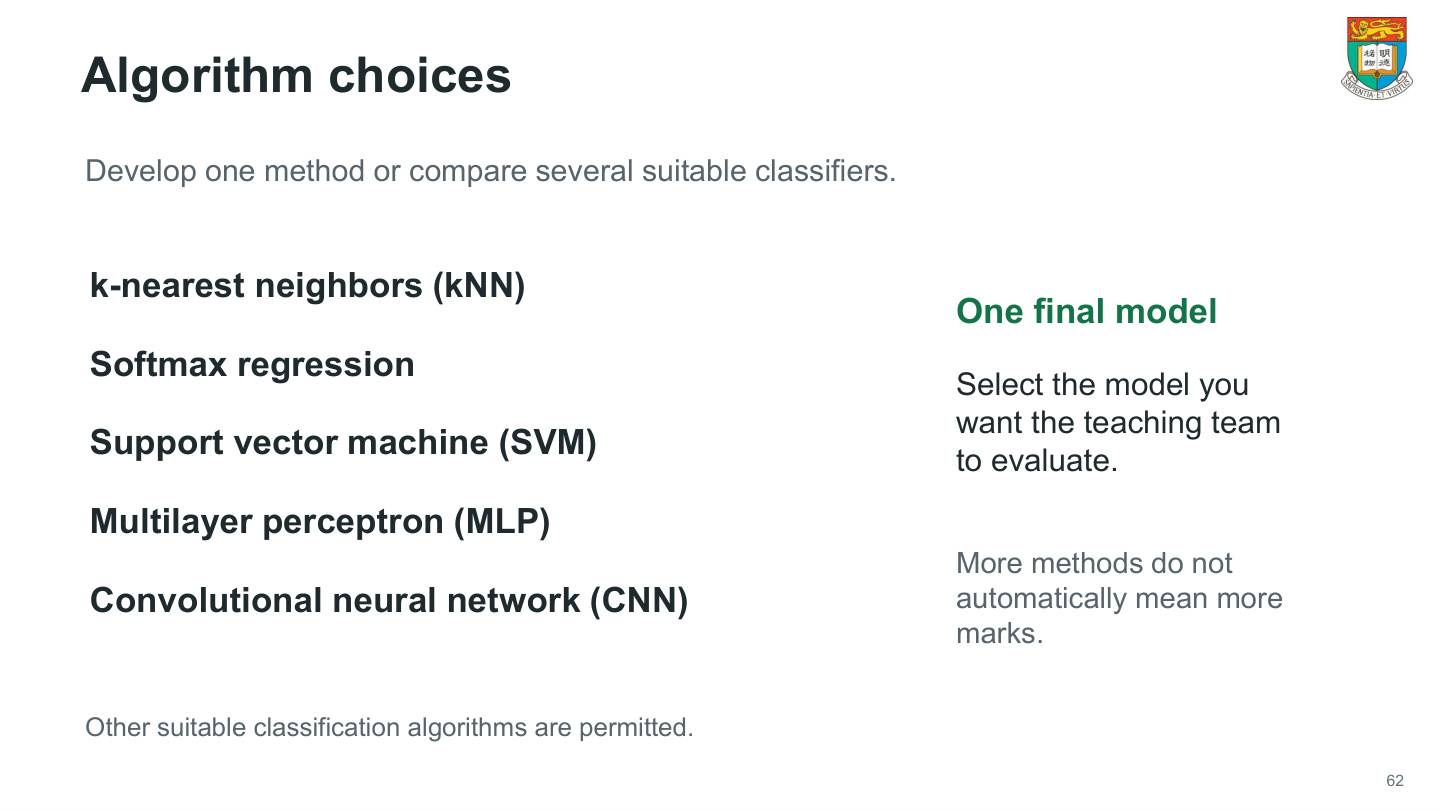
可选kNN、Softmax回归、SVM、MLP、CNN,也允许其他适合的分类算法。你可以只认真做一种,也可以比较几种;最后要明确交给老师评价的是哪个模型。
选择的过程应有证据:先保证输入、预处理、训练/验证划分一致,再比较验证表现与计算成本。比如kNN实现直观,但保存参考集多、预测可能慢;MLP和CNN需自己处理梯度及训练;复杂度增加也会增加实现出错的机会。
“多做几种”不自动等于“分数更多”。优先完成一个接口正确、实验完整的模型;比较其他方法时,用相同评价条件说明差别。
最终模型的含义包括:算法结构、训练得到的参数、预处理规则、必要文件。不能报告中写CNN,加载接口却实际预测旧的Softmax模型。确定方案后,把模型标识、权重路径和README说明对齐,并用独立数据检验。
“自己实现”具体意味着哪些步骤要亲手写
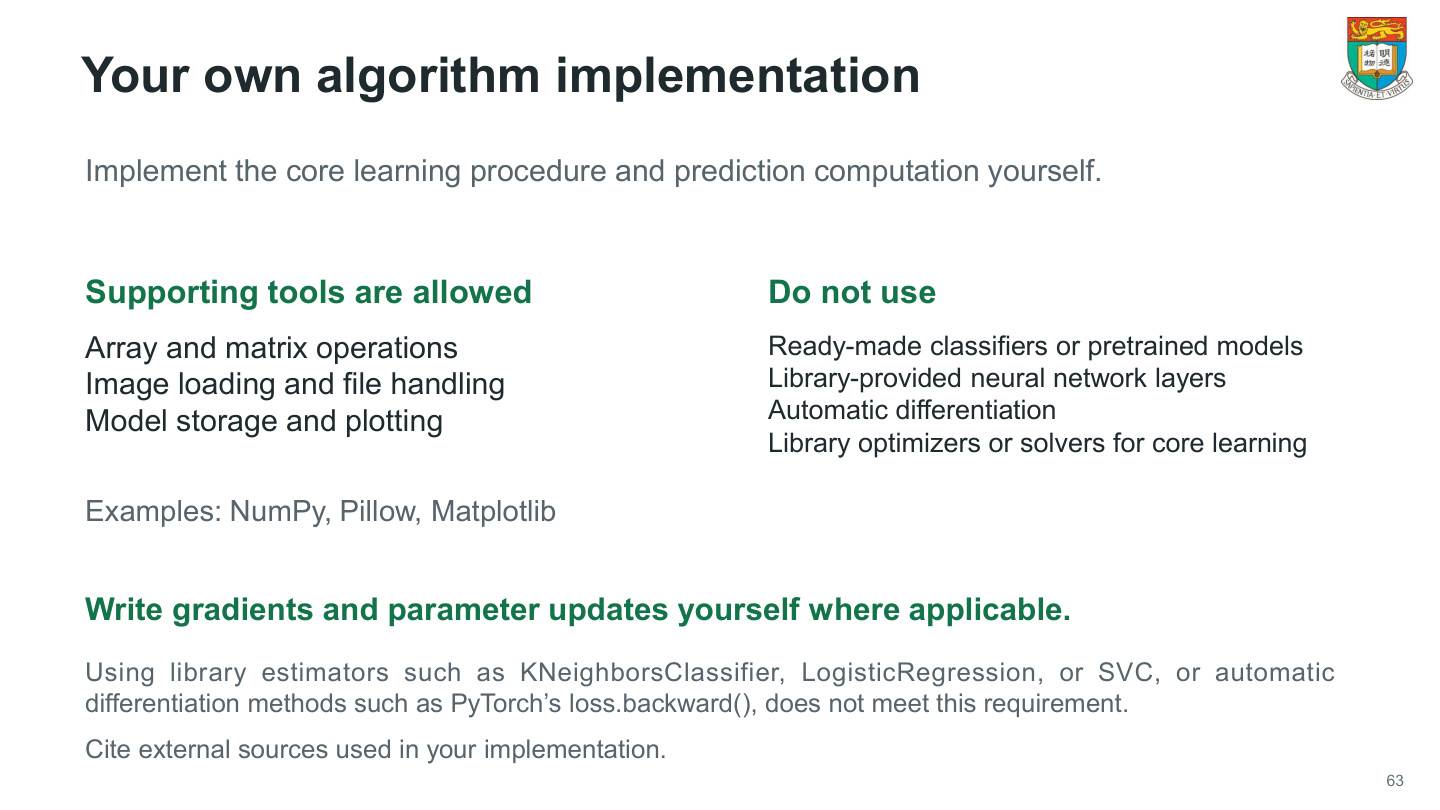
需要自己实现核心学习与预测计算。允许NumPy做数组/矩阵运算,Pillow读图片,Matplotlib画图,也允许文件操作和模型存储;不允许现成分类器、预训练模型、库提供的神经网络层、自动求导,以及替代核心学习的库优化器或求解器。
具体拆开看:自己写 X @ W 使用NumPy矩阵乘法,是实现算法的一部分;直接调用 LogisticRegression.fit 让库完成训练,则把核心学习交出去了。自己实现kNN应写距离、邻居选择与投票,不能用 KNeighborsClassifier 替代。SVM不能直接用SVC完成核心算法;神经网络适用时要自己写前向、梯度与参数更新,不能调用 loss.backward()。
这不是“所有工具都不能用”,而是要分清工具是在搬数据、做基础数学,还是替你决定了学习算法。模型存成数组文件或合适格式,也不等于用了现成分类器。
引用外部算法说明或代码时要标明来源;写出来源并不自动豁免核心实现要求。练习:若把某次库调用删除,你的代码还是否包含关键的学习规则与预测逻辑?
保存的不只是权重,还包括训练时学到的预处理
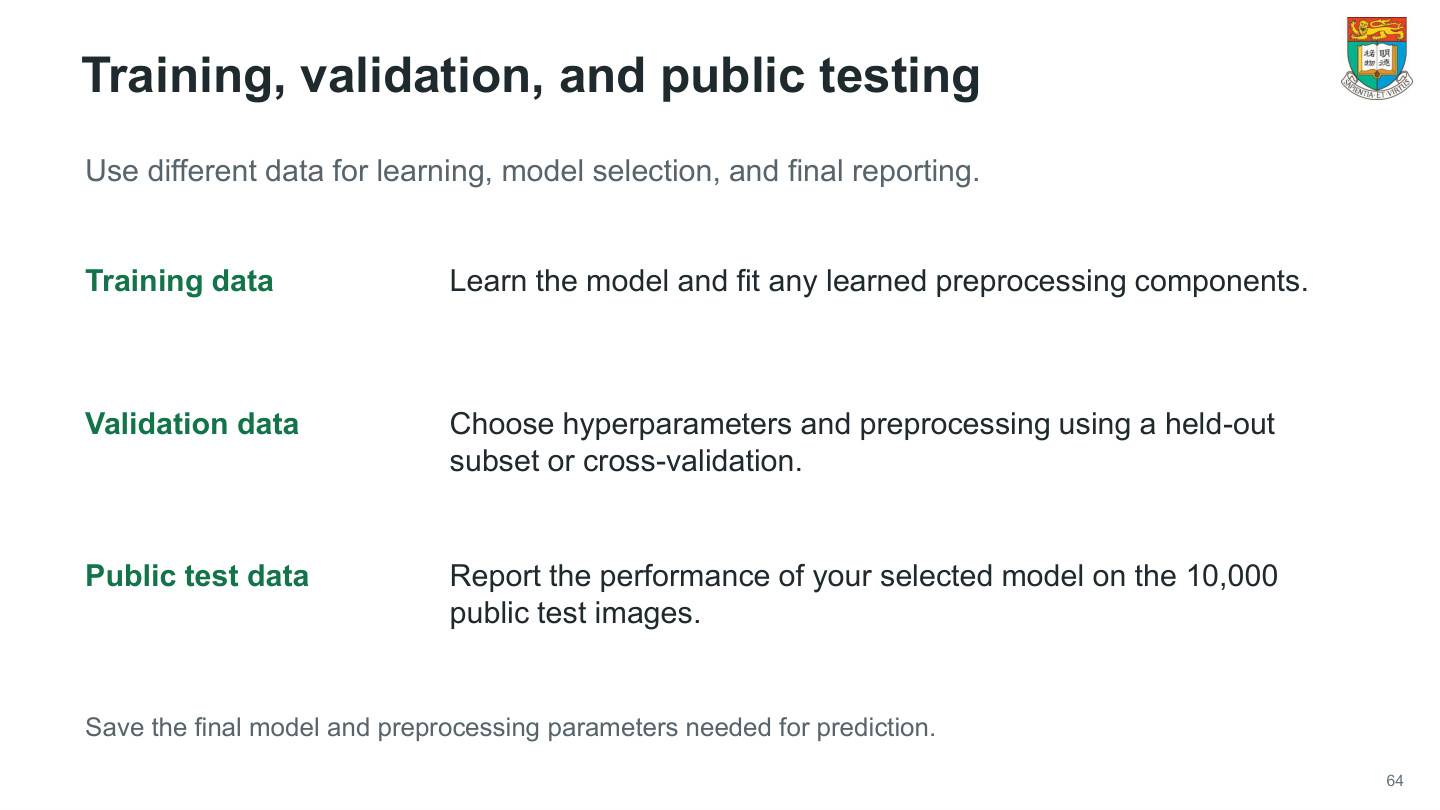
训练、验证、公开测试各有不同用途,预测所需信息都要随模型保存。
训练数据用于学习参数;如果预处理需要估计均值、方差或其他统计量,也应在训练部分拟合。验证数据用于选择超参数和预处理方案,可以用留出集或交叉验证。公开测试用于报告已经选定的模型在10000张图上的结果。
例如训练时先做 (x−mean)/std,mean和std是从训练部分算出的,那么预测新图时应加载这两个值再用相同公式,不能对每张新图自行重算一套,也不能在私有测试文件夹上重新拟合全局标准化。
最终保存清单可包括权重、偏置、结构配置、类别顺序、缩放常数、需要的统计量。只存最后的准确率数字无法恢复模型;只存权重却忘记对应输入形状也可能无法重现预测。
练习:关掉训练进程,启动新的Python,仅凭提交目录能否读入图片并得到一致输出?如果必须依赖之前交互窗口中的变量,说明保存工作还不完整。
私有测试怎样评价模型
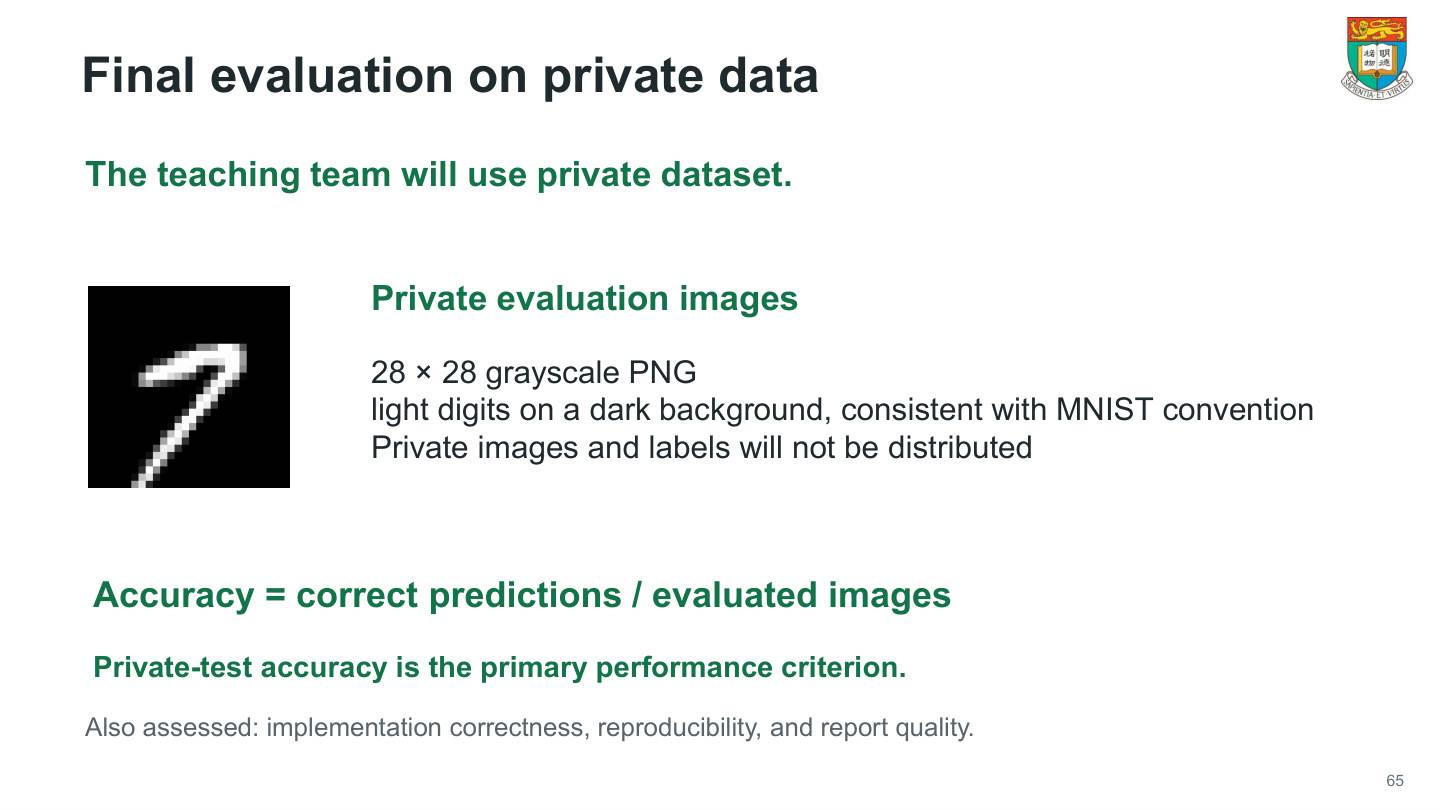
老师使用28×28灰度PNG进行私有测试,图像为浅色数字、深色背景。主要性能指标是准确率=正确预测数/评价图片数,同时评价算法实现、可复现性和报告质量。
预测时保持与训练相同的灰度转换、缩放和数组布局。模型从保存文件载入,读取传入的图片目录,为每张PNG输出一个0–9标签。
公开测试与私有测试是两批样本,成绩应分别记录。公开测试用来报告选定模型的表现,私有测试由老师评价。
提交目录:每个文件各有职责,别只压缩一个模型
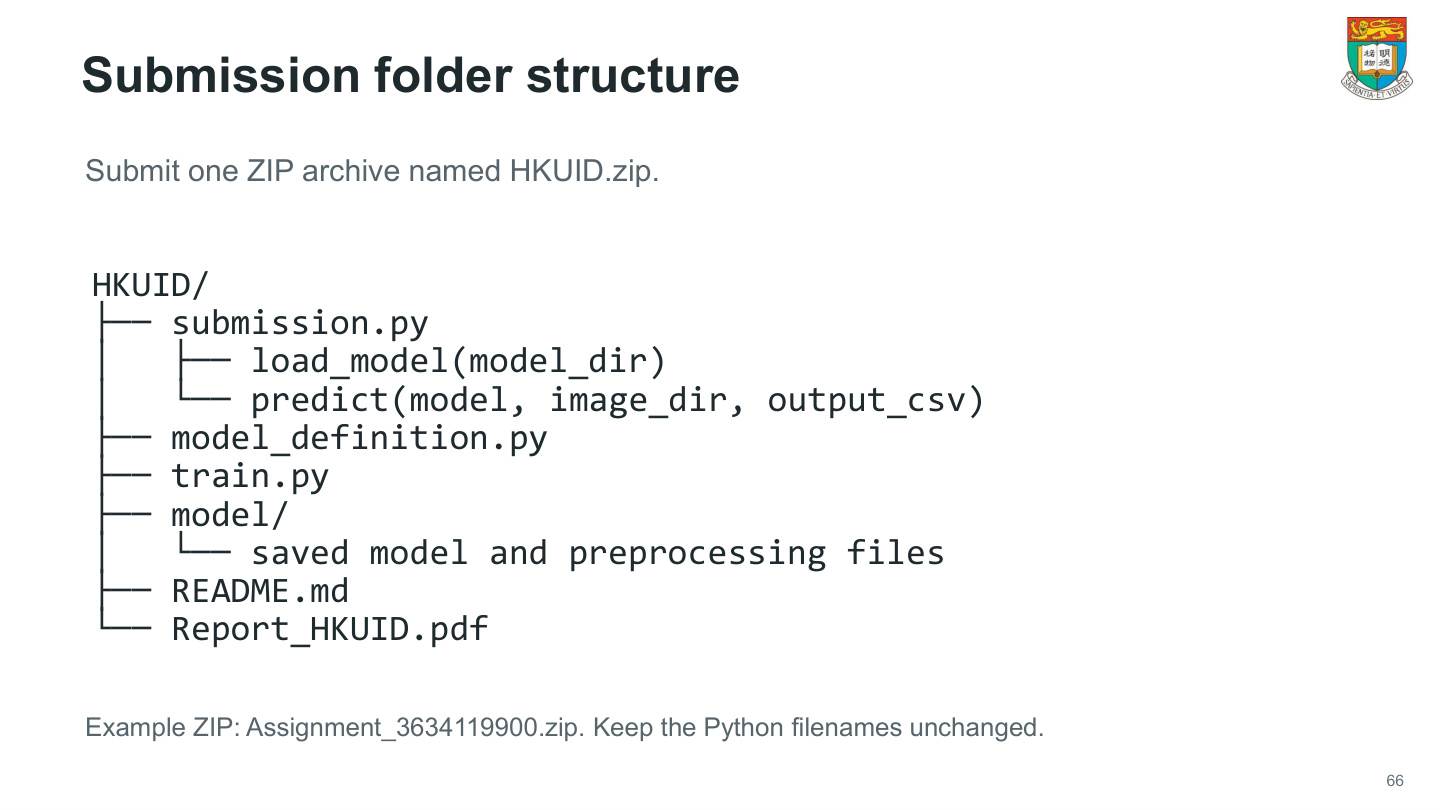
以学号作为顶层文件夹名称:
HKUID/
  submission.py
  model_definition.py
  train.py
  model/
  README.md
  Report_HKUID.pdf
submission.py 提供 load_model(model_dir) 和 predict(model,image_dir,output_csv) 两个入口;model_definition.py 放算法或模型类定义;train.py 放训练和保存逻辑;model/ 放已学参数与预处理;README说明用法,PDF解释实验。
压缩应使别人解压后能直接识别这层结构,不要多套不明文件夹,也别把模型文件留在你电脑的绝对路径中。占位文字HKUID应替换成自己的真实编号,函数名和Python文件名则按规定保留。
书面作业第3页给的压缩包示例是 3634119900.zip,所以写实际学号加 .zip。这张 Lab 页底部另写了 Assignment_3634119900.zip,提交命名以书面作业为准。以上述学号为例,包内顶层目录是 3634119900/,报告叫 Report_3634119900.pdf。
检查时分别问:入口在不在;模型能否载入;代码定义齐不齐;报告和说明是否随包带上。仅凭压缩成功,不表示包内接口正确。
load_model示例:从目录路径恢复一个模型对象
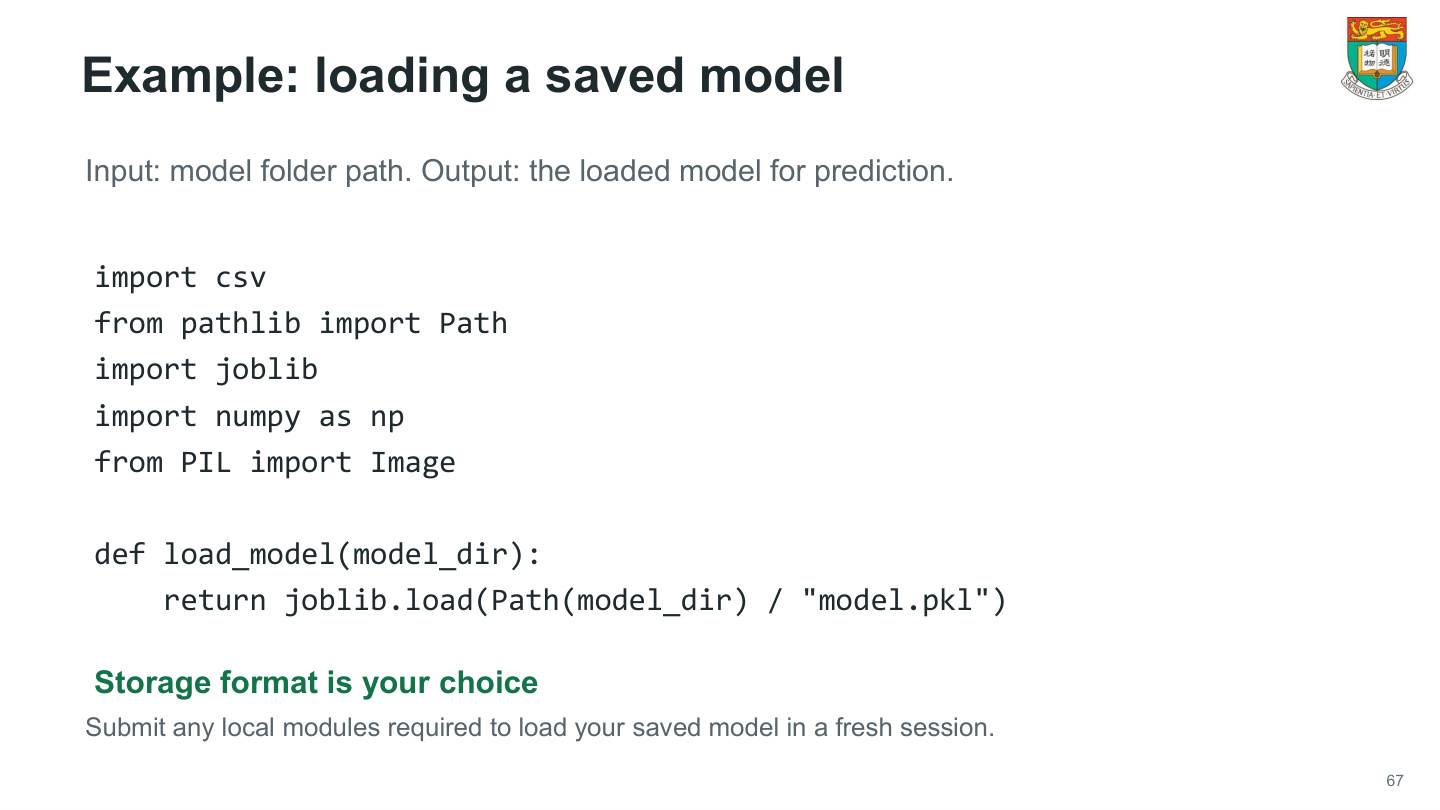
加载代码:
import csv
from pathlib import Path
import joblib
import numpy as np
from PIL import Image

def load_model(model_dir):
    return joblib.load(Path(model_dir) / "model.pkl")
逐行看:csv为后面写表格准备;Path提供路径拼接;joblib为此示例读取保存对象;np提供数组;Pillow的Image读取图片。前五行并不都在load_model函数里使用,它们也为下一页的predict提供工具。
函数输入model_dir是一个文件夹路径。Path(model_dir)把路径转换成路径对象,/ "model.pkl"在此表示拼接文件名,不是做数学除法。joblib.load从这个实际文件恢复对象,return把对象交还调用者。若传入D:/work/model,示例会寻找该目录中的model.pkl。
模型格式可自行选择;这里用pkl演示加载。使用这个示例就需提供对应文件和joblib依赖;若保存的是自己定义的类,新进程还需能导入那个类,所以定义不能只存在旧训练窗口里。
输入是路径,输出是模型对象,不是准确率或CSV。函数应加载已经训练好的结果,而非每调用一次便重新训练。
predict示例:逐文件读图,再写一行预测
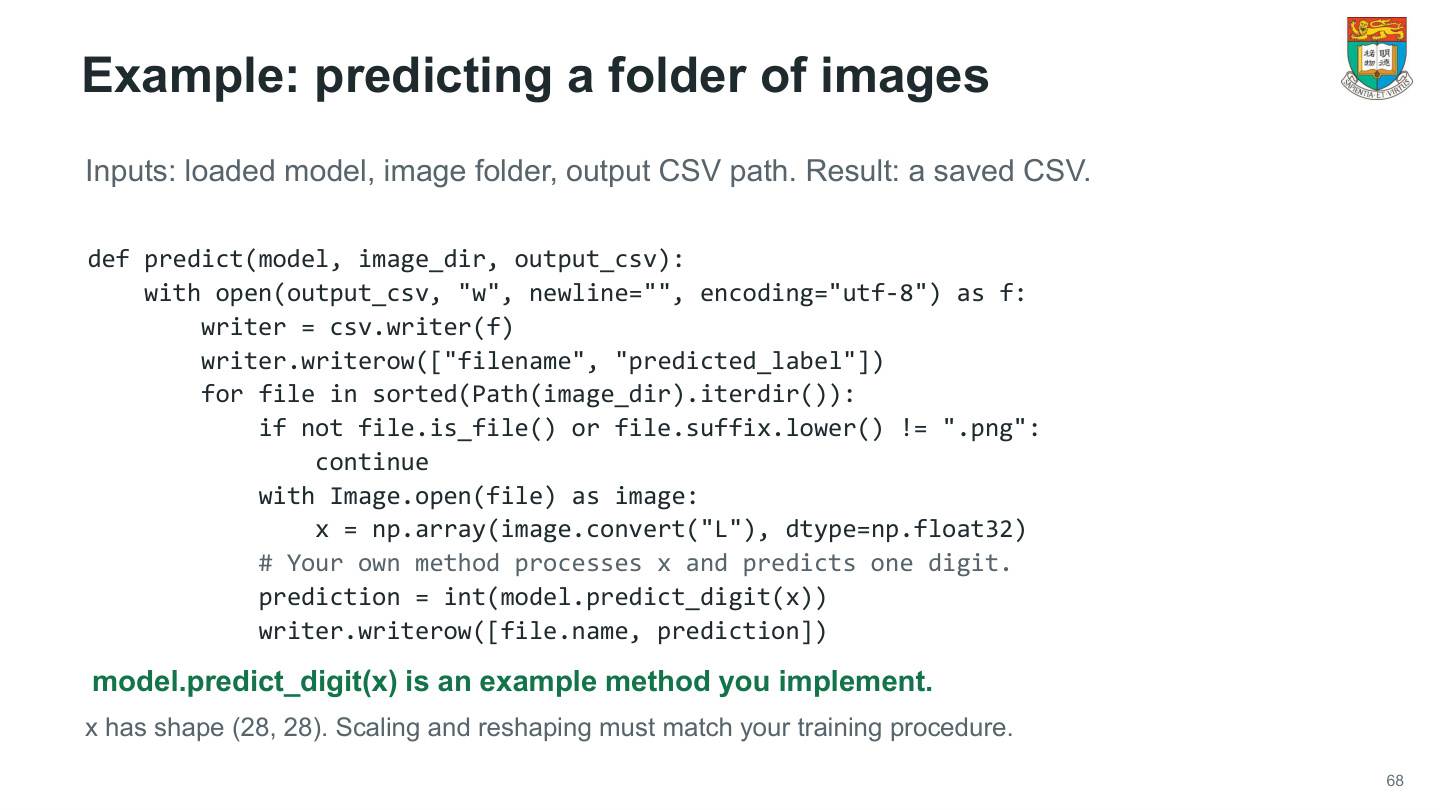
预测代码:
def predict(model, image_dir, output_csv):
    with open(output_csv, "w", newline="", encoding="utf-8") as f:
        writer = csv.writer(f)
        writer.writerow(["filename", "predicted_label"])
        for file in sorted(Path(image_dir).iterdir()):
            if not file.is_file() or file.suffix.lower() != ".png":
                continue
            with Image.open(file) as image:
                x = np.array(image.convert("L"), dtype=np.float32)
            # Your own method processes x and predicts one digit.
            prediction = int(model.predict_digit(x))
            writer.writerow([file.name, prediction])
①三个输入分别为已载入模型、图片目录、输出CSV路径。②open(...,"w")新写或覆盖结果,with负责结束时关闭;newline=""交由CSV工具处理换行,编码为UTF-8。③创建writer并先写两个列名。
④Path(...).iterdir()列出当前目录项目,sorted固定顺序。⑤不是文件,或扩展名转小写后不等于.png,就continue跳到下一个项目;因此不是递归扫描所有子目录。⑥打开图片,convert("L")转灰度,np.array(...,float32)转浮点数组。对规定28×28图,x形状为(28,28),像素此时仍通常在0–255范围;转换为float32不等于已经除255。
⑦predict_digit是你自己实现的方法,不是NumPy自带功能;里面必须做与训练一致的缩放、形状处理和模型计算。int把单个标签转整数,不会检查它是否真的在0–9,所以实现还应保证类别范围。⑧每张图写原文件名与预测,各占一列。
例如遍历到 image_00000.png 后,先得到浮点数组 x.shape == (28,28)。若模型内部采用展平输入,它会缩放并整理成784个数,再输出数字7,随后 writer.writerow 将它写成 image_00000.png,7。predict 把结果写到指定文件,正常结束返回 None。
老师如何调用:按脚本位置定位目录
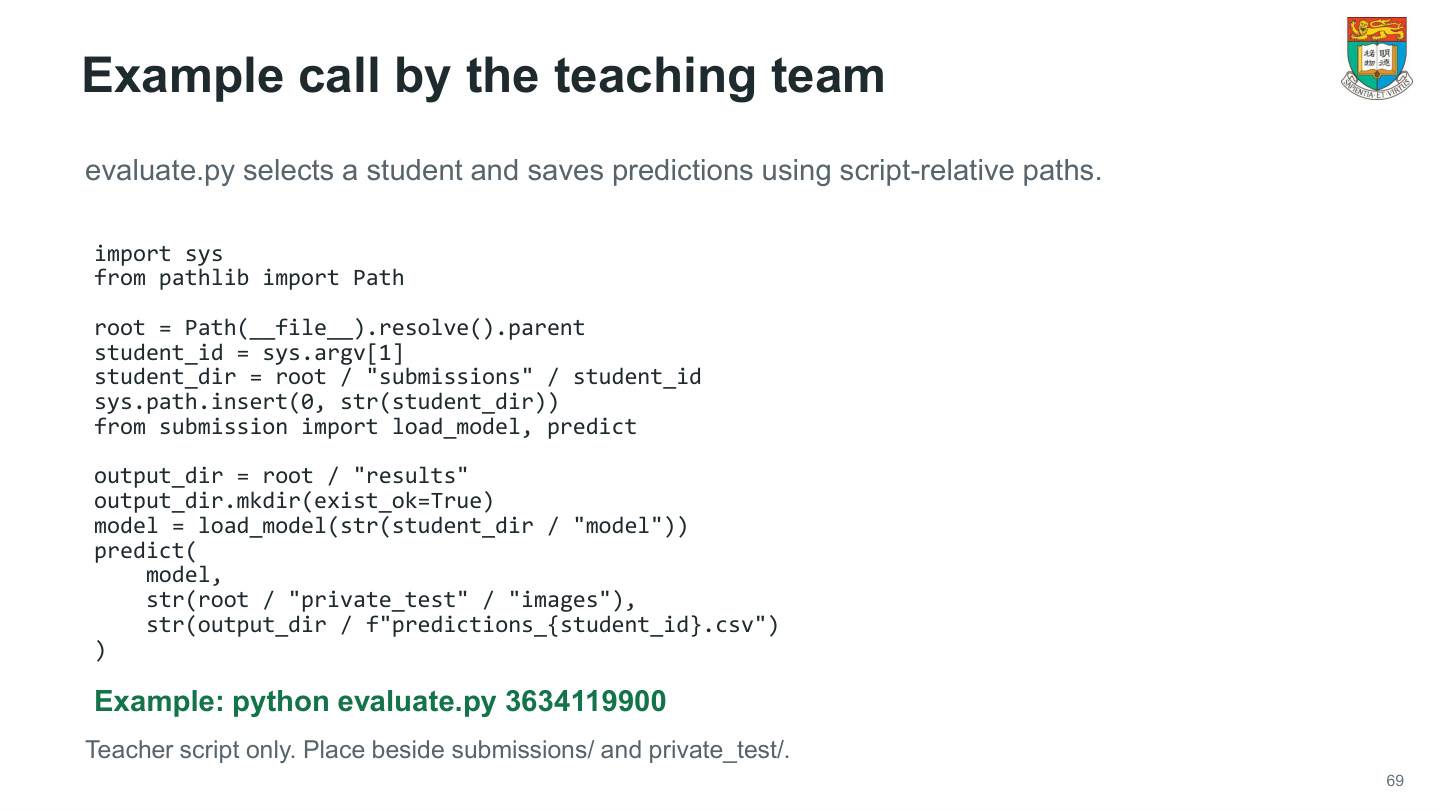
评测脚本:
import sys
from pathlib import Path
root = Path(__file__).resolve().parent
student_id = sys.argv[1]
student_dir = root / "submissions" / student_id
sys.path.insert(0, str(student_dir))
from submission import load_model, predict
output_dir = root / "results"
output_dir.mkdir(exist_ok=True)
model = load_model(str(student_dir / "model"))
predict(model,
        str(root / "private_test" / "images"),
        str(output_dir / f"predictions_{student_id}.csv"))
①导入系统与路径工具。②__file__是评测脚本自身路径,resolve()化为绝对位置,.parent取它所在目录。这样root不是猜当前终端在哪。③sys.argv[1]读取命令行第一个附加参数,如 python evaluate.py 3634119900 中的编号;argv[0]才是脚本名。
④拼出root/submissions/编号。⑤把学生目录放到模块搜索路径最前,使接下来能找到该目录的submission.py。⑥导入规定的两个函数;仅仅导入便自动开始长时间训练,会妨碍这种调用方式。
⑦拼出results目录,mkdir(exist_ok=True)在已有目录时不报“已存在”。⑧把学生model目录传入加载函数。⑨调用预测,依次传模型、私有图片目录、带编号的结果路径。str将路径对象变成字符串;f字符串将编号插入文件名。
这是老师侧的示例脚本,放在submissions与private_test旁,不是要求把私有测试集一起交上。若学生代码写死自己桌面的路径,换电脑就会失败;应使用传入参数和随包文件。
CSV结果:文件名与预测数字必须逐行对应
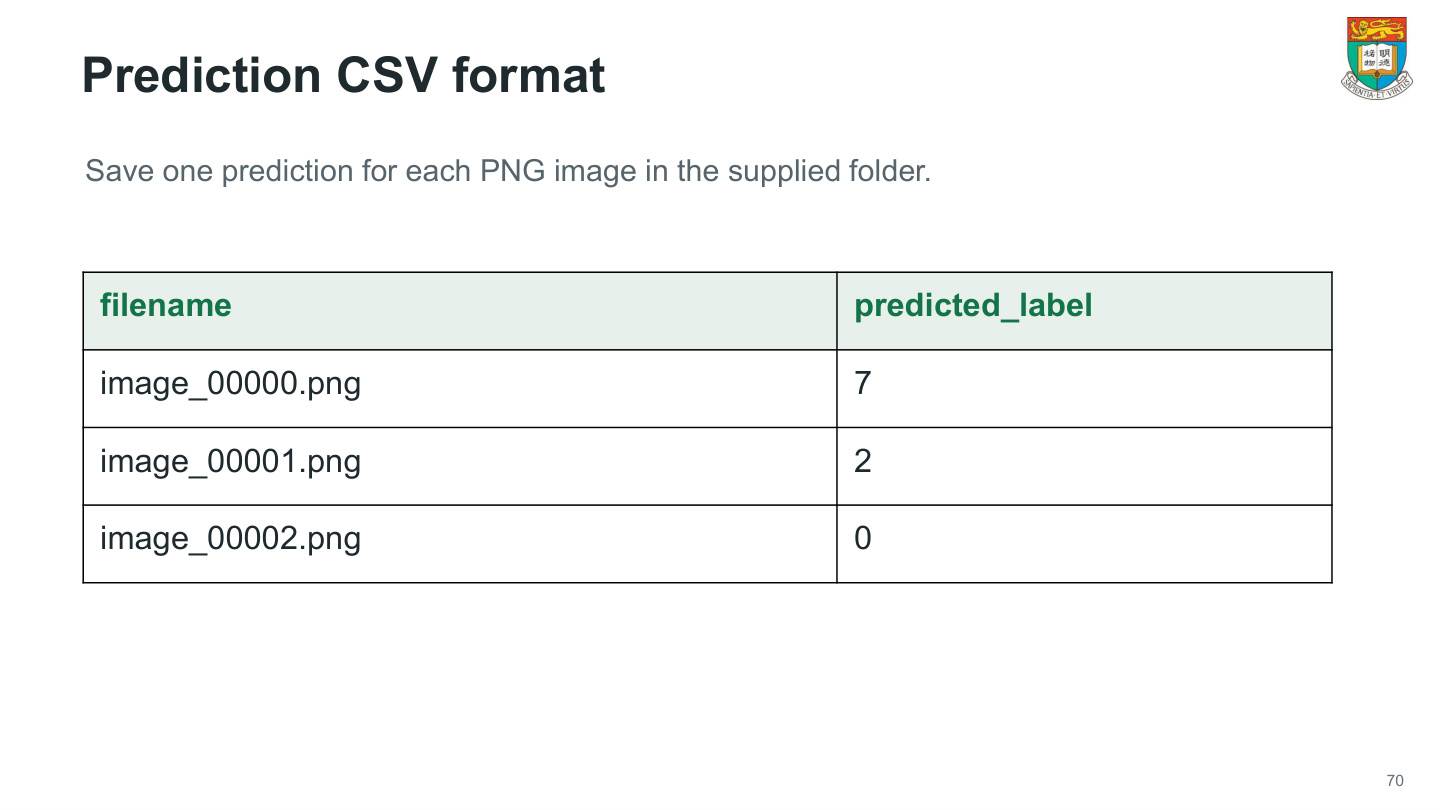
每张PNG有一行预测,列名为 filename,predicted_label。示例:
filename,predicted_label
image_00000.png,7
image_00001.png,2
image_00002.png,0
第一行是表头,不是第1张图;后面每一行的第一列精确写输入文件名,第二列写0–9的一个整数。数字0是有效类别,应原样保留,不能被当作空白。
例如真实标签表先列 image_00002.png,预测表先列 image_00000.png。评测可以按文件名把 image_00002.png 的预测0与该图片的真值配对。仅按行号匹配会把第一行的7误配给 image_00002.png。
CSV是逗号分隔文本,不是把屏幕上的表格截图放进文件。使用 csv.writer 可以正确处理分隔与换行。每张图出现一次,不能遗漏、重复,也不要额外把子文件夹名当作图片名。
例如有100张有效PNG,结果应有100条数据行,加1条表头。仅仅生成了非空CSV并不能证明覆盖完整;还要核对输入文件名集合和输出文件名集合一致、标签都是合法整数。
其他提交文件:让一个全新的Python会话也能恢复模型
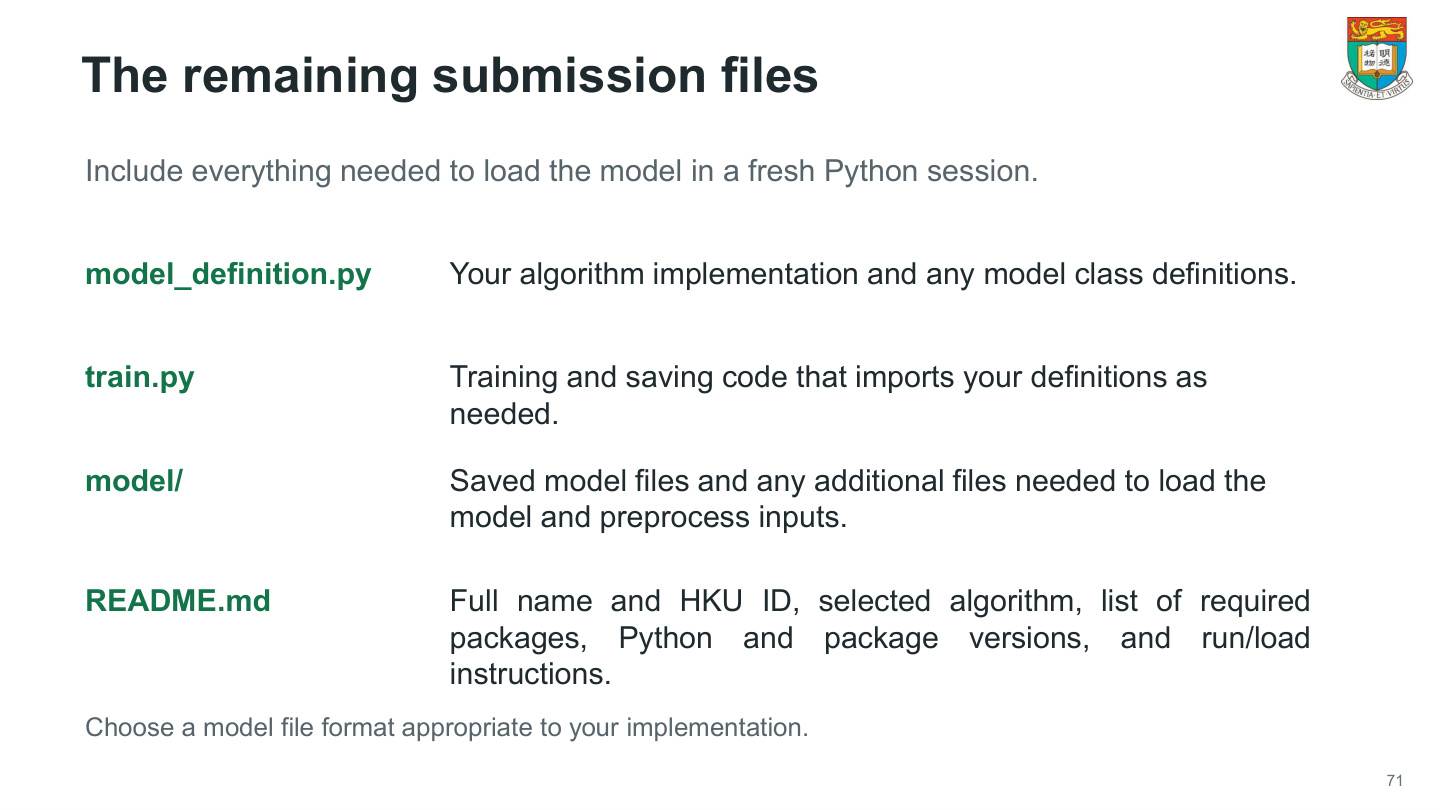
表中四类文件各解决一个问题。model_definition.py保存算法实现和模型类;train.py负责训练、调用定义、保存结果;model/存权重与必要预处理文件;README告诉别人需要什么环境、怎样加载和运行。
为什么定义与权重要分开理解?权重是一堆学到的数值,类或函数定义说明怎样使用这些数。如果只存了一个自定义对象,而相关类只存在原来的训练窗口,新会话可能不知道如何还原它。
README写明姓名、HKU ID、选定算法、Python与依赖包版本、运行和加载步骤。模型存储格式可以按自己的实现选择,但加载代码必须与之匹配。
按下面顺序检查:从新进程开始→按README装好依赖→导入submission→从随包model目录载入→对一小批规定图像预测→检查CSV。
不要依赖编辑器里未保存的变量、绝对路径或训练时临时文件。交付的目标,是让别人仅用这份包就能理解并重现你描述的过程。
报告怎样组织方法、实验和结果
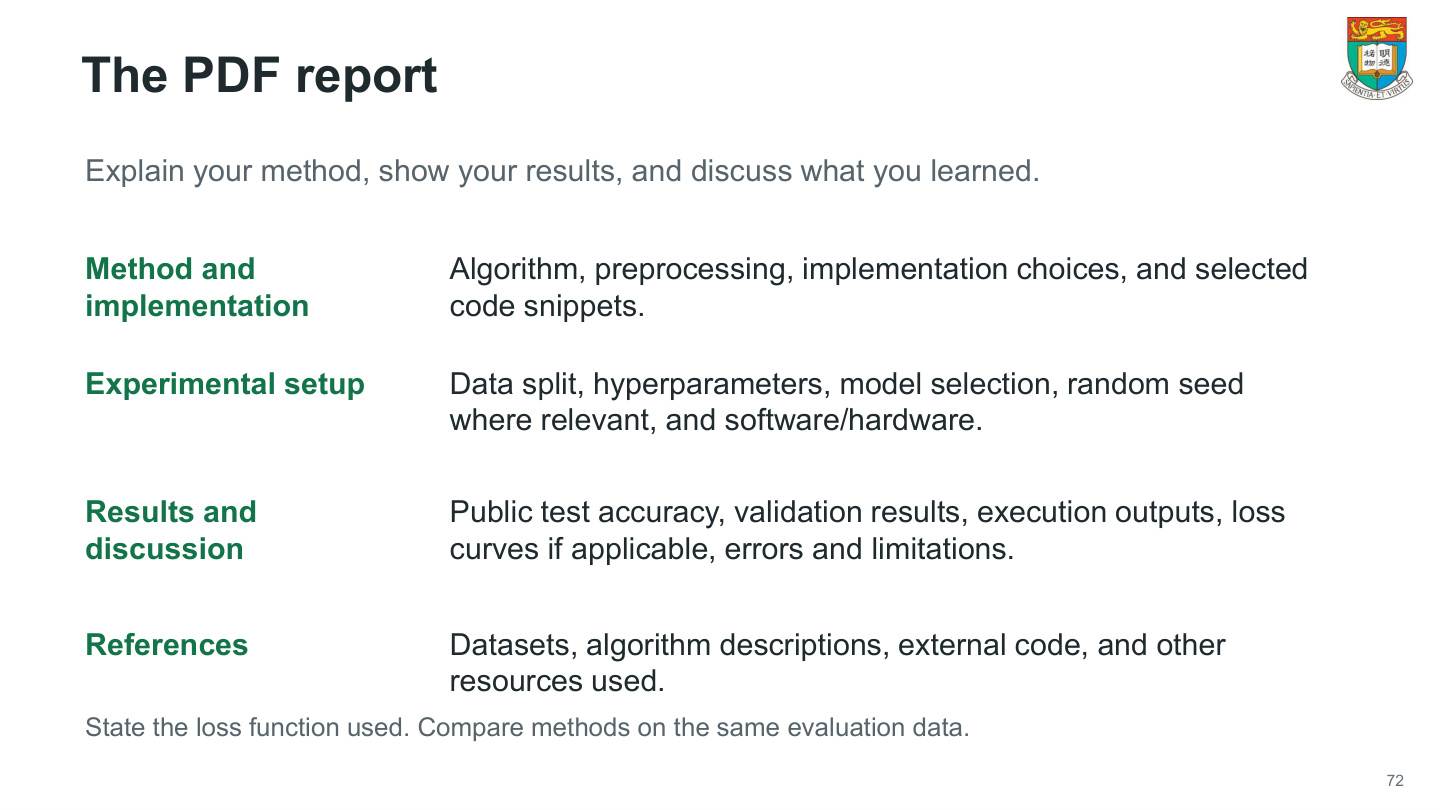
报告分为方法实现、实验设置、结果讨论、参考来源。
方法与实现回答:用了什么算法,输入怎样预处理,关键计算怎样自己完成,为什么选这些设计。贴代码时选能解释核心步骤的片段,并用文字说明输入、输出和维数。
实验设置回答:训练/验证/测试怎样划分,超参数如何选,随机种子是什么,运行的软件硬件是什么。种子并不自动保证所有操作完全确定,但记录它有助于别人复现选择过程。
结果与讨论写真实的验证、公开测试结果、执行输出;适用时给损失曲线,分析典型错误与局限。损失函数必须明确,例如分类交叉熵;不能只写“loss很低”却不说明怎么算。比较不同方法时应使用同一评价数据和合理一致的设置。
参考来源列数据集、算法说明、借鉴代码和资源。引用要能让读者找到,不应把外部解释当成自己独立推导。
书面作业还要求在报告首页写全名与 HKU ID。
结束页:检查你是否能独立走完整条流程
用一张图回顾整个流程。Python 读出28×28个灰度值,按训练时的规则转换,已载入的模型输出数字,例如7,最后写成一行 image_00000.png,7。用于学习和选模型的训练、验证步骤发生在这条预测流程之前。