左右键翻页;“连续阅读”展开整份;搜索可定位概念。
CNN与聚类
本讲先学CNN怎样从图像中提取特征、预测类别,再学k-means怎样把没有标签的数据分成几组。前半练习小窗口的乘加,后半练习距离与平均数。
本讲学习顺序
学习顺序:卷积→池化→CNN结构→数据增强→k-means→k-means++。CNN学习图像特征;k-means反复分组、求均值;k-means++负责选初始中心。
卷积定义:固定输出位置,再逐项累加
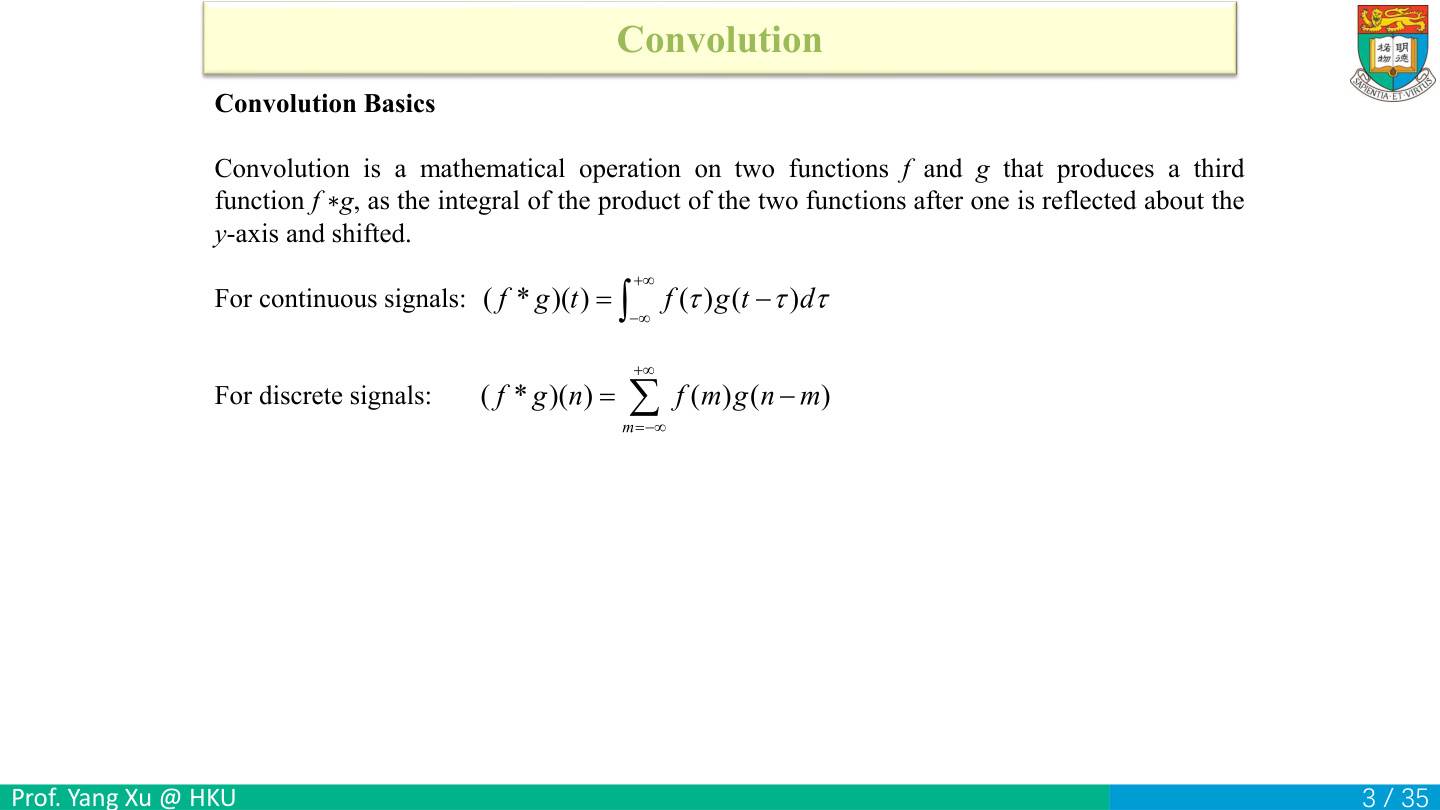
卷积的直觉:两个信号在不同相对位置重叠,把每处的“一个值×另一个值”加起来,得到该位置的一个新值。星号 * 表示卷积,不是单纯的逐元素乘法。
连续形式是 y(t)=∫ f(τ)g(t−τ)dτ,积分区间从负无穷到正无穷。t 是这次要算的输出时间,先固定;τ(tau)是扫描用的临时变量,会在积分中走过所有位置;f(τ)g(t−τ) 是扫描到该处的乘积。积分是把极细的贡献累加。算完一个 t,再换 t 得到完整输出曲线。
离散形式把积分换成求和:y[n]=Σ_m f[m]g[n−m]。n 是输出下标,m 是被加掉的下标。有限信号之外一般按0处理,所以实际只需加非零重叠项。
算一遍:f=[1,2]、g=[3,4],都从下标0开始。y[0]=1×3=3;y[1]=1×4+2×3=10;y[2]=2×4=8。输出 [3,10,8]。中间的10来自两项重叠,不是把输入两两相加。
自测:若 f=[1],卷积输出是什么?答案是原信号g,因为每个位置只把g的对应值乘1。
系统响应:为什么输出会包含过去输入的贡献
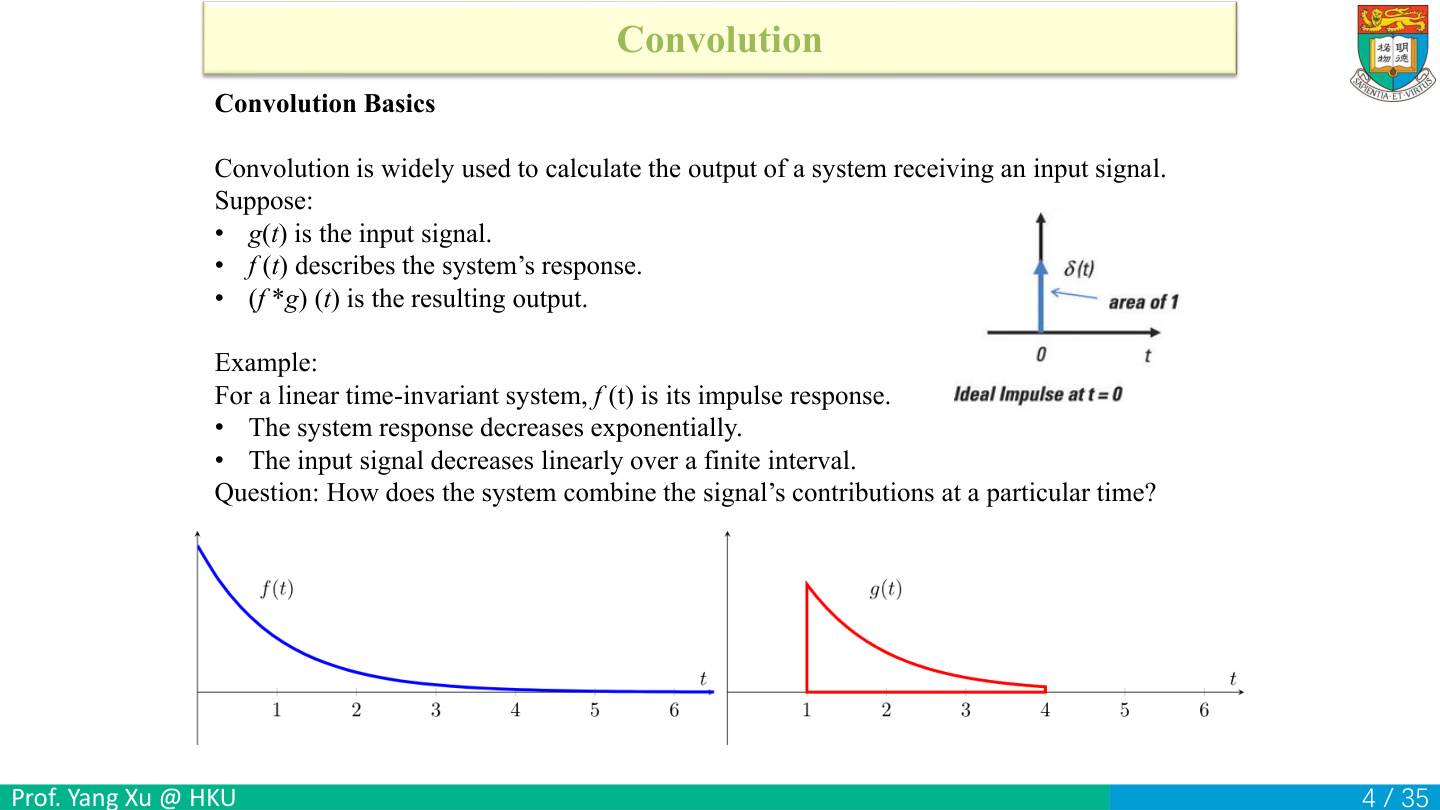
g(t) 是输入,f(t) 是系统响应,输出写作 (f*g)(t)。对线性时不变系统,f是冲激响应:给系统一个短促的单位刺激,它随后怎样变化。“线性”允许多个刺激的响应相加;“时不变”表示刺激晚来一秒,响应也整体晚一秒。
把复杂输入想成许多小刺激。每个刺激会留下逐渐衰减的影响。输出时刻 t 不只取决于当前刺激,也叠加了较早刺激尚未消失的影响。卷积就把这些贡献加起来。若用 f(τ)g(t−τ),τ可解释为影响延迟,g(t−τ)是 t 之前 τ 时刻的输入。
例子:离散响应 f=[1,0.5],输入前两时刻为 g=[2,4]。第一输出2;第二输出 1×4+0.5×2=5,其中4来自现在,1来自过去输入2的残留;第三输出 0.5×4=2。这比“每时刻直接输出输入值”多了系统记忆。
右上δ(t)的箭头表示集中在t=0、总面积为1的单位冲激。左下蓝线是施加它之后的响应f。右下红线是实际输入g,示意它只在1到4之间出现,并随时间变小。计算输出时,把输入提供的每一小份贡献乘上对应延迟的蓝线响应,再全加起来。
自测:第二个输出为什么是5而不是4?因为当前输入贡献4,上一时刻输入残留的影响贡献1,总共5。
翻转、平移、相乘、积分:四个动作不能省
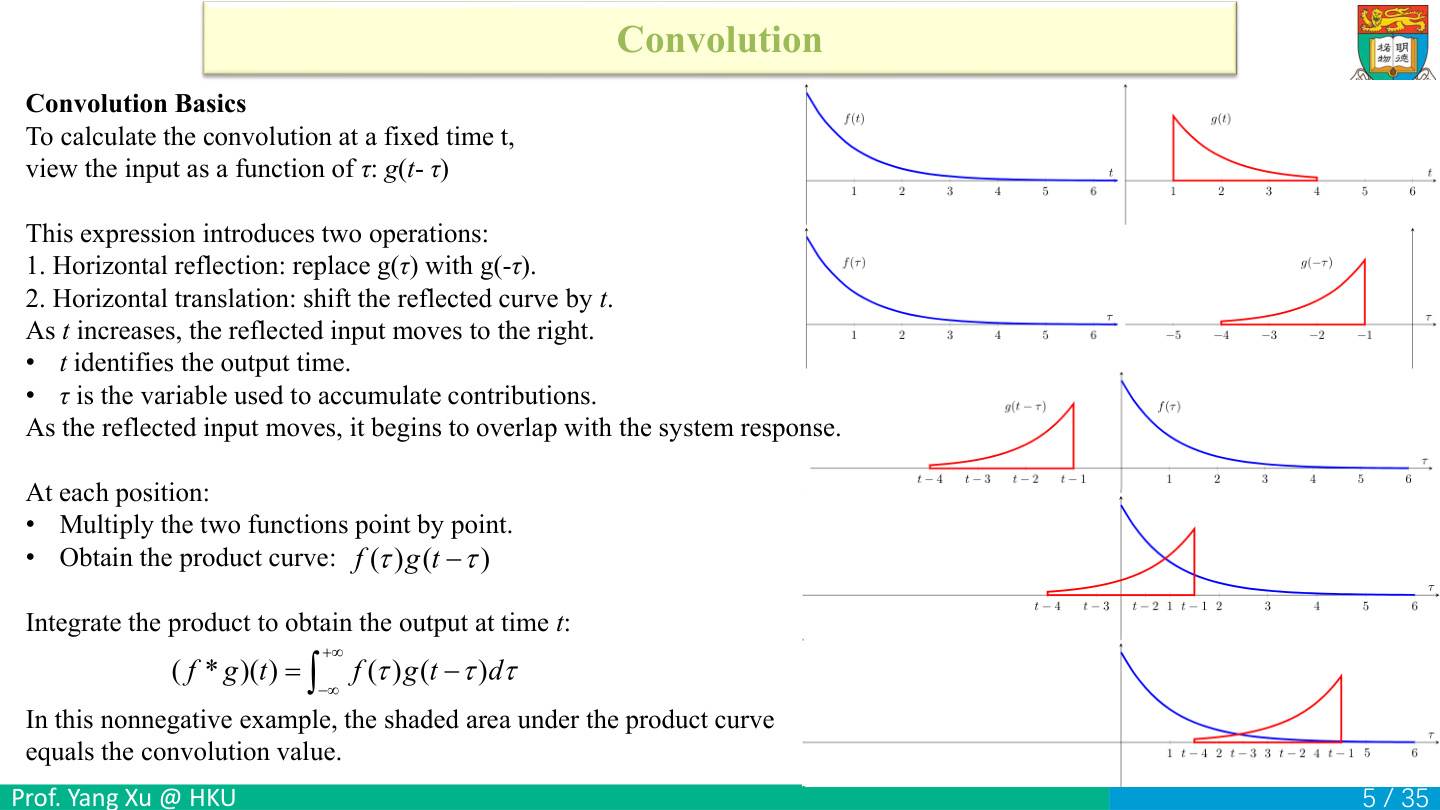
计算 g(t−τ) 时,先把t固定,再让τ沿横轴移动。这样就能观察输入在某一个输出时刻的重叠情况。
- 从
g(τ)开始,把横坐标取负,得到g(−τ),这叫左右翻转。 - 把翻转后的曲线沿横轴平移 t,得到
g(−(τ−t))=g(t−τ)。t变大时曲线往右移。 - 对每个 τ,把两条曲线的高度相乘,得到乘积曲线
f(τ)g(t−τ)。没有重叠的位置至少一项为0,乘积也为0。 - 将乘积曲线积分,只得到一个输出值
y(t),不是整条输出曲线。改变 t 后重复四步,才得到整条曲线。
例子:设 f、g 都只在 [0,1] 内等于1,其他地方为0。t=0.5时,g(t−τ)非零范围为 −0.5≤τ≤0.5,与 f 的 [0,1] 重叠 [0,0.5],所以积分0.5。t=1时重叠长度1,输出1;t=1.5时重叠 [0.5,1],输出0.5。因此输出是三角形。
从右侧图读区间。g原本在[1,4]内,所以g(t−τ)非零要求1≤t−τ≤4。拆成两边得τ≤t−1、τ≥t−4,合起来是[t−4,t−1]。蓝线只在τ≥0时有响应。比如t=2,红线范围是[−2,1],真正要乘起来积分的只有[0,1]。
自测:两条曲线的非零区间完全不重叠,输出是多少?答案0,因为每个位置的乘积都为0。
把卷积看成加权累加,并连接到神经网络
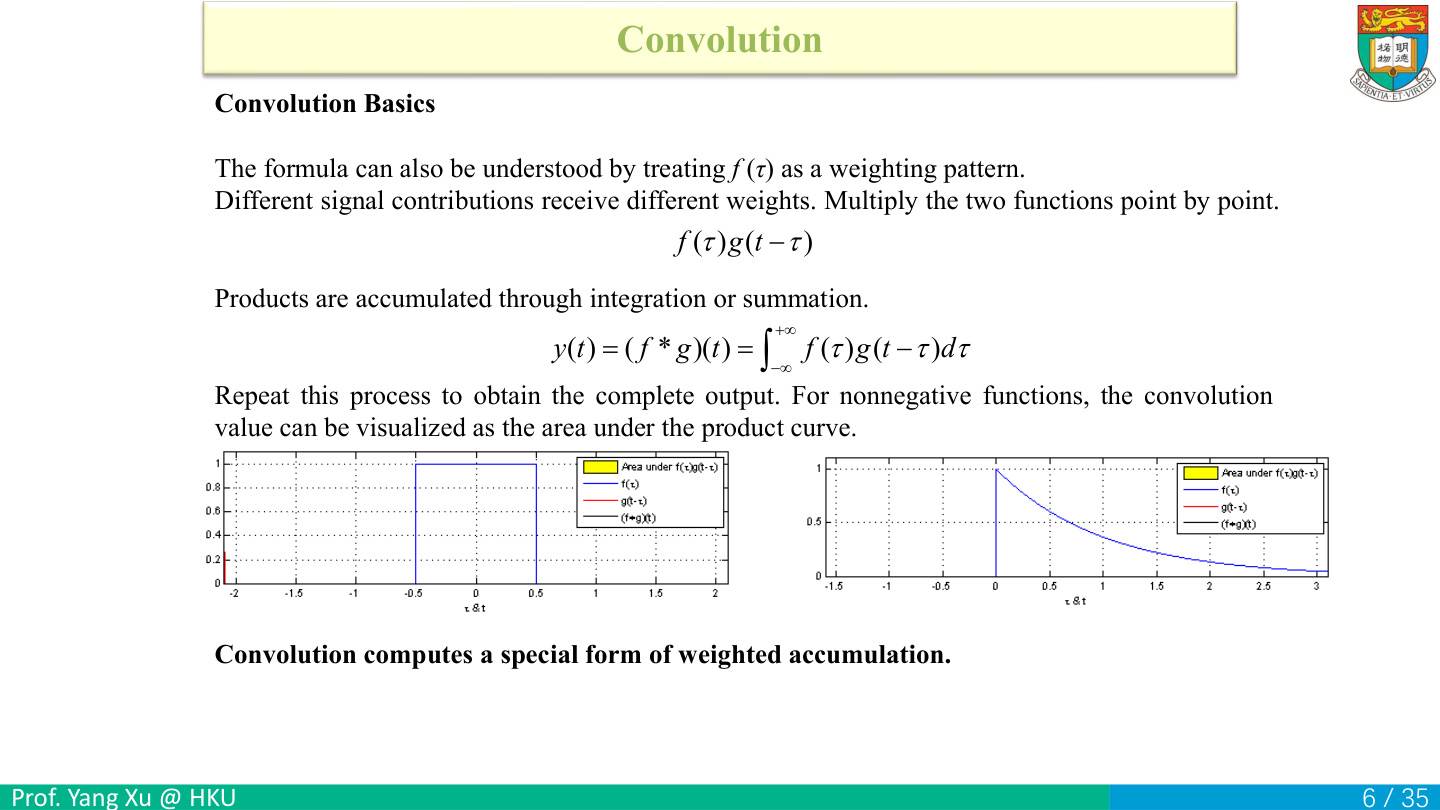
“加权”就是把每个输入乘上对应的重要程度,再相加。例如输入 [2,4,8]、权重 [0.2,0.3,0.5],加权结果为 0.4+1.2+4=5.6。卷积在每个位置重复这种乘加。
在本页写法里,f(τ) 提供权重模式,g(t−τ) 提供与输出位置t有关的输入。计算顺序是“固定t→逐处取输入与权重→相乘→累加→保存结果”。改t时输入相对权重移动。对离散图像,积分变成有限求和,权重模式变成小矩阵(kernel)。
神经网络与固定图像滤波的关键差别在于:kernel 的权重可以通过训练得到。最初它可能没有明确意义;预测做错后,损失的梯度告诉每个权重应该怎样微调。训练很多次后,某些核对边缘或纹理产生强响应。
卷积核的权重可以为正、为负或为0。正权重加强相应输入,负权重用于抵消或检测差异。例如平滑核常把多个像素平均,边缘核则常计算相邻像素的差。
自测:权重 [1,−1] 作用于两个相同输入 [5,5],对应相乘求和是多少?答案0。它能强调差异而抵消相同部分,说明“加权”并不等于“求平均”。
图像上的小窗口:CNN通常计算不翻核的相关
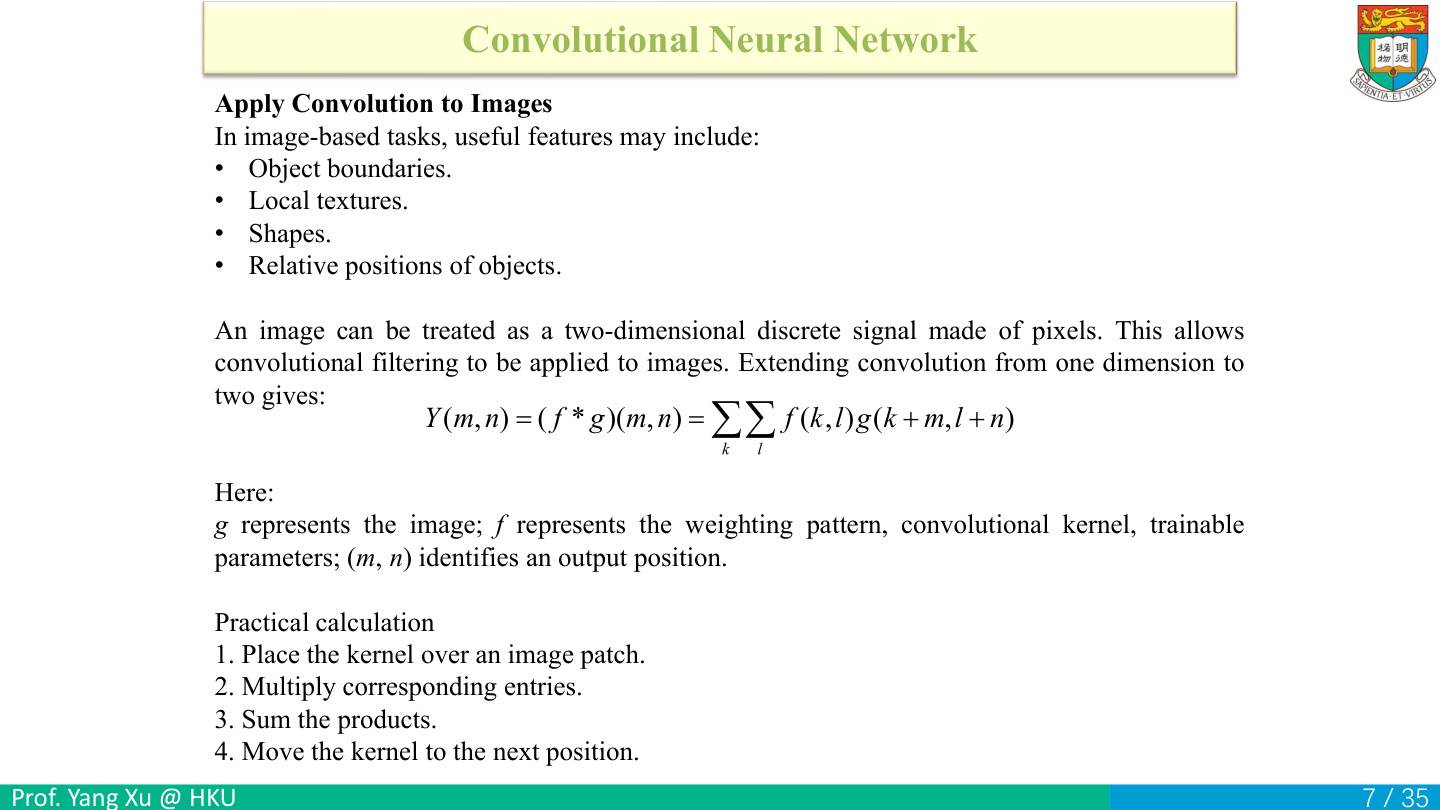
图像可看成像素组成的二维数组。把一个小权重矩阵放在图像一块区域上,对应相乘再相加,就得到输出某个位置的特征值。小窗口挪动后,重复使用同一组权重,这叫权重共享。
公式 Y(m,n)=Σ_kΣ_l f(k,l)g(k+m,l+n) 中,f是核、g是图像,m和n定位窗口,k和l遍历核内部。它直接用核中的权重读取图像,严格名称是互相关(cross-correlation);CNN也把这种运算称为卷积。第3页的数学卷积会翻转核,这里的图像运算保持核的方向。
用通常“行、列”记法可以写 Y[r,c]=Σ_iΣ_j K[i,j]X[r+i,c+j]。若图像有多个通道,还要对输入通道求和,并可加一个输出通道的偏置。核里每个数字是参数,输出图里的每个数字是激活值;输出图有很多位置并不意味着每处要学一套新参数。
例子:图块 [[1,2],[3,4]]、核 [[1,0],[0,−1]],响应 1×1+2×0+3×0+4×(−1)=−3。把核翻180度会得到3,所以两种约定确实不同。
自测:同一个核从左上移到右下,参数数量怎样变化?保持不变;它读取了另一块像素,使用的仍是同一套权重。
把四个卷积位置全部算出来
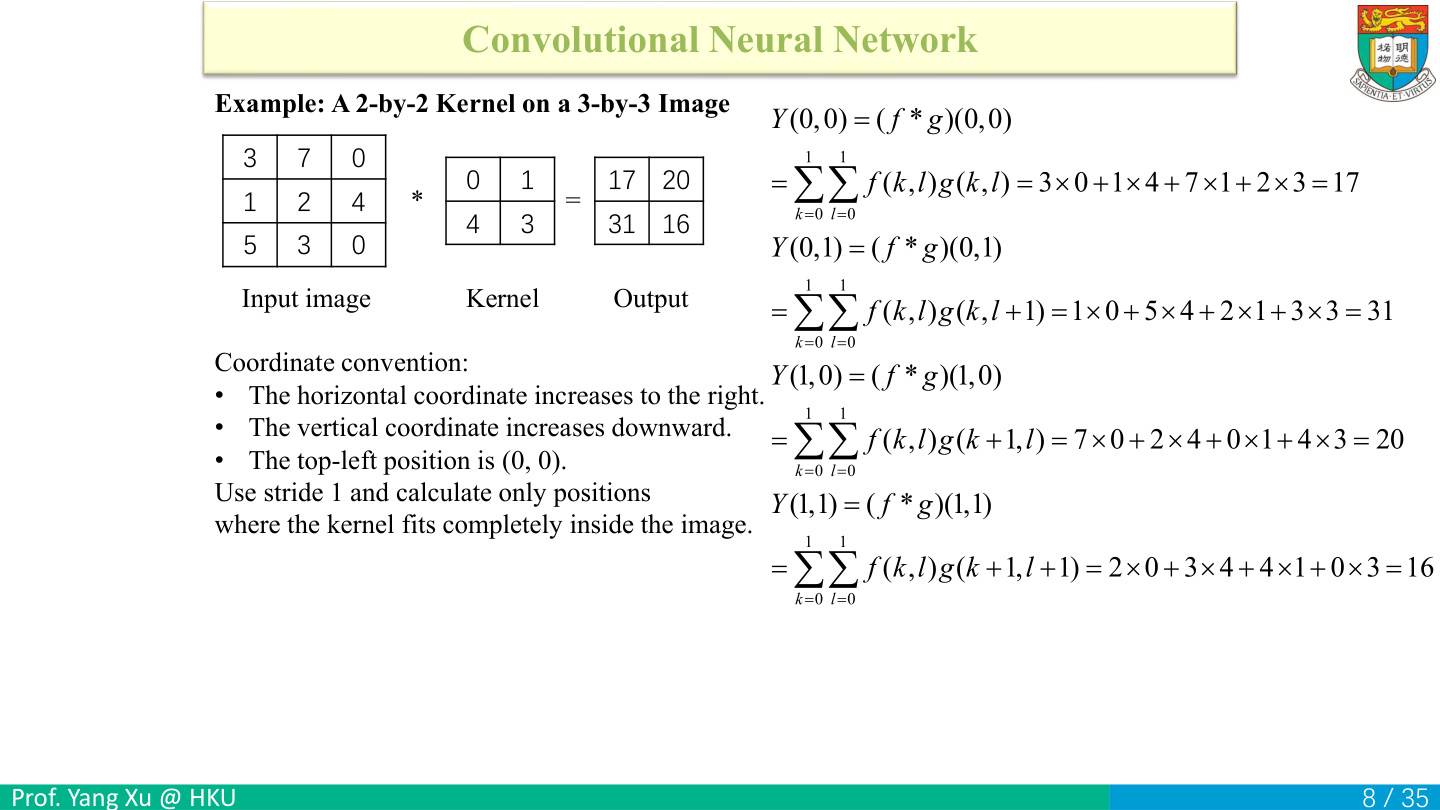
动手试试 · 移动2×2卷积窗口
原图 X=[[3,7,0],[1,2,4],[5,3,0]],核 K=[[0,1],[4,3]]。步长1表示每次移动一格;不补边,只在核完全放得下时计算。因此有2行、2列输出。以下采用程序最常见的 (行,列) 编号,避免与原页 (横坐标,纵坐标) 颠倒。
- 左上
Y[0,0]读取[[3,7],[1,2]]:3×0+7×1+1×4+2×3=0+7+4+6=17。 - 右上
Y[0,1]读取[[7,0],[2,4]]:7×0+0×1+2×4+4×3=0+0+8+12=20。 - 左下
Y[1,0]读取[[1,2],[5,3]]:1×0+2×1+5×4+3×3=0+2+20+9=31。 - 右下
Y[1,1]读取[[2,4],[3,0]]:2×0+4×1+3×4+0×3=0+4+12+0=16。
所以输出 [[17,20],[31,16]]。课件把横坐标放第一位,因此它的 Y(0,1)=31 是向下移动,而 NumPy 常用的 Y[0,1]=20 是向右移动。两者计算没有矛盾,是坐标命名不同。
本题的运算到乘加为止。若后面接ReLU,再把负数置0;若给出偏置b,再对每个窗口的乘加结果加b。
自测:若核全为0,四个输出是多少?全部0。若额外规定偏置−1,则才会变成全−1;偏置必须看题设是否存在。
输出尺寸与padding:先数窗口能放几次
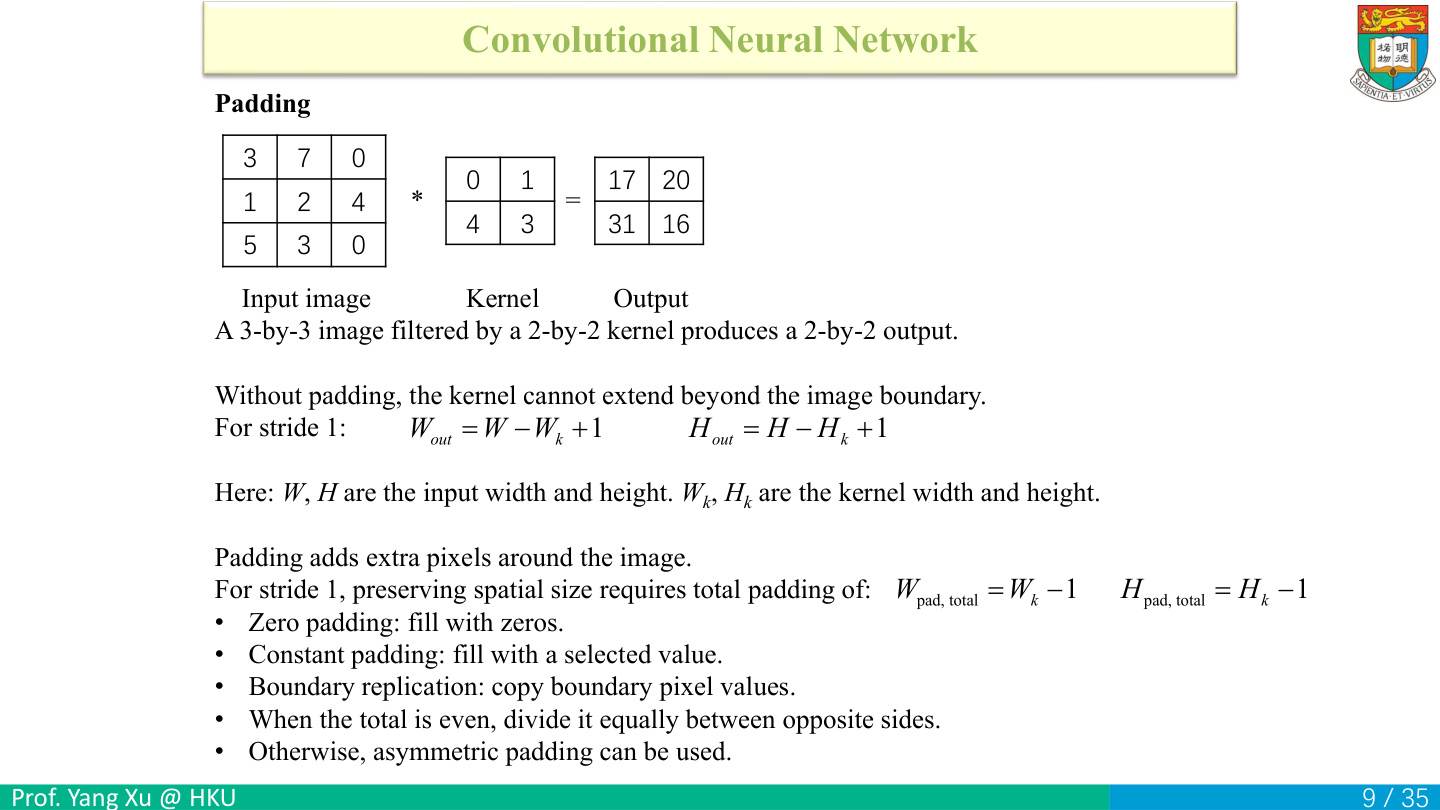
没有补边时,宽度W上的核宽为k,步长1。核起点可以在 0,1,…,W−k,一共 W−k+1 个,因此 Wout=W−k+1;高度同理。3×3输入和2×2核产生2×2输出,是在数合法起点,不是在记魔法公式。
若左、右分别补 pL,pR 格,宽度变 W+pL+pR,输出宽变 W+pL+pR−k+1。想在步长1时保持W不变,令两边相等,消去W后得到 pL+pR=k−1。这是两侧总补边量。3×3核总补2,可左右各1;2×2核总补1,不能左右各半格,需一侧0、一侧1。
步长为s时,第j步的窗口从js开始,末端在js+k−1。补边后最后一格下标是W+pL+pR−1,所以完整窗口满足 js+k−1≤W+pL+pR−1。移项得 js≤W+pL+pR−k。最大的j是 floor((W+pL+pR−k)/s),再数上j=0,输出宽就是这个值+1。例:宽7、核宽3、步长2、无补边,起点0、2、4,输出宽3。
补0、固定常数、复制边界值都是不同边界假设。补边不是凭空恢复图像外的真实信息,它只是规定“越过边界时输入取什么值”。
自测:5×5输入、3×3核、步长1,四边各补1,输出几乘几?(5+1+1−3)+1=5,所以5×5。若不补则3×3。
非对称补边:九个输出逐一核算
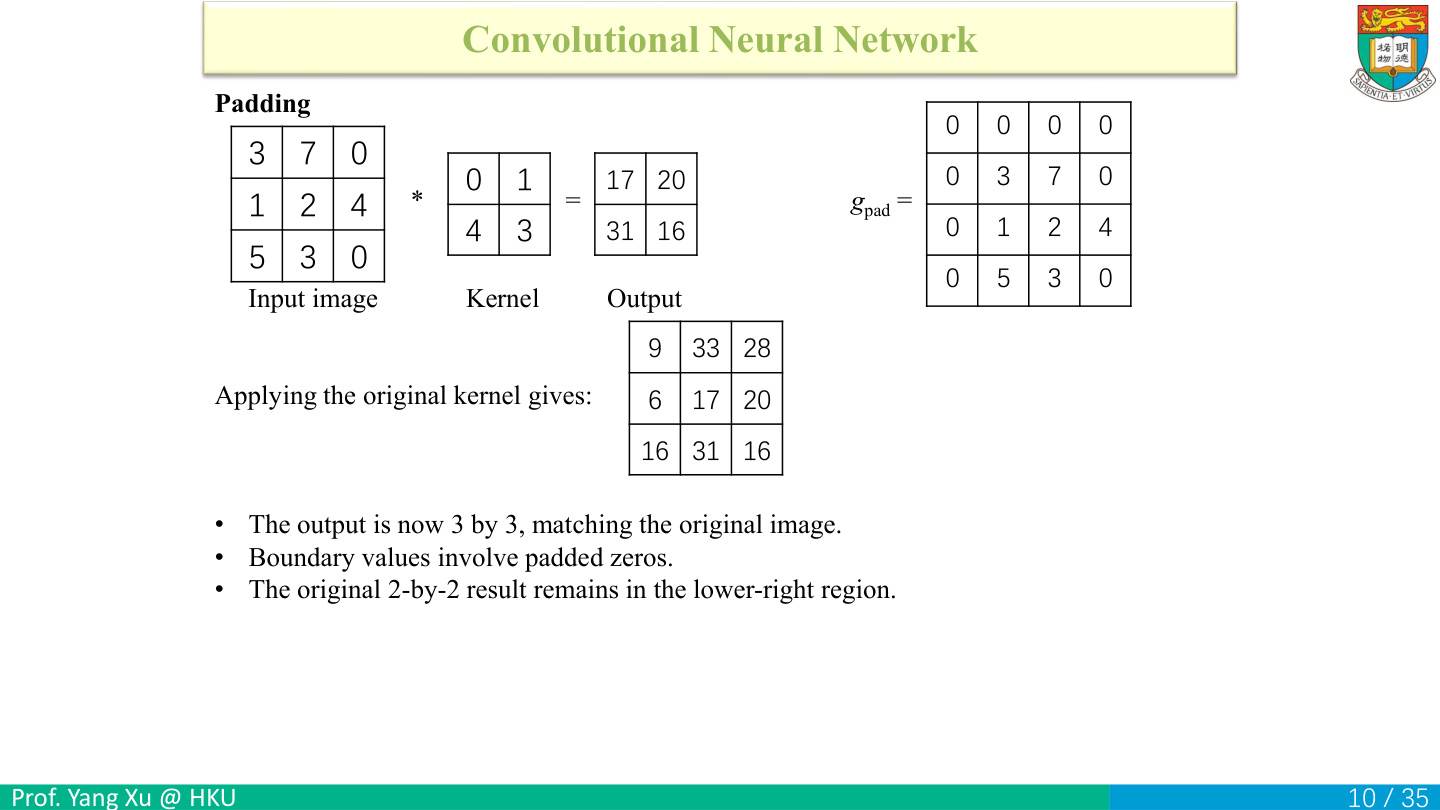
图中给3×3图像的顶部和左侧各补一行/列0,右侧和底部不补,得到 [[0,0,0,0],[0,3,7,0],[0,1,2,4],[0,5,3,0]]。2×2核仍是 [[0,1],[4,3]]。总补边每个方向只有1格,因此输出恢复3×3。
按行从左到右算,四个对应项全部写出:
第1行:0×0+0×1+0×4+3×3=9
       0×0+0×1+3×4+7×3=33
       0×0+0×1+7×4+0×3=28
第2行:0×0+3×1+0×4+1×3=6
       3×0+7×1+1×4+2×3=17
       7×0+0×1+2×4+4×3=20
第3行:0×0+1×1+0×4+5×3=16
       1×0+2×1+5×4+3×3=31
       2×0+4×1+3×4+0×3=16
于是输出为 [[9,33,28],[6,17,20],[16,31,16]],原来的2×2结果位于右下。原因是原图整体往右下偏移了一格,旧窗口在新坐标中的起点也随之改变。
补边位置怎样影响结果:这里只在顶部和左侧补1格。若改成四边各补1格,输入会变5×5,输出变4×4,边界上的数值也随之改变。
自测:新输出左上为什么不是0?窗口虽有三个0,右下还有原图的3,乘核右下3得到9。
感受野:一个输出究竟看到了原图多大区域
感受野是能够影响某个激活值的原始输入区域。单层3×3卷积的一个输出最多直接依赖3×3输入;下一层的3×3窗口读三个相邻的第一层位置,又会间接读更大一片原图。感受野说的是依赖范围,不是通道数,也不是模型参数总数。
把两层3×3卷积沿水平方向画成一行。两层步长都为1,第二层中心输出会读取第一层的三个相邻位置,各自再往原图追一层。
| 第一层位置 | 它读到的原图位置 |
|---|---|
| r−1 | r−2,r−1,r |
| r | r−1,r,r+1 |
| r+1 | r,r+1,r+2 |
去掉重复位置,原图从r−2到r+2共5格。竖向同理,因此感受野是5×5。再加一层相同卷积,左右各扩一格,变成7×7。
小区域适合边缘、局部纹理;更大区域能组合眼睛、鼻子、嘴巴之间的布局。仅看到一小片相似纹理,可能分不清人脸还是别的物体,所以要逐层整合上下文。但更大并不自动更好,细小缺陷也可能因下采样而消失。
一个实用计算法:初始感受野r=1、原图步距j=1;经过核k、步长s的一层,r_new=r+(k−1)j、j_new=js。先用旧j算r,再更新j。
自测:3×3步长1卷积后再2×2步长2池化,池化输出的感受野多宽?3+(2−1)×1=4,不是6;原图步距此时变2。
最大池化与平均池化:四块窗口分别做什么
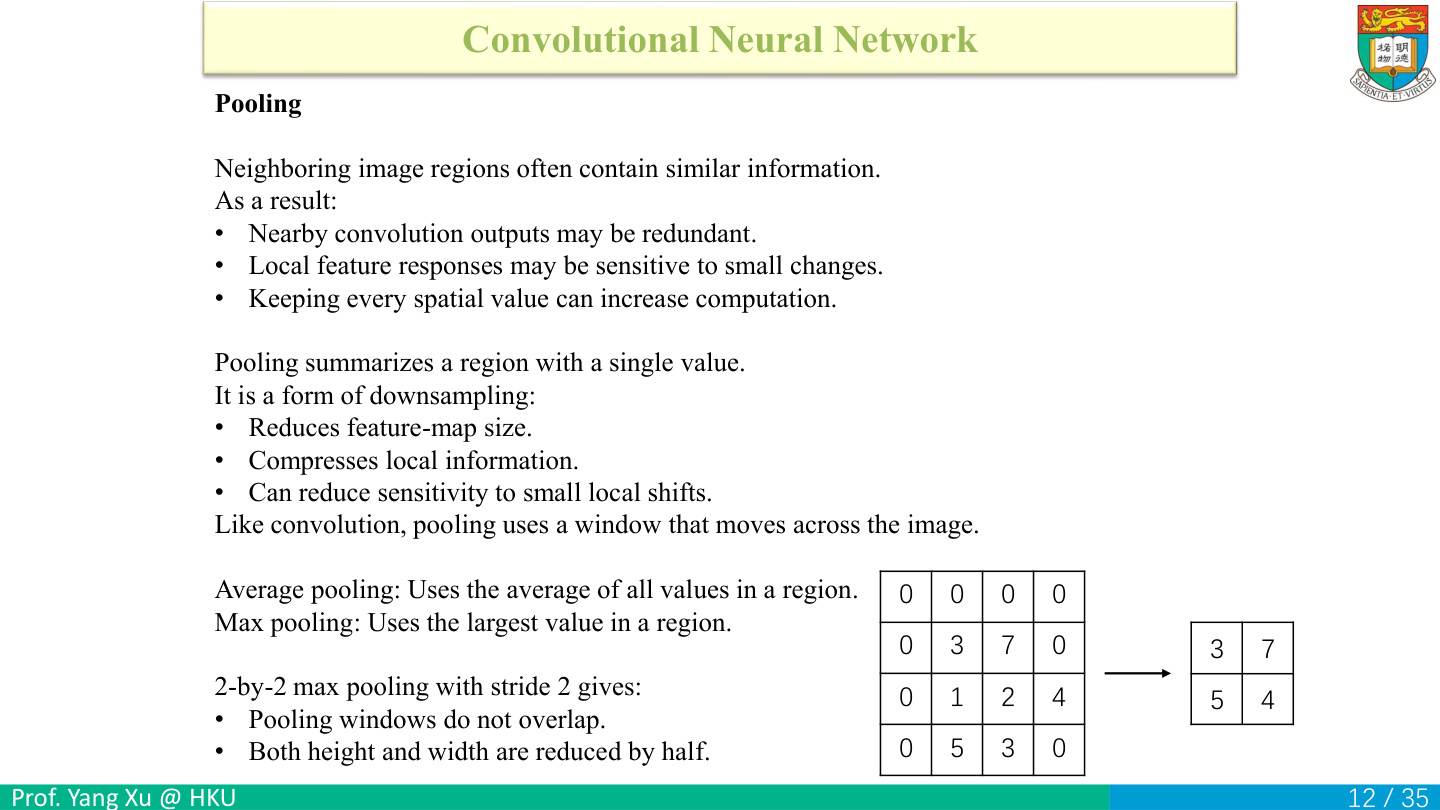
池化用一个数概括局部区域。max pooling取最大值;average pooling取平均值。普通池化没有需要训练的卷积权重。窗口大小和步长是设置值,不是通过梯度学出来的数字。
输入为 [[0,0,0,0],[0,3,7,0],[0,1,2,4],[0,5,3,0]]。2×2窗口、步长2,横竖每次跳两格,四块不重叠:
- 左上
[0,0;0,3]:最大3;平均(0+0+0+3)/4=0.75。 - 右上
[0,0;7,0]:最大7;平均1.75。 - 左下
[0,1;0,5]:最大5;平均1.5。 - 右下
[2,4;3,0]:最大4;平均2.25。
所以最大池化输出 [[3,7],[5,4]]。高宽各减半,位置数从16变4;若输入有多个通道,通常每个通道各自池化,通道数不变。不要对整张特征图只取一次全局最大值,除非题目明确要求 global pooling。
池化将一个窗口压成一个值,因此会丢失窗口内的精确位置。小幅移动若仍留在同一窗口,最大值常能保持;跨过窗口边界时,输出就可能改变。反向传播时,最大池化把梯度送回窗口最大值的位置。
自测:窗口 [−2,−1;−5,−3] 的最大池化结果是多少?−1。若之后再接ReLU,才会变成0。
从局部特征到类别:按数据形状走完整个CNN
点击图片放大。
课堂补充
Week07课堂讲解 · Part01 00:39:44–00:48:20
池化与分类结构
Week07课堂讲解 · Part01 00:57:55–01:20:44
Softmax、AlexNet、通道、Flatten与ReLU
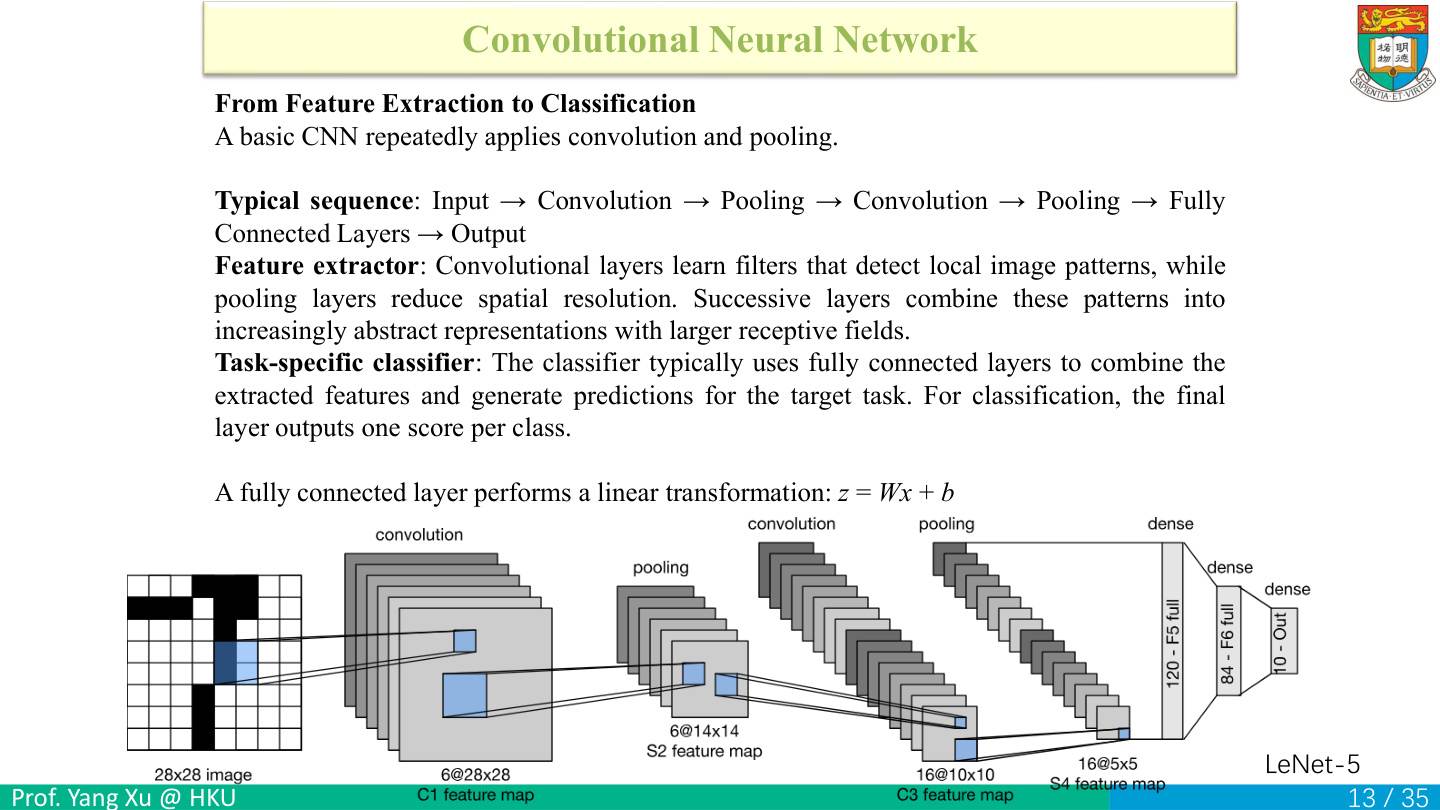
LeNet型CNN前半用卷积和池化提取局部特征,后半用全连接层组合这些特征,产生类别分数。训练时,损失的梯度同时更新前后两部分。
全连接层做 z=Wx+b。在图中的最后一层,x有84维,W为10×84,b有10维,得到10个类别分数。第c个分数是84个加权项的和,再加该类别的偏置;这一层参数数为 10×84+10=850。
Flatten按固定顺序把特征图展成向量。例如16张5×5特征图共 16×5×5=400 个数,展开后仍是这400个数。
自测:16张5×5特征图,接120个全连接节点,共多少参数?400×120+120=48120。
沿原图逐层计算:28×28图像→6@28×28,@表示6张28×28特征图;卷积保持高宽,输出6通道。池化→6@14×14;第二次卷积→16@10×10;第二次池化→16@5×5;Flatten→400维;全连接依次 400→120→84→10。若第二次卷积取步长1、不补边,14变10对应5×5核,因为 14−5+1=10。最后的10是类别数,120与84是中间隐藏节点数。
Softmax和交叉熵:从分数到损失再到更新
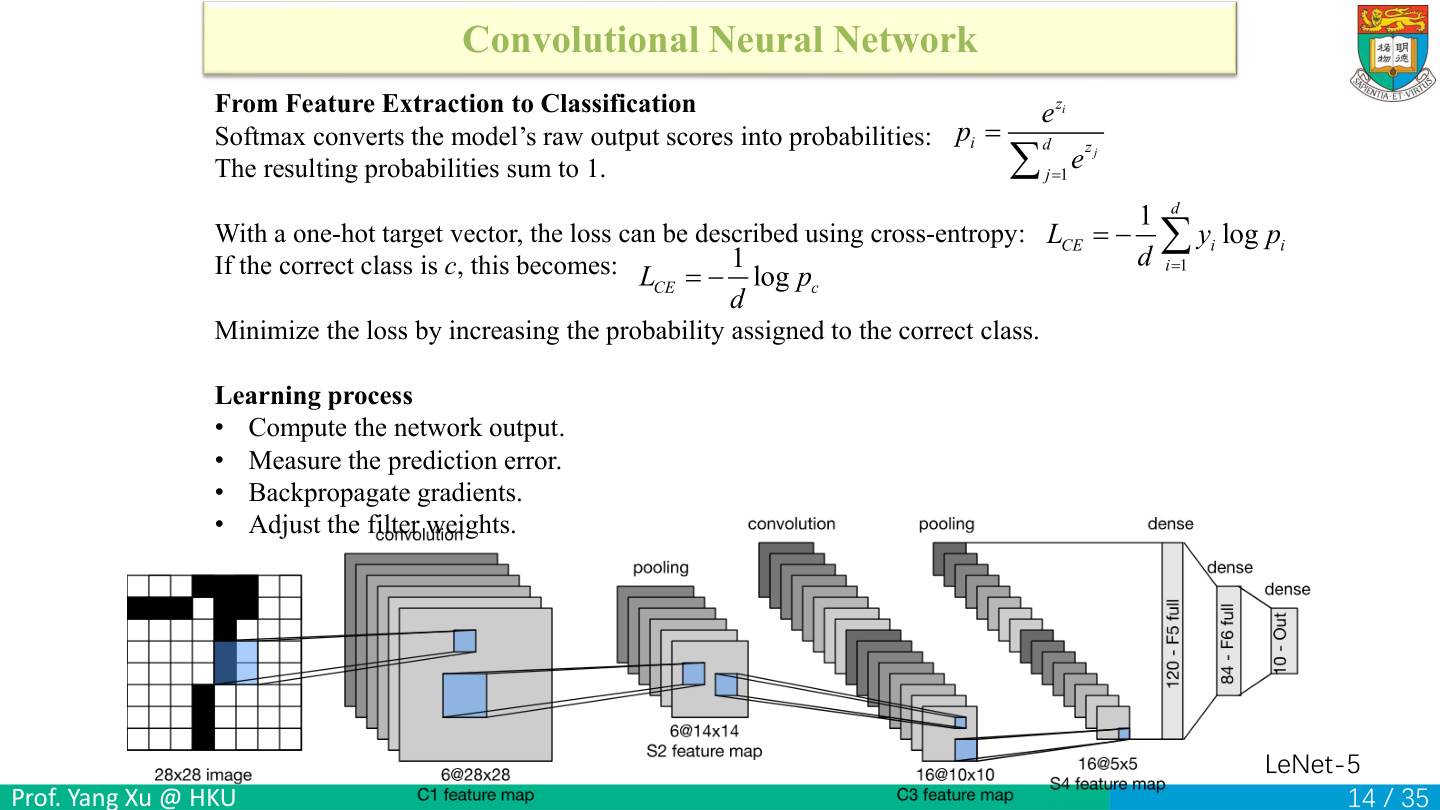
网络最后输出的z叫logits(原始分数),可正可负,也不要求和为1。softmax定义 p_i=exp(z_i)/Σ_j exp(z_j)。指数令各项为正;除以总和令全部概率加起来为1。它使不同类别相互竞争。
算一遍:z取 [ln2,0,0],指数为 [2,1,1],总和4,概率 [0.5,0.25,0.25]。若正确类别是第1类,one-hot标签为 [1,0,0]。标准单样本交叉熵 −Σ_i y_i ln p_i 只剩 −ln0.5≈0.6931。若正确类概率提高至0.9,损失变约0.1053,确实更小。
原页在类别求和前额外乘 1/d(d为类别数),所以该页损失是标准单样本交叉熵再除d。按其约定,上例d=3时为0.2310。两种定义只差常数,但梯度大小也差d倍。通常“对批量取平均”除的是样本数B,不能把B与类别数d混为一谈。
梯度从两个项来。把真类c的损失写开:−ln p_c = −z_c + ln(Σ_j exp(z_j))。
- 对第i个分数求导,第一项贡献−1(i=c)或0(i≠c),合写成
−y_i。 - 第二项先求对数导数,再乘里面的导数,得到
exp(z_i)/Σ_j exp(z_j)=p_i。 - 相加得
p_i−y_i。上例是[−0.5,0.25,0.25]。梯度下降减去梯度,真类分数上升、其他分数下降。若用原页的1/d缩放,再把这三个梯度各除d。
实际计算:算softmax可先令 z'=z−max(z),避免指数太大;各分数同减常数不改变概率。自测:所有logit都相同,概率各是多少?1/d。
AlexNet第一层:多个滤波器就是多个输出通道
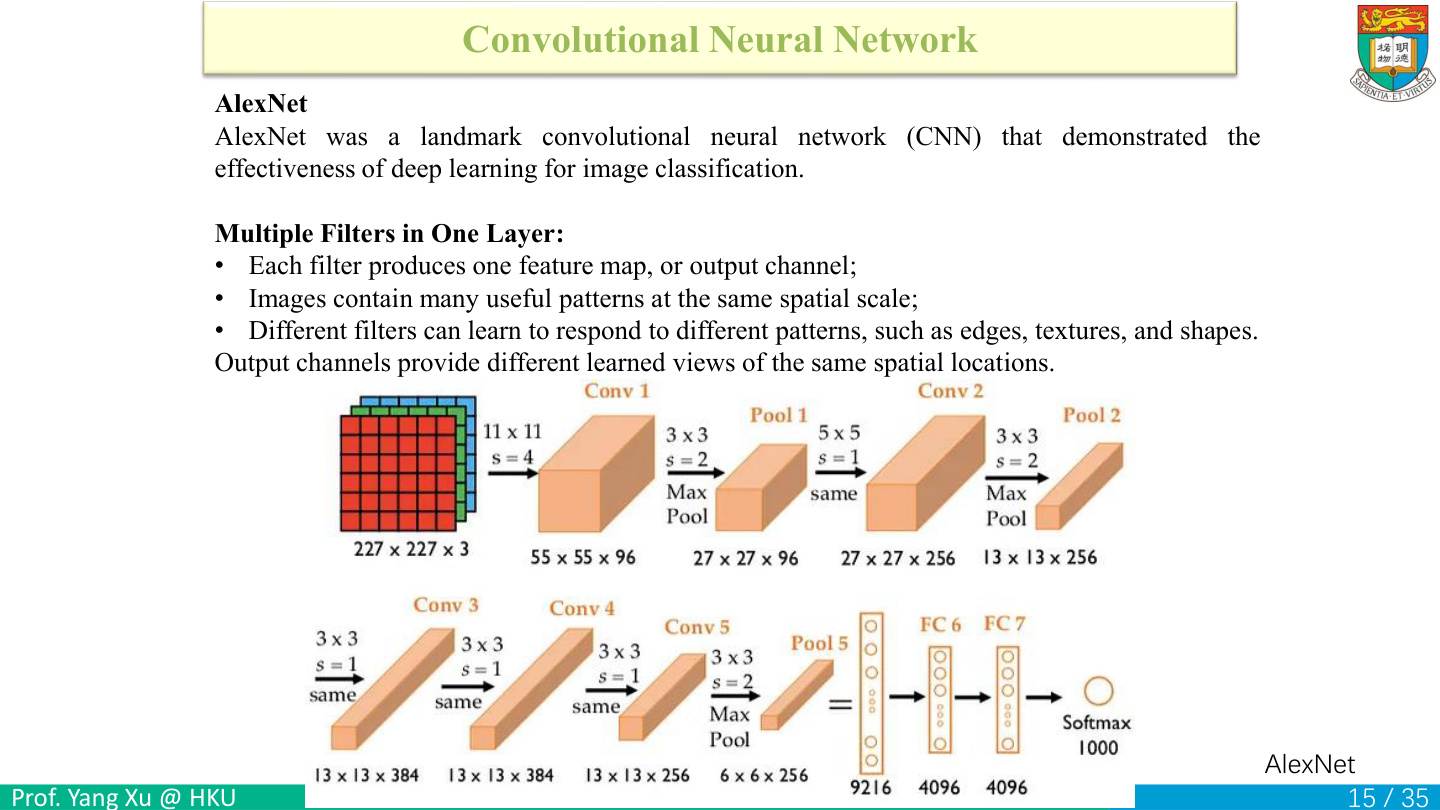
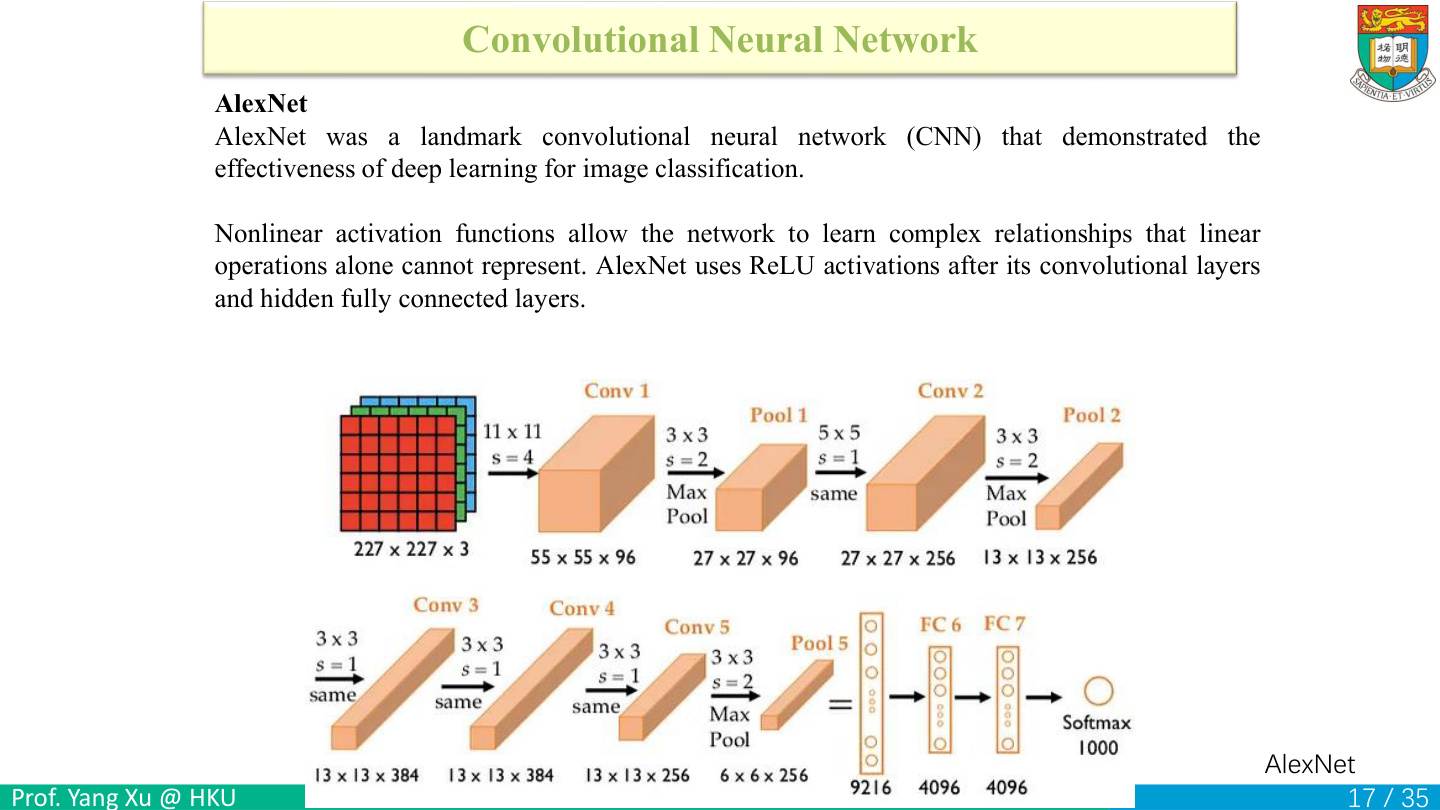
本页借AlexNet介绍同一层的多个滤波器。一个核可以偏好竖边,另一个偏好横边或纹理。它们同时看相同位置的图像,但使用不同参数,因此输出不同特征图。把这些图叠起来,就是通道维度。
彩色图通常有红、绿、蓝三个输入通道。一个输出通道对应的核并不是只看一张2D图,而是对三个通道各有一组空间权重,再把三个通道的响应相加,最后加一个偏置。若核为3×3、输入通道3,则每个输出通道有 3×3×3=27 个权重与1个偏置。
例子:输出通道8,参数总数为 (3×3×3+1)×8=224。如果输入图变得更大,在同样的通道数、核大小和共享方式下,参数仍是224;变化的是卷积要计算的空间位置数和计算量。这正是共享权重与全连接层的重要区别。
在图上识别三个方向:平面的宽和高代表空间分辨率,叠起来的厚度代表通道数。输出通道8不等于有8个最终类别;分类头可以把它们综合成10类或其他类别数。
自测:灰度图、5个3×3输出核,每个有偏置,共多少参数?5×(9+1)=50。
沿图从227×227×3开始。每一行的输出接到下一行。
| 操作 | 边长怎样算 | 输出形状 |
|---|---|---|
| Conv1:11×11、步长4 | (227−11)/4+1=55 | 55×55×96 |
| Pool1:3×3、步长2 | (55−3)/2+1=27 | 27×27×96 |
| Conv2:5×5、步长1、两边各补2 | 27+4−5+1=27 | 27×27×256 |
| Pool2:3×3、步长2 | (27−3)/2+1=13 | 13×13×256 |
| Conv3→Conv4→Conv5:3×3、步长1、两边各补1 | 13+2−3+1=13 | 13×13×384→13×13×384→13×13×256 |
| Pool5:3×3、步长2 | (13−3)/2+1=6 | 6×6×256 |
把最后一层展成6×6×256=9216个数,再经过两个4096维全连接层。1000个输出分数进入softmax,得到1000类概率。
AlexNet逐层变化:空间缩小,通道可以增多
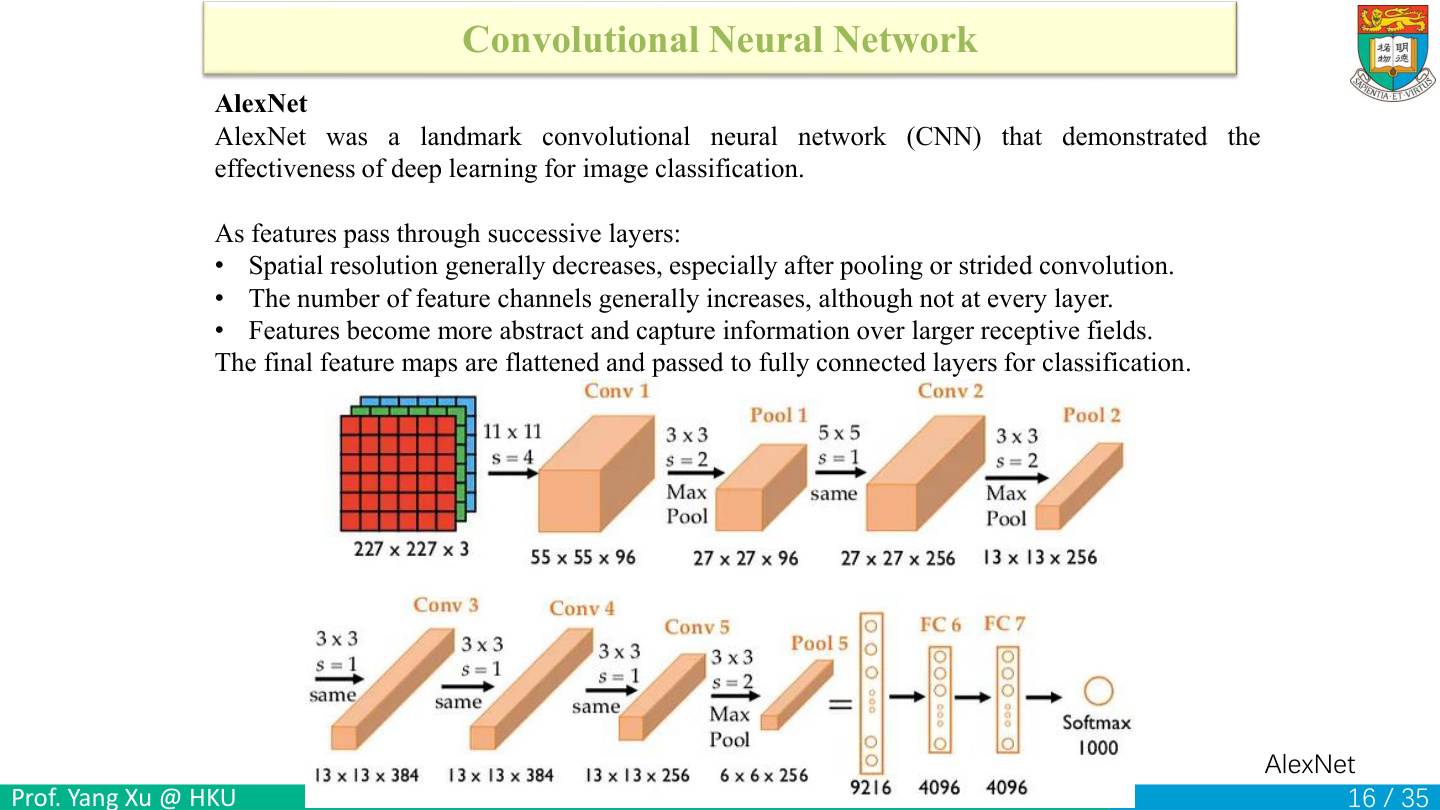
沿AlexNet的箭头看两种变化:池化或大步长卷积缩小高宽,卷积核的数量决定输出通道。图中的通道序列有增加、保持和减少三种情况。
算一遍:输入特征 16×16×8,3×3卷积、步长1、每边补1、输出通道16,得到 16×16×16;接2×2步长2池化,得到 8×8×16。卷积参数 (3×3×8+1)×16=1168;池化参数0;Flatten长度 8×8×16=1024。
空间位置减少后,深层特征将较大区域内的模式组合起来。例如先检测边缘,再组合成轮廓和部件。高宽描述特征的位置,通道描述同一位置的不同响应。
图中最后由三维特征变成一维向量后接全连接层。全连接参数可能很多:1024输入、100隐藏节点就有 1024×100+100=102500。因此图像尺寸和池化设置会直接影响分类头的大小。
自测:8×8×16展开后多长?8×8×16=1024。这个长度就是下一全连接层的输入维数。
从图上挑相邻两步对照。Pool2把27×27×256变为13×13×256,分辨率改变,通道保持。Conv3把13×13×256变为13×13×384,分辨率保持,通道增加。Conv5又把384降到256。最后的差异体现在占多少位置和每个位置有多少种特征。
ReLU:为什么层数很多还需要非线性
ReLU定义 a=max(0,z):正数原样通过,负数变0。例子 z=[−2,0,3] 变为 [0,0,3]。它是逐元素操作,不改变张量的高、宽或通道数,也没有可学习权重。
为什么需要它?两层若只有线性或仿射运算,h=W1x+b1、z=W2h+b2,代入即 z=(W2W1)x+(W2b1+b2),仍可写成一层。中间加ReLU后,不同输入使不同节点被截断,整体成为分段线性函数,不能通常合并成一个固定矩阵。这让网络能表达更复杂的类别边界。
反向传播时,z>0处导数1,梯度通过;z<0处导数0,梯度被挡住;z=0处通常约定导数为0。于是一个ReLU神经元在这次输入下是否激活,会影响哪些参数收到梯度。
算一遍:一个神经元 z=2x−3。x=1时z=−1、输出0;x=2时z=1、输出1。它在阈值1.5处改变响应。多个这样的单元组合,能拼出多段响应。
自测:卷积输出−3,接ReLU后是多少?0。卷积先做乘加,ReLU再做截断,两步顺序分开算。
VGG:重复的小模块怎样构成大网络
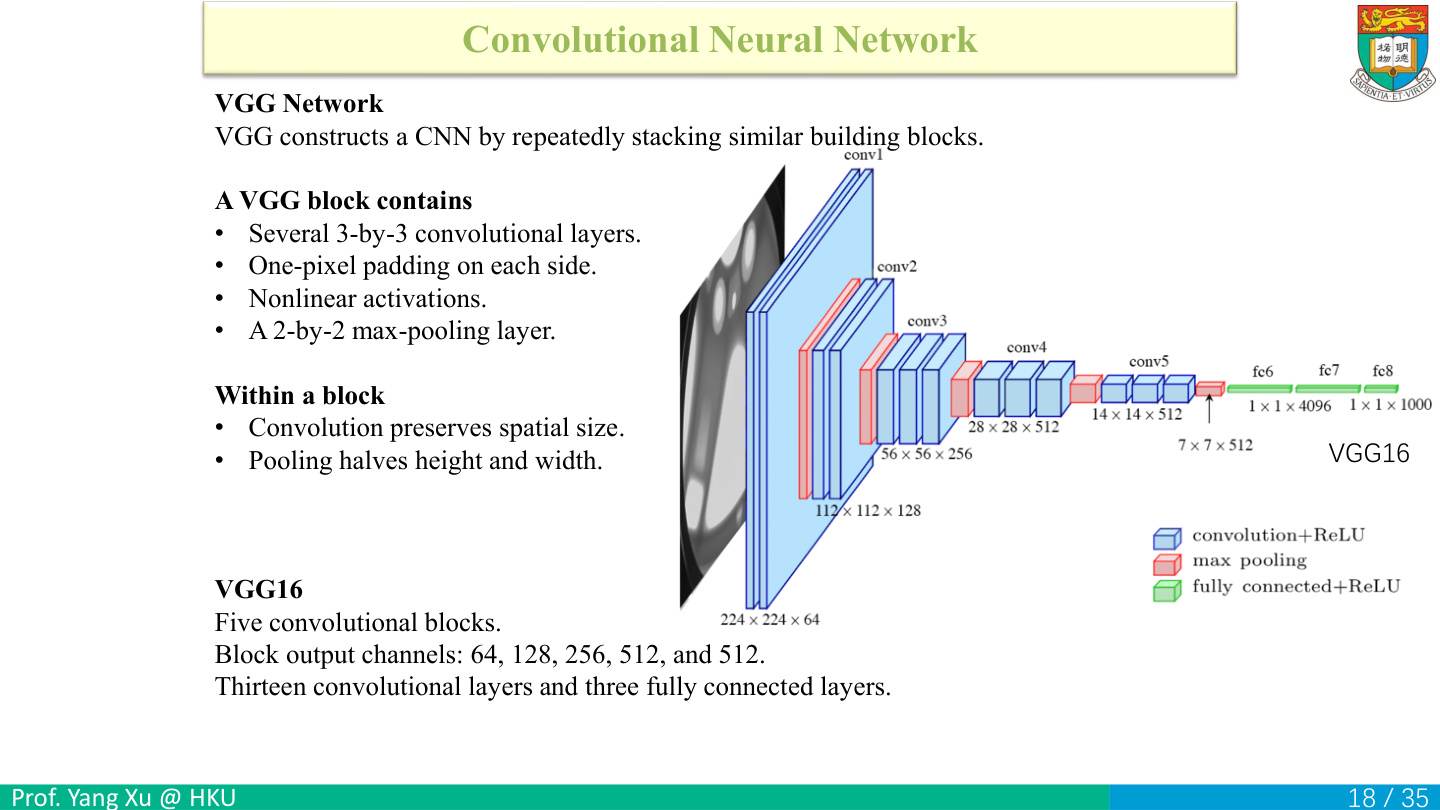
VGG把相似模块反复堆叠。课件的block包括若干3×3卷积、每边1格补0、非线性激活,最后用2×2最大池化。步长1时,卷积输出边长 W+2−3+1=W,所以block内部卷积保持高宽,池化才把高宽大致减半。
VGG16中的16按带权重的层计数:13层卷积加3层全连接,不把ReLU、池化、Flatten全部数进去。五个卷积块输出通道依次64、128、256、512、512,因此最后两个block通道不再翻倍。仅看“16”不能推断每一层尺寸。
输入边长224,经过五次2×2步长2池化,依次变成112、56、28、14、7。每次把边长除2,五次后为 224/2⁵=7。
为什么堆小核?在相同通道数C、忽略偏置时,两层3×3有 18C² 权重,感受野可到5×5;一层5×5有 25C² 权重。两层之间还多一次非线性。比较成立需要通道安排相同,不能在不同输入输出通道下直接套18和25。
自测:32×32输入,在一个block里经过两次3×3步长1补1卷积,再经过2×2步长2池化,最终多大?两次卷积均保持32×32,池化后为16×16。
原图每到一个新卷积块,先看高宽,再看蓝色特征图的通道数。
| 卷积块 | 块内输出 H×W×C | 最大池化后 |
|---|---|---|
| 1 | 224×224×64 | 112×112×64 |
| 2 | 112×112×128 | 56×56×128 |
| 3 | 56×56×256 | 28×28×256 |
| 4 | 28×28×512 | 14×14×512 |
| 5 | 14×14×512 | 7×7×512 |
最后展开7×7×512=25088个数,接全连接层4096→4096→1000。图中的1×1×4096画法表示一个4096维向量。
数据增强的目的:让模型少记住偶然的拍摄条件
过拟合可以理解成“练习题背得很好,换个拍法就不会了”。参数很多、训练照片少时,模型可能记住背景、光线和固定位置,而没有学到真正与类别相关的特征。正则化、dropout约束模型;数据增强则在训练输入上制造合理变化,两种方法可以配合。
例子:100张零件照片都在白桌面拍摄,缺陷照片又恰好偏暗,模型可能用“暗不暗”判断缺陷。给正常与缺陷照片都随机改变亮度,就能让模型更多关注零件本身。
一套稳妥顺序是:先按原始对象或拍摄批次划分训练/验证/测试;再只在训练集内生成随机增强;验证和测试用固定预处理。若先增强再随机分割,同一原图的不同版本可能进入训练和测试,结果会虚高,这叫数据泄漏。
每种增强都暗含“这个变化不该改变目标”的假设。判断增强是否合理,先问任务想保留什么。例如旋转普通零件可能仍是同类,但把数字6旋转180度可能变成9,原标签便不能盲目保留。
自测:识别数字时,为什么旋转幅度要受限制?因为把6转180度可能变成9,标签含义会改变。增强需要保留任务要预测的内容。
五类增强逐项理解:图像变了,标签要不要变
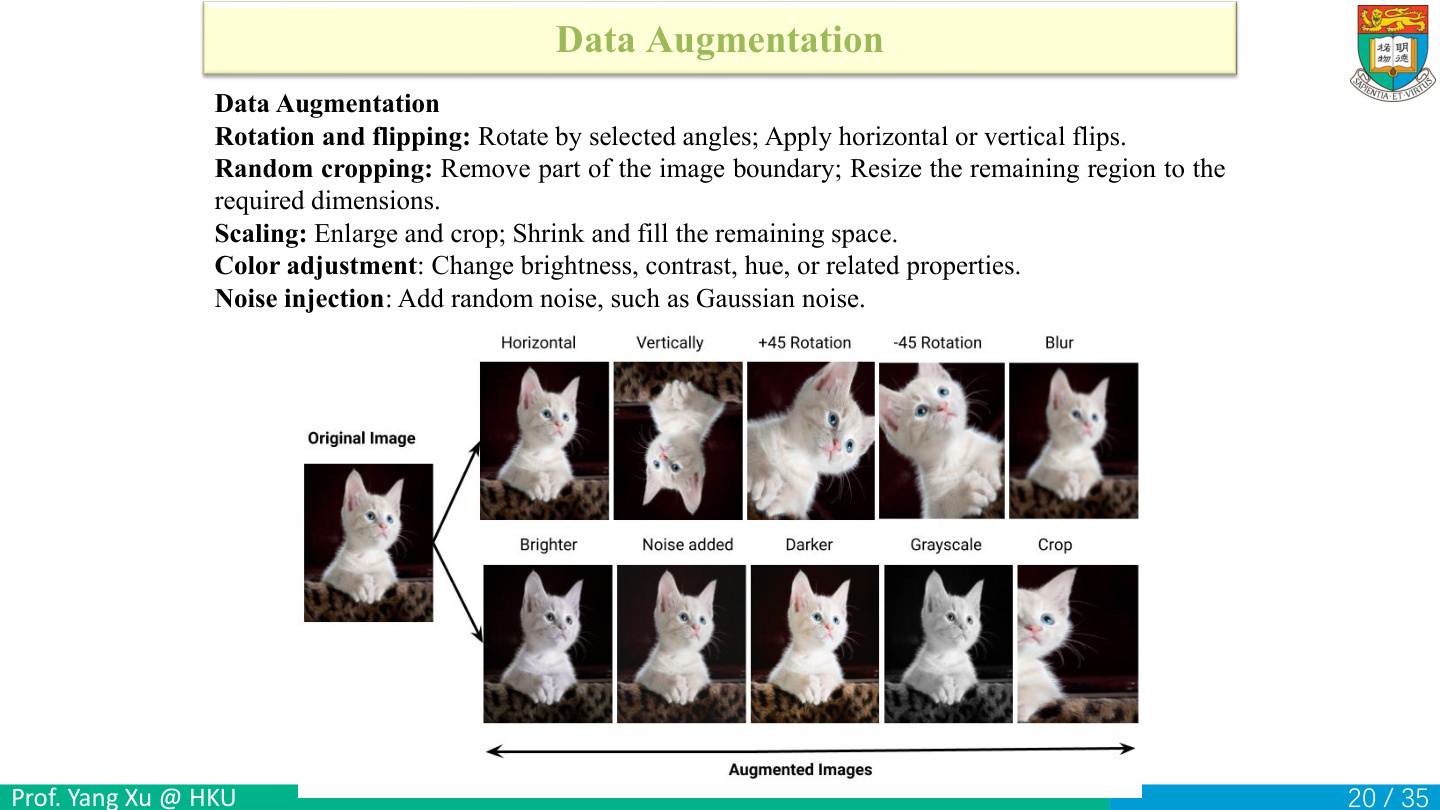
常见增强分五类:旋转/翻转、裁剪、缩放、颜色调整、加噪声。下面分别看它们改变了图像的哪一部分,以及标签怎样一起处理。
- 旋转与翻转:改变像素位置。若只是物体分类且类别不变,可保留类别标签;若预测抓取点、检测框或分割掩码,坐标也要随相同变换一起改。左右翻转不等于上下翻转。
- 随机裁剪:截取部分区域再调整尺寸。若裁掉了整件缺陷,仍标“有缺陷”会制造错误监督。坐标任务还要减去裁剪起点,再按缩放比例变换。
- 缩放:放大后可能裁边,缩小后可能补边。宽高同比缩放可保持形状;不同比例会拉伸物体,要判断是否合理。
- 颜色调整:亮度、对比度、色相变化通常不改位置,但若任务依赖颜色判材质或警示灯状态,改变颜色可能改变标签意义。
- 噪声注入:例如
x'=clip(x+ε,0,1),ε来自均值0的高斯分布。clip把值限制在合法范围;噪声尺度太大会掩盖原信息。
教学坐标算例:宽100的图,横坐标按0–99编号,水平翻转把x=20变成 99−20=79,y不变。若写 100−20=80 就差一格。
自测:只调亮度,抓取点坐标是否应移动?不应;但裁剪、旋转和翻转通常需要更新几何标签。随机参数必须对图像与对应标签保持一致。
机器人抓取增强:背景能换,抓取位置不能乱
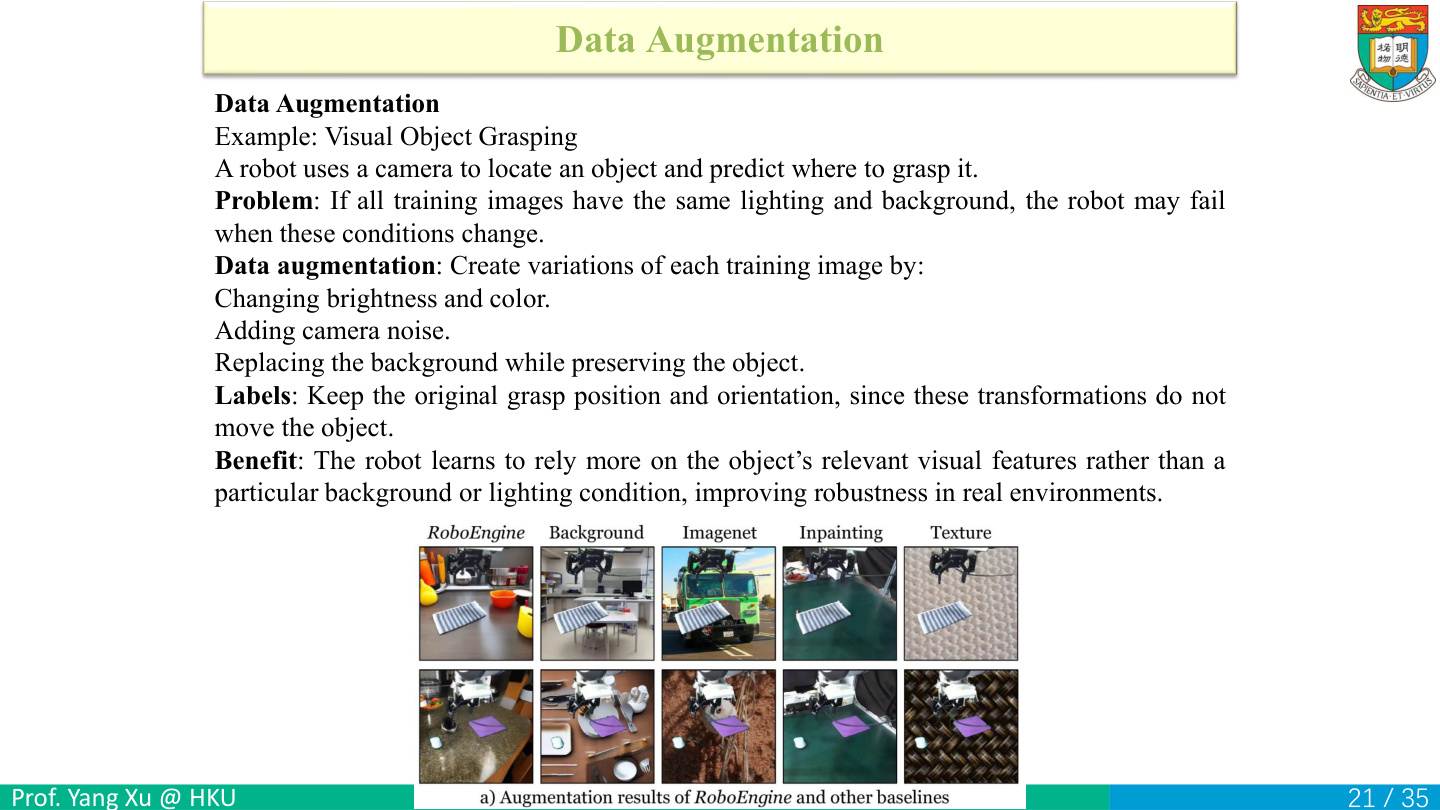
机器人根据相机图像预测抓取位置和角度。改变亮度、加入相机噪声、替换背景,可以让同一物体在训练时呈现不同外观,减少模型对固定拍摄环境的依赖。
对这些不移动物体的外观变换,抓取点 (u,v) 与角度θ可以保持原值。流程是:读取图像和原标签→生成外观变化→确认物体几何位置没变→用同一标签训练。替换背景应保留物体掩码,若把物体边缘切掉或贴到错误位置,就不再是本页所说的情况。
对照:原抓取点 (40,30),亮度乘0.8,仍是 (40,30);若把图顺时针旋转90度,抓取点与角度都应根据旋转中心变换,不能照抄原标签。增强代码先判断是否几何变化,比机械“标签都不动”更可靠。
休息
休息15分钟。前半讲完CNN,后半开始学习无标签数据的聚类。
进入聚类
接下来学k-means:选中心→把样本分给最近中心→按组求均值→重复。再学k-means++怎样选择分散的初始中心。
聚类设定:样本数、特征维度和K不能混淆
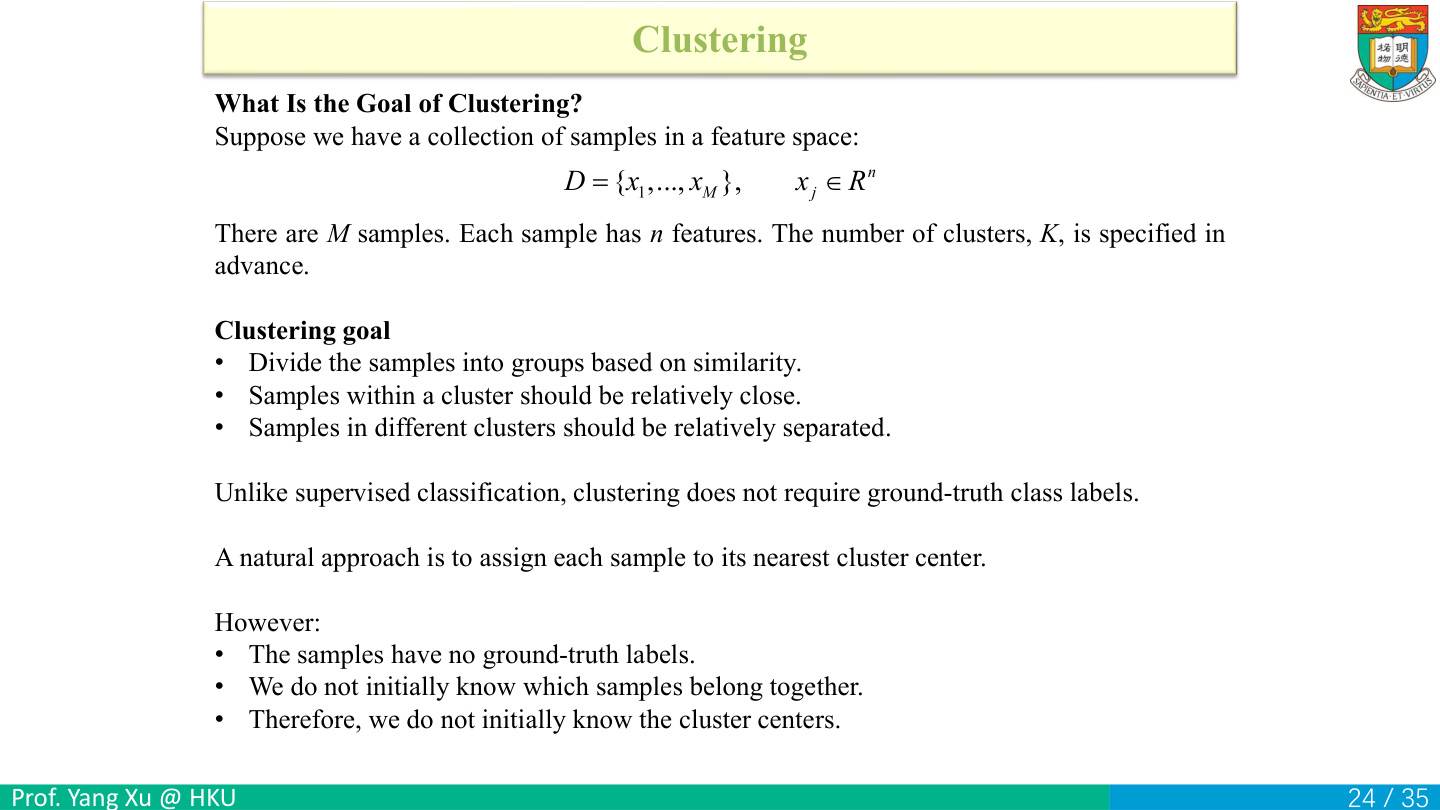
记号为 D={x1,…,xM}、xj∈R^n。M是样本个数,n是每个样本的特征个数,K是希望分成几组。例子中若记录6个时间窗口,每个窗口测电流和温度,那么M=6、n=2;若想找3种运行模式,K=3。
距离用来描述相似度。二维欧氏距离是 sqrt((a1−b1)^2+(a2−b2)^2);平方距离省去开根号。对同一个点比较哪个中心最近,距离与平方距离给出的排序相同,因为非负数平方是单调的。但优化总距离和与优化总平方距离不是同一目标。
没有标签时,初始不知道各组成员,也不知道各组中心:中心取决于成员,成员又取决于中心。k-means通过交替固定一部分来处理这个循环。它默认用“接近一个中心”来表达一组,适合相对紧凑的群体;弯月形、差异很大的密度结构未必适合。
例子:温度相差10、电流相差1,直接平方后为100和1,温度会更影响距离。把各特征减均值、除标准差后,可以用相对变化幅度计算距离。
自测:六个样本,每个样本有电流、温度两个数,分三组,M、n、K各是多少?M=6,n=2,K=3。
k-means的目标,以及均值为何是最佳中心
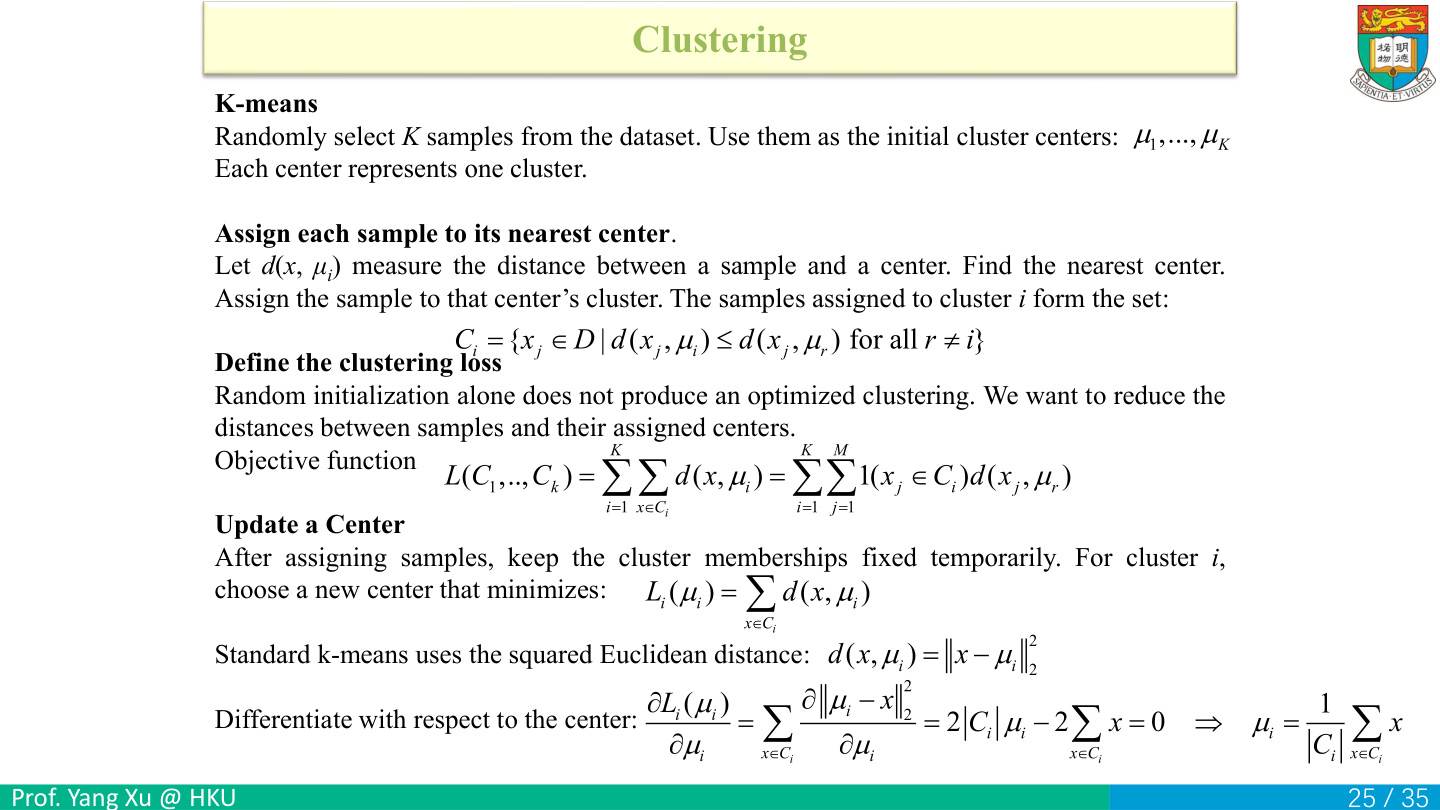
先选K个中心μ,再把每个样本交给最近中心。Ci表示第i组的样本集合;|Ci|是组内样本数。若多个中心距离相同,需要固定破平局规则,否则数学集合写“≤”可能使一个点同时满足多组,而程序通常要给唯一组号。
标准k-means最小化 L=Σ_i Σ_(x∈Ci) ||x−μi||²。两层求和的意思是:先加一组内所有点的平方距离,再把K组加起来。指示函数 1(x∈Ci) 在属于该组时取1,否则取0,能把相同目标写成对全部样本的求和。
固定组员,为什么中心应取均值?先用一维写清:Li(μ)=Σ(x−μ)^2=Σx²−2μΣx+mμ²,其中m=组员数。对μ求导,第一项不含μ所以为0;第二项导数 −2Σx;第三项导数 2mμ。令总导数0,2mμ−2Σx=0,两边除2m,得 μ=Σx/m。二阶导数2m>0,所以这是最小点。向量情形对每个坐标分别求平均。
算一遍:组内 [1,3,8] 的均值4,平方误差 9+1+16=26;若中心3,误差 4+0+25=29,更大。注意均值4不一定是原来某个样本,这是允许的。
自测:若目标改成绝对距离和,仍必定取均值吗?不是,一维绝对误差的最优点是中位数。若Ci为空,则无法除以0,需重置空簇等额外策略。
完整迭代:先分配全部样本,再统一更新中心
动手试试 · 交替分配样本和更新中心
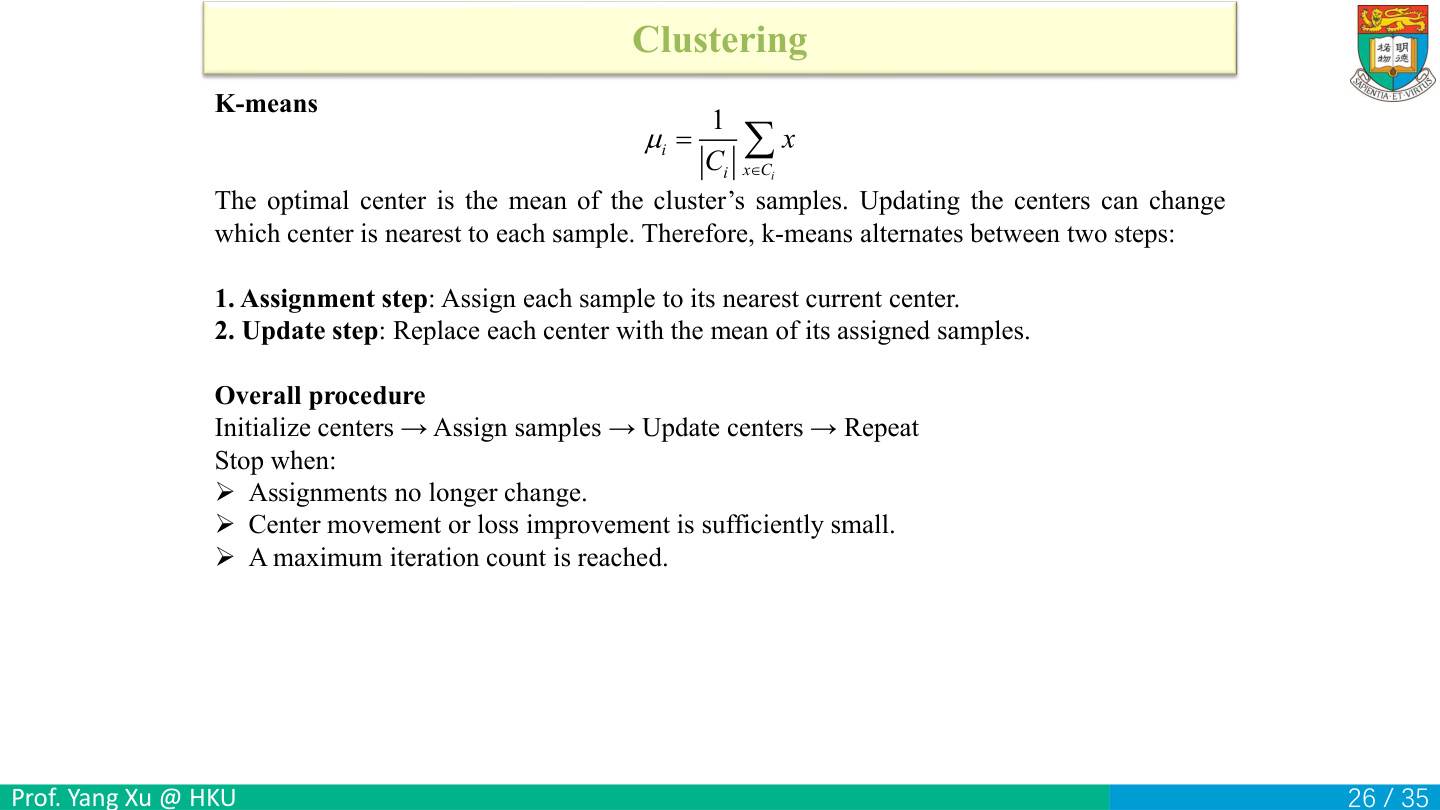
k-means重复两个阶段:assignment用当前中心给全部点分组;update对每组求均值,把它作为下一轮中心。更新时组成员暂时固定,下一轮才重新判断最近中心。
算两轮。数据为1、2、5、6,K=2,初始中心取1和2。每次分配都用同一对中心。
| 样本 | 第一轮到中心1、2的距离 | 第一轮去向 | 第二轮到中心1、13/3的距离 | 第二轮去向 |
|---|---|---|---|---|
| 1 | 0,1 | 组1 | 0,10/3 | 组1 |
| 2 | 1,0 | 组2 | 1,7/3 | 组1 |
| 5 | 4,3 | 组2 | 4,2/3 | 组2 |
| 6 | 5,4 | 组2 | 5,5/3 | 组2 |
- 读第一轮的去向,组1只有1,均值为1。组2有2、5、6,均值为(2+5+6)/3=13/3。
- 用新中心填第二轮距离。例如点2到13/3的距离是13/3−2=7/3,比它到1的距离1更大,所以移到组1。
- 第二轮更新后,中心分别为(1+2)/2=1.5与(5+6)/2=5.5。两中心中点是3.5。1、2仍在左边,5、6仍在右边,重新分配后分组稳定。
为什么目标会下降?分配阶段让每个点选最近中心,距离减少或保持;更新阶段用均值最小化组内平方误差,也会减少或保持。两步交替使损失逐渐稳定。
停止条件可用组号不变、中心移动小于容差、目标改善很小或达到最大迭代数。达到迭代上限只是计算停止,不一定表示已稳定。
初始中心为何重要:局部最优与多次重启
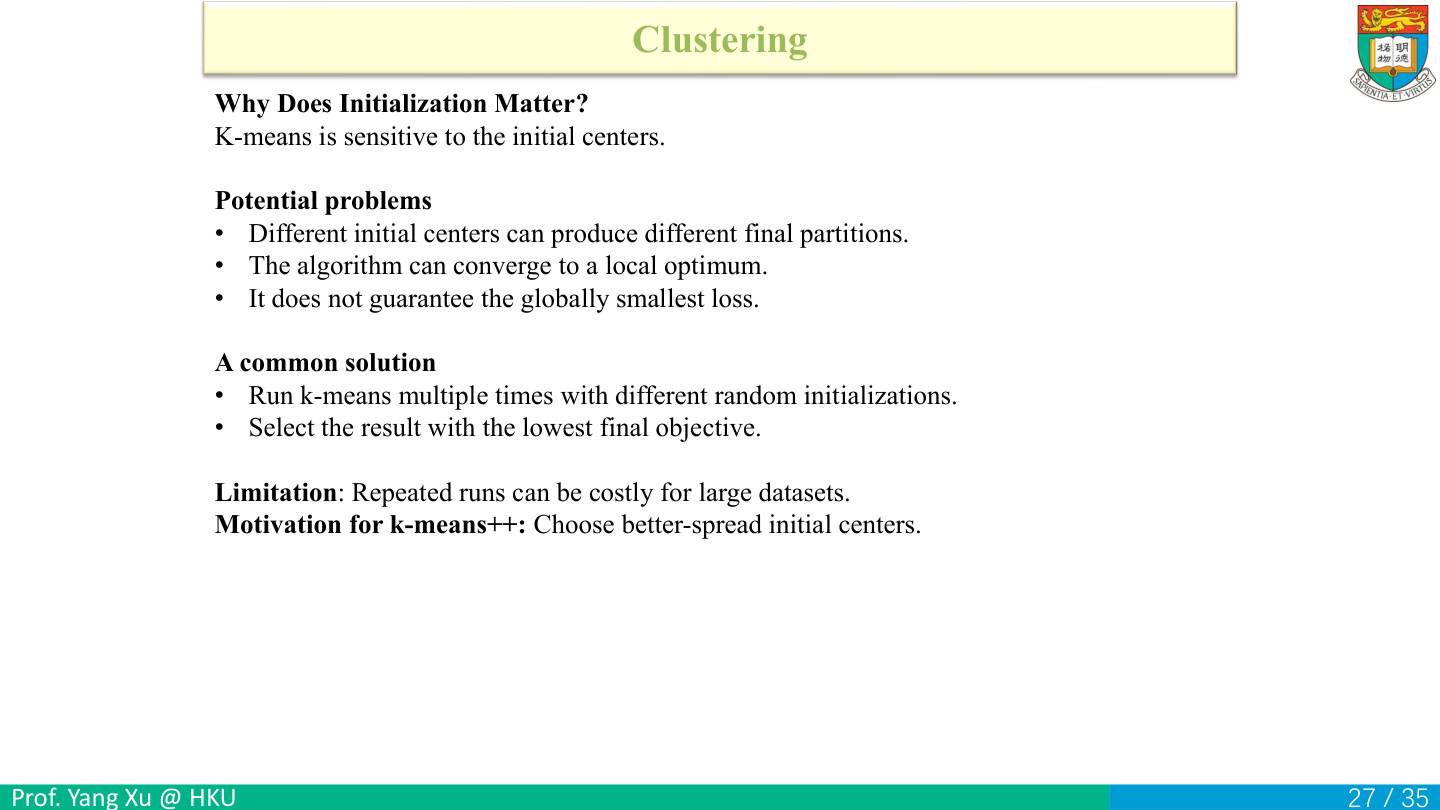
不同初始中心可以让k-means停在不同的稳定分区。下面比较两个已经稳定、却有不同SSE的结果,理解“局部最优”的意思。
例子:一维数据 {0,4,5,9},K=2。分成 {0} 与 {4,5,9},中心0与6,边界3,重新按最近中心分配后仍不变,SSE为 0+4+1+9=14。另一分区 {0,4} 与 {5,9} 的中心2与7,边界4.5,也稳定,SSE 4+4+4+4=16。稳定分区可有不同损失,稳定本身不证明最好。
常用办法是不同随机初始化跑多次,分别记录最终SSE,选最小的一次。比较必须使用同一数据、同一K、同一距离与预处理;K增大通常能降低SSE,不能仅凭更低SSE说更多簇更合理。
固定随机种子可以复现一次初始化。k-means++则按距离选择分散的中心,改善起点;后续仍使用分配和均值更新。
自测:同一数据、同一K,两次结果的SSE分别14与16,按平方误差目标选哪个?14,因为它的组内距离总和更小。
k-means++:按最近中心的平方距离抽样
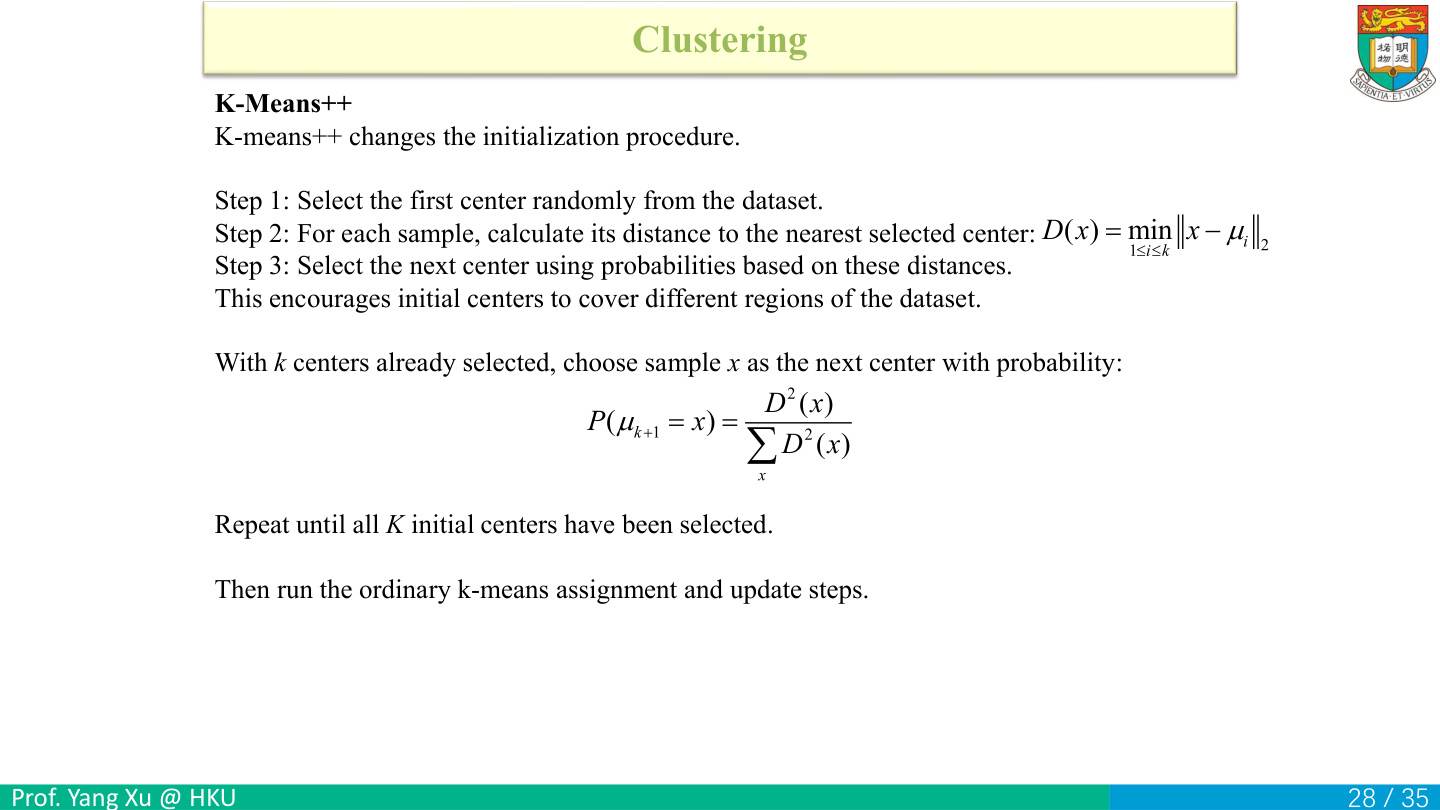
k-means++只负责初始化。第一中心从数据中随机选;已有中心后,对每个样本x先算到每个已选中心的距离,保留最小值 D(x)=min_i ||x−μi||。再用 P(x)=D(x)^2/Σ_u D(u)^2 作为下一个中心的抽样概率。
计算顺序是:找最近中心→算距离平方→把全部平方距离相加→各自除以总和→按概率抽样。D(x)是普通距离,D(x)²才是抽样权重。
例子:数据0、2、5,已选中心0。D是0、2、5,平方权重0、4、25,总29,概率0、4/29、25/29。5很可能被选中,但2仍有4/29的机会。“概率最大”不等于“一定选它”。已选中心距离0,正常情况下不会再被抽到。
为K个中心重复抽样后,仍按普通k-means计算最近组与均值,不能把抽中的原样本永远锁成最终中心。
自测:已有两个中心1和9,点2到它们的距离1和7,用哪个数作D?1,因为它已被中心1很好代表。
电流聚类题设:六个数、一个特征、三个簇
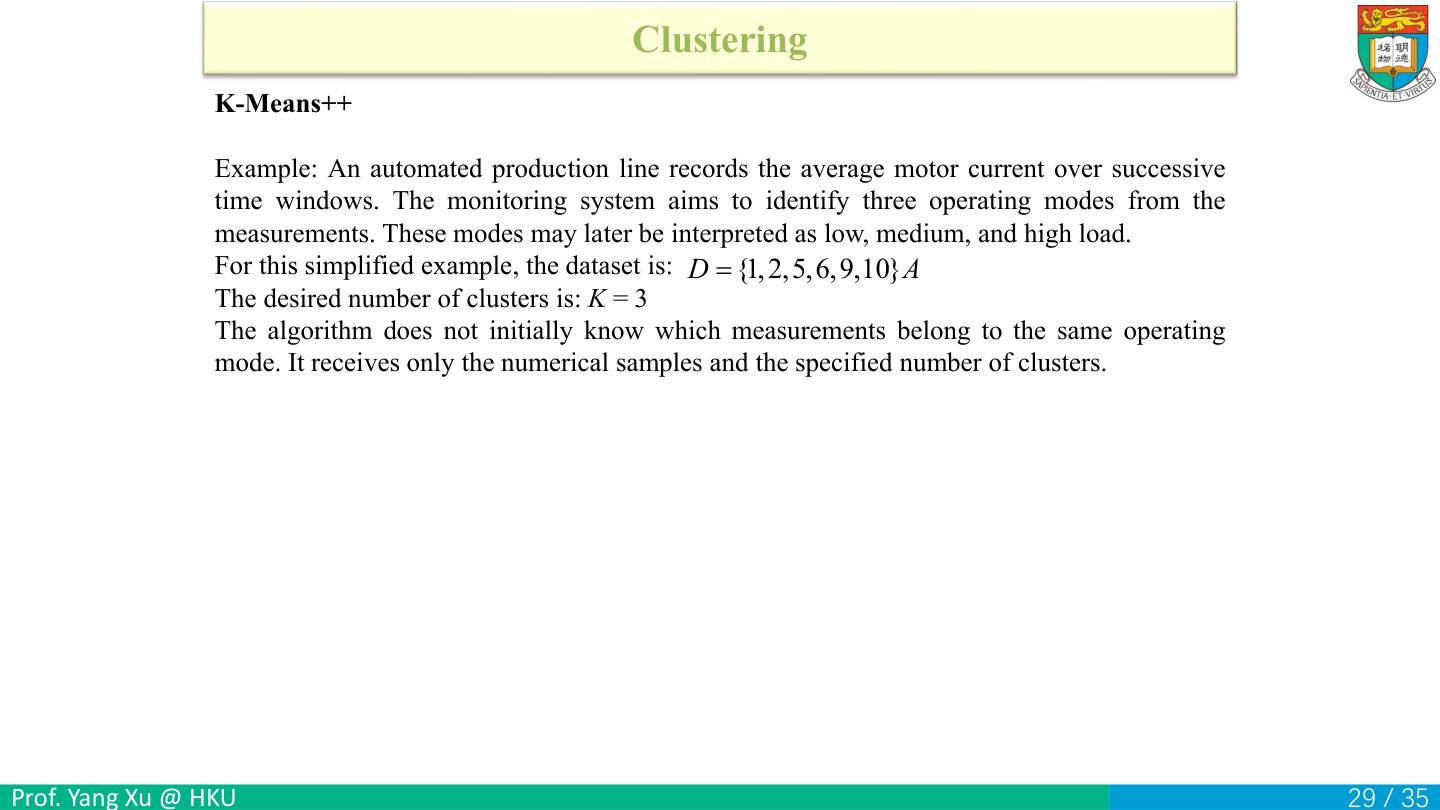
原数据 D={1,2,5,6,9,10} A,单位A是安培。每个数对应一个时间窗口的平均电流,所以样本数M=6、特征维度n=1。K=3由题目指定,算法没有预先获知每个值属于低、中、高负载。
一维普通距离就是绝对值 |x−μ|,平方距离就是 (x−μ)^2。例:5A与2A相差3A,平方距离9A²。聚类损失用A²;抽样概率为平方距离除平方距离总和,单位相消,所以概率没有安培单位。
接下来逐步执行:先取中心2→算六个点的抽样概率→抽到9→更新每个点到最近中心的距离→再抽第三中心→运行k-means。
自测:该题n是多少?1,虽然有6个数,六是样本数。若每个时间窗还记录一个温度,才会变成二维特征,距离计算也要多一项。
第二中心抽样:分母139怎样得到
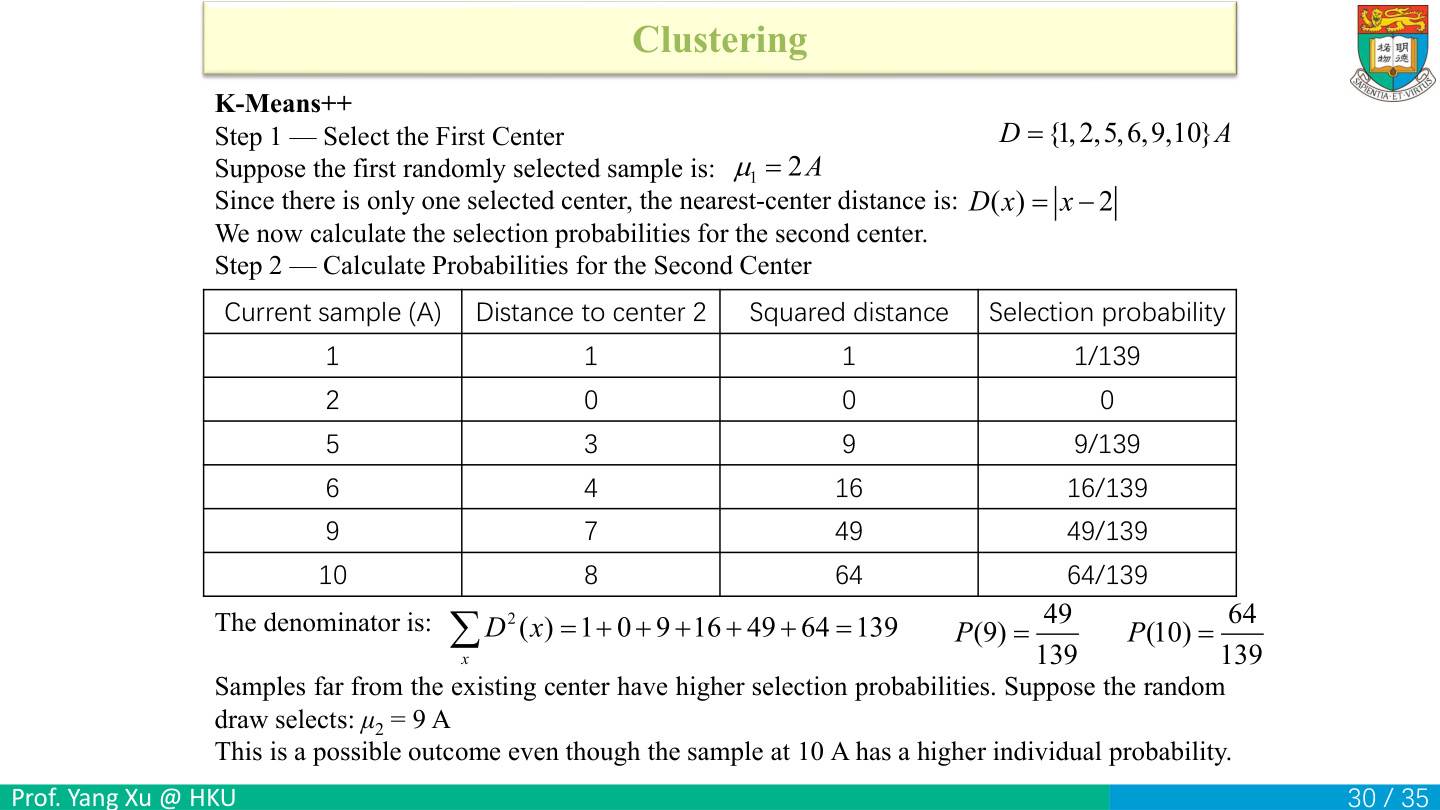
题设第一中心μ1=2A。对每个x计算 D(x)=|x−2|,然后平方:
| x(A) | 减法与距离 | D² | 概率 |
|---|---|---|---|
| 1 | abs(1−2)=1 | 1 | 1/139 |
| 2 | abs(2−2)=0 | 0 | 0 |
| 5 | abs(5−2)=3 | 9 | 9/139 |
| 6 | abs(6−2)=4 | 16 | 16/139 |
| 9 | abs(9−2)=7 | 49 | 49/139 |
| 10 | abs(10−2)=8 | 64 | 64/139 |
分母逐项相加 1+0+9+16+49+64=139。概率和 (1+0+9+16+49+64)/139=1,这是检查表格的第一方法。10的概率约46.04%,9约35.25%,5约6.47%。题目接着假设随机抽中9,这与10概率更大不矛盾。
把随机数换成更好算的0到139刻度,从左往右按权重划区间。样本1占[0,1),5占[1,10),6占[10,26),9占[26,75),10占[75,139)。样本2的权重为0,所以略过。假如抽到60,它落在[26,75),这次就选9。每段长除以139就是表中的概率。
此时完成的是第二个初始中心的抽样。抽到9,就把9作为中心;有了三个初始中心后,再开始正式分组。
自测:10概率最大,能把算法改写为每次直接取最远点吗?不能;那是确定性的另一种选择规则,改变了k-means++的随机抽样定义。
选了2和9以后:每点只保留最近的距离
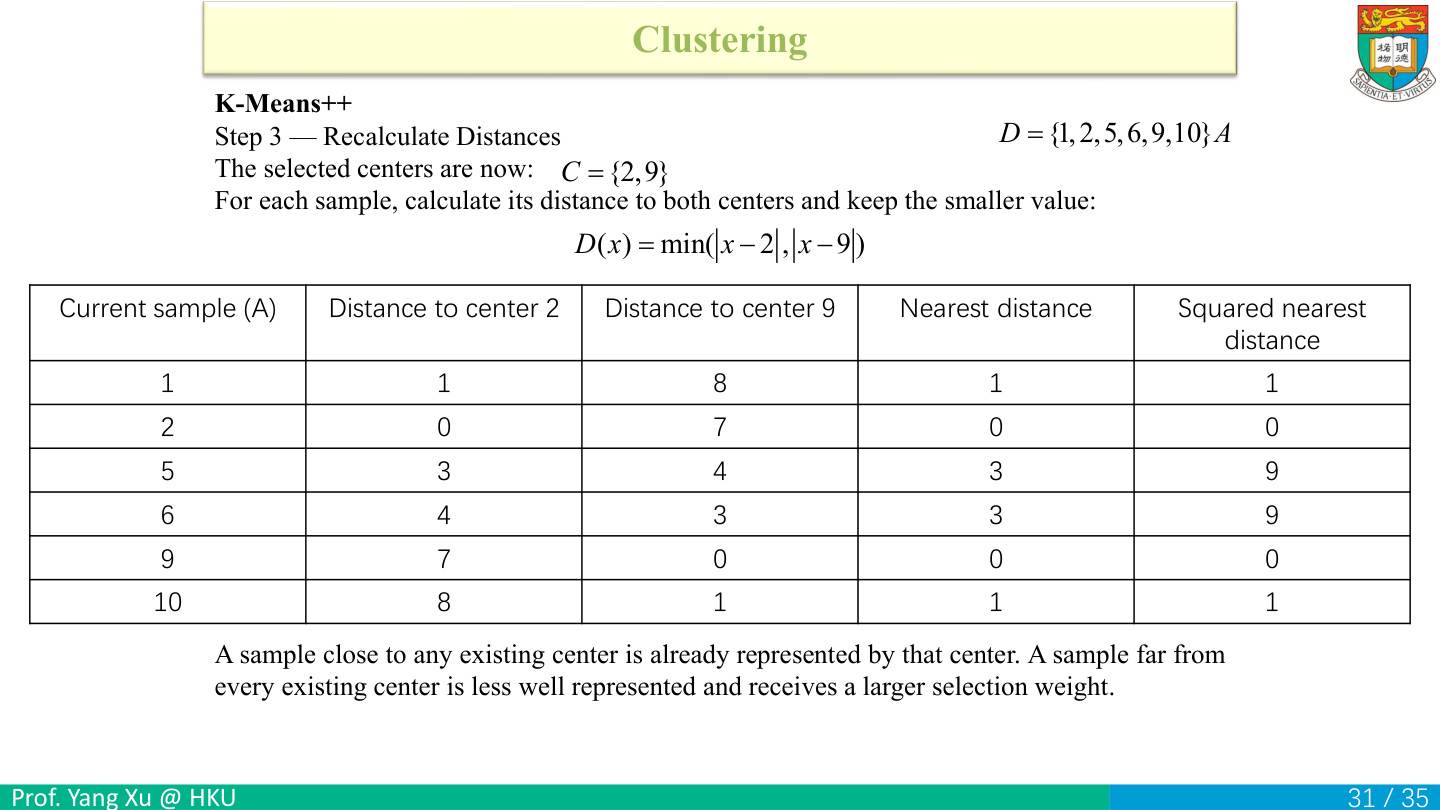
已有中心集合 {2,9}。第三中心抽样前必须重算距离,不能继续沿用上一页到2的距离。逐点做两次减法,再取较小的绝对值:
| x | 到2距离 | 到9距离 | D=min | D² |
|---|---|---|---|---|
| 1 | 1 | 8 | 1 | 1 |
| 2 | 0 | 7 | 0 | 0 |
| 5 | 3 | 4 | 3 | 9 |
| 6 | 4 | 3 | 3 | 9 |
| 9 | 7 | 0 | 0 | 0 |
| 10 | 8 | 1 | 1 | 1 |
例如10到2很远,但离已选的9只有1,所以其权重从64降到1。6到2为4、到9为3,最近距离改成3,平方是9。5到两个中心为3和4,取3。现在中间区域5、6尚未被很好代表,抽样权重相对变大。
这一过程体现“覆盖不同区域”:不是奖励离某一个特定中心远,而是奖励离所有已选中心都不近。若一个点贴近任意一个中心,它已经被覆盖,就无需再花一个中心重复表示。
表中的0、1、9只是初始抽样用的平方最近距离。它们还不是最终聚类结束后的SSE,之后中心会更新到均值,所有距离需要再次计算。
自测:点9到中心2是7,为什么本页D不是7?因为它本身就是中心9,到该中心距离0;取最小值0。把到两个中心的平方距离相加会错误地给9很大权重。
第三中心:45%对应的是5和6,不是9
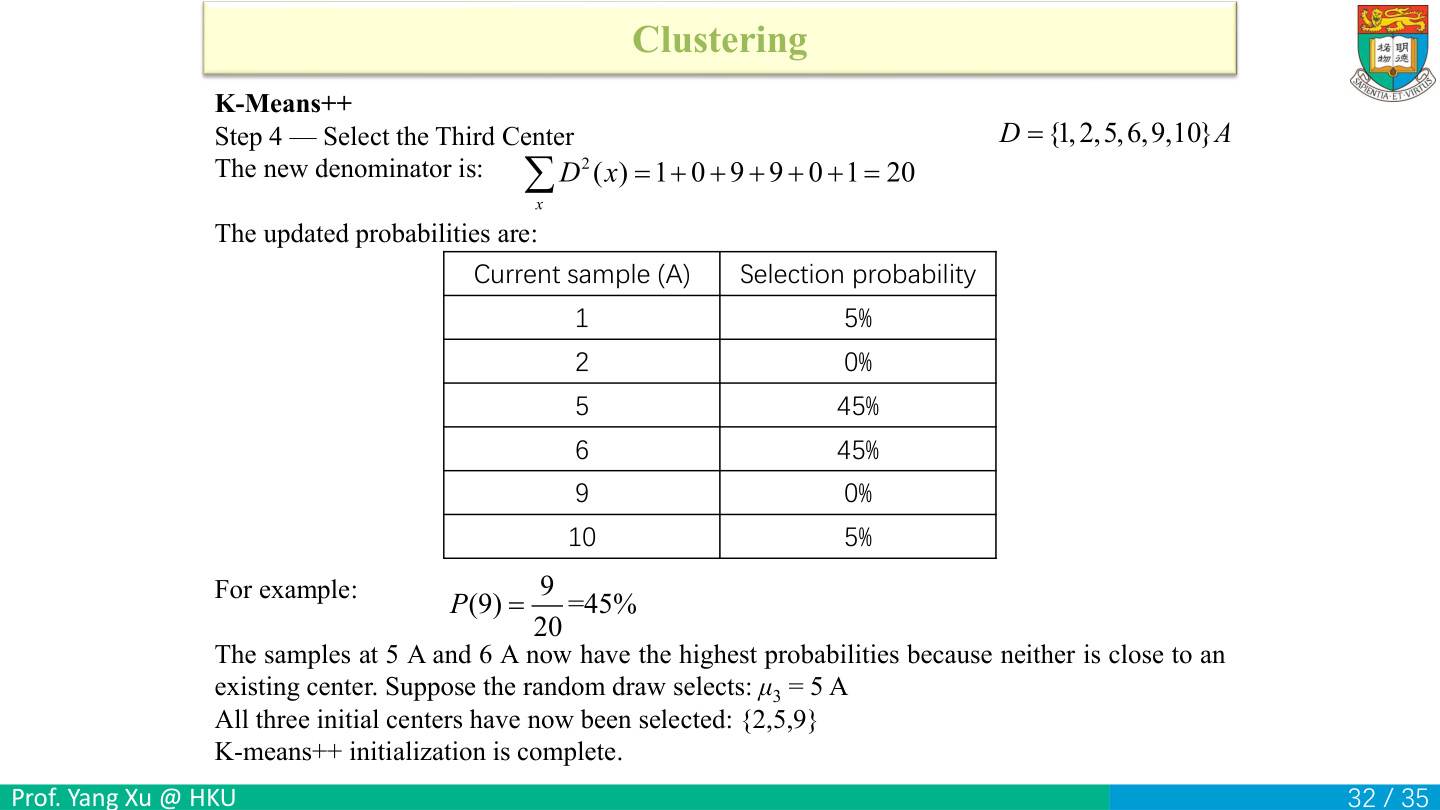
上一页权重为 [1,0,9,9,0,1],总和 1+0+9+9+0+1=20。分别除20,得到 [5%,0%,45%,45%,0%,5%]。这里每个概率对应原数据顺序1、2、5、6、9、10。
这里应写 P(5)=P(6)=9/20=45%。原图表格下的 P(9) 是笔误:样本9已是中心,距离0,所以P(9)=0。分子9来自距离3的平方。
按题目给出的抽样结果,第三中心取5A,三个初始中心为 {2,5,9}。5是一次随机抽中的样本,下一步再用组内均值更新它。
概率检查有两条:已选中心2与9的概率均0;全部概率和 5+0+45+45+0+5=100%。完成后停止k-means++初始化,开始普通k-means的分配与更新。
自测:若有人算出点10的概率64/139,错在哪?他沿用了只有中心2时的旧表,没有在中心9加入后重算最近距离。这个错误不在归一化除法,而在更早的距离更新步骤。
正式k-means:把抽到的中心更新成组内均值
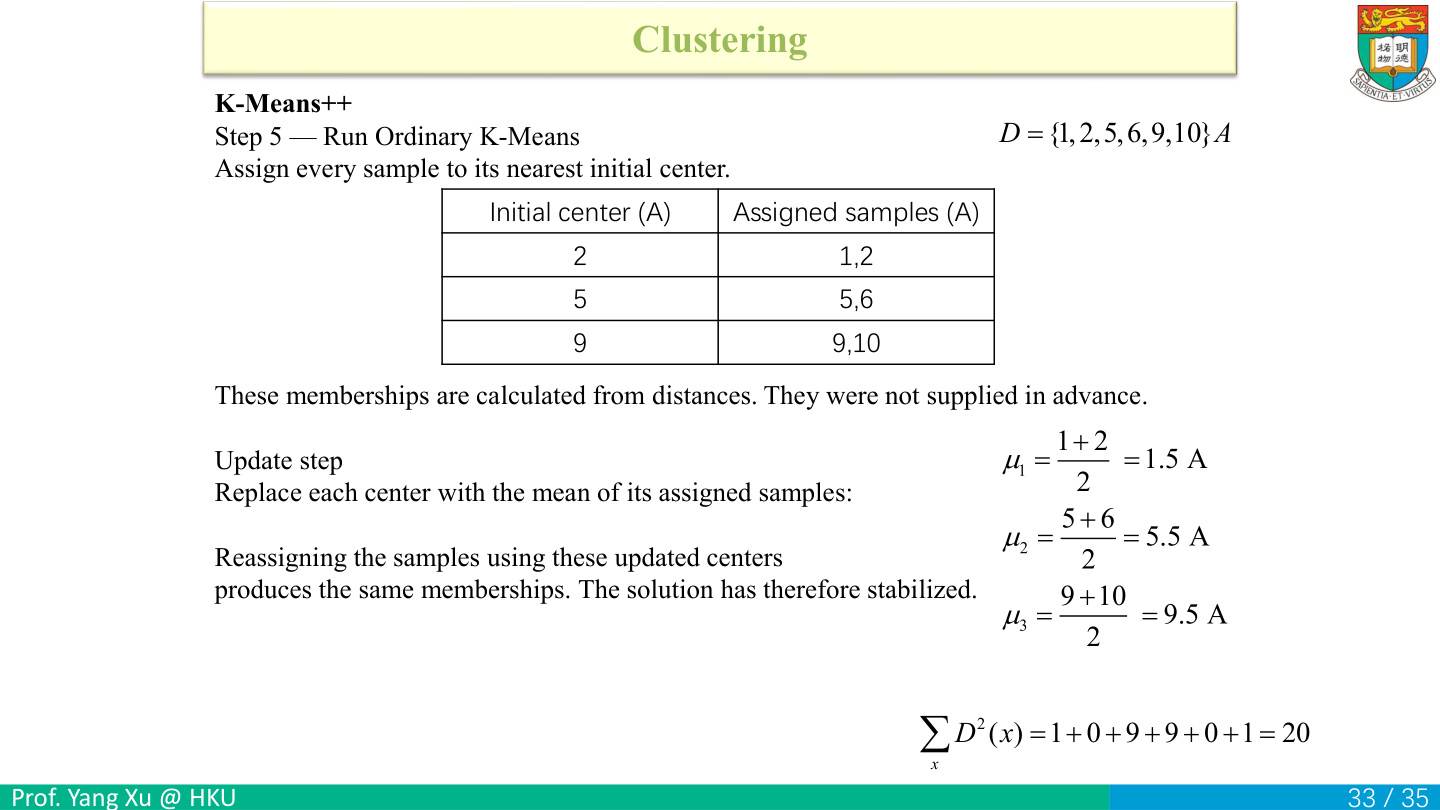
初始中心2、5、9齐了,先比较每个点到三个中心的距离:
x=1:1,4,8 →中心2       x=2:0,3,7 →中心2
x=5:3,0,4 →中心5       x=6:4,1,3 →中心5
x=9:7,4,0 →中心9       x=10:8,5,1→中心9
得到三组 {1,2}、{5,6}、{9,10}。再统一更新:μ1=(1+2)/2=1.5,μ2=(5+6)/2=5.5,μ3=(9+10)/2=9.5,单位仍是A。均值不必是原样本值,所以1.5、5.5、9.5合法。
还需要检查更新后的分配。三个中心相邻中点为 (1.5+5.5)/2=3.5 与 (5.5+9.5)/2=7.5。1、2都低于3.5;5、6在3.5与7.5之间;9、10高于7.5。分组不变,再求均值也不变,因而稳定。
原页底部残留的 ΣD²=20 是前一阶段的抽样分母,不能当本页最终聚类损失。用初始中心2、5、9时SSE为 1+0+0+1+0+1=3;更新为1.5、5.5、9.5后,每点误差绝对值0.5,SSE为 6×0.25=1.5。两种数都需要重新计算,均不是20。
自测:为什么不能抽中5以后就直接宣布最后中心是2、5、9?因为那只是初始化;组内均值更新还能将目标从3降到1.5。
最终结果、损失单位与新样本预测
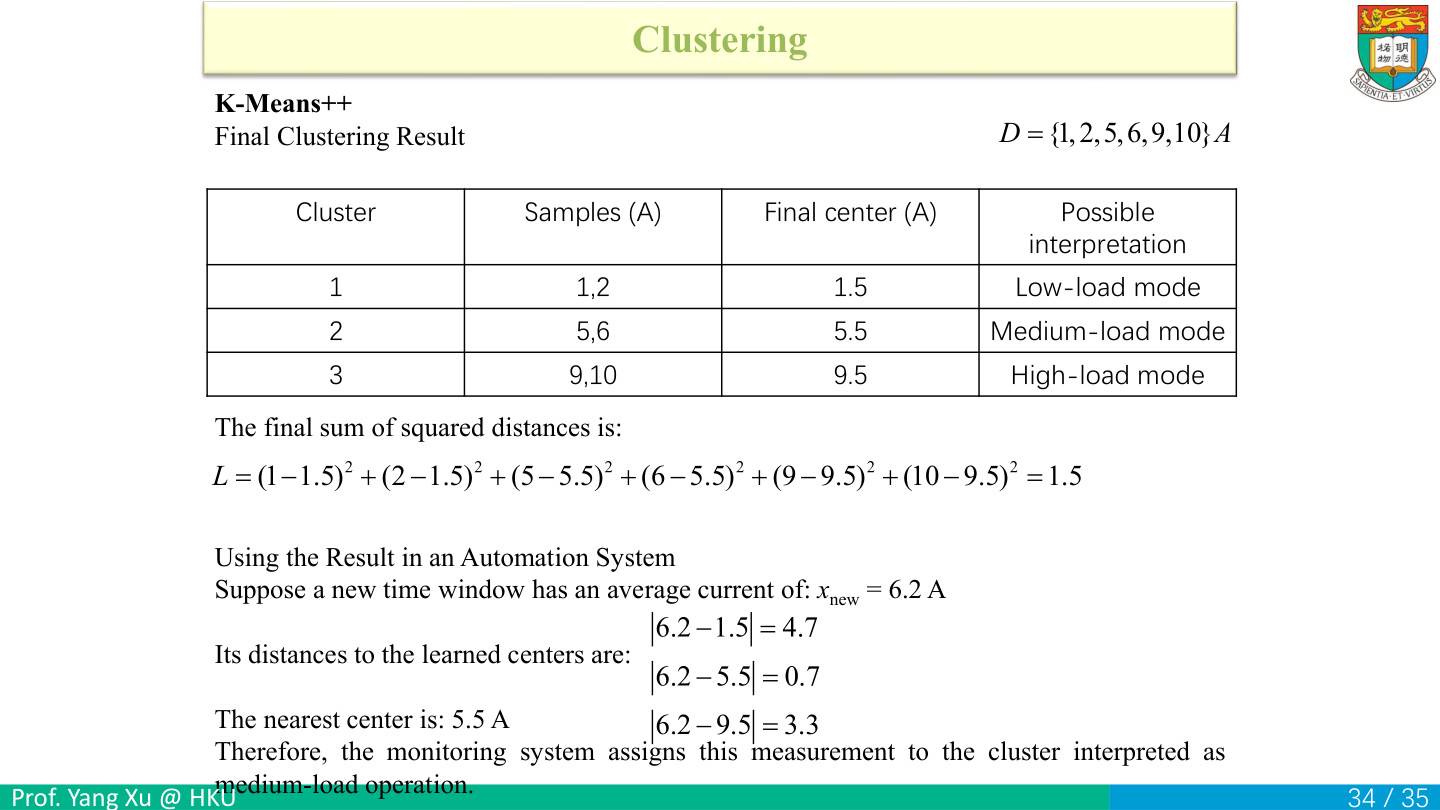
最终中心为1.5、5.5、9.5A,三组分别 {1,2}、{5,6}、{9,10}。它们可以被业务人员解释为低、中、高负载模式;组号1、2、3本身没有固定语义,交换编号不会改变分组质量。
损失逐项算:(1−1.5)²=0.25、(2−1.5)²=0.25、(5−5.5)²=0.25、(6−5.5)²=0.25、(9−9.5)²=0.25、(10−9.5)²=0.25。总SSE为 6×0.25=1.5 A²。若题目要每样本平均平方距离,则除6得到0.25A²;若问SSE,就不要主动除6。
新电流6.2A到三个中心的距离是:|6.2−1.5|=4.7、|6.2−5.5|=0.7、|6.2−9.5|=3.3。最近中心5.5,因此分到中间组。课件最后一行第三个距离写成减法时要取绝对值,距离不能为负。
自测:6.2的组内平方误差是多少?0.7²=0.49 A²。这和整个训练集SSE1.5不是同一个统计量。
本讲回顾
CNN计算顺序:卷积乘加→激活→池化→展开→全连接分类。k-means计算顺序:初始化→分配→求均值→重复;k-means++负责其中的初始化。
结束
本讲结束。下一讲学习贝叶斯网络与自编码器。